
Points clés à retenir
- Dégradé ≠ en panne : un disque dont la latence d'E/S passe d'environ 10 ms à plus de 100 ms peut perturber la continuité des activités même s'il n'est pas complètement en panne — une situation plus difficile à détecter qu'une panne matérielle pure et simple.
- La rapidité compte : Sangfor aSAN (la solution de stockage distribuée définie par logiciel de Sangfor) identifie un disque dur bloqué en 13 secondes, contre 120 secondes par défaut pour vSAN pour marquer un disque hors ligne.
- La granularité réduit l'impact : l'isolation au niveau des partitions de Sangfor aSAN évite de mettre hors ligne un disque entier à cause de quelques partitions incohérentes, contrairement aux approches traditionnelles qui isolent au niveau du disque entier.
- Conception axée sur le logiciel : Sangfor aSAN assure une isolation complète au niveau de la couche application/logiciel, sans retrait physique du disque, réduisant ainsi les dépendances de compatibilité matérielle entre les différents fournisseurs.
- Gestion adaptative des pannes : le centre de pannes distribué de Sangfor aSAN réactive les répliques qui se rétablissent naturellement et ne déclenche l’isolation et la reconstruction complètes que pour les pannes persistantes ou récurrentes, minimisant ainsi les cycles de reconstruction inutiles.
- Éprouvé en production : dans l’environnement MES d’un client du secteur manufacturier, un incident de blocage de disque a été résolu en 15 secondes après le déploiement de Sangfor aSAN, et de multiples incidents de dégradation de disque ont été gérés sur une période de six mois tout en maintenant l’interruption de service très courte.
- Applicabilité plus large que la surveillance hors bande : comparée aux solutions concurrentes basées sur les iostats, la surveillance intégrée par E/S de Sangfor aSAN offre des mesures plus précises et un risque de faux positifs plus faible.
À mesure que les entreprises modernisent leur infrastructure de virtualisation, le stockage distribué doit garantir des performances stables et efficaces dans des environnements matériels de plus en plus complexes et diversifiés. Or, une panne complète d'un disque suffit à perturber l'activité. Un périphérique qui reste en ligne tandis que son temps de réponse d'E/S passe d'environ 10 ms à plus de 100 ms peut bloquer les écritures de répliques, réduire le débit du cluster et menacer la continuité de service.
Sangfor aSAN relève ce défi grâce à un cadre d'isolation des disques basé sur un logiciel, conçu pour identifier les composants dégradés, contenir leur impact et protéger la stabilité du stockage sans traiter immédiatement chaque ralentissement temporaire comme une panne matérielle permanente.
PARTIE 1. Disques dégradés : la menace cachée pour la stabilité de l’entreprise
Les systèmes de stockage distribués utilisent généralement des algorithmes d'écriture à cohérence forte et à réplicas multiples . Une écriture n'est confirmée à l'application qu'une fois que tous les réplicas requis ont terminé l'opération. Lorsqu'un disque, un hôte ou un autre composant entre dans un état dégradé, par exemple lorsque le temps de réponse des E/S disque passe de 10 ms à plus de 100 ms, les E/S d'écriture peuvent se bloquer, ce qui affecte considérablement les performances de l'application et peut entraîner une interruption de service à grande échelle. Ce problème peut être encore plus marqué dans les environnements matériels hétérogènes, où la qualité des composants et leurs caractéristiques de défaillance peuvent varier.
Les solutions traditionnelles utilisent généralement la détection hors bande pour considérer un disque dégradé comme défaillant. Bien que cela permette de préserver la continuité d'activité, cette méthode présente deux limitations majeures. Premièrement, un disque dégradé peut retrouver un état normal ultérieurement. Deuxièmement, considérer la dégradation comme une panne permanente peut accélérer le remplacement et l'usure du matériel, augmentant ainsi les coûts de maintenance.
Pour remédier à ces problèmes, l'industrie a mis en place une approche améliorée : un cadre d'isolation logicielle prenant en compte les applications. Ce cadre surveille périodiquement les indicateurs d'état des disques, tels que la latence et les IOPS. Lorsqu'un disque atteint un seuil spécifié, il est identifié comme bloqué ou lent, et une série d'actions correctives est déclenchée.
Bien que cette approche représente un progrès, plusieurs domaines nécessitent encore des améliorations :
- Délai d'exécution limité : les contrôles de cohérence des réplicas doivent répertorier tous les fragments du disque. Du premier signe de blocage du disque à son isolation finale, le processus peut prendre plusieurs minutes, un laps de temps pendant lequel la continuité des activités peut déjà être gravement compromise.
- Impact important : Une incohérence dans seulement quelques partitions sur un disque lent peut empêcher l'isolation complète du disque, permettant ainsi à l'interruption de l'activité de se poursuivre.
- Identification imprécise : Le système ne surveille que le côté disque, ce qui augmente le risque de détections manquées et de faux positifs.
PARTIE 2. Isolation logicielle des disques aSAN : un nouveau modèle de gestion des pannes de stockage
L'isolation logicielle des disques SAN de Sangfor combine la détection des pannes prenant en compte les applications, le diagnostic heuristique des pannes et la mise en quarantaine précise des composants. Ces fonctionnalités permettent d'éviter qu'un seul composant défectueux n'affecte la continuité de l'activité.
1. Architecture de cadre d'isolation souple : deux couches protègent la stabilité du stockage
Le framework d'isolation souple aSAN utilise le volume de stockage virtuel physique comme unité de gestion et se compose de deux parties :
- Plan de données du client de stockage : La détection de la dégradation des répliques protège la disponibilité des répliques, isole temporairement une réplique dégradée en quelques secondes et signale rapidement les informations de panne afin que les opérations commerciales ne soient pas affectées.
- Plan de contrôle d'isolation souple : Le Centre de gestion des pannes distribuées (DFC) collecte les informations de panne signalées par les modules d'extension des nœuds de pannes distribuées (DFN). Il corrèle et analyse ces rapports afin de diagnostiquer les pannes avec précision et de réduire les faux positifs. Si une panne peut être résolue rapidement, la réplique défaillante est réactivée après sa résolution, évitant ainsi un fonctionnement prolongé avec un nombre réduit de répliques. Si une panne ne peut être résolue, le composant affecté est totalement isolé et la réplique défaillante est reconstruite afin de garantir la fiabilité des données.
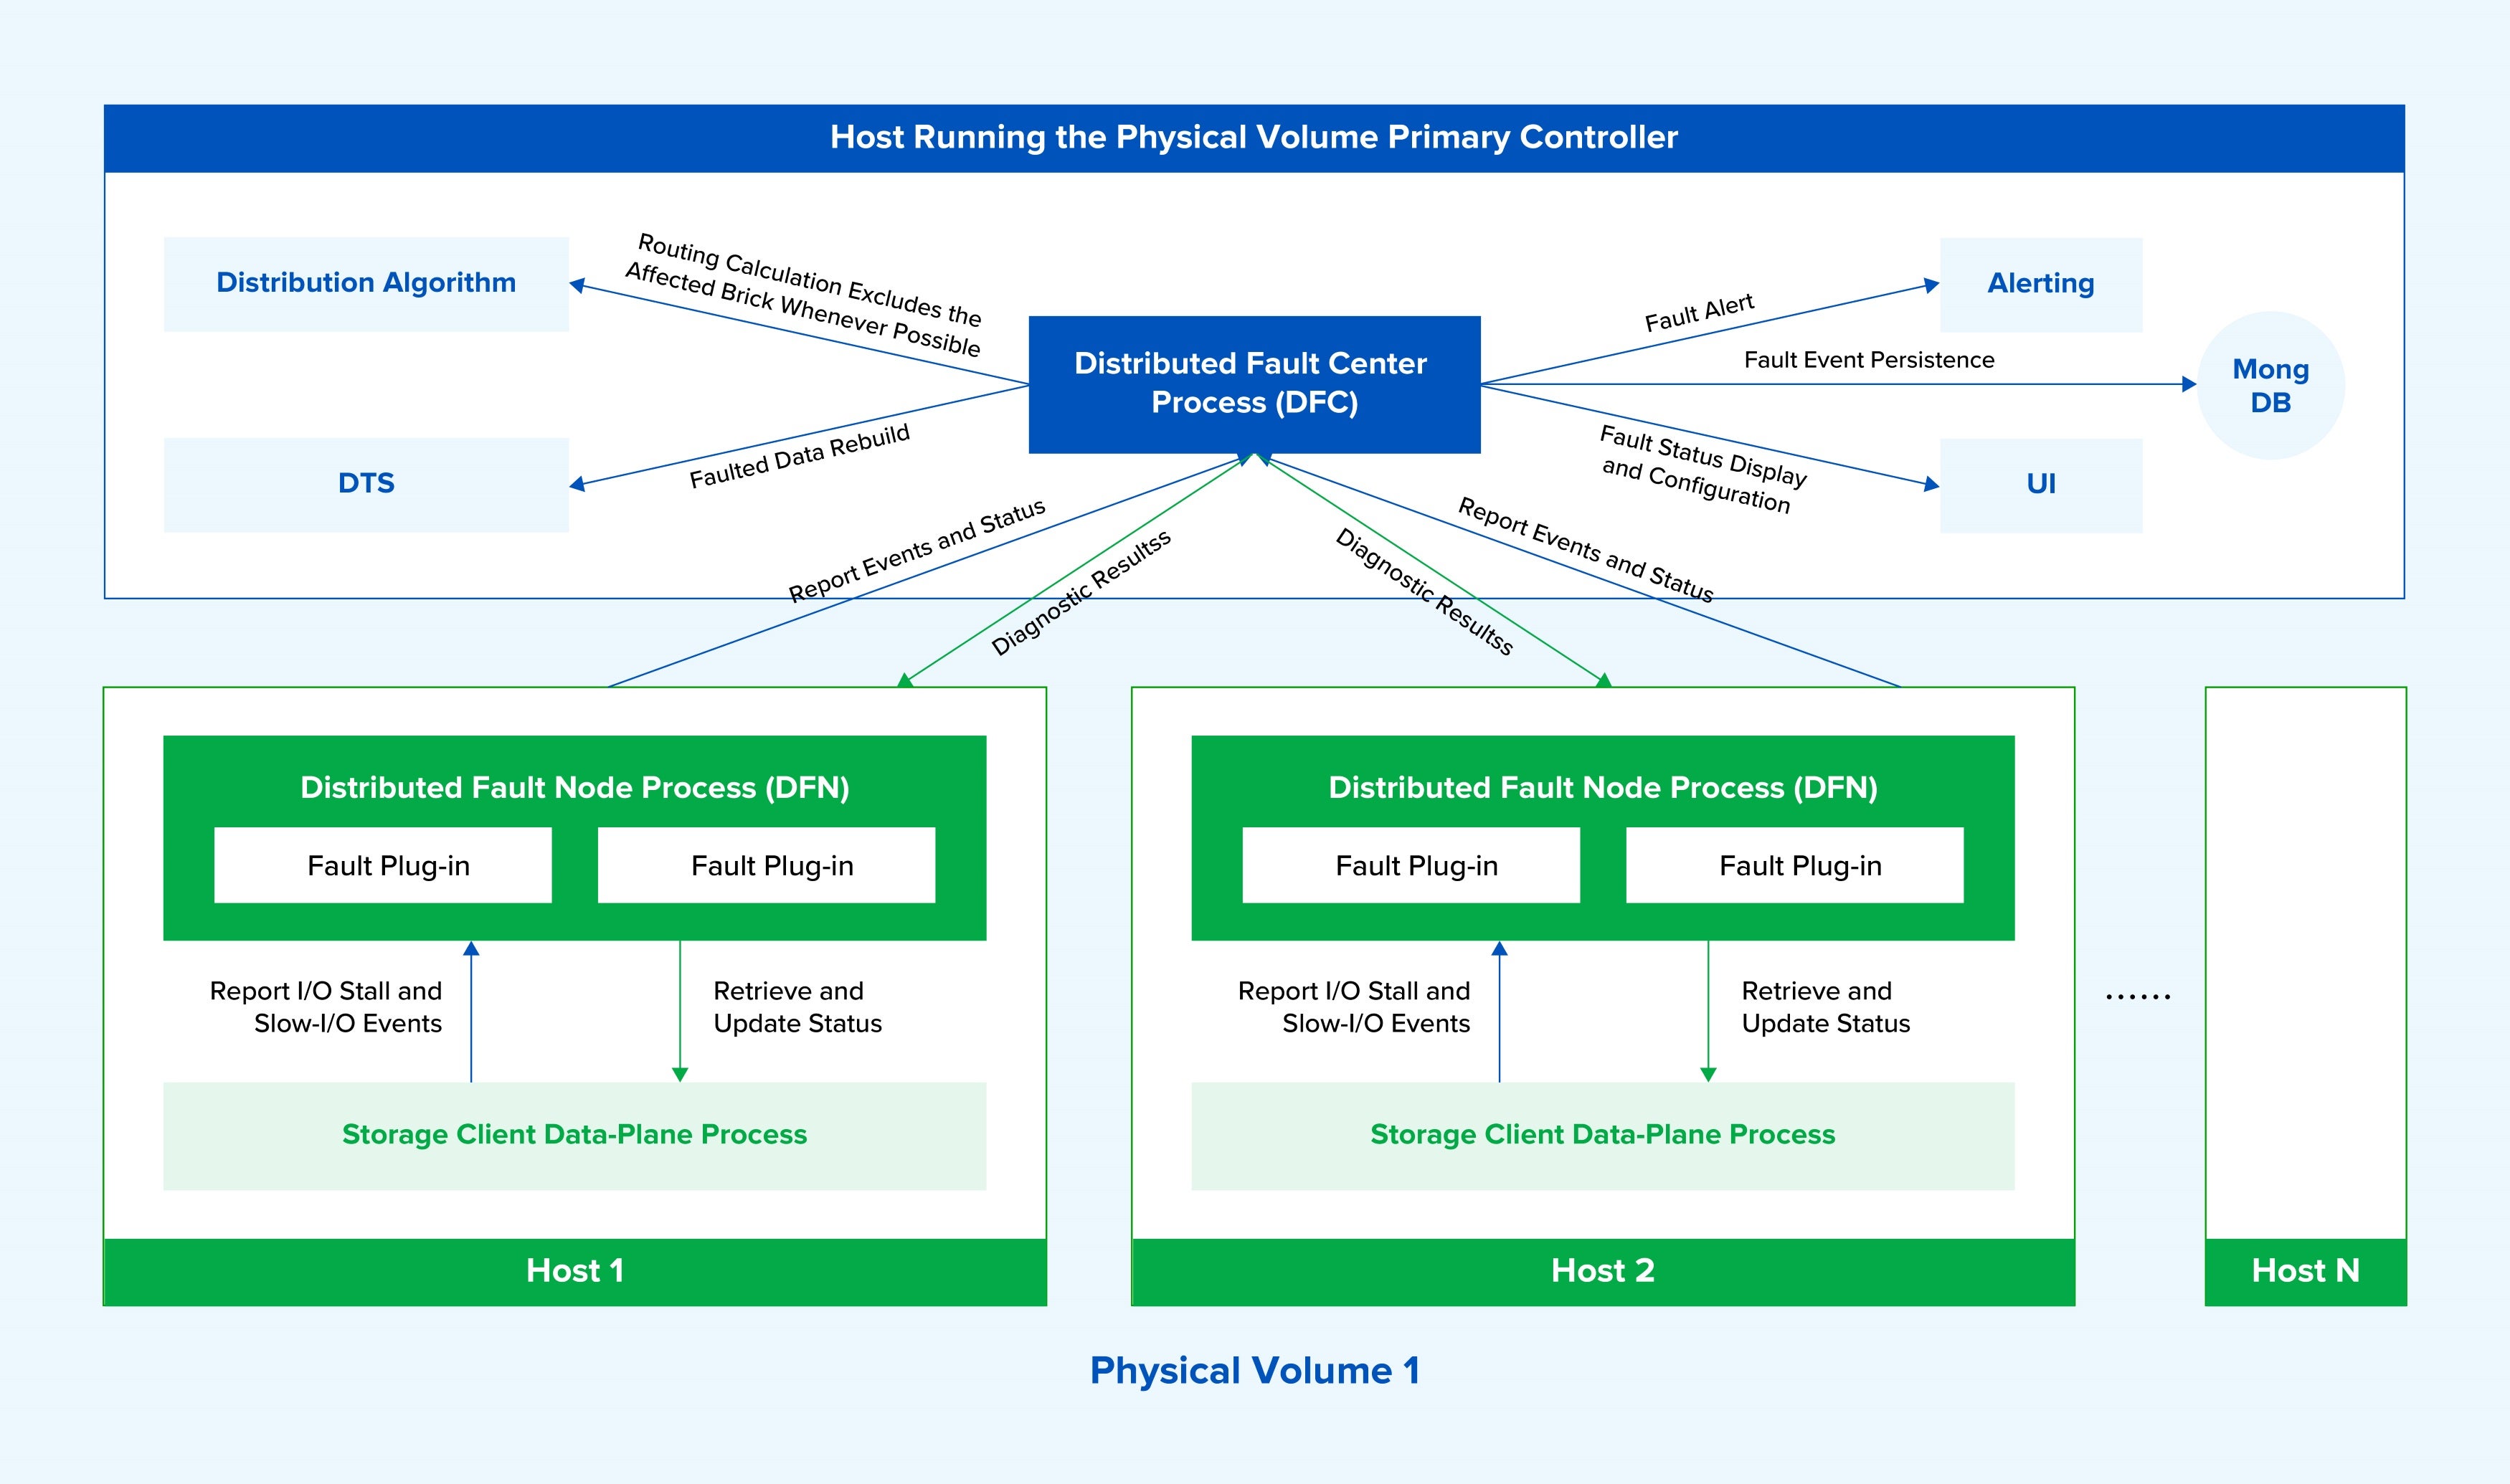
Figure 1. Architecture du cadre d'isolation logicielle d'un lecteur aSAN.
2. Une avancée majeure dans l'isolation des logiciels de la couche application sans retrait physique du disque dur
Comparée à la méthode courante de retrait physique des disques et aux approches d'isolation logicielle classiques prenant en compte les applications, la plateforme Sangfor aSAN utilise un mécanisme d'isolation entièrement logiciel. Elle élimine les opérations de retrait physique des disques, évite les problèmes de compatibilité entre les différentes marques de matériel et améliore la polyvalence et la stabilité de la solution.
DFN propose également une interface de gestion des pannes intégrant le module client du plan de données et le module de détection des disques bloqués ou lents. Ceci étend les capacités de gestion des pannes et permet une correction plus précise.
Globalement, la solution d'isolation logicielle des disques aSAN de Sangfor démontre à la fois une innovation architecturale et une valeur pratique au niveau applicatif, offrant une nouvelle approche de la gestion des pannes dans les systèmes de stockage distribués. Les deux séries de résultats comparatifs suivantes illustrent les performances de cette solution en pratique.
PARTIE 3. Résultats de validation : aSAN en tête des performances sur l’ensemble des tests
1. Comparaison avec VMware lors de tests de blocage et de ralentissement des disques
Sangfor a effectué des tests comparatifs et une validation pratique par rapport à VMware dans cinq domaines : détection des E/S disque bloquées, détection des E/S disque lentes, détection de la dégradation du contrôleur RAID, reconstruction après une panne de disque bloqué ou lent et l’effet d’une telle panne sur les E/S de l’entreprise.
| Élément de test | aSAN (Sangfor) | vSAN (VMware) | Comparaison |
| Détection de blocage des E/S disque | Pour un disque dur, si une requête d'E/S reste bloquée pendant 13 secondes ou si sa latence dépasse 500 ms, aSAN identifie le disque comme bloqué. Le disque n'est pas immédiatement mis hors service. | Si un périphérique ou un contrôleur ne répond pas à une commande d'abandon dans les 120 secondes (délai d'expiration par défaut), vSAN marque le disque ou le groupe de disques comme hors ligne afin d'éviter que le problème n'affecte l'ensemble du cluster vSAN. | aSAN assure une détection plus rapide. Associé à des mécanismes de réplication et de reconstruction, aSAN contribue à éviter les erreurs de classification des pannes transitoires et permet une détection rapide et précise. |
| Détection d'E/S disque lentes | Pour un disque dur, si la latence d'E/S dépasse 70 ms pendant 1 minute sur une période de 5 minutes, aSAN identifie le disque comme lent. Le disque n'est pas immédiatement mis hors service. | Le critère de rétrogradation du pilote est déclenché lorsqu'au moins quatre écritures retardées surviennent sur une période d'environ six heures et que la latence d'écriture dépasse le seuil prédéfini du pilote. Ces seuils sont de 500 ms pour les écritures sur disque dur, de 50 ms pour les lectures sur SSD et de 200 ms pour les écritures sur SSD. | • aSAN identifie plus rapidement les disques lents, en utilisant des critères relativement directs et simples. • vSAN utilise des critères plus complexes et une période d'évaluation plus longue. |
| Détection de dégradation du contrôleur RAID | La couche de stockage n'effectue pas de détection statistique distincte des E/S lentes au niveau matériel RAID. Au niveau logiciel système, la dégradation du contrôleur RAID est détectée par le même mécanisme que celui utilisé pour la détection des disques lents. | Si la transmission d'E/S en temps réel entre le contrôleur RAID et l'hôte dépasse 30 secondes, vSAN marque immédiatement le périphérique comme dégradé . | aSAN ne dépend pas de la surveillance ou de la correction au niveau matériel, ce qui offre une plus grande adaptabilité matérielle et réduit la dépendance à l'égard de fournisseurs de matériel spécifiques. |
| Reconstruction après une panne de transmission (blocage ou ralentissement) | Une reconstruction est lancée si le défaut du disque persiste pendant 5 minutes, ou s'il se reproduit et se résout automatiquement 3 fois en 1 heure. Cela permet d'éviter qu'une reconstruction ne soit déclenchée par un défaut transitoire du disque. | Lorsqu'un disque est marqué comme dégradé, vSAN lance immédiatement sa reconstruction si la capacité disponible est suffisante. | aSAN évalue en permanence l'état de la panne, réduisant considérablement la possibilité d'une reconstruction inutile due à une panne transitoire et améliorant la stabilité globale du système. |
| E/S commerciales lors d'un défaut de disque dur bloqué ou lent | Si les E/S expirent après 8 secondes ou restent lentes en continu, le disque concerné est rétrogradé et les E/S professionnelles ne sont plus envoyées à la réplique concernée. Toutefois, si un fragment individuel possède moins de répliques que nécessaire, aSAN peut continuer à envoyer des données à la réplique lente au niveau du fragment, maximisant ainsi la continuité des activités. |
• Lorsqu'un disque est marqué comme dégradé , toutes les E/S sont suspendues pendant que vSAN recalcule l'accessibilité de chaque objet en miroir. • Si l'objet reste opérationnel (c'est-à-dire si plus de 50 % des votes sont disponibles), les E/S reprennent. La vérification prend environ 5 à 7 secondes. • Si une machine virtuelle a un FTT = 0, elle ne peut être restaurée qu'après la récupération du disque d'origine ou l'insertion d'un disque de remplacement. |
• Dans les scénarios de pannes multipoints, aSAN prend en charge une dégradation et une isolation plus granulaires au niveau des fragments, offrant une remédiation plus précise. Lorsqu'un disque est marqué comme dégradé par vSAN, l'impact est plus important. La vérification de 5 à 7 secondes de tous les objets en miroir peut engendrer des variations de performances. Si les exigences de réplication ne peuvent être satisfaites, les E/S au niveau du disque peuvent devenir indisponibles, affectant ainsi les services métier. |
Figure 2. Comparaison avec VMware dans les tests de disques bloqués et lents.
La comparaison avec VMware vSAN dans la gestion des disques bloqués et lents a montré que la solution d'isolation logicielle des disques Sangfor aSAN offrait des performances supérieures et un mécanisme de surveillance plus complet dans l'environnement testé.
2. Comparaison avec la solution d'isolation logicielle d'un autre fournisseur
| Détail de la solution | Sangfor | Comparateur de fournisseurs | Comparaison |
| Approche de remédiation | Sangfor utilise une stratégie d'isolation multiniveau basée sur une analyse intelligente des E/S , permettant une isolation flexible et précise tout en minimisant l'impact sur le système de stockage global. | • Utilise l'isolation au niveau du lecteur. • Une fois qu'iostat a détecté une anomalie, le disque entier est isolé. |
Sangfor assure une isolation plus fine et une remédiation plus précise. La solution de surveillance hors bande du fournisseur de comparaison ne prend en charge que l'isolation au niveau du disque. Cette approche est plus simple à mettre en œuvre, mais moins efficace et peut affecter l'utilisation des données normalement stockées sur le disque. |
| Point de détection | Sangfor utilise une surveillance intégrée pour observer en temps réel chaque opération d'E/S du client de stockage et collecter des indicateurs de performance plus détaillés. | • Repose sur une surveillance hors bande. • Se concentre principalement sur les indicateurs de performance globaux au niveau du disque. |
La surveillance intégrée de Sangfor offre une granularité plus fine, des indicateurs plus complets et un risque de classification erronée plus faible. La surveillance hors bande du fournisseur de comparaison est plus simple et nécessite moins d'efforts de mise en œuvre, mais sa granularité de détection est plus grossière et sa couverture métrique est limitée, ce qui rend difficile l'identification précise des anomalies. |
Figure 3. Comparaison globale avec la solution d'isolation souple d'un autre fournisseur.
La comparaison a permis de faire les observations suivantes :
- Approche de remédiation : Sangfor aSAN utilise une stratégie d’isolation multiniveau basée sur une analyse intelligente des E/S. La granularité de l’isolation est plus fine et la remédiation plus précise. La solution de comparaison ne prend en charge que l’isolation au niveau du disque.
- Point de détection : Sangfor aSAN utilise une surveillance intégrée pour observer chaque opération d'E/S du client de stockage. Ceci offre une granularité plus fine, davantage de dimensions de métriques et un risque d'erreur de classification moindre. La solution de comparaison utilise une surveillance hors bande via iostat. Bien que cette approche soit plus simple à mettre en œuvre, elle offre une détection moins efficace.
Globalement, la solution d'isolation logicielle des disques aSAN de Sangfor combine une détection précise et efficace, des politiques intelligentes et flexibles, et une large couverture des scénarios. Ces caractéristiques assurent une protection robuste pour la stabilité des opérations commerciales et font de cette solution un choix fiable pour les systèmes de stockage d'entreprise.
PARTIE 4. Déploiement en production
aSAN améliore la stabilité du MES et réduit les efforts opérationnels
Dans notre système MES (Manufacturing Execution System), les pannes de disques durs entraînaient une chute brutale du temps de réponse. La planification de la production, la gestion des stocks et le contrôle qualité étaient tous impactés. Les pertes économiques mensuelles qui en résultaient atteignaient des centaines de milliers de RMB, tandis que le dépannage consommait un temps et des efforts opérationnels considérables et perturbait fortement la production.
Directeur exécutif, entreprise manufacturière de niveau 1
Lire d'autres témoignages de réussite MES
Après l'introduction de la solution d'isolation logicielle pour disques aSAN de Sangfor, l'environnement MES a bénéficié des améliorations suivantes :
- Intervention rapide : un blocage de disque dur à basse fréquence a été résolu en moins de 15 secondes, permettant ainsi aux services aux entreprises de reprendre rapidement leur fonctionnement normal.
- Stabilité durable : Plusieurs incidents de dégradation de disques durs survenus au cours des six derniers mois ont été résolus tout en maintenant l'interruption de service dans un délai très court.
- Amélioration de l'efficacité : Un fonctionnement stable et efficace du MES a permis une planification de la production plus rapide et plus précise, a considérablement amélioré l'efficacité de la gestion des matériaux et a soutenu une surveillance efficace de la qualité en temps réel, contribuant ainsi à un taux de défauts de produits plus faible.
Au-delà des économies financières directes, l'équipe des opérations informatiques a été libérée des tâches fastidieuses de dépannage matériel, ce qui lui a permis de consacrer des ressources clés aux initiatives informatiques stratégiques et à l'expérience utilisateur, générant ainsi des gains mesurables en matière de productivité opérationnelle globale.
L'isolation logicielle des disques de Sangfor aSAN établit une nouvelle référence en matière de gestion proactive des pannes dans le stockage distribué. Fort de plusieurs années d'innovation interne dans le domaine du stockage, Sangfor continue de développer des solutions fiables et de niveau entreprise qui permettent aux organisations de remplacer leurs infrastructures existantes et d'évoluer sereinement dans des environnements numériques complexes.
Obtenez une démo gratuite de Sangfor HCI
FAQ sur Sangfor aSAN et disque dégradé
Sangfor aSAN (également connu sous le nom de Sangfor Distributed Storage Fabric ou Sangfor Server SAN) est une solution de stockage distribuée définie par logiciel qui agrège les disques locaux de serveurs x86 standard en un pool de stockage unifié. Elle fournit des services de stockage par blocs et iSCSI aux environnements virtualisés, permettant aux machines virtuelles de consommer dynamiquement du stockage en fonction des besoins de l'entreprise.
Un disque dégradé reste en ligne mais présente un temps de réponse d'E/S anormalement élevé ; par exemple, une latence passant d'environ 10 ms à plus de 100 ms. Contrairement à un disque défaillant, il ne cesse pas complètement de fonctionner, mais il peut bloquer les écritures de répliques et ralentir l'ensemble du cluster de stockage.
Comme le disque est toujours techniquement en ligne, la surveillance traditionnelle ne permet pas de déterminer facilement s'il s'agit d'une véritable panne ou d'un simple ralentissement temporaire. Considérer chaque ralentissement comme une panne permanente risque d'entraîner un remplacement matériel inutile, tandis que l'ignorer risque de provoquer une interruption prolongée de l'activité.
aSAN utilise un cadre d'isolation souple à deux couches : un plan de données client de stockage qui détecte la dégradation des répliques et l'isole en quelques secondes, et un plan de contrôle (modules d'extension Distributed Fault Center et Distributed Fault Node) qui met en corrélation les données de panne, réactive les répliques qui se rétablissent et isole et reconstruit entièrement les répliques qui ne se rétablissent pas.
vSAN marque un disque ou un groupe de disques hors ligne s'il ne répond pas à une commande d'arrêt dans un délai d'attente par défaut de 120 secondes et suspend les E/S de tous les objets en miroir pendant 5 à 7 secondes lors du recalcul. aSAN détecte les E/S bloquées en seulement 13 secondes, utilise une isolation au niveau du shard (plutôt qu'au niveau du disque entier) et peut continuer à envoyer des E/S à une réplique dégradée lorsque les exigences de réplication ne sont pas satisfaites.
Non. aSAN utilise un mécanisme d'isolation entièrement logiciel au niveau de la couche application, évitant ainsi le retrait physique du disque et les problèmes de compatibilité matérielle qui peuvent en découler.
Une reconstruction est déclenchée si le défaut persiste pendant 5 minutes, ou s'il se reproduit et se répare automatiquement 3 fois en 1 heure — une conception destinée à éviter de déclencher des reconstructions inutiles à cause de problèmes transitoires.
Dans l'environnement MES d'une entreprise manufacturière de premier plan, aSAN a résolu un blocage de disque dur à basse fréquence en moins de 15 secondes et a maintenu une interruption de service de très courte durée sur plusieurs événements de disque dégradé sur une période de six mois, réduisant ainsi les efforts de dépannage opérationnel.

