
Conclusiones clave
- Degradado ≠ averiado: Una unidad con una latencia de E/S que aumenta de ~10 ms a más de 100 ms puede interrumpir la continuidad del negocio aunque no haya fallado por completo, una condición más difícil de detectar que una falla de hardware manifiesta.
- La velocidad importa: Sangfor aSAN (la solución de almacenamiento distribuido definida por software de Sangfor) identifica una unidad HDD bloqueada en 13 segundos, en comparación con el tiempo de espera predeterminado de 120 segundos de vSAN para marcar un disco como fuera de línea.
- La granularidad reduce el impacto: el aislamiento a nivel de fragmento de Sangfor aSAN evita desconectar una unidad completa debido a unos pocos fragmentos inconsistentes, a diferencia de los enfoques tradicionales que aíslan a nivel de toda la unidad.
- Diseño centrado en el software: Sangfor aSAN realiza el aislamiento completamente en la capa de aplicación/software, sin necesidad de extraer la unidad física, lo que reduce las dependencias de compatibilidad de hardware entre diferentes proveedores.
- Gestión adaptativa de fallos: el Centro de Fallos Distribuidos de Sangfor aSAN reactiva las réplicas que se recuperan de forma natural y solo activa el aislamiento completo y la reconstrucción en caso de fallos persistentes o recurrentes, minimizando así los ciclos de reconstrucción innecesarios.
- Probado en producción: El entorno MES de un cliente del sector manufacturero experimentó una resolución de un incidente de disco bloqueado en 15 segundos tras la implementación de Sangfor aSAN, y se gestionaron múltiples eventos de disco degradado durante seis meses manteniendo una interrupción del servicio muy breve.
- Mayor aplicabilidad que la monitorización fuera de banda: en comparación con las soluciones de la competencia basadas en iostatos, la monitorización integrada por E/S de Sangfor aSAN proporciona métricas más precisas y un menor riesgo de falsos positivos.
A medida que las organizaciones modernizan su infraestructura de virtualización, se espera que el almacenamiento distribuido ofrezca un rendimiento estable y eficiente en entornos de hardware cada vez más complejos y diversos. Sin embargo, no es necesario que una unidad falle por completo para interrumpir el negocio. Un dispositivo que permanece en línea mientras su tiempo de respuesta de E/S aumenta de aproximadamente 10 ms a más de 100 ms puede bloquear las escrituras de réplicas, reducir el rendimiento del clúster y poner en peligro la continuidad del servicio.
Sangfor aSAN aborda este desafío con un marco de aislamiento de unidades basado en software, diseñado para identificar componentes degradados, contener su impacto y proteger la estabilidad del almacenamiento sin tratar inmediatamente cada ralentización temporal como una falla permanente del hardware.
PARTE 1. Discos duros degradados: La amenaza oculta para la estabilidad empresarial
Los sistemas de almacenamiento distribuido suelen utilizar algoritmos de escritura multirréplica con alta consistencia. La aplicación solo recibe confirmación de la escritura una vez que todas las réplicas necesarias hayan completado la operación. Cuando una unidad, un host u otro componente entra en un estado degradado, como cuando el tiempo de respuesta de E/S del disco aumenta de 10 ms a más de 100 ms, la E/S de escritura puede bloquearse, lo que afecta significativamente al rendimiento de la aplicación y puede provocar interrupciones del servicio a gran escala. Este problema puede agravarse en entornos de hardware heterogéneos, donde la calidad de los componentes y las características de fallo pueden variar.
Las soluciones tradicionales suelen utilizar la detección fuera de banda para convertir una unidad degradada en una unidad defectuosa. Si bien esto puede preservar la continuidad del negocio, presenta dos limitaciones importantes. En primer lugar, una condición degradada puede volver a la normalidad posteriormente. En segundo lugar, tratar la degradación como una falla permanente puede acelerar el reemplazo y el desgaste del hardware, lo que aumenta los costos de mantenimiento.
Para abordar estos problemas, la industria ha introducido un enfoque mejorado: un marco de aislamiento de software que tiene en cuenta las aplicaciones. Este marco supervisa periódicamente indicadores del estado de las unidades, como la latencia y las IOPS. Cuando una unidad alcanza un umbral específico, se identifica como bloqueada o lenta, y se inicia una secuencia de acciones correctivas.
Si bien este enfoque representa un progreso, aún hay varias áreas que requieren mejoras:
- Tiempo de respuesta limitado : Las comprobaciones de coherencia de réplicas deben enumerar todos los fragmentos de la unidad. Desde el primer indicio de un fallo en la unidad hasta su aislamiento final, el proceso puede tardar al menos varios minutos, tiempo durante el cual la continuidad del negocio ya podría haberse visto seriamente afectada.
- Impacto generalizado : La inconsistencia en tan solo unos pocos fragmentos de una unidad lenta puede impedir que se aísle toda la unidad, lo que permite que continúe la interrupción del negocio.
- Identificación imprecisa : El sistema solo monitoriza el lado de la unidad, lo que aumenta la probabilidad de detecciones fallidas y falsos positivos.
PARTE 2. Aislamiento suave de unidades aSAN: Un nuevo modelo para el manejo de fallas de almacenamiento
El sistema de aislamiento por software de unidades Sangfor aSAN combina la detección de fallos con reconocimiento de la aplicación, el diagnóstico heurístico de fallos y la cuarentena precisa de componentes. Estas capacidades ayudan a evitar que un único componente dañado afecte a la continuidad del negocio.
1. Arquitectura de marco de aislamiento suave: dos capas protegen la estabilidad del almacenamiento.
El marco de aislamiento suave aSAN utiliza el volumen de almacenamiento virtual físico como su unidad de gestión y consta de dos partes:
- Plano de datos del cliente de almacenamiento : La detección de degradación de réplicas protege la disponibilidad de las réplicas, aísla temporalmente una réplica degradada en cuestión de segundos e informa rápidamente sobre la información de fallos para que las operaciones comerciales no se vean afectadas.
- Plano de control de aislamiento suave : El Centro de Fallos Distribuidos (DFC) recopila la información de fallos reportada por los complementos del Nodo de Fallos Distribuidos (DFN). Correlaciona y analiza los informes para diagnosticar fallos con precisión y reducir los falsos positivos. Si un fallo se recupera en un corto período, la réplica degradada se reactiva tras la recuperación, evitando así un funcionamiento prolongado con menos réplicas. Si un fallo no se recupera, el componente afectado se aísla por completo y la réplica fallida se reconstruye para proteger la fiabilidad de los datos.
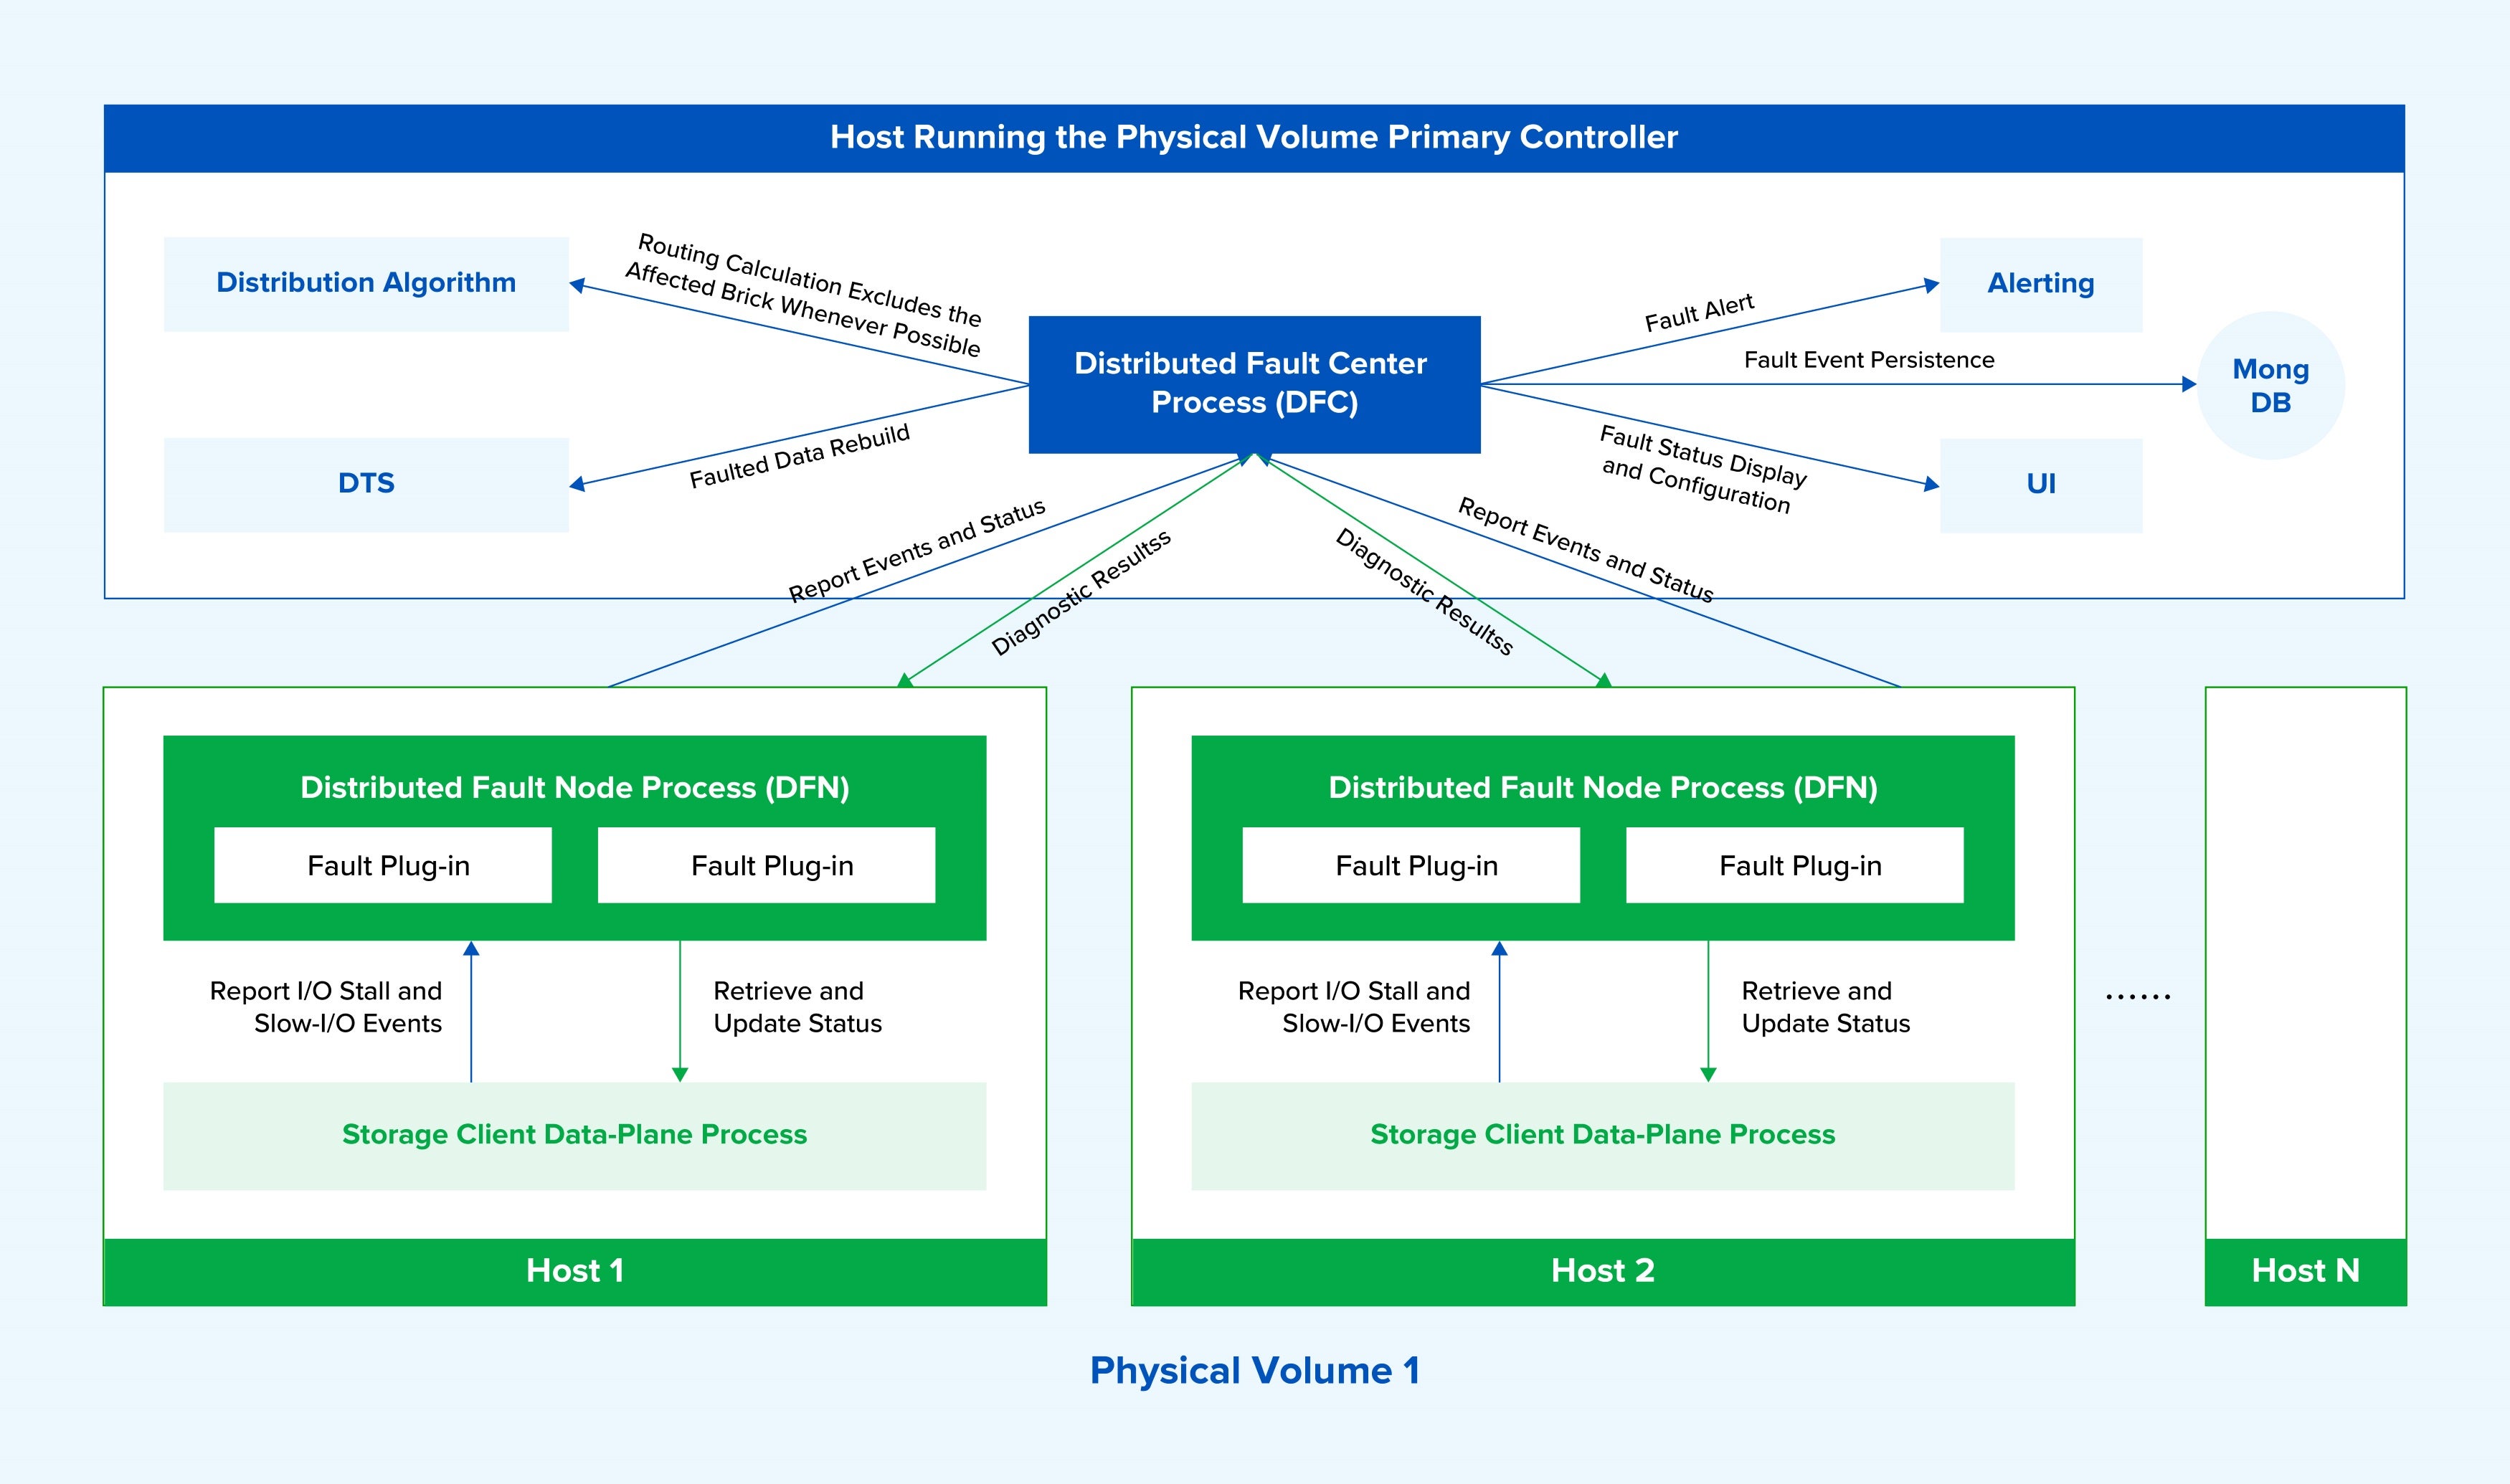
Figura 1. Arquitectura del marco de aislamiento suave de la unidad aSAN.
2. Un avance significativo en el aislamiento del software de la capa de aplicación sin necesidad de extraer físicamente la unidad.
En comparación con el método común de extracción física de unidades y los enfoques de aislamiento por software convencionales basados en aplicaciones, el marco Sangfor aSAN utiliza un mecanismo de aislamiento totalmente basado en software. Esto elimina las operaciones de extracción física de unidades, evita problemas de compatibilidad entre diferentes marcas de hardware y mejora la versatilidad y la estabilidad de la solución.
DFN también proporciona una interfaz de complemento para la gestión de fallos que integra el complemento del cliente del plano de datos y el complemento de detección de unidades bloqueadas o de baja velocidad. Esto amplía las capacidades de gestión de fallos y permite una corrección más precisa.
En resumen, la solución de aislamiento suave para unidades Sangfor aSAN demuestra tanto innovación arquitectónica como valor práctico en la capa de aplicación, ofreciendo un nuevo enfoque para la gestión de fallos en sistemas de almacenamiento distribuido. Los dos conjuntos de resultados comparativos que se presentan a continuación muestran el rendimiento práctico de la solución.
PARTE 3. Resultados de la validación: El rendimiento de aSAN lidera en todas las pruebas.
1. Comparación con VMware en pruebas de unidades bloqueadas y de velocidad lenta.
Sangfor llevó a cabo pruebas comparativas y validación práctica frente a VMware en cinco áreas: detección de E/S de disco bloqueadas, detección de E/S de disco lentas, detección de degradación del controlador RAID, reconstrucción después de una falla de disco bloqueado o lento y el efecto de dicha falla en las E/S empresariales.
| Elemento de prueba | aSAN (Sangfor) | vSAN (VMware) | Comparación |
| Detección de bloqueo de E/S de disco | En el caso de un disco duro (HDD), si una solicitud de E/S permanece bloqueada durante 13 segundos o su latencia supera los 500 ms, aSAN identifica la unidad como bloqueada. La unidad no se retira inmediatamente del servicio. | Si un dispositivo o controlador no responde a un comando de cancelación en un plazo de 120 segundos, el tiempo de espera predeterminado, vSAN marca el disco o grupo de discos como fuera de línea para evitar que el problema afecte a todo el clúster de vSAN. | aSAN proporciona una detección más rápida. Combinado con mecanismos de réplica y reconstrucción, aSAN ayuda a evitar que las fallas transitorias se clasifiquen erróneamente y permite una detección rápida y precisa. |
| Detección de E/S de disco lenta | En el caso de un disco duro, si la latencia de E/S supera los 70 ms durante 1 minuto en un período de 5 minutos, aSAN identifica la unidad como lenta. La unidad no se retira inmediatamente del servicio. | El criterio de degradación del controlador se activa cuando se producen 4 o más escrituras retardadas en un período de aproximadamente 6 horas y la latencia de escritura supera el umbral predefinido del controlador. Los umbrales son de 500 ms para escrituras en HDD, 50 ms para lecturas en SSD y 200 ms para escrituras en SSD. | • aSAN identifica las unidades lentas con mayor rapidez, utilizando criterios relativamente directos y sencillos. • vSAN utiliza criterios más complejos y un período de evaluación más prolongado. |
| Detección de degradación del controlador RAID | La capa de almacenamiento no realiza por separado la detección estadística de E/S lentas a nivel de hardware RAID. En la capa de software del sistema, la degradación del controlador RAID se detecta mediante el mismo mecanismo que la detección de unidades lentas. | Si la transmisión de E/S en tiempo real entre el controlador RAID y el host supera los 30 segundos, vSAN marca inmediatamente el dispositivo como degradado . | aSAN no depende de la monitorización ni de la corrección de problemas a nivel de hardware, lo que proporciona una mayor adaptabilidad del hardware y reduce la dependencia de proveedores de hardware específicos. |
| Reconstrucción tras un fallo de accionamiento lento o detenido | Se inicia una reconstrucción si la falla de la unidad persiste durante 5 minutos, o si la falla se repite y se recupera automáticamente 3 veces en 1 hora. Esto ayuda a evitar que una falla transitoria de la unidad active una reconstrucción. | Una vez que un disco se marca como degradado, vSAN comienza inmediatamente a reconstruirlo si hay suficiente capacidad disponible. | aSAN evalúa continuamente el estado de la falla, reduciendo significativamente la posibilidad de una reconstrucción innecesaria causada por una falla transitoria y mejorando la estabilidad general del sistema. |
| E/S de negocio durante un fallo de unidad de control bloqueada o lenta | Si la E/S agota el tiempo de espera después de 8 segundos o permanece lenta de forma continua, la unidad afectada se degrada y las operaciones de E/S empresariales dejan de enviarse a la réplica afectada. Sin embargo, si una partición individual tiene menos réplicas de las necesarias, aSAN puede seguir enviando datos a la réplica más lenta a nivel de partición, maximizando así la continuidad del negocio. |
• Una vez que un disco se marca como degradado , todas las operaciones de E/S se pausan mientras vSAN recalcula la accesibilidad de cada objeto replicado. • Si el objeto permanece en buen estado, es decir, si hay más del 50 % de los votos disponibles, se reanuda la E/S. La comprobación tarda aproximadamente entre 5 y 7 segundos. • Si una máquina virtual tiene un FTT = 0, solo podrá restaurarse después de que se recupere el disco original o se inserte un disco de reemplazo. |
• En escenarios de fallos multipunto, aSAN admite una degradación y un aislamiento más granulares a nivel de fragmento, lo que proporciona una remediación más precisa. • Una vez que vSAN marca un disco como degradado, el impacto es mayor. La comprobación de 5 a 7 segundos para todos los objetos replicados puede generar variabilidad en el rendimiento. Si no se cumplen los requisitos de réplica, las operaciones de entrada/salida a nivel de disco pueden quedar inaccesibles, lo que afecta a los servicios empresariales. |
Figura 2. Comparación con VMware en pruebas de unidades bloqueadas y de velocidad lenta.
La comparación con VMware vSAN en el manejo de unidades bloqueadas y lentas demostró que la solución de aislamiento suave de unidades Sangfor aSAN ofreció un rendimiento superior y un mecanismo de monitoreo más completo en el entorno probado.
2. Comparación con la solución de aislamiento suave de otro proveedor.
| Detalles de la solución | Sangfor | Comparación de proveedores | Comparación |
| Enfoque de remediación | Sangfor utiliza una estrategia de aislamiento multinivel basada en un análisis inteligente de E/S , lo que permite un aislamiento flexible y preciso al tiempo que minimiza el impacto en el sistema de almacenamiento general. | • Utiliza aislamiento a nivel de unidad. • Una vez que iostat detecta una anomalía, se aísla toda la unidad. |
Sangfor proporciona un aislamiento más preciso y una remediación más exacta. El sistema de monitorización fuera de banda del proveedor de comparación solo admite el aislamiento a nivel de unidad. Este método requiere menos esfuerzo de implementación, pero ofrece resultados menos eficaces y puede afectar al uso normal de los datos de la unidad. |
| Punto de detección | Sangfor utiliza un sistema de monitorización integrado para observar cada operación de E/S del cliente de almacenamiento en tiempo real y recopilar métricas de rendimiento más detalladas. | • Se basa en la monitorización fuera de banda. • Se centra principalmente en las métricas de rendimiento generales a nivel de disco. |
El sistema de monitorización integrado de Sangfor proporciona una mayor precisión, métricas más completas y un menor riesgo de clasificación errónea. El sistema de monitorización fuera de banda del proveedor de comparación es más sencillo y requiere menos esfuerzo de implementación, pero su granularidad de detección es más gruesa y su cobertura métrica es limitada, lo que dificulta la identificación precisa de anomalías. |
Figura 3. Comparación general con la solución de aislamiento flexible de otro proveedor.
La comparación arrojó las siguientes observaciones:
- Enfoque de remediación : Sangfor aSAN utiliza una estrategia de aislamiento multinivel basada en un análisis inteligente de E/S. La granularidad del aislamiento es mayor y la remediación es más precisa. La solución de comparación solo admite el aislamiento a nivel de unidad.
- Punto de detección : Sangfor aSAN utiliza monitorización integrada para observar cada operación de E/S del cliente de almacenamiento. Esto proporciona una granularidad más precisa, más dimensiones métricas y un menor riesgo de errores de clasificación. La solución de comparación utiliza monitorización fuera de banda mediante iostat. Si bien esto requiere menos trabajo de implementación, la detección resulta menos eficaz.
En resumen, la solución de aislamiento suave para unidades Sangfor aSAN combina una detección precisa y eficiente, políticas inteligentes y flexibles, y una amplia cobertura de escenarios. Estas capacidades brindan una sólida protección para la estabilidad de las operaciones comerciales y convierten a la solución en una opción confiable para los sistemas de almacenamiento empresariales.
PARTE 4. Implementación en producción
aSAN mejora la estabilidad del MES y reduce el esfuerzo operativo.
En nuestro Sistema de Ejecución de Manufactura (MES), las fallas en los variadores de frecuencia solían provocar una drástica disminución en el tiempo de respuesta. La planificación de la producción, la gestión de materiales y el control de calidad se veían afectados. Las pérdidas económicas mensuales resultantes alcanzaban cientos de miles de RMB, mientras que la resolución de problemas consumía una cantidad considerable de tiempo y esfuerzo operativos, interrumpiendo gravemente la producción normal.
Director Ejecutivo, Empresa de Fabricación de Nivel 1
Lea más historias de éxito de MES.
Tras la introducción de la solución de aislamiento suave de la unidad aSAN de Sangfor, el entorno MES logró las siguientes mejoras:
- Respuesta rápida: Un fallo de baja frecuencia en el disco duro se solucionó en 15 segundos, lo que permitió que los servicios empresariales volvieran a la normalidad rápidamente.
- Estabilidad sostenida: Se solucionaron varios incidentes de degradación de las unidades de disco durante seis meses, manteniendo la interrupción del servicio dentro de un período muy breve.
- Mayor eficiencia: El funcionamiento estable y eficiente del sistema MES permitió una programación de la producción más oportuna y precisa, mejoró significativamente la eficiencia de la gestión de materiales y facilitó una monitorización de la calidad eficaz en tiempo real, lo que contribuyó a una menor tasa de defectos en los productos.
Más allá del ahorro financiero directo, el equipo de operaciones de TI se liberó de la tediosa resolución de problemas de hardware, lo que les permitió dedicar recursos clave a iniciativas estratégicas de TI y a la experiencia del usuario, generando mejoras cuantificables en la productividad operativa general.
El aislamiento por software de las unidades de Sangfor aSAN establece un nuevo referente en la gestión proactiva de fallos en el almacenamiento distribuido. Respaldada por años de innovación propia en almacenamiento, Sangfor sigue desarrollando soluciones fiables de nivel empresarial que permiten a las organizaciones reemplazar la infraestructura heredada y desenvolverse con total confianza en entornos digitales complejos.
Obtén la demostración gratuita de Sangfor HCI
Preguntas frecuentes sobre Sangfor aSAN y unidades degradadas
Sangfor aSAN (también conocido como Sangfor Distributed Storage Fabric o Sangfor Server SAN) es una solución de almacenamiento distribuido definida por software que agrega discos locales de servidores x86 estándar en un grupo de almacenamiento unificado. Proporciona almacenamiento en bloques y servicios iSCSI a entornos virtualizados, lo que permite que las máquinas virtuales consuman almacenamiento de forma dinámica según las necesidades del negocio.
Una unidad degradada es aquella que permanece en línea pero experimenta un tiempo de respuesta de E/S anormalmente alto; por ejemplo, una latencia que aumenta de unos 10 ms a más de 100 ms. A diferencia de una unidad averiada, no deja de funcionar por completo, pero puede bloquear las escrituras de réplicas y ralentizar todo el clúster de almacenamiento.
Dado que la unidad sigue técnicamente en línea, la monitorización tradicional no permite determinar fácilmente si se trata de una falla real o simplemente de una ralentización temporal. Considerar cada ralentización como una falla permanente conlleva el riesgo de un reemplazo innecesario del hardware, mientras que ignorarla puede provocar una interrupción prolongada del negocio.
aSAN utiliza un marco de aislamiento suave de dos capas: un plano de datos del cliente de almacenamiento que detecta la degradación de la réplica y la aísla en cuestión de segundos, y un plano de control (complementos de Distributed Fault Center y Distributed Fault Node) que correlaciona los datos de fallos, reactiva las réplicas que se recuperan y aísla y reconstruye por completo las réplicas que no lo hacen.
vSAN marca un disco o grupo de discos como fuera de línea si no responde a un comando de cancelación dentro de un tiempo de espera predeterminado de 120 segundos, y pausa las operaciones de E/S para todos los objetos replicados durante 5 a 7 segundos durante el recálculo. aSAN detecta las operaciones de E/S bloqueadas en tan solo 13 segundos, utiliza el aislamiento a nivel de fragmento (en lugar de a nivel de disco completo) y puede continuar enviando operaciones de E/S a una réplica degradada cuando no se cumplen los requisitos de réplica.
No. aSAN utiliza un mecanismo de aislamiento totalmente basado en software en la capa de aplicación, lo que evita la extracción física de la unidad y los problemas de compatibilidad de hardware que esto puede ocasionar.
Se inicia una reconstrucción si el fallo persiste durante 5 minutos, o si se repite y se recupera automáticamente 3 veces en 1 hora; un diseño pensado para evitar que se activen reconstrucciones innecesarias debido a problemas transitorios.
En el entorno MES de una empresa manufacturera de primer nivel, aSAN resolvió un bloqueo de disco duro de baja frecuencia en 15 segundos y mantuvo la interrupción del servicio durante periodos muy cortos en múltiples eventos de unidades degradadas a lo largo de seis meses, lo que redujo el esfuerzo de resolución de problemas operativos.

