Ces deux dernières années, la planification de la mémoire en entreprise est devenue, discrètement, l'un des problèmes les plus complexes de la conception d'infrastructures. L'explosion des charges de travail liées à l'IA et la transition rapide de la production de semi-conducteurs vers la mémoire à large bande passante (HBM) ont fait grimper les prix de la DRAM pour serveurs de plus de 170 % sur un an . Les analystes du secteur prévoient que la pénurie et les prix élevés pourraient persister au moins jusqu'en 2027.
Pourtant, dans les environnements de production réels, l'utilisation de la mémoire révèle une tout autre réalité. Sur les plateformes virtualisées et cloud-native, les applications telles que les services JVM, les plateformes middleware, le big data et le machine learning ont tendance à réserver d'importants espaces mémoire en amont, alors qu'une partie seulement de cette mémoire est activement utilisée à un instant donné. Les pages restantes demeurent inactives pendant de longues périodes, consommant une capacité DRAM coûteuse sans contribuer directement aux performances.
C’est dans cet écart entre la mémoire allouée et la mémoire activement utilisée qu’apparaît une nouvelle approche d’optimisation.
La hiérarchisation de la mémoire repose sur une observation simple mais essentielle : toutes les pages mémoire ne se valent pas. Si les données fréquemment consultées (« chaudes ») sont stockées sur de la DRAM haute vitesse, tandis que les données rarement consultées (« froides ») sont placées de manière transparente sur un support plus performant et moins coûteux, la capacité mémoire globale peut être considérablement augmentée sans augmentation proportionnelle du coût du matériel.
Cependant, cette idée soulève immédiatement des questions cruciales pour les utilisateurs en entreprise :
- Est-il réellement possible d'étendre la mémoire au-delà de la DRAM physique sans déstabiliser les performances ?
- Comment le système identifie-t-il avec précision la mémoire chaude et froide, sans engendrer une surcharge importante du processeur ?
- Lorsque des données froides sont à nouveau accessibles, à quelle vitesse peuvent-elles revenir en mémoire haute vitesse et les applications le remarqueront-elles ?
Ces préoccupations sont légitimes. La mémoire constitue un élément critique des performances applicatives, et toute optimisation à ce niveau doit être à la fois précise et prévisible.
Cet article propose une analyse pratique et technique de la technologie de hiérarchisation de la mémoire de Sangfor. Nous expliquerons pourquoi la hiérarchisation de la mémoire est possible en toute sécurité, comment la DRAM et la NVMe collaborent au niveau système et quels principes de conception garantissent un impact minimal sur les performances. Enfin, et c'est tout aussi important, nous décrirons les cas où la hiérarchisation de la mémoire apporte une réelle valeur ajoutée et ceux où son utilisation requiert une grande prudence.
Notre objectif n'est pas de survendre un concept, mais de fournir un cadre transparent qui aide les architectes informatiques et les décideurs à déterminer si la hiérarchisation de la mémoire est adaptée à leurs environnements.
Pourquoi la mémoire peut-elle être « hiérarchisée » ?
Dans le domaine de l'optimisation de la mémoire en entreprise, les solutions traditionnelles telles que le gonflement de la mémoire, le partage transparent des pages, la compression de la mémoire et le surdimensionnement de la mémoire permettent d'améliorer l'utilisation de la mémoire physique et d'alléger, dans une certaine mesure, la pression exercée sur celle-ci. Toutefois, cette amélioration reste limitée. À mesure que les entreprises se développent, de nouvelles approches technologiques sont nécessaires pour accroître la capacité de mémoire disponible du système.
Dans les environnements cloud-native et virtualisés, les applications (comme les JVM, les services de cache et les intergiciels) réservent généralement une grande quantité d'espace mémoire. Cependant, la mémoire réellement « active », c'est-à-dire fréquemment lue et écrite, ne représente qu'environ 50 %, le reste demeurant dans un état « froid », peu sollicité.
C’est sur la base de cette caractéristique fondamentale qu’est née la solution de hiérarchisation de la mémoire. En divisant les données en mémoire en deux niveaux (données fréquemment utilisées et données rarement utilisées) selon leur fréquence d’accès, elle crée un pool de ressources mémoire unifié, combinant mémoire DRAM physique et SSD NVMe haute performance. Grâce à des algorithmes d’ordonnancement intelligents qui acheminent dynamiquement les données fréquemment utilisées et rarement utilisées, nous pouvons dépasser les limites de la mémoire physique sans impacter les performances critiques de l’entreprise.
Comment la DRAM et le NVMe collaborent-ils intelligemment ?
La solution de hiérarchisation de la mémoire de Sangfor repose sur une architecture de base composée d'un pool de mémoire multiniveau et d'un moteur d'ordonnancement intelligent, permettant une collaboration optimale entre la DRAM et les SSD NVMe. Elle assure ainsi une gestion hiérarchique de la mémoire et une planification dynamique avec une surcharge système extrêmement faible.
Conception d'architecture de pool de mémoire multiniveaux
- Niveau 0 (Niveau de données chaudes) : La DRAM haute vitesse gère les données « chaudes » à haute fréquence et sensibles à la latence, constituant ainsi la garantie principale des performances de l’entreprise.
- Niveau 1 (Niveau de données froides) : La technologie NVMe haute performance agit comme une couche d’extension de mémoire, transportant des données « froides » à basse fréquence pour permettre une extension élastique de la capacité de mémoire.
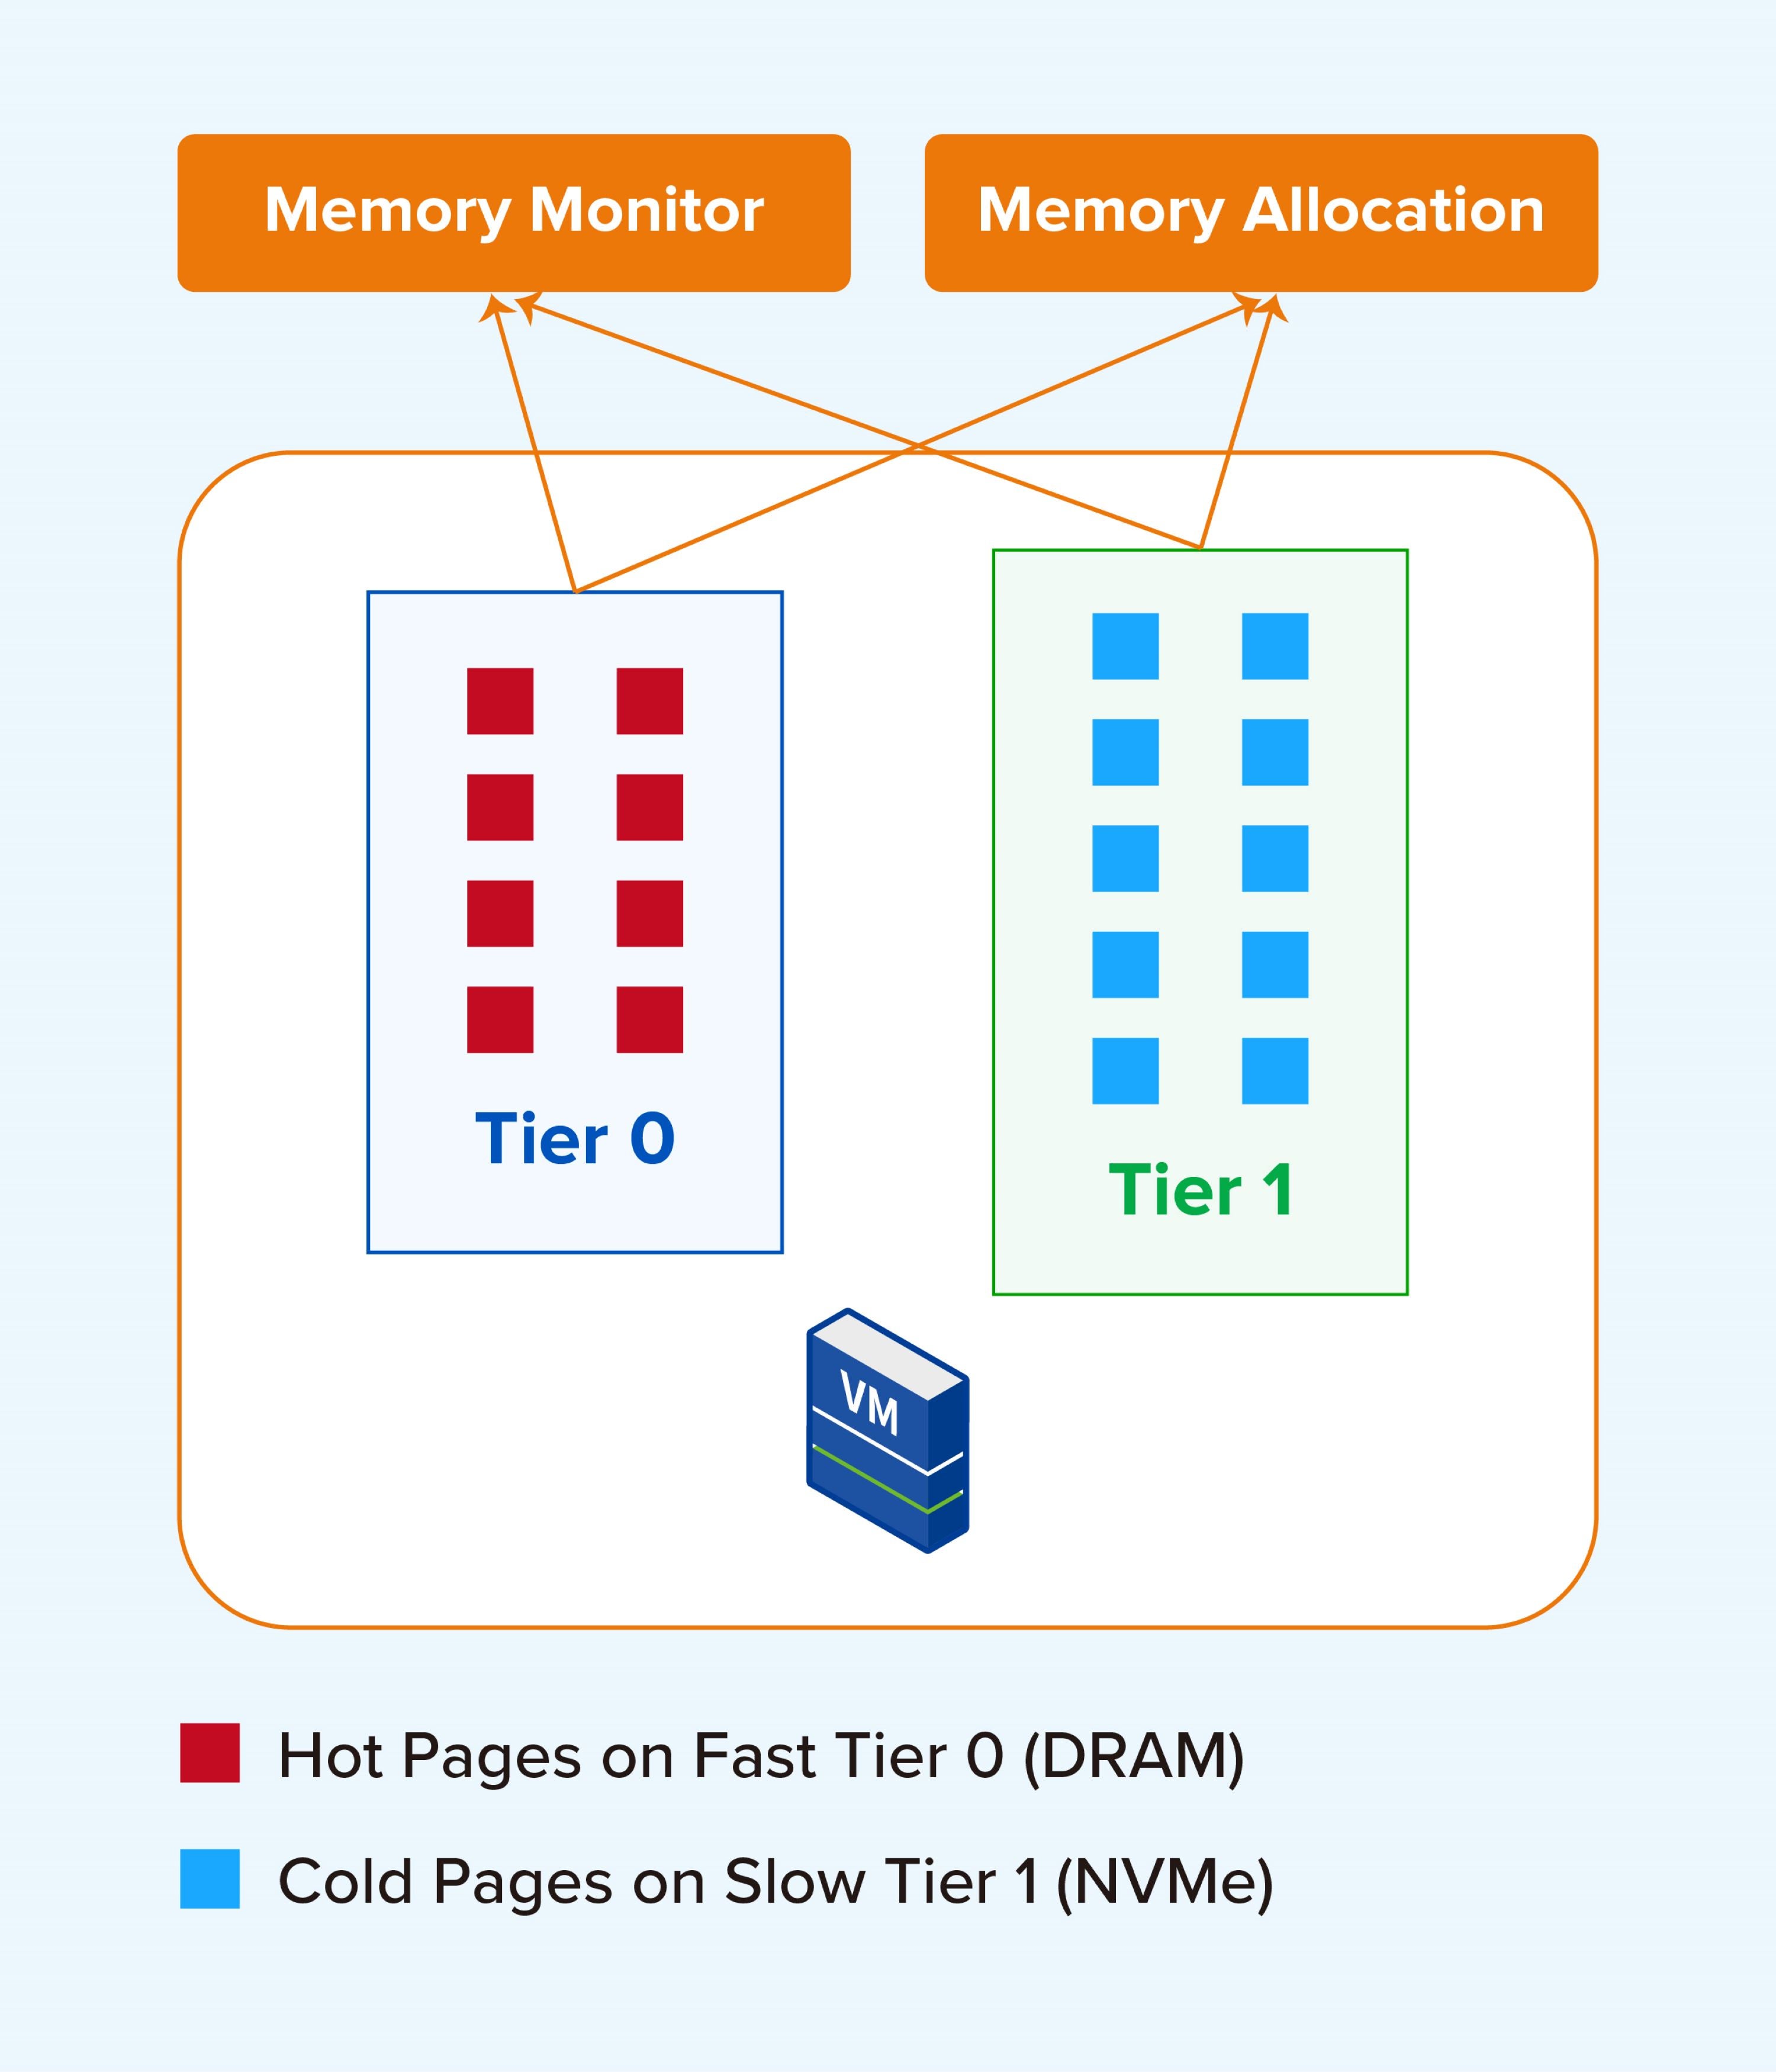
Conception d'architecture de pool de mémoire multiniveaux
Moteur de planification intelligent
Le moteur d'ordonnancement intelligent est au cœur de la solution de hiérarchisation de la mémoire. Grâce à la technologie de « partitionnement dynamique des régions + échantillonnage aléatoire clairsemé », il évalue la distribution globale de la mémoire chaude et froide avec une surcharge système minimale, permettant une identification précise et un ordonnancement dynamique.
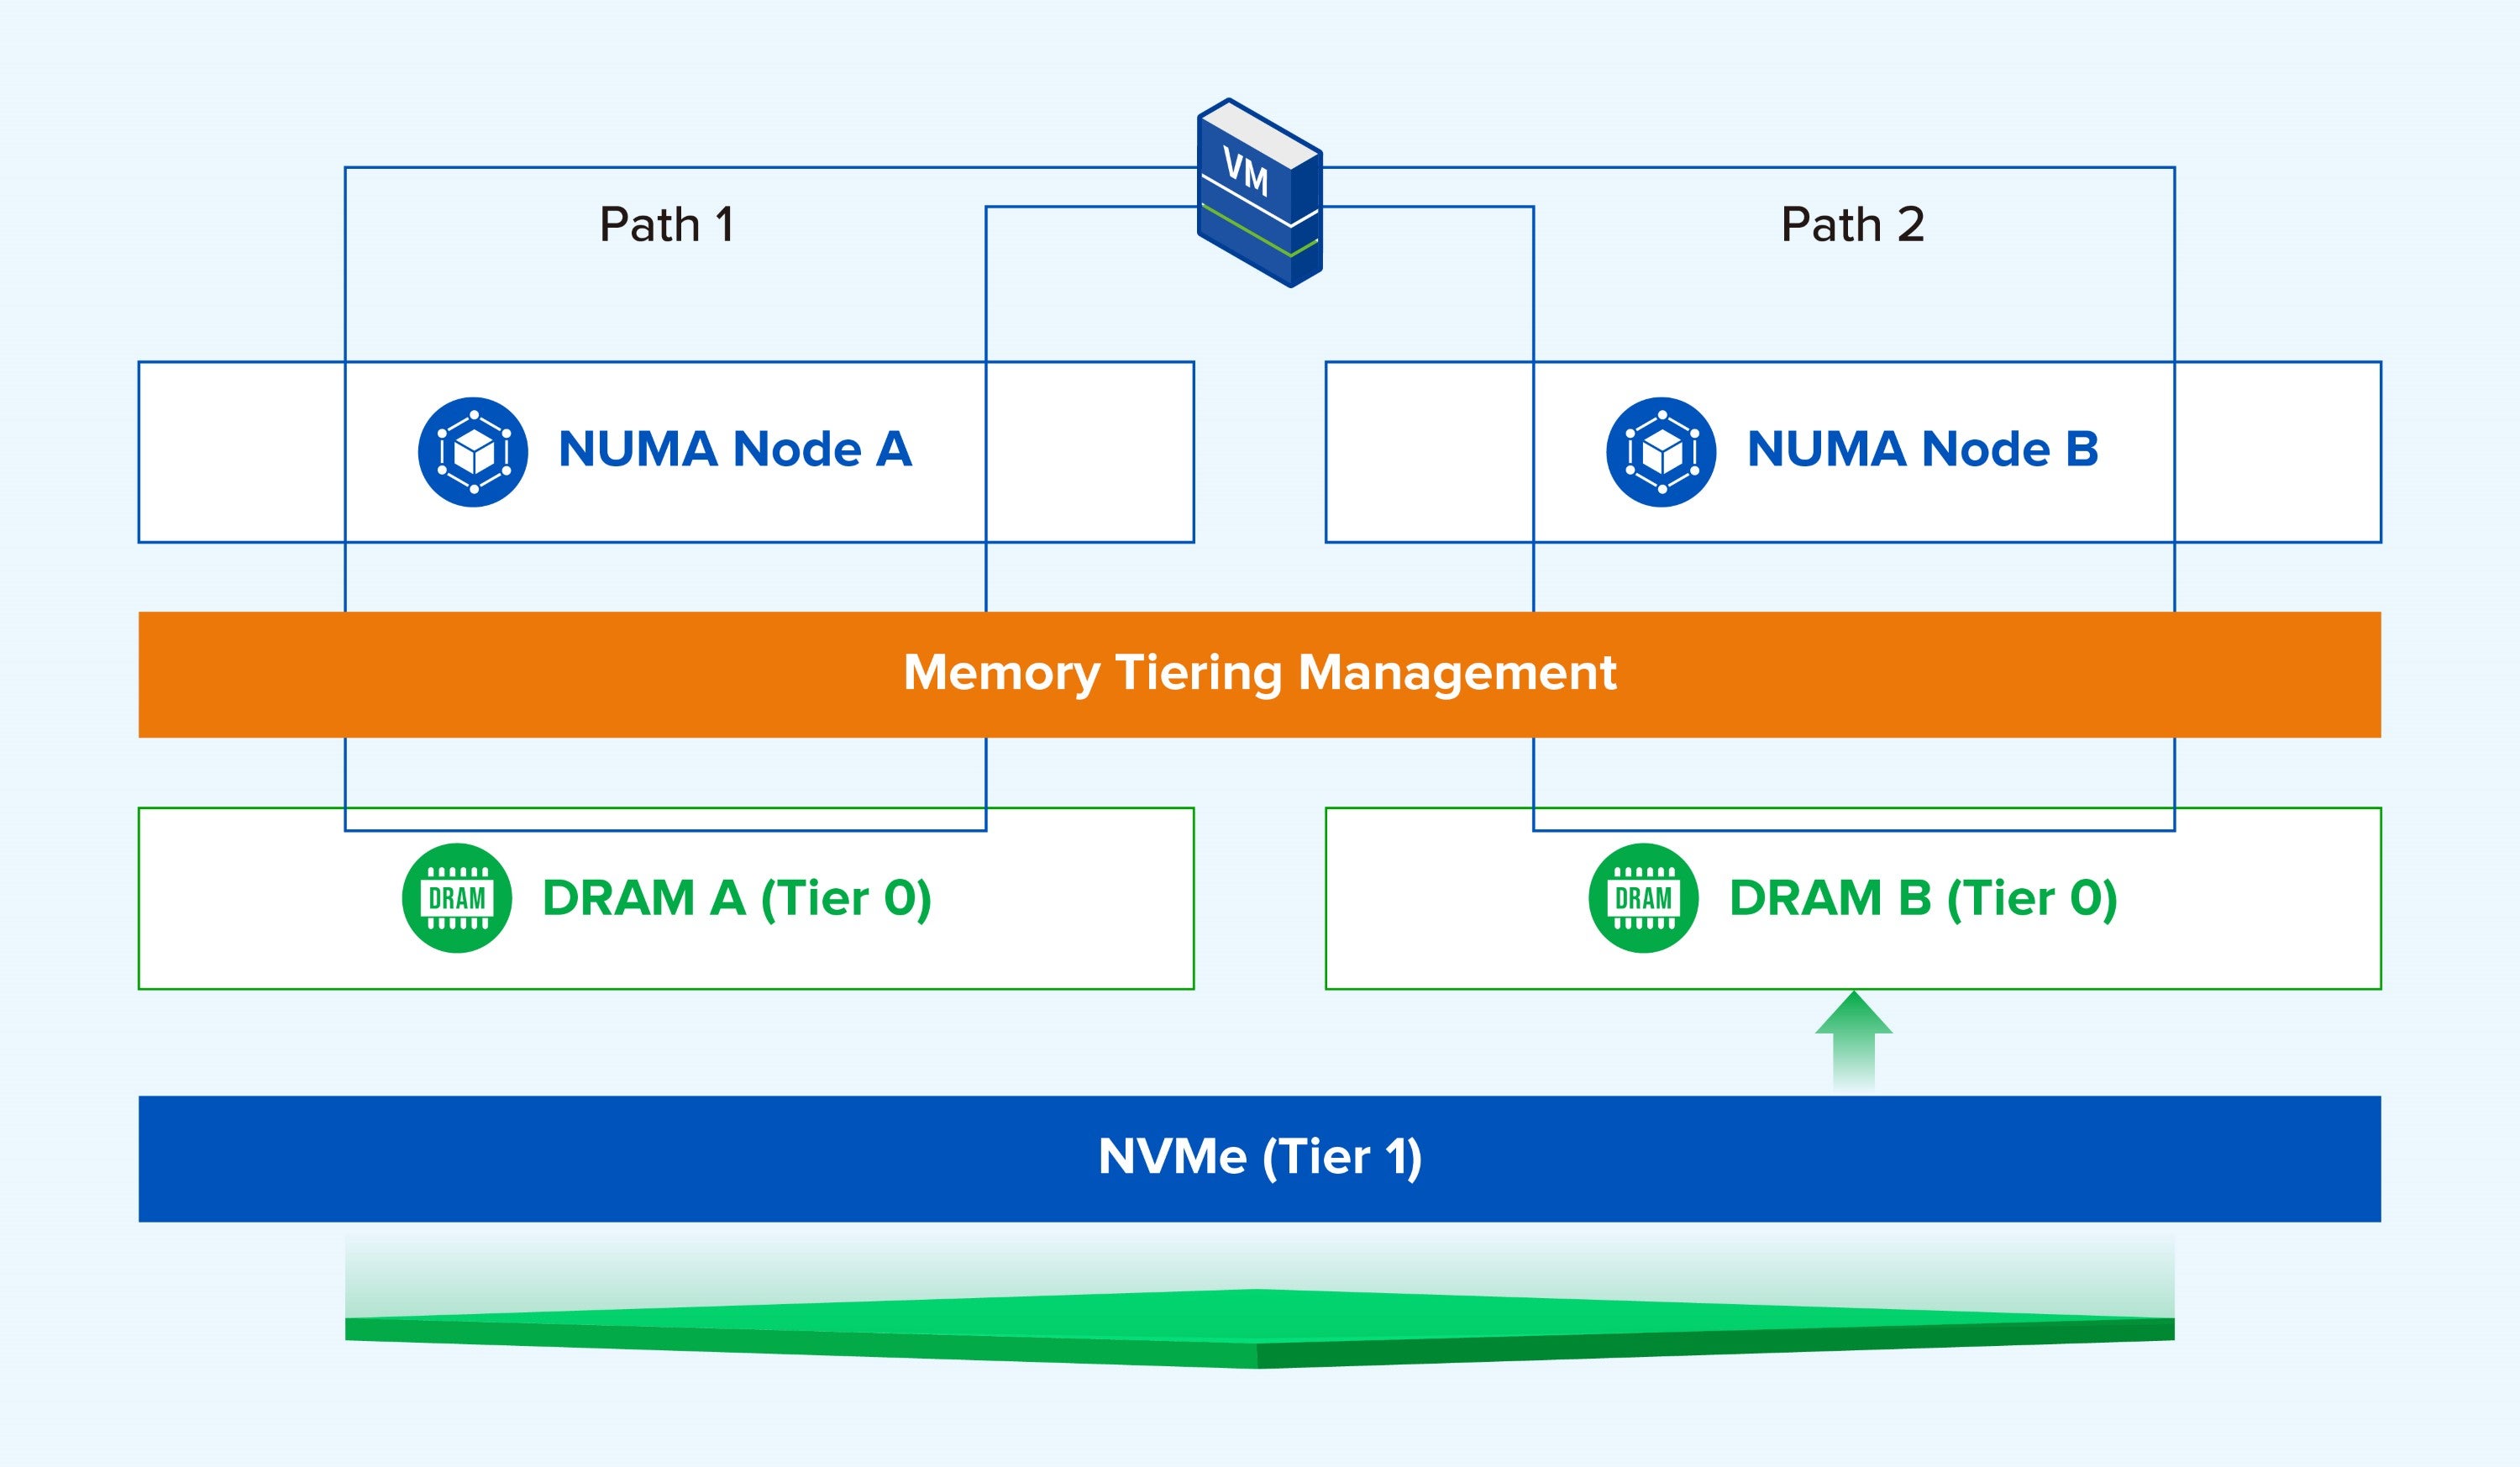
Chemin d'accès à la mémoire du processeur
Elle se compose de trois capacités fondamentales :
- Identification précise des données actives/réactives (ciblage précis) : grâce à une détection continue de l’activité, ce système cartographie en temps réel l’ensemble de données actives du système. Il distingue avec précision les données fréquemment utilisées qui doivent être conservées en mémoire DRAM haute vitesse et les pages inactives qui peuvent être déportées sans risque.
- Migration automatique de la mémoire (rapide) : exécute automatiquement la « rétrogradation des données froides » et la « promotion des données chaudes ». Cela libère de l’espace DRAM pour les applications principales tout en garantissant que les données réactivées retournent instantanément dans la couche chaude pour assurer des performances d’accès sans faille.
- Observabilité complète des liens (Visibilité optimale) : Surveille en continu la répartition de la charge mémoire, le comportement des migrations de pages et l’état d’accès au niveau froid afin d’offrir une capacité d’observabilité exhaustive. Ces données de surveillance aident les équipes d’exploitation à identifier les risques potentiels de performance et constituent une base solide pour l’optimisation des politiques et la planification des capacités.
Flux de données chauds et froids entre la DRAM et le NVMe
- DRAM → NVMe (Déclassement des pages inactives) : Lorsqu’une page inactive peu utilisée est identifiée, elle est ajoutée à la file d’attente de migration. Le système alloue alors de l’espace de stockage NVMe, écrit les données de la page depuis la DRAM vers le SSD NVMe et met à jour simultanément le mappage mémoire. Une fois la migration effectuée, l’espace DRAM correspondant est libéré, garantissant ainsi la priorité à la mémoire haute vitesse pour les données actives.
- NVMe → DRAM (Promotion des pages actives) : lorsqu’une application accède à nouveau à une page précédemment déportée vers la couche mémoire froide NVMe, le système capture la requête en temps réel et déclenche le processus de promotion. Il lit les données de la page cible depuis le NVMe vers la DRAM et met à jour la correspondance mémoire de manière synchrone, permettant ainsi aux données réactivées d’accéder à la couche mémoire haute vitesse et de rétablir les performances normales.
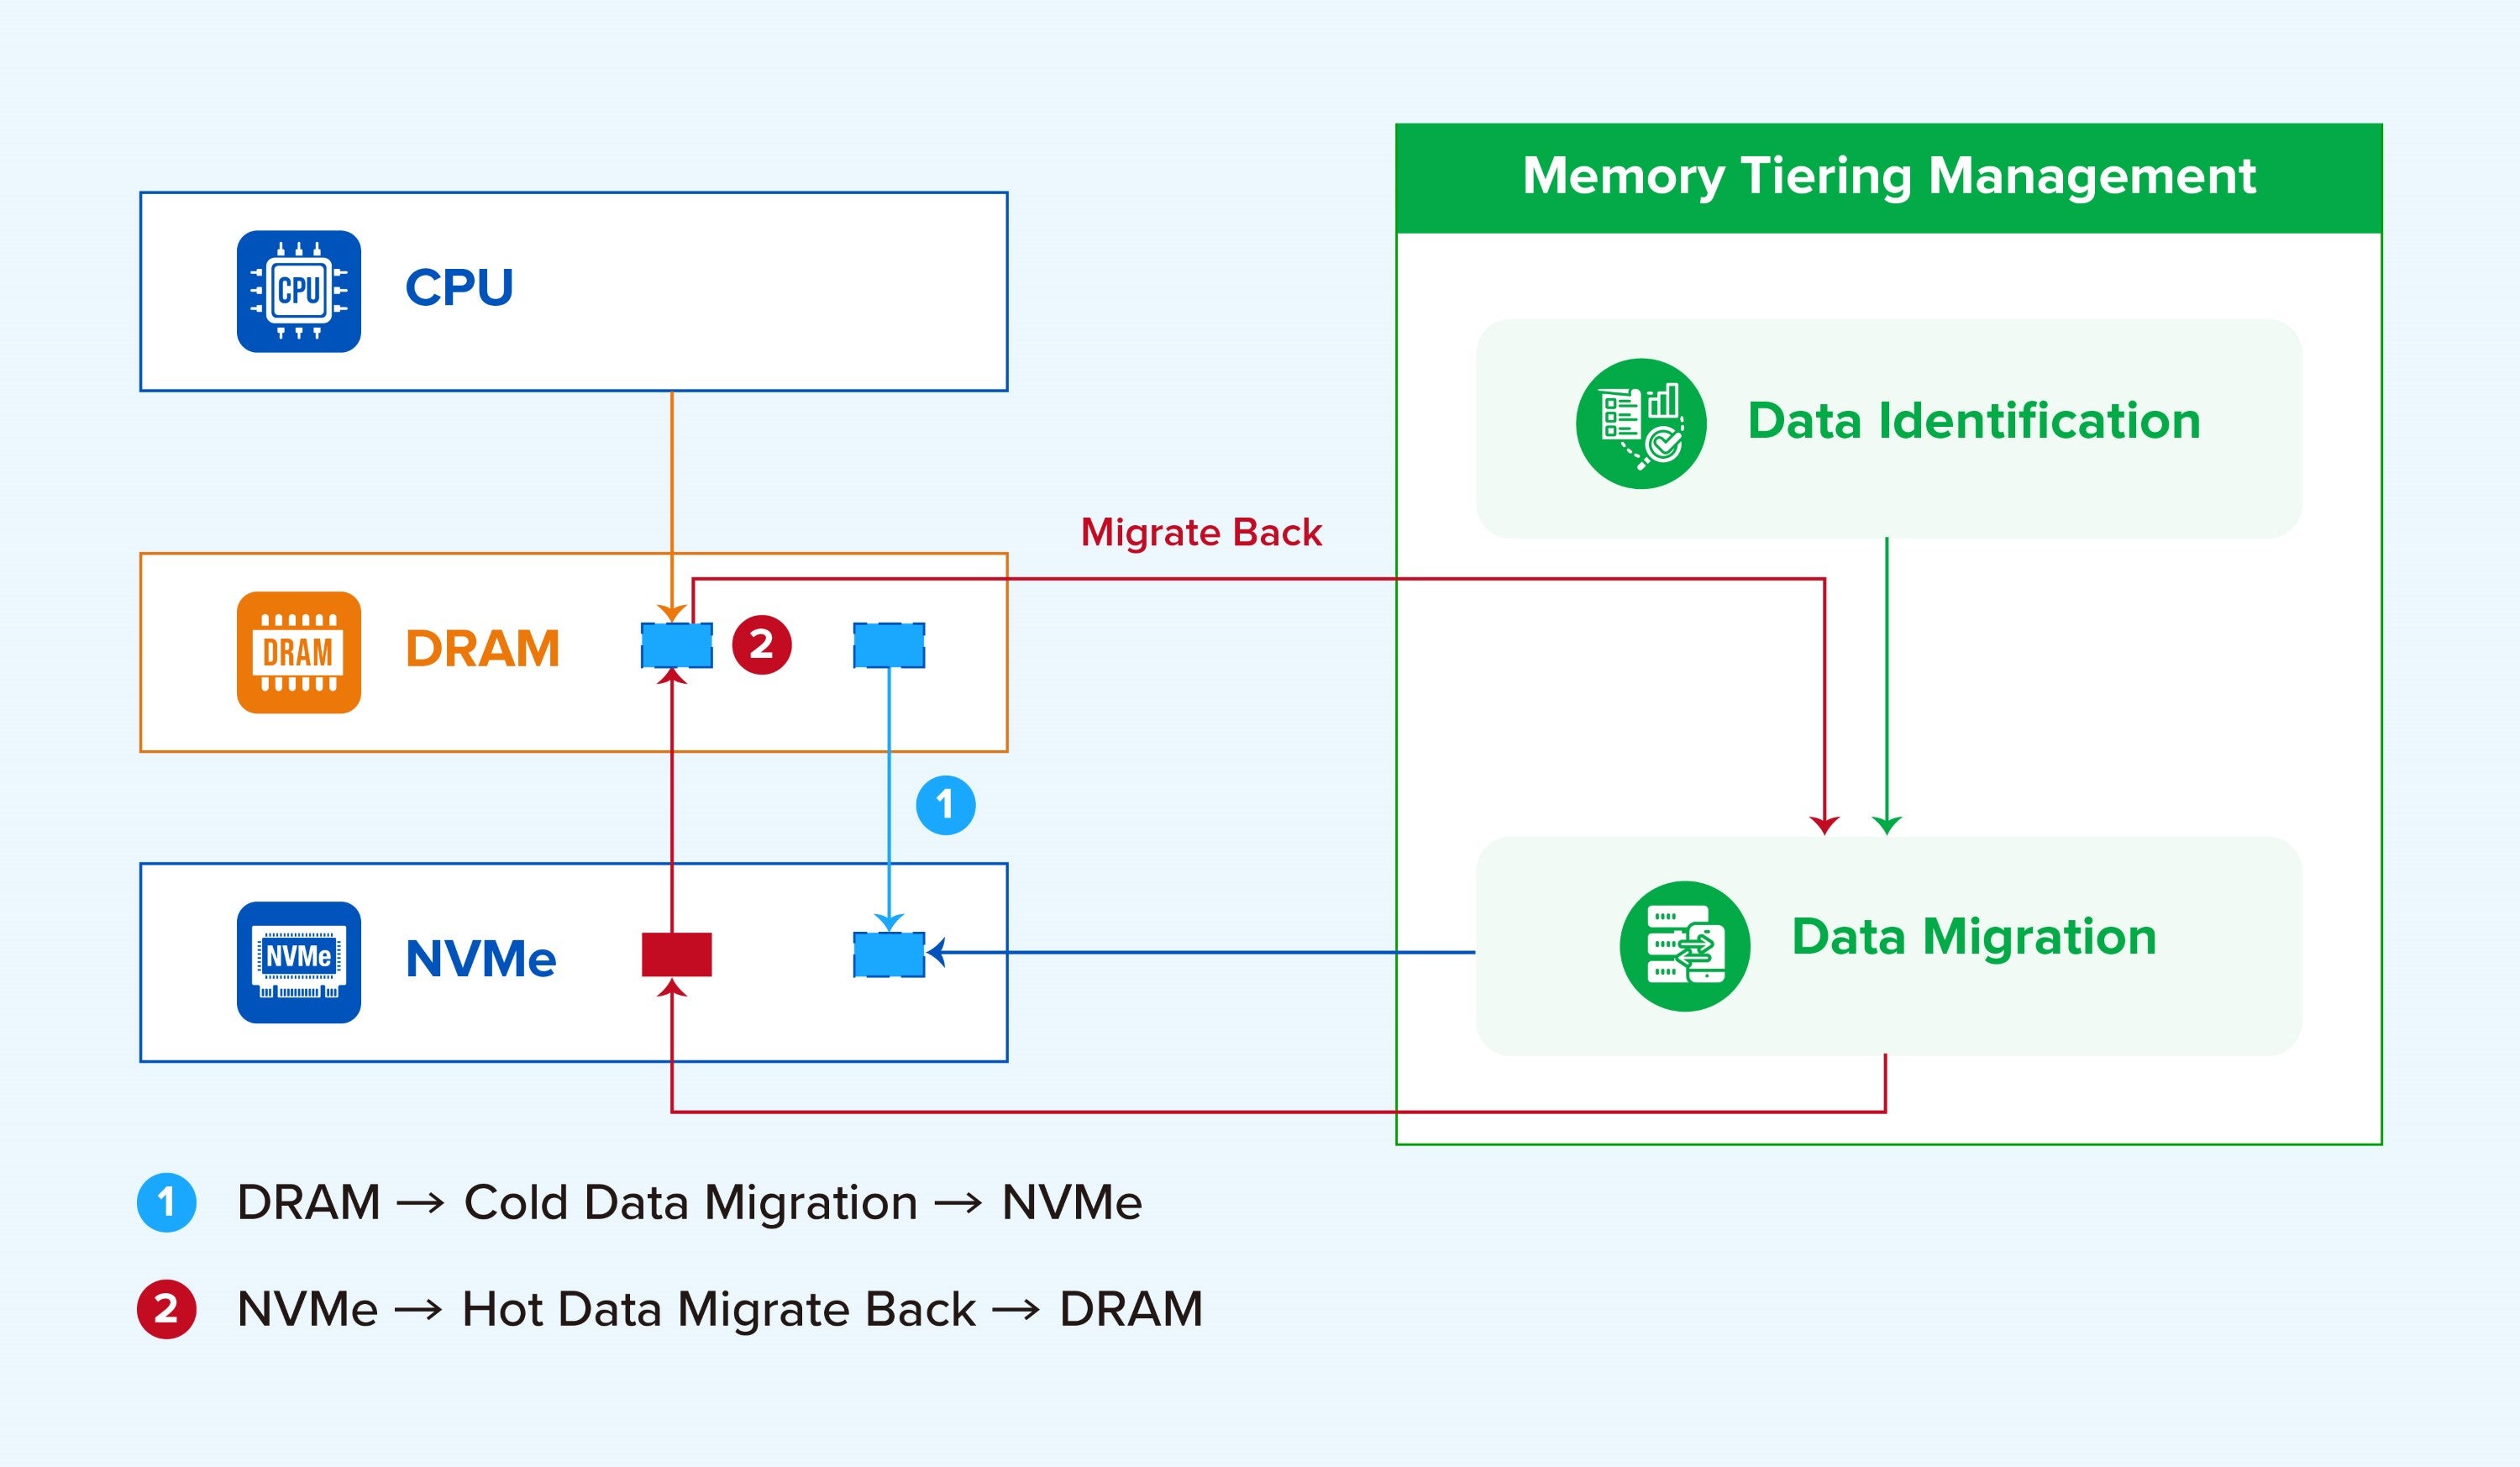
Mécanismes de migration de données
Comment le processeur accède-t-il à la mémoire hiérarchisée ? Minimisation des pertes de performance
Le défi technique du hiérarchisation de la mémoire réside dans la manière d'identifier rapidement les données, de planifier les pages et de permettre au processeur d'accéder rapidement à la mémoire une fois celle-ci hiérarchisée.
Dans cette architecture, le périphérique NVMe n'est pas utilisé comme stockage traditionnel, mais comme couche de mémoire froide sous la DRAM. Par conséquent, toutes les opérations d'accès à la mémoire du processeur sont finalement effectuées via la DRAM. Les chemins d'accès sont divisés en deux types :
- Chemin 1 : Accès à une page chaude : Le processeur initie l'accès → DRAM locale/distante → Renvoie les données.
- Chemin 2 : Échec de page froide : Le processeur initie l’accès → La page cible ne se trouve pas dans le niveau chaud de la DRAM → Le système récupère la page du NVMe vers la DRAM → Le processeur accède à la page.
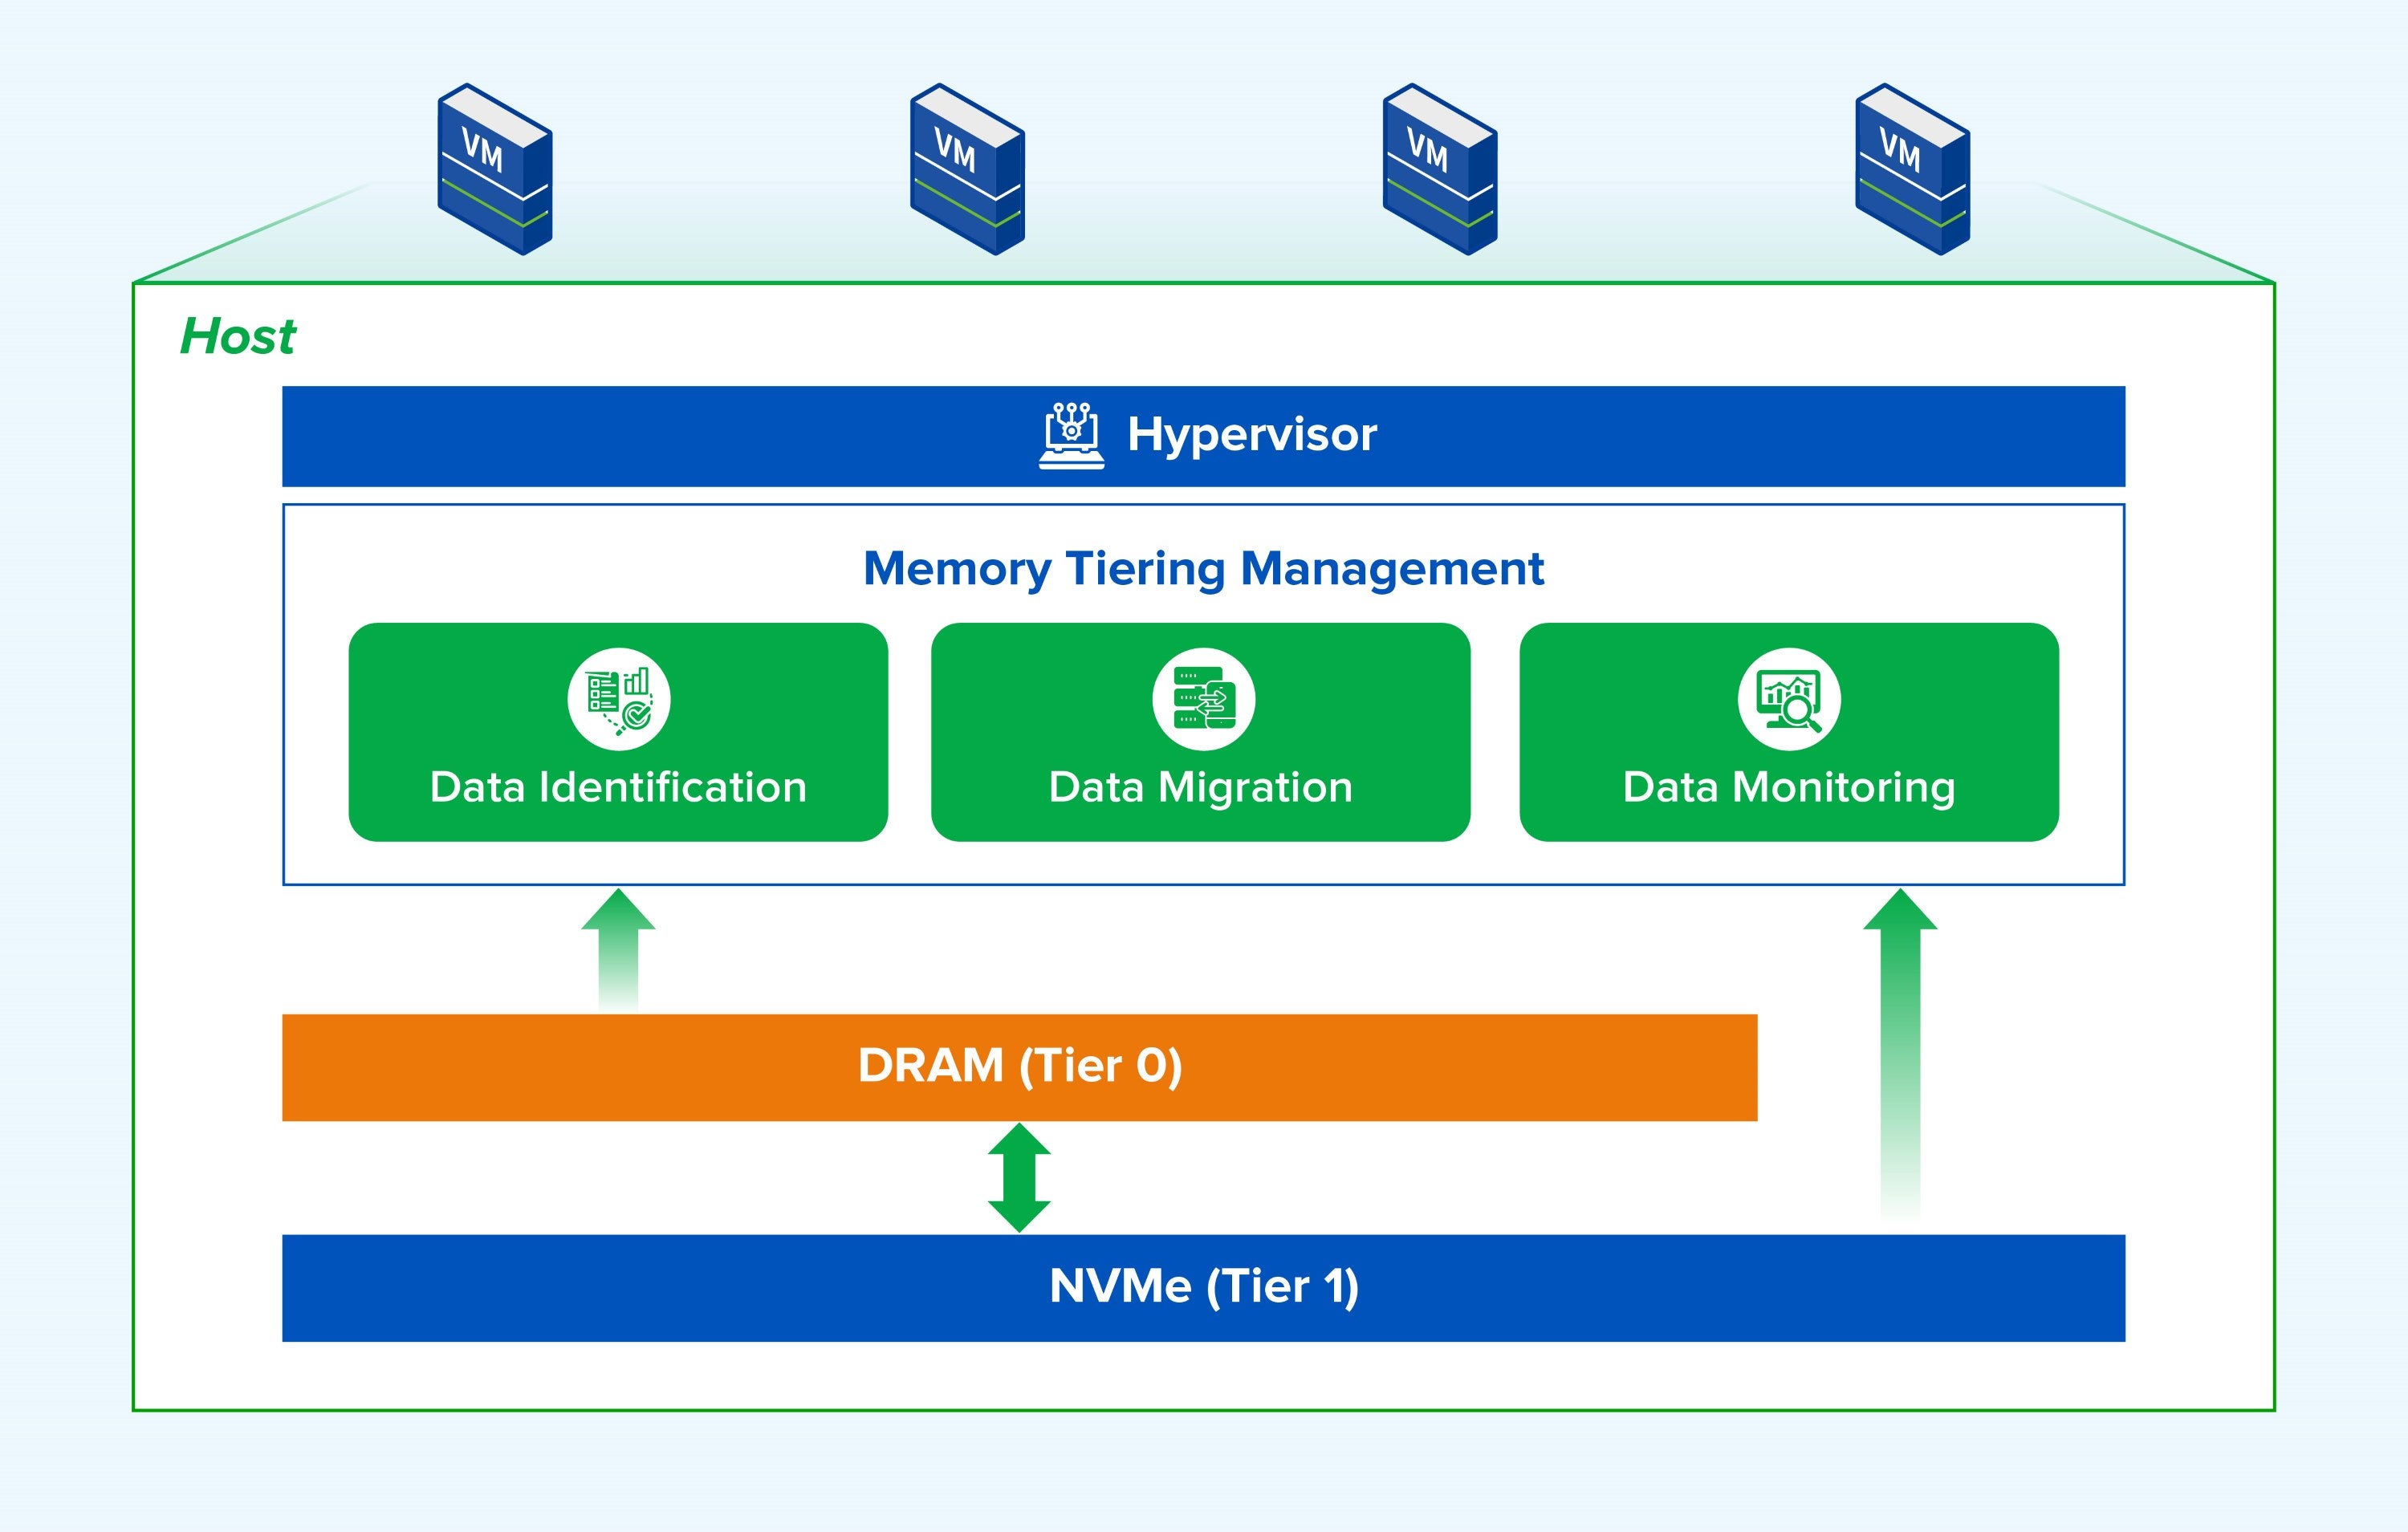
Architecture de hiérarchisation de la mémoire
Étant donné que le processeur du serveur n'accède pas directement au NVMe, comment minimiser l'impact sur les performances ? Pour répondre aux préoccupations relatives aux performances après la mise en place des niveaux de stockage, le système garantit la stabilité de l'activité grâce aux mécanismes suivants :
- Espace d'adressage unifié et accès transparent : cette fonctionnalité est totalement transparente pour les applications. L'accès à une page fréquemment utilisée en DRAM est direct et sans surcharge. L'accès à une page inactive en NVMe déclenche une interruption de défaut de page ; le noyau du système d'exploitation récupère rapidement les données du NVMe vers la DRAM, permettant ainsi au processeur d'y accéder. Le processeur fonctionne sans savoir si les données se trouvent en DRAM ou en NVMe : le noyau gère tout.
- Planification intelligente et ajustement dynamique des régions : le système ajuste dynamiquement la structure des régions en fonction des résultats de la surveillance afin d’optimiser la précision et la charge système. Lorsque des régions adjacentes présentent des schémas d’accès similaires, elles fusionnent automatiquement pour réduire le nombre d’objets surveillés. Si des zones à forte activité sont détectées au sein d’une région, celle-ci est divisée pour une identification plus précise. Ce mécanisme adaptatif garantit une granularité de surveillance optimale.
- La technologie NVMe à faible latence minimise la surcharge de transfert : le contrôleur NVMe lit et écrit directement dans la DRAM via PCIe sans intervention du processeur, consommant ainsi très peu de ressources d'interruption. Le matériel NVMe offre des avantages considérables : les latences se situent entre 10 et 100 µs (bien inférieures à celles des SSD/HDD SATA), et la bande passante PCIe 4.0 NVMe atteint jusqu'à 7 Go/s, soit environ un dixième de celle de la DRAM et bien supérieure à celle des solutions de stockage traditionnelles.
La hiérarchisation de la mémoire minimise l'impact sur les performances grâce à une gestion transparente pour les applications, une planification intelligente et la faible latence des disques NVMe, garantissant ainsi que le processeur fonctionne toujours sur des chemins à haut débit. Combinée à l'optimisation des chemins d'E/S du noyau et à l'héritage transparent de l'affinité locale NUMA , la capacité mémoire globale du serveur est doublée tandis que les pertes de performances réelles restent systématiquement inférieures à 10 %.
Démonstration en direct : La hiérarchisation de la mémoire en action
Doublement de la mémoire serveur avec seulement 6 % de perte de performance | Test de hiérarchisation de la mémoire HCI Sangfor
- Avant la hiérarchisation de la mémoire : 256 Go de mémoire physique, jusqu’à 73 % d’utilisation. TPS (transactions par seconde) de la base de données Oracle : plus de 15 000.
- Après hiérarchisation de la mémoire : 128 Go de mémoire physique + 128 Go de mémoire hiérarchisée, soit une capacité de mémoire équivalente à 256 Go. Le nombre moyen de transactions par seconde (TPS) d’Oracle Database est resté stable autour de 14 000, avec une baisse de performance maîtrisée en deçà de 10 %.
Guide pratique de mise en œuvre : Scénarios applicables et recommandations de planification
Scénarios applicables
- Scénarios idéaux : La hiérarchisation de la mémoire est adaptée aux cas d’utilisation nécessitant une grande capacité de mémoire totale, avec des profils d’accès aux données chauds/froids distincts, une sensibilité aux coûts et une tolérance à une latence légère et occasionnelle. On peut citer comme exemples les environnements de développement et de test, les services de mise en cache non essentiels et les clusters de microservices à charge faible à moyenne.
- Non recommandé pour : Ce produit n’est pas adapté aux applications critiques extrêmement sensibles à la latence d’accès, présentant des schémas d’accès denses et uniformes, et exigeant une gigue minimale et une stabilité élevée. Citons par exemple les systèmes de trading en temps réel, les bases de données de trading haute fréquence, les bases de données en mémoire et les bases de données OLTP haute fréquence.
La solution de hiérarchisation de la mémoire de Sangfor permet d'activer ou de désactiver cette fonctionnalité au niveau de la machine virtuelle (VM) . Les utilisateurs peuvent ainsi activer ou désactiver la hiérarchisation de la mémoire pour des VM spécifiques en fonction du type d'activité et des caractéristiques de l'entreprise, ce qui leur permet un contrôle précis des performances et des coûts. Si les prix du matériel baissent, les utilisateurs peuvent augmenter leur capacité en ligne en toute transparence, sans dépendance vis-à-vis d'un fournisseur ni souci de mises à niveau futures.
Meilleures pratiques pour la planification de la hiérarchisation de la mémoire
Pour concilier l'extension de la mémoire et la stabilité des performances, le ratio recommandé entre la DRAM et la mémoire hiérarchisée est de 1:1 . Ce ratio répond aux besoins de la plupart des entreprises, doublant efficacement la capacité de mémoire tout en maintenant les fluctuations de performances dans une plage acceptable.
Dans un contexte de prix élevés pour le matériel de mémoire, la hiérarchisation de la mémoire n'est plus seulement un outil d'optimisation des performances ; c'est une stratégie de maîtrise des coûts extrêmement efficace. Les utilisateurs peuvent ainsi réduire considérablement leurs budgets d'acquisition de matériel de mémoire sans impacter les performances de leurs activités principales, optimisant la réutilisation de leurs actifs informatiques existants et relevant sereinement le double défi de la croissance de la puissance de calcul et de la gestion des coûts informatiques.