In den letzten zwei Jahren hat sich die Speicherplanung für Unternehmen still und leise zu einem der größten Probleme im Infrastrukturdesign entwickelt. Die explosionsartige Zunahme von KI-Workloads und die rasante Verlagerung der Halbleiterkapazitäten hin zu High Bandwidth Memory (HBM) haben die Preise für Server-DRAM im Jahresvergleich um mehr als 170 % in die Höhe getrieben. Branchenanalysten warnen, dass die angespannte Versorgungslage und die hohen Preise mindestens bis 2027 anhalten könnten.
In realen Produktionsumgebungen sieht die Speichernutzung jedoch anders aus. Auf virtualisierten und Cloud-nativen Plattformen reservieren Anwendungen wie JVM-basierte Dienste, Middleware-Plattformen, Big Data und Machine Learning häufig große Speicherbereiche im Voraus, obwohl nur ein Teil davon aktiv genutzt wird. Die restlichen Speicherseiten bleiben lange ungenutzt und belegen teuren DRAM, ohne die Leistung direkt zu verbessern.
Diese Diskrepanz zwischen zugewiesenem und tatsächlich genutztem Speicher ist der Ansatzpunkt für eine neue Optimierung.
Das Memory-Tiering basiert auf einer einfachen, aber wichtigen Erkenntnis: Nicht alle Speicherseiten sind gleichwertig. Wenn häufig abgerufene „heiße“ Daten auf schnellem DRAM verbleiben, während selten abgerufene „kalte“ Daten transparent auf einem kostengünstigeren, aber leistungsstarken Speichermedium abgelegt werden, lässt sich die Gesamtspeicherkapazität deutlich erhöhen, ohne die Hardwarekosten proportional zu steigern.
Diese Idee wirft jedoch sofort kritische Fragen für Unternehmenskunden auf:
- Lässt sich der Speicher tatsächlich über den physischen DRAM hinaus erweitern, ohne die Leistung zu beeinträchtigen?
- Wie kann das System häufig und selten genutzten Speicher präzise identifizieren, ohne dabei eine hohe CPU-Auslastung zu verursachen?
- Wenn auf ältere Daten erneut zugegriffen wird, wie schnell können diese wieder in den Hochgeschwindigkeitsspeicher gelangen und werden die Anwendungen dies bemerken?
Diese Bedenken sind berechtigt. Der Speicher liegt auf dem kritischen Pfad der Anwendungsleistung, und jede Optimierung auf dieser Ebene muss sowohl präzise als auch vorhersagbar sein.
In diesem Artikel werfen wir einen praktischen und technischen Blick auf die Memory-Tiering-Technologie von Sangfor. Wir erläutern, warum Speicher sicher gestaffelt werden kann, wie DRAM und NVMe auf Systemebene zusammenarbeiten und welche Designprinzipien sicherstellen, dass die Leistungseinbußen streng kontrolliert werden. Ebenso wichtig ist es, die Szenarien aufzuzeigen, in denen Memory-Tiering klare Vorteile bietet und in denen Vorsicht geboten ist.
Unser Ziel ist es nicht, ein Konzept übermäßig zu bewerben, sondern einen transparenten Rahmen bereitzustellen, der IT-Architekten und Entscheidungsträgern hilft, zu beurteilen, ob Memory Tiering die richtige Lösung für ihre Umgebungen ist.
Warum kann der Speicher „gestaffelt“ sein?
Im Bereich der Speicheroptimierung in Unternehmen können traditionelle Lösungen wie Memory Ballooning, transparentes Seitenteilen, Speicherkomprimierung und Memory Overcommitment die physische Speicherauslastung verbessern und den Druck bis zu einem gewissen Grad verringern. Diese Verbesserung ist jedoch begrenzt. Mit dem Wachstum von Unternehmen sind neue technologische Ansätze erforderlich, um die verfügbare Speicherkapazität des Systems zu erweitern.
In Cloud-nativen und virtualisierten Umgebungen reservieren Anwendungen (wie JVMs, Caching-Dienste und Middleware) typischerweise viel Speicherplatz. Der tatsächlich „aktive“ Speicher, auf den häufig zugegriffen wird, macht jedoch nur etwa 50 % aus, während der Rest in einem selten genutzten, „kalten“ Zustand verbleibt.
Auf dieser Kernfunktionalität basiert die Lösung für Memory Tiering. Durch die Aufteilung der Speicherdaten in eine Hot-Data- und eine Cold-Data-Ebene anhand der Zugriffshäufigkeit entsteht ein einheitlicher Speicherressourcenpool aus physischem DRAM und leistungsstarken NVMe-SSDs. Intelligente Scheduling-Algorithmen leiten die Hot- und Cold-Data-Ebenen dynamisch weiter und ermöglichen so die Überwindung der Grenzen des physischen Speichers, ohne die Kernleistung zu beeinträchtigen.
Wie arbeiten DRAM und NVMe intelligent zusammen?
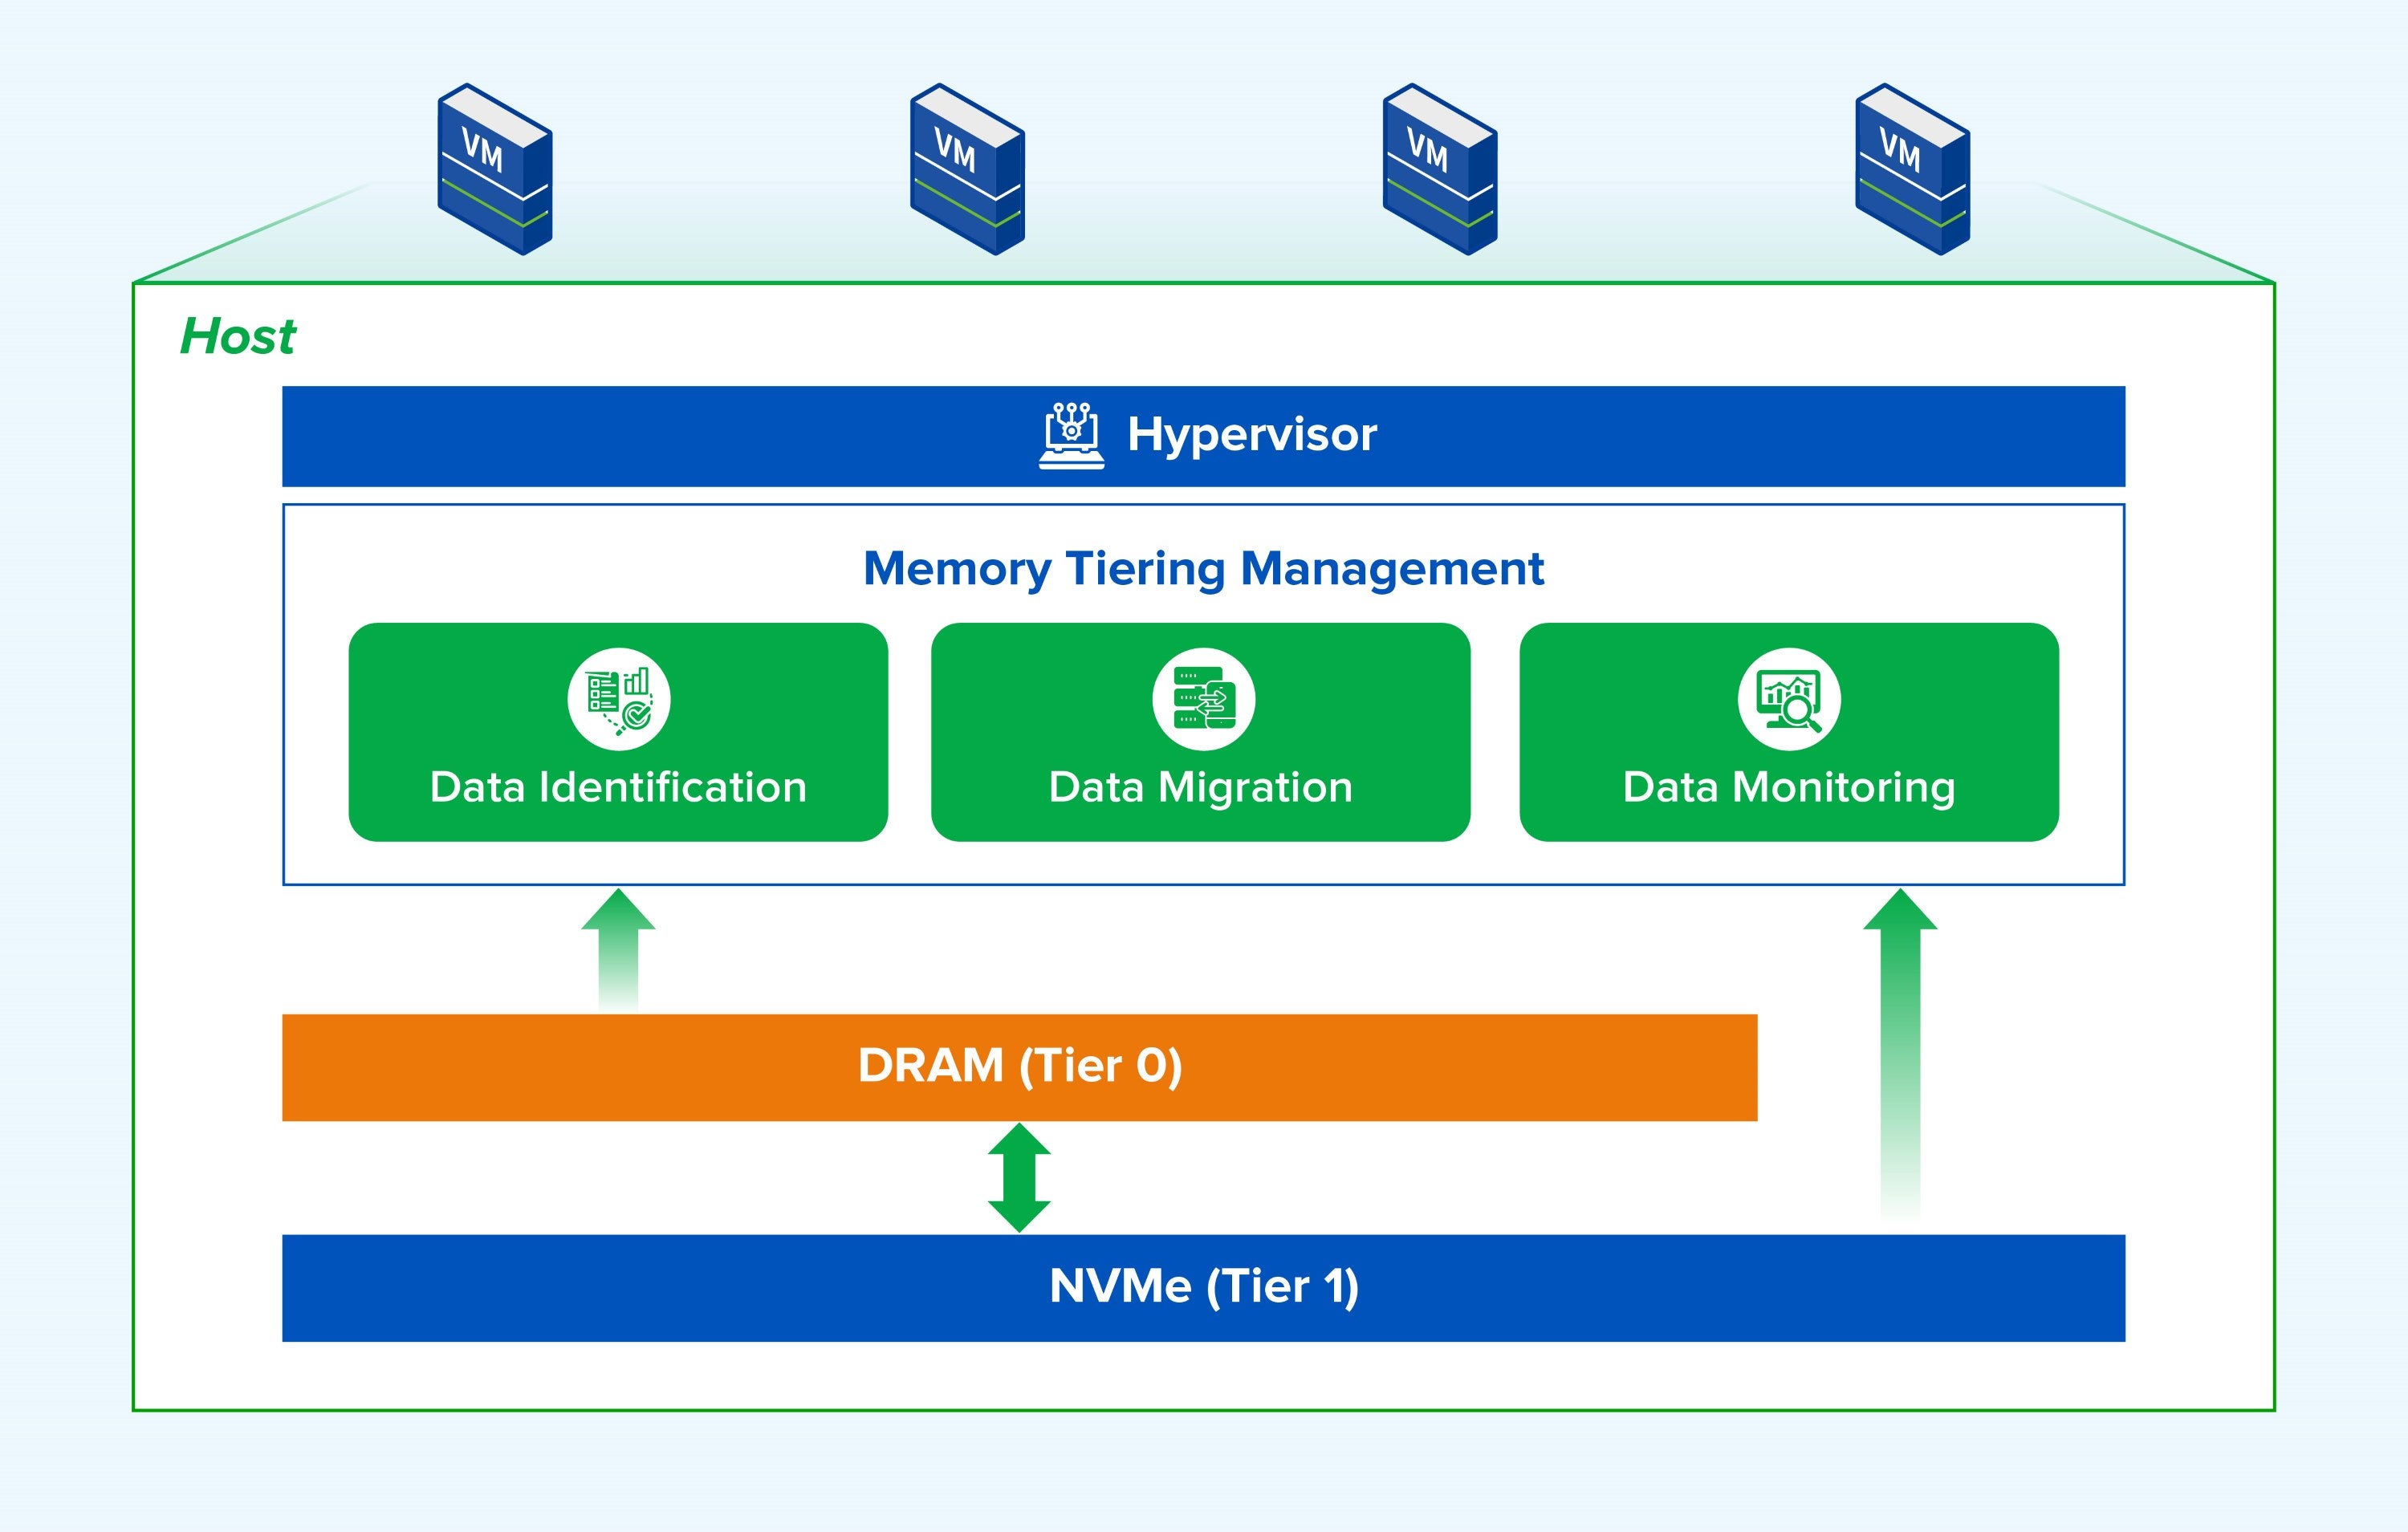
Die Memory-Tiering-Lösung von Sangfor basiert auf einer Kernarchitektur aus „Multi-Tier Memory Pool + Intelligent Scheduling Engine“ , um eine hocheffiziente Zusammenarbeit zwischen DRAM und NVMe-SSDs zu erreichen. Dies ermöglicht hierarchisches Speichermanagement und dynamisches Scheduling bei extrem geringem Systemaufwand.
Architekturentwurf für mehrstufige Speicherpools
- Tier 0 (Hot Data Tier): Hochgeschwindigkeits-DRAM verarbeitet hochfrequente, latenzempfindliche „Hot“-Daten und dient als zentrale Garantie für die Geschäftsleistung.
- Tier 1 (Cold Data Tier): Hochleistungsfähige NVMe-Speicher fungieren als Speichererweiterungsschicht und transportieren niederfrequente „kalte“ Daten, um eine elastische Erweiterung der Speicherkapazität zu erreichen.
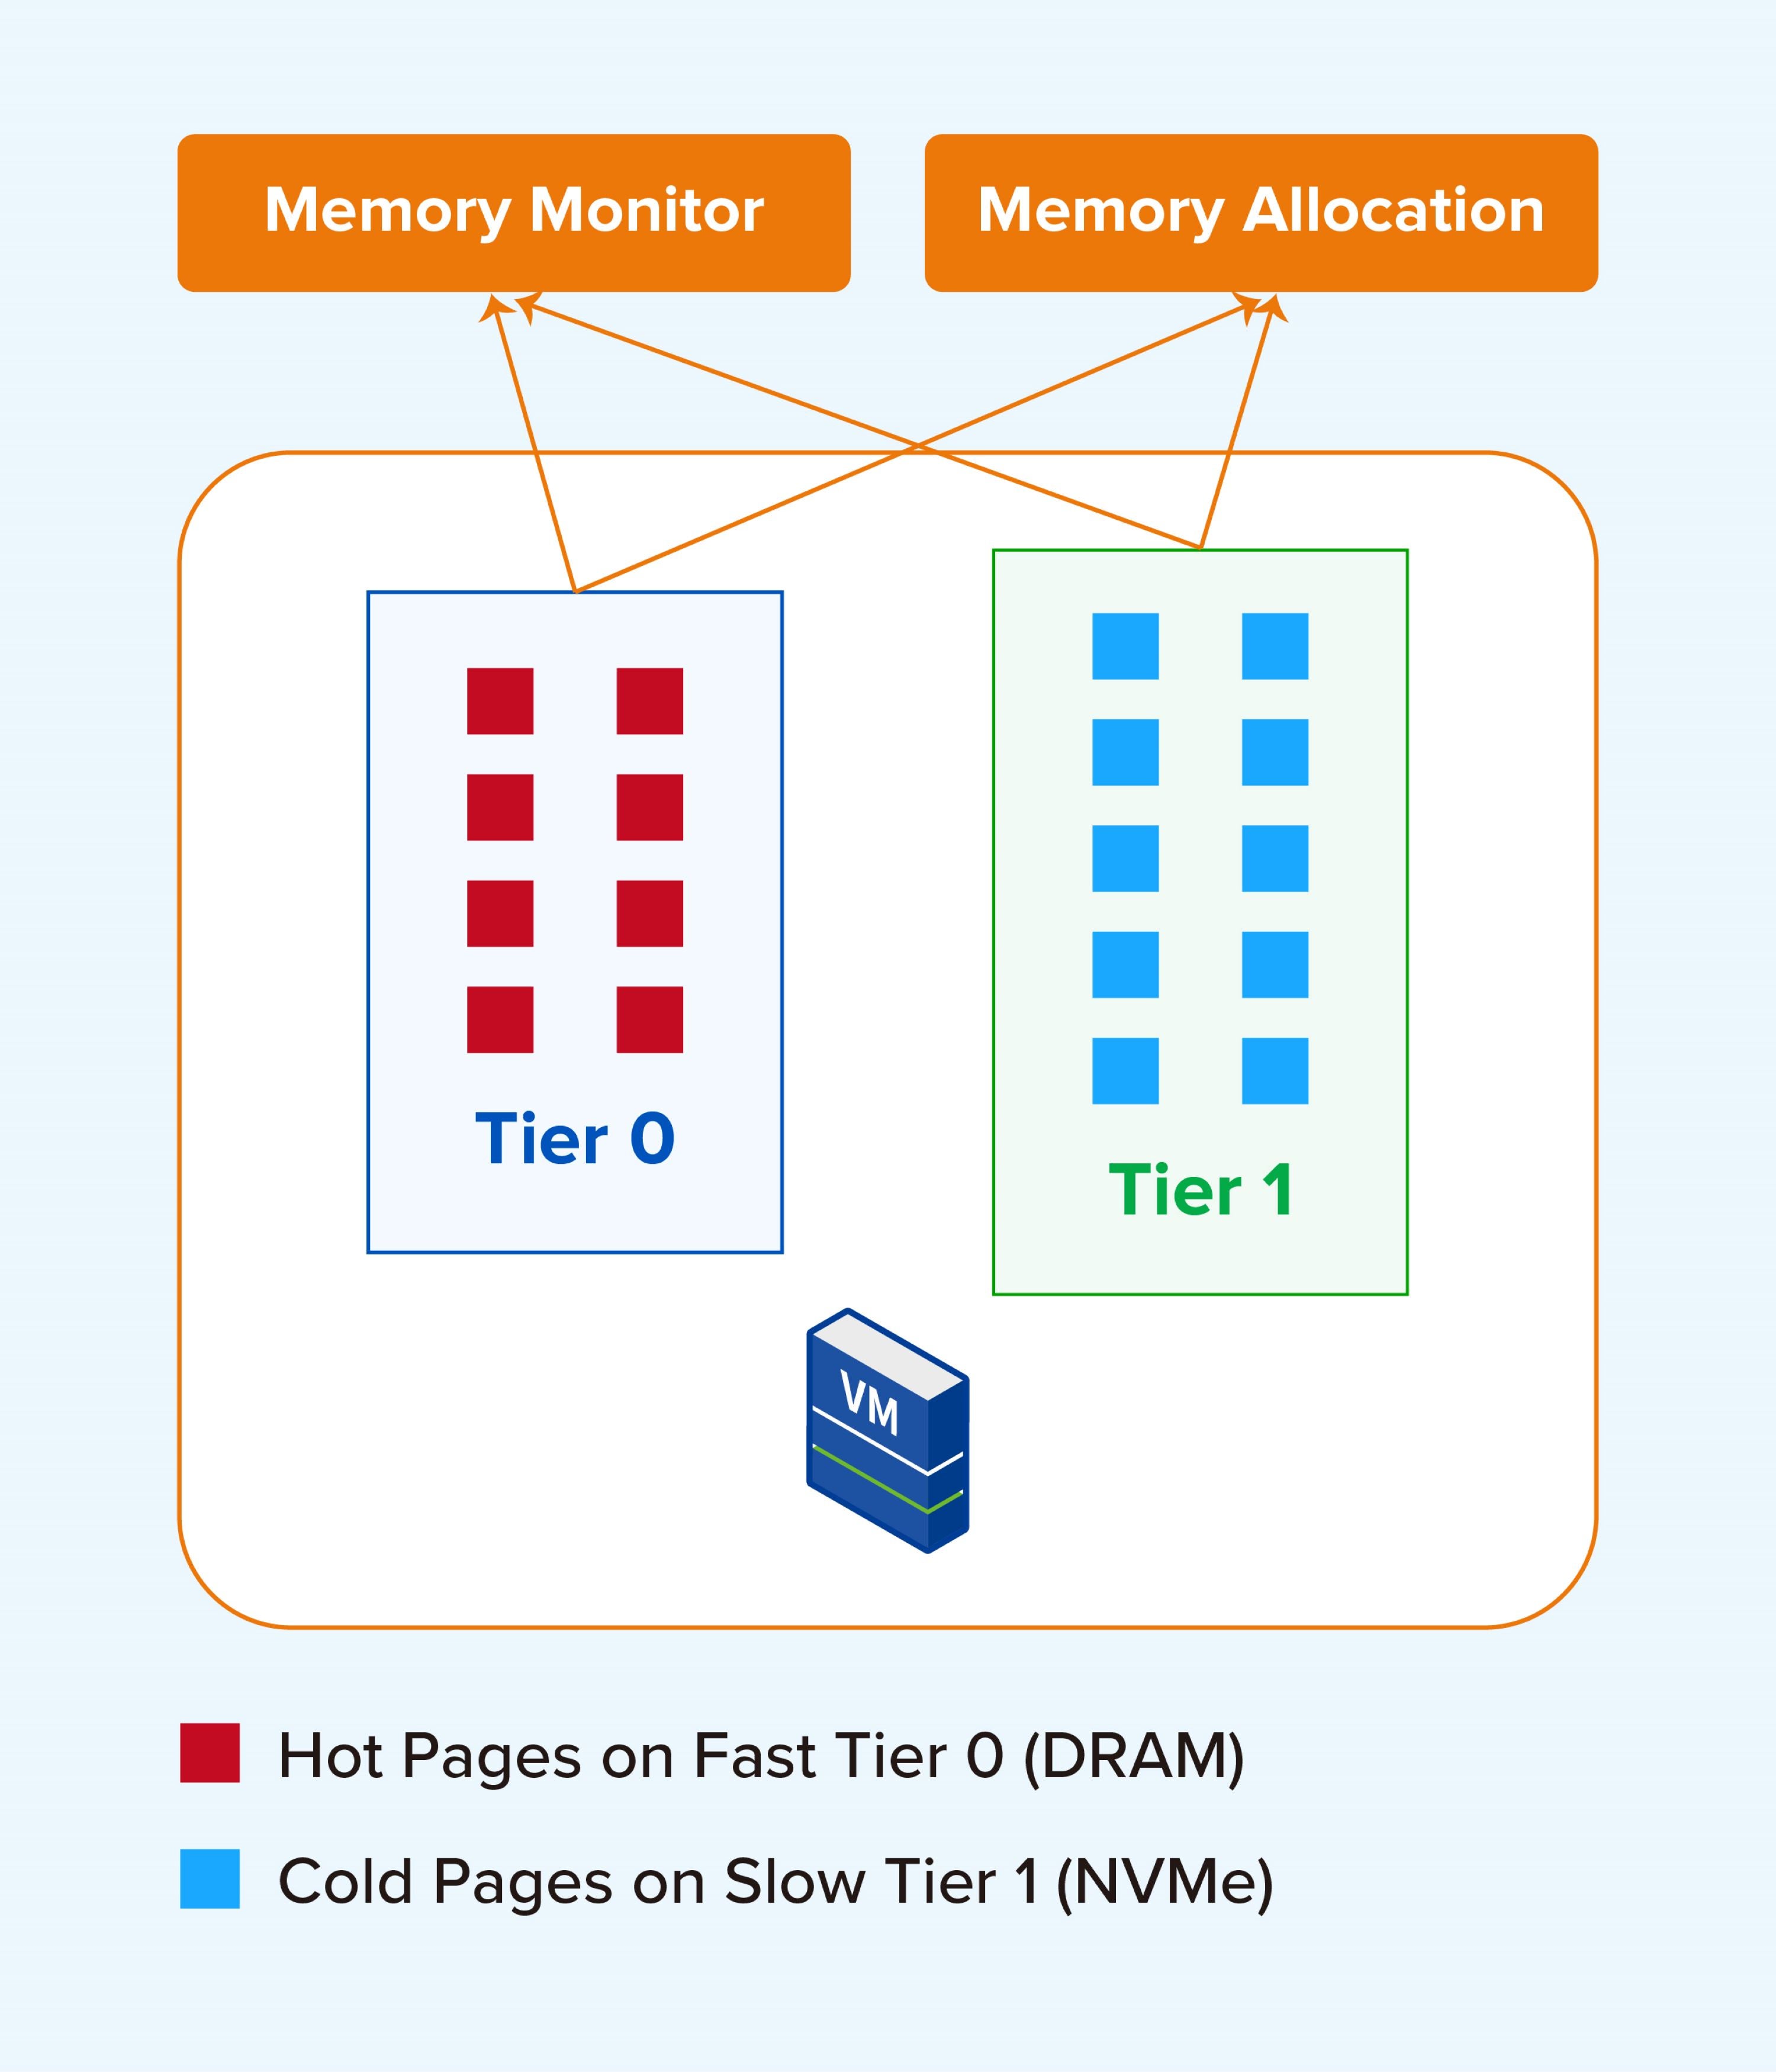
Architekturentwurf für mehrstufige Speicherpools
Intelligente Terminplanungs-Engine
Die intelligente Scheduling-Engine bildet das Herzstück der Memory-Tiering-Lösung. Durch die Nutzung der Technologie „Dynamische Regionspartitionierung + zufälliges Sparse Sampling“ ermittelt sie die globale Verteilung von häufig und selten genutztem Speicher mit minimalem Systemaufwand und ermöglicht so eine präzise Identifizierung und dynamische Planung.
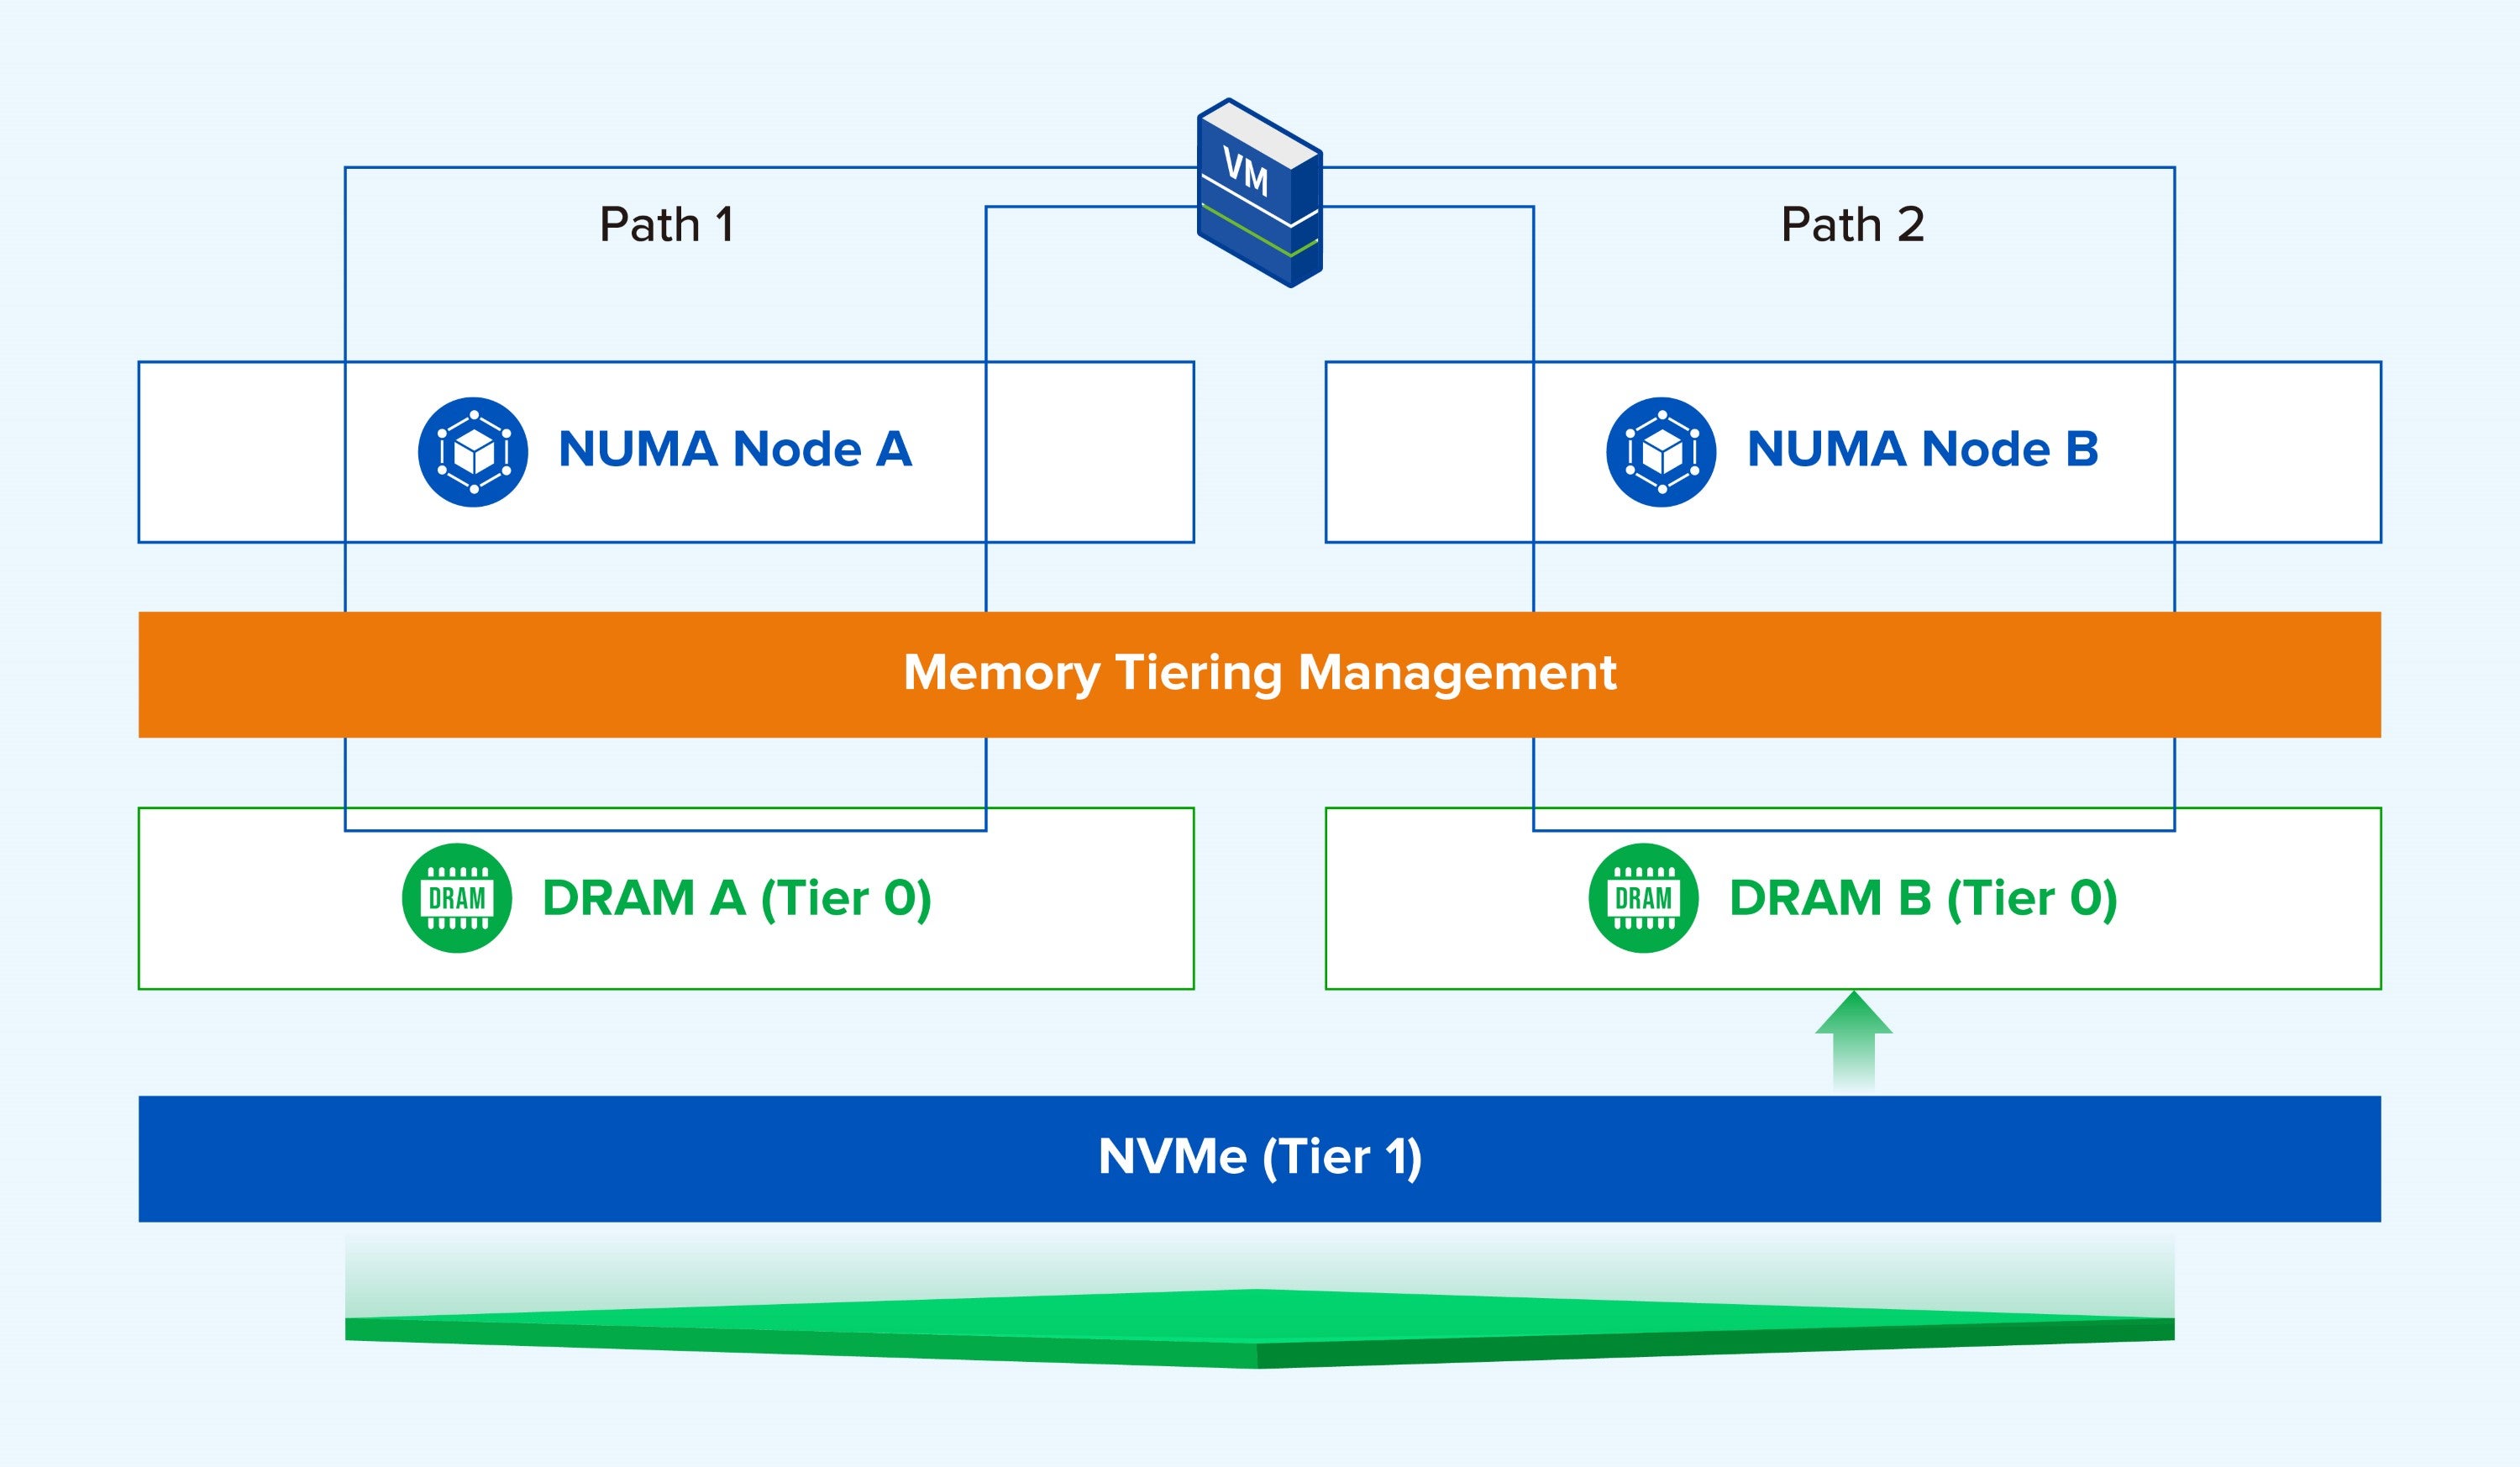
Der Pfad des CPU-Speicherzugriffs
Es besteht aus drei Kernfunktionen:
- Präzise Hot/Cold-Identifizierung (genaue Zielzuweisung): Durch kontinuierliche Hot-Erkennung erfasst es in Echtzeit den aktuell aktiven Arbeitsbereich des Unternehmens. Es unterscheidet präzise, welche Hot-Daten im Hochgeschwindigkeits-DRAM verbleiben müssen und welche Cold-Seiten sicher in den Downgrade-Modus verschoben werden können.
- Automatisierte Speichermigration (Schnellumstellung): Führt automatisch die „Absenkung kalter Daten“ und die „Promotion heißer Daten“ durch. Dadurch wird DRAM-Speicherplatz für Kernanwendungen freigegeben, während gleichzeitig sichergestellt wird, dass reaktivierte Daten sofort wieder in den aktiven Speicherbereich zurückkehren, um eine nahtlose Zugriffsleistung zu gewährleisten.
- Vollständige Überwachung (klare Transparenz): Kontinuierliche Überwachung der Speicherwärmeverteilung, des Seitenmigrationsverhaltens und des Zugriffsstatus auf die kalte Speicherschicht (Cold Tier) ermöglicht eine umfassende Überwachung. Diese Überwachungsdaten unterstützen den IT-Betrieb bei der Identifizierung potenzieller Leistungsrisiken und bilden eine solide Grundlage für die Optimierung von Richtlinien und die Kapazitätsplanung.
Datenfluss zwischen DRAM und NVMe (heiß und kalt)
- DRAM → NVMe (Cold Page Degradation): Sobald das System eine selten genutzte Seite identifiziert, wird diese der Warteschlange für die Migration selten genutzter Seiten hinzugefügt. Das System reserviert NVMe-Speicherplatz, schreibt die Seitendaten vom DRAM auf die NVMe-SSD und aktualisiert synchron die Speicherabbildung. Nach der Migration wird der entsprechende DRAM-Speicherplatz freigegeben, sodass der Hochgeschwindigkeitsspeicher für aktive Daten priorisiert wird.
- NVMe → DRAM (Hot Page Promotion): Greift eine Anwendung erneut auf eine Seite zu, die zuvor in den NVMe-Speicherbereich verschoben wurde, erfasst das System die Anfrage in Echtzeit und leitet die Wiederherstellung ein. Dabei werden die Daten der Zielseite aus dem NVMe-Speicher zurück in den DRAM gelesen und die Speicherbelegung synchron aktualisiert. So gelangen die reaktivierten Daten in den Hochgeschwindigkeitsspeicher und die normale Leistung wird wiederhergestellt.
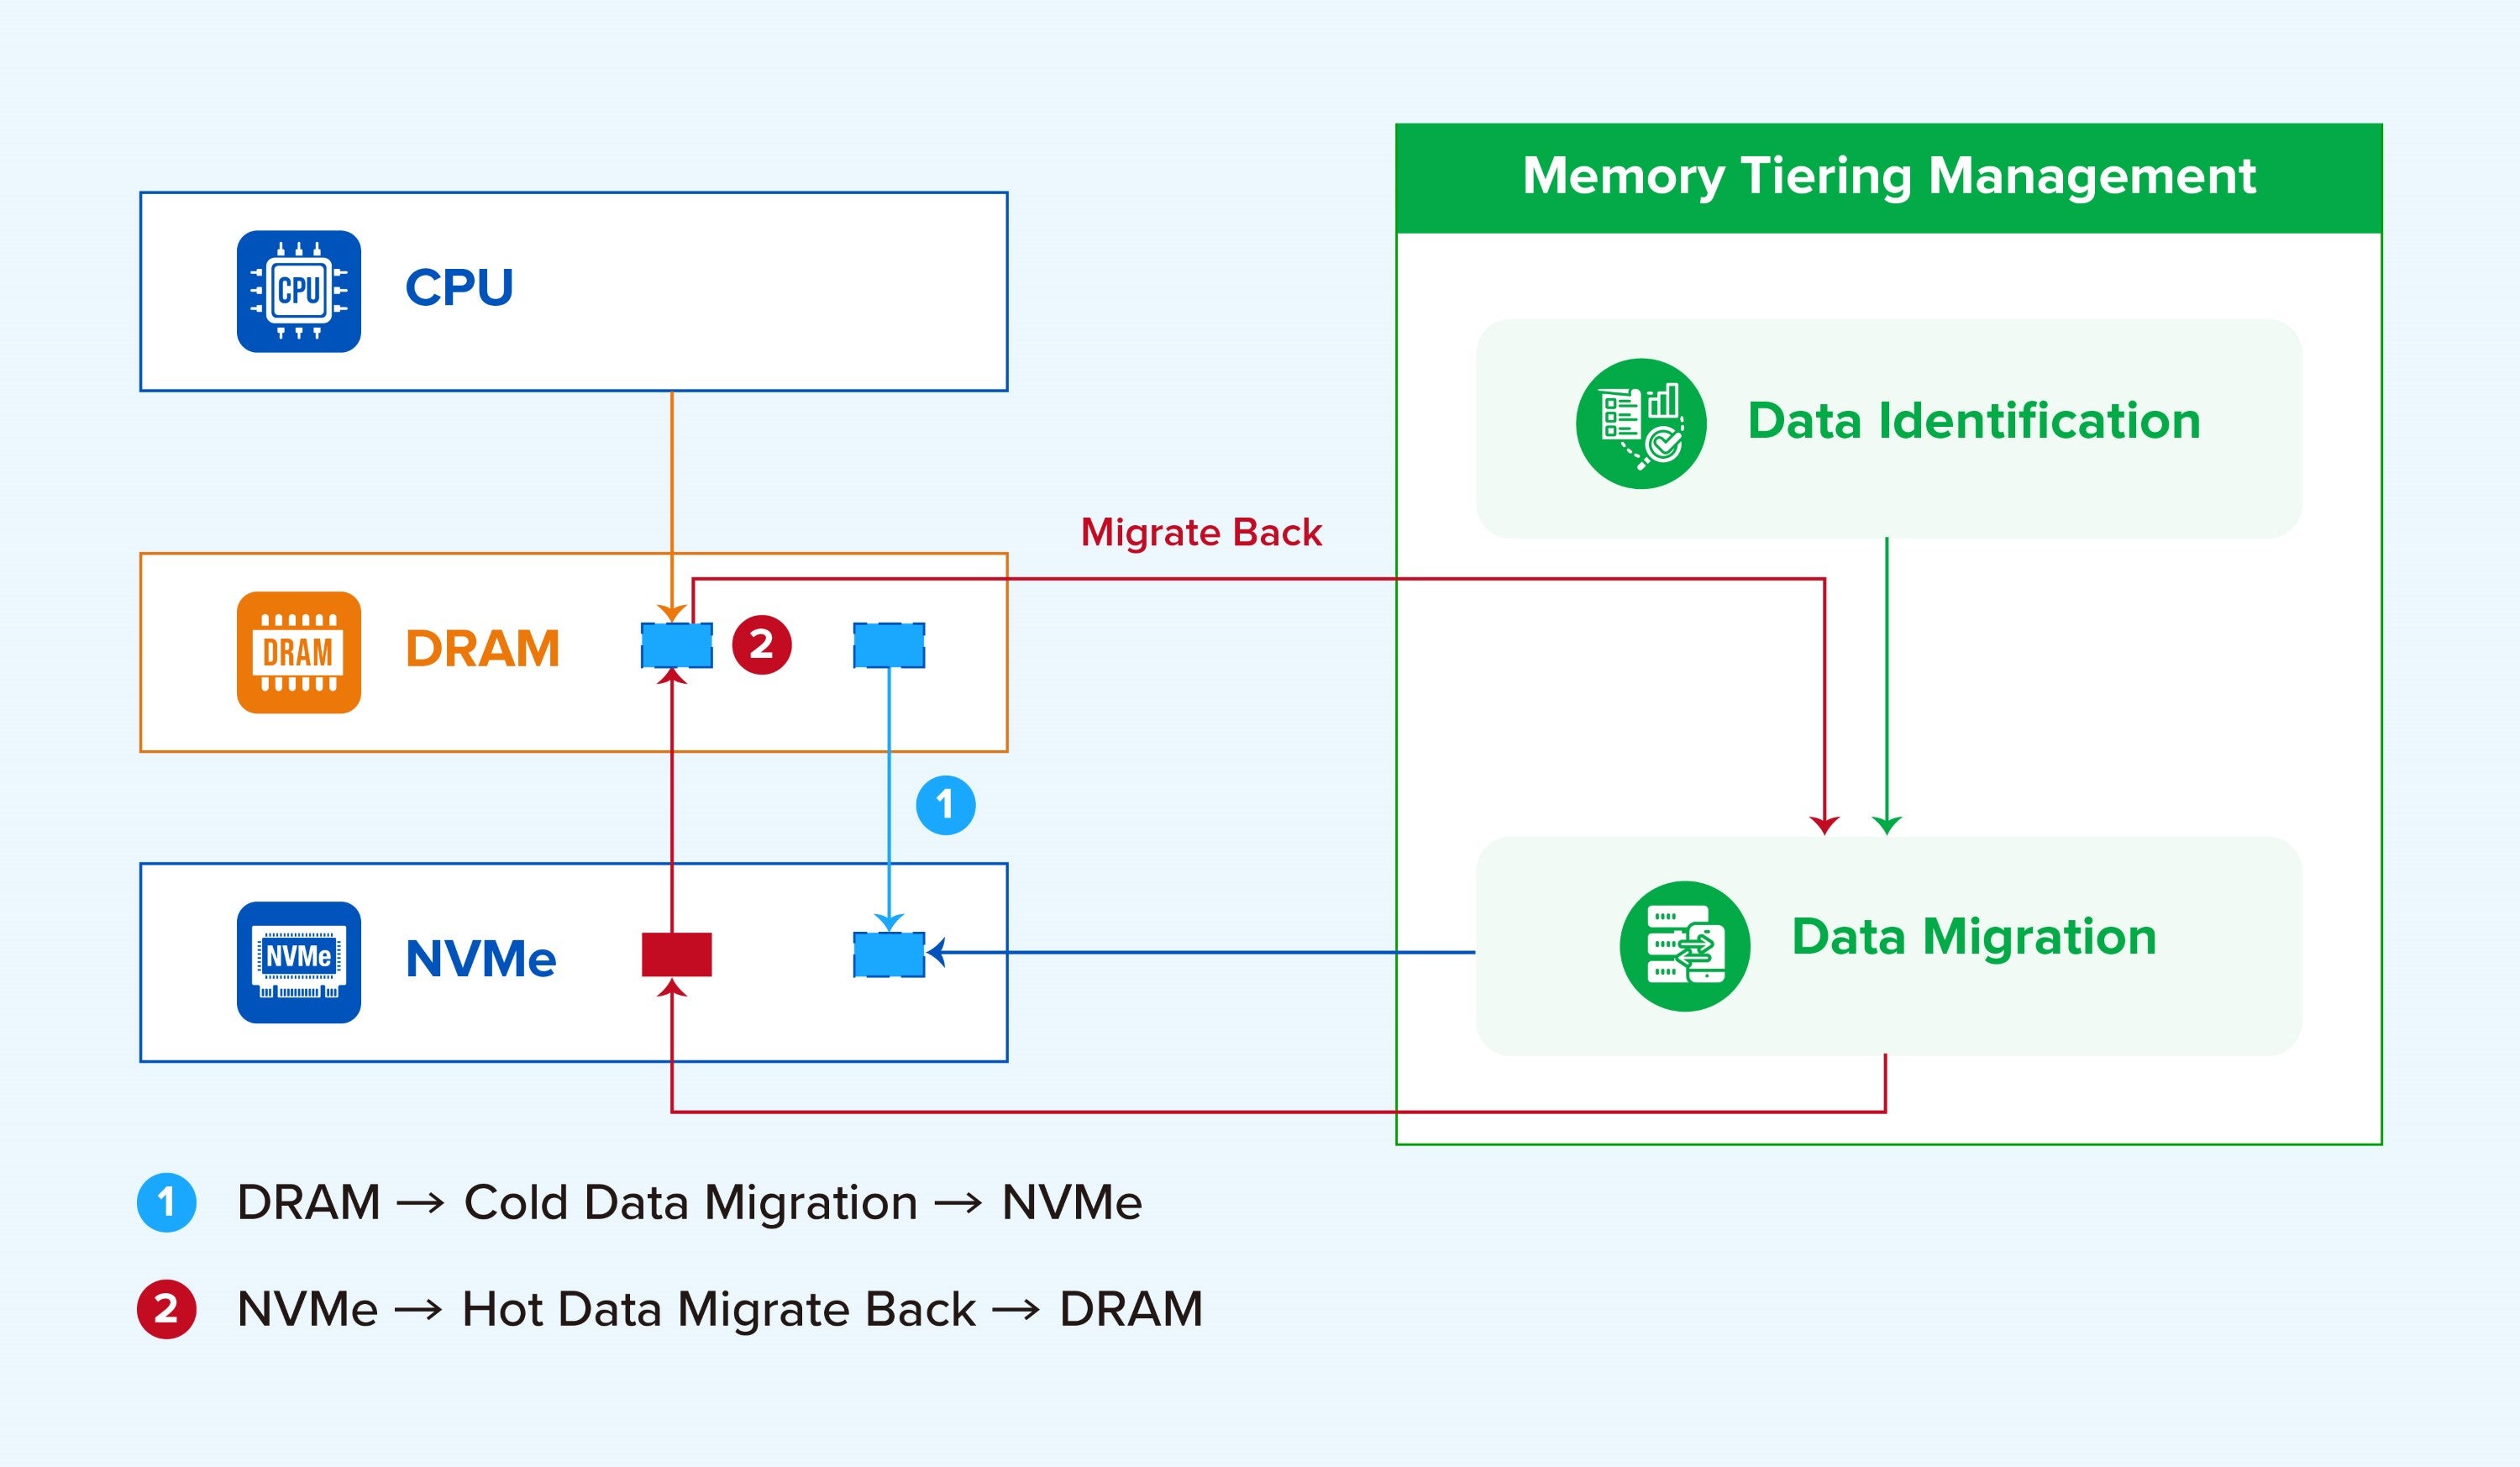
Datenmigrationsmechanismen
Wie greift die CPU auf gestaffelten Speicher zu? Minimierung von Leistungsverlusten.
Die technische Herausforderung beim Memory Tiering besteht darin, Daten schnell zu identifizieren, Seiten einzuplanen und der CPU einen schnellen Zugriff auf den Speicher zu ermöglichen, sobald dieser gestuft ist.
In dieser Architektur wird das NVMe-Gerät nicht als herkömmlicher Speicher, sondern als Cold-Memory-Tier unterhalb des DRAM verwendet. Daher werden alle Speicherzugriffe der CPU letztendlich über den DRAM abgewickelt. Die Zugriffspfade lassen sich in zwei Typen unterteilen:
- Pfad 1: Hot Page Hit: CPU initiiert Zugriff → Lokaler/Remote DRAM → Gibt Daten zurück.
- Pfad 2: Cold Page Miss: Die CPU initiiert den Zugriff → Die Zielseite befindet sich nicht im DRAM-Hot-Tier → Das System lädt die Seite von NVMe zurück in den DRAM → Die CPU greift auf die Seite zu.
Speicherschichtarchitektur
Da die Server-CPU nicht direkt auf NVMe zugreift, wie lässt sich der Leistungsverlust minimieren? Um Bedenken hinsichtlich der Leistung nach dem Tiering auszuräumen, gewährleistet das System die Geschäftsstabilität durch die folgenden Mechanismen:
- Einheitlicher Adressraum & Transparenter Zugriff: Dies ist für Anwendungen vollständig transparent. Beim Zugriff auf eine häufig genutzte Seite im DRAM erfolgt ein direkter Zugriff ohne zusätzlichen Aufwand. Beim Zugriff auf eine selten genutzte Seite im NVMe-Speicher wird ein Seitenfehler-Interrupt ausgelöst; der Betriebssystemkern lädt die Daten umgehend vom NVMe-Speicher zurück in den DRAM, sodass die CPU darauf zugreifen kann. Die CPU arbeitet unabhängig davon, ob sich die Daten im DRAM oder im NVMe-Speicher befanden – der Kernel kümmert sich um alles.
- Intelligente Planung und dynamische Regionsanpassung: Das System passt die Regionsstruktur dynamisch anhand der Überwachungsergebnisse an, um ein optimales Verhältnis zwischen Genauigkeit und Systemaufwand zu erzielen. Bei ähnlichen Zugriffsmustern benachbarter Regionen werden diese automatisch zusammengeführt, um die Anzahl der zu überwachenden Objekte zu reduzieren. Werden innerhalb einer Region deutliche Hotspots erkannt, wird diese zur detaillierteren Identifizierung aufgeteilt. Dieser adaptive Mechanismus gewährleistet eine optimale Überwachungsgranularität.
- NVMe mit niedriger Latenz minimiert den Übertragungsaufwand: Der NVMe-Controller liest und schreibt direkt über PCIe auf den DRAM, ohne dass die CPU eingreift, und benötigt dadurch nur sehr wenige CPU-Interrupt-Ressourcen. NVMe-Hardware bietet erhebliche Vorteile: Die Latenzen liegen zwischen 10 und 100 µs (deutlich niedriger als bei SATA-SSDs/HDDs), und die Bandbreite von PCIe 4.0 NVMe erreicht bis zu 7 GB/s – etwa ein Zehntel der DRAM-Bandbreite und weit über der von herkömmlichen Speichermedien.
Memory-Tiering minimiert Leistungseinbußen primär durch anwendungstransparentes Management, intelligente Planung und latenzarme NVMe-Speicher, wodurch sichergestellt wird, dass die CPU stets über Hochgeschwindigkeitspfade arbeitet. In Kombination mit der Optimierung der Kernel-I/O-Pfade und der nahtlosen Vererbung der NUMA- Affinität verdoppelt sich die Gesamtspeicherkapazität des Servers, während die tatsächlichen Leistungseinbußen zuverlässig unter 10 % bleiben.
Live-Demo: Memory Tiering in Aktion
Doppelter Serverspeicher bei nur 6 % Leistungsverlust | Sangfor HCI Memory Tiering im Test
- Vor dem Memory Tiering: 256 GB physischer Speicher, bis zu 73 % Auslastung. Oracle Database TPS (Transaktionen pro Sekunde): über 15.000.
- Nach dem Memory Tiering: 128 GB physischer Speicher + 128 GB Tiering-Speicher, entsprechend einer Speicherkapazität von 256 GB. Die durchschnittliche Transaktionsrate (TPS) der Oracle-Datenbank blieb stabil bei etwa 14.000, wobei der Leistungsabfall sicher unter 10 % gehalten wurde.
Leitfaden zur praktischen Umsetzung: Anwendbare Szenarien und Planungsempfehlungen
Anwendbare Szenarien
- Ideale Szenarien: Memory Tiering eignet sich für Anwendungsfälle, die eine hohe Gesamtspeicherkapazität erfordern, unterschiedliche Zugriffsmuster für häufig und selten genutzte Daten aufweisen, kostensensibel sind und geringe, gelegentliche Latenzen tolerieren. Beispiele hierfür sind Entwicklungs- und Testumgebungen, nicht zum Kernsystem gehörende Caching-Dienste und Microservice-Cluster mit geringer bis mittlerer Last.
- Nicht empfohlen für: Es eignet sich nicht für Kernanwendungen, die extrem empfindlich auf Zugriffsverzögerungen reagieren, dichte und einheitliche Zugriffsmuster aufweisen und strikt geringes Jitter und hohe Stabilität erfordern. Beispiele hierfür sind Echtzeit-Handelssysteme, Hochfrequenzhandelsdatenbanken, In-Memory-Datenbanken und Hochfrequenz-OLTP-Datenbanken.
Die Memory-Tiering-Lösung von Sangfor ermöglicht das Aktivieren und Deaktivieren dieser Funktion auf Ebene virtueller Maschinen (VMs) . Anwender können Memory Tiering flexibel für bestimmte VMs je nach Geschäftsart und -merkmalen steuern und so Leistung und Kosten präzise kontrollieren. Sollten die Hardwarepreise zukünftig sinken, können Anwender die Kapazität nahtlos online skalieren – ohne Herstellerbindung oder zukünftige Upgrade-Probleme.
Bewährte Vorgehensweise für die Planung von Speicherstufen
Um ein Gleichgewicht zwischen Speichererweiterung und stabiler Geschäftsleistung zu gewährleisten, wird ein Verhältnis von DRAM zu Tiered Memory von 1:1 empfohlen. Dieses Verhältnis deckt die Anforderungen der meisten Unternehmensszenarien ab und verdoppelt die Speicherkapazität bei gleichzeitig akzeptablen Leistungsschwankungen.
In einem Marktumfeld mit anhaltend hohen Speicherpreisen ist Memory Tiering nicht mehr nur ein Werkzeug zur Leistungsoptimierung, sondern eine hocheffektive Strategie zur Kostenkontrolle. Anwender können ihre Budgets für die Speicherbeschaffung drastisch reduzieren, ohne die Kernleistung ihres Unternehmens zu beeinträchtigen. Gleichzeitig maximieren sie den Wiederverwendungswert vorhandener IT-Ressourcen und meistern so die Herausforderungen des wachsenden Rechenleistungsbedarfs und des gleichzeitigen IT-Kostenmanagements.