Negli ultimi due anni, la pianificazione della memoria aziendale è diventata silenziosamente uno dei problemi più complessi nella progettazione delle infrastrutture. L'esplosione dei carichi di lavoro di intelligenza artificiale e il rapido spostamento della capacità produttiva di semiconduttori verso le memorie ad alta larghezza di banda (HBM) hanno fatto lievitare i prezzi delle DRAM per server di oltre il 170% su base annua , con gli analisti del settore che avvertono che la scarsità di offerta e i prezzi elevati potrebbero persistere almeno fino al 2027.
Tuttavia, negli ambienti di produzione reali, l'utilizzo della memoria racconta una storia diversa. Nelle piattaforme virtualizzate e cloud-native, applicazioni come i servizi basati su JVM, le piattaforme middleware, i big data e il machine learning tendono a riservare ampi spazi di memoria in anticipo, mentre solo una parte di tale memoria viene effettivamente utilizzata in un dato momento. Le pagine rimanenti restano inattive per lunghi periodi, consumando costosa capacità DRAM senza contribuire direttamente alle prestazioni.
È proprio in questo divario tra la memoria allocata e la memoria effettivamente utilizzata che emerge un nuovo approccio di ottimizzazione.
La suddivisione della memoria in livelli si basa su un'osservazione semplice ma fondamentale: non tutte le pagine di memoria sono uguali. Se i dati "caldi" a cui si accede frequentemente possono rimanere su DRAM ad alta velocità, mentre i dati "freddi" a cui si accede raramente vengono posizionati in modo trasparente su un supporto a basso costo e ad alte prestazioni, la capacità di memoria complessiva può essere notevolmente ampliata senza un aumento proporzionale dei costi hardware.
Tuttavia, questa idea solleva immediatamente questioni critiche per gli utenti aziendali:
- È davvero possibile estendere la memoria oltre i limiti fisici della DRAM senza compromettere le prestazioni?
- Come fa il sistema a identificare con precisione le memorie calde e fredde, senza introdurre un elevato sovraccarico della CPU?
- Quando si accede nuovamente a dati non più utilizzati, con quale rapidità questi possono tornare nella memoria ad alta velocità e le applicazioni se ne accorgeranno?
Queste preoccupazioni sono fondate. La memoria si trova sul percorso critico delle prestazioni di un'applicazione e qualsiasi ottimizzazione a questo livello deve essere al contempo precisa e prevedibile.
In questo articolo, esaminiamo da vicino, sia dal punto di vista pratico che tecnico, la tecnologia di tiering della memoria di Sangfor. Spiegheremo perché è possibile suddividere la memoria in livelli in modo sicuro, come DRAM e NVMe collaborano a livello di sistema e quali principi di progettazione garantiscono che l'impatto sulle prestazioni rimanga strettamente controllato. Altrettanto importante, illustreremo gli scenari in cui il tiering della memoria offre un vantaggio evidente e quelli in cui dovrebbe essere utilizzato con cautela.
Il nostro obiettivo non è quello di enfatizzare eccessivamente un concetto, ma di fornire un framework trasparente che aiuti gli architetti IT e i responsabili delle decisioni a determinare se la suddivisione della memoria a livelli sia la soluzione giusta per i loro ambienti.
Perché la memoria può essere "strutturata su più livelli"?
Nell'ambito dell'ottimizzazione della memoria aziendale, le soluzioni tradizionali come il memory ballooning, la condivisione trasparente delle pagine, la compressione della memoria e l'overcommitment della memoria possono migliorare l'utilizzo della memoria fisica e alleviare la pressione in una certa misura. Tuttavia, questo miglioramento è limitato. Con la continua crescita delle dimensioni aziendali, sono necessari nuovi approcci tecnologici per espandere la capacità di memoria disponibile del sistema.
Negli ambienti cloud-native e virtualizzati, le applicazioni (come JVM, servizi di caching e middleware) in genere riservano una grande quantità di spazio di memoria. Tuttavia, la memoria effettivamente "attiva", ovvero quella letta e scritta frequentemente, rappresenta solo circa il 50%, mentre il resto rimane in uno stato "freddo", a basso accesso.
Sulla base di questa caratteristica fondamentale, è nata la soluzione di tiering della memoria. Dividendo i dati in memoria in un livello di dati "caldi" e un livello di dati "freddi" in base alla frequenza di accesso, si crea un pool unificato di risorse di memoria utilizzando DRAM fisica e SSD NVMe ad alte prestazioni. Grazie ad algoritmi di pianificazione intelligenti per instradare dinamicamente i dati "caldi" e "freddi", è possibile superare i limiti della memoria fisica senza compromettere le prestazioni aziendali principali.
Come collaborano in modo intelligente DRAM e NVMe?
La soluzione Memory Tiering di Sangfor adotta un'architettura di base composta da un "pool di memoria multilivello + motore di pianificazione intelligente" per ottenere una collaborazione altamente efficiente tra DRAM e SSD NVMe. Ciò consente una gestione gerarchica della memoria e una pianificazione dinamica con un overhead di sistema estremamente ridotto.
Progettazione dell'architettura del pool di memoria multilivello
- Livello 0 (Livello dati critici): la DRAM ad alta velocità gestisce i dati "critici" ad alta frequenza e sensibili alla latenza, fungendo da garanzia fondamentale per le prestazioni aziendali.
- Livello 1 (Livello dati freddi): NVMe ad alte prestazioni funge da livello di espansione della memoria, trasportando dati "freddi" a bassa frequenza per ottenere un'espansione elastica della capacità di memoria.
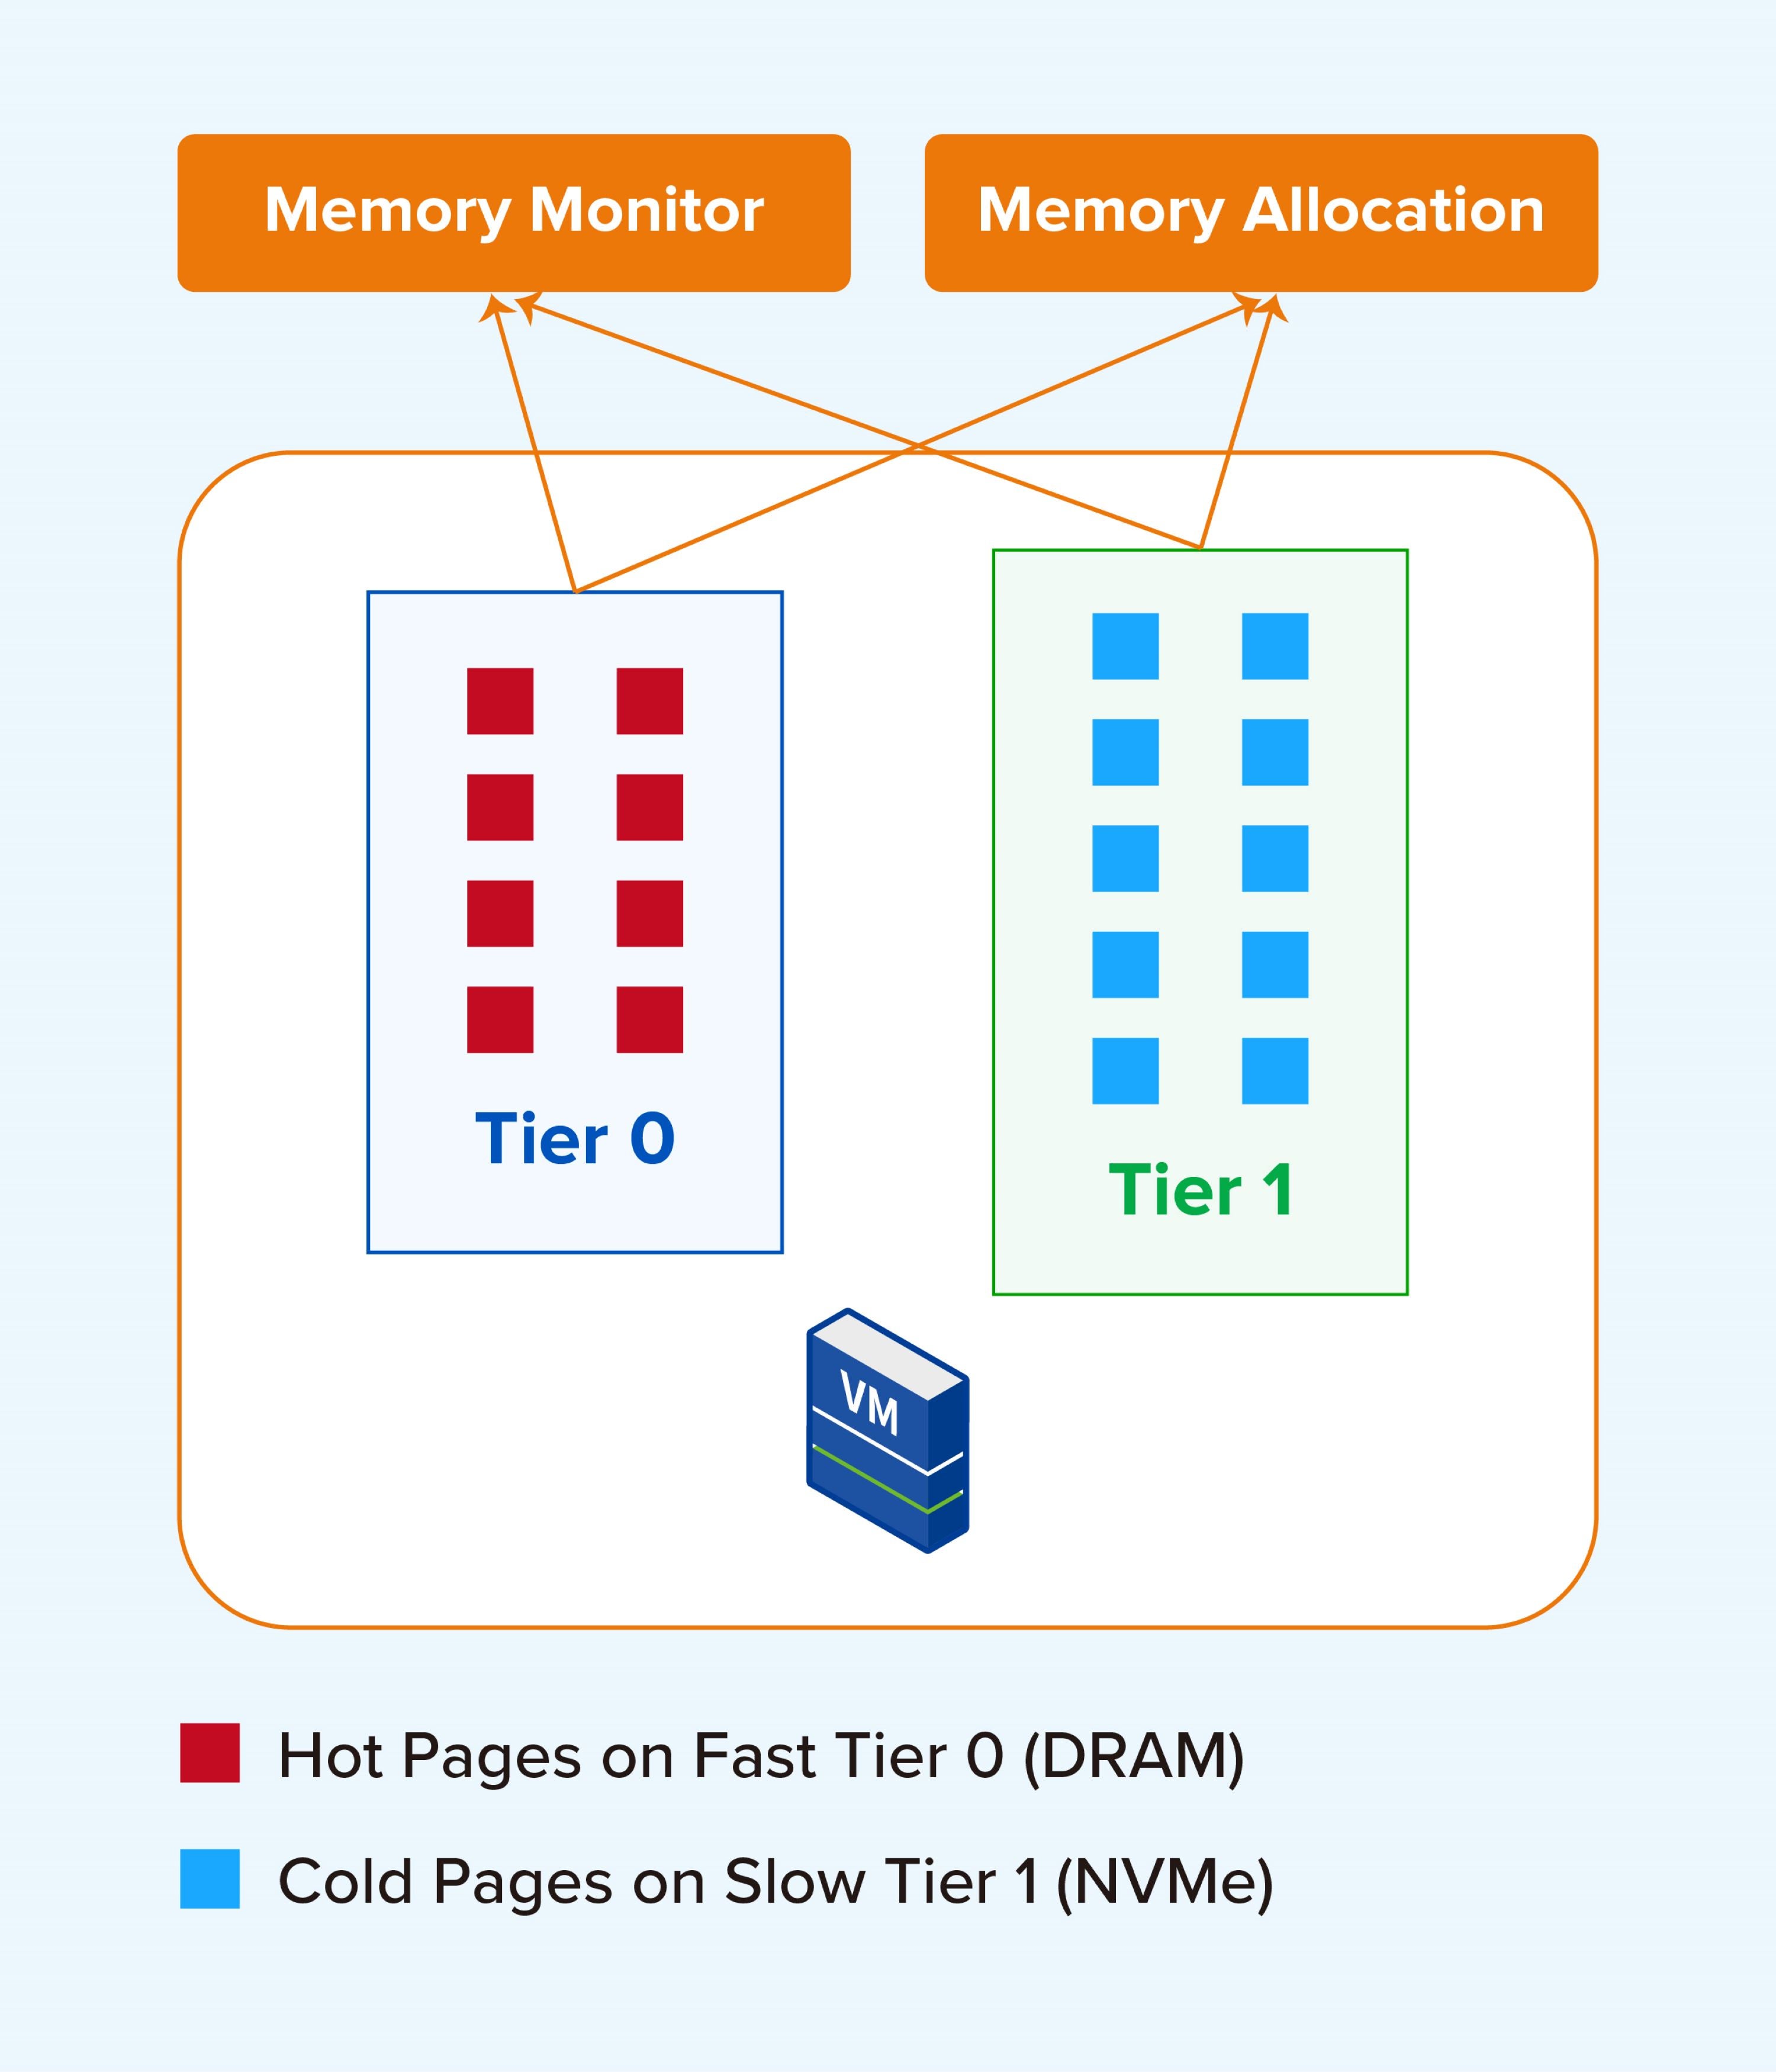
Progettazione dell'architettura del pool di memoria multilivello
Motore di pianificazione intelligente
Il motore di pianificazione intelligente è il cuore della soluzione di tiering della memoria. Utilizzando la tecnologia "partizionamento dinamico delle regioni + campionamento sparso casuale", valuta la distribuzione globale della memoria calda e fredda con un sovraccarico di sistema minimo, consentendo un'identificazione accurata e una pianificazione dinamica.
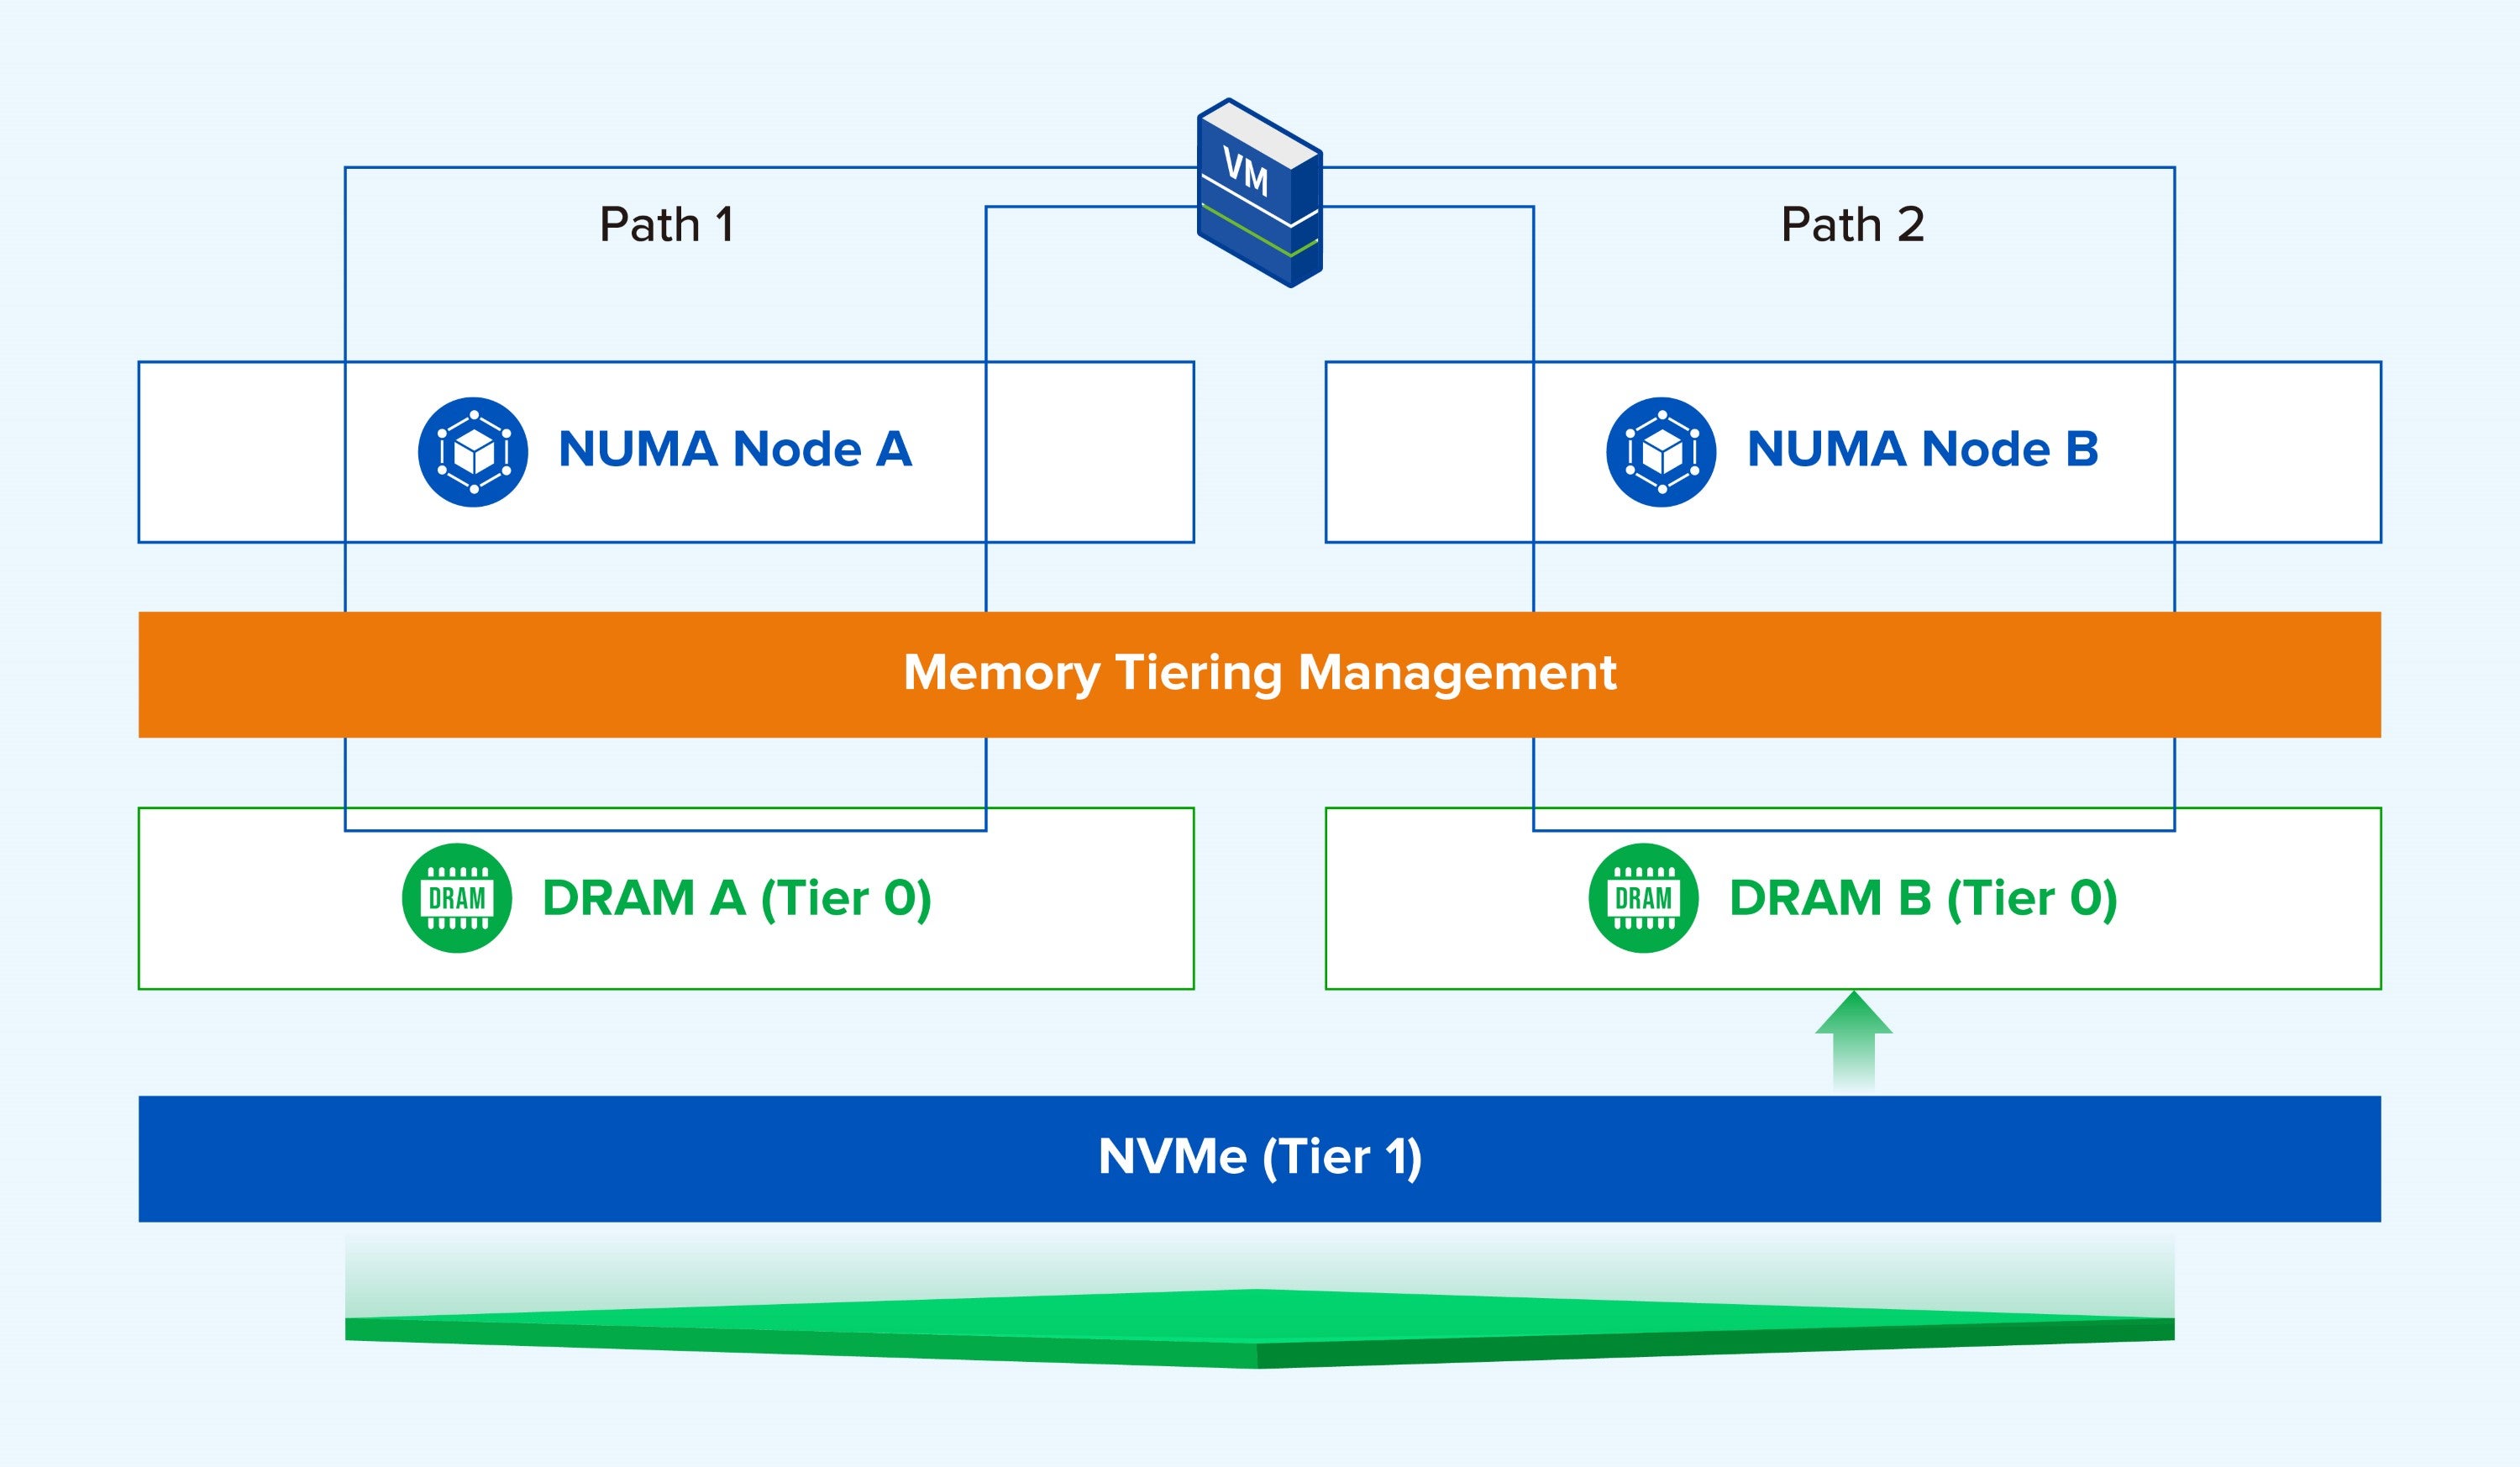
Percorso di accesso alla memoria della CPU
Si compone di tre capacità fondamentali:
- Identificazione accurata di dati caldi/freddi (targeting preciso): tramite il rilevamento continuo del calore, mappa in tempo reale il set di dati effettivamente attivo dell'azienda. Distingue con precisione quali dati caldi devono rimanere nella DRAM ad alta velocità e quali pagine fredde possono essere tranquillamente declassate.
- Migrazione automatica della memoria (spostamento rapido): esegue automaticamente la "declassazione dei dati freddi" e la "promozione dei dati caldi". Ciò libera spazio DRAM per le applicazioni principali, garantendo al contempo che i dati riattivati ritornino immediatamente al livello caldo per assicurare prestazioni di accesso senza interruzioni.
- Osservabilità completa del collegamento (visibilità chiara): monitora continuamente la distribuzione del calore della memoria, il comportamento di migrazione delle pagine e lo stato di accesso ai livelli di memoria meno utilizzati per creare una capacità di osservabilità completa. Questi dati di monitoraggio aiutano le operazioni IT a identificare potenziali rischi per le prestazioni e forniscono una solida base per l'ottimizzazione delle policy e la pianificazione della capacità.
Flusso di dati caldi e freddi tra DRAM e NVMe
- DRAM → NVMe (Declassamento delle pagine fredde): una volta che il sistema identifica una pagina fredda a basso accesso, questa viene aggiunta alla coda dei candidati per la migrazione. Il sistema alloca spazio di archiviazione NVMe, scrive i dati della pagina dalla DRAM all'SSD NVMe e aggiorna in modo sincrono la mappatura della memoria. Una volta completata la migrazione, lo spazio DRAM corrispondente viene liberato, garantendo che la memoria ad alta velocità abbia la priorità per i dati attivi.
- NVMe → DRAM (Promozione pagina a caldo): Quando un'applicazione accede nuovamente a una pagina precedentemente retrocessa al livello di memoria a bassa velocità NVMe, il sistema intercetta la richiesta in tempo reale e avvia il processo di promozione. Legge i dati della pagina di destinazione da NVMe e li carica nuovamente in DRAM, aggiornando la mappatura della memoria in modo sincrono, consentendo ai dati riattivati di accedere al livello di memoria ad alta velocità e ripristinare le normali prestazioni.
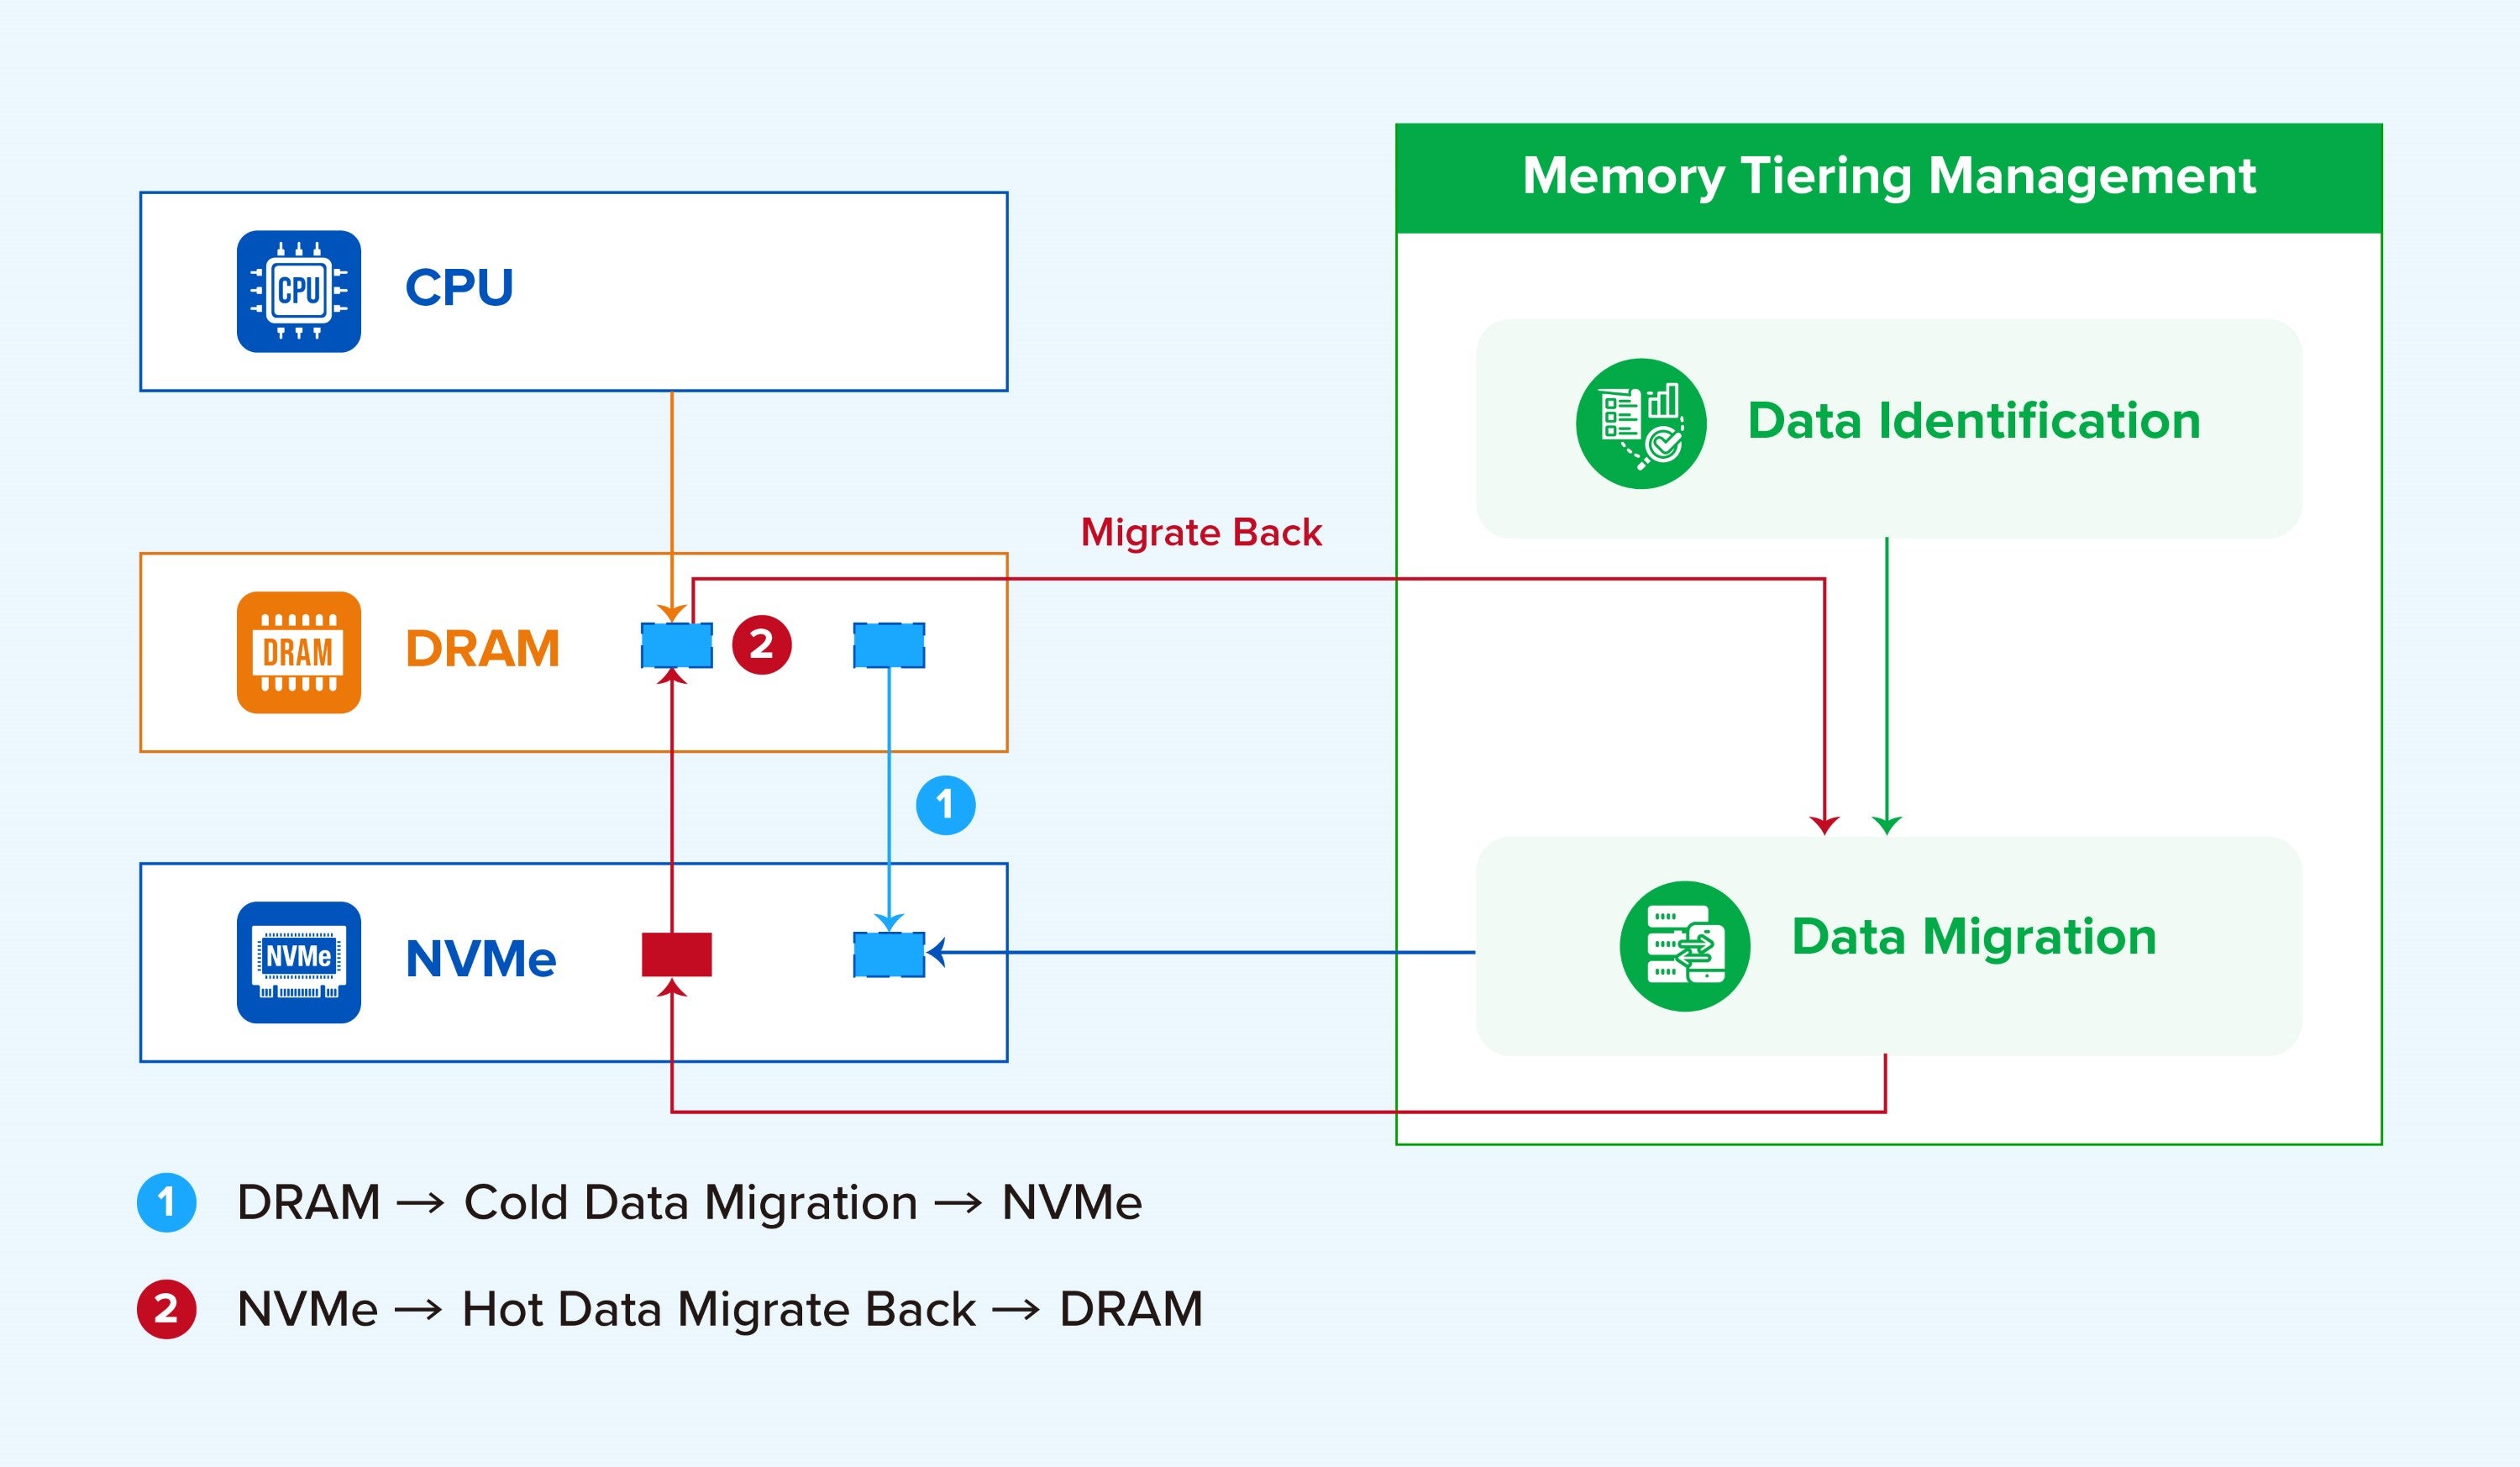
Meccanismi di migrazione dei dati
Come accede la CPU alla memoria a livelli? Minimizzare la perdita di prestazioni
La sfida tecnica della suddivisione della memoria in livelli (memory tiering) consiste nel come identificare rapidamente i dati, pianificare le pagine e consentire alla CPU di accedere rapidamente alla memoria una volta che questa è stata suddivisa in livelli.
In questa architettura, il dispositivo NVMe non viene utilizzato come memoria di archiviazione tradizionale, ma come livello di memoria fredda (Cold Memory Tier) al di sotto della DRAM. Pertanto, tutte le operazioni di accesso alla memoria della CPU vengono in definitiva completate tramite la DRAM. I percorsi di accesso sono suddivisi in due tipi:
- Percorso 1: Accesso alla pagina calda: la CPU avvia l'accesso → DRAM locale/remota → restituisce i dati.
- Percorso 2: Errore di pagina fredda: la CPU avvia l'accesso → La pagina di destinazione non si trova nel livello caldo della DRAM → Il sistema recupera la pagina da NVMe alla DRAM → La CPU accede alla pagina.
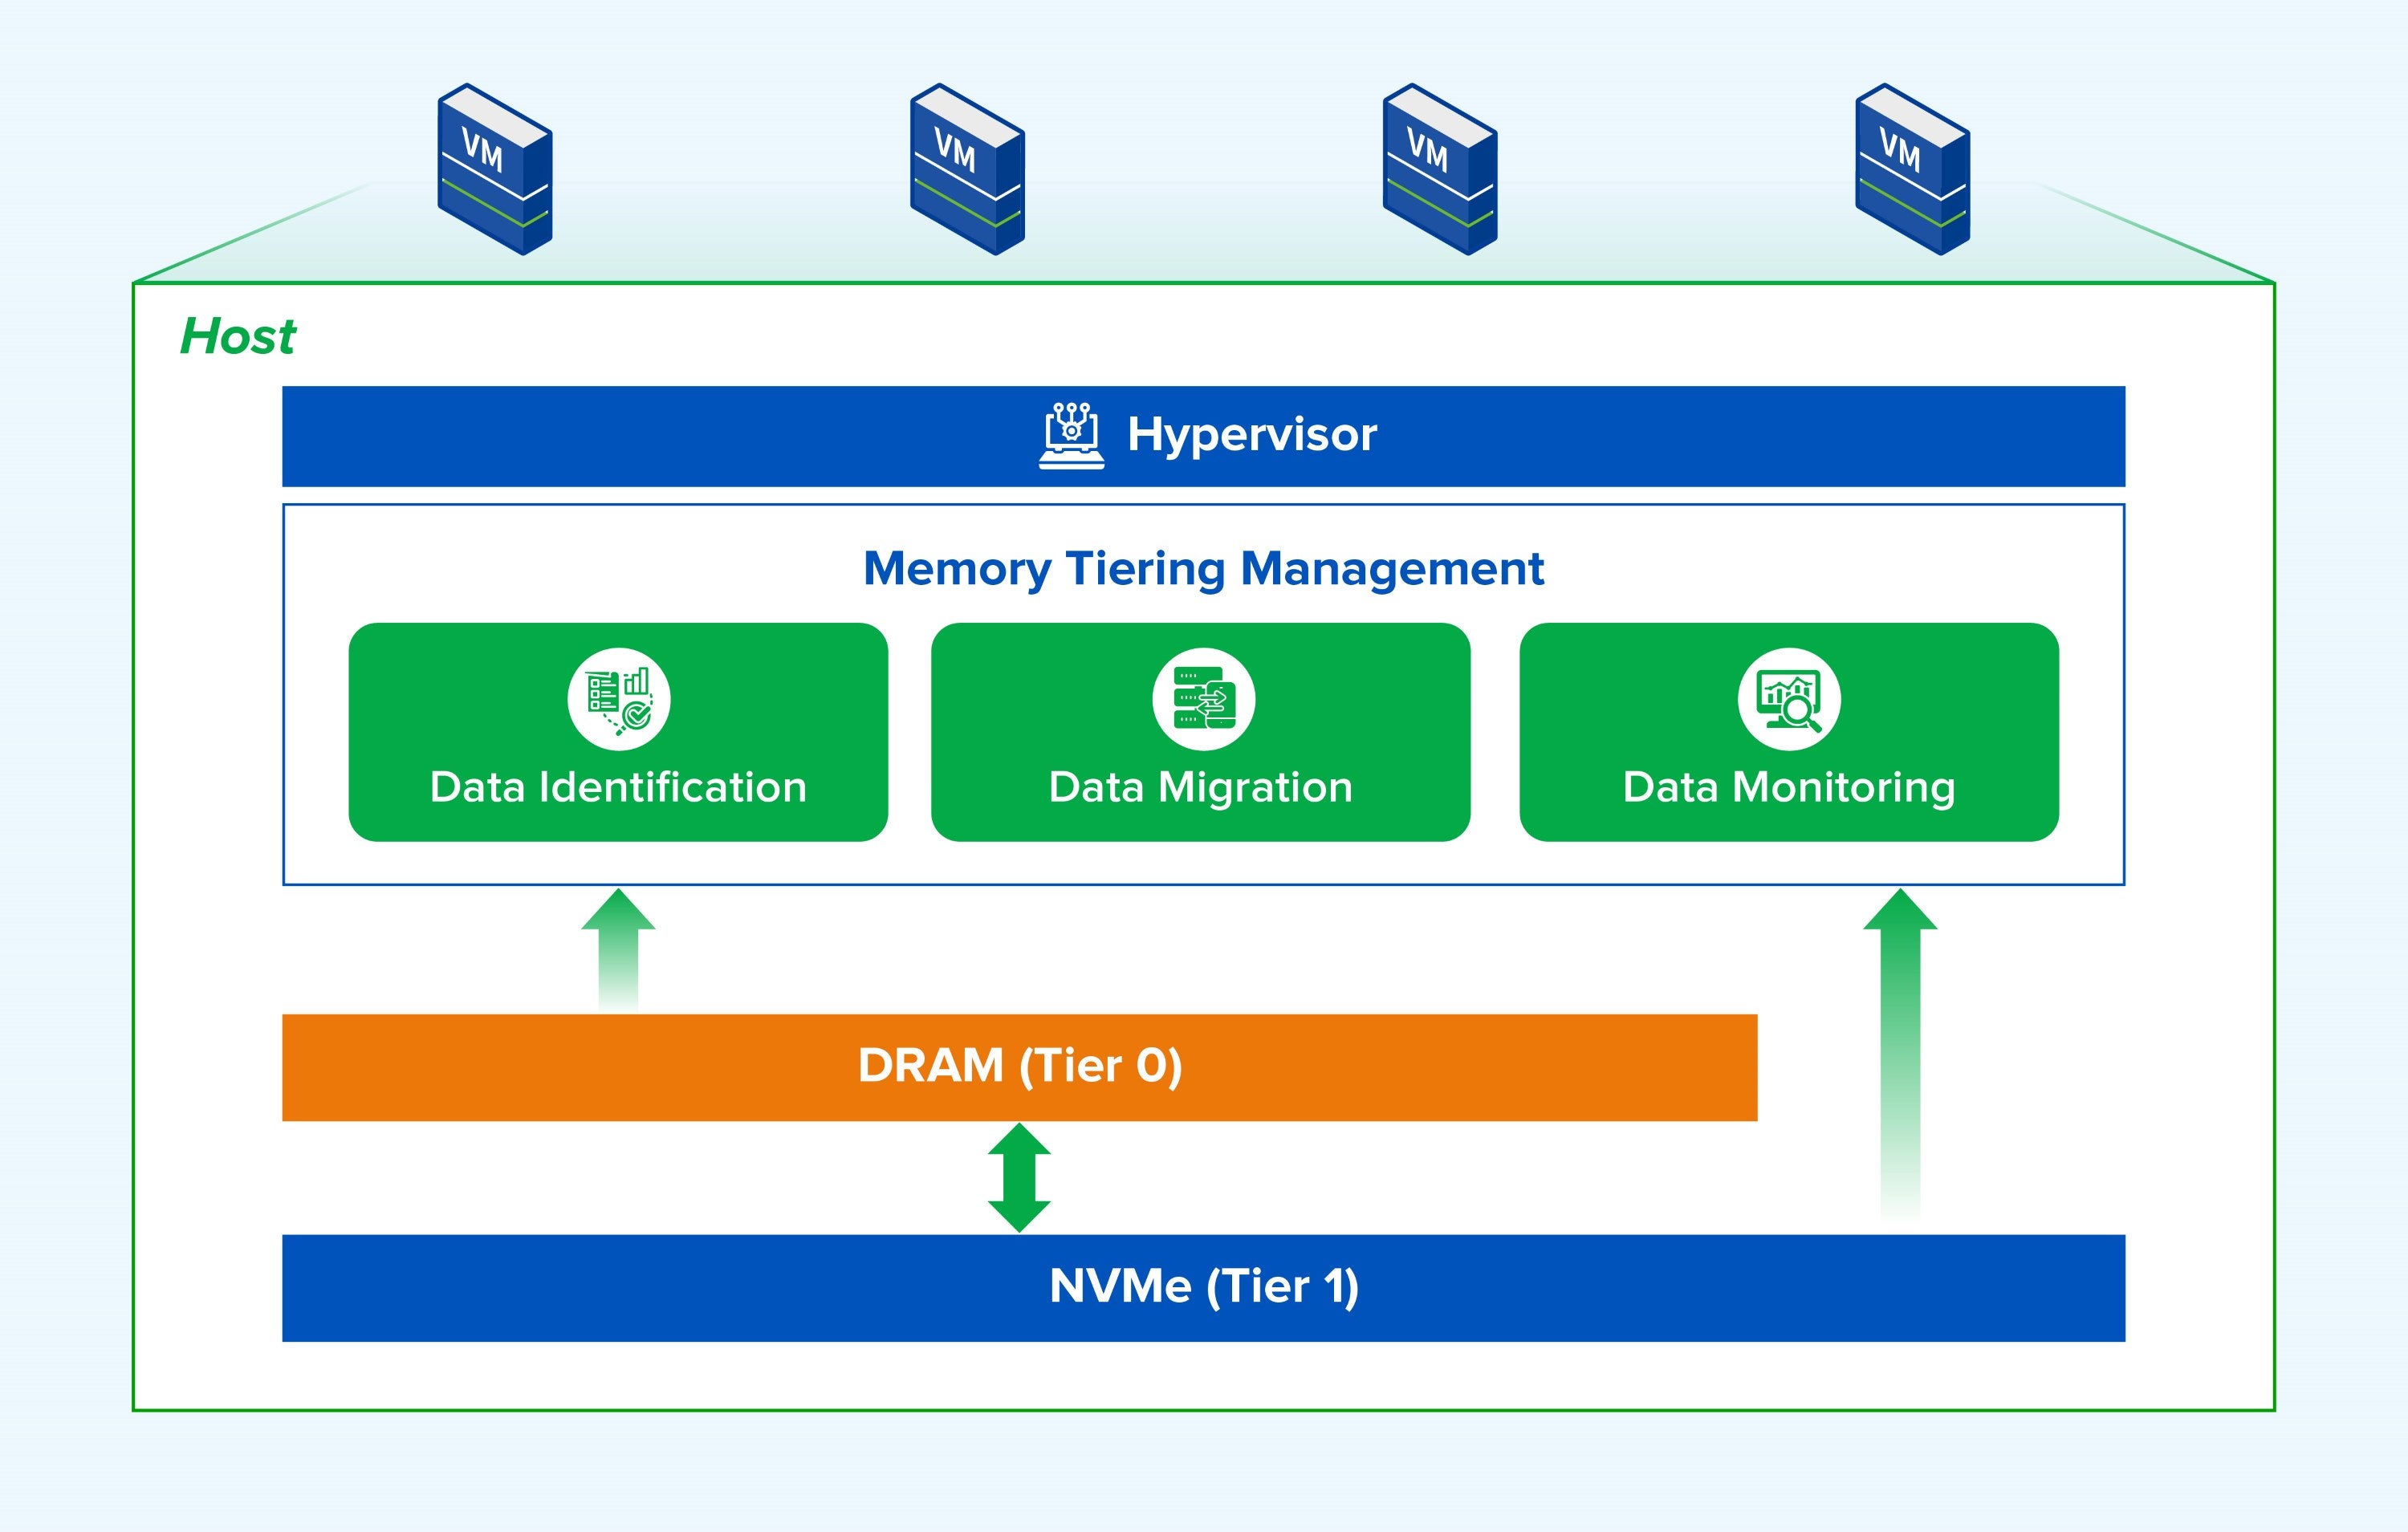
Architettura a livelli di memoria
Poiché la CPU del server non accede direttamente a NVMe, come possiamo ridurre al minimo l'impatto sulle prestazioni? Per affrontare le problematiche relative alle prestazioni dopo la fase di tiering, il sistema garantisce la stabilità operativa attraverso i seguenti meccanismi:
- Spazio di indirizzamento unificato e accesso trasparente: questo sistema è completamente trasparente per le applicazioni. Quando si accede a una pagina "calda" nella DRAM, l'accesso è diretto e senza alcun overhead aggiuntivo. Quando si accede a una pagina "fredda" nell'NVMe, viene generato un interrupt di errore di pagina; il kernel del sistema operativo recupera rapidamente i dati dall'NVMe alla DRAM, consentendo l'accesso alla CPU. La CPU opera senza sapere se i dati si trovavano nella DRAM o nell'NVMe: il kernel gestisce tutto.
- Pianificazione intelligente e regolazione dinamica delle regioni: il sistema regola dinamicamente la struttura delle regioni in base ai risultati del monitoraggio per bilanciare precisione e sovraccarico di sistema. Quando le regioni adiacenti presentano modelli di accesso simili, vengono unite automaticamente per ridurre il numero di oggetti da monitorare. Quando vengono rilevati punti critici (hot spot) all'interno di una regione, questa viene suddivisa per un'identificazione più precisa. Questo meccanismo adattivo mantiene la granularità del monitoraggio ottimale.
- La bassa latenza dell'NVMe riduce al minimo il sovraccarico di trasferimento: il controller NVMe legge e scrive direttamente sulla DRAM tramite PCIe senza l'intervento della CPU, consumando pochissime risorse di interrupt della CPU. L'hardware NVMe offre vantaggi significativi: le latenze sono comprese tra 10 e 100 μs (molto inferiori rispetto agli SSD/HDD SATA) e la larghezza di banda PCIe 4.0 NVMe raggiunge fino a 7 GB/s, circa un decimo della DRAM e di gran lunga superiore alle soluzioni di archiviazione tradizionali.
La gestione a livelli della memoria riduce al minimo l'impatto sulle prestazioni principalmente attraverso una gestione trasparente alle applicazioni, una pianificazione intelligente e NVMe a bassa latenza, garantendo che la CPU operi sempre su percorsi ad alta velocità. In combinazione con l'ottimizzazione del percorso I/O del kernel e l'ereditarietà trasparente dell'affinità locale NUMA , la capacità di memoria complessiva del server viene raddoppiata, mantenendo al contempo cali di prestazioni effettivi al di sotto del 10%.
Dimostrazione dal vivo: la gestione della tiering della memoria in azione
Raddoppia la memoria del server con una perdita di prestazioni di solo il 6% | Testato con la funzionalità di tiering della memoria HCI di Sangfor.
- Prima del Memory Tiering: 256 GB di memoria fisica, fino al 73% di utilizzo. TPS (transazioni al secondo) del database Oracle: oltre 15000.
- Dopo il Memory Tiering: 128 GB di memoria fisica + 128 GB di memoria di tiering, equivalenti a una capacità di memoria di 256 GB. La media delle transazioni al secondo (TPS) di Oracle Database è rimasta stabile intorno a 14000, con un calo delle prestazioni saldamente controllato entro il 10%.
Guida pratica all'implementazione: scenari applicabili e raccomandazioni di pianificazione
Scenari applicabili
- Scenari ideali: la stratificazione della memoria è adatta a casi d'uso che richiedono un'elevata capacità di memoria totale, con modelli di accesso ai dati "caldi" e "freddi" ben definiti, sensibilità ai costi e tolleranza a lievi latenze occasionali. Esempi includono ambienti di sviluppo e test, servizi di caching non di base e cluster di microservizi a carico medio-basso.
- Sconsigliato per: Non è adatto ad applicazioni critiche estremamente sensibili alla latenza di accesso, con modelli di accesso densi e uniformi, e che richiedono un jitter estremamente basso e un'elevata stabilità. Esempi includono sistemi di trading in tempo reale, database di trading ad alta frequenza, database in memoria e database OLTP ad alta frequenza.
La soluzione Memory Tiering di Sangfor consente di abilitare o disabilitare la funzionalità a livello di macchina virtuale (VM) . Gli utenti possono attivare o disattivare il Memory Tiering per VM specifiche in base al tipo di attività e alle caratteristiche, consentendo un controllo preciso sia sulle prestazioni che sui costi. Se in futuro i prezzi dell'hardware dovessero diminuire, gli utenti potranno scalare la capacità online senza vincoli con un fornitore specifico o preoccupazioni relative a futuri aggiornamenti.
Migliori pratiche per la pianificazione della stratificazione della memoria
Per bilanciare l'espansione della memoria con la stabilità delle prestazioni aziendali, il rapporto consigliato tra DRAM e memoria a livelli (Tiered Memory) è di 1:1 . Questo rapporto soddisfa le esigenze della maggior parte degli scenari aziendali, raddoppiando con successo la capacità di memoria e mantenendo le fluttuazioni delle prestazioni entro un intervallo accettabile.
In un contesto di mercato in cui i prezzi dell'hardware di memoria rimangono elevati, la stratificazione della memoria non è più solo uno strumento di ottimizzazione delle prestazioni, ma una strategia di controllo dei costi estremamente efficace. Gli utenti possono ridurre drasticamente i budget per l'acquisto di hardware di memoria senza compromettere le prestazioni aziendali principali, massimizzando il valore di riutilizzo delle risorse IT esistenti per affrontare con serenità la duplice sfida della crescita della potenza di calcolo e della gestione dei costi IT.