En los últimos dos años, la planificación de la memoria empresarial se ha convertido discretamente en uno de los problemas más difíciles del diseño de infraestructuras. El auge de las cargas de trabajo de IA y el rápido cambio de la capacidad de semiconductores hacia la memoria de alto ancho de banda (HBM) han disparado los precios de la DRAM para servidores en más de un 170 % interanual , y los analistas del sector advierten que la escasez de suministro y los precios elevados podrían persistir al menos hasta 2027.
Sin embargo, en entornos de producción reales, la utilización de la memoria presenta una realidad distinta. En plataformas virtualizadas y nativas de la nube, aplicaciones como los servicios basados en JVM, las plataformas de middleware, el big data y el aprendizaje automático tienden a reservar grandes espacios de memoria por adelantado, aunque solo una parte de esa memoria se utiliza activamente en un momento dado. Las páginas restantes permanecen inactivas durante largos periodos, consumiendo costosa capacidad de DRAM sin contribuir directamente al rendimiento.
Esta brecha entre la memoria asignada y la memoria en uso activo es donde surge un nuevo enfoque de optimización.
La estratificación de la memoria se basa en una observación simple pero poderosa: no todas las páginas de memoria son iguales. Si los datos de acceso frecuente ("calientes") pueden permanecer en la DRAM de alta velocidad, mientras que los datos de acceso poco frecuente ("fríos") se ubican de forma transparente en un medio de menor costo y alto rendimiento, la capacidad total de la memoria puede expandirse significativamente sin aumentar proporcionalmente el costo del hardware.
Sin embargo, esta idea plantea de inmediato cuestiones críticas para los usuarios empresariales:
- ¿Es posible ampliar la memoria más allá de la DRAM física sin desestabilizar el rendimiento?
- ¿Cómo identifica el sistema con precisión la memoria caliente y la memoria fría, sin generar una sobrecarga elevada en la CPU?
- Cuando se vuelve a acceder a los datos que no se utilizan habitualmente, ¿con qué rapidez pueden regresar a la memoria de alta velocidad y lo notarán las aplicaciones?
Estas preocupaciones son válidas. La memoria se encuentra en la ruta crítica del rendimiento de la aplicación, y cualquier optimización en esta capa debe ser precisa y predecible.
En este artículo, analizamos en detalle la tecnología de estratificación de memoria de Sangfor, tanto desde un punto de vista práctico como técnico. Explicaremos por qué la estratificación de memoria se puede realizar de forma segura, cómo colaboran la DRAM y la NVMe a nivel de sistema y qué principios de diseño garantizan un control estricto del impacto en el rendimiento. Asimismo, describiremos los escenarios en los que la estratificación de memoria aporta un valor evidente y aquellos en los que debe utilizarse con precaución.
Nuestro objetivo no es exagerar las ventajas de un concepto, sino proporcionar un marco transparente que ayude a los arquitectos de TI y a los responsables de la toma de decisiones a determinar si la estratificación de la memoria es la adecuada para sus entornos.
¿Por qué se puede clasificar la memoria en "niveles"?
En el ámbito de la optimización de la memoria empresarial, las soluciones tradicionales como el aumento de memoria dinámica, el uso compartido transparente de páginas, la compresión de memoria y la sobreasignación de memoria pueden mejorar la utilización de la memoria física y aliviar la presión hasta cierto punto. Sin embargo, esta mejora es limitada. A medida que las empresas crecen, se requieren nuevos enfoques tecnológicos para ampliar la capacidad de memoria disponible del sistema.
En entornos nativos de la nube y virtualizados, las aplicaciones (como las JVM, los servicios de caché y el middleware) suelen reservar una gran cantidad de memoria. Sin embargo, la memoria verdaderamente "activa", que se lee y escribe con frecuencia, representa solo alrededor del 50%, mientras que el resto permanece en un estado de bajo acceso o "inactivo".
Partiendo de esta característica fundamental, nació la solución de estratificación de memoria. Al dividir los datos de memoria en un nivel de datos de acceso frecuente y otro de acceso poco frecuente según la frecuencia de acceso, se crea un conjunto unificado de recursos de memoria mediante DRAM física y SSD NVMe de alto rendimiento. Gracias a algoritmos de planificación inteligentes que enrutan dinámicamente los datos de acceso frecuente y poco frecuente, podemos superar las limitaciones de la memoria física sin comprometer el rendimiento empresarial principal.
¿Cómo colaboran de forma inteligente la DRAM y la NVMe?
La solución Memory Tiering de Sangfor adopta una arquitectura central de "Grupo de memoria multinivel + Motor de planificación inteligente" para lograr una colaboración altamente eficiente entre la DRAM y las unidades SSD NVMe. Esto permite una gestión jerárquica de la memoria y una planificación dinámica con una sobrecarga del sistema extremadamente baja.
Diseño de arquitectura de grupos de memoria de múltiples niveles
- Nivel 0 (Nivel de datos críticos): La memoria DRAM de alta velocidad gestiona los datos críticos de alta frecuencia y sensibles a la latencia, sirviendo como garantía fundamental para el rendimiento empresarial.
- Nivel 1 (Nivel de datos inactivos): La tecnología NVMe de alto rendimiento actúa como una capa de expansión de memoria, transportando datos "inactivos" de baja frecuencia para lograr una expansión elástica de la capacidad de memoria.
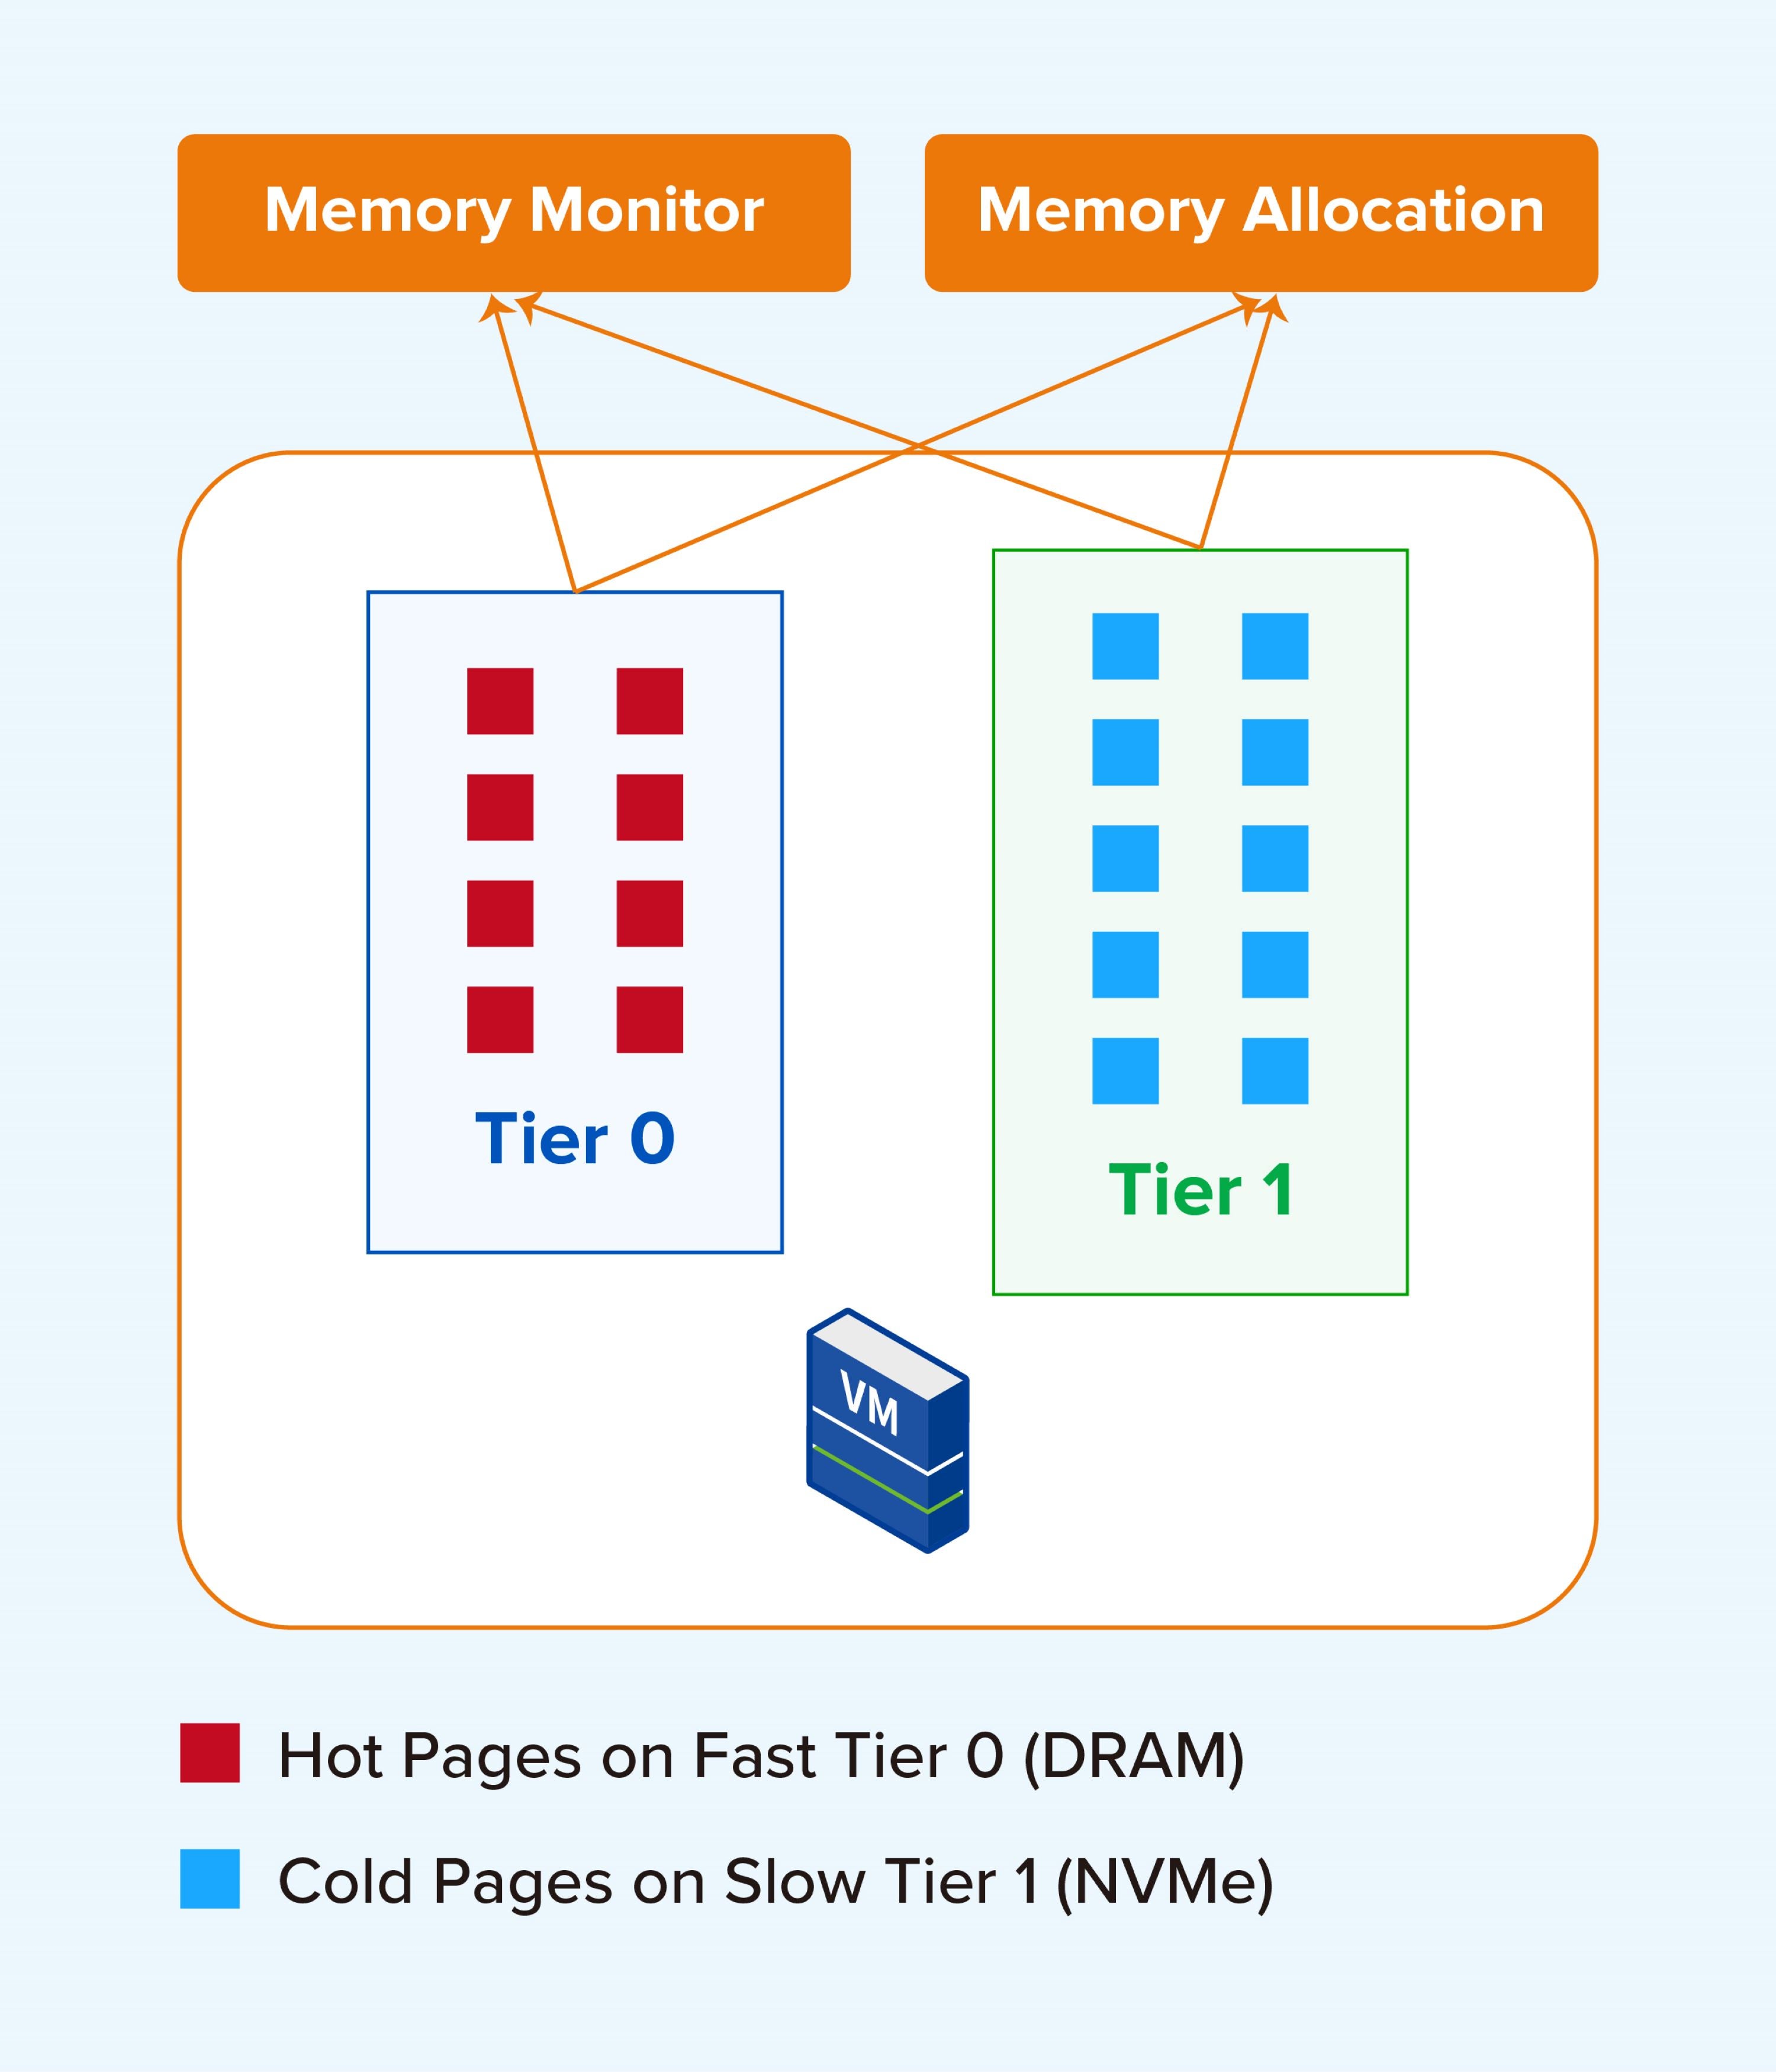
Diseño de arquitectura de grupos de memoria de múltiples niveles
Motor de programación inteligente
El motor de planificación inteligente es el núcleo de la solución de estratificación de memoria. Mediante la tecnología de "particionamiento dinámico de regiones + muestreo aleatorio disperso", evalúa la distribución global de la memoria caliente y fría con una mínima sobrecarga del sistema, lo que permite una identificación precisa y una planificación dinámica.
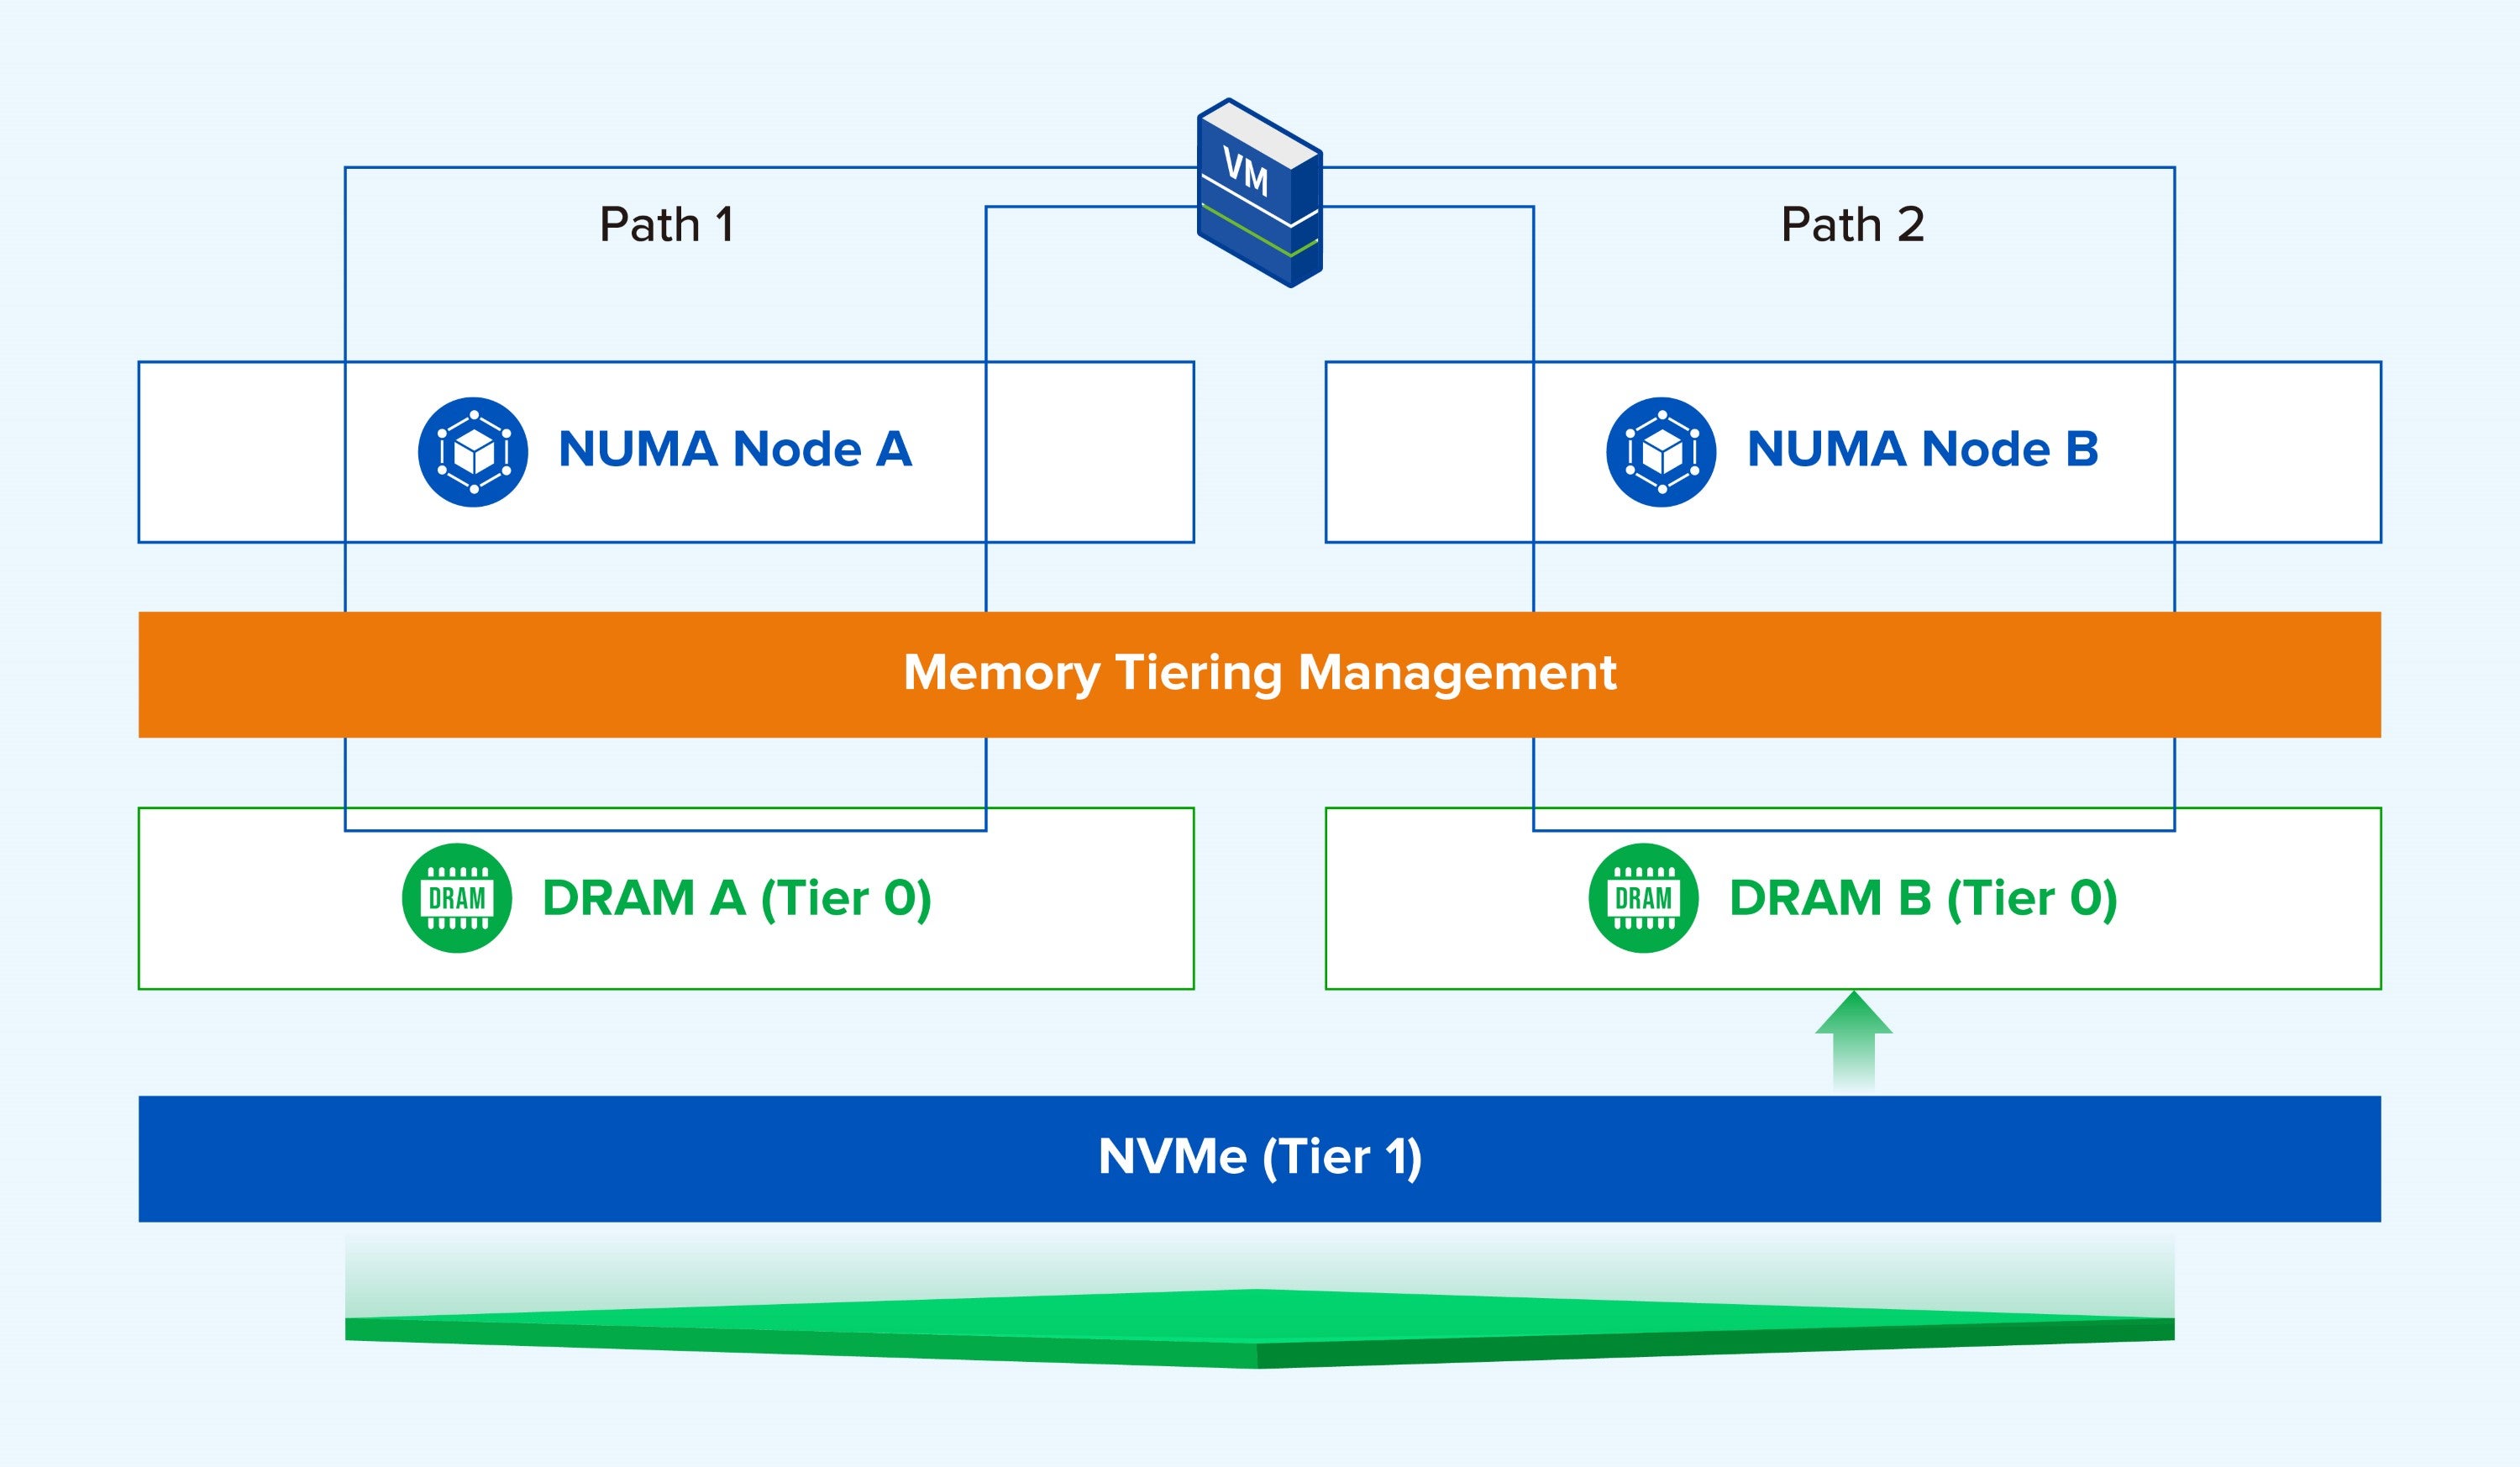
La ruta de acceso de la CPU a la memoria
Consta de tres capacidades principales:
- Identificación precisa de datos activos/inactivos (segmentación precisa): Mediante la detección continua de calor, mapea el conjunto de datos activos reales de la empresa en tiempo real. Distingue con precisión qué datos activos deben permanecer en la DRAM de alta velocidad y qué páginas inactivas pueden degradarse de forma segura.
- Migración de memoria automatizada (rápida): Ejecuta automáticamente la "degradación de datos inactivos" y la "promoción de datos activos". Esto libera espacio en la memoria DRAM para las aplicaciones principales, al tiempo que garantiza que los datos reactivados regresen instantáneamente al nivel activo para asegurar un rendimiento de acceso sin interrupciones.
- Observabilidad de enlace completo (visibilidad clara): Supervisa continuamente la distribución del calor de la memoria, el comportamiento de la migración de páginas y el estado de acceso al nivel menos utilizado para ofrecer una capacidad de observabilidad integral. Estos datos de supervisión ayudan a las operaciones de TI a identificar posibles riesgos de rendimiento y proporcionan una base sólida para la optimización de políticas y la planificación de capacidad.
Flujo de datos calientes y fríos entre DRAM y NVMe
- DRAM → NVMe (Degradación de página inactiva): Una vez que el sistema identifica una página inactiva de bajo acceso, se agrega a la cola de candidatos para la migración de páginas inactivas. El sistema asigna espacio de almacenamiento NVMe, escribe los datos de la página desde la DRAM a la SSD NVMe y actualiza de forma síncrona la asignación de memoria. Una vez migrada, se libera el espacio DRAM correspondiente, lo que garantiza que la memoria de alta velocidad tenga prioridad para los datos activos.
- NVMe → DRAM (Promoción de Páginas Activas): Cuando una aplicación vuelve a acceder a una página que previamente se había relegado a la capa de memoria NVMe de acceso poco frecuente, el sistema detecta la solicitud en tiempo real y activa el proceso de promoción. Lee los datos de la página de destino desde NVMe a la DRAM y actualiza la asignación de memoria de forma síncrona, lo que permite que los datos reactivados accedan a la capa de memoria de alta velocidad y se restablezca el rendimiento normal.
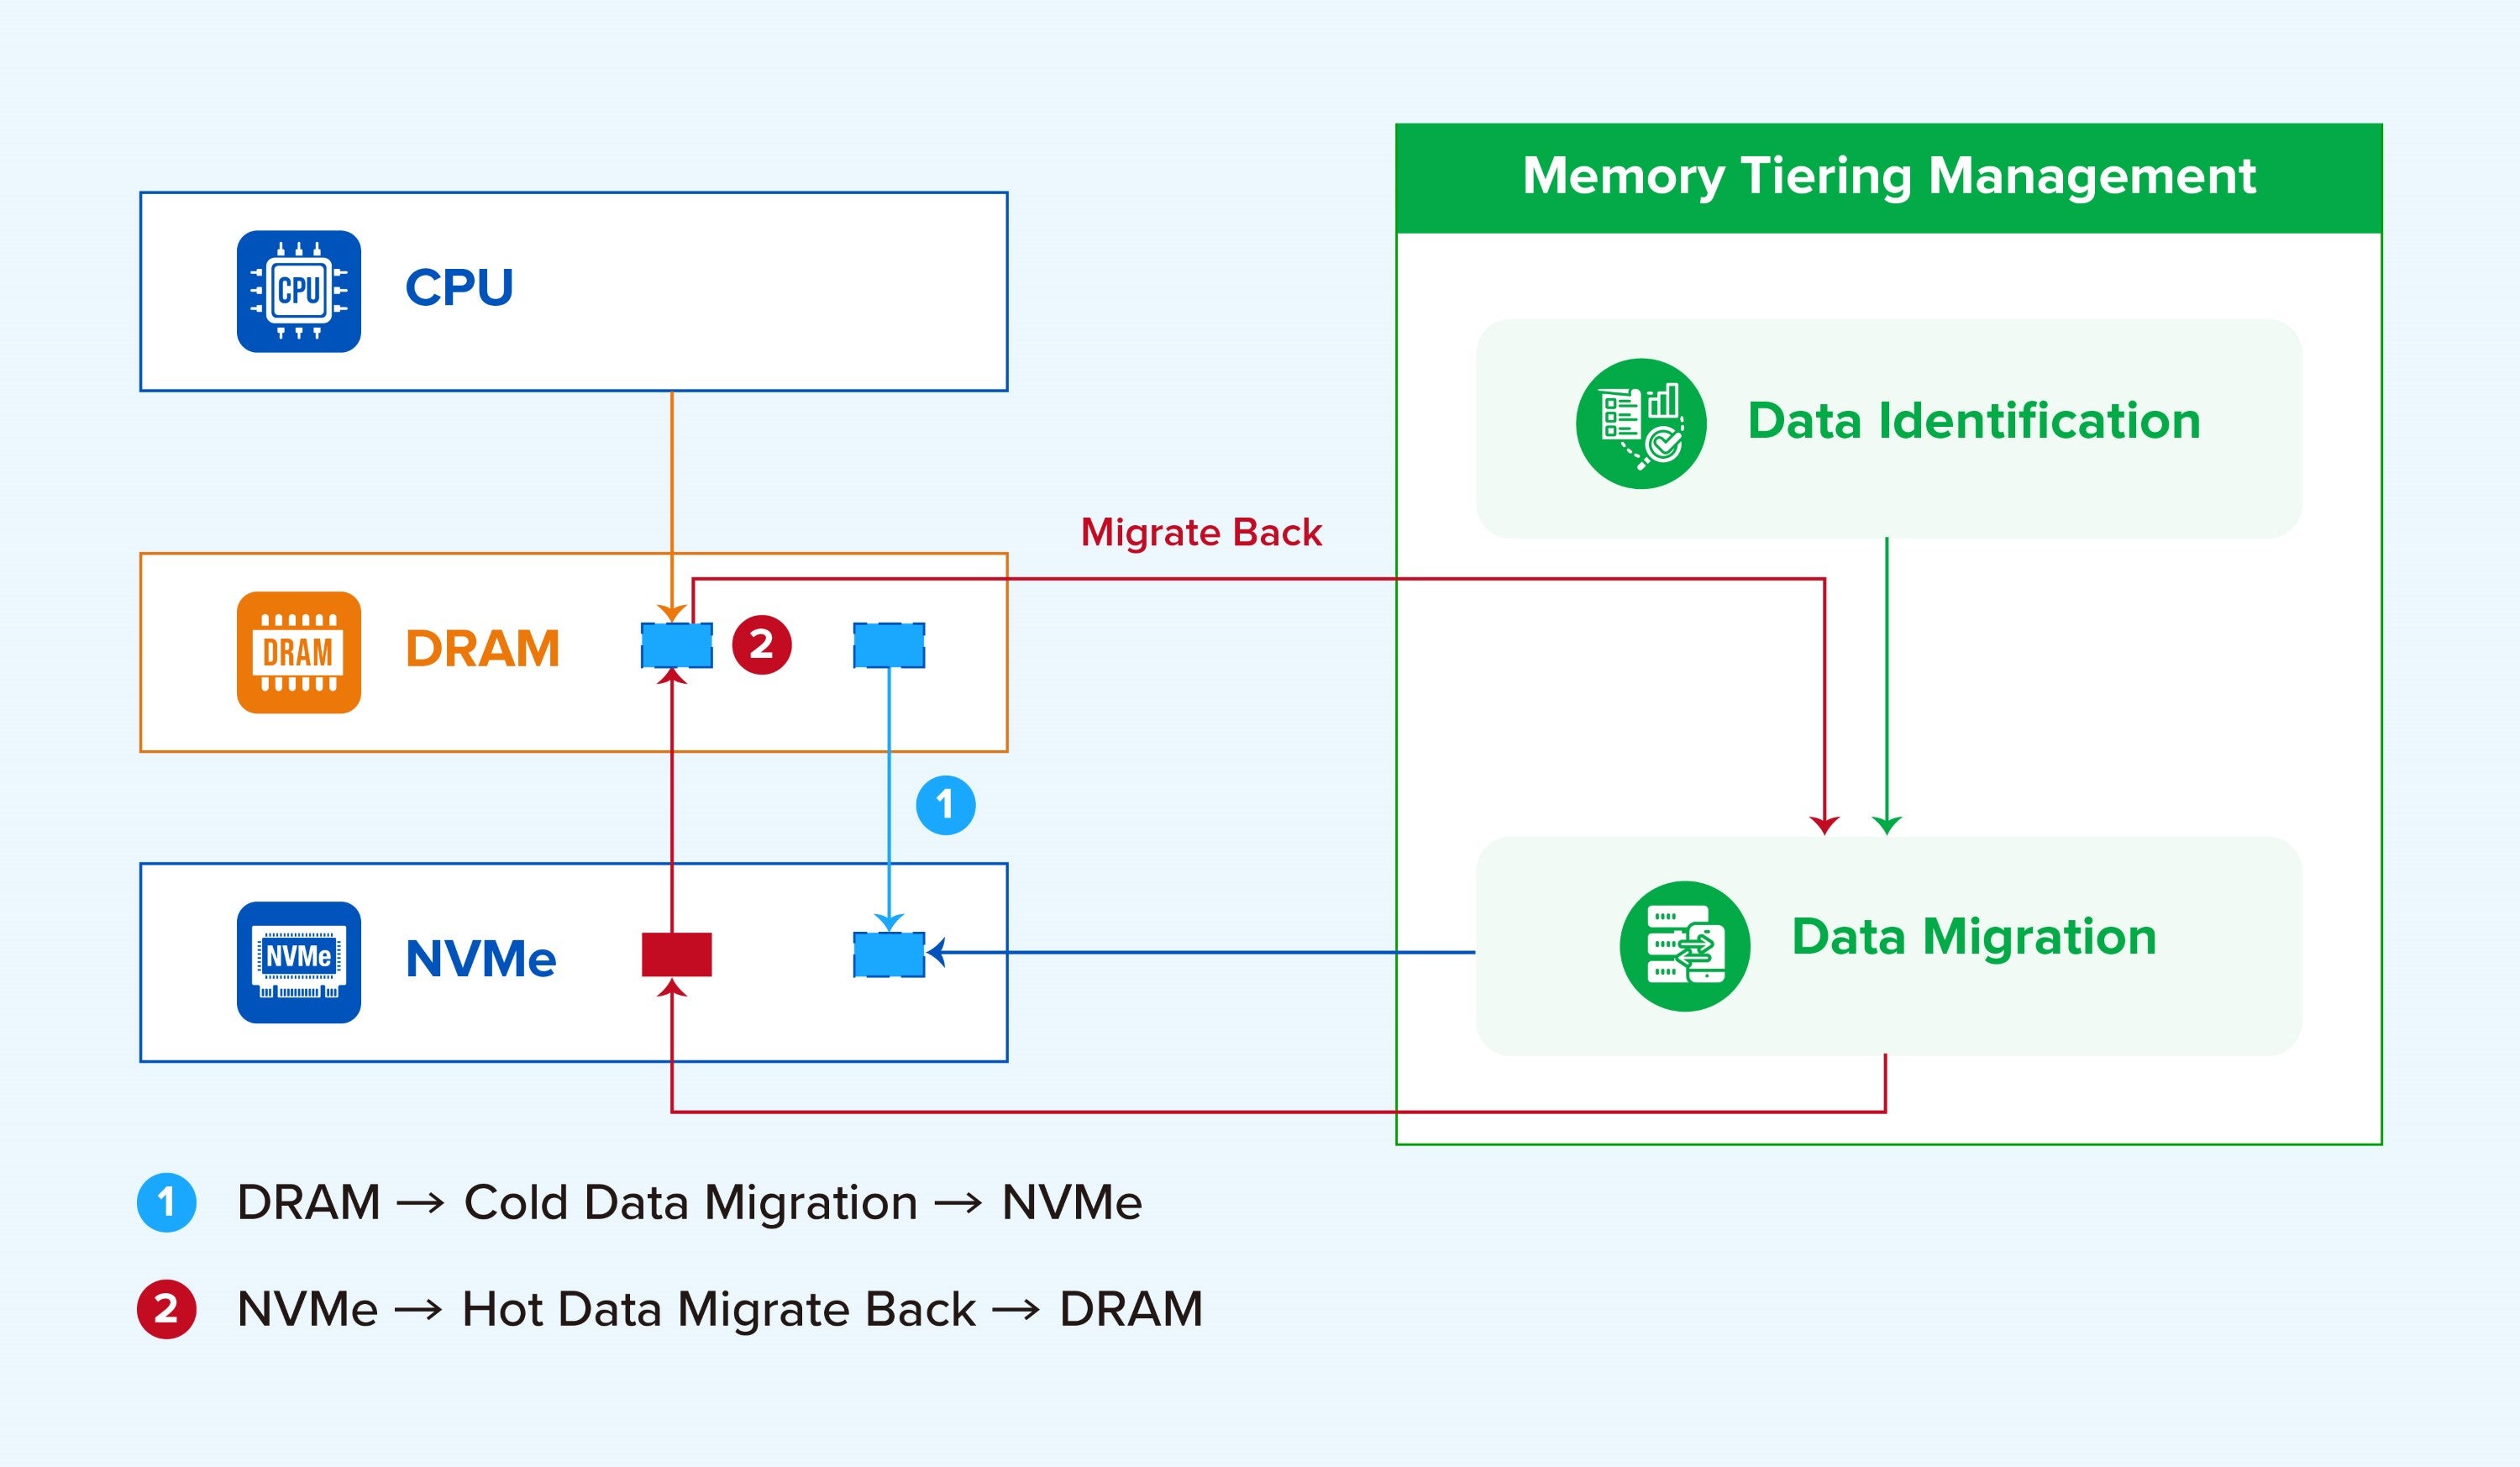
Mecanismos de migración de datos
¿Cómo accede la CPU a la memoria por niveles? Minimizando la pérdida de rendimiento.
El reto técnico de la estratificación de la memoria reside en cómo identificar rápidamente los datos, programar las páginas y permitir que la CPU acceda rápidamente a la memoria una vez que esta se ha estratificado.
En esta arquitectura, el dispositivo NVMe no se utiliza como almacenamiento tradicional, sino como una capa de memoria fría debajo de la DRAM. Por lo tanto, todas las operaciones de acceso a la memoria de la CPU se completan finalmente a través de la DRAM. Las rutas de acceso se dividen en dos tipos:
- Ruta 1: Acceso a página caliente: La CPU inicia el acceso → DRAM local/remota → Devuelve datos.
- Ruta 2: Fallo de página fría: La CPU inicia el acceso → La página de destino no está en el nivel caliente de DRAM → El sistema recupera la página de NVMe de vuelta a DRAM → La CPU accede a la página.
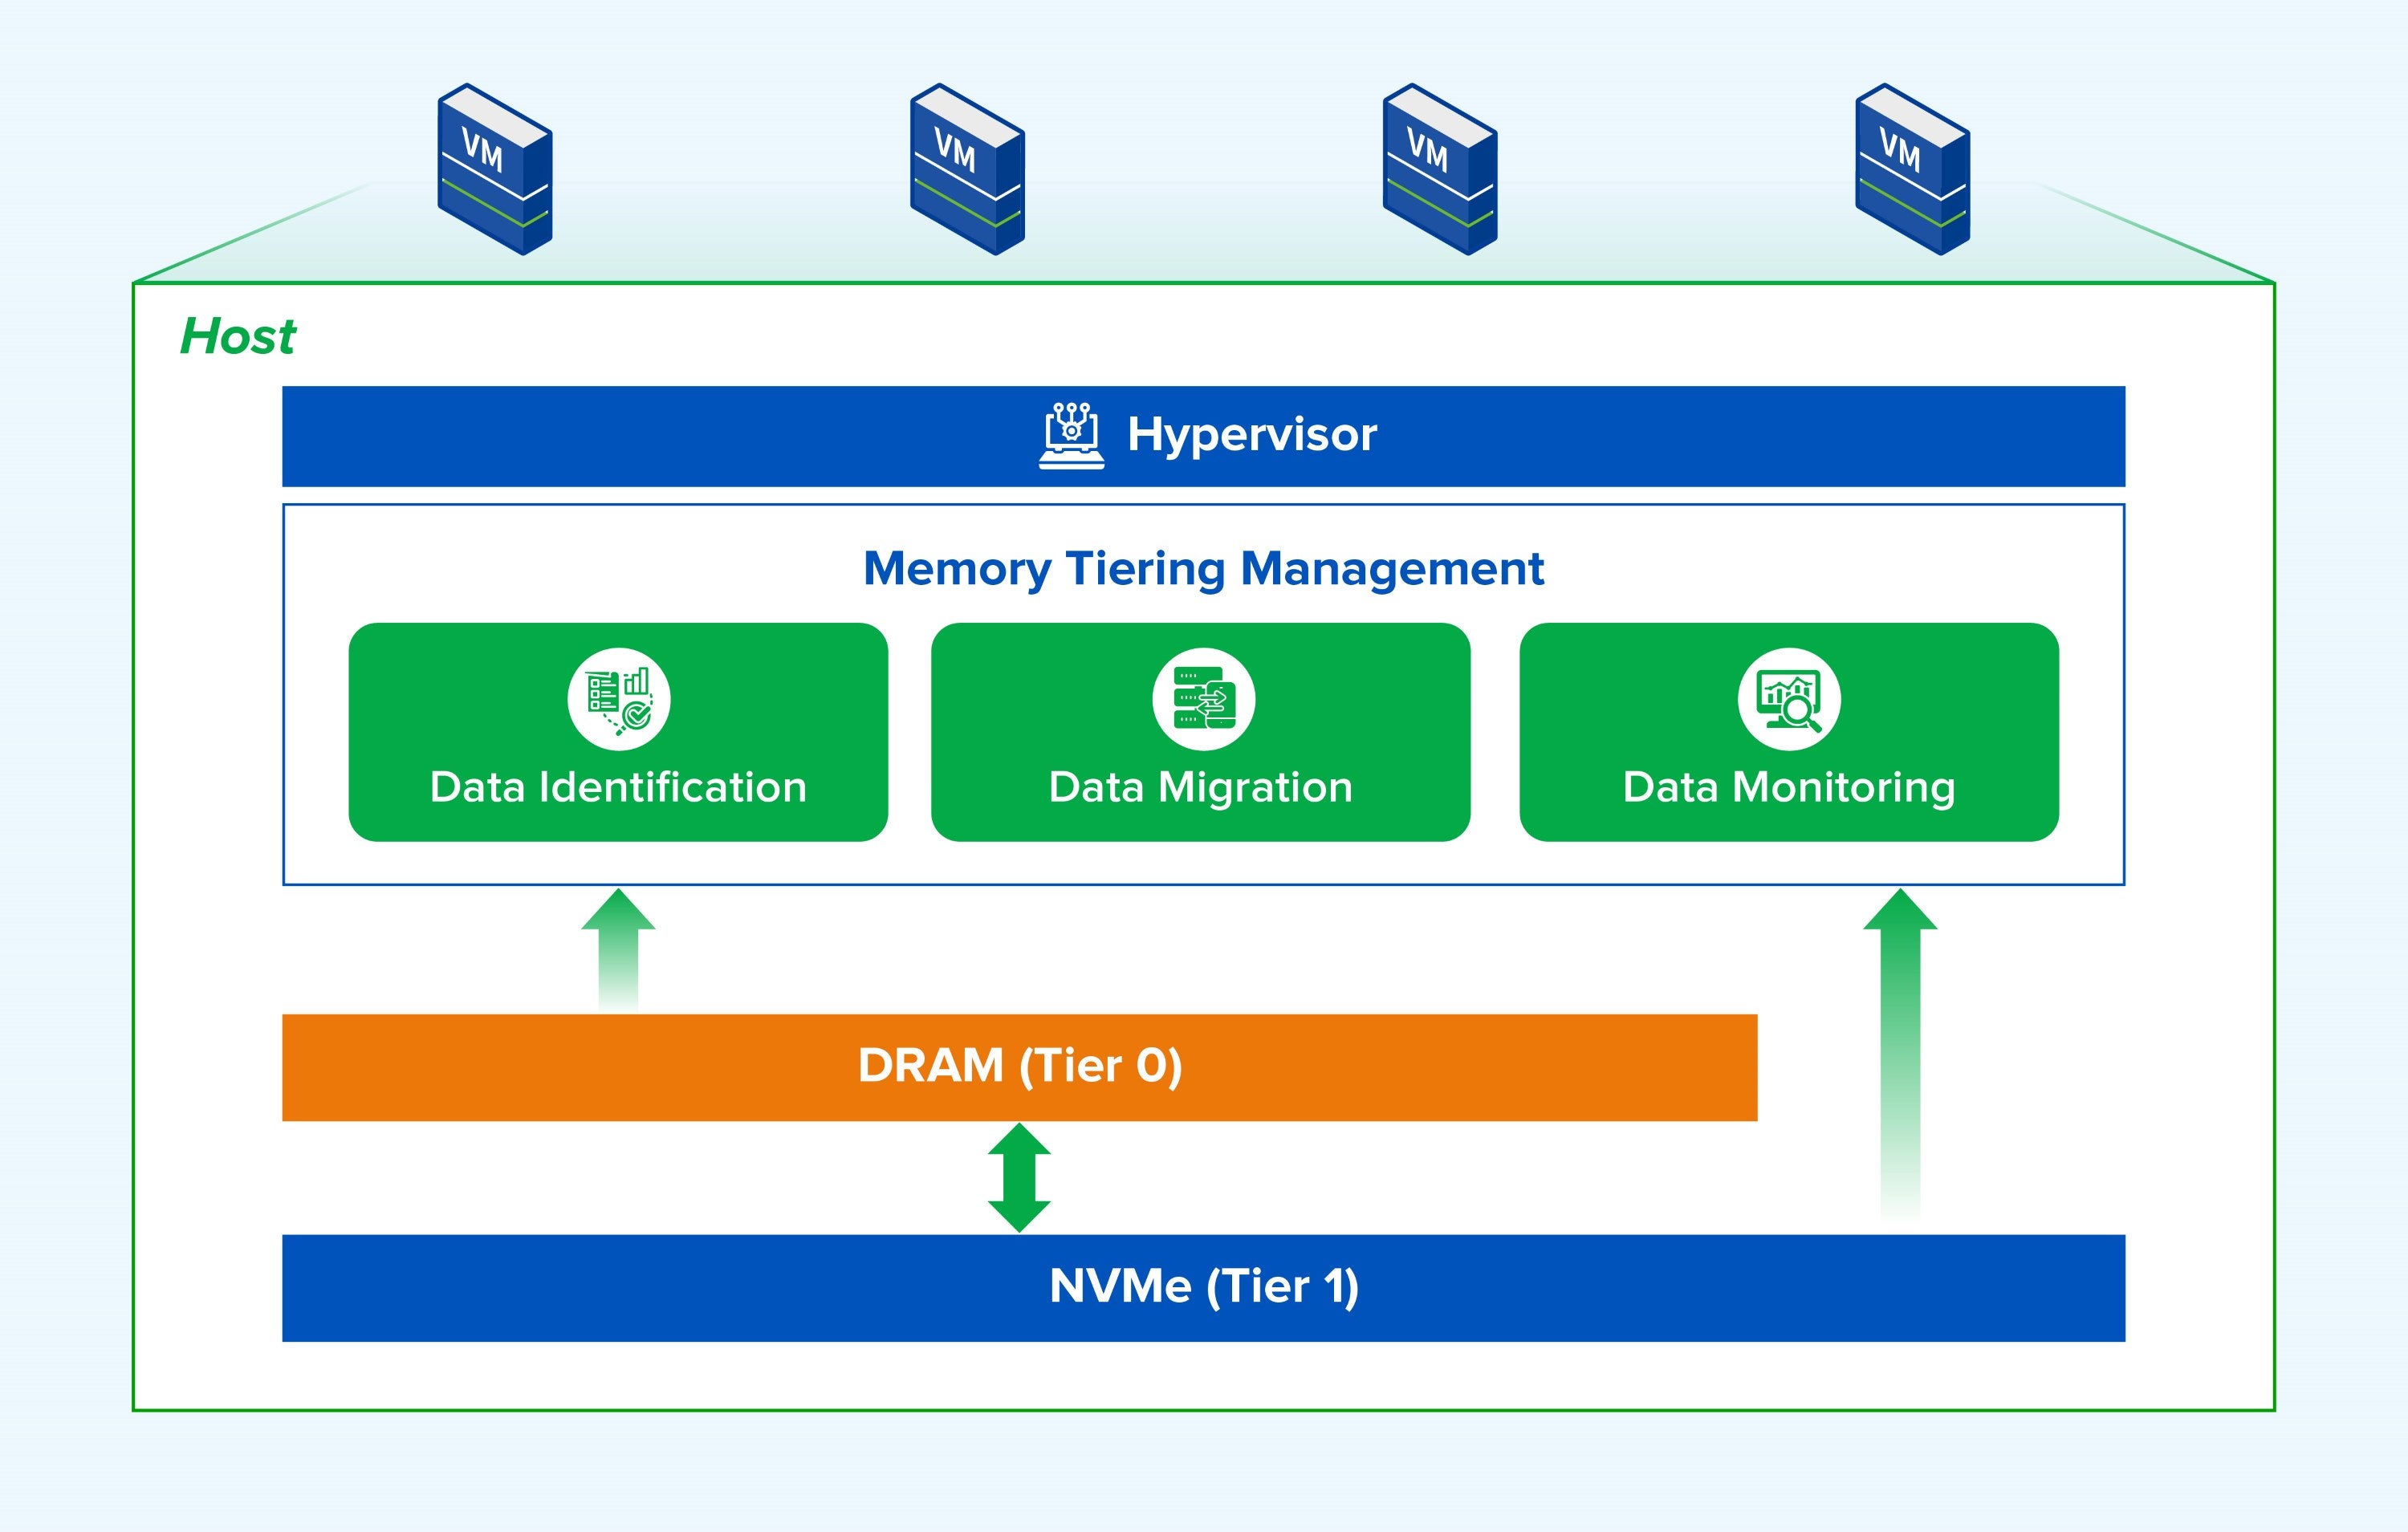
Arquitectura de estratificación de memoria
Dado que la CPU del servidor no accede directamente a NVMe, ¿cómo minimizamos el impacto en el rendimiento? Para abordar las preocupaciones sobre el rendimiento posterior a la estratificación, el sistema garantiza la estabilidad del negocio mediante los siguientes mecanismos:
- Espacio de direcciones unificado y acceso transparente: Esto es completamente transparente para las aplicaciones. Al acceder a una página activa en la DRAM, se trata de un acceso directo sin sobrecarga adicional. Al acceder a una página inactiva en NVMe, se activa una interrupción por fallo de página; el núcleo del sistema operativo recupera rápidamente los datos de NVMe y los transfiere a la DRAM, permitiendo el acceso a la CPU. La CPU opera sin saber si los datos estaban en la DRAM o en NVMe; el núcleo se encarga de todo.
- Programación inteligente y ajuste dinámico de regiones: El sistema ajusta dinámicamente la estructura de regiones en función de los resultados de la monitorización para equilibrar la precisión y la carga del sistema. Cuando las regiones adyacentes presentan patrones de acceso similares, se fusionan automáticamente para reducir la cantidad de objetos monitorizados. Al detectar puntos críticos dentro de una región, esta se divide para una identificación más precisa. Este mecanismo adaptativo mantiene una granularidad de monitorización óptima.
- La baja latencia de NVMe minimiza la sobrecarga de transferencia: el controlador NVMe lee y escribe en la DRAM directamente a través de PCIe sin intervención de la CPU, consumiendo muy pocos recursos de interrupción de la CPU. El hardware NVMe ofrece ventajas significativas: las latencias se sitúan entre 10 y 100 μs (mucho más bajas que las de las unidades SSD/HDD SATA), y el ancho de banda de NVMe PCIe 4.0 alcanza hasta 7 GB/s, aproximadamente una décima parte de la DRAM y muy superior al almacenamiento tradicional.
La estratificación de la memoria minimiza el impacto en el rendimiento principalmente mediante una gestión transparente para las aplicaciones, una planificación inteligente y NVMe de baja latencia, lo que garantiza que la CPU siempre opere en rutas de alta velocidad. Combinado con la optimización de la ruta de E/S del kernel y la herencia perfecta de la afinidad local NUMA , la capacidad total de memoria del servidor se duplica, mientras que la caída real del rendimiento se mantiene de forma fiable por debajo del 10 %.
Demostración en vivo: La gestión de memoria por niveles en acción.
Duplica la memoria del servidor con solo un 6 % de pérdida de rendimiento | Prueba de niveles de memoria de Sangfor HCI
- Antes de la optimización de la memoria: 256 GB de memoria física, hasta un 73 % de utilización. Transacciones por segundo (TPS) de la base de datos Oracle: más de 15 000.
- Tras la optimización de la memoria: 128 GB de memoria física + 128 GB de memoria de optimización, equivalente a una capacidad de memoria de 256 GB. El promedio de TPS de Oracle Database se mantuvo estable en torno a 14000, con una caída del rendimiento controlada de forma segura dentro del 10 %.
Guía práctica de implementación: escenarios aplicables y recomendaciones de planificación
Escenarios aplicables
- Escenarios ideales: La estratificación de memoria es adecuada para casos de uso que requieren una gran capacidad total de memoria, con patrones de acceso a datos distintos (tanto en caliente como en frío), sensibilidad al costo y tolerancia a latencias leves y ocasionales. Algunos ejemplos incluyen entornos de desarrollo y pruebas, servicios de almacenamiento en caché no esenciales y clústeres de microservicios con carga baja a media.
- No recomendado para: No es adecuado para aplicaciones críticas que sean extremadamente sensibles a la latencia de acceso, presenten patrones de acceso densos y uniformes, y requieran una fluctuación mínima y una alta estabilidad. Algunos ejemplos son los sistemas de negociación en tiempo real, las bases de datos de negociación de alta frecuencia, las bases de datos en memoria y las bases de datos OLTP de alta frecuencia.
La solución Memory Tiering de Sangfor permite activar o desactivar la función a nivel de máquina virtual (VM) . Los usuarios pueden configurar de forma flexible la asignación de niveles de memoria para máquinas virtuales específicas según su tipo y características de negocio, lo que permite un control preciso tanto del rendimiento como del coste. Si los precios del hardware bajan en el futuro, los usuarios pueden aumentar la capacidad en línea sin depender de un proveedor específico ni preocuparse por futuras actualizaciones.
Buenas prácticas para la planificación de la estratificación de la memoria
Para equilibrar la expansión de la memoria con la estabilidad del rendimiento empresarial, la proporción recomendada de DRAM a memoria por niveles es de 1:1 . Esta proporción cubre las necesidades de la mayoría de los escenarios empresariales, duplicando con éxito la capacidad de memoria y manteniendo las fluctuaciones de rendimiento dentro de un rango aceptable.
En un mercado donde los precios del hardware de memoria siguen siendo elevados, la estratificación de la memoria ya no es solo una herramienta de optimización del rendimiento, sino una estrategia de control de costes altamente eficaz. Los usuarios pueden reducir drásticamente los presupuestos de adquisición de hardware de memoria sin sacrificar el rendimiento empresarial principal, maximizando el valor de reutilización de los activos de TI existentes para afrontar con tranquilidad el doble reto del crecimiento de la capacidad de procesamiento y la gestión de los costes de TI.