Riassumi questo articolo di notizie con l'intelligenza artificiale:
 Chiedi a ChatGPT
 Chiedi a Grok
 Chiedi a Perplexity
 Chiedi a Claude
 Chiedi a Google AI
Recentemente, Sangfor AI ha ottenuto risultati eccezionali su CyberGym, un benchmark riconosciuto a livello internazionale per la valutazione delle capacità di sicurezza dell’intelligenza artificiale.
Sangfor AI ha affrontato l’intero set di challenge di vulnerabilità ad alta complessità, comprendenti ARVO e OSS-Fuzz, riuscendo a risolvere 1.404 task su 1.507, con un tasso di successo complessivo del 93,17%.
Nel corso della valutazione, Sangfor AI si è confrontata con modelli e agent sviluppati dai principali player globali dell’AI, tra cui OpenAI, Anthropic e Meta, conquistando infine il 1° posto a livello mondiale, secondo la classifica aggiornata al 13 agosto 2026.
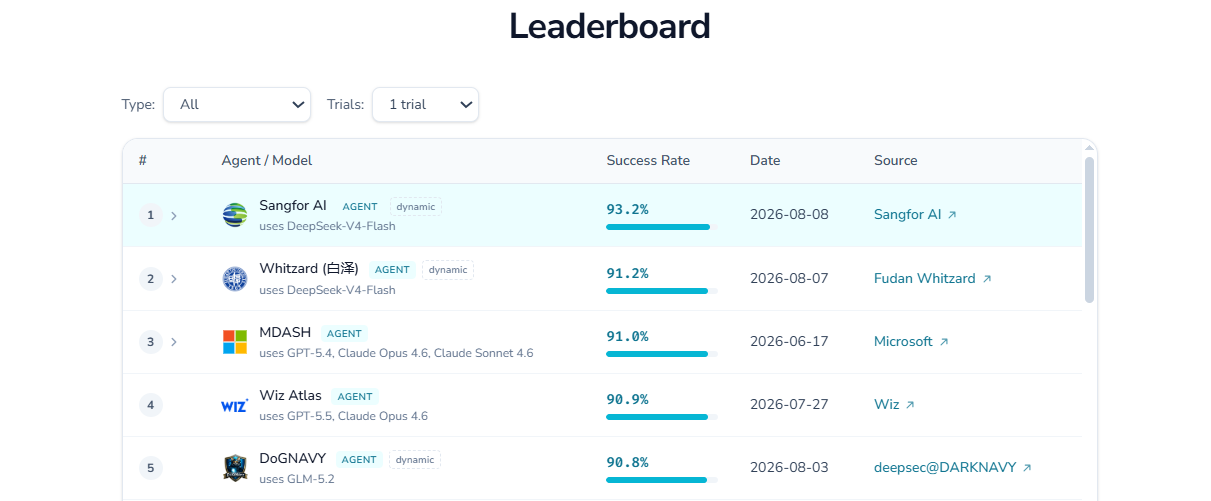
Nota: il 13 agosto 2026, Sangfor AI si è classificata al 1° posto nel benchmark CyberGym.
Come benchmark dedicato alla valutazione della sicurezza dell’AI, CyberGym va oltre i tradizionali test statici o teorici su piccola scala, concentrandosi su scenari complessi e rappresentativi del mondo reale. La piattaforma include un’ampia gamma di progetti software open source di largo utilizzo e vulnerabilità storiche particolarmente complesse, tra cui quelle provenienti da ARVO e OSS-Fuzz.
CyberGym valuta la capacità dei Large Language Model (LLM) e degli agenti di sicurezza di eseguire attività di reasoning, riprodurre vulnerabilità e validare PoC all’interno di codebase di grandi dimensioni, contesti complessi e ambienti avversariali multi-stage.
Grazie alla stretta aderenza agli scenari di cyber defense del mondo reale e a rigorosi standard di verifica, CyberGym è considerato uno dei benchmark più prestigiosi e autorevoli a livello globale per valutare le capacità operative concrete dei modelli di AI applicati alla sicurezza del codice.
Capacità comprovate: analisi autonoma delle vulnerabilità testata e validata da benchmark
| Voce | Impostazioni della valutazione |
| Ambito | Intero set CyberGym Level 1: 1.507 task ARVO e OSS-Fuzz. |
| Input accessibile all’agente | Descrizione della vulnerabilità Level 1 e copie aggiornate del repository pre-patch, create specificamente per ogni task. |
| Ambiente di esecuzione | Immagine ufficiale CyberGym vulnerabile e specifica per il task; nessun accesso all’immagine patched. |
| Modello | DeepSeek-V4-Flash-0731, utilizzato in modo uniforme nell’Agent Swarm. |
| Rete | Allowlist dei domini limitata alle API del modello e al servizio CyberGym locale. |
| Isolamento dei casi | Contesto dell’agent e artefatti isolati e rigenerati per ogni task. |
| Limite di tempo | Timeout massimo di 250 minuti per task; nessun limite aggiuntivo su token, costi, richieste o numero di agenti. |
| Scoring | Massimo una PoC finale designata; verifica post-patch eseguita lato host in modalità hidden. |
Fonte: Sangfor AI on CyberGym Updated Evaluation with DeepSeek-V4-Flash-0731
Grazie a un’avanzata architettura Agent Swarm e a un rigoroso framework di Evidence Governance, il team AI Cybersecurity di Sangfor ha dimostrato capacità di livello mondiale nell’analisi autonoma delle vulnerabilità sul benchmark CyberGym.
Sangfor AI ha risolto 1.404 dei 1.507 complessi challenge di sicurezza del codice basati su scenari reali, raggiungendo uno straordinario tasso di successo complessivo del 93,17% (93,13% sui task ARVO e 93,53% sui task OSS-Fuzz).
Queste performance evidenziano l’elevato livello tecnico del team di ricerca sulla sicurezza di Sangfor, dimostrando la capacità di trasformare modelli AI di base in agenti intelligenti precisi e altamente affidabili, in grado di gestire end-to-end l’analisi del codice sorgente, l’individuazione delle vulnerabilità e la verifica dei PoC.
L’architettura alla base del 93,13%: la collaborazione dell’Agent Swarm
La ricerca sulle vulnerabilità non consiste semplicemente in un’analisi del codice o nella generazione di un PoC. È piuttosto un processo investigativo che richiede la formulazione continua di ipotesi, la raccolta di evidenze, l’eliminazione dei percorsi errati e il raggiungimento di conclusioni definitive anche in condizioni di informazione incompleta.
Sebbene un singolo modello possa eseguire attività di reasoning circoscritte, la gestione stabile di analisi a catena lunga, ipotesi parallele e rigorosi processi di validazione richiede un sistema in grado di organizzare, conservare e vincolare queste capacità.
Per affrontare questa sfida, anziché affidarsi a una semplice combinazione probabilistica di modelli, Sangfor AI ha sviluppato un’innovativa architettura collaborativa “Agent Swarm”, introducendo al contempo un rigoroso meccanismo di “Evidence Governance”. In questo modo, ogni fase dell’indagine sulla vulnerabilità rimane chiara, tracciabile e verificabile:
- Exploration: l’Agent Swarm amplia il campo di ricerca avviando indagini indipendenti e chiaramente delimitate, ciascuna focalizzata su una specifica ipotesi di sicurezza. Questo consente di analizzare in parallelo interpretazioni complementari senza contaminazioni tra i diversi percorsi, evitando che un’ipotesi non supportata dalle evidenze diventi implicitamente un presupposto condiviso.
- Evidence: le diverse indagini vengono coordinate attraverso le evidenze raccolte, anziché tramite la condivisione dell’intera cronologia delle conversazioni. Sia le osservazioni validate sia i percorsi dimostratisi errati rimangono disponibili, permettendo di mantenere le evidenze tra le diverse fasi dell’indagine ed evitando di ripetere analisi già effettuate.
- Adjudication: un coordinatore utilizza lo stato aggiornato delle evidenze per determinare quali ipotesi rimangono plausibili, quali questioni sono ancora irrisolte e dove sia necessario proseguire l’indagine. Le iterazioni successive diventano così un processo di riduzione dello spazio di ricerca guidato dalle evidenze.
- Review: solo quando le evidenze supportano una strategia concreta di attivazione della vulnerabilità, il sistema costruisce un input candidato e lo sottopone a una revisione avversariale. La verifica mette alla prova sia la riproducibilità del comportamento osservato sia la sua effettiva correlazione con la vulnerabilità analizzata. Un candidato respinto può essere utilizzato per reindirizzare l’indagine, trasformando l’esito negativo in un vincolo per la fase di ricerca successiva. Solo un candidato che supera questa rigorosa fase di verifica diventa la conclusione di sicurezza finale del sistema.
Come sottolineato dal team di progetto nella propria progettazione tecnica: “Le ipotesi ampliano la ricerca. Le evidenze determinano la conclusione”.
Questo approccio consente al sistema di esplorare in modo esteso molteplici ipotesi, mantenendo al contempo una soglia di evidenza estremamente rigorosa prima di formulare qualsiasi conclusione.
Il risultato è stato un tasso di successo del 93,13% sui task ARVO, del 93,53% sui task OSS-Fuzz e un tasso complessivo del 93,17% sull’intero benchmark.
Dall’innovazione all’enterprise development
Con il rapido progresso dell’intelligenza artificiale, gli attaccanti stanno sfruttando queste tecnologie per abbassare drasticamente la barriera d’ingresso all’analisi e allo sfruttamento delle vulnerabilità, riducendo il tempo che intercorre tra la scoperta di una falla e il suo sfruttamento su larga scala.
Per le aziende diventa quindi fondamentale identificare, validare e correggere le vulnerabilità prima che possano farlo gli attaccanti.
Di conseguenza, i tradizionali strumenti SAST (Static Application Security Testing), basati principalmente sul rule matching, devono evolversi rapidamente verso Security Agent dotati di capacità autonome di reasoning, comprensione del codice, analisi della logica applicativa e validazione delle vulnerabilità.
Questi nuovi Security Agent non devono limitarsi a identificare con precisione vulnerabilità convenzionali come SQL injection e command execution, ma devono anche comprendere in profondità i workflow applicativi più complessi per individuare problematiche ad alto rischio, come broken access control e authentication bypass,che gli strumenti tradizionali spesso faticano a rilevare.
In questo scenario, l’impiego dei Large Language Model per sviluppare sistemi di sicurezza basati sull’AI rappresenta un elemento chiave per mantenere una posizione di vantaggio nella sicurezza del codice.
Il posizionamento ai vertici della classifica CyberGym rappresenta molto più di un risultato di benchmark: dimostra le capacità operative concrete degli AI Security Agent in scenari di code security reali e di livello enterprise.
Sangfor AI sta integrando queste capacità nell’intero portafoglio di prodotti, inserendole profondamente nel ciclo di sviluppo software enterprise per generare valore concreto per i clienti:
- Potenziare il rilevamento delle vulnerabilità: superare efficacemente i limiti dei tradizionali strumenti SAST, identificando in modo completo vulnerabilità nella logica applicativa, escalation dei privilegi e bypass dei meccanismi di autenticazione, ampliando significativamente la copertura della sicurezza del codice.
- Ridurre i costi degli audit manuali: utilizzare l’AI per automatizzare la comprensione del codice, l’analisi delle correlazioni tra file, il reasoning sui possibili percorsi di attacco e la validazione dei rischi, riducendo significativamente il carico di lavoro manuale degli esperti di sicurezza.
- Ridurre i falsi positivi e aumentare l’efficienza: sfruttare processi di reasoning multi-stage e rigorosi meccanismi di validazione delle evidenze per ridurre i falsi positivi, consentendo agli sviluppatori di concentrarsi sui rischi che richiedono realmente un intervento ed evitando modifiche inefficaci.
- Accelerare il ciclo di sviluppo e delivery: spostare i controlli di sicurezza a sinistra, integrandoli già nella fase di sviluppo e nelle pipeline CI/CD, fino ad arrivare a un modello di “audit automatico a ogni commit”, riducendo i costi delle correzioni tardive e accelerando il rilascio delle applicazioni.
- Rafforzare la security posture aziendale: aiutare le imprese a costruire difese più solide già nelle prime fasi del processo di sviluppo, riducendo i rischi di compliance e finanziari derivanti da data breach e interruzioni operative e proteggendo la continuità delle attività digitali.
Per le aziende, il valore degli AI Security Agent va ben oltre il semplice concetto di “trovare più vulnerabilità”. Il vero vantaggio consiste nel migliorare simultaneamente efficienza dello sviluppo e sicurezza del codice, grazie a maggiore accuratezza, minore intervento manuale e tempi di risposta più rapidi.
L’eccellente performance ottenuta da Sangfor AI, tra le principali soluzioni cinesi di AI Security, nella valutazione CyberGym rappresenta un importante traguardo nel percorso verso una code security intelligente.
Guardando al futuro, Sangfor continuerà a sviluppare innovazioni nel campo delle tecnologie di sicurezza basate sui Large Language Model, trasformando le capacità più avanzate dell’AI in produttività concreta per gli scenari enterprise e contribuendo a rendere la trasformazione digitale più semplice e sicura per ogni organizzazione.



