Lo storage esterno continua a svolgere un ruolo importante in molti ambienti iperconvergenti. Può migliorare l'accesso ai dati, supportare un'espansione flessibile della capacità e soddisfare la crescente domanda aziendale. La sua integrità, tuttavia, è direttamente correlata alla stabilità delle applicazioni.
Un ritardo superiore a dieci secondi nel trasferimento di immagini medicali può rallentare una diagnosi critica. Blocchi ripetuti nella sincronizzazione dei log delle transazioni bancarie possono compromettere l'elaborazione dei dati. File di progettazione che continuano a rimanere in caricamento possono rallentare le attività di ingegneria. Questi sintomi possono sembrare intermittenti, ma la causa sottostante è spesso un percorso di storage esterno degradato.
PARTE 1. Quando i percorsi verso lo storage esterno si degradano: impatti su prestazioni ed efficienza
Mantenere efficienti i percorsi di accesso allo storage è essenziale per garantire un flusso di dati affidabile e operazioni aziendali efficienti. Il Multipath I/O viene ampiamente utilizzato per migliorare la ridondanza e la disponibilità dell'accesso allo storage attraverso il bilanciamento del carico e il failover.
Negli ambienti di produzione, tuttavia, un singolo percorso degradato può ridurre le prestazioni di accesso dell'intera LUN di storage:
- In modalità di bilanciamento del carico, un percorso con latenza elevata può ridurre l'efficienza IOPS dei percorsi funzionanti correttamente e generare prestazioni disomogenee.
- In modalità attivo/standby, una latenza nascosta sul percorso attivo può causare direttamente blocchi delle applicazioni. Se il rilevamento del percorso standby reagisce troppo lentamente, il failover potrebbe non avvenire in tempo per garantire la continuità del servizio.
Per affrontare questi rischi, Sangfor HCI introduce funzionalità di rilevamento e isolamento del degrado dei percorsi di storage esterno, progettate per individuare potenziali problemi di prestazioni negli ambienti che utilizzano Multipath I/O.
PARTE 2. La tecnologia è fondamentale: monitoraggio, isolamento e ripristino coordinati
Sangfor HCI gestisce i percorsi di storage esterno attraverso tre moduli coordinati: monitoraggio preciso delle anomalie, isolamento intelligente dei percorsi a rischio e ripristino dinamico dei percorsi. Quando il sistema rileva blocchi nell'accesso allo storage o un degrado delle prestazioni, genera un avviso e può isolare il percorso interessato prima che il problema abbia un impatto sui workload aziendali.
Rispetto ad approcci convenzionali, come le eBPF kprobe o le statistiche dei dischi esposte tramite kernel diskstats, Sangfor implementa direttamente nel kernel del sistema la logica necessaria. Questa architettura riduce al minimo il consumo di risorse, aumenta la precisione del rilevamento e ha un impatto trascurabile sulle prestazioni del sistema.
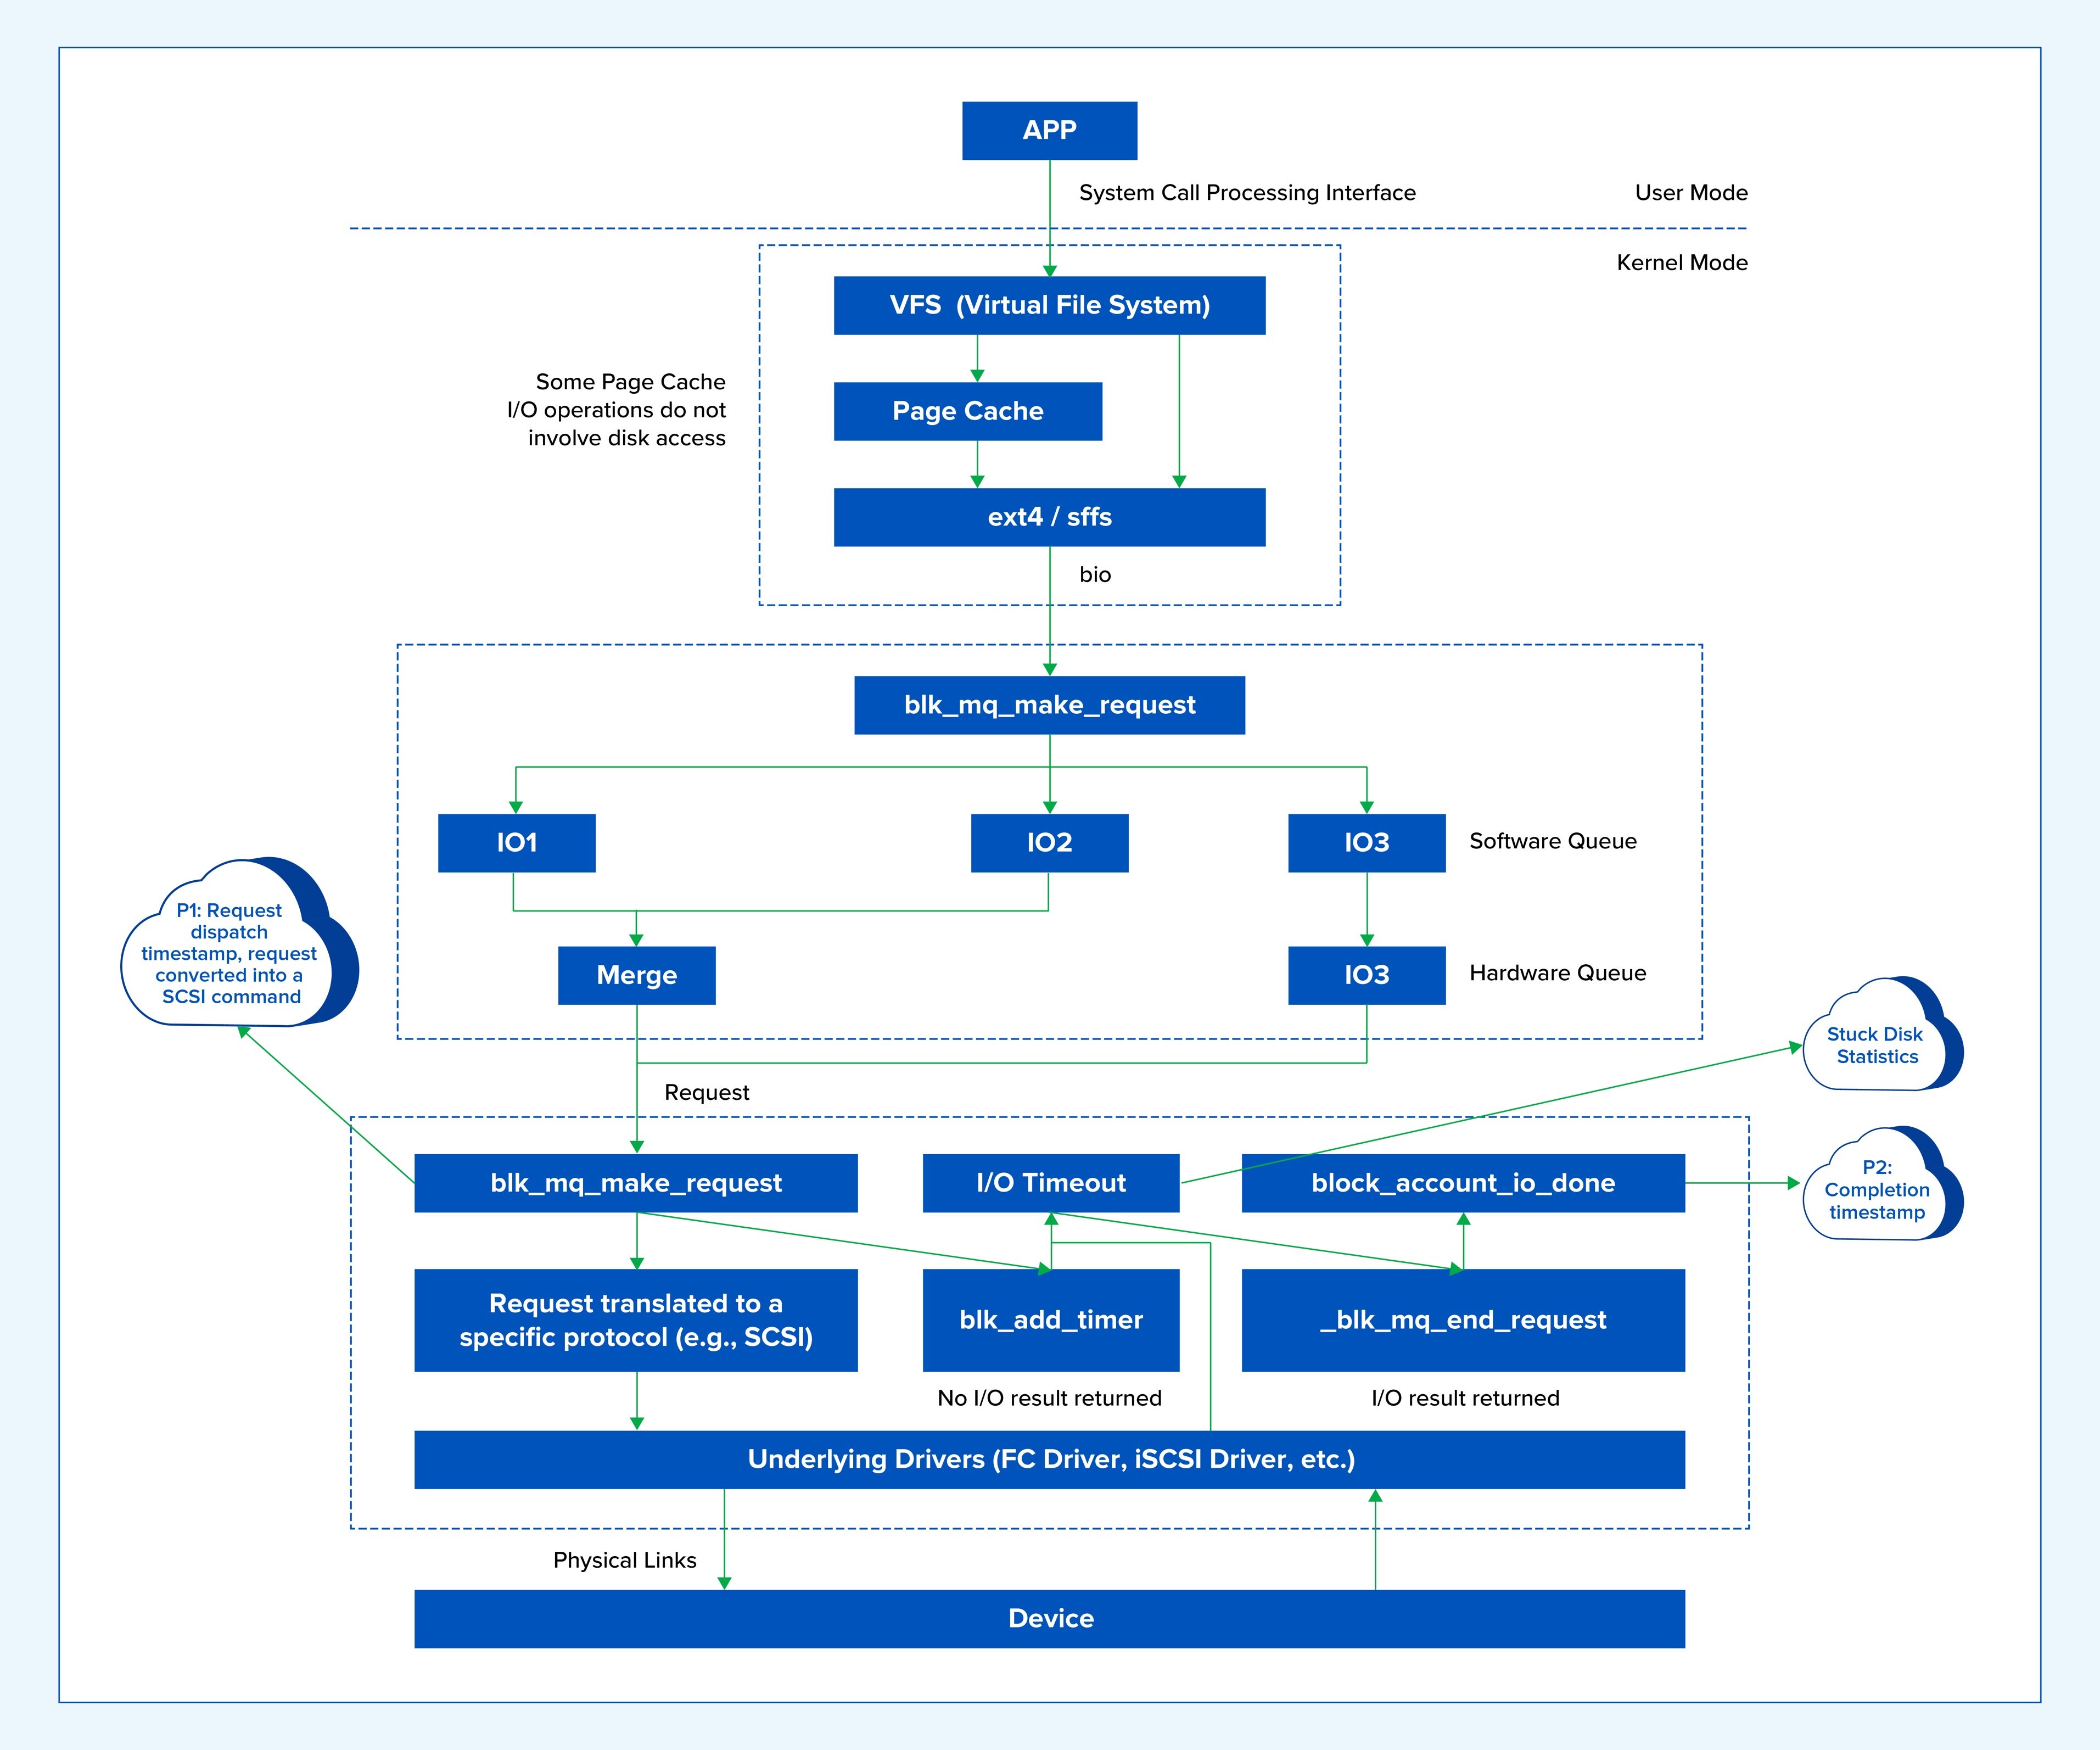
1. Monitoraggio preciso delle anomalie
Durante le operazioni di lettura e scrittura dei dati, il sistema combina il monitoraggio delle operazioni I/O lente con quello dei blocchi dell'I/O (I/O stall), adottando un approccio multilivello al rilevamento delle anomalie.
Monitoraggio delle operazioni I/O lente: tracciamento della latenza a livello di millisecondi
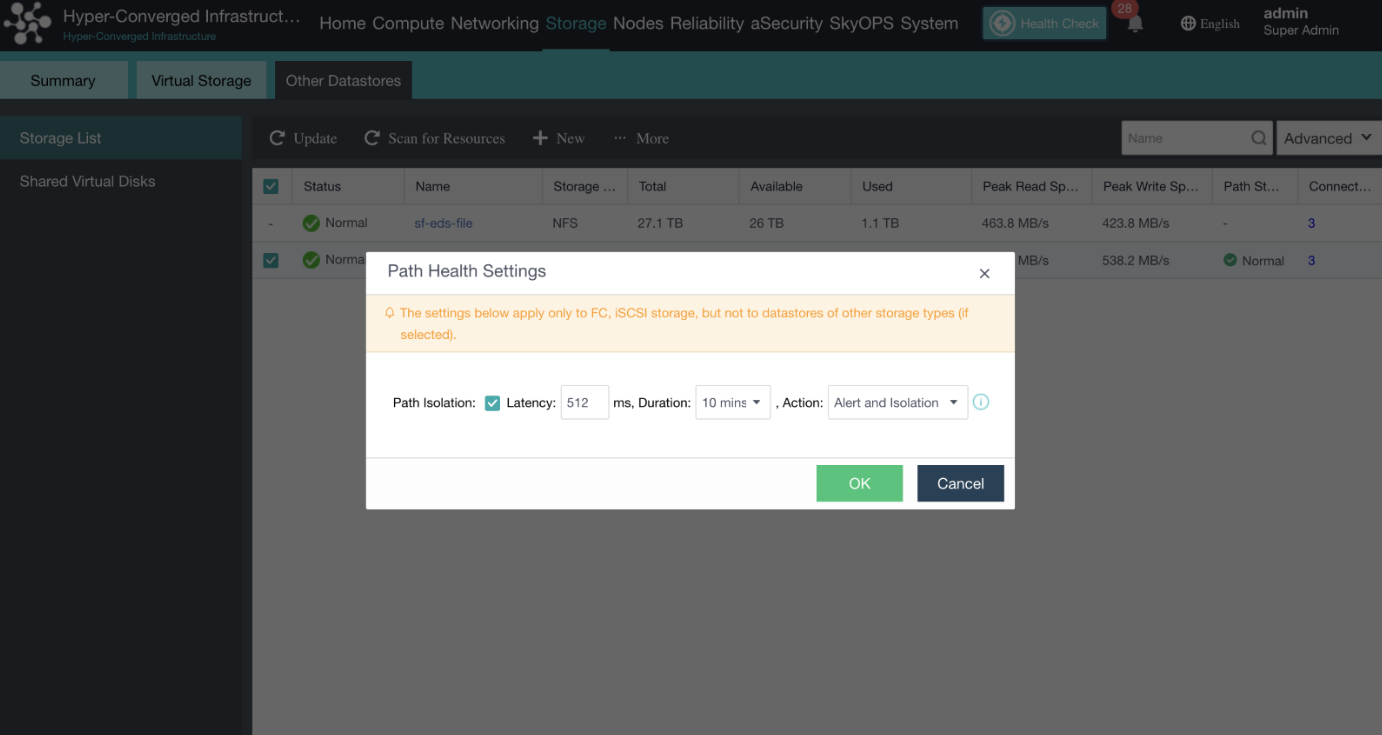
Principio di funzionamento: il sistema registra l'ora di avvio (P1) e l'ora di completamento (P2) di ogni operazione I/O. Calcola la durata dell'operazione di lettura o scrittura e la confronta con una soglia configurabile, impostata a 512 ms per impostazione predefinita. Se la latenza supera il limite, la piattaforma registra l'orario, il disco, l'area dei dati e le informazioni correlate. Per impostazione predefinita, viene registrata al massimo una voce di log ogni cinque secondi; questo limite può essere temporaneamente disabilitato.
Meccanismo decisionale: la distribuzione degli intervalli temporali delle operazioni I/O (I/O time buckets) per ciascuna partizione del disco può essere consultata tramite l'interfaccia /proc/ioslow_stats. Gli amministratori possono configurare una finestra di analisi compresa tra 30 secondi e 30 minuti. Se almeno il 50% delle operazioni su un disco di storage esterno supera la soglia, il sistema attiva automaticamente un avviso o un'azione di isolamento.
Monitoraggio dei blocchi I/O (I/O stall): rilevamento dei timeout a livello di kernel
Principio di funzionamento: Sangfor aggiunge una logica alla funzione del kernel che gestisce i timeout delle operazioni I/O sui dati. Le richieste che non vengono completate entro il tempo previsto vengono conteggiate come eventi di blocco I/O (I/O stall). Gli amministratori possono consultare lo stato in tempo reale delle partizioni interessate tramite /proc/iostuck_stats.
Generazione degli avvisi: il servizio di monitoraggio analizza ogni dieci minuti le variazioni del contatore dei blocchi I/O e notifica agli amministratori eventuali anomalie.
2. Isolamento intelligente per bilanciare affidabilità e disponibilità
- Isolamento basato sulla latenza: nelle modalità Multipath con bilanciamento del carico o configurazioni multi-active/multi-standby, il sistema confronta la latenza media di tutti i percorsi disponibili. Se la differenza tra i percorsi con latenza elevata e quelli con latenza ridotta supera la soglia configurata (ad esempio, il 50% del valore predefinito), il percorso anomalo viene isolato. Nelle configurazioni attivo/standby, il sistema isola direttamente il percorso non appena rileva un'anomalia di latenza su quel percorso.
- Limiti di sicurezza per l'isolamento: la piattaforma mantiene disponibili almeno il 50% dei percorsi e comunque non meno di un percorso, evitando che un isolamento eccessivo elimini la ridondanza.
- Gestione a ciclo chiuso: durante l'isolamento, il percorso viene contrassegnato come non disponibile e il dispositivo viene portato offline. Durante il ripristino, lo stato di disabilitazione viene rimosso automaticamente e il dispositivo viene sottoposto a una nuova scansione senza intervento manuale.
3. Ripristino tramite scansione approfondita per l'aggiornamento dinamico dei percorsi
Quando un percorso I/O viene isolato a causa di un guasto o di una latenza eccessiva, viene avviato immediatamente il processo di ripristino tramite scansione approfondita (deep-scan recovery):
- Rimozione dei percorsi non validi: eliminazione dei collegamenti non disponibili contrassegnati dal servizio Multipath.
- Riconnessione e verifica dei dispositivi: scansione dei dispositivi di storage confrontandoli con l'elenco degli ID delle LUN e ricreazione nel kernel dei dispositivi associati ai percorsi mancanti.
- Ripristino delle risorse funzionanti: eliminazione dei percorsi non validi rimasti in seguito alle modifiche della mappatura dello storage e riabilitazione dei percorsi recuperati caratterizzati da latenza elevata, precedentemente disabilitati.
PARTE 3. Copertura funzionale più ampia e flessibilità di implementazione
Sangfor HCI è progettata per offrire funzionalità più complete di gestione dello stato dei percorsi di storage rispetto alle soluzioni che supportano un numero limitato di protocolli, utilizzano parametri di monitoraggio fissi o prevedono un'unica modalità di intervento.
| Vendor | Storage esterno | Rilevamento dei percorsi degradati | Isolamento dei percorsi degradati |
|---|---|---|---|
| VMware | Supportato | Avvisi sulle anomalie Multipath | Disabilitazione manuale dei percorsi |
| Vendor H | Supportato | Avvisi sulle anomalie Multipath | Non supportato |
| Vendor S | Non supportato | Nessuno | Nessuno |
| Sangfor HCI | Supportato | Monitoraggio della latenza dei percorsi di storage esterno FC e iSCSI. Parametri configurabili: soglia di latenza da 50 ms a 10 min; durata del monitoraggio da 30 sec a 30 min. Opzioni di risposta: solo avviso oppure avviso e isolamento. | Monitoraggio della latenza e isolamento dei percorsi di storage esterno FC e iSCSI. Parametri configurabili: soglia di latenza da 50 ms a 10 min; durata del monitoraggio da 30 sec a 30 min. Opzioni di risposta: solo avviso oppure avviso e isolamento. |
1. Monitoraggio dei percorsi
Sangfor HCI supporta il monitoraggio della latenza per le principali connessioni verso lo storage esterno, inclusi Fibre Channel e iSCSI. Questo consente di supportare una gamma più ampia di architetture di storage rispetto alle piattaforme che offrono una copertura limitata dei protocolli.
2. Flessibilità di configurazione
Gli admin possono configurare le soglie di latenza e gli intervalli di monitoraggio in base alle caratteristiche dei carichi di lavoro e ai relativi requisiti di servizio (SLA). Questo approccio garantisce un controllo più preciso rispetto alle soluzioni basate su parametri fissi o con possibilità di configurazione limitate.
3. Flessibilità nella gestione delle anomalie
Sangfor supporta diverse modalità di risposta alle anomalie, tra cui l'isolamento automatico e quello manuale dei percorsi. Questa flessibilità consente alle organizzazioni di adottare politiche operative differenti in funzione dei diversi scenari aziendali, evitando di dover ricorrere a un'unica modalità di intervento o di operare senza meccanismi di isolamento dei percorsi degradati.
Conclusione: individuare i rischi dello storage prima che compromettano la continuità operativa
Il degrado delle prestazioni dello storage raramente si manifesta inizialmente con un guasto completo. Più spesso, si presenta sotto forma di latenze intermittenti, operazioni di I/O bloccate o prestazioni disomogenee tra i diversi percorsi di accesso, fenomeni difficili da individuare prima che abbiano un impatto sulle applicazioni.
Grazie al monitoraggio continuo della latenza dei percorsi, all'isolamento delle connessioni degradate e al ripristino dinamico dei percorsi una volta recuperate le normali condizioni operative, Sangfor HCI aiuta i team IT a identificare tempestivamente i rischi legati allo storage e a garantire la continuità dei servizi.
Per le organizzazioni che stanno valutando un'alternativa a VMware, la sola compatibilità con lo storage esterno non è sufficiente. La capacità di rilevare e gestire i percorsi degradati prima che compromettano i carichi di lavoro critici è altrettanto importante per realizzare un'infrastruttura HCI resiliente.
Il comportamento delle funzionalità dipende dalla versione del prodotto, dall'architettura di storage, dalla configurazione multipath e dalle condizioni dei carichi di lavoro. Si consiglia ai clienti di verificare il funzionamento negli scenari rappresentativi del proprio ambiente.
Stai valutando alternative a VMware?
Mentre le organizzazioni rivalutano le proprie strategie di virtualizzazione, è altrettanto importante conoscere il panorama più ampio delle piattaforme di virtualizzazione dei server.
Sangfor è stata recentemente riconosciuta come Visionary nel Gartner® Magic Quadrant™ 2026 per le piattaforme di virtualizzazione dei server.
Scarica il report Gartner® Magic Quadrant™ per approfondire le tendenze del mercato, le valutazioni dei fornitori e i principali aspetti da considerare nella scelta della prossima piattaforma di virtualizzazione.

