ระบบจัดเก็บข้อมูลภายนอกยังคงเป็นส่วนสำคัญของสภาพแวดล้อมไฮเปอร์คอนเวอร์เจนซ์หลายแห่ง มันสามารถปรับปรุงการเข้าถึงข้อมูล รองรับการขยายความจุที่ยืดหยุ่น และรองรับความต้องการทางธุรกิจที่เพิ่มขึ้นได้ อย่างไรก็ตาม สุขภาพของระบบจัดเก็บข้อมูลภายนอกนั้นขึ้นอยู่กับความเสถียรของแอปพลิเคชันโดยตรง
ความล่าช้าในการถ่ายโอนภาพทางการแพทย์ที่มากกว่าสิบวินาทีอาจทำให้การวินิจฉัยที่สำคัญช้าลง การหยุดชะงักซ้ำๆ ในการซิงโครไนซ์บันทึกธุรกรรมของธนาคารอาจขัดขวางการประมวลผลข้อมูล ไฟล์ออกแบบที่โหลดไม่หยุดอาจทำให้งานด้านวิศวกรรมล่าช้า อาการเหล่านี้อาจเกิดขึ้นเป็นระยะๆ แต่สาเหตุที่แท้จริงมักเกิดจากเส้นทาง จัดเก็บข้อมูลภายนอกที่เสื่อมสภาพ
ส่วนที่ 1. เส้นทางจัดเก็บข้อมูลภายนอกที่เสื่อมสภาพ: อุปสรรคที่ซ่อนเร้นต่อประสิทธิภาพและประสิทธิผล
การรักษาความสมบูรณ์ของเส้นทางการรับส่งข้อมูลเป็นสิ่งสำคัญต่อการไหลเวียนของข้อมูลที่เชื่อถือได้และการดำเนินงานทางธุรกิจที่มีประสิทธิภาพ การรับส่งข้อมูลแบบหลายเส้นทาง (Multipath I/O) ถูกนำมาใช้กันอย่างแพร่หลายเพื่อปรับปรุงความซ้ำซ้อนและความพร้อมใช้งานในการเข้าถึงพื้นที่จัดเก็บข้อมูลผ่านการกระจายโหลดและการสำรองข้อมูลเมื่อเกิดข้อผิดพลาด
อย่างไรก็ตาม ในการใช้งานจริง เส้นทางการเข้าถึงที่เสียหายเพียงเส้นเดียวก็สามารถลดประสิทธิภาพการเข้าถึงของ LUN จัดเก็บข้อมูลทั้งหมดได้:
- ในโหมดการกระจายโหลด เส้นทางที่มีความหน่วงสูงอาจทำให้ประสิทธิภาพ IOPS ของเส้นทางที่ทำงานได้ปกติลดลง และทำให้ประสิทธิภาพการทำงานไม่สม่ำเสมอ
- ในโหมดแอคทีฟ/สแตนด์บาย ความล่าช้าที่ซ่อนอยู่บนเส้นทางแอคทีฟอาจทำให้แอปพลิเคชันหยุดทำงานโดยตรง หากการตรวจจับเส้นทางสแตนด์บายตอบสนองช้าเกินไป การสลับไปยังเส้นทางสำรองอาจไม่เกิดขึ้นทันเวลาเพื่อรักษาความต่อเนื่องของบริการ
เพื่อรับมือกับความเสี่ยงเหล่านี้ Sangfor HCI จึงได้นำเสนอการตรวจจับและการแยกความเสื่อมคุณภาพของเส้นทางจัดเก็บข้อมูลภายนอก ซึ่งออกแบบมาเพื่อระบุอันตรายด้านประสิทธิภาพในสภาพแวดล้อม I/O แบบหลายเส้นทาง
ส่วนที่ 2 เทคโนโลยีหลัก: ระบบวงปิดสำหรับการตรวจสอบ การแยก และการกู้คืน
Sangfor HCI บริหารจัดการเส้นทางจัดเก็บข้อมูลภายนอกผ่านโมดูลที่ประสานงานกันสามโมดูล ได้แก่ การตรวจสอบความผิดปกติอย่างแม่นยำ การแยกความเสี่ยงอย่างชาญฉลาด และการกู้คืนเส้นทางแบบไดนามิก เมื่อระบบตรวจพบการหยุดชะงักของการจัดเก็บข้อมูลหรือประสิทธิภาพการทำงานลดลง ระบบจะแจ้งเตือนและสามารถแยกเส้นทางที่ได้รับผลกระทบก่อนที่จะส่งผลกระทบต่อปริมาณงานของธุรกิจ
เมื่อเปรียบเทียบกับวิธีการแบบดั้งเดิม เช่น eBPF kprobes หรือ kernel diskstats แล้ว Sangfor ใช้ตรรกะที่จำเป็นโดยตรงในเคอร์เนลของระบบ การออกแบบนี้ช่วยลดภาระทรัพยากร เพิ่มความแม่นยำในการตรวจจับ และมีผลกระทบต่อประสิทธิภาพของระบบน้อยมาก
1. การตรวจสอบความผิดปกติอย่างแม่นยำ
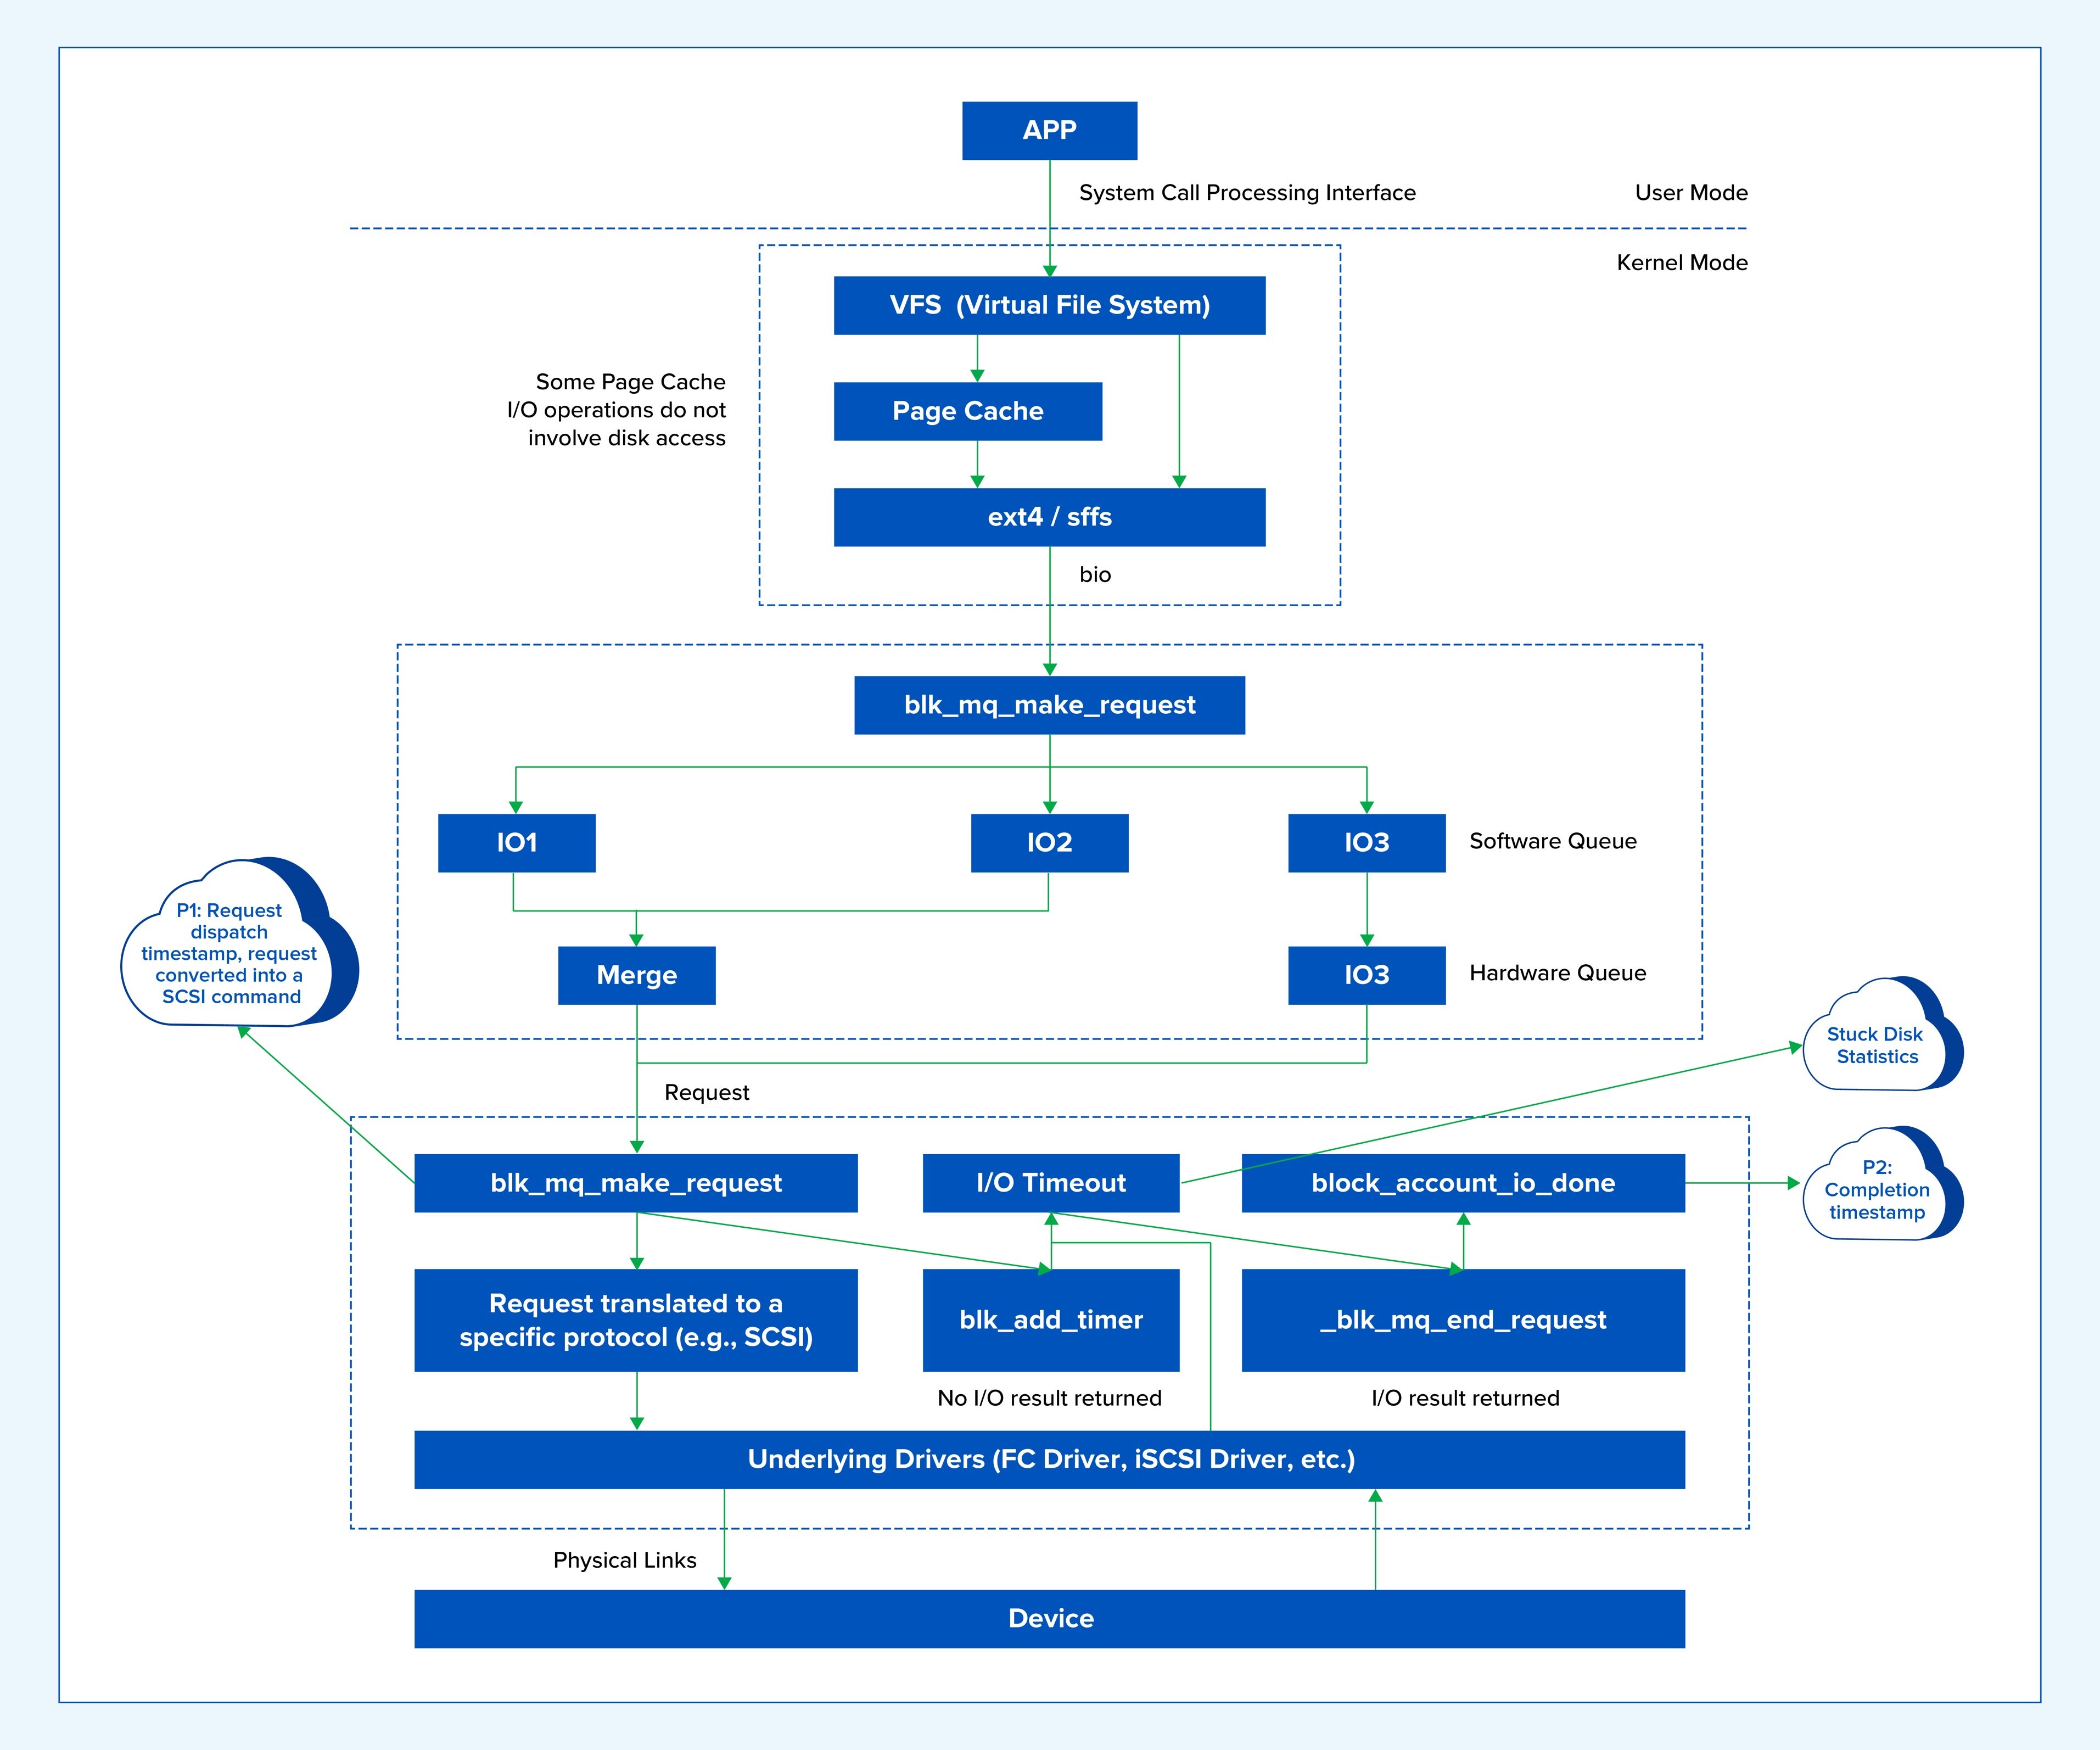
ในระหว่างการอ่านและเขียนข้อมูล ระบบจะผสานการตรวจสอบ I/O ที่ช้าเข้ากับการตรวจสอบ I/O ที่หยุดชะงัก เพื่อสร้างวิธีการตรวจจับความผิดปกติแบบหลายชั้น
การตรวจสอบการรับส่งข้อมูลช้า: การติดตามความหน่วงเวลาในระดับมิลลิวินาที
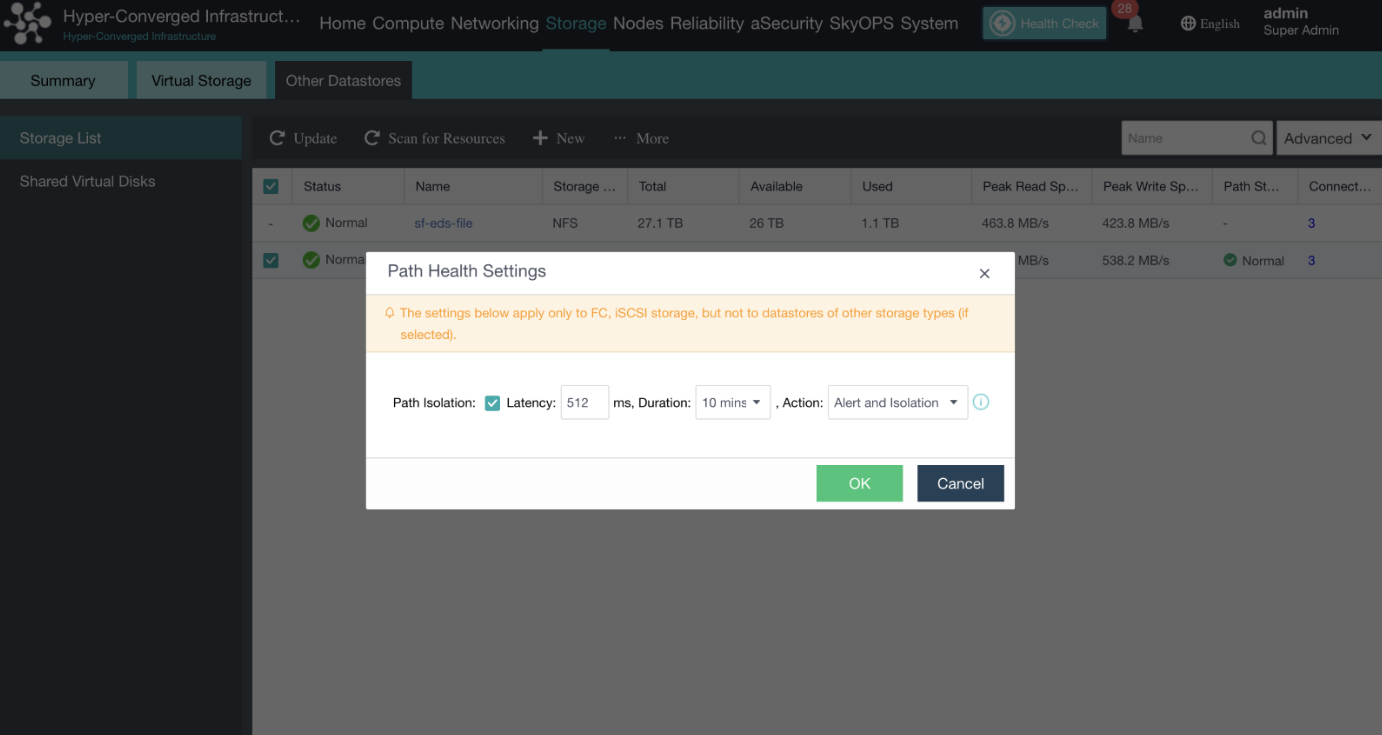
หลักการ: ระบบจะบันทึกเวลาเริ่มต้น (P1) และเวลาสิ้นสุด (P2) ของการดำเนินการ I/O แต่ละครั้ง ระบบจะคำนวณระยะเวลาการอ่าน/เขียนและเปรียบเทียบกับค่าเกณฑ์ที่กำหนดค่าได้ โดยค่าเริ่มต้นคือ 512 มิลลิวินาที หากเวลาแฝงเกินขีดจำกัด ระบบจะบันทึกเวลา ดิสก์ พื้นที่ข้อมูล และข้อมูลที่เกี่ยวข้อง โดยค่าเริ่มต้น จะมีการบันทึกข้อมูลไม่เกินหนึ่งรายการทุกๆ ห้าวินาที และสามารถปิดใช้งานข้อจำกัดนี้ได้ชั่วคราว
กลไกการตัดสินใจ: สามารถดูการกระจายของช่วงเวลา I/O สำหรับแต่ละพาร์ติชั่นดิสก์ได้ผ่านทางอินเทอร์เฟซ /proc/ioslow_stats ผู้ดูแลระบบสามารถกำหนดช่วงเวลาการวิเคราะห์ได้ตั้งแต่ 30 วินาทีถึง 30 นาที หากอย่างน้อย 50% ของการทำงานบนดิสก์จัดเก็บข้อมูลภายนอกเกินเกณฑ์ที่กำหนด ระบบจะแจ้งเตือนหรือดำเนินการแยกส่วนโดยอัตโนมัติ
การตรวจสอบการหยุดชะงักของ I/O: การบันทึกการหมดเวลาในระดับเคอร์เนล
หลักการ: Sangfor เพิ่มตรรกะลงในฟังก์ชันเคอร์เนลที่จัดการการหมดเวลาของการรับส่งข้อมูล (I/O) คำขอที่ไม่ส่งคืนภายในเวลาที่กำหนดจะถูกนับเป็นเหตุการณ์ I/O ที่หยุดชะงัก ผู้ดูแลระบบสามารถดูสถานะแบบเรียลไทม์ของพาร์ติชันที่ได้รับผลกระทบได้ผ่านทาง /proc/iostuck_stats
การแจ้งเตือน: บริการแจ้งเตือนจะสแกนหาการเปลี่ยนแปลงในจำนวน I/O ที่หยุดชะงักทุกสิบนาที และแจ้งให้ผู้ดูแลระบบทราบถึงความผิดปกติ
2. ระบบแยกส่วนอัจฉริยะที่สร้างสมดุลระหว่างความน่าเชื่อถือและความพร้อมใช้งาน
- การแยกเส้นทางตามค่าความหน่วง: สำหรับโหมดการกระจายโหลดหรือโหมดหลายเส้นทางแบบแอคทีฟ/สแตนด์บายหลายตัว ระบบจะเปรียบเทียบค่าความหน่วงเฉลี่ยของเส้นทางที่มีอยู่ทั้งหมด หากความแตกต่างระหว่างเส้นทางที่มีความหน่วงสูงและเส้นทางที่มีความหน่วงต่ำเกินเกณฑ์ที่กำหนดไว้ (เช่น 50% ของค่าเริ่มต้น) เส้นทางที่ผิดปกติจะถูกแยกออก สำหรับการกำหนดค่าแบบแอคทีฟ/สแตนด์บาย ระบบจะแยกเส้นทางนั้นโดยตรงทันทีที่ตรวจพบความผิดปกติของค่าความหน่วงในเส้นทางนั้น
- แนวกั้นการแยกส่วน: แพลตฟอร์มจะคงเส้นทางที่มีอยู่ไว้ไม่ต่ำกว่า 50% และไม่น้อยกว่าหนึ่งเส้นทาง เพื่อป้องกันไม่ให้การแยกส่วนที่มากเกินไปทำลายความซ้ำซ้อน
- การทำงานแบบวงปิด: ในระหว่างการแยกตัว เส้นทางจะถูกทำเครื่องหมายว่าไม่พร้อมใช้งานและอุปกรณ์จะถูกตัดการเชื่อมต่อ ในระหว่างการกู้คืน สถานะการปิดใช้งานจะถูกล้างโดยอัตโนมัติและอุปกรณ์จะถูกสแกนใหม่โดยไม่ต้องมีการแทรกแซงด้วยตนเอง
3. การกู้คืนแบบสแกนเชิงลึกสำหรับการอัปเดตเส้นทางแบบไดนามิก
เมื่อเส้นทางการรับส่งข้อมูล (I/O) ถูกตัดขาดเนื่องจากข้อผิดพลาดหรือความหน่วงสูงเกินไป การกู้คืนด้วยการสแกนเชิงลึกจะเริ่มต้นทันที:
- ลบเส้นทางที่ไม่ถูกต้อง: ลบลิงก์ที่ไม่สามารถใช้งานได้ซึ่งถูกทำเครื่องหมายโดยบริการมัลติพาธ
- เชื่อมต่ออุปกรณ์อีกครั้งและตรวจสอบ: สแกนอุปกรณ์จัดเก็บข้อมูลเทียบกับรายการ LUN ID และสร้างอุปกรณ์พาธที่หายไปในเคอร์เนลขึ้นใหม่
- กู้คืนทรัพยากรที่ใช้งานได้: ล้างเส้นทางที่ไม่ถูกต้องซึ่งเกิดจากการเปลี่ยนแปลงการแมปพื้นที่จัดเก็บ และเปิดใช้งานเส้นทางที่มีความหน่วงสูงที่กู้คืนมาได้ซึ่งถูกปิดใช้งานไว้ก่อนหน้านี้อีกครั้ง
ส่วนที่ 3. การครอบคลุมฟังก์ชันที่กว้างขึ้นและการใช้งานที่ยืดหยุ่น
Sangfor HCI ได้รับการออกแบบมาเพื่อการจัดการสุขภาพเส้นทางที่ครอบคลุมมากกว่าโซลูชันที่ให้การครอบคลุมโปรโตคอลที่จำกัด พารามิเตอร์การตรวจสอบที่ตายตัว หรือวิธีการตอบสนองเพียงวิธีเดียว
1. การครอบคลุมการตรวจสอบเส้นทาง
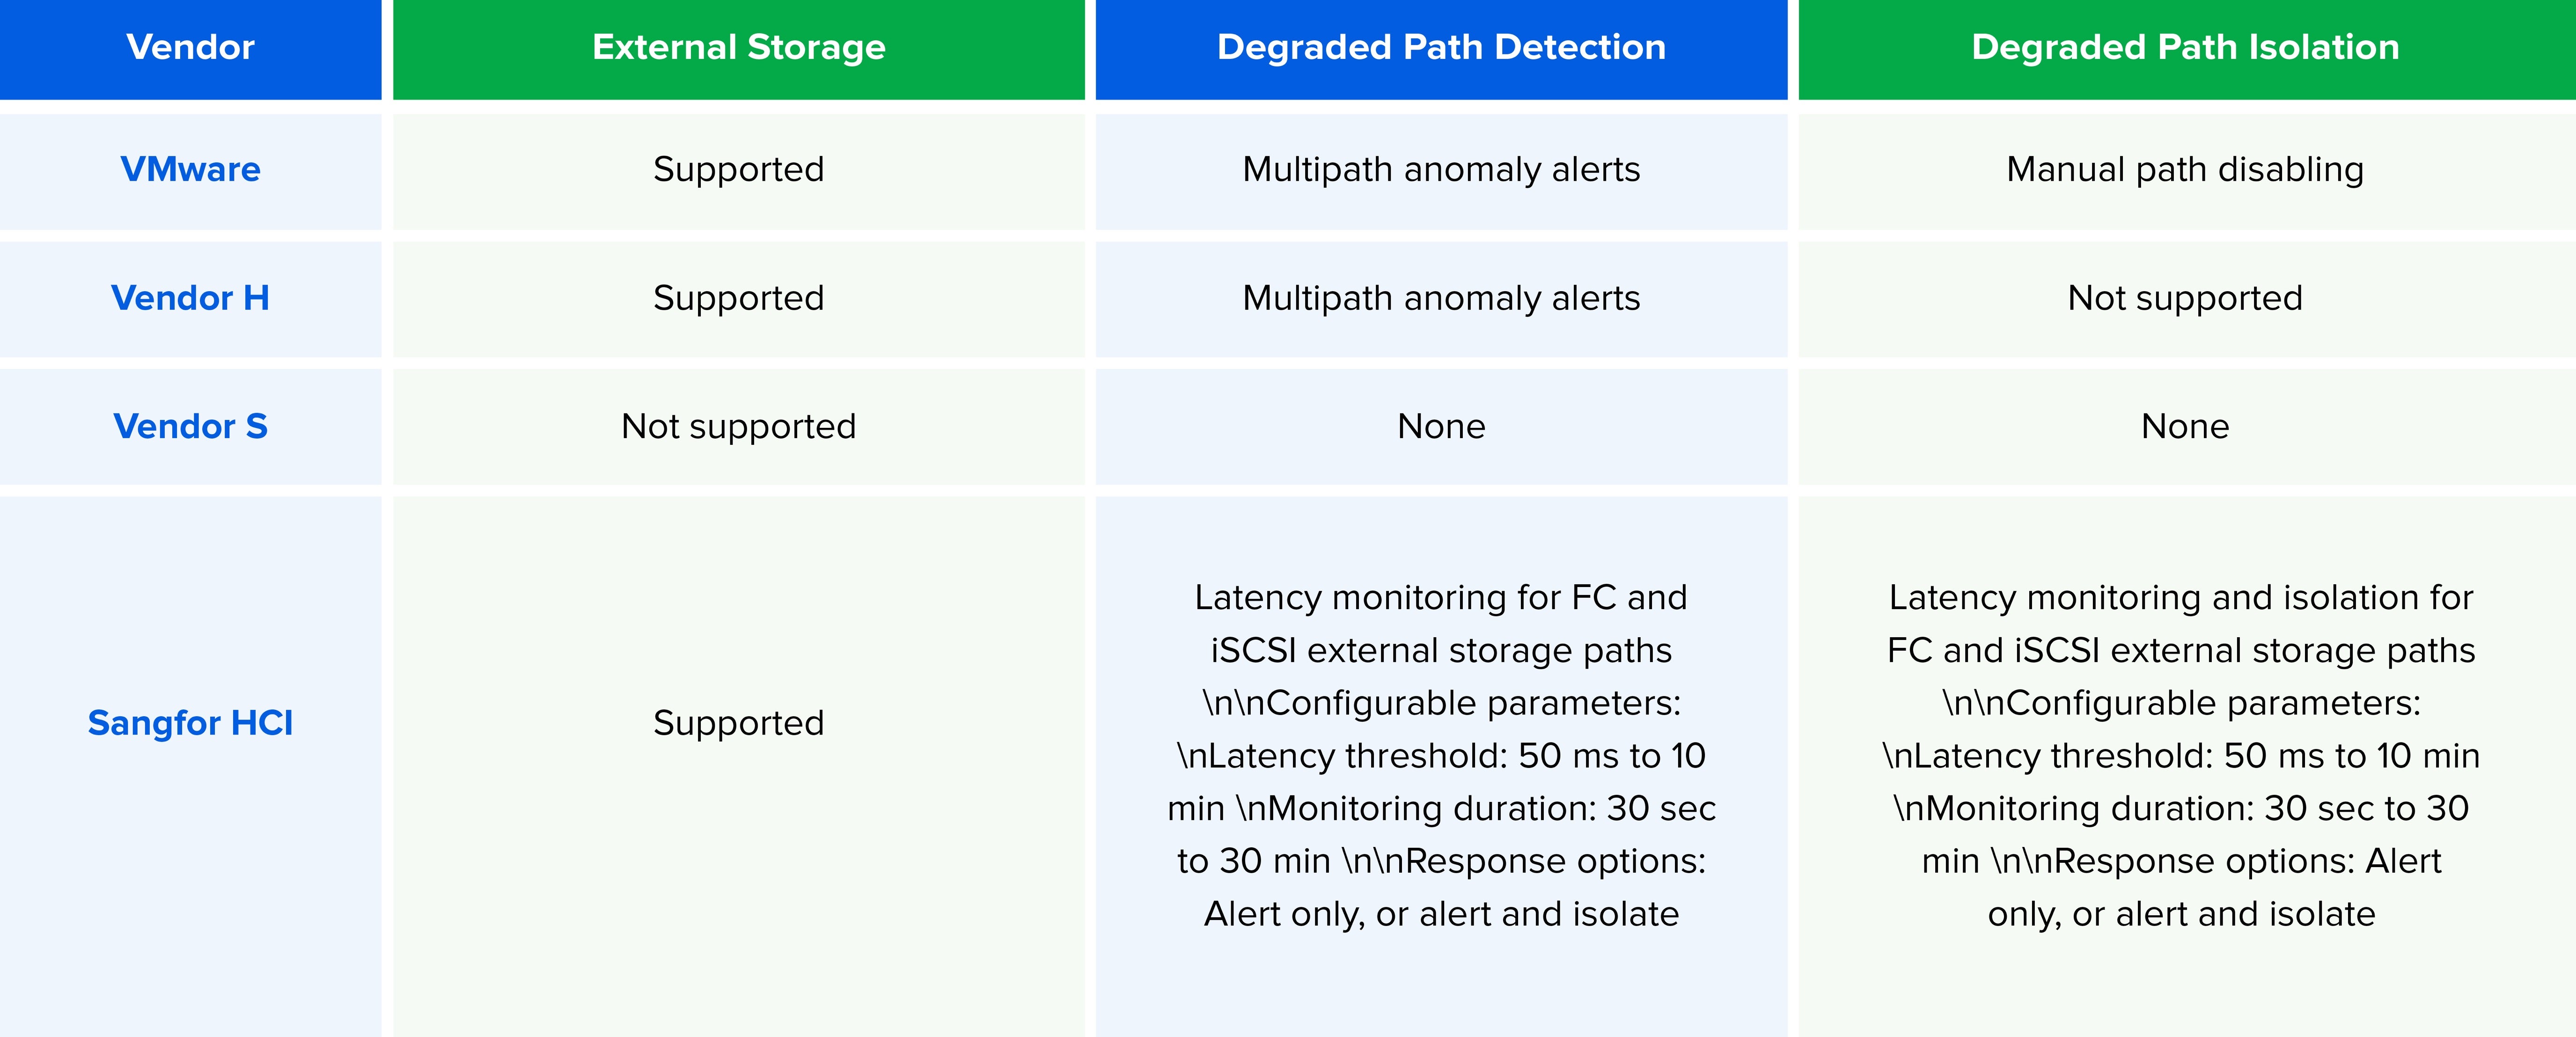
Sangfor HCI รองรับการตรวจสอบความหน่วงแฝงสำหรับการเชื่อมต่ออุปกรณ์จัดเก็บข้อมูลภายนอกทั่วไป รวมถึง Fibre Channel และ iSCSI ซึ่งช่วยรองรับสถาปัตยกรรมจัดเก็บข้อมูลที่หลากหลายกว่าแพลตฟอร์มที่มีการครอบคลุมโปรโตคอลไม่ครบถ้วน
2. ความยืดหยุ่นในการกำหนดค่า
ผู้ดูแลระบบสามารถปรับแต่งค่าเกณฑ์ความหน่วงและช่วงเวลาการตรวจสอบให้เหมาะสมกับลักษณะเฉพาะและข้อกำหนดระดับบริการของปริมาณงานได้ ซึ่งจะช่วยให้ควบคุมได้แม่นยำกว่ารูปแบบการกำหนดค่าแบบตายตัวหรือแบบจำกัด
3. การตอบสนองต่อความผิดปกติที่ยืดหยุ่น
Sangfor รองรับวิธีการตอบสนองหลายรูปแบบ รวมถึงการแยกส่วนอัตโนมัติและด้วยตนเอง ความยืดหยุ่นนี้ช่วยให้องค์กรสามารถใช้แนวนโยบายการดำเนินงานที่แตกต่างกันในสถานการณ์ทางธุรกิจต่างๆ แทนที่จะพึ่งพาเพียงวิธีการแก้ไขเพียงวิธีเดียว หรือดำเนินการโดยปราศจากการแยกส่วนเส้นทางที่เสียหาย
สรุป: ตรวจจับความเสี่ยงด้านการจัดเก็บข้อมูลก่อนที่จะส่งผลกระทบต่อธุรกิจ
ความเสื่อมสภาพของระบบจัดเก็บข้อมูลนั้นมักไม่เริ่มต้นด้วยความล้มเหลวโดยสมบูรณ์ บ่อยครั้งที่มันปรากฏในรูปแบบของความหน่วงเวลาที่ไม่สม่ำเสมอ การหยุดชะงักของ I/O หรือประสิทธิภาพของเส้นทางที่ไม่สม่ำเสมอ ซึ่งยากที่จะระบุได้ก่อนที่แอปพลิเคชันจะได้รับผลกระทบ ด้วยการตรวจสอบความหน่วงเวลาของเส้นทางอย่างต่อเนื่อง การแยกการเชื่อมต่อที่เสื่อมสภาพ และการกู้คืนเส้นทางที่กลับมาใช้งานได้โดยอัตโนมัติ Sangfor HCI ช่วยให้ทีมไอทีสามารถจัดการกับความเสี่ยงด้านการจัดเก็บข้อมูลได้เร็วขึ้นและรักษาความต่อเนื่องของบริการได้
สำหรับองค์กรที่กำลังพิจารณาหาทางเลือก อื่นแทน VMware นั้น ความเข้ากันได้กับอุปกรณ์จัดเก็บข้อมูลภายนอก เพียงอย่างเดียวไม่เพียงพอ ความสามารถในการตรวจจับและจัดการเส้นทางที่เสียหายก่อนที่จะส่งผลกระทบต่อเวิร์กโหลดที่สำคัญนั้นมีความสำคัญไม่แพ้กันสำหรับการสร้างสภาพแวดล้อม HCI ที่มีความยืดหยุ่น
ลักษณะการทำงานของฟีเจอร์ขึ้นอยู่กับเวอร์ชันของผลิตภัณฑ์ สถาปัตยกรรมจัดเก็บข้อมูล การกำหนดค่ามัลติพาธ และสภาวะการทำงาน ลูกค้าควรตรวจสอบสถานการณ์ตัวอย่างในสภาพแวดล้อมของตนเอง
กำลังพิจารณาทางเลือกอื่นนอกเหนือจาก VMware อยู่หรือไม่?
ในขณะที่องค์กรต่างๆ กำลังประเมินกลยุทธ์ด้านเวอร์ชวลไลเซชันของตนใหม่ การทำความเข้าใจภาพรวมของเวอร์ชวลไลเซชันเซิร์ฟเวอร์ที่กว้างขึ้นก็มีความสำคัญไม่แพ้กัน Sangfor เพิ่งได้รับการยกย่องให้เป็นผู้มีวิสัยทัศน์ในรายงาน Gartner® Magic Quadrant™ ปี 2026 สำหรับแพลตฟอร์มเวอร์ชวลไลเซชันเซิร์ฟเวอร์ ดาวน์โหลดรายงาน Gartner® Magic Quadrant™ เพื่อสำรวจแนวโน้มตลาด การประเมินผู้จำหน่าย และข้อควรพิจารณาที่สำคัญเมื่อเลือกแพลตฟอร์มเวอร์ชวลไลเซชันถัดไปของคุณ