El almacenamiento externo sigue siendo una parte importante de muchos entornos hiperconvergentes. Puede mejorar el acceso a los datos, permitir una expansión de capacidad flexible y satisfacer la creciente demanda empresarial. Sin embargo, su buen funcionamiento está directamente relacionado con la estabilidad de las aplicaciones.
Un retraso de más de diez segundos en la transferencia de imágenes médicas puede demorar un diagnóstico crítico. Las interrupciones repetidas en la sincronización del registro de transacciones bancarias pueden interrumpir el procesamiento de datos. Los archivos de diseño que se cargan continuamente pueden retrasar el trabajo de ingeniería. Estos síntomas pueden parecer intermitentes, pero la causa subyacente suele ser una ruta de almacenamiento externo degradada .
PARTE 1. Rutas de almacenamiento externo degradadas: una barrera oculta para el rendimiento y la eficiencia.
Mantener la integridad de las rutas de acceso es fundamental para un flujo de datos fiable y unas operaciones comerciales eficientes. La E/S multipath se utiliza ampliamente para mejorar la redundancia y la disponibilidad del acceso al almacenamiento mediante el equilibrio de carga y la conmutación por error.
Sin embargo, en producción, una única ruta degradada puede reducir el rendimiento de acceso para toda la LUN de almacenamiento:
- En el modo de equilibrio de carga, una ruta con alta latencia puede reducir la eficiencia de IOPS de las rutas que funcionan correctamente y generar un rendimiento desigual.
- En el modo activo/en espera, la latencia oculta en la ruta activa puede provocar directamente bloqueos en la aplicación. Si la detección de la ruta en espera reacciona con demasiada lentitud, es posible que la conmutación por error no se produzca a tiempo para garantizar la continuidad del servicio.
Para abordar estos riesgos, Sangfor HCI introduce la detección y el aislamiento de la degradación de la ruta de almacenamiento externa, diseñados para identificar riesgos de rendimiento en entornos de E/S de rutas múltiples.
PARTE 2. Tecnología central: un circuito cerrado de monitorización, aislamiento y recuperación.
Sangfor HCI gestiona las rutas de almacenamiento externo mediante tres módulos coordinados: monitorización precisa de anomalías, aislamiento inteligente de riesgos y recuperación dinámica de rutas. Cuando el sistema detecta bloqueos de almacenamiento o degradación del rendimiento, genera una alerta y puede aislar la ruta afectada antes de que impacte en las cargas de trabajo empresariales.
En comparación con los métodos convencionales como eBPF kprobes o el análisis de datos de disco del kernel, Sangfor implementa la lógica necesaria directamente en el núcleo del sistema. Este diseño minimiza el consumo de recursos, aumenta la precisión de la detección y tiene un impacto mínimo en el rendimiento del sistema.
1. Monitoreo preciso de anomalías
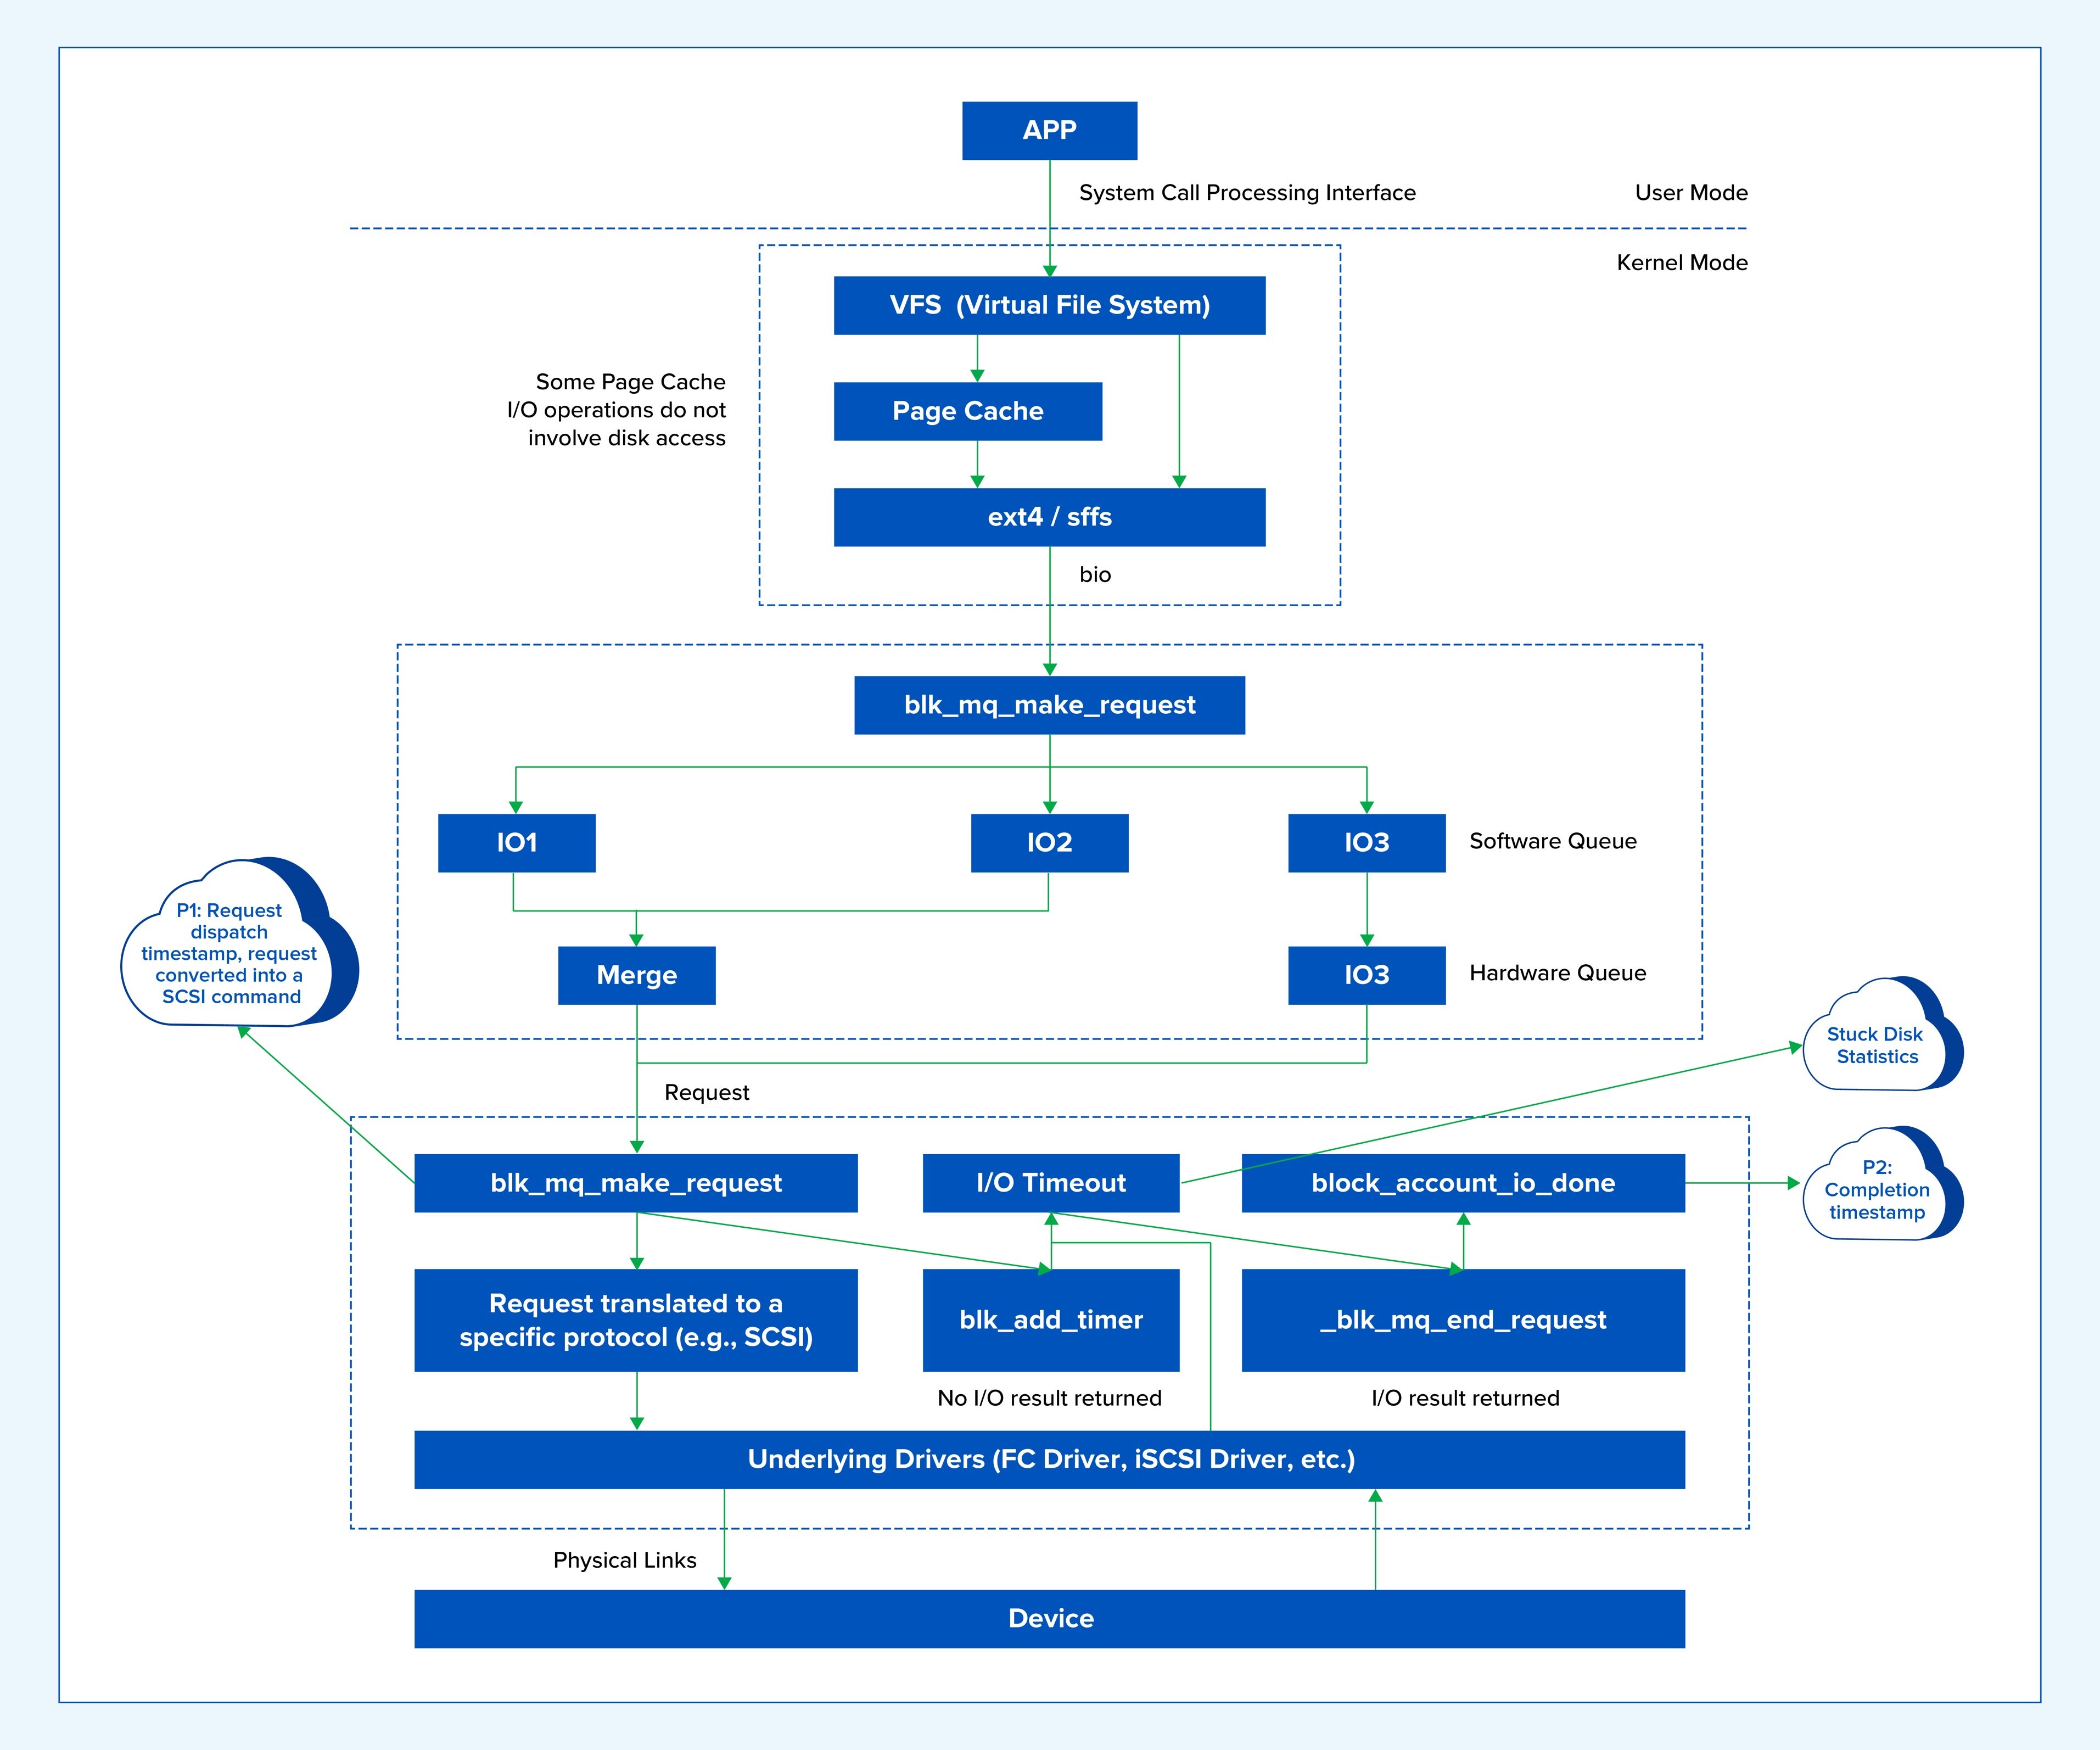
Durante las operaciones de lectura y escritura de datos, el sistema combina la monitorización de E/S lentas con la monitorización de bloqueos de E/S para crear un enfoque de detección de anomalías de múltiples capas.
Monitorización de E/S lentas: seguimiento de la latencia a nivel de milisegundos.
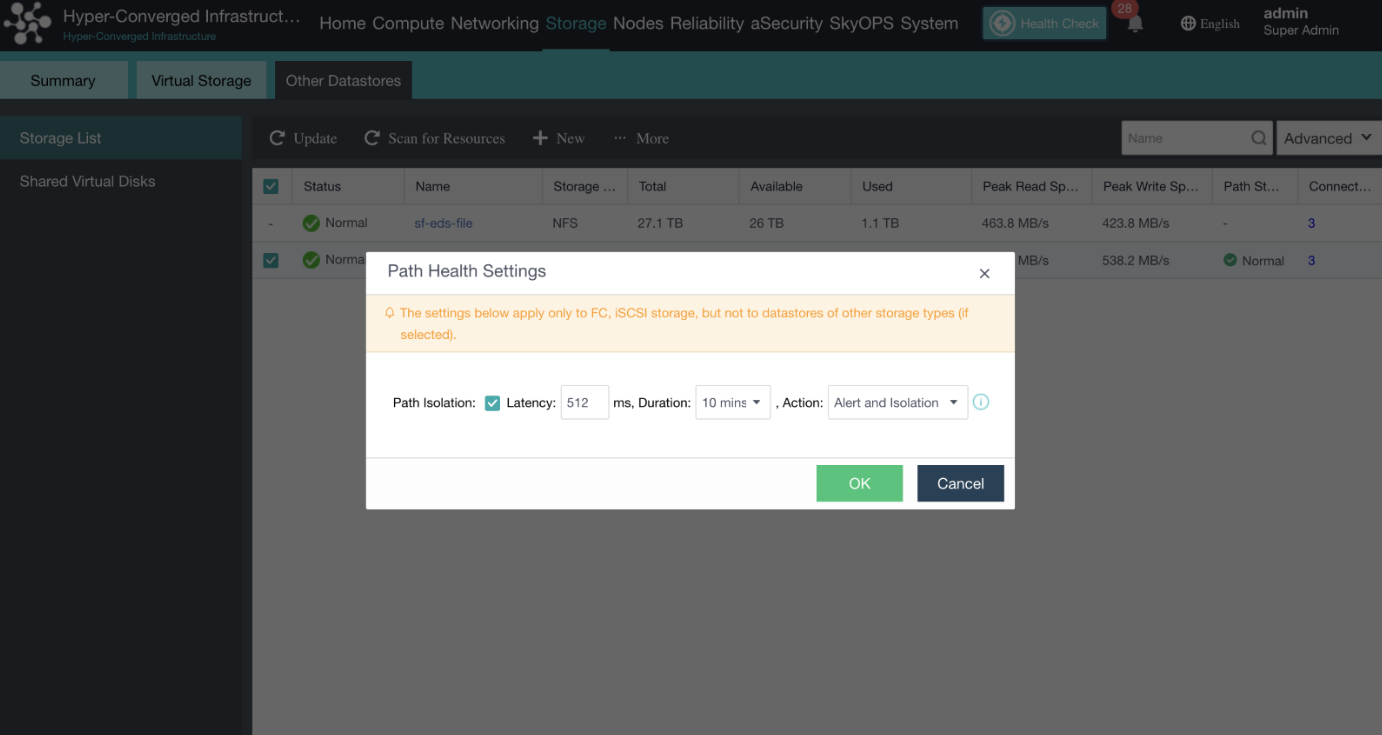
Principio: El sistema registra la hora de inicio (P1) y la hora de finalización (P2) de cada operación de E/S. Calcula la duración de lectura/escritura y la compara con un umbral configurable. El valor predeterminado es de 512 ms. Si la latencia supera el límite, la plataforma registra la hora, el disco, la región de datos y la información relacionada. Por defecto, no se registra más de una entrada de registro cada cinco segundos, y este límite puede desactivarse temporalmente.
Mecanismo de decisión: La distribución de los intervalos de tiempo de E/S para cada partición de disco se puede visualizar a través de la interfaz /proc/ioslow_stats. Los administradores pueden configurar un período de análisis de entre 30 segundos y 30 minutos. Si al menos el 50 % de las operaciones en un disco de almacenamiento externo superan el umbral, el sistema activa automáticamente una alerta o una acción de aislamiento.
Supervisión de bloqueos de E/S: captura de tiempos de espera a nivel de kernel
Principio: Sangfor agrega lógica a la función del kernel que gestiona los tiempos de espera de E/S de datos. Las solicitudes que no responden a tiempo se contabilizan como eventos de E/S bloqueados. Los administradores pueden ver el estado en tiempo real de las particiones afectadas a través de /proc/iostuck_stats.
Alertas: El servicio de alertas analiza los cambios en el recuento de E/S bloqueadas cada diez minutos y notifica a los administradores sobre cualquier anomalía.
2. Aislamiento inteligente que equilibra la fiabilidad y la disponibilidad.
- Aislamiento basado en latencia: En los modos de equilibrio de carga o multipath multiactivo/multien espera, el sistema compara la latencia promedio de todas las rutas disponibles. Si la diferencia entre las rutas de alta y baja latencia supera el umbral configurado (por ejemplo, el 50 % del valor predeterminado), la ruta anómala se aísla. En una configuración activo/en espera, el sistema aísla directamente la ruta en cuanto detecta una anomalía de latencia en ella.
- Barrera de aislamiento: La plataforma conserva al menos el 50 % de las rutas disponibles y nunca menos de una, lo que evita que un aislamiento excesivo elimine la redundancia.
- Funcionamiento en bucle cerrado: Durante el aislamiento, la ruta se marca como no disponible y el dispositivo se desconecta. Durante la recuperación, el estado de desactivación se elimina automáticamente y el dispositivo se vuelve a escanear sin intervención manual.
3. Recuperación mediante escaneo profundo para actualizaciones de rutas dinámicas
Cuando una ruta de E/S queda aislada debido a un fallo o a una latencia excesiva, la recuperación mediante escaneo profundo comienza inmediatamente:
- Eliminar rutas no válidas: Eliminar los enlaces no disponibles marcados por el servicio de rutas múltiples.
- Vuelva a conectar y verifique los dispositivos: Escanee los dispositivos de almacenamiento con la lista de ID de LUN y vuelva a crear los dispositivos de ruta que falten en el kernel.
- Restaurar recursos en buen estado: Limpiar las rutas no válidas que hayan quedado tras los cambios en la asignación de almacenamiento y volver a habilitar las rutas de alta latencia recuperadas que antes estaban deshabilitadas.
PARTE 3. Mayor cobertura funcional e implementación flexible
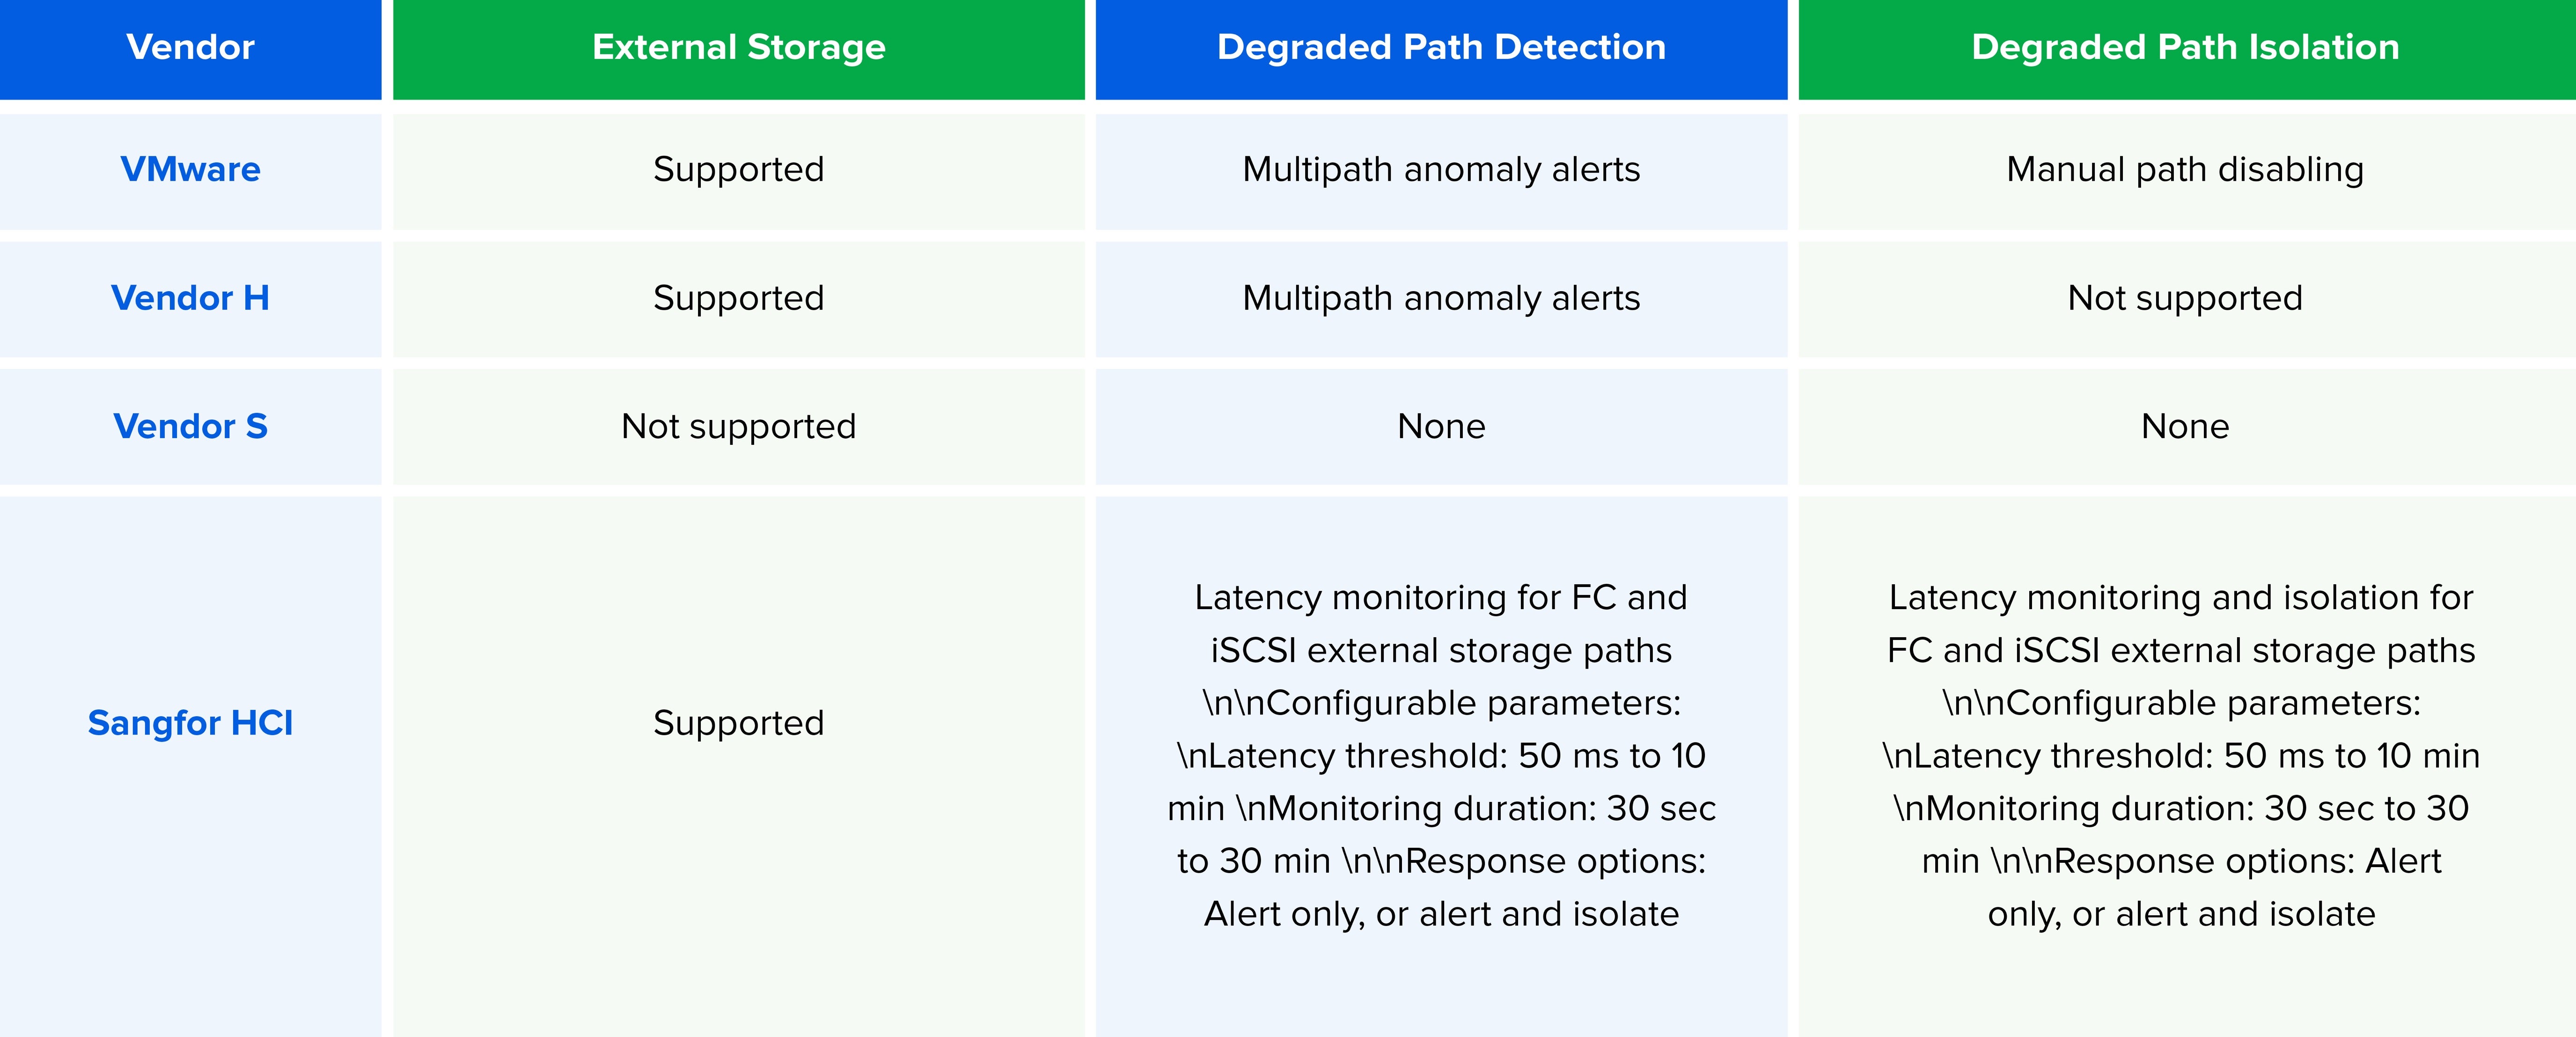
Sangfor HCI está diseñado para proporcionar una gestión del estado de la vía más amplia que las soluciones que ofrecen una cobertura de protocolo limitada, parámetros de monitorización fijos o un único método de respuesta.
1. Cobertura de monitoreo de ruta
Sangfor HCI admite la monitorización de la latencia para la conectividad de almacenamiento externo común, incluyendo Fibre Channel e iSCSI. Esto permite adaptarse a una gama más amplia de arquitecturas de almacenamiento que las plataformas con una cobertura de protocolo incompleta.
2. Flexibilidad de configuración
Los administradores pueden ajustar los umbrales de latencia y los periodos de monitorización para que reflejen las características y los requisitos de nivel de servicio de sus cargas de trabajo. Esto proporciona un control más preciso que los modelos de configuración fijos o limitados.
3. Respuesta flexible ante anomalías
Sangfor admite múltiples métodos de respuesta, incluyendo el aislamiento automático y manual. Esta flexibilidad permite a las organizaciones aplicar diferentes políticas operativas en distintos escenarios de negocio, en lugar de depender de un único método de tratamiento o de operar sin aislamiento de rutas degradadas.
Conclusión: Detecte los riesgos de almacenamiento antes de que afecten al negocio.
La degradación del almacenamiento rara vez comienza con una falla total. Con mayor frecuencia, se manifiesta como latencia intermitente, E/S bloqueadas o un rendimiento irregular de la ruta, difícil de identificar antes de que las aplicaciones se vean afectadas. Al monitorear continuamente la latencia de la ruta, aislar las conexiones degradadas y restaurar dinámicamente las rutas recuperadas, Sangfor HCI ayuda a los equipos de TI a abordar los riesgos de almacenamiento con anticipación y mantener la continuidad del servicio.
Para las organizaciones que evalúan una alternativa a VMware , la compatibilidad con el almacenamiento externo por sí sola no es suficiente. La capacidad de detectar y gestionar rutas degradadas antes de que interrumpan las cargas de trabajo críticas es igualmente importante para construir un entorno HCI resiliente.
El comportamiento de las funciones depende de la versión del producto, la arquitectura de almacenamiento, la configuración de rutas múltiples y las condiciones de carga de trabajo. Los clientes deben validar escenarios representativos en su propio entorno.
¿Está evaluando alternativas a VMware?
A medida que las organizaciones reevalúan su estrategia de virtualización, comprender el panorama general de la virtualización de servidores es igualmente importante. Sangfor fue reconocida recientemente como Visionaria en el Cuadrante Mágico de Gartner® 2026 para Plataformas de Virtualización de Servidores. Descargue el informe del Cuadrante Mágico de Gartner® para explorar las tendencias del mercado, las evaluaciones de los proveedores y las consideraciones clave al seleccionar su próxima plataforma de virtualización.