Riassumi questo articolo di notizie con l'intelligenza artificiale:
 Chiedi a ChatGPT
 Chiedi a Grok
 Chiedi a Perplexity
 Chiedi a Claude
 Chiedi a Google AI
Per molte organizzazioni, VMware vSphere è da tempo una costante: stabile, affidabile e profondamente integrato nelle attività quotidiane. Non è il tipo di piattaforma che richiede attenzione urgente, a meno che qualcosa non imponga di affrontare l’argomento.
In questo momento, qualcosa lo sta facendo.
Non un annuncio ufficiale. Non una scadenza definitiva fissata nero su bianco. Ma qualcosa di altrettanto importante: una finestra sempre più ridotta per prendere decisioni consapevoli.
Sebbene Broadcom non abbia confermato ufficialmente una data di fine supporto (EOS) per vSphere 8, vi sono elementi sufficienti, basati sui modelli storici del ciclo di vita del prodotto e sulle dinamiche di mercato, per ritenere che attendere maggiore chiarezza potrebbe avere un costo. Per la maggior parte dei clienti VMware, inoltre, il passaggio da vSphere 8 a vSphere 9 non rappresenta un semplice aggiornamento di versione, bensì un punto di svolta strategico che li costringe ad accettare un percorso di upgrade verso vSphere 9 potenzialmente costoso e dirompente, oppure a riconsiderare l’intera base della propria infrastruttura di virtualizzazione.
Una timeline abbastanza chiara da permettere di agire
VMware ha storicamente seguito un modello di ciclo di vita relativamente coerente: circa cinque anni di supporto completo, seguiti da un ulteriore periodo di supporto tecnico limitato.
Considerando che vSphere 8 è stato rilasciato nell’ottobre 2022, molti osservatori del settore e analisti dei cicli di vita prevedono:
- Fine del supporto generale (stima): intorno a ottobre 2027
- Supporto esteso/assistenza tecnica (stima): fino al 2029 circa
Sebbene non si tratti di impegni ufficiali, questi scenari hanno comunque un impatto concreto. La pianificazione strategica dell’infrastruttura non inizia quando le scadenze vengono confermate: inizia molto prima.
Secondo la ricerca di Gartner® “The VMware Migration Cost Estimation Playbook”, “la durata complessiva di una migrazione può variare significativamente, con molte organizzazioni che richiedono dai 18 ai 48 mesi per completare iniziative su scala enterprise”.
Anche in assenza di un annuncio formale di fine supporto (EOS), quindi, la conseguenza è chiara:
il margine di tempo disponibile è più ridotto di quanto possa sembrare.
Quando le tempistiche diventano ufficiali, gli effetti a cascata tendono ad accelerare rapidamente:
- I cicli di rinnovo si restringono, spesso lasciando meno spazio per negoziare o rivalutare la strategia tecnologica
- I progetti di migrazione passano da iniziative pianificate a percorsi vincolati da scadenze e maggiori rischi operativi
- L’allineamento interno tra budget, risorse e priorità diventa più complesso con l’aumentare della pressione temporale
È per questo che molti responsabili IT stanno iniziando a muoversi prima che le date siano definitive. Non perché sia necessario effettuare un cambiamento immediato, ma perché è importante:
- Comprendere l’attuale livello di esposizione (workload, dipendenze e vincoli infrastrutturali)
- Valutare architetture alternative mentre esiste ancora margine decisionale
- Costruire maggiore flessibilità nella roadmap tecnologica, evitando di trovarsi vincolati a un’unica scelta in futuro
Un approccio diverso per affrontare la prossima fase
Per le organizzazioni che stanno valutando il prossimo passo, Sangfor propone un modo diverso di ripensare l’infrastruttura esistente: non semplicemente sostituirla, ma evolverla.
Scegliere Sangfor HCI come piattaforma successiva a VMware consente una transizione fluida dei workload critici, introducendo al contempo importanti vantaggi operativi, prestazionali ed economici. Sangfor offre funzionalità enterprise equivalenti ai principali componenti dell’ecosistema VMware: High Availability, gestione completa delle macchine virtuali, networking avanzato, all’interno di uno stack integrato e gestibile tramite un’unica console centralizzata.
Tuttavia, il valore reale risiede nella capacità di andare oltre queste funzionalità di base, grazie a caratteristiche innovative pensate per rispondere direttamente alle principali sfide che oggi i team IT devono affrontare.
I principali vantaggi di Sangfor HCI per la migrazione
-
Sangfor Memory Tiering: ottimizzare prestazioni e costi
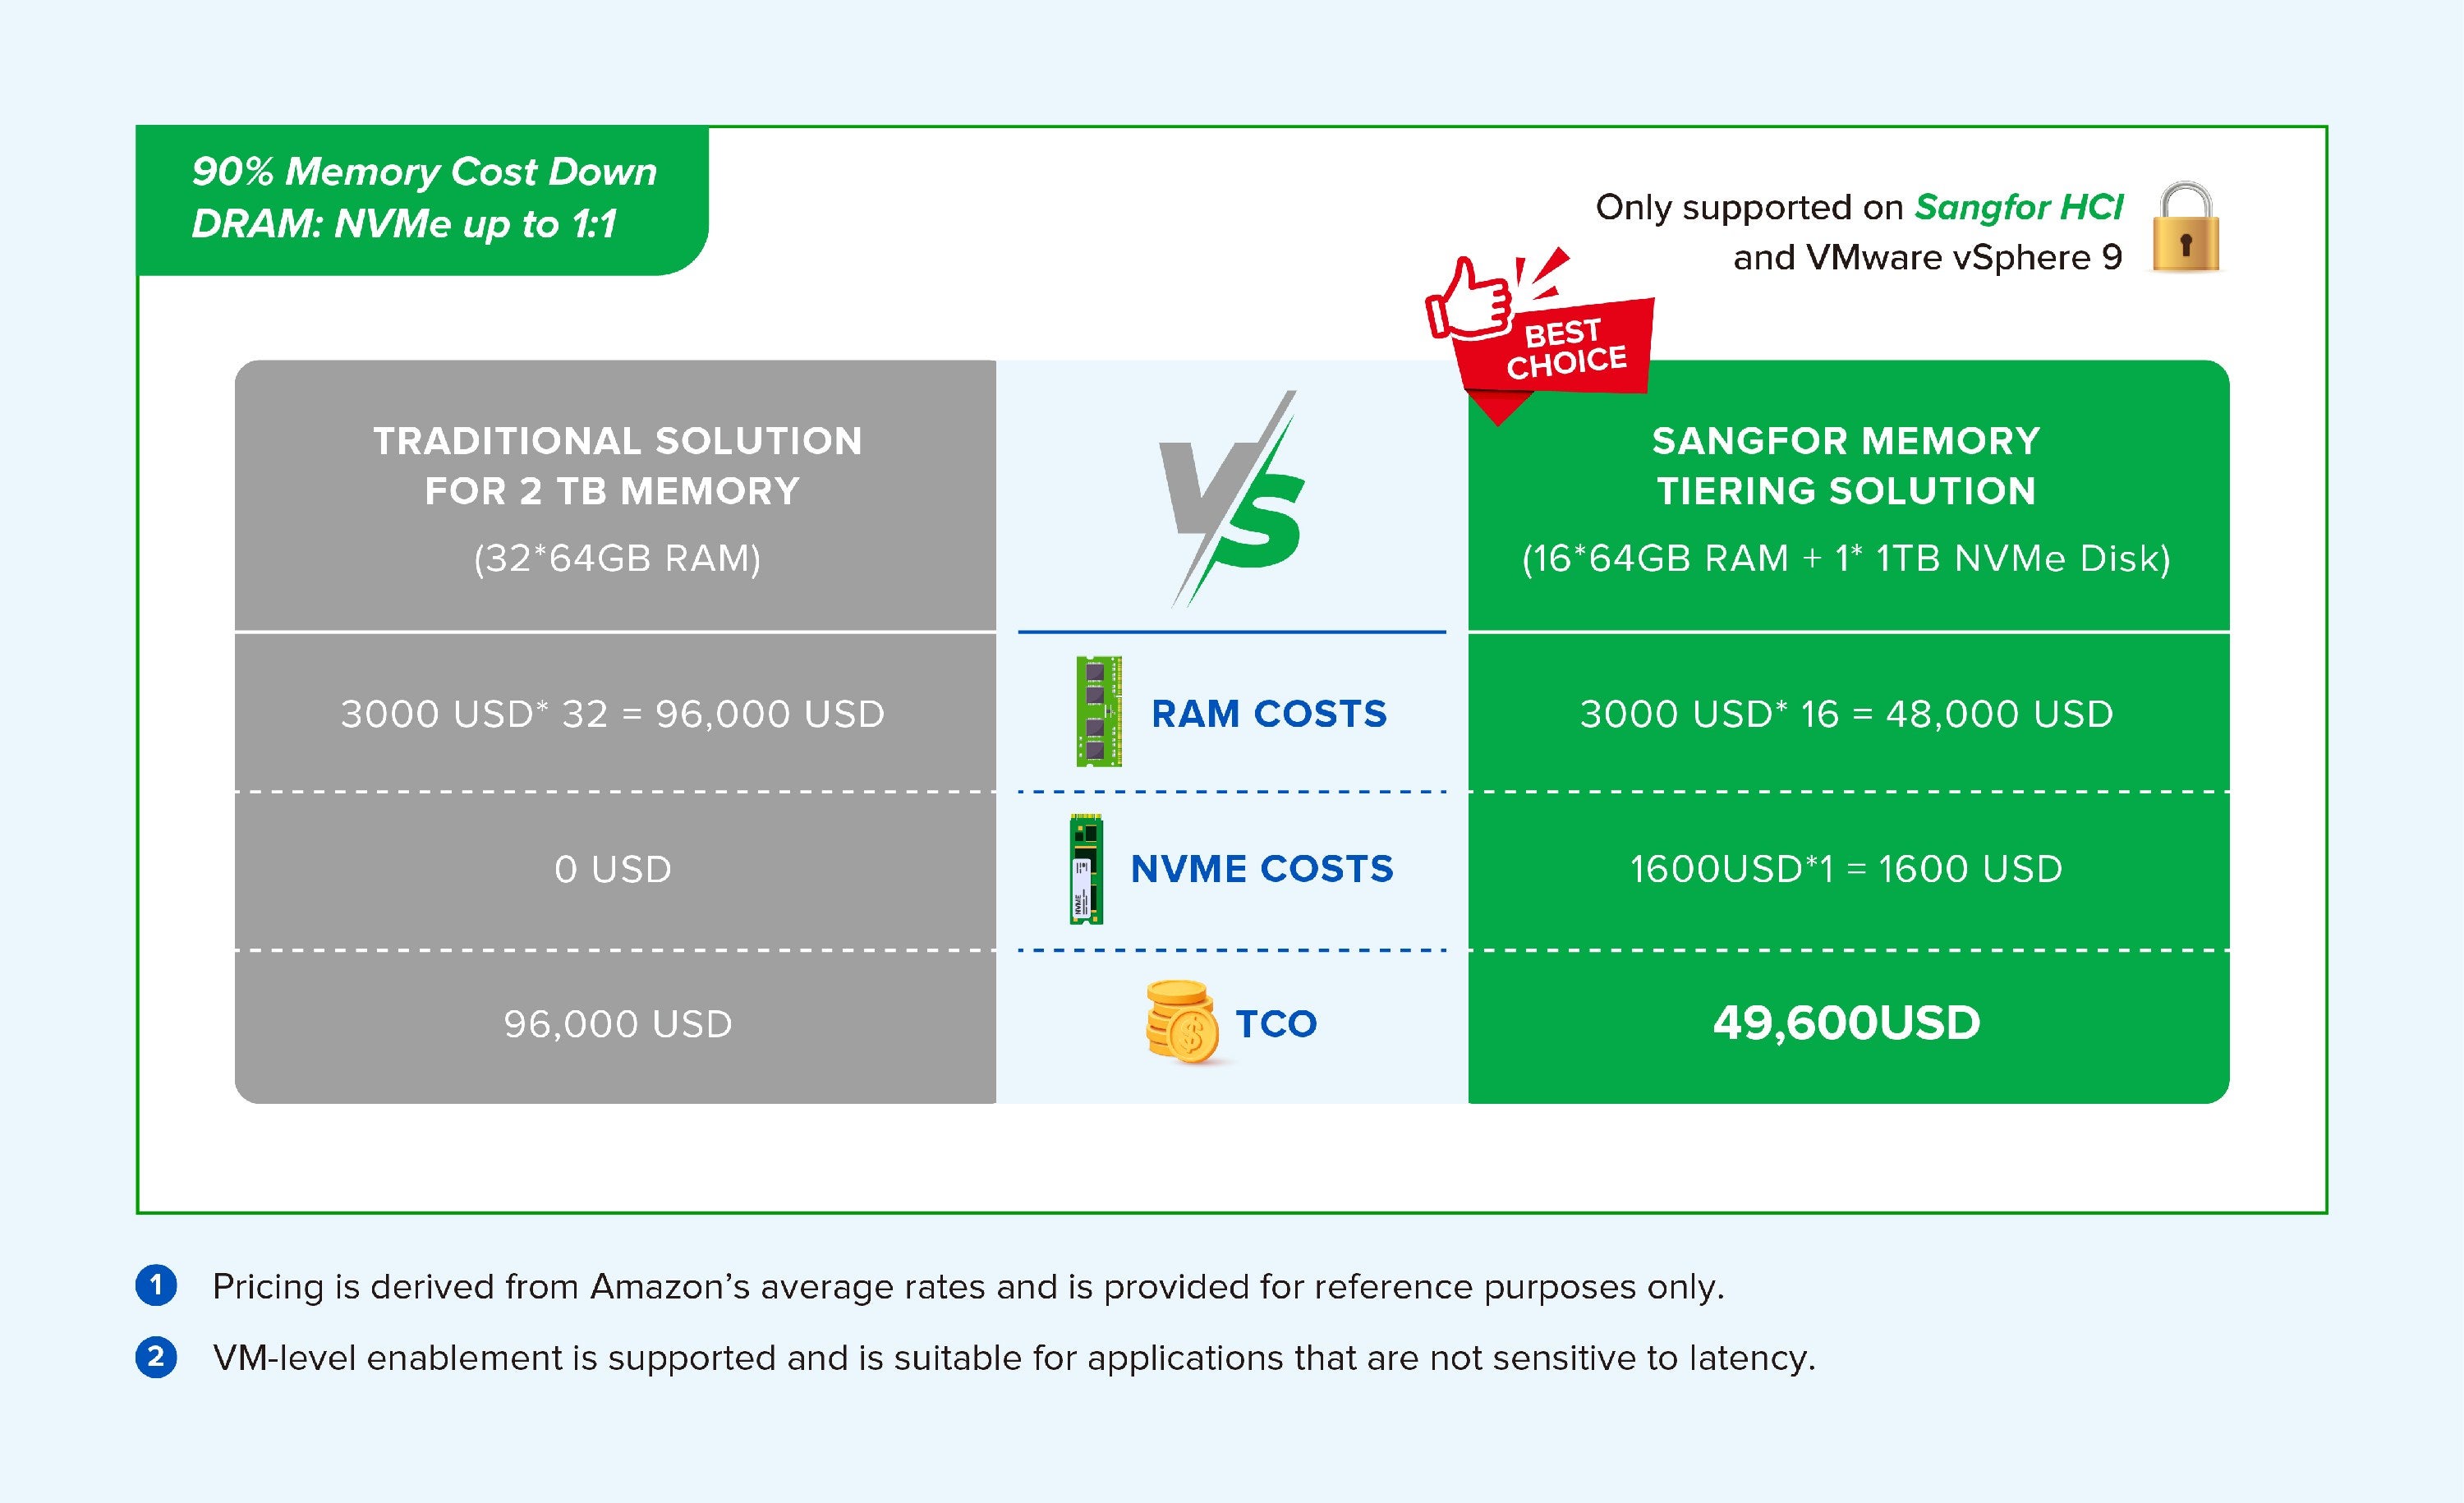
Una delle innovazioni di punta di Sangfor, confrontata con VMware vSphere 9 senza costi aggiuntivi di licenza, è il Memory Tiering: una tecnologia che crea in modo intelligente un pool di memoria dinamico combinando la velocità della DRAM ad alte prestazioni con una memoria persistente più conveniente (come Intel Optane).Questa tecnologia assegna automaticamente i dati più “caldi” (hot), ovvero quelli a cui si accede più frequentemente, alla DRAM per garantire le massime prestazioni, mentre trasferisce i dati “tiepidi” (warm) al livello di memoria persistente.Il risultato? È possibile supportare un numero maggiore di applicazioni ad alta intensità di memoria, come applicazioni Web, ERP, microservizi e middleware, senza sostenere il costo elevato necessario per equipaggiare i server utilizzando esclusivamente memoria DRAM.Questo si traduce direttamente in una maggiore densità di macchine virtuali, prestazioni applicative superiori e una riduzione significativa del Total Cost of Ownership (TCO) rispetto alle architetture tradizionali, consentendo di ottenere più valore dagli investimenti infrastrutturali.
-
DRS 2.0 Intelligente: bilanciamento del carico proattivo e consapevole dello storage
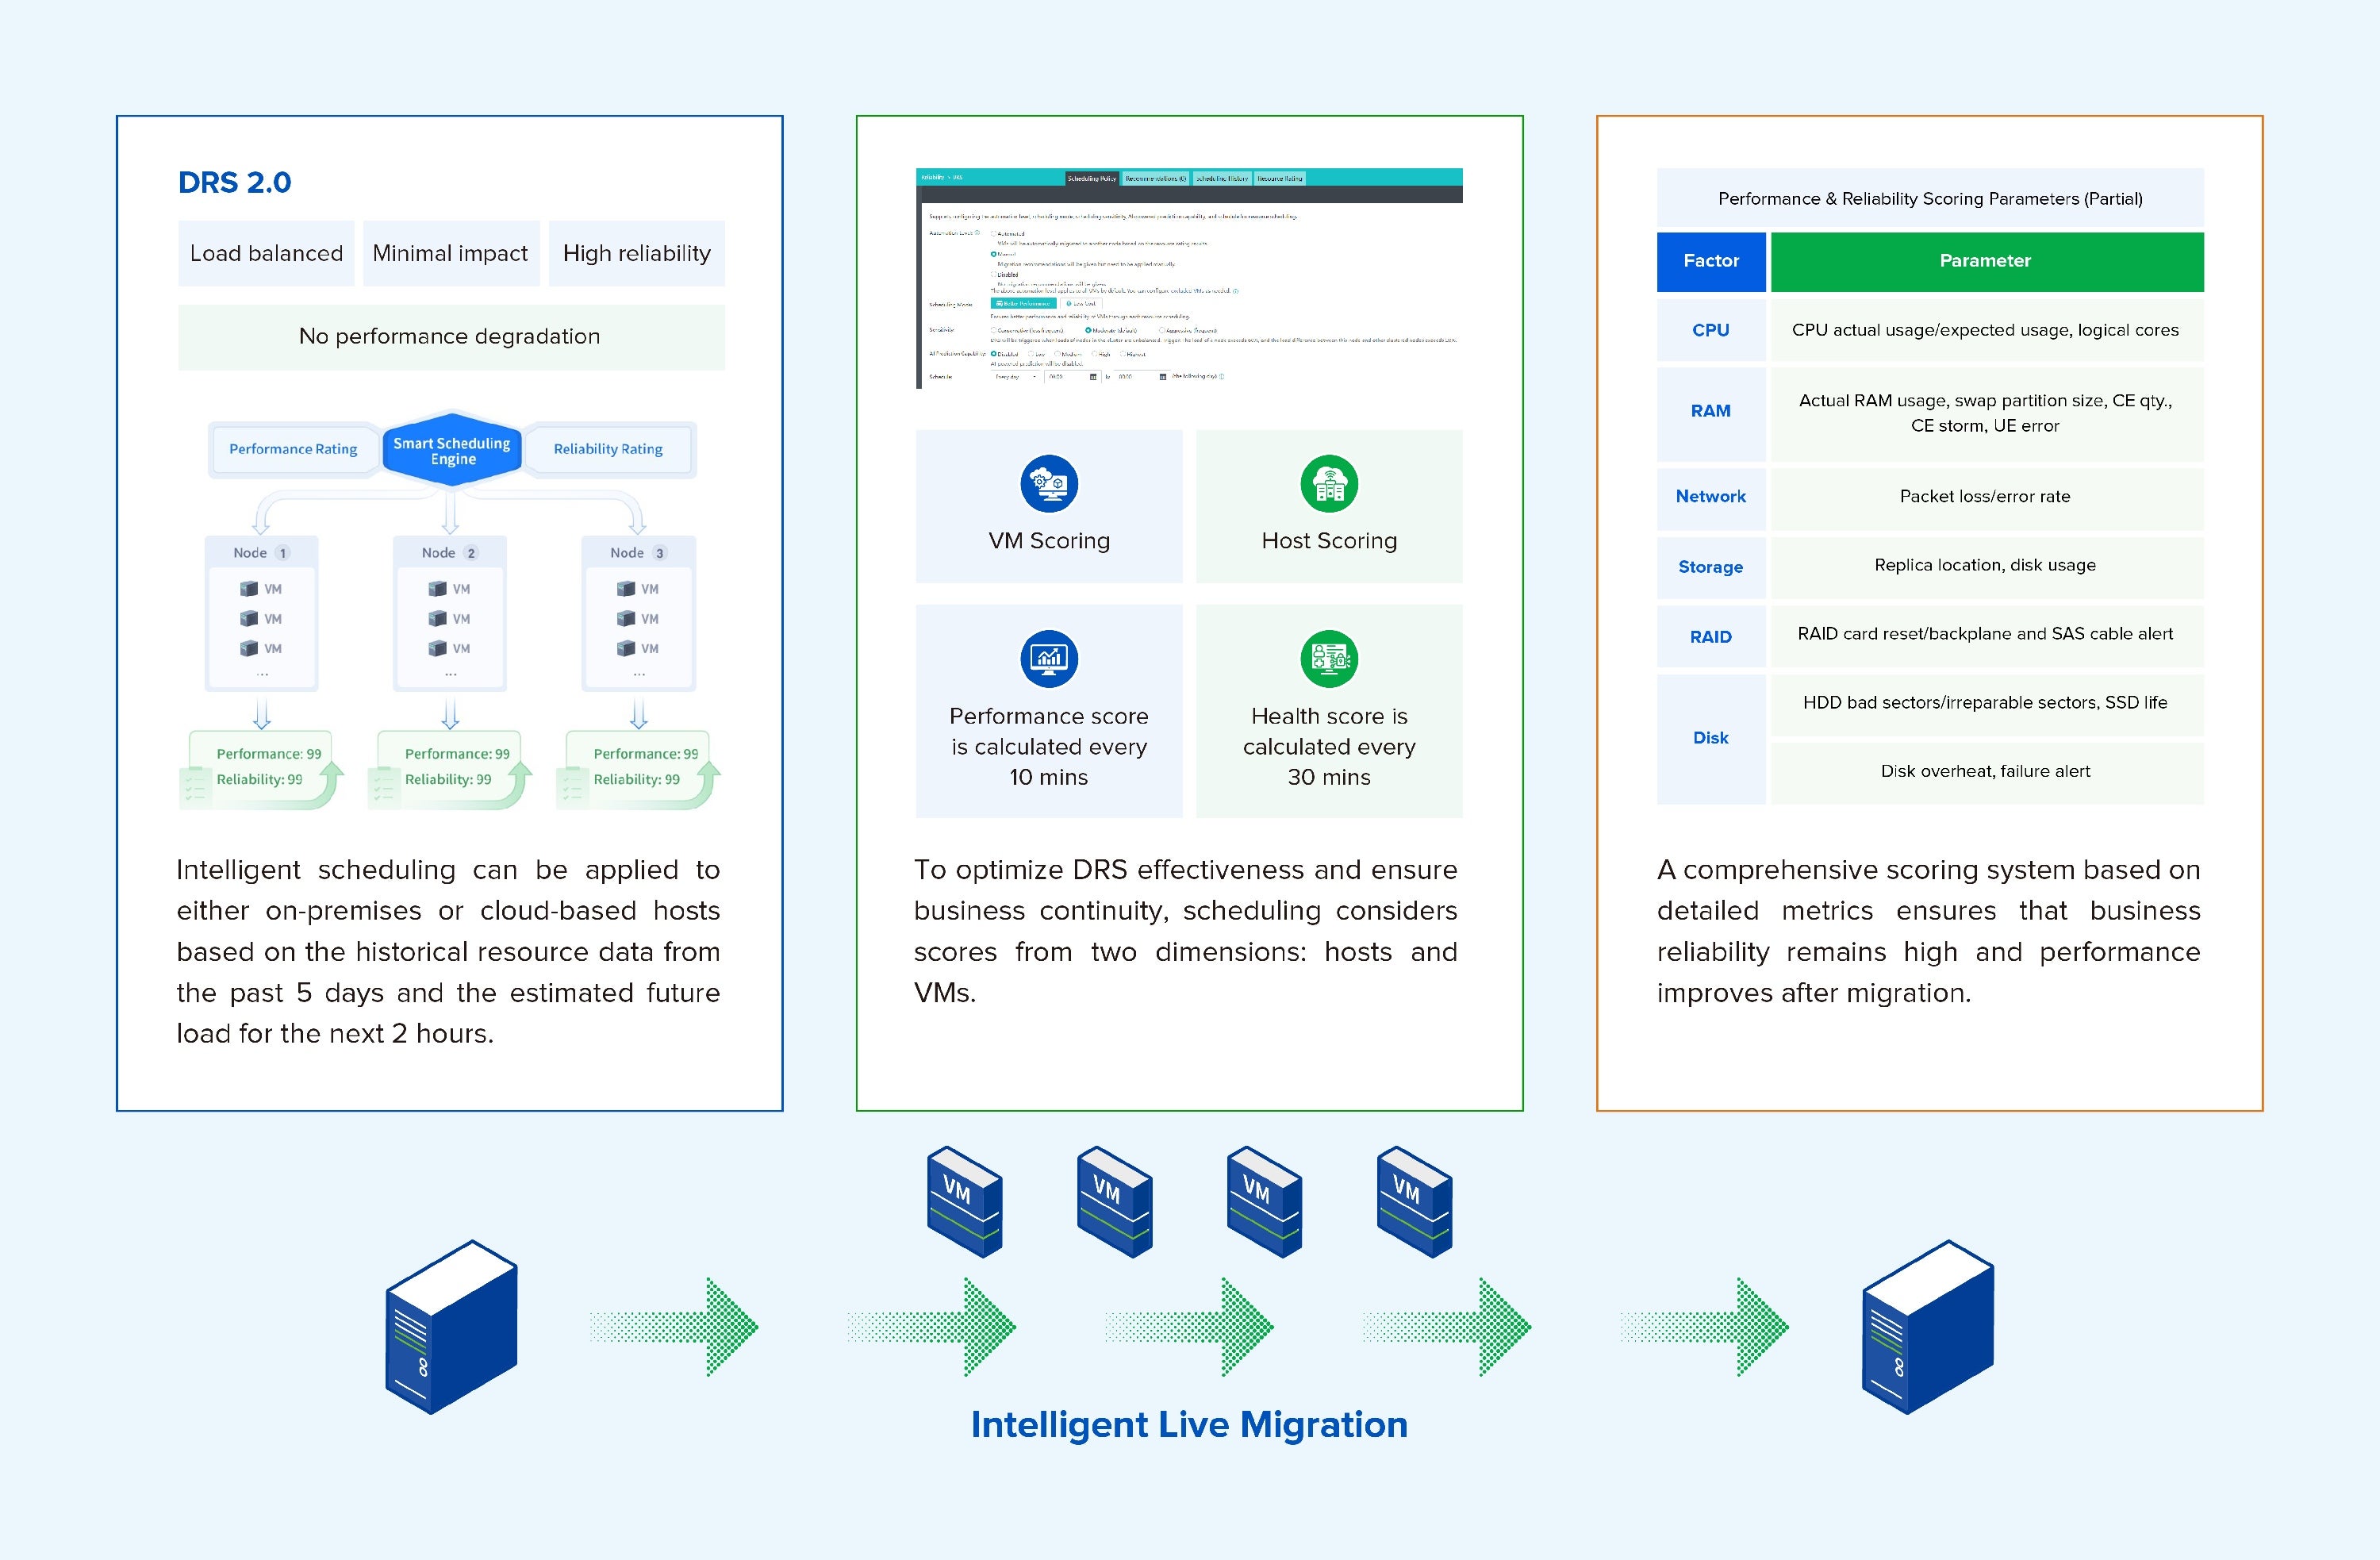
In VMware vSphere 8, il DRS implementa esclusivamente un bilanciamento del carico di base e non supporta una previsione avanzata delle prestazioni delle macchine virtuali dopo una migrazione. L’analisi basata sull’intelligenza artificiale è stata introdotta in VMware vSphere 9 per consentire una previsione più intelligente delle prestazioni delle VM in seguito allo spostamento dei workload.Sangfor DRS 2.0 rappresenta un sistema significativamente più evoluto. È completamente storage-aware, ovvero considera anche il carico di I/O e la latenza dello storage, evitando di creare nuovi colli di bottiglia mentre risolve quelli legati alle risorse di calcolo.Inoltre, utilizza funzionalità di analisi predittiva per anticipare potenziali situazioni di contesa delle risorse prima che possano influire sulle prestazioni applicative.Questo ribilanciamento proattivo e intelligente garantisce un utilizzo ottimale delle risorse sia lato compute sia lato storage, offrendo livelli di prestazioni ed efficienza costanti che i sistemi basati esclusivamente su interventi reattivi non sono in grado di garantire.
-
Rilevamento proattivo dello stato hardware: dalla gestione reattiva alle operazioni predittive
I guasti hardware non pianificati rappresentano una delle principali cause di downtime. Il sistema Sangfor Proactive Hardware Sub-Health Detection consente di passare da un modello di manutenzione reattivo a un approccio predittivo.Attraverso il monitoraggio continuo dei parametri chiave di tutti i componenti critici (come SSD, HDD, memoria, alimentatori (PSU) e ventole) gli algoritmi di analisi sono in grado di identificare segnali di degrado precoci, come l’aumento dei settori danneggiati, l’incremento della latenza di lettura o la presenza di errori di memoria correggibili, molto prima che si verifichi un guasto completo.Il sistema fornisce alert precisi e tempestivi, consentendo al team IT di pianificare la sostituzione dei componenti durante finestre di manutenzione programmate, prevenendo interruzioni critiche e garantendo maggiore stabilità, affidabilità e continuità operativa dell’infrastruttura.
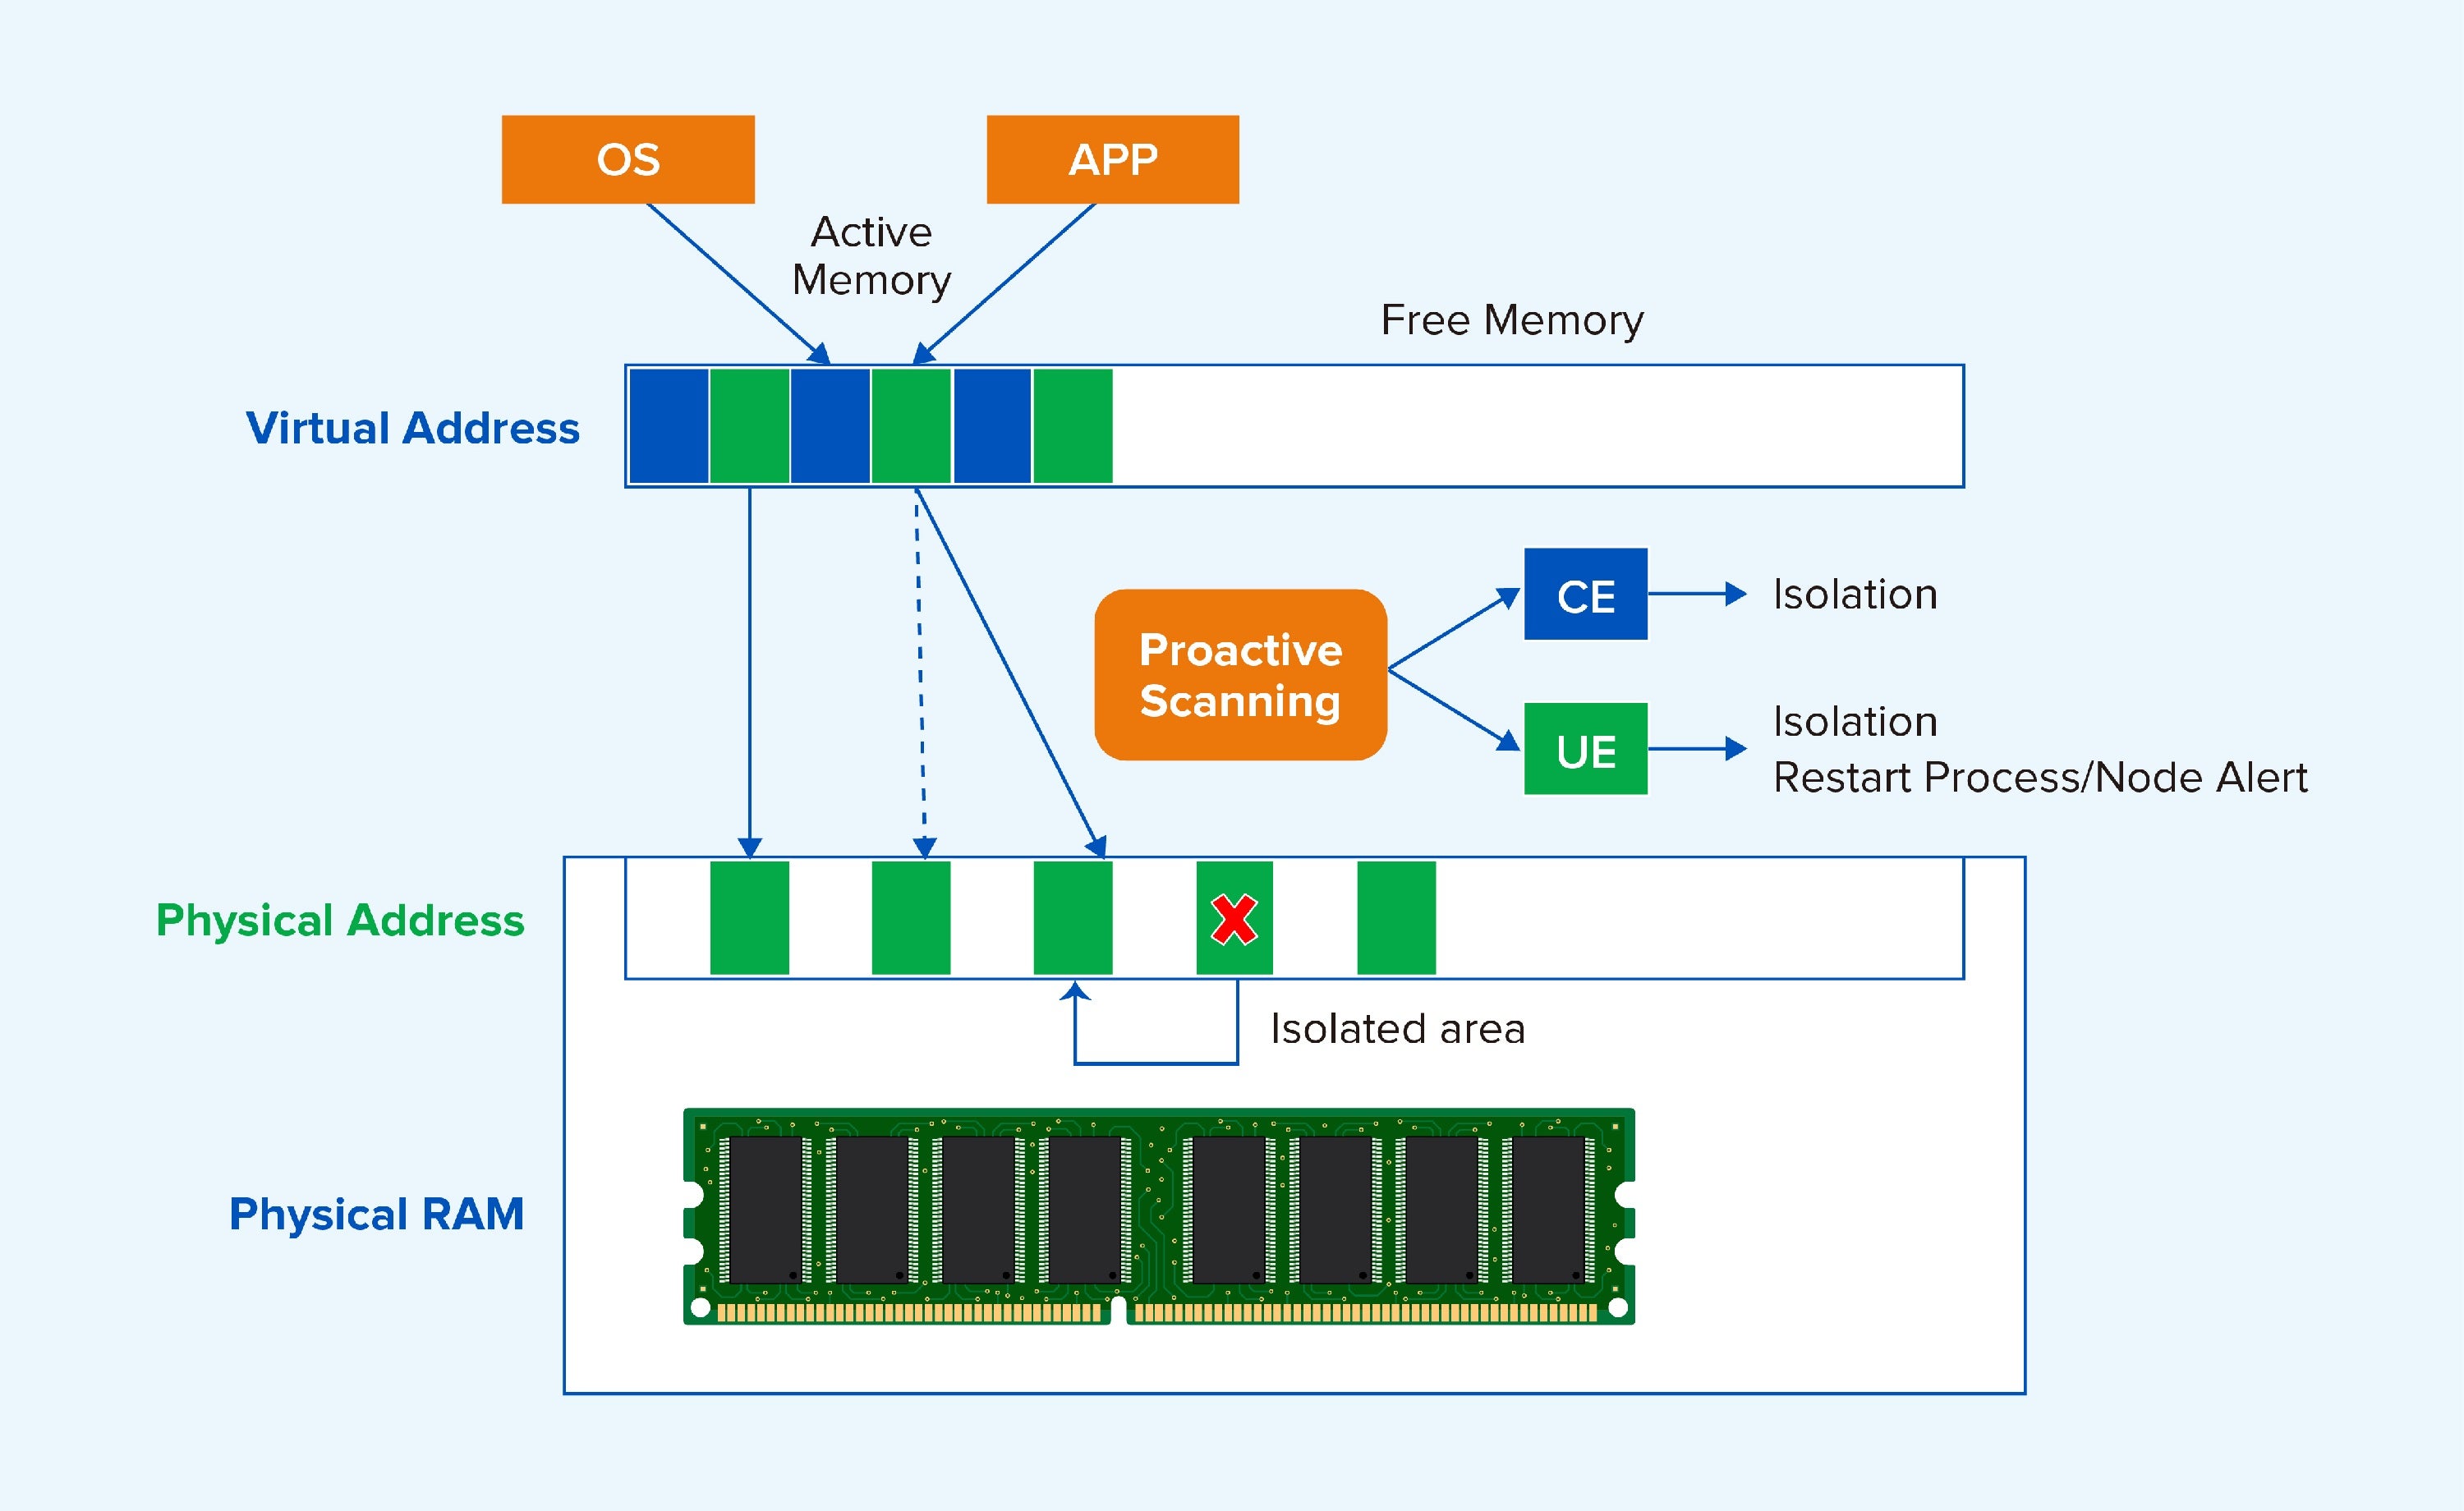
Prendiamo come esempio il rilevamento dello stato della memoria. VMware utilizza un meccanismo di monitoraggio che rileva le segnalazioni di errore relative alle interazioni entre CPU e memoria, mentre Sangfor adotta scansioni proattive periodiche per identificare attivamente errori CE/UE (Correctable Error/Uncorrectable Error), consentendo un rilevamento anticipato dei problemi.
Quando VMware rileva un errore CE o UE, ESXi monitora la frequenza cumulativa degli errori correggibili (CE). Se la frequenza supera una determinata soglia in un intervallo di tempo specifico (ad esempio, ≥4 volte nell’arco di 24 ore), viene generato un “Memory Health Alert” e l’admin viene invitato a sostituire i moduli di memoria per evitare che eventuali errori critici possano evolvere in guasti hardware.Una volta rilevato un errore UE, ESXi contrassegna immediatamente la pagina di memoria fisica interessata come “ritirata” (retired) e forza lo spegnimento della macchina virtuale che utilizza quella pagina di memoria, isolando il problema e prevenendo fenomeni come il Purple Screen of Death (PSOD) o la corruzione dei dati sull’host.Dopo il rilevamento di un errore CE/UE, Sangfor adotta invece un approccio più proattivo isolando immediatamente i blocchi di memoria da 2 MB, garantendo che il flusso dei dati avvenga sempre attraverso indirizzi di memoria affidabili.Rispetto a un semplice sistema di segnalazione degli errori, Sangfor consente alle organizzazioni di evitare l’utilizzo di indirizzi di memoria anomali già nelle fasi iniziali del problema, riducendo ulteriormente il rischio di interruzioni e malfunzionamenti.
-
Supporto a lungo termine dei sistemi operativi guest
Con vSphere 9, VMware ha interrotto il supporto per diversi sistemi operativi legacy, tra cui RHEL 8, CentOS 7, Ubuntu 22.10 e Windows Server 2008 R2. Questo significa che, durante l’aggiornamento della piattaforma di virtualizzazione, i clienti potrebbero essere costretti ad aggiornare anche le proprie macchine virtuali e le applicazioni che vi vengono eseguite, con un conseguente aumento significativo dei costi e una maggiore complessità nella gestione della transizione.Al contrario, analizzando Sangfor HCI, è ancora possibile trovare nell’elenco ufficiale di compatibilità il supporto per sistemi operativi guest molto datati, come Windows Server 2000/2003 e Red Hat Enterprise Linux 5.Questo approccio consente a Sangfor di offrire ai clienti un supporto più esteso nel tempo e una maggiore stabilità operativa, facilitando la gestione di ambienti legacy e riducendo la pressione derivante da aggiornamenti obbligatori di sistemi e applicazioni.
Considerazione finale: non si tratta della data esatta
La data precisa di fine supporto per vSphere 8 potrebbe non essere ancora stata confermata ufficialmente. Tuttavia, la direzione del mercato appare sufficientemente chiara. Continuare a seguire un percorso di aggiornamento obbligato all’interno dell’ecosistema VMware potrebbe comportare:
- un aumento significativo dei costi legati a licenze e sottoscrizioni software;
- un ulteriore ciclo di migrazioni potenzialmente complesse e disruptive;
- una continua dipendenza strategica dalla roadmap di un singolo fornitore.
La scelta di Sangfor HCI offre invece:
- un percorso di migrazione comprovato e a basso rischio, supportato da strumenti e metodologie validate per il trasferimento dei workload VMware;
- un Total Cost of Ownership (TCO) prevedibile e spesso inferiore, grazie a un modello di licensing trasparente;
- accesso a funzionalità innovative come Memory Tiering e Predictive DRS 2.0, in grado di offrire vantaggi immediati in termini di prestazioni ed efficienza operativa;
- una gestione semplificata dell’infrastruttura, con la possibilità di amministrare cluster Sangfor HCI, tenant, macchine virtuali e persino ambienti VMware attraverso un’unica piattaforma.Dalle architetture three-tier con storage esterno alle infrastructures iperconvergenti basate su software-defined data center, fino alla disaster recovery, al backup e agli ambienti multi-cluster eterogenei, Sangfor offre soluzioni flessibili in grado di adattarsi alle diverse esigenze infrastrutturali delle organizzazioni.
Conclusione: affrontare il futuro con fiducia
La transizione VMware introdotta a seguito delle nuove strategie di Broadcom non deve necessariamente rappresentare un ostacolo. Può diventare un’opportunità strategica per costruire una base IT più agile, intelligente ed efficiente dal punto di vista dei costi.Sangfor HCI non offre soltanto un’equivalenza funzionale rispetto alle piattaforme esistenti, ma anche un percorso concreto verso un’infrastruttura più evoluta, caratterizzata da operatività senza interruzioni, capacità predittive basate sull’intelligenza artificiale ed elevata efficienza.
Invitiamo le organizzazioni a valutare direttamente queste possibilità. È il momento di analizzare come affrontare il periodo successivo al 2027 con maggiore consapevolezza e controllo. Sangfor mette a disposizione consulenze tecniche approfondite, POC per testare i workload specifici e una roadmap chiara verso un data center pronto per il futuro, basato su innovazione e flessibilità.
Prima si inizia il percorso di valutazione, maggiore sarà il controllo che le organizzazioni potranno mantenere sulle proprie scelte tecnologiche future.