Für viele Unternehmen ist VMware vSphere seit Langem eine Konstante – stabil, zuverlässig und fest in den täglichen Betrieb integriert. Es ist nicht die Art von Plattform, die dringende Aufmerksamkeit erfordert, es sei denn, etwas zwingt zum Nachdenken.
Im Moment ist etwas so.
Keine formelle Ankündigung. Keine in Stein gemeißelte Frist. Sondern etwas, das wohl genauso wichtig ist: ein immer kleiner werdendes Zeitfenster für fundierte Entscheidungen.
Broadcom hat zwar noch kein offizielles Supportende für vSphere 8 bestätigt, doch die bisherigen Lebenszyklusmuster und die Marktdynamik lassen vermuten, dass ein Abwarten mit Kosten verbunden sein könnte . Für die meisten VMware-Kunden ist das Upgrade von vSphere 8 auf vSphere 9 jedoch nicht nur ein routinemäßiges Versionsupdate, sondern ein strategischer Wendepunkt. Sie müssen sich entscheiden: Entweder sie akzeptieren einen kostspieligen und potenziell störenden Upgrade-Pfad zu vSphere 9 oder sie überdenken ihre gesamte Virtualisierungsinfrastruktur.
Ein Zeitplan, der klar genug ist, um zu handeln
VMware verfolgte in der Vergangenheit ein relativ einheitliches Lebenszyklusmodell: etwa fünf Jahre voller Support, gefolgt von einer zusätzlichen Phase mit eingeschränkter technischer Unterstützung.
Da vSphere 8 im Oktober 2022 veröffentlicht wurde, prognostizieren viele Branchenbeobachter und Lifecycle-Tracker Folgendes:
- Ende der allgemeinen Unterstützung (voraussichtlich): etwa Oktober 2027
- Erweiterter/Technischer Support (voraussichtlich): bis etwa 2029
Auch wenn es sich hierbei nicht um offizielle Zusagen handelt, sind sie in der Praxis dennoch von Bedeutung. Die Infrastrukturstrategie beginnt nicht erst mit der Bestätigung von Fristen, sondern lange davor .
Laut der Gartner®-Studie „The VMware Migration Cost Estimation Playbook“ kann die Dauer einer vollständigen Migration stark variieren, wobei viele Unternehmen für Vorhaben im Unternehmensmaßstab 18 bis 48 Monate benötigen.
Auch ohne eine formelle Ankündigung des Betriebsendes ist die Schlussfolgerung eindeutig:
Die Start- und Landebahn ist kürzer als sie aussieht.
Sobald Zeitpläne offiziell werden, beschleunigen sich die Folgeeffekte in der Regel rasant:
- Die Erneuerungszyklen verengen sich, oft mit weniger Spielraum für Verhandlungen oder eine Neubewertung der Richtung.
- Migrationsprojekte verlagern sich von strategischen Initiativen zu zeitlich begrenzten Ausführungsrisiken.
- Die interne Abstimmung (Budget, Ressourcen, Prioritäten) wird mit zunehmender Dringlichkeit schwieriger.
Deshalb handeln viele IT-Verantwortliche bereits, bevor die Termine endgültig feststehen. Nicht weil sie sofort handeln müssen, sondern weil sie es müssen:
- Verstehen Sie ihre aktuelle Gefährdung (Arbeitsbelastung, Abhängigkeiten, Einschränkungen)
- Prüfen Sie alternative Architekturentwürfe, solange noch genügend Zeit vorhanden ist.
- Sie sollten Wahlmöglichkeiten in ihre Roadmap einbauen, anstatt sich später auf einen einzigen Weg festzulegen.
Ein anderer Ansatz für die nächste Phase
Für Organisationen, die ihren nächsten Schritt planen, bietet Sangfor die Möglichkeit, nicht nur die bestehende Umgebung zu ersetzen, sondern sie grundlegend zu überdenken.
Die Wahl von Sangfor HCI als Nachfolger von VMware gewährleistet einen reibungslosen Übergang aller kritischen Workloads und bietet gleichzeitig signifikante Vorteile in Bezug auf Betrieb, Leistung und Wirtschaftlichkeit. Sangfor bietet robuste, unternehmensgerechte Alternativen zu den Kernfunktionen von VMware: Hochverfügbarkeit (HA), umfassendes VM-Management und robuste Netzwerkfunktionen – alles in einem nahtlos integrierten Stack, der über eine zentrale Benutzeroberfläche verwaltet wird.
Der wahre Wert liegt jedoch darin, diese Grundlagen mit bahnbrechenden Funktionen zu übertreffen, die direkt auf die heutigen IT-Probleme eingehen.
Die wichtigsten Vorteile von Sangfor HCI für Ihre Migration
-
Sangfor Memory Tiering: Leistung und Kosten optimieren
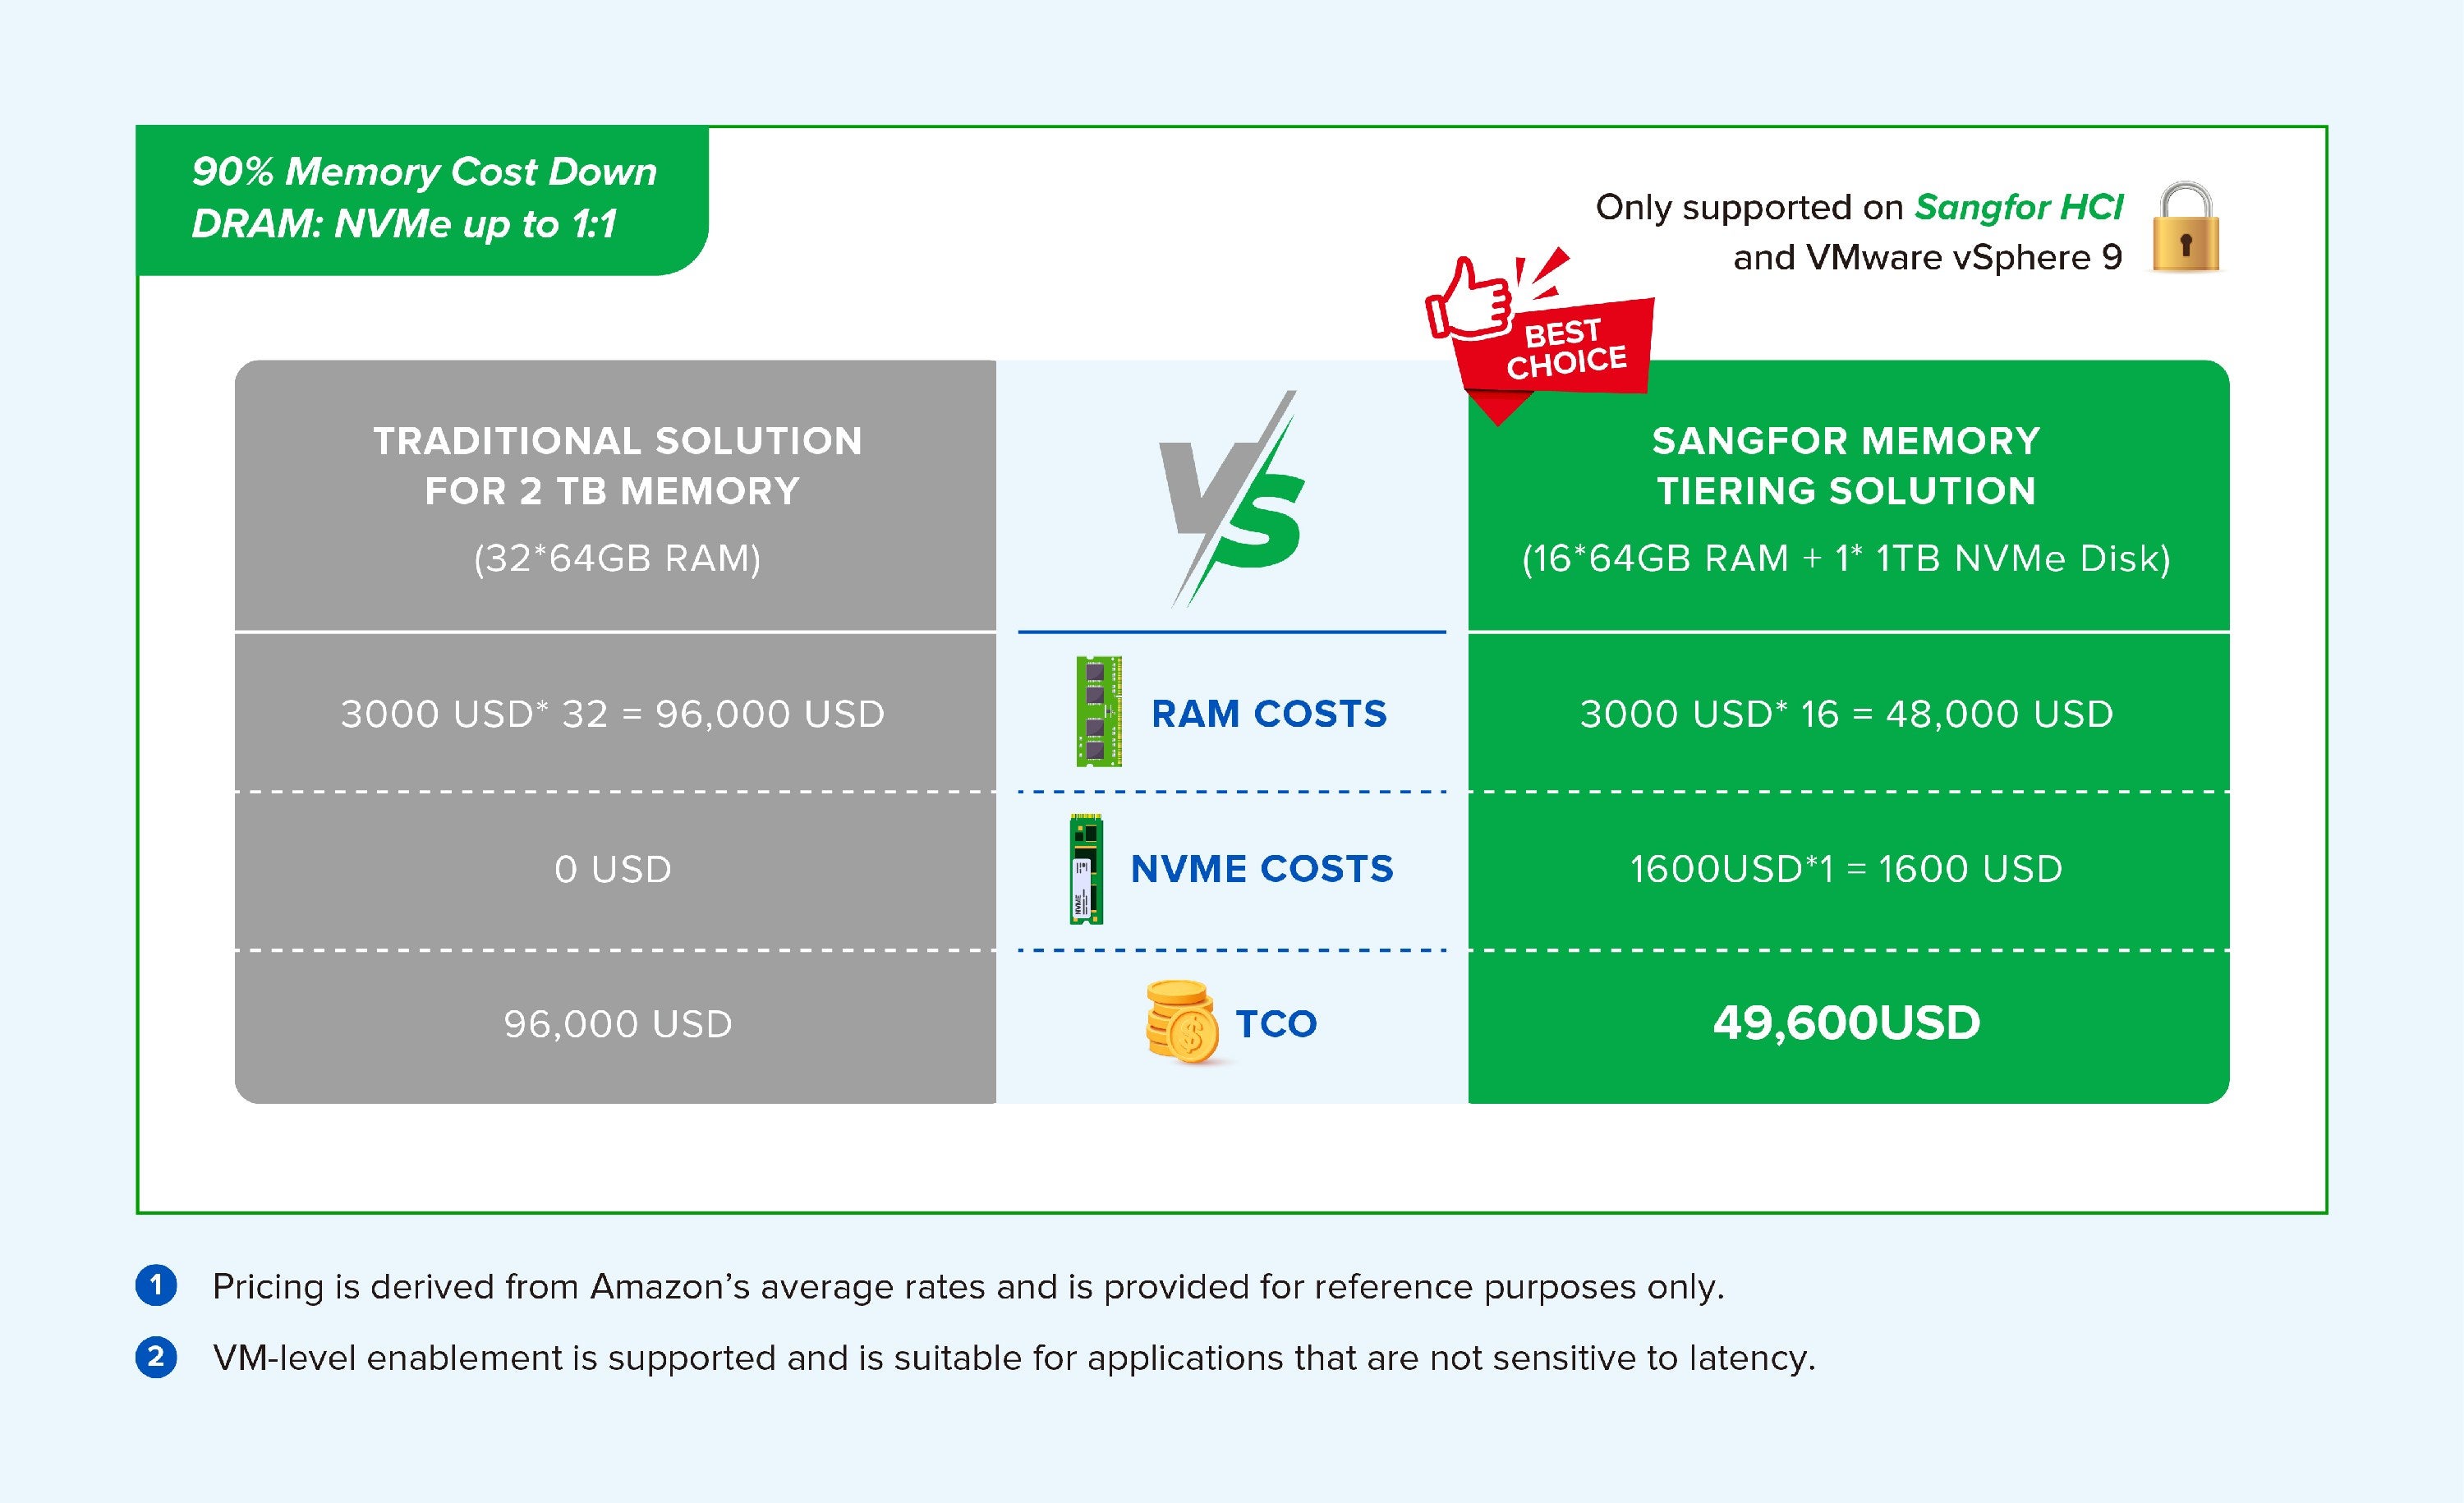
Eine unserer wichtigsten Innovationen, die sich im Vergleich zu VMware vSphere 9 ohne zusätzliche Lizenz bewährt hat, ist Memory Tiering . Diese Technologie erstellt intelligent einen dynamischen Speicherpool, der Hochgeschwindigkeits-DRAM mit kostengünstigerem persistentem Speicher (wie Intel Optane) kombiniert. Häufig genutzte Daten werden automatisch im DRAM platziert, um maximale Leistung zu erzielen, während weniger häufig genutzte Daten in den persistenten Speicher verschoben werden. Das Ergebnis: Sie können speicherintensive Anwendungen (Web, ERP, Microservices, Middleware) unterstützen, ohne die hohen Kosten für die alleinige Ausstattung von Servern mit DRAM tragen zu müssen. Dies führt direkt zu einer höheren VM- Dichte, besserer Anwendungsleistung und deutlich niedrigeren Gesamtbetriebskosten im Vergleich zu herkömmlichen Architekturen – und maximiert so Ihre Investitionsrendite.
-
Intelligentes DRS 2.0: Proaktiver und speicherbewusster Lastausgleich
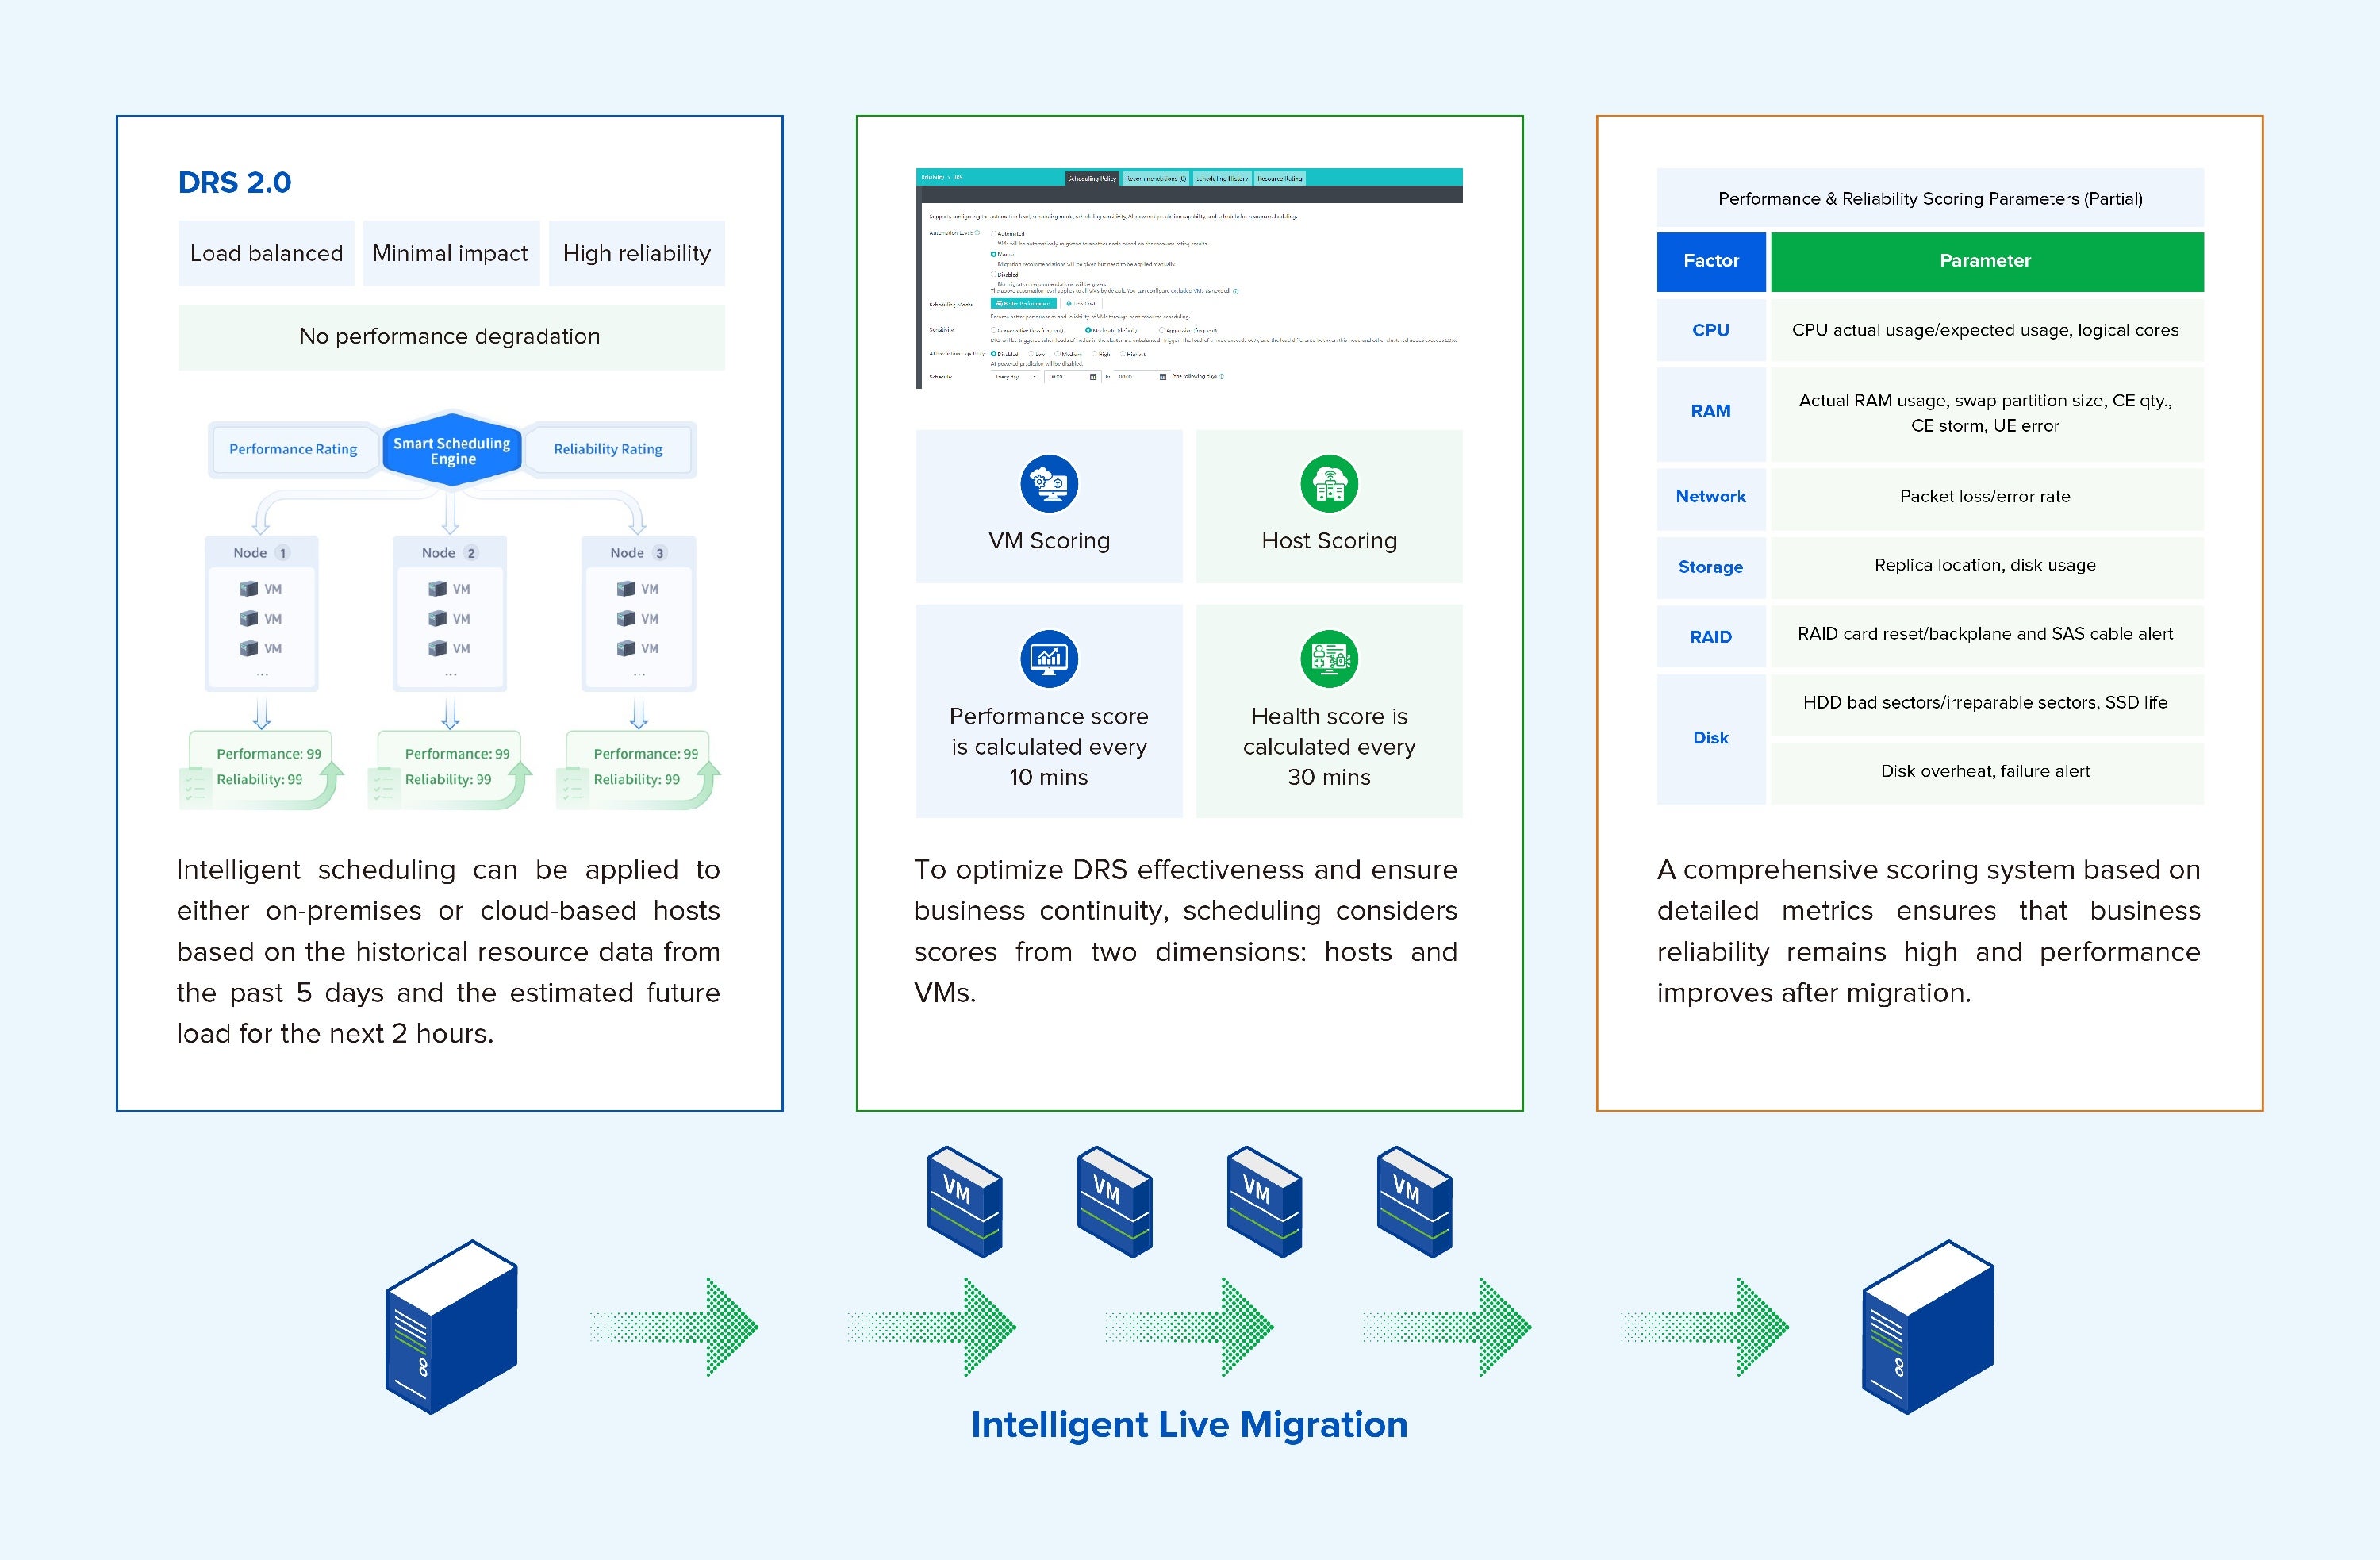
In VMware vSphere 8 implementierte DRS lediglich grundlegendes Load Balancing und unterstützte keine detaillierte Leistungsprognose nach der Migration. Erst mit VMware vSphere 9 wurde die KI-Analyse eingeführt, um die Leistung virtueller Maschinen nach der Migration intelligent vorherzusagen. Sangfors DRS 2.0 ist ein deutlich fortschrittlicheres System. Es berücksichtigt die Speicher-E/A-Last und -Last, um neue Engpässe zu vermeiden und gleichzeitig Rechenengpässe zu beheben. Darüber hinaus nutzt es prädiktive Analysen, um Ressourcenkonflikte vorherzusagen, bevor diese die Anwendungsleistung beeinträchtigen. Dieses proaktive, intelligente Rebalancing gewährleistet eine optimale Ressourcennutzung sowohl im Rechen- als auch im Speicherbereich und liefert so eine konstant hohe Leistung und Effizienz, die reaktive Systeme nicht erreichen können.
-
Proaktive Erkennung von Hardware-Unterfunktionen: Vom reaktiven zum prädiktiven Betrieb
Ungeplante Hardwareausfälle sind eine Hauptursache für Ausfallzeiten. Das proaktive Hardware-Zustandserkennungssystem von Sangfor ermöglicht Ihnen den Übergang von einer reaktiven zu einer vorausschauenden Wartung. Durch die kontinuierliche Überwachung wichtiger Kennzahlen aller kritischen Komponenten (SSDs, HDDs, Arbeitsspeicher, Netzteile, Lüfter) erkennen unsere Algorithmen frühzeitig Warnsignale – wie beispielsweise eine Zunahme defekter Sektoren, steigende Leselatenzen oder korrigierbare Speicherfehler – lange bevor es zu einem Totalausfall kommt. Das System liefert präzise Warnmeldungen, sodass Ihr IT-Team den Austausch von Komponenten in Wartungsfenstern planen und so schwerwiegende Ausfälle verhindern sowie eine außergewöhnliche Stabilität und Zuverlässigkeit Ihrer Infrastruktur gewährleisten kann.
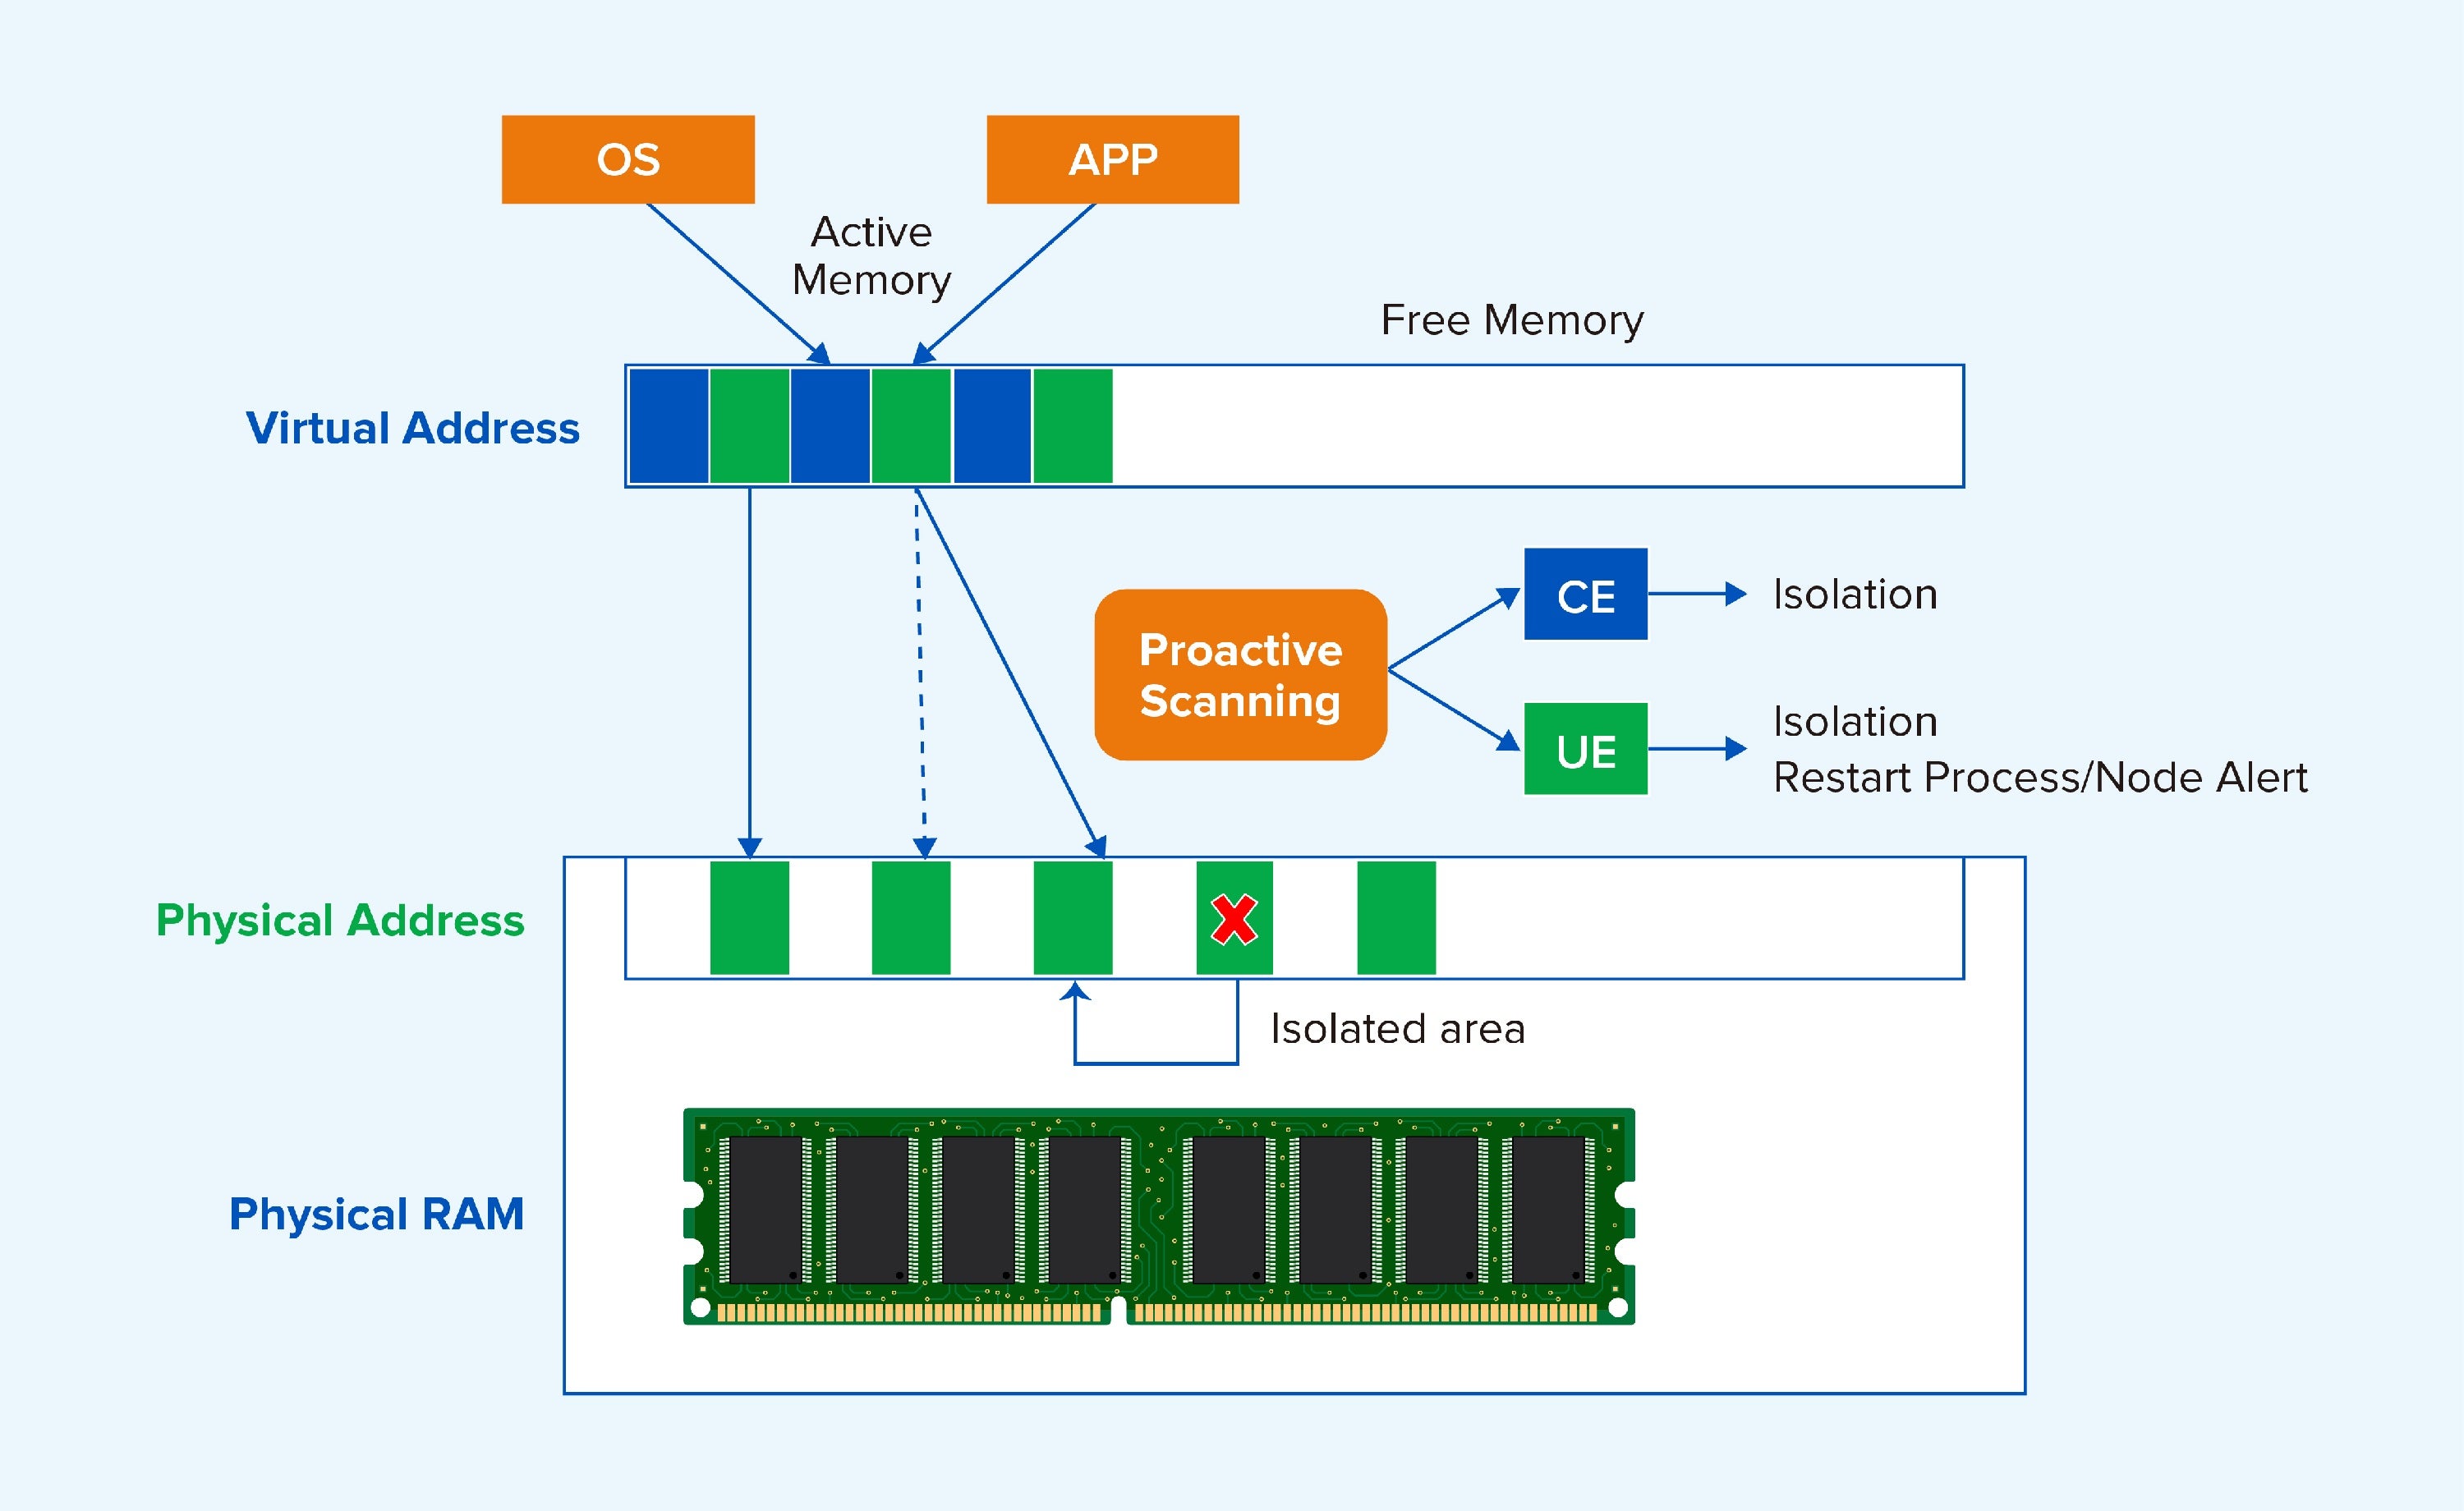
Nehmen wir die Speicherzustandsüberwachung als Beispiel. VMware verwendet einen Überwachungsmechanismus, der Fehlerberichte bezüglich der Interaktionen zwischen CPU und Speicher erfasst, während Sangfor regelmäßige proaktive Scans einsetzt, um CE/UE aktiv zu erkennen und so eine frühzeitige Problemerkennung zu ermöglichen.
Nachdem VMware einen CE (Common Error) oder UE (Unified Error) erkannt hat, überwacht ESXi die kumulative Häufigkeit dieser Ereignisse. Überschreitet die Häufigkeit innerhalb eines bestimmten Zeitraums einen Schwellenwert (z. B. ≥ 4 Mal pro 24 Stunden), wird eine „Speicherzustandswarnung“ ausgelöst, und dem Administrator wird empfohlen, die Speichermodule auszutauschen, um eine Eskalation potenzieller schwerwiegender Fehler zu verhindern. Sobald ein UE erkannt wird, markiert ESXi die fehlerhafte physische Speicherseite sofort als „ausgemustert“ und fährt die virtuelle Maschine, die diese Speicherseite verwendet, zwangsweise herunter, um den Fehler zu isolieren und einen Purple Screen of Death (PSOD) oder Datenbeschädigung auf dem Host zu verhindern. Nachdem Sangfor einen CE/UE erkannt hat, isoliert es proaktiv 2M und stellt so sicher, dass Daten immer über fehlerfreie Adressen fließen. Im Vergleich zu einfachen Warnmeldungen ermöglicht Sangfor Unternehmen, die Verwendung abnormaler Adressen in einem früheren Stadium zu vermeiden.
-
Langfristige Unterstützung für Gastbetriebssysteme
vSphere 9 unterstützt eine Reihe älterer Betriebssysteme wie RHEL 8, CentOS 7, Ubuntu 22.10 und Windows Server 2008 R2 nicht mehr. Das bedeutet, dass Kunden bei einem Plattform-Upgrade auch ihre virtuellen Maschinen und Anwendungen aktualisieren müssen, was deutlich höhere Kosten und mehr Unsicherheit mit sich bringt. Im Gegensatz dazu unterstützt die neueste Version von Sangfor HCI laut offizieller Kompatibilitätsliste weiterhin sehr alte Gastbetriebssysteme wie Windows Server 2000/2003 und Red Hat 5. Sangfor kann seinen Kunden somit langfristigere und stabilere Supportleistungen bieten.
Abschließender Gedanke: Es geht nicht um das genaue Datum.
Das genaue Enddatum für vSphere 8 ist möglicherweise noch nicht bestätigt. Die Richtung ist jedoch ziemlich klar. Die Beibehaltung des erzwungenen VMware-Upgrade-Pfads bedeutet wahrscheinlich Folgendes:
- Deutlich gestiegene Softwarelizenz- und Abonnementkosten.
- Eine weitere Runde potenziell disruptiver Migrationsbemühungen.
- Fortgesetzte strategische Abhängigkeit von der Roadmap eines einzigen Anbieters.
Die Wahl von Sangfor HCI bietet:
- Ein bewährter, risikoarmer Migrationspfad mit validierten Tools und Methoden für die Migration von VMware-Workloads.
- Eine vorhersehbare und oft reduzierte Gesamtbetriebskosten durch ein transparentes Lizenzmodell.
- Zugang zu innovativen Funktionen wie Memory Tiering und Predictive DRS 2.0, die sofortige Leistungs- und Effizienzsteigerungen ermöglichen.
- Eine vereinfachte Managementlösung : Verwalten Sie Sangfor HCI-Cluster, Mandanten, virtuelle Maschinen und sogar VMware-Cluster über eine einzige Plattform. Von 3-Tier-Architekturen mit externem Speicher über hyperkonvergente Architekturen mit softwaredefinierten Rechenzentren bis hin zu Disaster Recovery und Backup sowie heterogenen Multi-Cluster-Umgebungen bietet Sangfor stets die optimale Lösung.
Fazit: Mit Zuversicht in die Zukunft blicken
Der von Broadcom vorgeschriebene VMware-Wechsel muss kein Rückschlag sein. Er kann Ihre strategische Chance sein, eine agilere, intelligentere und kosteneffizientere IT-Grundlage zu schaffen. Sangfor HCI bietet nicht nur vollständige Funktionskompatibilität, sondern einen klaren Weg zu einer überlegenen Infrastruktur, die sich durch unterbrechungsfreien Betrieb, vorausschauende Intelligenz und bahnbrechende Effizienz auszeichnet.
Wir laden Sie ein, sich selbst davon zu überzeugen. Lassen Sie uns besprechen, wie Ihr Unternehmen auch nach 2027 souverän agieren kann. Kontaktieren Sie Sangfor noch heute für eine detaillierte technische Beratung, einen Proof-of-Concept zur Prüfung Ihrer spezifischen Workloads und einen klaren Fahrplan für ein zukunftssicheres, innovationsgetriebenes Rechenzentrum.
Und je früher Sie anfangen, desto mehr von der Zukunft bleiben Sie in Ihren Händen.