
Introduction
Alors que les entreprises accélèrent leurs initiatives de remplacement de VMware, une question revient sans cesse : mes bases de données et mes charges de travail gourmandes en E/S seront-elles aussi performantes, voire plus, sur la nouvelle plateforme de virtualisation ? Pendant des années, VMware vSphere a été la référence en matière d’exécution d’applications critiques, et toute migration soulève naturellement des inquiétudes quant à la constance des performances, aux pics de latence et à l’efficacité des ressources.
Sangfor Virtualization (HCI) n'est pas une simple solution de remplacement. Elle est conçue pour répondre aux exigences de performance les plus élevées des systèmes d'information critiques. En optimisant en profondeur l'architecture sous-jacente, notamment la planification des accès mémoire non uniformes (NUMA) et l'extension de la capacité mémoire, Sangfor Virtualization garantit que les bases de données, les caches en mémoire et autres charges de travail sensibles aux E/S non seulement maintiennent, mais dépassent souvent leurs niveaux de performance antérieurs.
Dans cet article, nous analyserons deux technologies essentielles qui rendent cela possible : la planification NUMA adaptative et la hiérarchisation de la mémoire . En nous appuyant sur des données de test validées et des analyses architecturales, nous verrons comment ces fonctionnalités permettent de résoudre les principaux problèmes de performance rencontrés dans les environnements serveurs modernes.
Partie 1 : Maîtriser la latence d’accès à la mémoire grâce à la planification NUMA adaptative
Le défi NUMA dans les environnements virtualisés
Les serveurs d'entreprise modernes s'appuient sur l'architecture NUMA pour dépasser les limitations du multiprocesseur symétrique (SMP) traditionnel. Dans un système NUMA, les cœurs de processeur et la mémoire sont répartis en nœuds. Chaque nœud possède sa propre mémoire locale ; si l'accès à la mémoire locale est rapide, l'accès à la mémoire d'un nœud distant engendre une latence importante. Les accès à la mémoire locale prennent environ 70 à 90 ns ; les accès distants sont généralement 1,5 à 2 fois plus lents et peuvent être encore plus lents en cas de contention.
Dans un environnement virtualisé, chaque machine virtuelle (VM) est représentée par un ensemble de threads vCPU. Si ces threads sont répartis sur différents nœuds NUMA, ou s'ils migrent d'un nœud à l'autre, la VM subira des accès à la mémoire distante, entraînant une latence imprévisible et une réduction du débit. Ceci est particulièrement préjudiciable aux systèmes de bases de données tels qu'Oracle, DM8 et PostgreSQL, ainsi qu'aux systèmes de stockage de données en mémoire comme Redis.
Approche de VMware vSphere : vSphere 6.0 et versions ultérieures intègrent un planificateur NUMA automatique qui gère efficacement la plupart des charges de travail courantes. Il offre des fonctionnalités telles que l’exposition vNUMA et l’équilibrage de charge entre les nœuds. Toutefois, pour les charges de travail très spécialisées et gourmandes en E/S, les administrateurs peuvent avoir besoin d’affiner les paramètres d’affinité du processeur ou d’ajuster des paramètres avancés afin d’obtenir des performances optimales.
Planification NUMA adaptative de Sangfor Virtualization
Sangfor Virtualization adopte une approche fondamentalement différente. Au lieu de s'appuyer sur une intervention manuelle, elle met en œuvre un moteur d'ordonnancement NUMA entièrement adaptatif , fonctionnant de manière automatique et dynamique. L'ordonnanceur analyse en continu le nombre de vCPU de chaque machine virtuelle et la charge en temps réel des nœuds NUMA physiques, puis prend des décisions de placement optimales. Comme illustré sur la figure, le système sélectionne automatiquement le nœud NUMA approprié pour chaque machine virtuelle. Lorsque le nombre de vCPU d'une machine virtuelle est inférieur au nombre de cœurs d'un nœud NUMA, la machine virtuelle est exécutée sur un seul nœud NUMA. Lorsque le nombre de vCPU est supérieur au nombre de cœurs d'un nœud NUMA, la machine virtuelle est répartie sur plusieurs nœuds NUMA, et la topologie vNUMA est exposée au système d'exploitation invité, permettant ainsi à la machine virtuelle de prendre des décisions optimales en interne.
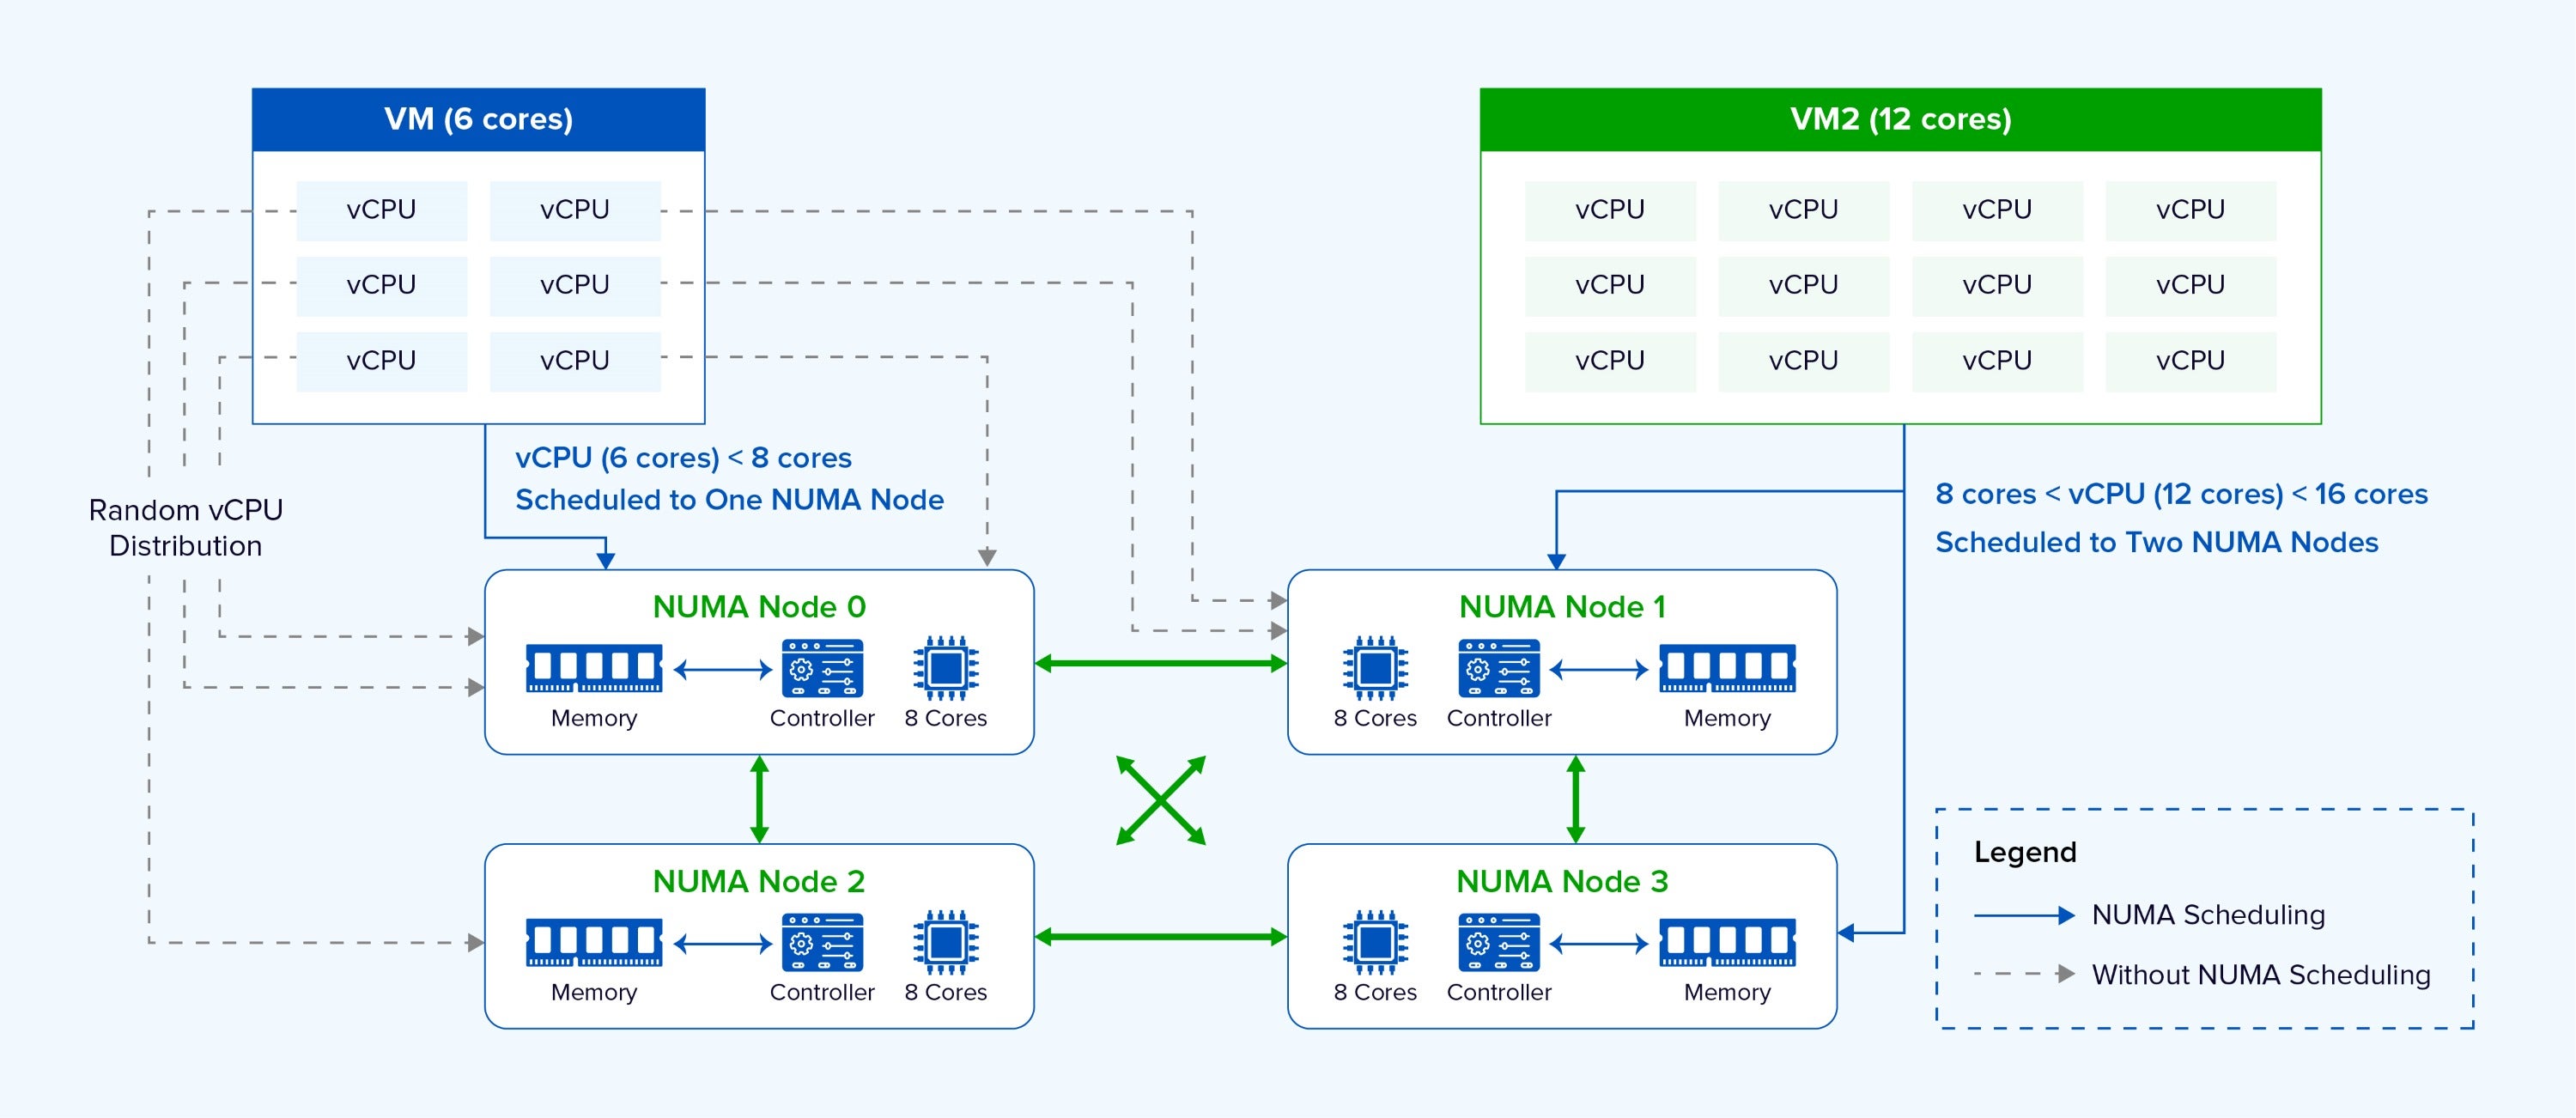
- Consolidation des vCPU : lorsqu’une machine virtuelle possède moins de vCPU que le nombre de cœurs d’un nœud NUMA physique, Sangfor Virtualization place toutes ses vCPU et sa mémoire sur ce même nœud. Ceci garantit un accès mémoire 100 % local pour la machine virtuelle et élimine la latence inter-nœuds.
- Répartition intelligente des ressources pour les machines virtuelles de grande taille : pour les machines virtuelles disposant d’un nombre de vCPU supérieur à la capacité d’un seul nœud, le planificateur les répartit sur plusieurs nœuds NUMA. De plus, il expose la topologie NUMA virtuelle (vNUMA) au système d’exploitation invité. Ce dernier peut ainsi prendre des décisions de planification éclairées, optimisant davantage la localité de la mémoire.
- Répartition de la charge entre les nœuds : le planificateur surveille la charge des nœuds NUMA et peut déplacer les machines virtuelles entre les nœuds si nécessaire afin d’éviter les conflits de ressources. Il identifie également les machines virtuelles « importantes » (comme celles exécutant des bases de données critiques) et priorise leur placement sur des nœuds moins sollicités pour garantir des performances stables.
Au-delà des vCPU : affinité NUMA pour le stockage et le réseau
Ce qui distingue Sangfor Virtualization, c'est que ses optimisations NUMA vont bien au-delà de la simple planification du processeur. Un chemin d'E/S complet — du vCPU au processus QEMU, en passant par le service de stockage aSAN et même le processus de transfert de données réseau — peut être intelligemment associé au même nœud NUMA. Cette approche globale élimine les accès mémoire distants sur l'ensemble de la pile d'E/S, réduisant ainsi considérablement la charge de traitement.
Associée à des pages mémoire de grande taille (pages énormes), cette optimisation profite directement aux bases de données et aux applications gourmandes en stockage. Par exemple, lors d'une opération d'écriture dans une base de données, l'ensemble du flux de travail reste au sein du même domaine NUMA, ce qui minimise la latence et maximise le débit.
Remarque : L’optimisation de l’affinité NUMA s’applique à chaque hôte. L’accès au stockage entre hôtes dans des configurations distribuées (telles qu’un SAN) entraînera toujours une latence réseau, comme dans toute architecture distribuée.
Validation des performances
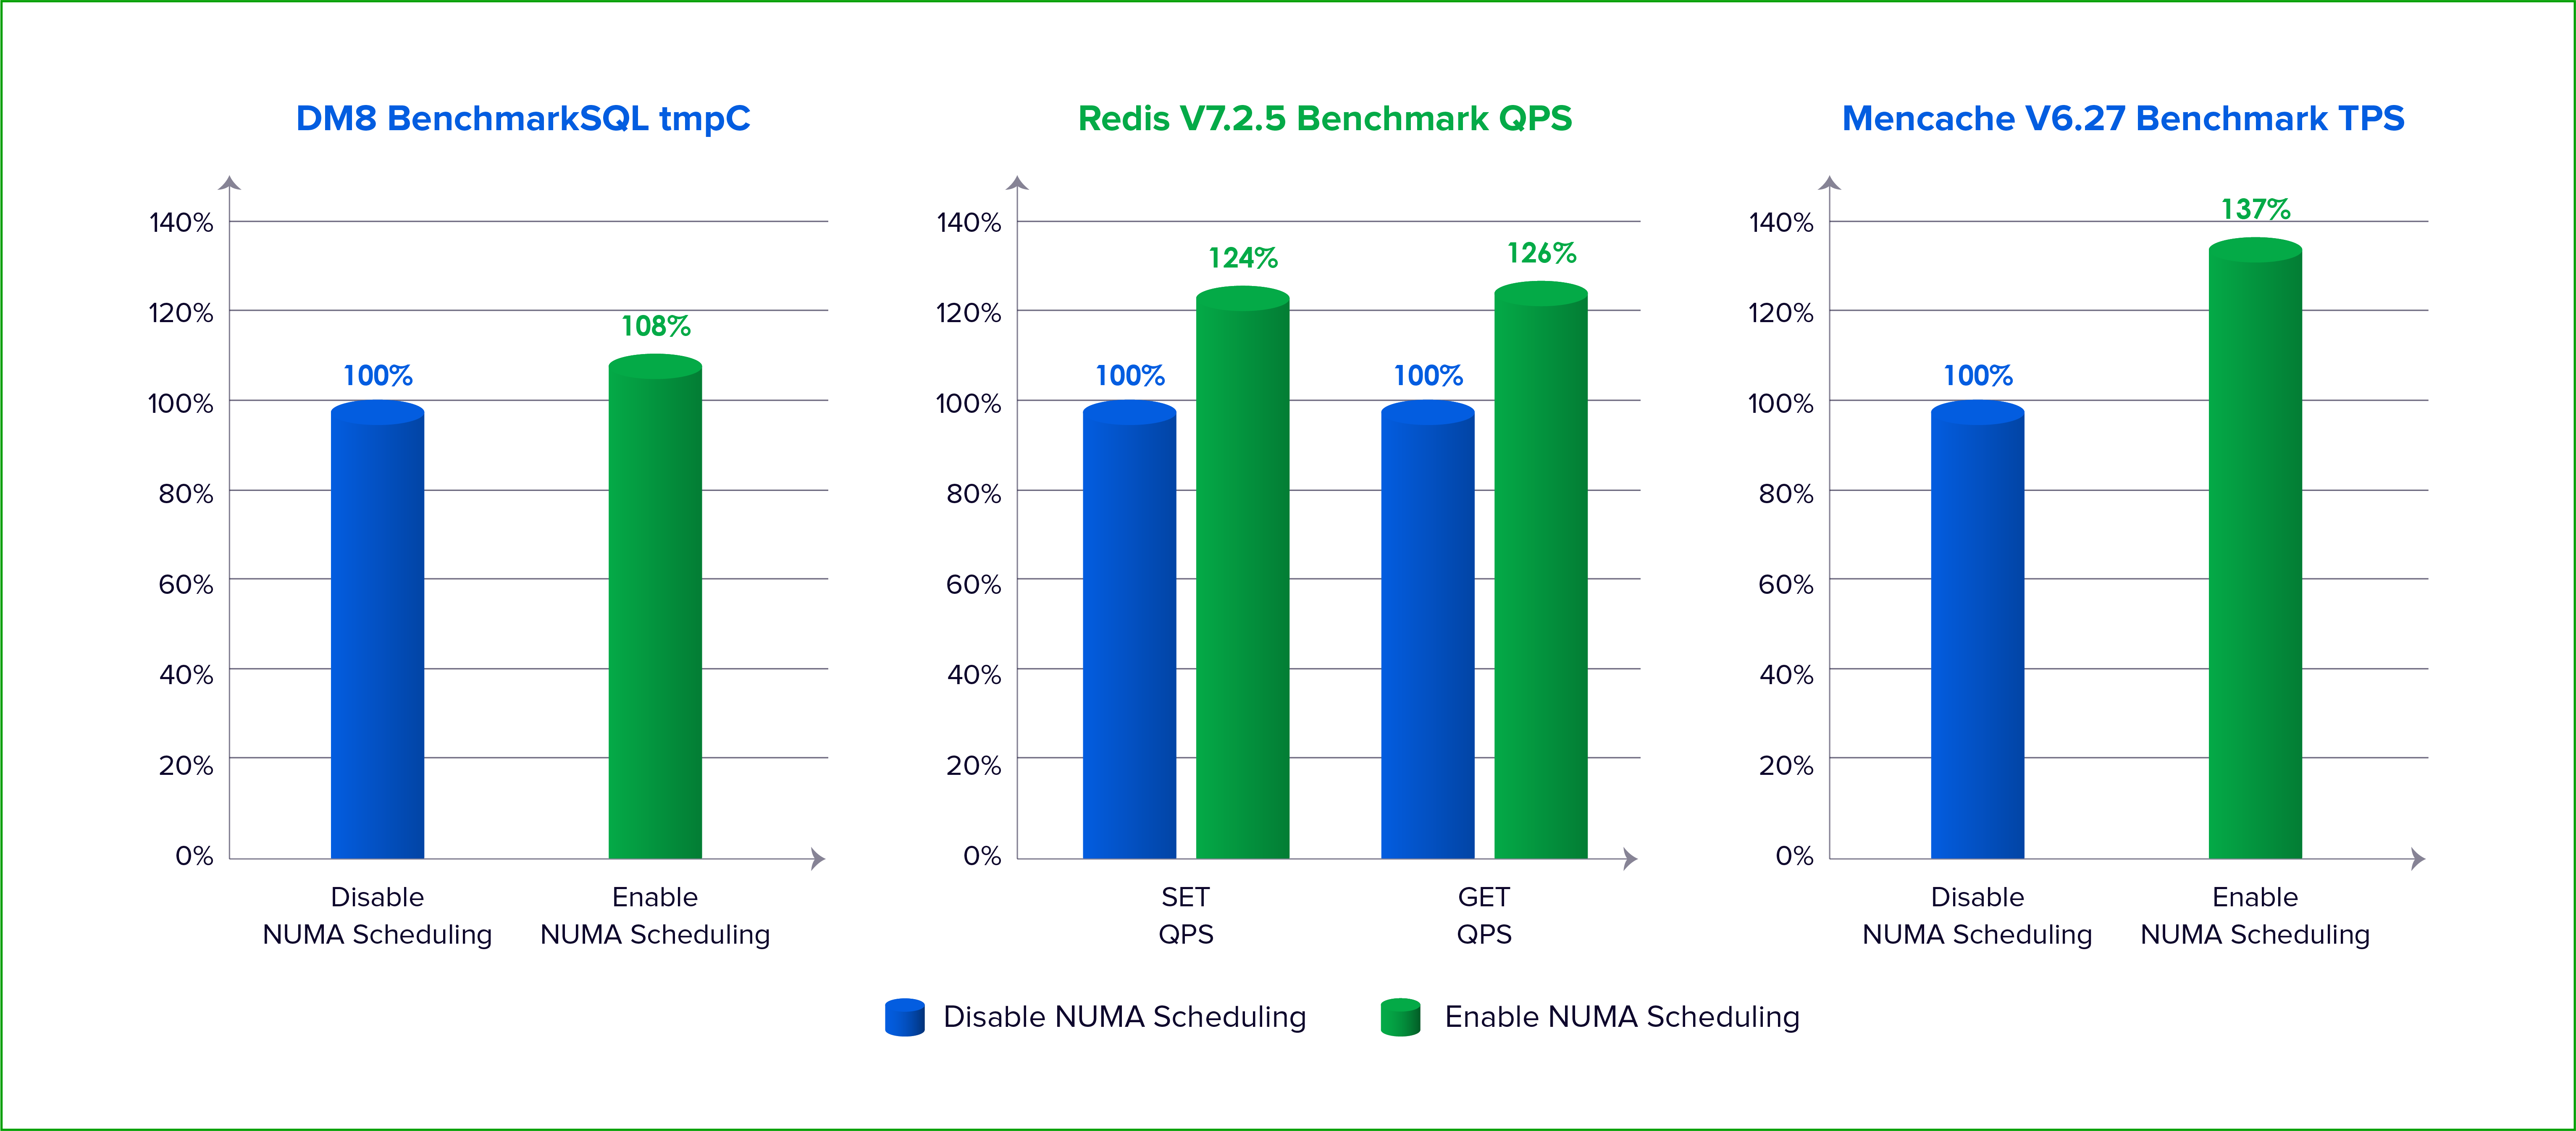
L'efficacité de ces optimisations est validée par des tests rigoureux. Lors d'un test de performance utilisant DM8 (une base de données nationale de premier plan) et l'outil standard BenchmarkSQL (modèle TPC-C), l'activation de la planification NUMA de Sangfor Virtualization a permis d'augmenter considérablement le nombre de cycles par minute (tpmC) par rapport à une configuration où la planification NUMA était désactivée.
De même, lors des tests de performance Redis utilisant redis-benchmark pour les opérations SET/GET, le nombre de requêtes par seconde (QPS) s'est nettement amélioré avec l'activation de la planification NUMA. Les tests Memcache utilisant memaslap ont également montré une augmentation du nombre de transactions par seconde (TPS). Ces résultats démontrent que pour les charges de travail sensibles à l'accès mémoire — précisément les applications les plus susceptibles d'être impactées par une mauvaise configuration NUMA — la virtualisation Sangfor offre des gains de performance tangibles.
Partie 2 : Dépasser les limites de la capacité mémoire grâce à la hiérarchisation de la mémoire
Le dilemme du coût de la mémoire
Pour les bases de données et les applications gourmandes en E/S, la capacité mémoire est souvent la ressource la plus critique. Des pools de mémoire plus importants permettent des caches plus volumineux (comme l'Oracle SGA), un traitement des données en mémoire plus performant et une concurrence accrue. Cependant, les prix de la DRAM restent volatils et les contraintes d'approvisionnement en matériel peuvent rendre les mises à niveau de mémoire à grande échelle excessivement coûteuses.
Les techniques traditionnelles utilisées sur des plateformes comme VMware vSphere (compression de la mémoire, partage transparent des pages et surallocation de mémoire) peuvent améliorer l'utilisation de la mémoire, mais présentent des limitations intrinsèques. Elles n'augmentent pas fondamentalement la quantité de mémoire disponible pour le système ; elles se contentent d'optimiser l'utilisation de la DRAM existante. Lorsque les charges de travail requièrent plus de mémoire active que de mémoire physiquement disponible, les performances se dégradent inévitablement.
Comment fonctionne la hiérarchisation de la mémoire de virtualisation Sangfor
Sangfor Virtualization introduit un changement de paradigme grâce à la hiérarchisation de la mémoire . Cette technologie crée un pool de mémoire unifié en combinant de la DRAM rapide avec des SSD NVMe haute performance. L'idée principale est d'utiliser le SSD NVMe comme une extension de la mémoire système, doublant ainsi la capacité disponible sans ajouter de DRAM.
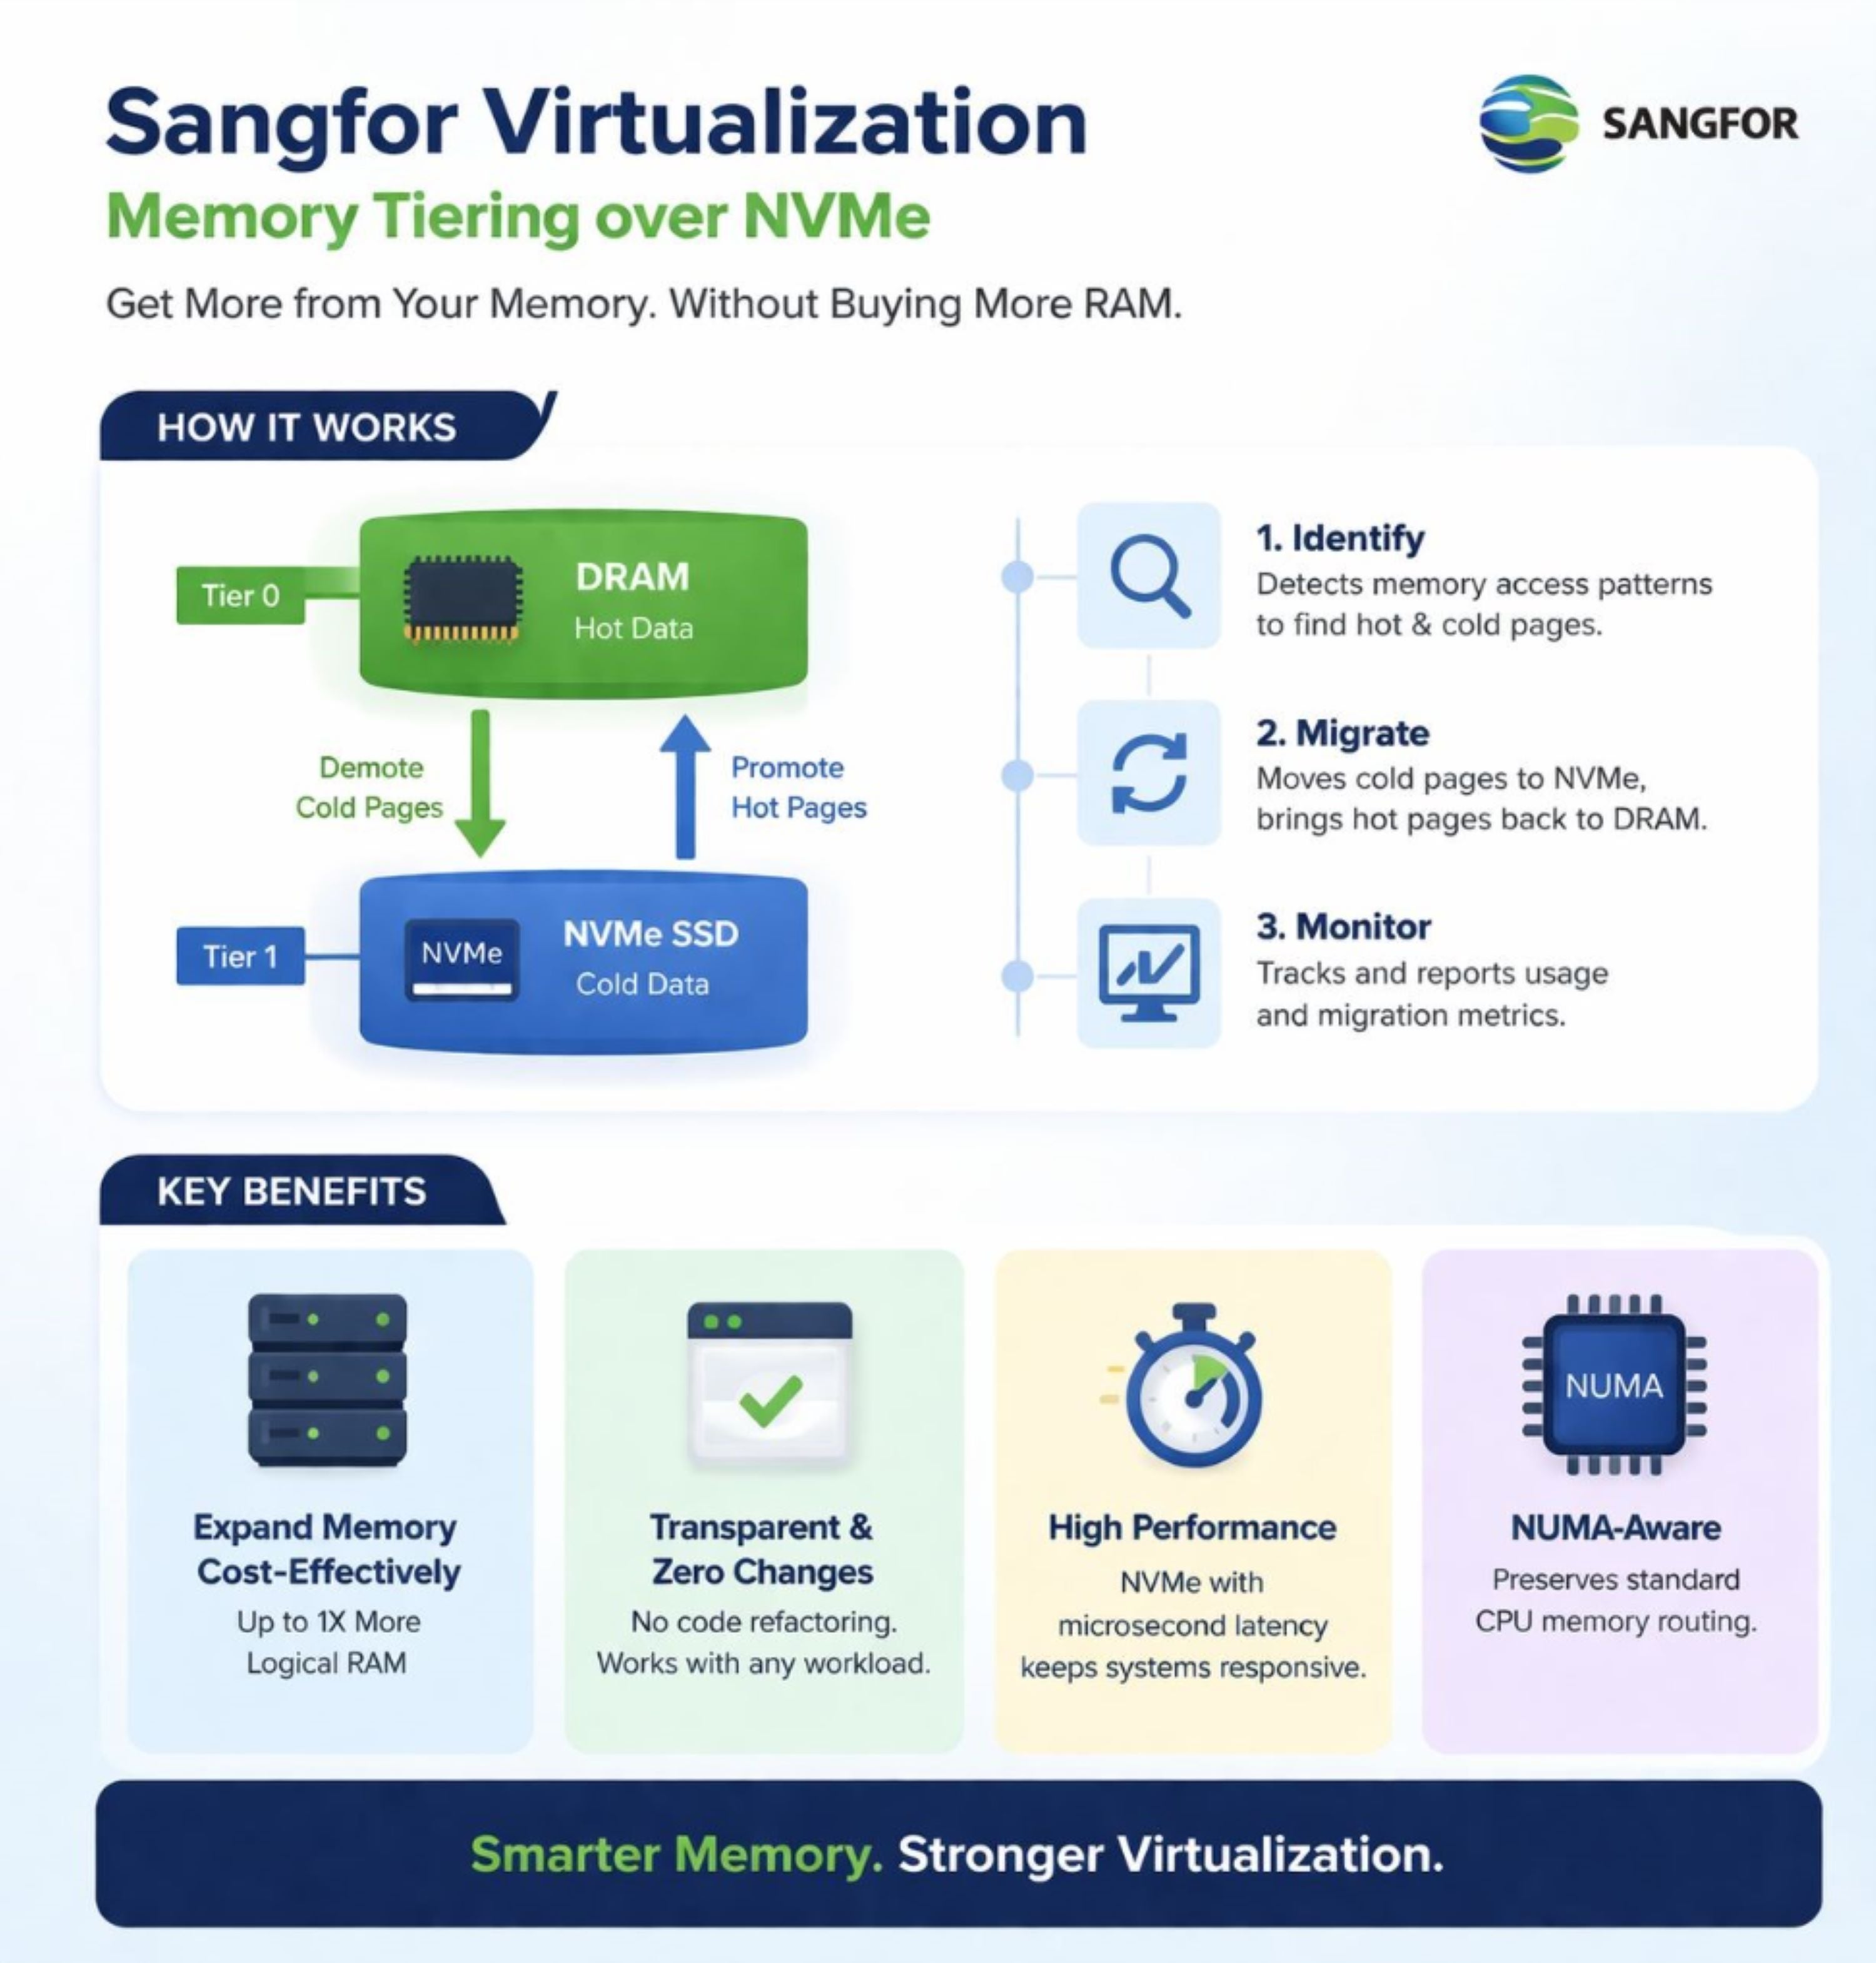
Le secret réside dans le placement intelligent des données. Grâce à un partitionnement dynamique léger des régions et à un mécanisme d'échantillonnage aléatoire épars , Sangfor Virtualization surveille en permanence les pages mémoire pour distinguer les données « chaudes » (fréquemment consultées) des données « froides » (rarement consultées).
- Les données fréquemment utilisées (telles que les index de base de données actifs, les journaux de transactions critiques ou les tables fréquemment interrogées) restent dans la couche DRAM (niveau 0) pour un accès à faible latence.
- Les données inactives (comme les enregistrements historiques, les pages liées aux sauvegardes ou la mémoire applicative inutilisée) sont automatiquement déplacées vers le niveau NVMe (niveau 1). Cette migration est transparente et ne nécessite aucune intervention du système d'exploitation invité ni de l'application.
Contrôle du flux d'accès au processeur et des performances
Lorsqu'un processeur demande une adresse mémoire, le système vérifie la mémoire DRAM. Si la page est trouvée (accès direct), l'accès est immédiat. Si elle est absente (échec d'accès), le système déclenche une erreur de page transparente, déplace rapidement la page requise du NVMe vers la DRAM, puis effectue l'accès au processeur. Du point de vue de l'application, ce processus est identique à une opération mémoire standard.
Point essentiel, la couche NVMe est traitée comme de la mémoire, et non comme un périphérique d'échange. Le contrôleur NVMe exploite la bande passante PCIe pour déplacer les données avec une intervention minimale du processeur. Grâce aux SSD NVMe PCIe 4.0/5.0 modernes offrant une latence de 10 à 100 µs et une bande passante jusqu'à 7 Go/s, la surcharge liée à la promotion des pages froides est extrêmement réduite.
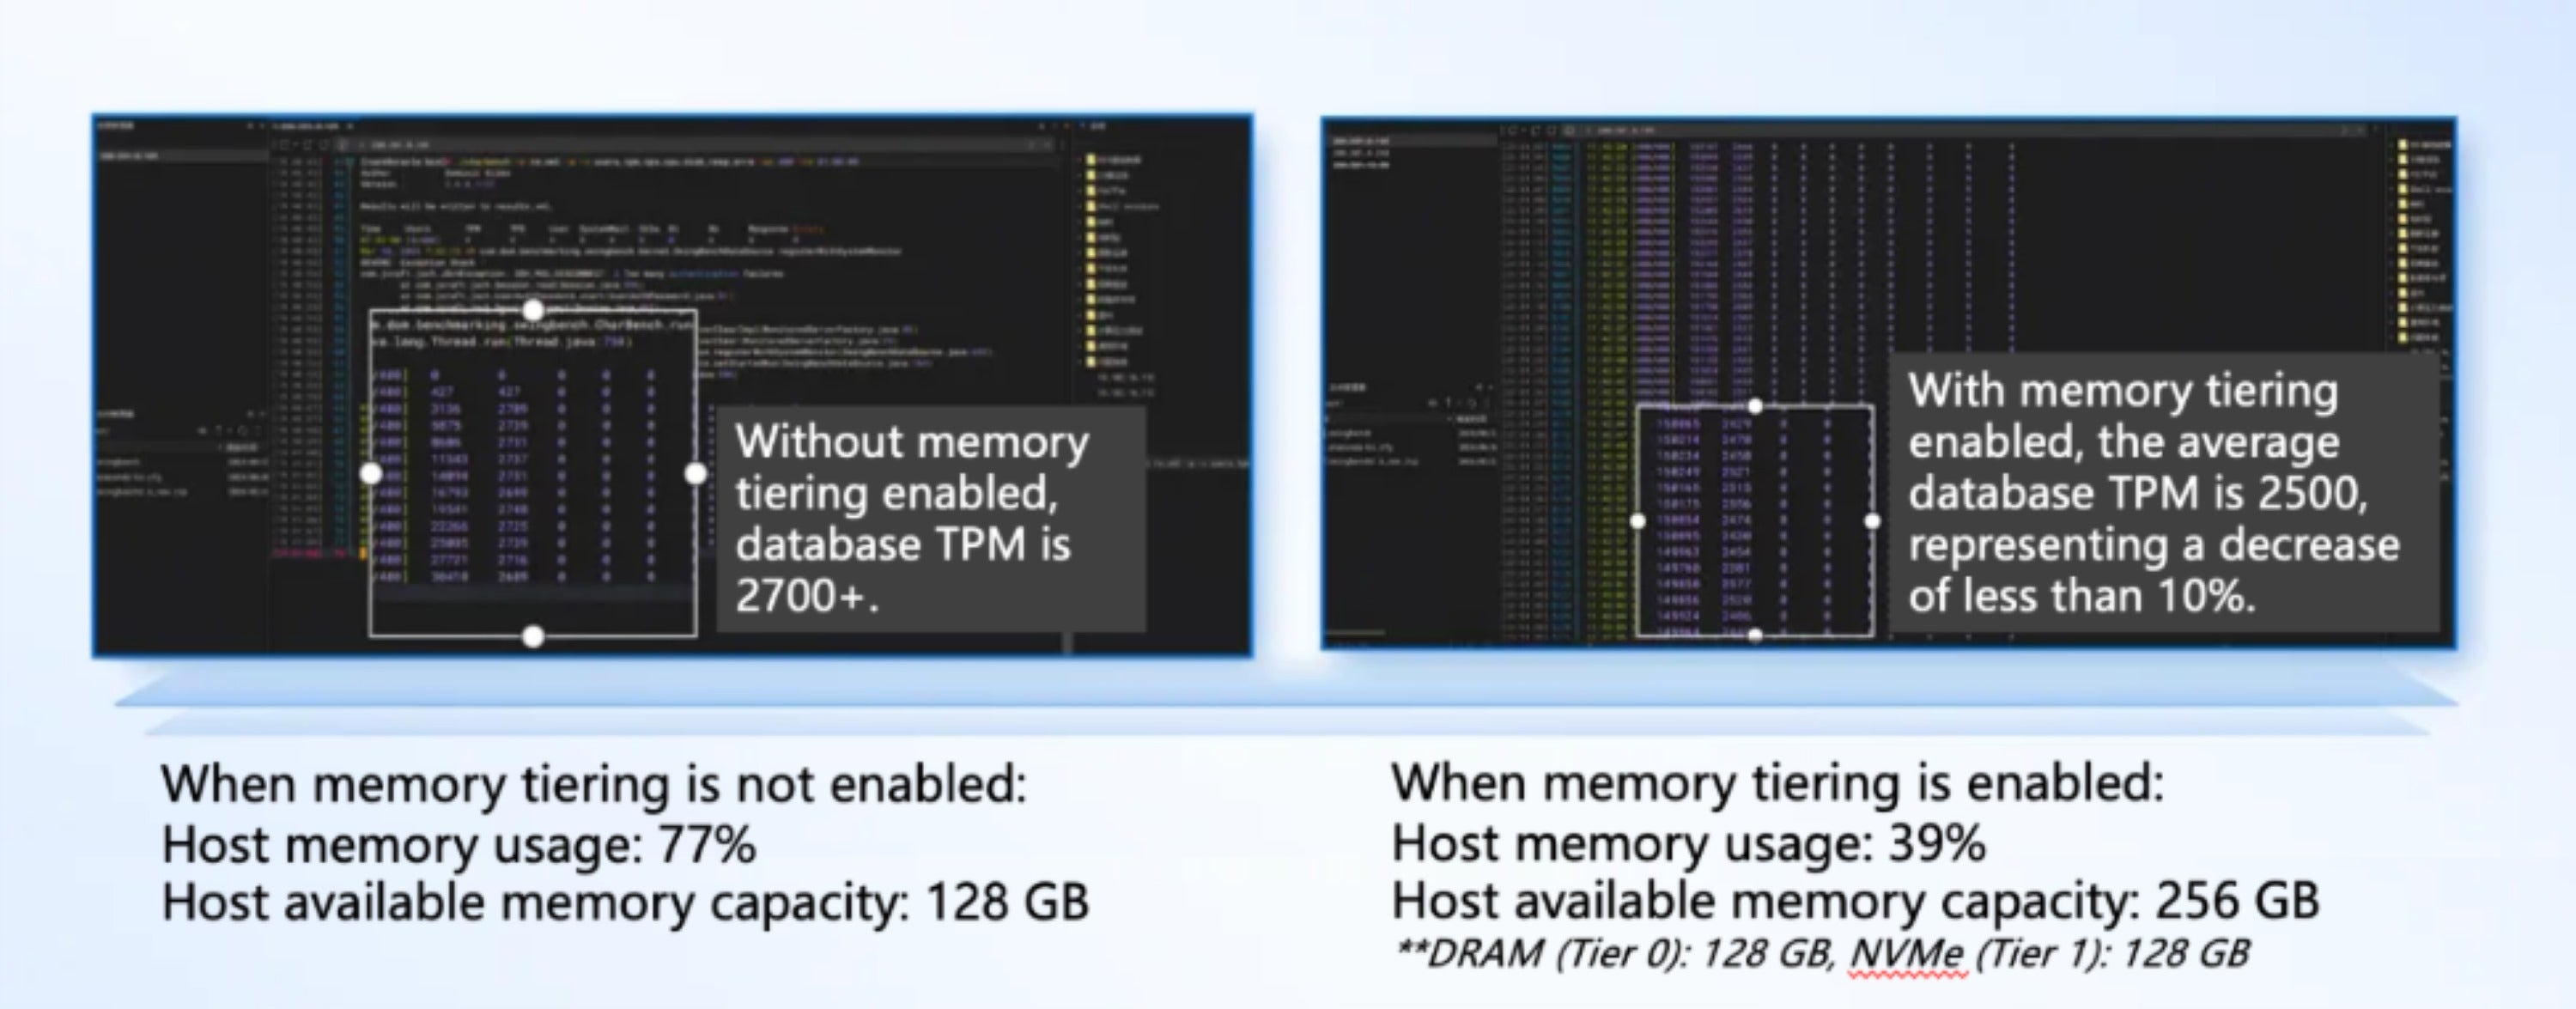
Lors de tests en conditions réelles sur une base de données Oracle, l'activation de la hiérarchisation de la mémoire a permis à un serveur doté de 128 Go de mémoire vive physique de supporter efficacement une charge de travail qui nécessiterait normalement 256 Go. Le nombre de transactions par minute (TPM) a diminué d'environ 10 % , un compromis modeste pour un doublement de la capacité de mémoire utilisable.
Flexibilité de déploiement et meilleures pratiques
Toutes les charges de travail ne sont pas des candidates idéales pour la hiérarchisation de la mémoire. Elle est particulièrement adaptée aux scénarios présentant des profils de données chauds/froids distincts, tels que :
- Virtualisation de bureau (VDI)
- Environnements de développement et de test
- Services de mise en cache non critiques
- Clusters de microservices de taille moyenne
Pour répondre aux exigences de latence ultra-faible, la hiérarchisation de la mémoire peut être désactivée sélectivement pour chaque machine virtuelle :
- Systèmes de négociation à haute fréquence
- Bases de données OLTP sensibles à la latence avec des modèles d'accès uniformes
- Analyses en temps réel avec des exigences de SLA strictes
Sangfor recommande un rapport de capacité DRAM/niveaux de 1:1 pour obtenir un équilibre optimal, offrant ainsi le double de mémoire effective avec un impact minimal sur les performances.
Conclusion
Migrer de VMware vSphere vers Sangfor Virtualization n'est pas un simple changement d'architecture ; c'est l'occasion de repenser votre couche de virtualisation pour des performances et une efficacité accrues. Pour les charges de travail gourmandes en bases de données et en E/S, les deux technologies présentées – la planification NUMA adaptative et la hiérarchisation de la mémoire – répondent directement aux contraintes les plus critiques des infrastructures modernes : la latence d'accès à la mémoire et la capacité de mémoire.
La planification NUMA adaptative garantit un accès prévisible et à faible latence à la mémoire locale pour vos bases de données, caches en mémoire et intergiciels, en s'adaptant automatiquement aux variations de charge de travail sans intervention manuelle. La hiérarchisation de la mémoire, quant à elle, offre une solution pragmatique pour augmenter la capacité mémoire sans le coût prohibitif de la DRAM, vous permettant ainsi de regrouper davantage de charges de travail par serveur tout en maintenant des performances acceptables.
Grâce à ces innovations, Sangfor Virtualization propose une plateforme qui non seulement répond aux exigences de performance de VMware vSphere, mais les surpasse souvent, notamment dans les scénarios exigeants qui caractérisent les systèmes d'information critiques des entreprises modernes. Lors de votre transition vers une solution de remplacement de VMware, ayez l'assurance que vos applications les plus critiques sont entre de bonnes mains.
Si votre organisation rencontre des difficultés similaires, nous vous invitons à nous contacter . Nous sommes prêts à réaliser une évaluation collaborative et à élaborer un plan de transition sur mesure, parfaitement adapté à votre environnement.

