
導入
組織がVMwareの置き換えを加速させるにつれ、常に一つの疑問が浮上します。それは、データベースやI/O負荷の高いワークロードは、新しい仮想化プラットフォーム上で同等、あるいはそれ以上のパフォーマンスを発揮できるのか、という点です。VMware vSphereは長年にわたり、ミッションクリティカルなアプリケーションを実行するための標準プラットフォームとして君臨してきました。そのため、移行にあたっては、パフォーマンスの一貫性、レイテンシの急増、リソース効率などについて、当然ながら懸念が生じます。
Sangfor Virtualization (HCI)は、単なる既存システムの置き換えではありません。基幹業務システムの最も厳しいパフォーマンス要件に対応するために設計されています。基盤となるアーキテクチャ、特に非均一メモリアクセス (NUMA) スケジューリングとメモリ容量拡張を徹底的に最適化することで、Sangfor Virtualization は、データベース、インメモリキャッシュ、その他の I/O に敏感なワークロードのパフォーマンスレベルを維持するだけでなく、多くの場合、それを上回ることを保証します。
この記事では、これを可能にする2つの重要なテクノロジー、アダプティブNUMAスケジューリングとメモリ階層化について詳しく解説します。検証済みのテストデータとアーキテクチャに関する知見に基づき、これらの機能が現代のサーバー環境における根本的なパフォーマンスボトルネックをどのように解決するのかを探ります。
パート1:適応型NUMAスケジューリングによるメモリアクセス遅延の克服
仮想化環境におけるNUMAの課題
最新のエンタープライズサーバーは、従来の対称型マルチプロセッシング(SMP)の限界を超えて拡張するために、NUMAアーキテクチャを採用しています。NUMAシステムでは、プロセッサコアとメモリがノードに分割されます。各ノードは独自のローカルメモリを持ち、ローカルメモリへのアクセスは高速ですが、リモートノードのメモリへのアクセスには大きな遅延が発生します。ローカルメモリへのアクセスには約70~90ナノ秒かかりますが、リモートアクセスは通常1.5~2倍遅く、競合が発生するとさらに遅くなる可能性があります。
仮想化環境では、各仮想マシン(VM)はvCPUスレッドの集合として表現されます。これらのスレッドが異なるNUMAノードに分散してスケジュールされる場合、またはノード間を移動する場合には、VMはリモートメモリアクセスを経験し、予測不可能なレイテンシとスループットの低下につながります。これは、Oracle、DM8、PostgreSQLなどのデータベースシステムや、Redisなどのインメモリデータストアにとって特に有害です。
VMware vSphereのアプローチ:vSphere 6.0以降のバージョンには、一般的なワークロードのほとんどを効率的に処理する自動NUMAスケジューラが搭載されています。vNUMAの公開やノード間の負荷分散などの機能を提供します。ただし、高度に特殊化されたI/O負荷の高いワークロードの場合、管理者は最適なパフォーマンスを実現するために、CPUアフィニティ設定を微調整したり、高度なパラメータを調整したりする必要がある場合があります。
Sangfor Virtualizationの適応型NUMAスケジューリング
Sangfor Virtualizationは、根本的に異なるアプローチを採用しています。手動による介入に頼るのではなく、自動的かつ動的に動作する完全適応型のNUMAスケジューリングエンジンを実装しています。スケジューラは、各VMのvCPU数と物理NUMAノードのリアルタイム負荷を継続的に分析し、最適な配置を決定します。図に示すように、システムは各仮想マシンに対して適切なNUMAノードを自動的に選択します。VMのvCPU数がNUMAノードのコア数より少ない場合、VMは単一のNUMAノードにスケジュールされます。vCPU数がNUMAノードのコア数を超える場合、VMは複数のNUMAノードに分散してスケジュールされ、vNUMAトポロジーがゲストOSに公開されるため、VMは内部で最適な決定を下すことができます。
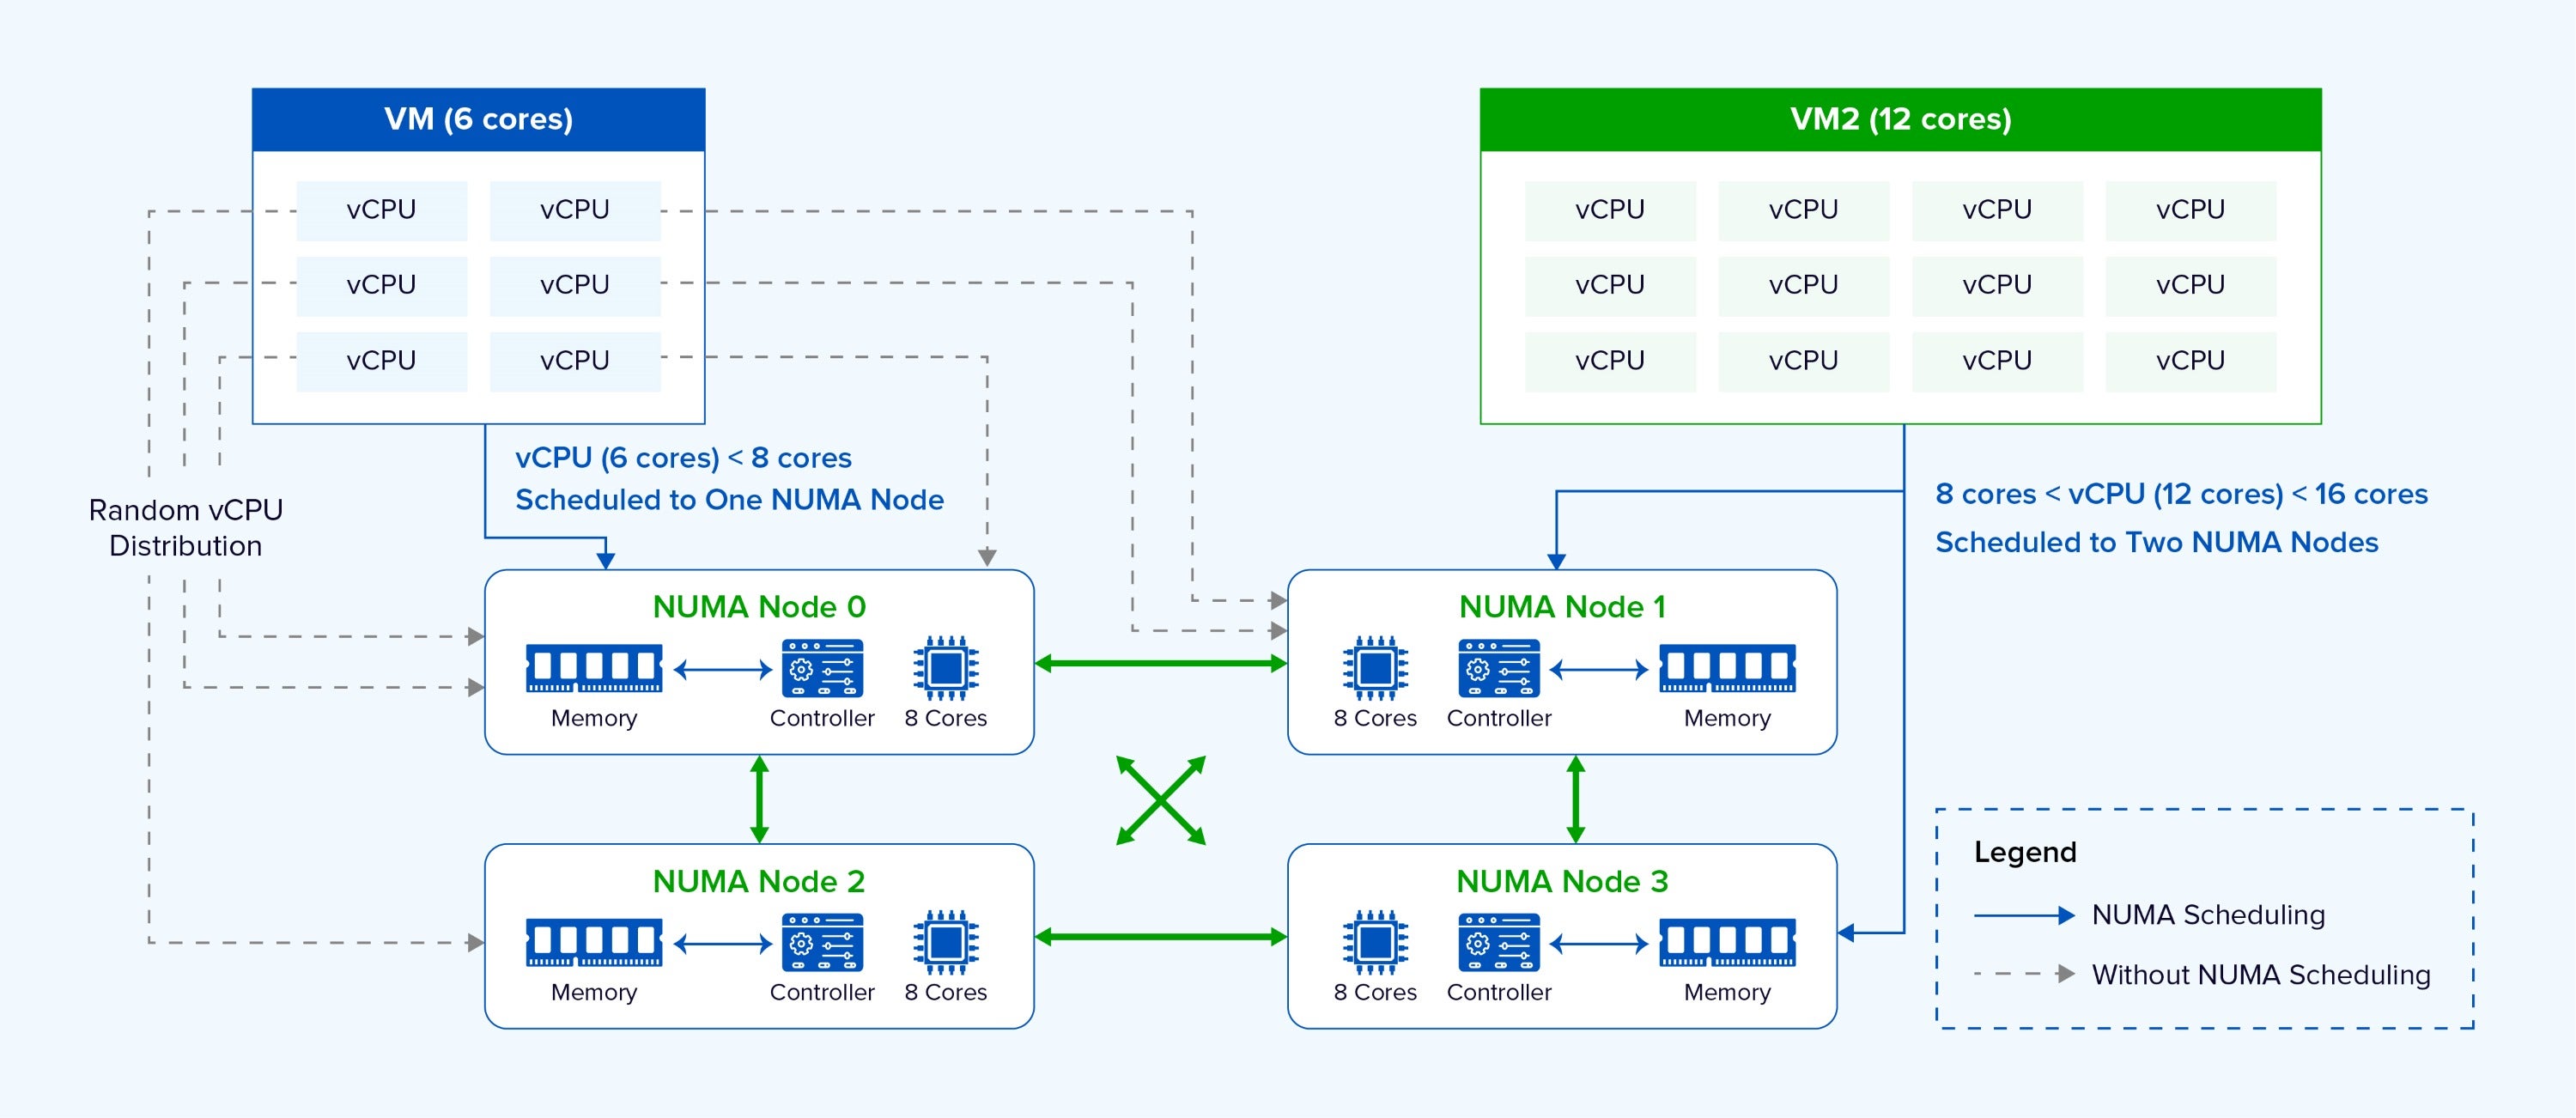
- vCPU統合: VMのvCPU数が単一の物理NUMAノード上のコア数以下の場合、Sangfor VirtualizationはすべてのvCPUとメモリを同じノード内に配置します。これにより、VMのメモリへのアクセスが100%ローカルになり、ノード間のレイテンシが解消されます。
- 大規模VM向けのインテリジェントな分散処理:単一ノードで収容できる数を超えるvCPUを持つVMの場合、スケジューラはそれらを複数のNUMAノードに分散します。さらに重要なのは、仮想NUMA(vNUMA)トポロジーをゲストOSに公開することです。これにより、VM内のオペレーティングシステムは情報に基づいたスケジューリング判断を下すことができ、メモリの局所性をさらに最適化できます。
- ノード間の負荷分散:スケジューラはNUMAノードの負荷を監視し、必要に応じてVMをノード間で移行してリソースの競合を防ぎます。また、「重要な」VM(重要なデータベースを実行しているVMなど)を識別し、競合の少ないノードに優先的に配置することで、安定したパフォーマンスを確保します。
vCPUを超えて:ストレージとネットワークのNUMAアフィニティ
Sangfor Virtualizationの特長は、NUMA最適化がCPUスケジューリングにとどまらない点にあります。vCPUからQEMUプロセス、aSANストレージサービス、さらにはネットワークデータ転送プロセスに至るまで、完全なI/Oパスを同一のNUMAノードにインテリジェントに固定できます。この包括的なアプローチにより、I/Oスタック全体にわたるリモートメモリアクセスが排除され、処理オーバーヘッドが大幅に削減されます。
大容量メモリページ(ヒュージページ)と組み合わせることで、この最適化はデータベースやストレージを多用するアプリケーションに直接的なメリットをもたらします。例えば、データベースが書き込み操作を実行する際、ワークフロー全体が同じNUMAドメイン内に留まるため、レイテンシが最小限に抑えられ、スループットが最大化されます。
注: NUMAアフィニティ最適化は各ホスト内で適用されます。分散構成(aSANなど)におけるホスト間ストレージアクセスでは、あらゆる分散アーキテクチャと同様にネットワーク遅延が発生します。
性能検証
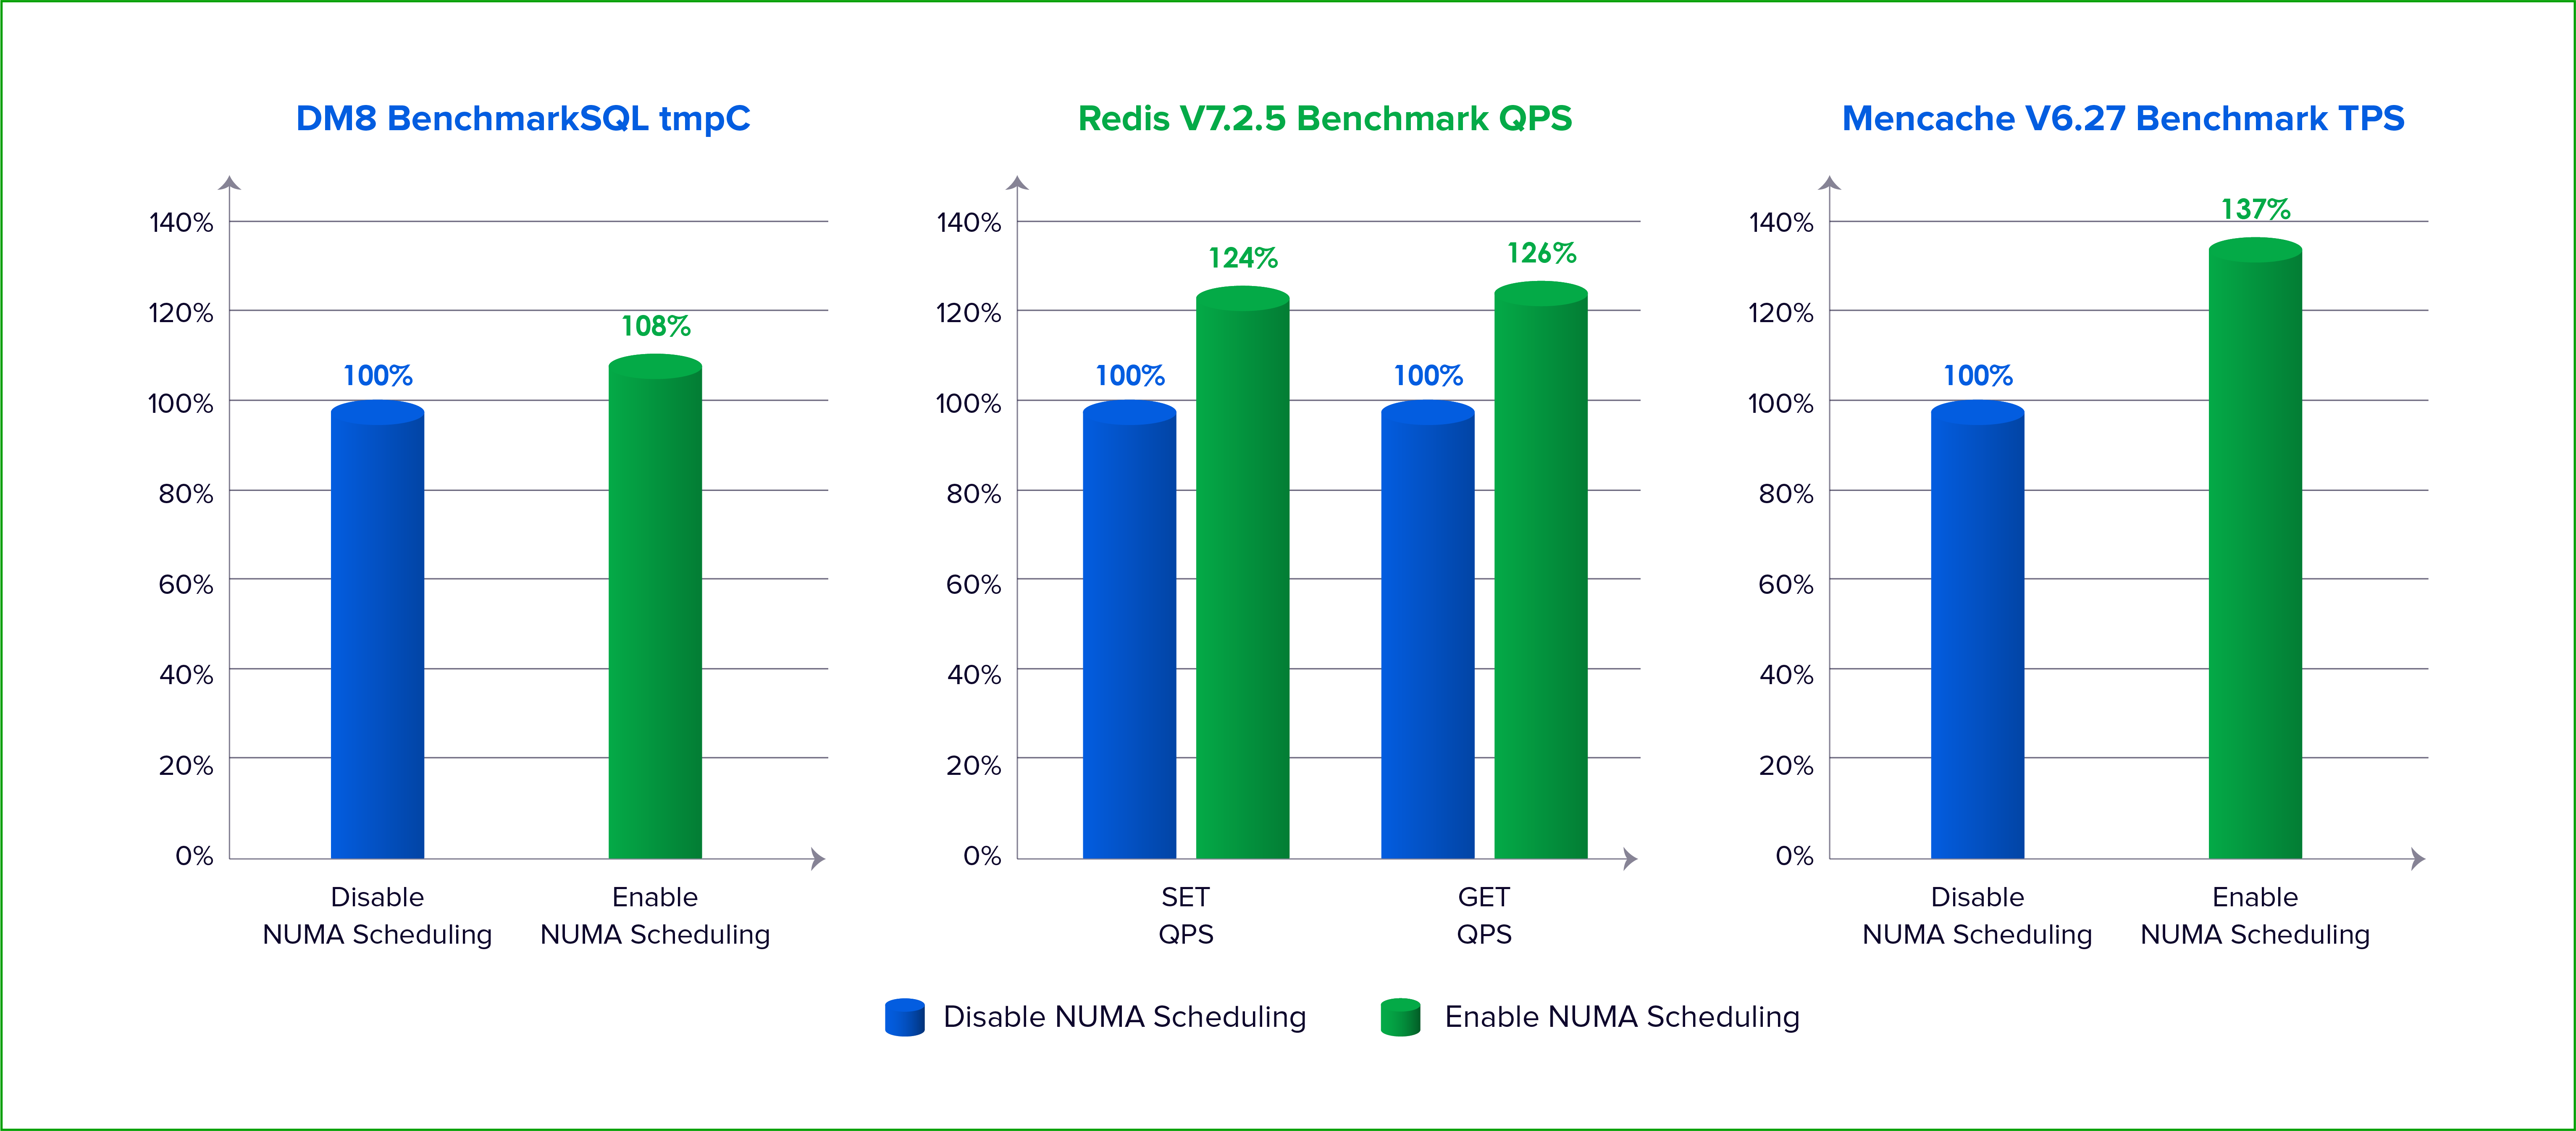
これらの最適化の効果は、厳密なテストによって検証されています。国内有数のデータベースであるDM8と標準のBenchmarkSQLツール(TPC-Cモデル)を用いたベンチマークテストでは、 Sangfor VirtualizationのNUMAスケジューリングを有効にすることで、NUMAスケジューリングを無効にした構成と比較して、tpmCが大幅に向上しました。
同様に、SET/GET操作にredis-benchmarkを使用したRedisベンチマークでは、NUMAスケジューリングが有効になっている場合、1秒あたりのクエリ数(QPS)が著しく向上しました。memaslapを使用したMemcacheテストでも、1秒あたりのトランザクション数(TPS)が向上しました。これらの結果は、メモリアクセスに敏感なワークロード(まさにNUMA構成の不備によって最も影響を受けやすいアプリケーション)において、Sangfor仮想化が目に見えるパフォーマンス向上をもたらすことを示しています。
パート2:メモリ階層化でメモリ容量の壁を突破する
メモリコストのジレンマ
データベースやI/O負荷の高いアプリケーションにとって、メモリ容量はしばしば最も重要なリソースとなります。メモリ容量が大きいほど、バッファキャッシュ(Oracle SGAなど)の容量が大きくなり、インメモリデータ処理能力が向上し、並列処理能力も高まります。しかし、DRAMの価格は変動が激しく、ハードウェアのサプライチェーン上の制約により、大規模なメモリ増設は非常に高額になる可能性があります。
VMware vSphereなどのプラットフォームで用いられる従来の手法(メモリ圧縮、透過的ページ共有、メモリオーバーコミットなど)は、メモリ利用率を向上させることはできますが、本質的な限界があります。これらの手法は、システムに利用可能なメモリ量を根本的に増やすものではなく、既存のDRAMの効率を高めるだけです。ワークロードが物理的に利用可能なメモリ量よりも多くのアクティブメモリを必要とする場合、パフォーマンスは必然的に低下します。
Sangfor仮想化メモリ階層化の仕組み
Sangfor Virtualizationは、 メモリ階層化によってパラダイムシフトをもたらします。この技術は、高速DRAMと高性能NVMe SSDを組み合わせることで、統合されたメモリプールを作成します。その核心となるアイデアは、NVMe SSDをシステムメモリの拡張として使用することで、DRAMを追加することなく利用可能な容量を実質的に2倍にすることです。
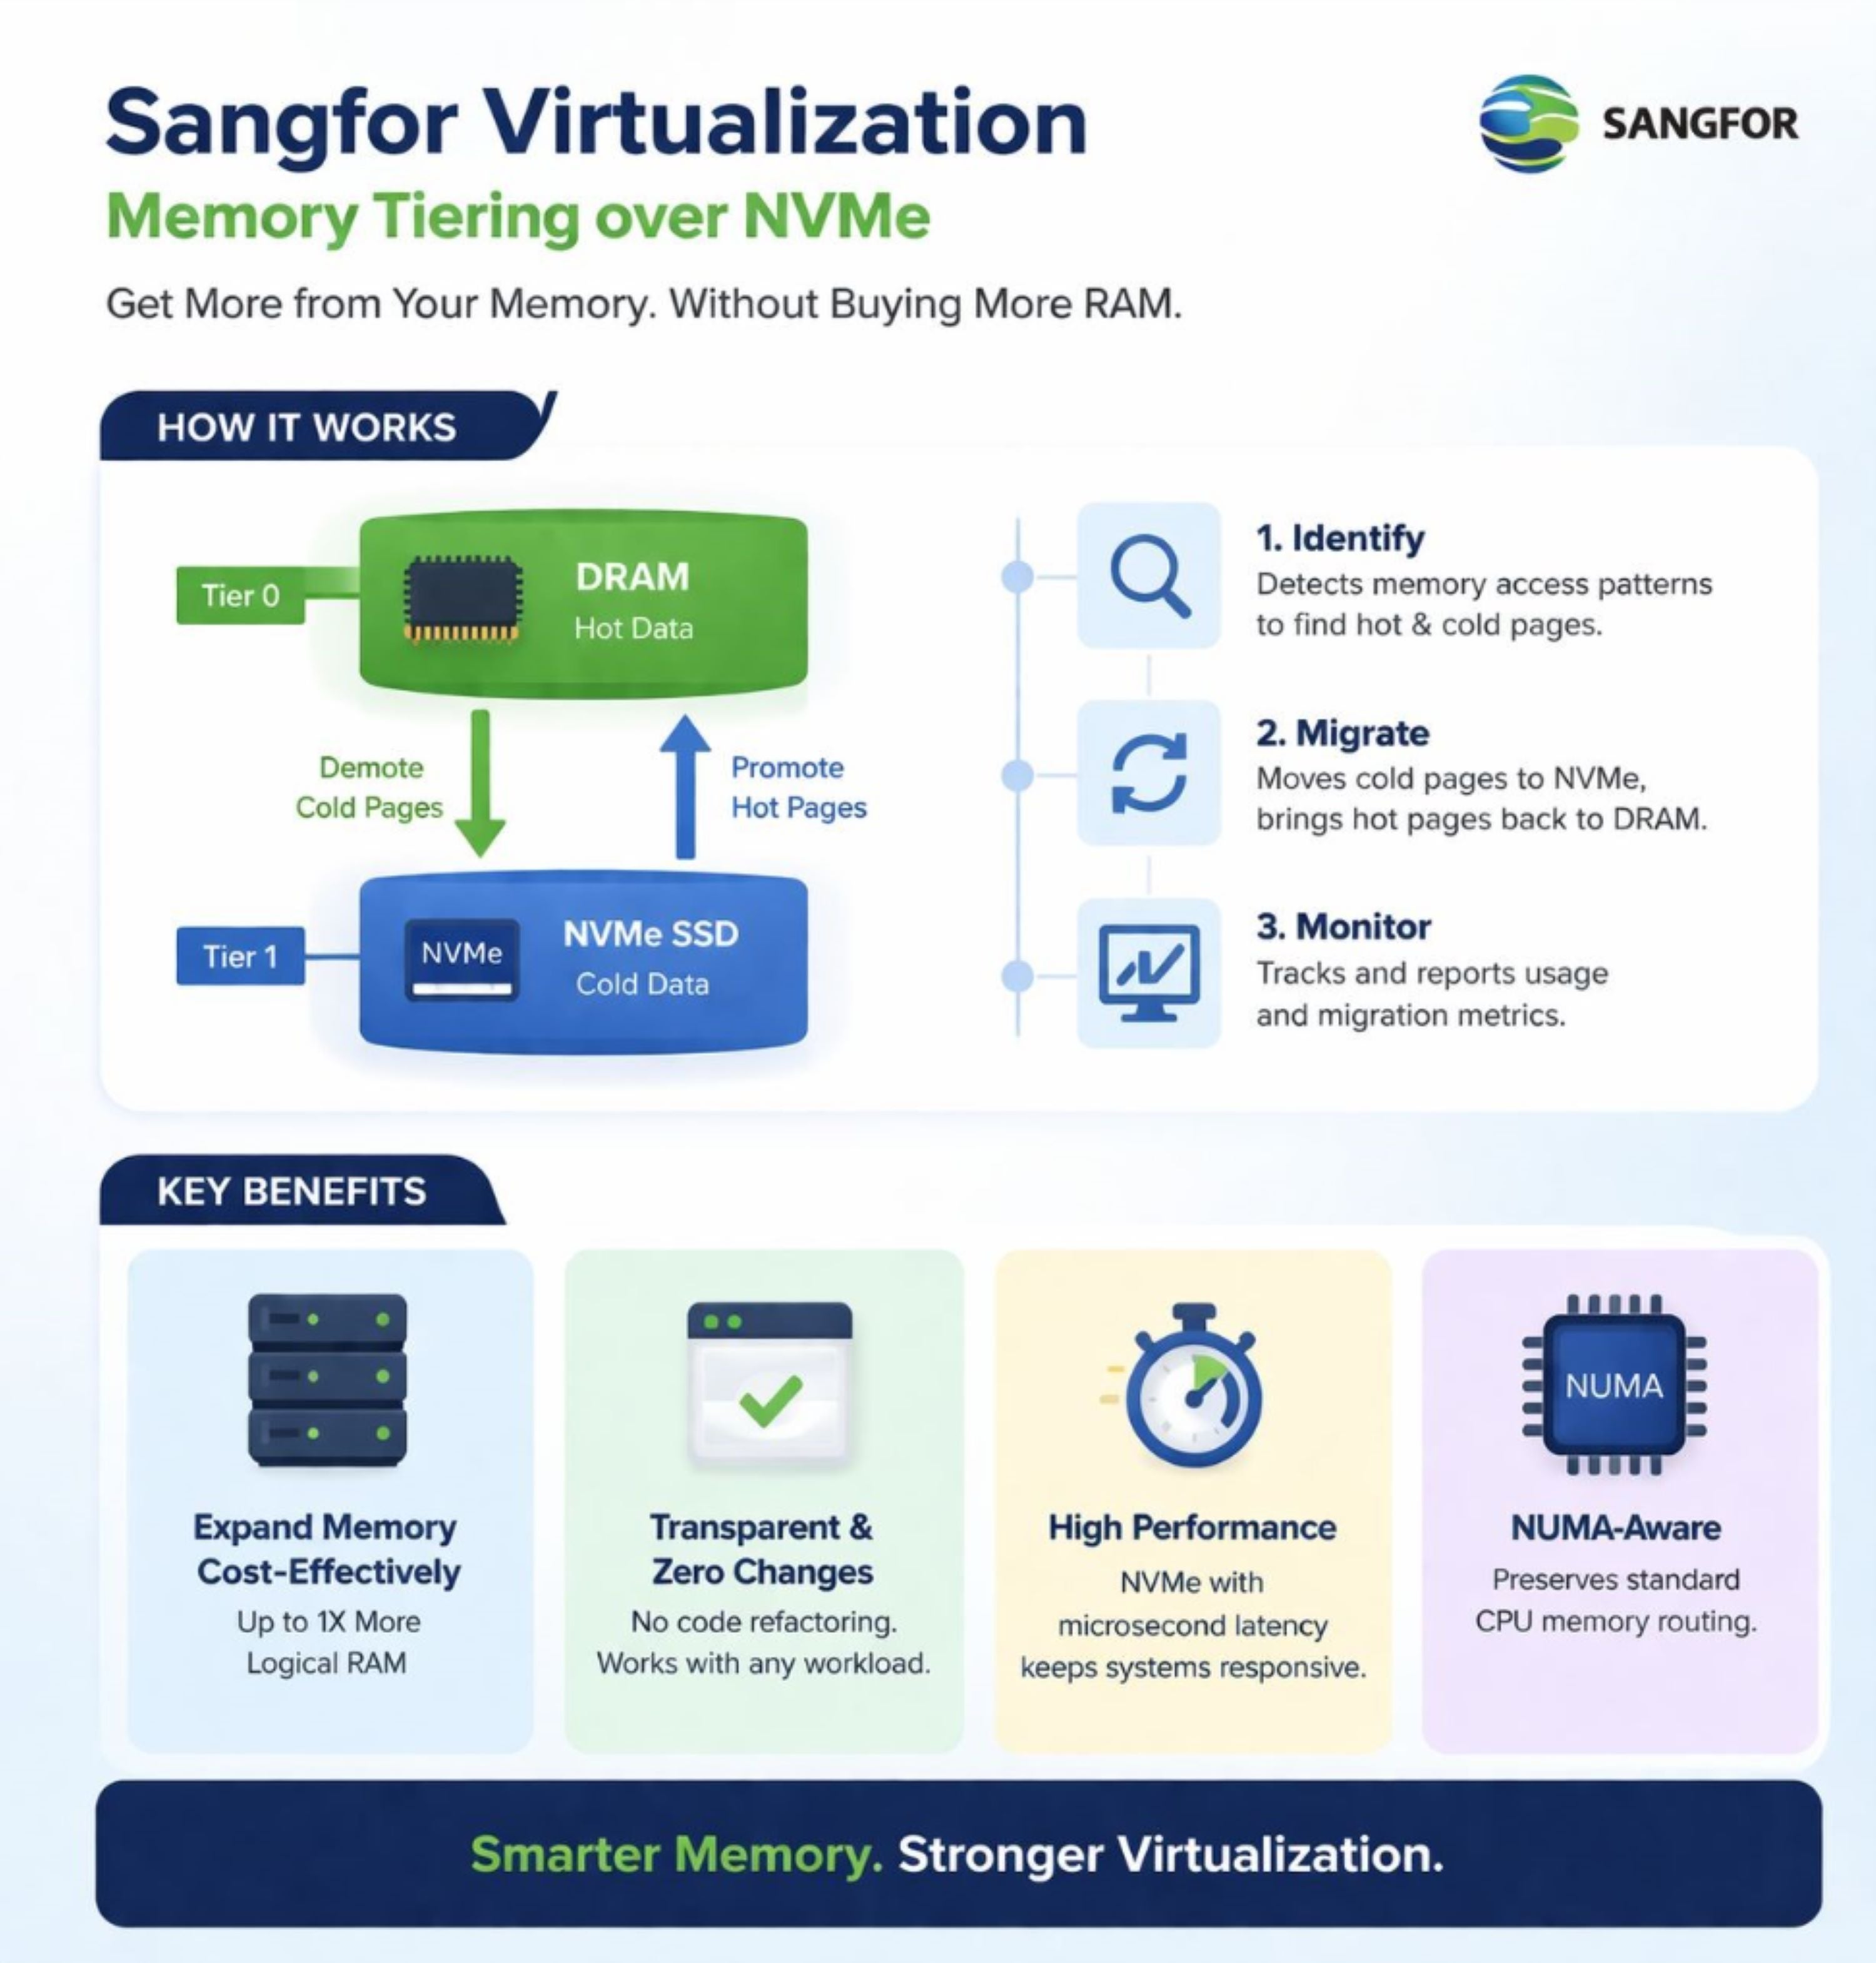
その秘密は、インテリジェントなデータ配置にあります。軽量な動的領域分割とランダムなスパースサンプリングメカニズムを使用することで、Sangfor Virtualizationはメモリページを継続的に監視し、「ホット」(頻繁にアクセスされる)データと「コールド」(アクセス頻度の低い)データを区別します。
- アクティブなデータベースインデックス、重要なトランザクションログ、頻繁にクエリされるテーブルなどのホットデータは、低遅延アクセスを実現するためにDRAM層(ティア0)に保持されます。
- 履歴データ、バックアップ関連ページ、アイドル状態のアプリケーションメモリなどのコールドデータは、自動的にNVMe層(ティア1)に移動されます。この移行は、ゲストOSやアプリケーションの介入なしに、透過的に実行されます。
CPUアクセスフローとパフォーマンス制御
CPUがメモリアドレスを要求すると、システムはDRAM層をチェックします。ページが見つかった場合(ホットヒット)、アクセスは即座に行われます。ページが存在しない場合(コールドミス)、システムは透過的なページフォルトを発生させ、必要なページをNVMeからDRAMに素早く移動させてから、CPUのアクセスを完了します。アプリケーションの観点から見ると、このプロセスは標準的なメモリ操作と区別がつきません。
重要な点として、NVMe層はスワップデバイスではなくメモリとして扱われます。NVMeコントローラはPCIeの帯域幅を活用して、CPUの介入を最小限に抑えながらデータを転送します。最新のPCIe 4.0/5.0 NVMeドライブは、10~100µsの低レイテンシと最大7GB/sの帯域幅を実現しているため、コールドページプロモーションのオーバーヘッドは極めて低く抑えられます。
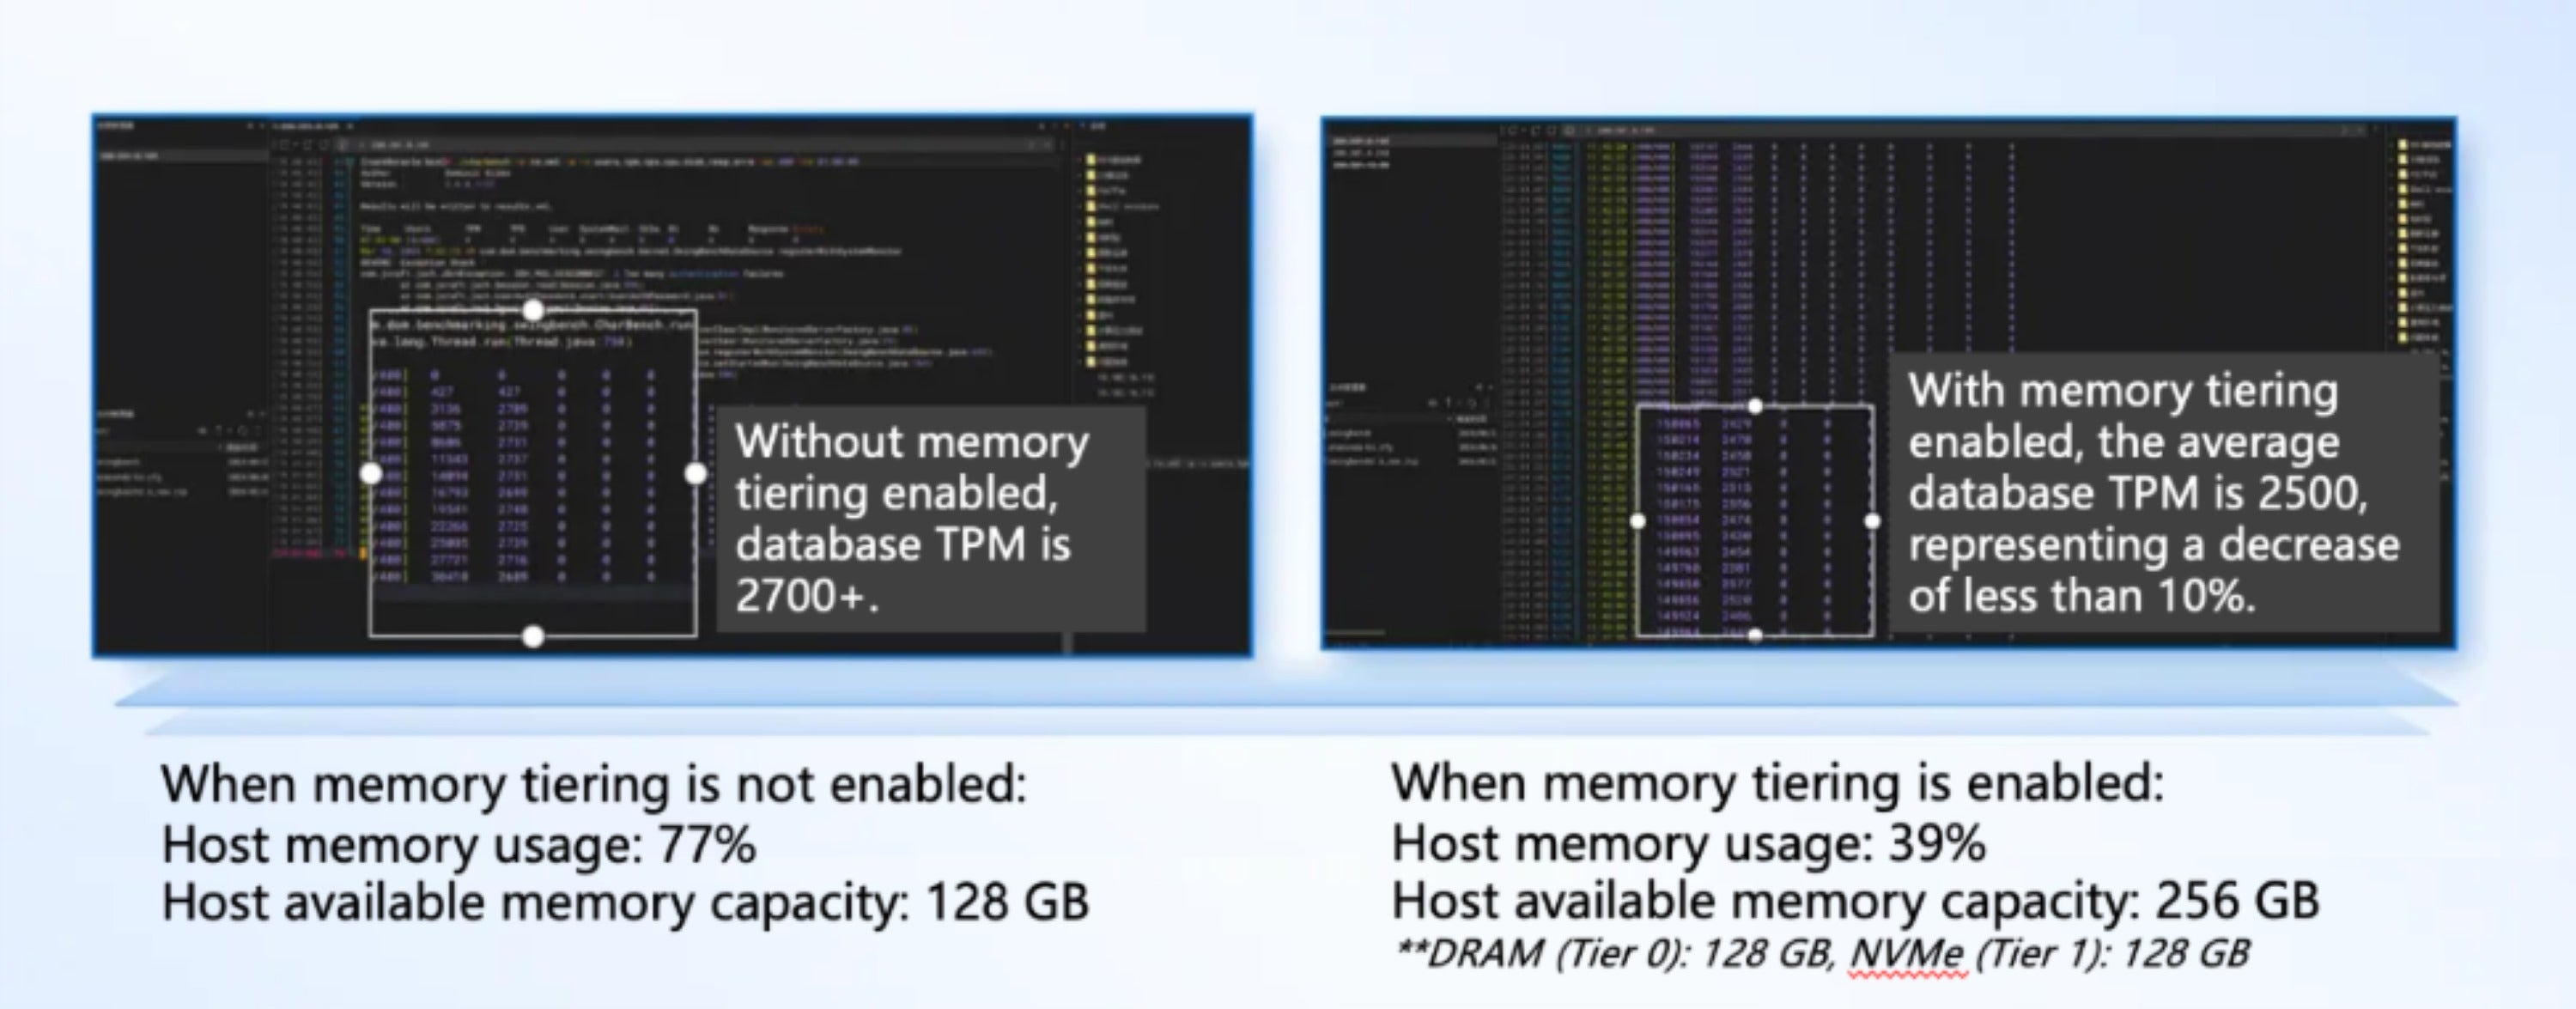
実際のOracleデータベースのテストでは、メモリ階層化を有効にすることで、128GBの物理DRAMを搭載したサーバーで、通常256GBを必要とするワークロードを効果的に処理することができました。その結果、TPM(1分あたりのトランザクション数)は約10%しか減少せず、使用可能なメモリ容量が2倍になったことに対するトレードオフとしてはわずかなものでした。
導入の柔軟性とベストプラクティス
すべてのワークロードがメモリ階層化に適しているわけではありません。メモリ階層化は、以下のような、ホットデータとコールドデータのパターンが明確に分かれているシナリオに最適です。
- デスクトップ仮想化(VDI)
- 開発環境およびテスト環境
- 重要度の低いキャッシュサービス
- 中規模のマイクロサービスクラスター
超低遅延が求められる場合、メモリ階層化は仮想マシンごとに選択的に無効にすることができます。
- 高頻度取引システム
- レイテンシに敏感なOLTPデータベース(アクセスパターンが均一)
- 厳格なSLA要件を満たすリアルタイム分析
Sangforは、最適なバランスを実現するために、DRAMと階層化容量の比率を1:1にすることを推奨しています。これにより、パフォーマンスへの影響を最小限に抑えつつ、実効メモリ容量を2倍にすることができます。
結論
VMware vSphereからSangfor Virtualizationへの移行は、単なる横滑り移行ではなく、より高いパフォーマンスと効率性を実現するために仮想化レイヤーを再設計する絶好の機会です。データベースやI/O負荷の高いワークロードにおいては、今回ご紹介する2つのテクノロジー、アダプティブNUMAスケジューリングとメモリ階層化が、最新のインフラストラクチャにおける最も重要な制約であるメモリアクセスレイテンシとメモリ容量に直接的に対処します。
アダプティブNUMAスケジューリングは、データベース、インメモリキャッシュ、ミドルウェアがローカルメモリに予測可能で低遅延のアクセスを実現し、手動による介入なしにワークロードの変動に自動的に適応することを保証します。一方、メモリ階層化は、DRAMの高額なコストをかけずにメモリ容量を拡張する現実的な方法を提供し、許容範囲内のパフォーマンスを維持しながら、サーバーあたりのワークロードを統合することを可能にします。
これらの革新技術により、Sangfor VirtualizationはVMware vSphereが設定したパフォーマンス要件を満たすだけでなく、特に現代の基幹業務システムを特徴づける要求の厳しいシナリオにおいて、それを上回るプラットフォームを提供します。VMwareからの移行を進めるにあたり、お客様の最も重要なアプリケーションは確かな技術力を持つSangfor Virtualizationにお任せください。
貴社も同様の課題に直面している場合は、ぜひご連絡ください。貴社の状況に合わせた最適な移行計画を策定するため、共同で状況評価を実施する準備ができています。

