
Einführung
Da Unternehmen ihre VMware-Ablösungsinitiativen beschleunigen, taucht immer wieder dieselbe Frage auf: Werden meine Datenbanken und E/A-intensiven Workloads auf der neuen Virtualisierungsplattform genauso gut – oder sogar besser – funktionieren? VMware vSphere gilt seit Jahren als Goldstandard für den Betrieb unternehmenskritischer Anwendungen, und jede Migration wirft naturgemäß Bedenken hinsichtlich Leistungskonsistenz, Latenzspitzen und Ressourceneffizienz auf.
Sangfor Virtualization (HCI) ist nicht einfach nur ein direkter Ersatz. Es wurde entwickelt, um die höchsten Leistungsanforderungen von zentralen Geschäftssystemen zu erfüllen. Durch die tiefgreifende Optimierung der zugrundeliegenden Architektur, insbesondere im Hinblick auf NUMA-Scheduling (Non-Uniform Memory Access) und Speichererweiterung, stellt Sangfor Virtualization sicher, dass Datenbanken, In-Memory-Caches und andere E/A-sensitive Workloads ihre bisherige Leistung nicht nur beibehalten, sondern oft sogar übertreffen.
In diesem Beitrag analysieren wir zwei Schlüsseltechnologien, die dies ermöglichen: Adaptive NUMA Scheduling und Memory Tiering . Anhand validierter Testdaten und architektonischer Erkenntnisse untersuchen wir, wie diese Funktionen die grundlegenden Leistungsengpässe in modernen Serverumgebungen beheben.
Teil 1: Überwindung der Speicherzugriffslatenz durch adaptive NUMA-Planung
Die NUMA-Herausforderung in virtualisierten Umgebungen
Moderne Unternehmensserver nutzen die NUMA-Architektur, um die Skalierungsgrenzen des traditionellen symmetrischen Multiprocessings (SMP) zu überwinden. In einem NUMA-System sind die Prozessorkerne und der Speicher in Knoten unterteilt. Jeder Knoten verfügt über einen eigenen lokalen Speicher. Während der Zugriff auf den lokalen Speicher schnell ist, verursacht der Zugriff auf den Speicher eines entfernten Knotens erhebliche Latenzzeiten. Lokale Speicherzugriffe dauern etwa 70–90 ns ; entfernte Zugriffe sind üblicherweise 1,5–2-mal langsamer und können sich bei hoher Auslastung weiter verschlechtern.
In einer virtualisierten Umgebung wird jede virtuelle Maschine (VM) durch eine Menge von vCPU-Threads repräsentiert. Werden diese Threads auf verschiedene NUMA-Knoten verteilt oder zwischen Knoten migriert, kommt es zu Remote-Speicherzugriffen der VM, was unvorhersehbare Latenzen und einen reduzierten Durchsatz zur Folge hat. Dies ist besonders nachteilig für Datenbanksysteme wie Oracle, DM8 und PostgreSQL sowie für In-Memory-Datenspeicher wie Redis.
VMware vSpheres Ansatz: vSphere 6.0 und spätere Versionen verfügen über einen automatischen NUMA-Scheduler, der die meisten allgemeinen Workloads effizient verarbeitet. Er bietet Funktionen wie vNUMA-Exposition und Lastverteilung über verschiedene Knoten. Bei hochspezialisierten, E/A-intensiven Workloads müssen Administratoren jedoch unter Umständen die CPU-Affinitätseinstellungen feinabstimmen oder erweiterte Parameter anpassen, um eine optimale Leistung zu erzielen.
Adaptive NUMA-Planung von Sangfor Virtualization
Sangfor Virtualization verfolgt einen grundlegend anderen Ansatz. Anstatt auf manuelle Eingriffe zu setzen, implementiert es eine vollständig adaptive NUMA-Scheduling-Engine , die automatisch und dynamisch arbeitet. Der Scheduler analysiert kontinuierlich die Anzahl der vCPUs jeder VM und die Echtzeit-Auslastung der physischen NUMA-Knoten und trifft anschließend optimale Platzierungsentscheidungen. Wie in der Abbildung dargestellt, wählt das System automatisch den passenden NUMA-Knoten für jede virtuelle Maschine aus. Ist die Anzahl der vCPUs einer VM geringer als die Anzahl der Kerne eines NUMA-Knotens, wird die VM auf einem einzelnen NUMA-Knoten eingeplant. Übersteigt die Anzahl der vCPUs die Anzahl der Kerne eines NUMA-Knotens, wird die VM auf mehrere NUMA-Knoten verteilt, und die vNUMA-Topologie wird dem Gastbetriebssystem zugänglich gemacht, sodass die VM intern optimale Entscheidungen treffen kann.
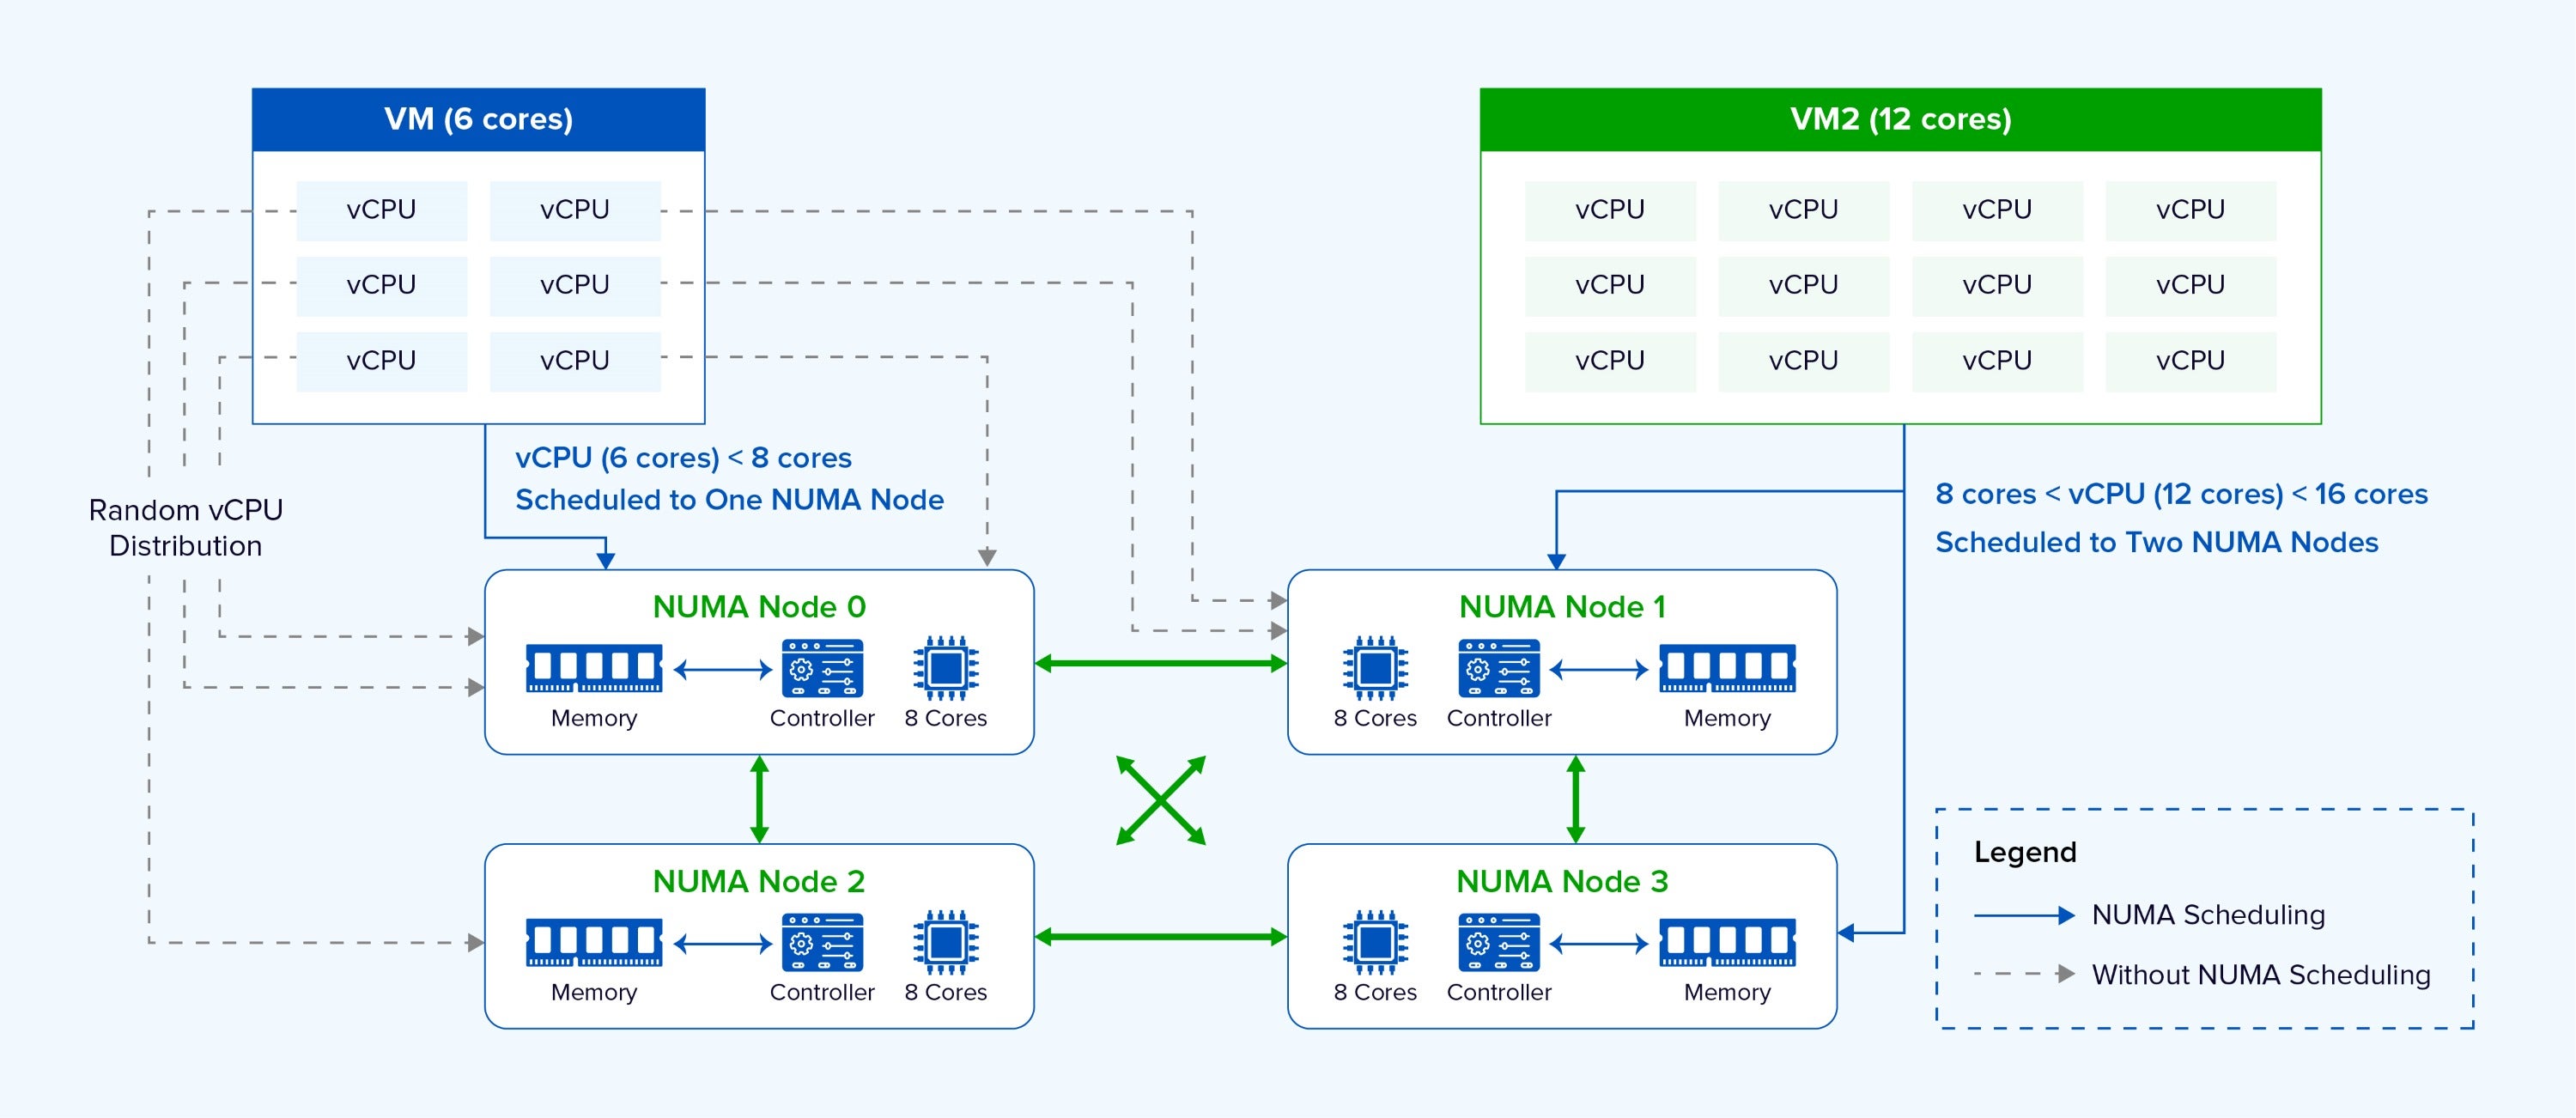
- vCPU-Konsolidierung: Wenn die Anzahl der vCPUs einer VM kleiner oder gleich der Anzahl der Kerne eines einzelnen physischen NUMA-Knotens ist, platziert Sangfor Virtualization alle vCPUs und den gesamten Arbeitsspeicher auf demselben Knoten. Dies gewährleistet einen vollständig lokalen Speicherzugriff für die VM und eliminiert knotenübergreifende Latenzzeiten.
- Intelligente Verteilung für große VMs: Bei VMs mit mehr vCPUs, als ein einzelner Knoten verarbeiten kann, verteilt der Scheduler diese auf mehrere NUMA-Knoten. Entscheidend ist, dass er die virtuelle NUMA-Topologie (vNUMA) dem Gastbetriebssystem zugänglich macht. Dadurch kann das Betriebssystem innerhalb der VM fundierte Scheduling-Entscheidungen treffen und die Speicherlokalität weiter optimieren.
- Lastverteilung zwischen den Knoten: Der Scheduler überwacht die Auslastung der NUMA-Knoten und kann VMs bei Bedarf zwischen den Knoten verschieben, um Ressourcenkonflikte zu vermeiden. Er identifiziert außerdem wichtige VMs (z. B. solche, auf denen kritische Datenbanken laufen) und priorisiert deren Platzierung auf weniger ausgelasteten Knoten, um eine stabile Leistung zu gewährleisten.
Jenseits von vCPU: Speicher- und Netzwerk-NUMA-Affinität
Was Sangfor Virtualization auszeichnet, ist, dass die NUMA-Optimierungen weit über die CPU-Planung hinausgehen. Ein vollständiger E/A-Pfad – von der vCPU über den QEMU-Prozess und den aSAN-Speicherdienst bis hin zum Netzwerkdatenweiterleitungsprozess – kann intelligent an denselben NUMA-Knoten gebunden werden. Dieser ganzheitliche Ansatz eliminiert den Fernzugriff auf den Speicher im gesamten E/A-Stack und reduziert so den Verarbeitungsaufwand drastisch.
In Kombination mit großen Speicherseiten (Huge Pages) kommt diese Optimierung datenbank- und speicherintensiven Anwendungen direkt zugute. Führt eine Datenbank beispielsweise einen Schreibvorgang durch, bleibt der gesamte Workflow innerhalb derselben NUMA-Domäne, wodurch die Latenz minimiert und der Durchsatz maximiert wird.
Hinweis: Die NUMA-Affinitätsoptimierung gilt innerhalb jedes einzelnen Hosts. Der hostübergreifende Speicherzugriff in verteilten Konfigurationen (wie z. B. aSAN) verursacht weiterhin die in jeder verteilten Architektur zu erwartende Netzwerklatenz.
Leistungsvalidierung
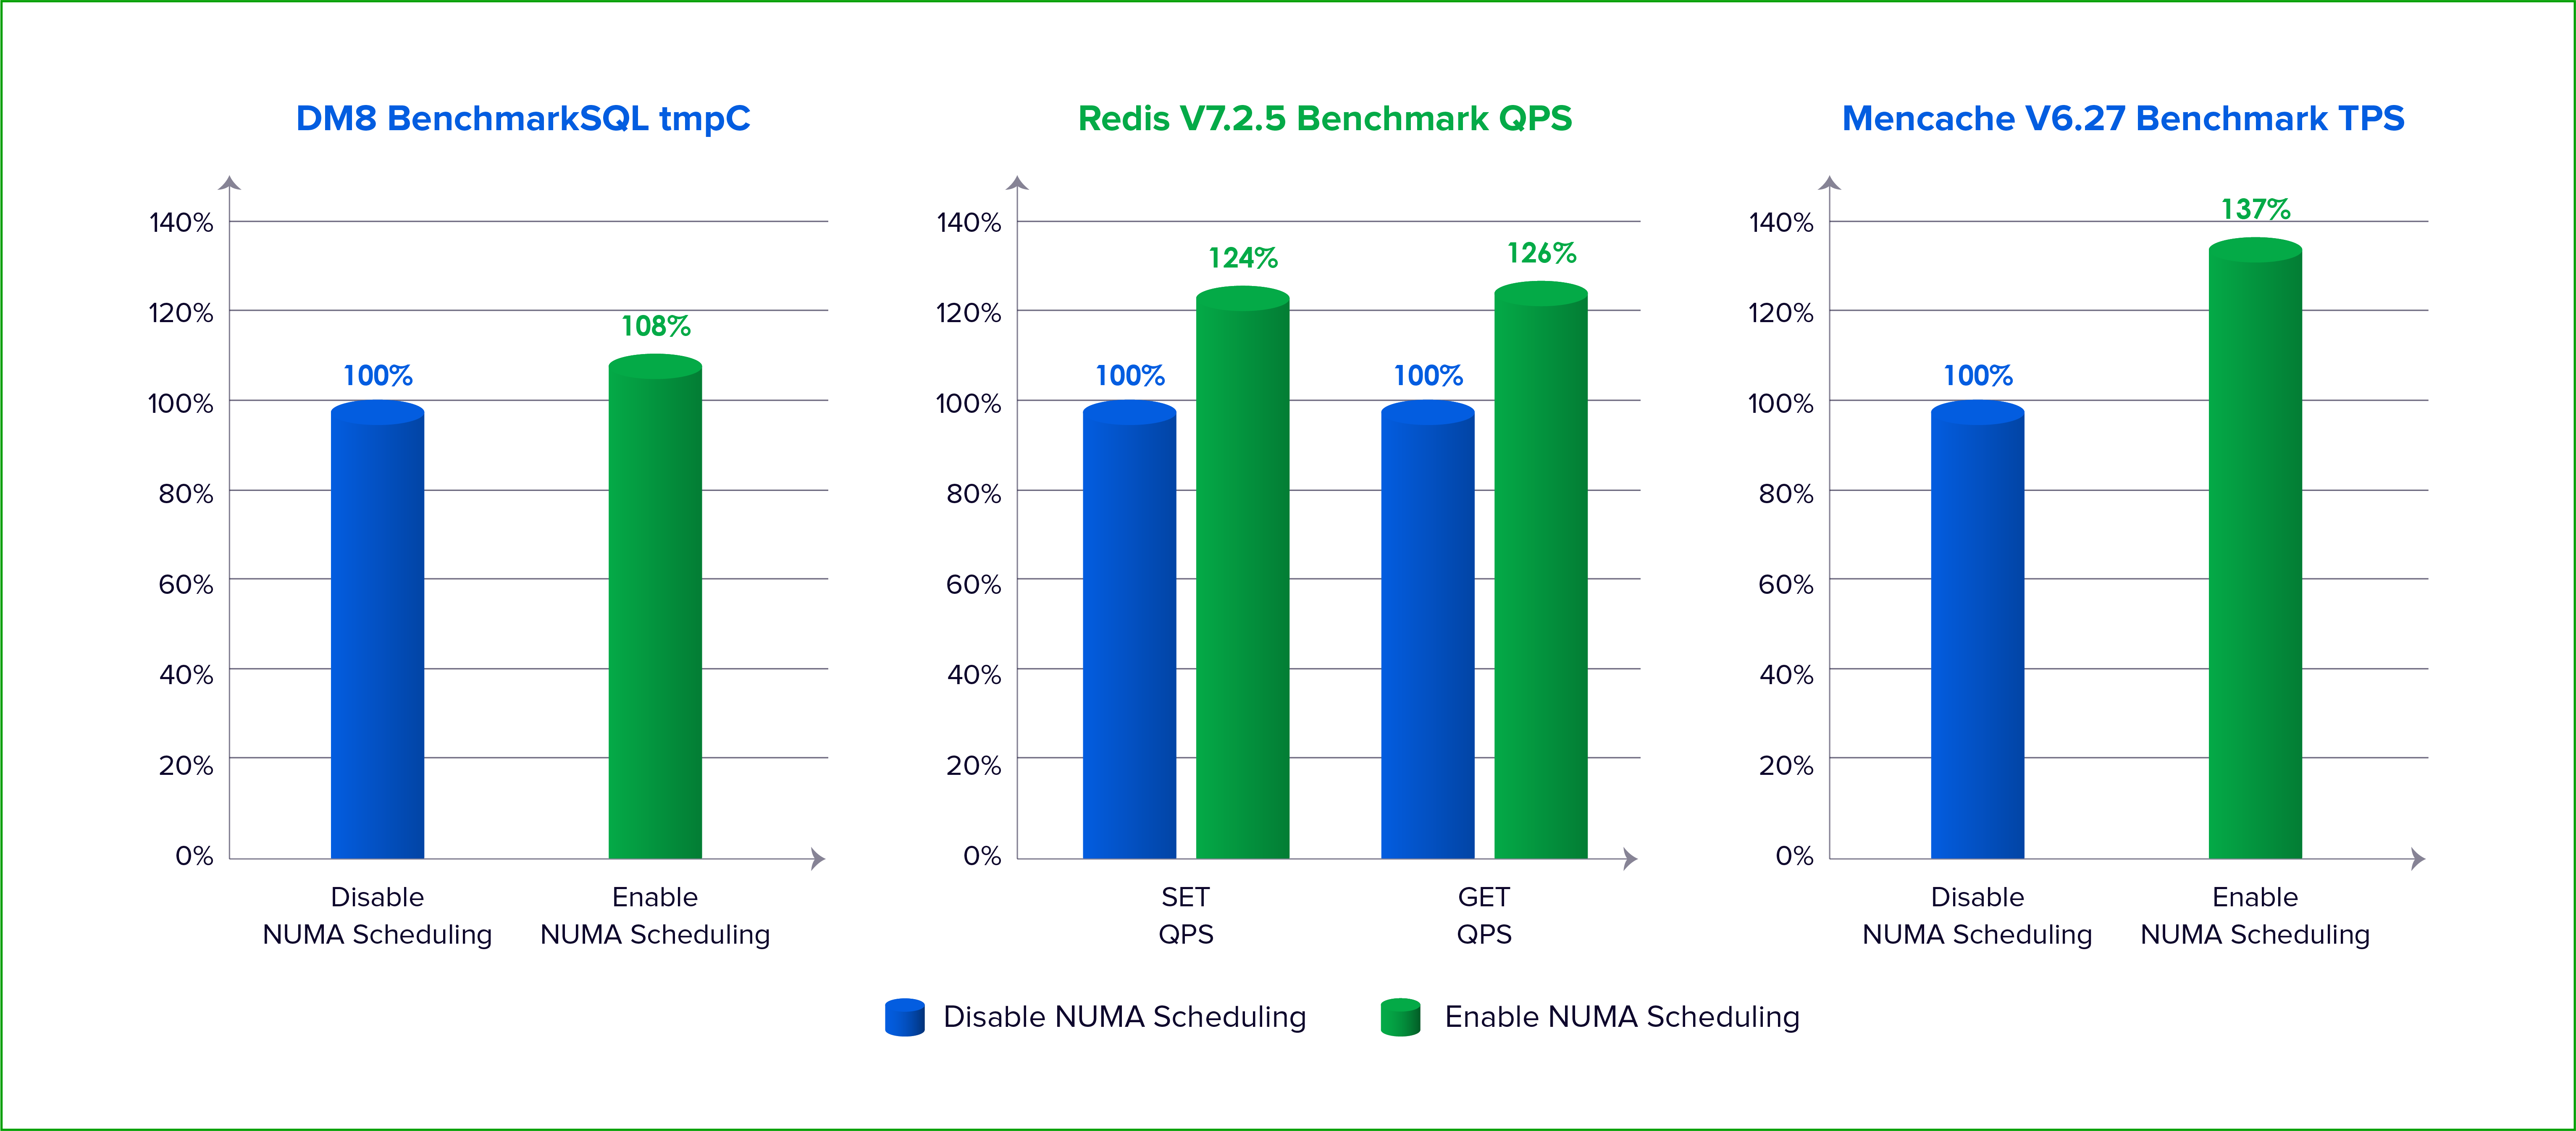
Die Wirksamkeit dieser Optimierungen wird durch strenge Tests bestätigt. In einem Benchmark mit DM8 (einer führenden chinesischen Datenbank) und dem Standardtool BenchmarkSQL (TPC-C-Modell) führte die Aktivierung des NUMA-Schedulings von Sangfor Virtualization zu einer deutlichen Steigerung von tpmC im Vergleich zu einer Konfiguration ohne NUMA-Scheduling.
Auch in Redis-Benchmarks mit redis-benchmark für SET/GET-Operationen verbesserte sich die Anzahl der Abfragen pro Sekunde (QPS) deutlich, wenn NUMA-Scheduling aktiviert war. Memcache-Tests mit memaslap zeigten ebenfalls höhere Transaktionszahlen pro Sekunde (TPS). Diese Ergebnisse belegen, dass Sangfor Virtualization für speicherzugriffsintensive Workloads – also genau jene Anwendungen, die am ehesten von einer unzureichenden NUMA-Konfiguration betroffen sind – spürbare Leistungssteigerungen ermöglicht.
Teil 2: Die Speicherkapazitätsgrenze durchbrechen mit Memory Tiering
Das Speicherkosten-Dilemma
Für Datenbanken und E/A-intensive Anwendungen ist die Speicherkapazität oft die wichtigste Ressource. Größere Speicherpools ermöglichen größere Puffer-Caches (wie z. B. Oracle SGA), eine höhere Datenverarbeitungsgeschwindigkeit im Arbeitsspeicher und eine gesteigerte Parallelität. Allerdings unterliegen die DRAM-Preise weiterhin Schwankungen, und Engpässe in der Hardware-Lieferkette können umfangreiche Speichererweiterungen extrem verteuern.
Herkömmliche Techniken, die in Plattformen wie VMware vSphere eingesetzt werden – darunter Speicherkomprimierung, transparente Seitenteilung und Memory-Overcommit – können die Auslastung zwar verbessern, weisen aber systembedingte Einschränkungen auf. Sie erhöhen nicht grundsätzlich den verfügbaren Arbeitsspeicher, sondern optimieren lediglich die Effizienz des vorhandenen DRAM. Wenn Workloads mehr aktiven Speicher benötigen, als physisch verfügbar ist, verschlechtert sich die Leistung zwangsläufig.
Wie Sangfor Virtualization Memory Tiering funktioniert
Sangfor Virtualization führt mit Memory Tiering einen Paradigmenwechsel ein. Diese Technologie schafft einen einheitlichen Speicherpool durch die Kombination von schnellem DRAM mit leistungsstarken NVMe-SSDs. Die Kernidee besteht darin, die NVMe-SSD als Erweiterung des Systemspeichers zu nutzen und so die verfügbare Kapazität effektiv zu verdoppeln, ohne zusätzlichen DRAM zu benötigen.
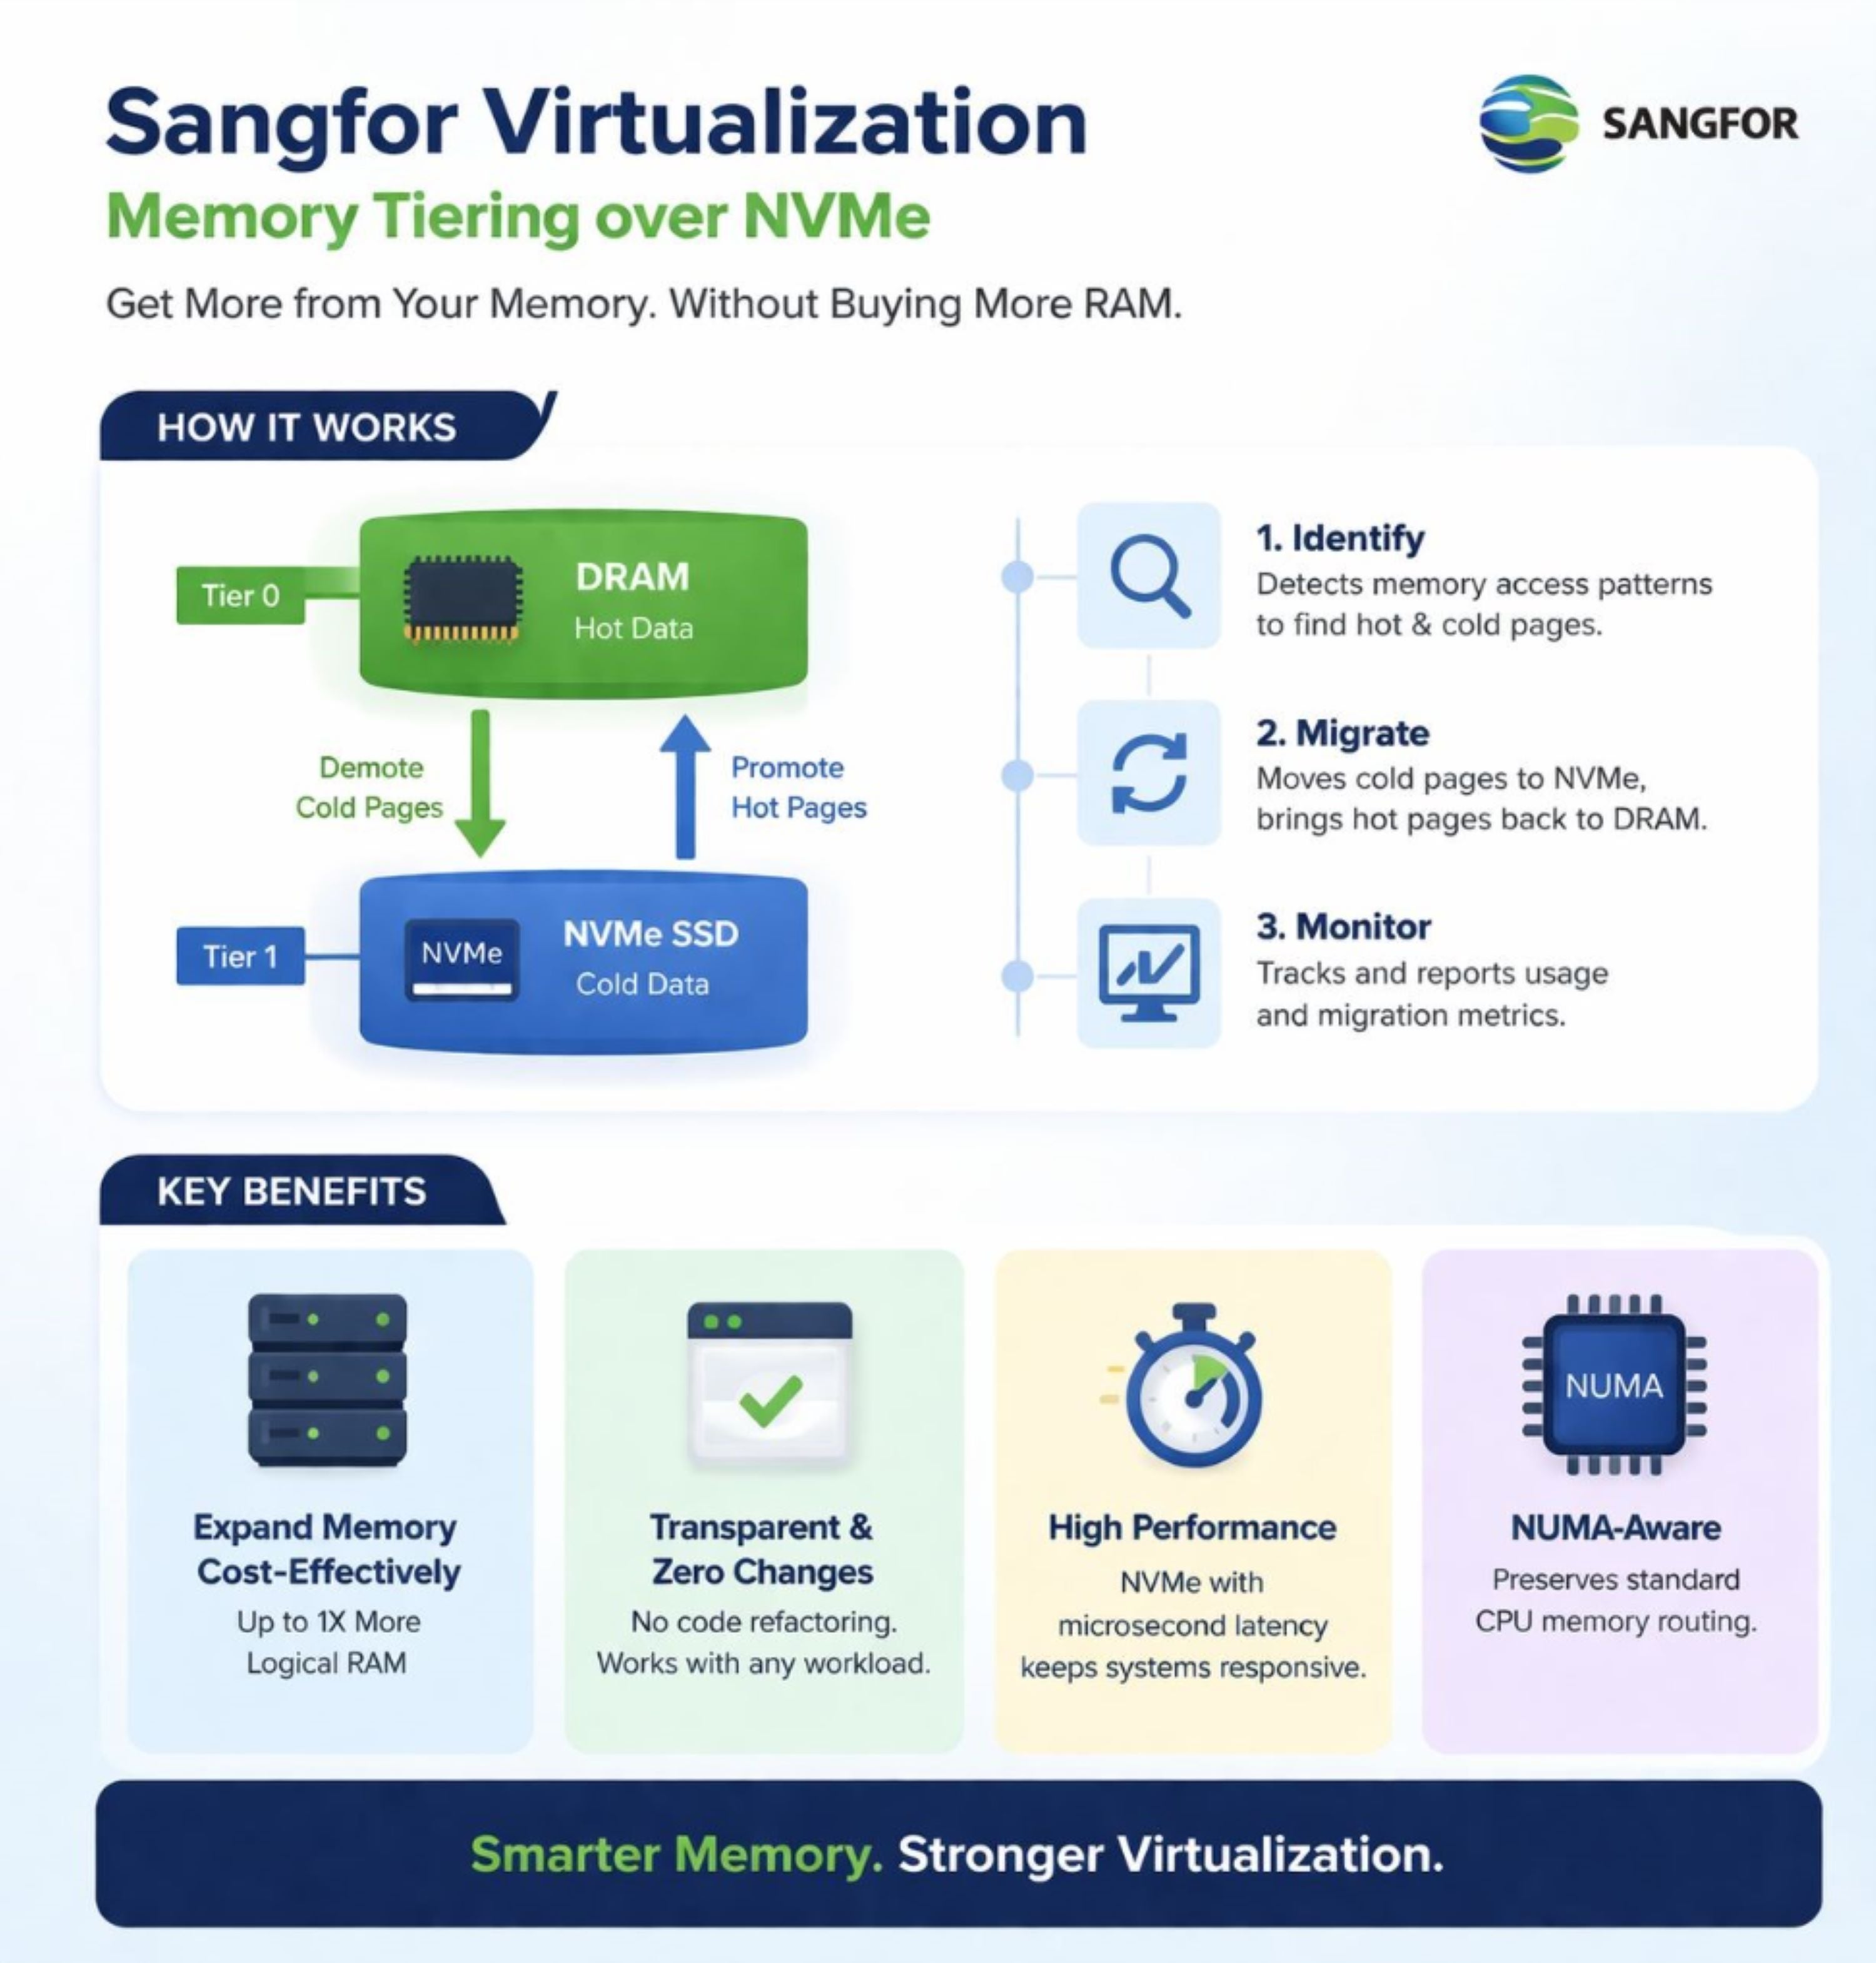
Der Clou liegt in der intelligenten Datenplatzierung. Mithilfe eines ressourcenschonenden dynamischen Bereichspartitionierungs- und Zufallsstichprobenverfahrens überwacht Sangfor Virtualization kontinuierlich die Speicherseiten, um zwischen „heißen“ (häufig abgerufenen) und „kalten“ (selten abgerufenen) Daten zu unterscheiden.
- Häufig genutzte Daten – wie aktive Datenbankindizes, kritische Transaktionsprotokolle oder häufig abgefragte Tabellen – verbleiben zur Gewährleistung eines latenzarmen Zugriffs im DRAM-Tier (Tier 0).
- Wenig genutzte Daten – wie historische Datensätze, Sicherungsseiten oder ungenutzter Anwendungsspeicher – werden automatisch auf die NVMe-Ebene (Tier 1) verschoben. Diese Migration erfolgt transparent, ohne Eingriff des Gastbetriebssystems oder der Anwendung.
CPU-Zugriffsfluss- und Leistungssteuerung
Wenn die CPU eine Speicheradresse anfordert, prüft das System den DRAM-Speicher. Wird die Seite gefunden (Hot Hit), erfolgt der Zugriff sofort. Ist sie nicht vorhanden (Cold Miss), löst das System einen transparenten Seitenfehler aus, verschiebt die benötigte Seite schnell vom NVMe-Speicher zurück in den DRAM und schließt anschließend den CPU-Zugriff ab. Für die Anwendung ist dieser Vorgang nicht von einer normalen Speicheroperation zu unterscheiden.
Entscheidend ist, dass die NVMe-Ebene als Arbeitsspeicher und nicht als Auslagerungsspeicher behandelt wird. Der NVMe-Controller nutzt die PCIe-Bandbreite, um Daten mit minimaler CPU-Belastung zu übertragen. Da moderne PCIe 4.0/5.0 NVMe-Laufwerke Latenzen im Bereich von 10–100 µs und Bandbreiten von bis zu 7 GB/s bieten, ist der Aufwand für die Aktualisierung von Seiten extrem gering.
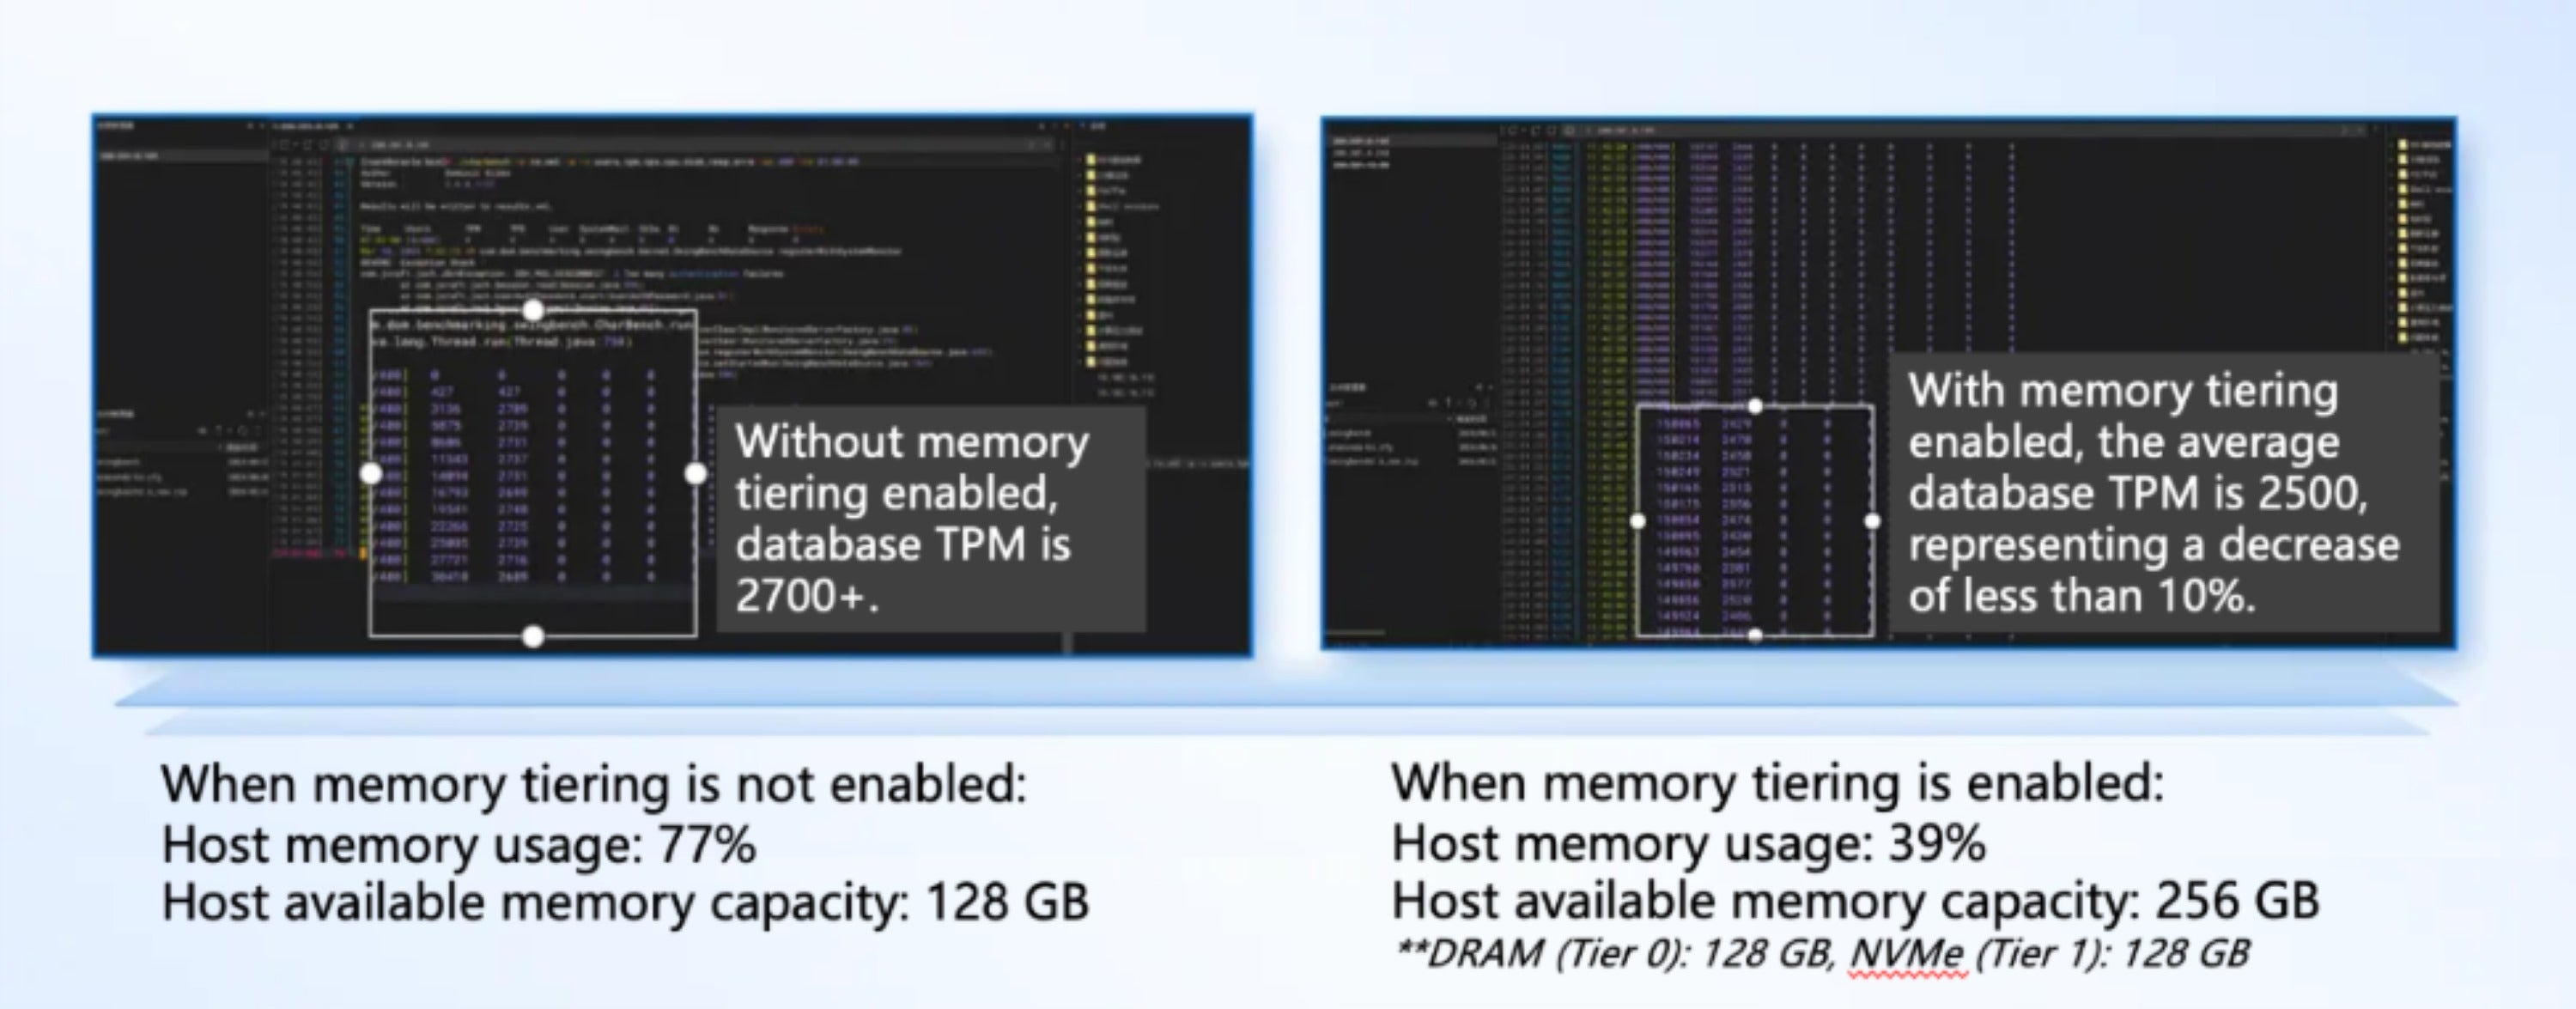
In realen Oracle-Datenbanktests ermöglichte die Aktivierung von Memory Tiering einem Server mit 128 GB physischem DRAM, eine Arbeitslast effektiv zu bewältigen, die normalerweise 256 GB erfordern würde. Die resultierenden Transaktionen pro Minute (TPM) sanken nur um etwa 10 % – ein geringfügiger Kompromiss für die Verdopplung der nutzbaren Speicherkapazität.
Flexibilität bei der Bereitstellung und bewährte Verfahren
Nicht alle Arbeitslasten eignen sich ideal für Memory Tiering. Es eignet sich am besten für Szenarien mit deutlich ausgeprägten Mustern häufiger und seltener Datennutzung, wie zum Beispiel:
- Desktop-Virtualisierung (VDI)
- Entwicklungs- und Testumgebungen
- Nicht kritische Caching-Dienste
- Moderate Microservice-Cluster
Für Anforderungen an extrem niedrige Latenzzeiten kann Memory Tiering selektiv pro VM deaktiviert werden:
- Hochfrequenzhandelssysteme
- Latenzempfindliche OLTP-Datenbanken mit einheitlichen Zugriffsmustern
- Echtzeitanalysen mit strengen SLA-Anforderungen
Sangfor empfiehlt ein DRAM-zu-Tiering-Kapazitätsverhältnis von 1:1, um ein optimales Gleichgewicht zu erreichen – die doppelte effektive Speicherkapazität bei minimalen Leistungseinbußen.
Abschluss
Die Migration von VMware vSphere zu Sangfor Virtualization ist mehr als nur ein Schritt auf der gleichen Ebene; sie bietet die Chance, Ihre Virtualisierungsschicht für höhere Leistung und Effizienz neu zu gestalten. Für datenbank- und E/A-intensive Workloads adressieren die beiden vorgestellten Technologien – Adaptive NUMA Scheduling und Memory Tiering – direkt die kritischsten Einschränkungen moderner Infrastrukturen: Speicherzugriffslatenz und Speicherkapazität.
Adaptives NUMA-Scheduling gewährleistet, dass Ihre Datenbanken, In-Memory-Caches und Middleware mit vorhersehbarem, latenzarmem Zugriff auf den lokalen Speicher laufen und sich automatisch an die Workload-Dynamik anpassen, ohne dass ein manueller Eingriff erforderlich ist. Memory Tiering hingegen bietet einen pragmatischen Weg zur Skalierung der Speicherkapazität ohne die prohibitiven Kosten von DRAM. Dadurch können Sie mehr Workloads pro Server konsolidieren und gleichzeitig die Leistung in akzeptablen Grenzen halten.
Mit diesen Innovationen bietet Sangfor Virtualization eine Plattform, die die Leistungserwartungen von VMware vSphere nicht nur erfüllt, sondern oft übertrifft – insbesondere in den anspruchsvollen Szenarien moderner Kerngeschäftssysteme. Bei Ihrem VMware-Ersatz können Sie sich darauf verlassen, dass Ihre wichtigsten Anwendungen in kompetenten Händen sind.
Wenn Ihre Organisation vor ähnlichen Herausforderungen steht, laden wir Sie ein, uns zu kontaktieren. Wir sind bereit, gemeinsam mit Ihnen eine Analyse durchzuführen und einen maßgeschneiderten Übergangsplan zu entwickeln, der genau auf Ihre Gegebenheiten abgestimmt ist.

