
การแนะนำ
ขณะที่องค์กรต่างๆ เร่งดำเนินการเปลี่ยนระบบไปใช้ VMware คำถามหนึ่งที่มักเกิดขึ้นเสมอคือ ฐานข้อมูลและเวิร์กโหลดที่ใช้ I/O จำนวนมากจะทำงานได้ดีเท่าเดิมหรือดีกว่าเดิมบนแพลตฟอร์มเวอร์ชวลไลเซชันใหม่หรือไม่? ตลอดหลายปีที่ผ่านมา VMware vSphere ถือเป็นมาตรฐานทองคำสำหรับการใช้งานแอปพลิเคชันที่สำคัญ และการย้ายระบบใดๆ ก็ตามย่อมทำให้เกิดความกังวลเกี่ยวกับความสม่ำเสมอของประสิทธิภาพ การเกิดความหน่วง และประสิทธิภาพการใช้ทรัพยากร
Sangfor Virtualization (HCI) ไม่ใช่แค่การทดแทนแบบสำเร็จรูป แต่ได้รับการออกแบบมาเพื่อตอบสนองความต้องการด้านประสิทธิภาพสูงสุดของระบบธุรกิจหลัก ด้วยการปรับแต่งสถาปัตยกรรมพื้นฐานอย่างลึกซึ้ง โดยเฉพาะอย่างยิ่งในส่วนของการจัดตารางเวลาการเข้าถึงหน่วยความจำแบบไม่สม่ำเสมอ (NUMA) และการขยายความจุหน่วยความจำ Sangfor Virtualization จึงมั่นใจได้ว่าฐานข้อมูล แคชในหน่วยความจำ และเวิร์กโหลดที่ไวต่อ I/O อื่นๆ ไม่เพียงแต่จะรักษาประสิทธิภาพไว้ได้ แต่บ่อยครั้งก็มีประสิทธิภาพสูงกว่าระดับเดิมด้วย
ในบทความนี้ เราจะวิเคราะห์เทคโนโลยีสำคัญสองอย่างที่ทำให้สิ่งนี้เป็นไปได้ ได้แก่ การจัดตาราง เวลา NUMA แบบปรับได้ (Adaptive NUMA Scheduling) และ การจัดลำดับชั้นหน่วยความจำ (Memory Tiering ) โดยอาศัยข้อมูลการทดสอบที่ได้รับการตรวจสอบแล้วและข้อมูลเชิงลึกด้านสถาปัตยกรรม เราจะสำรวจว่าคุณสมบัติเหล่านี้จัดการกับปัญหาคอขวดด้านประสิทธิภาพพื้นฐานในสภาพแวดล้อมเซิร์ฟเวอร์สมัยใหม่ได้อย่างไร
ส่วนที่ 1: เอาชนะปัญหาความล่าช้าในการเข้าถึงหน่วยความจำด้วยการจัดตารางเวลา NUMA แบบปรับได้
ความท้าทายของ NUMA ในสภาพแวดล้อมเสมือนจริง
เซิร์ฟเวอร์ระดับองค์กรสมัยใหม่ใช้สถาปัตยกรรม NUMA เพื่อขยายขนาดให้เหนือกว่าข้อจำกัดของระบบประมวลผลแบบสมมาตร (SMP) แบบดั้งเดิม ในระบบ NUMA แกนประมวลผลและหน่วยความจำจะถูกแบ่งออกเป็นโหนด แต่ละโหนดมีหน่วยความจำเฉพาะของตัวเอง และในขณะที่การเข้าถึงหน่วยความจำเฉพาะที่ทำได้อย่างรวดเร็ว การเข้าถึงหน่วยความจำจากโหนดระยะไกลจะทำให้เกิดความหน่วงอย่างมาก การเข้าถึงหน่วยความจำเฉพาะที่ใช้เวลา ประมาณ 70–90 นาโนวินาที การเข้าถึงจากระยะไกลมักจะช้ากว่า 1.5–2 เท่า และอาจช้าลงไปอีกหากเกิดการแย่งชิงทรัพยากร
ในสภาพแวดล้อมเสมือนจริง เครื่องเสมือน (VM) แต่ละเครื่องจะถูกแทนด้วยชุดของเธรด vCPU หากเธรดเหล่านี้ถูกจัดสรรให้ทำงานบนโหนด NUMA ที่แตกต่างกัน หรือหากมีการย้ายระหว่างโหนด เครื่องเสมือนจะประสบกับการเข้าถึงหน่วยความจำระยะไกล ซึ่งนำไปสู่ความหน่วงที่ไม่สามารถคาดเดาได้และปริมาณงานลดลง ปัญหานี้ส่งผลเสียอย่างมากต่อระบบฐานข้อมูล เช่น Oracle, DM8 และ PostgreSQL รวมถึงที่เก็บข้อมูลในหน่วยความจำ เช่น Redis ด้วย
แนวทางของ VMware vSphere: vSphere 6.0 และเวอร์ชันที่ใหม่กว่านั้นมีตัวจัดตารางเวลา NUMA อัตโนมัติที่จัดการเวิร์กโหลดทั่วไปส่วนใหญ่ได้อย่างมีประสิทธิภาพ โดยมีคุณสมบัติเช่น การเปิดเผย vNUMA และการกระจายโหลดระหว่างโหนด อย่างไรก็ตาม สำหรับเวิร์กโหลดที่เน้นการรับส่งข้อมูล I/O ระดับสูง ผู้ดูแลระบบอาจยังคงต้องปรับแต่งการตั้งค่าความสัมพันธ์ของ CPU หรือปรับพารามิเตอร์ขั้นสูงเพื่อให้ได้ประสิทธิภาพสูงสุด
การจัดตารางเวลา NUMA แบบปรับได้ของ Sangfor Virtualization
ระบบเวอร์ชวลไลเซชันของ Sangfor ใช้แนวทางที่แตกต่างออกไปโดยสิ้นเชิง แทนที่จะพึ่งพาการแทรกแซงด้วยตนเอง ระบบนี้ใช้กลไกการจัดตารางเวลา NUMA แบบปรับตัวได้เต็มรูปแบบ ซึ่งทำงานโดยอัตโนมัติและไดนามิก ตัวจัดตารางเวลาจะวิเคราะห์จำนวน vCPU ของแต่ละ VM และภาระงานแบบเรียลไทม์ของโหนด NUMA ทางกายภาพอย่างต่อเนื่อง จากนั้นจึงตัดสินใจเลือกตำแหน่งที่เหมาะสมที่สุด ดังแสดงในรูป ระบบจะเลือกโหนด NUMA ที่เหมาะสมสำหรับเครื่องเสมือนแต่ละเครื่องโดยอัตโนมัติ เมื่อจำนวน vCPU ของ VM น้อยกว่าจำนวนคอร์บนโหนด NUMA ระบบจะจัดตารางเวลา VM บนโหนด NUMA เดียว เมื่อจำนวน vCPU มากกว่าจำนวนคอร์บนโหนด NUMA ระบบจะจัดตารางเวลา VM บนหลายโหนด NUMA และโครงสร้าง vNUMA จะถูกเปิดเผยต่อระบบปฏิบัติการของเครื่องเสมือน ทำให้ VM สามารถตัดสินใจได้อย่างเหมาะสมภายในตัวเอง
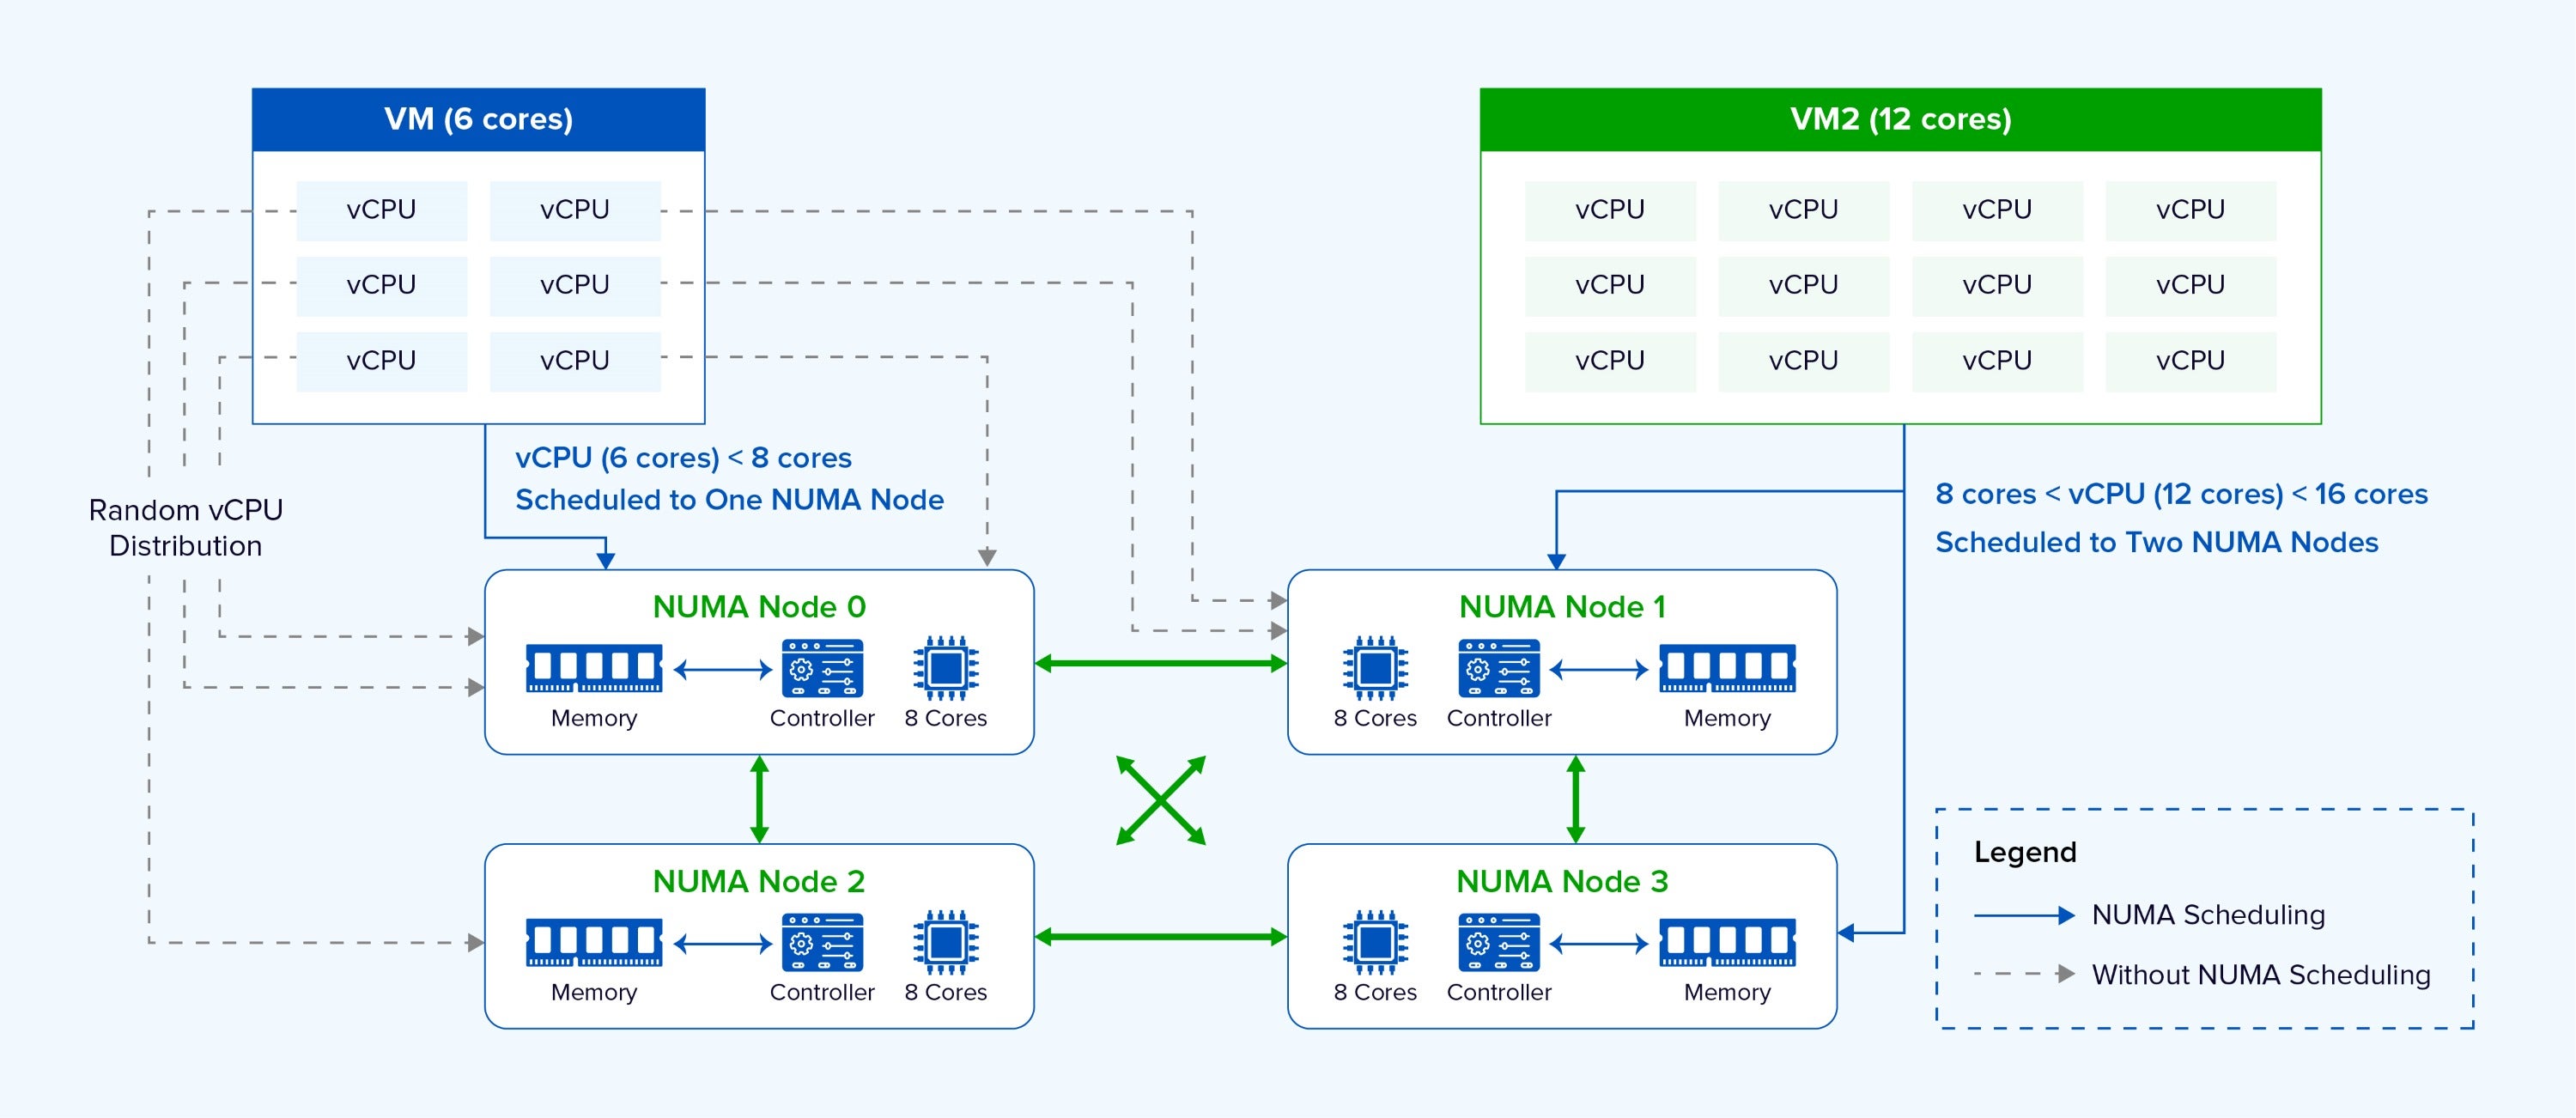
- การรวม vCPU: เมื่อจำนวน vCPU ของ VM น้อยกว่าหรือเท่ากับจำนวนคอร์บนโหนด NUMA ทางกายภาพเดียว Sangfor Virtualization จะวาง vCPU และหน่วยความจำทั้งหมดไว้ในโหนดเดียวกันนั้น ซึ่งช่วยให้มั่นใจได้ว่า VM จะสามารถเข้าถึงหน่วยความจำภายในได้ 100% ช่วยลดความหน่วงข้ามโหนด
- การกระจายทรัพยากรอย่างชาญฉลาดสำหรับ VM ขนาดใหญ่: สำหรับ VM ที่มี vCPU มากกว่าที่โหนดเดียวจะรองรับได้ ตัวจัดตารางเวลาจะกระจาย vCPU เหล่านั้นไปยังโหนด NUMA หลายโหนด ที่สำคัญคือ มันยังเปิดเผยโครงสร้าง NUMA เสมือน (vNUMA) ให้กับระบบปฏิบัติการภายใน VM ด้วย ซึ่งช่วยให้ระบบปฏิบัติการภายใน VM สามารถตัดสินใจในการจัดตารางเวลาได้อย่างชาญฉลาด ส่งผลให้การใช้หน่วยความจำมีประสิทธิภาพยิ่งขึ้น
- การกระจายโหลดข้ามโหนด: ตัวจัดตารางเวลาจะตรวจสอบโหลดของโหนด NUMA และสามารถย้าย VM ระหว่างโหนดได้เมื่อจำเป็นเพื่อป้องกันการแย่งชิงทรัพยากร นอกจากนี้ยังระบุ VM ที่ "สำคัญ" (เช่น VM ที่ใช้งานฐานข้อมูลที่สำคัญ) และจัดลำดับความสำคัญในการวาง VM เหล่านั้นบนโหนดที่มีการแย่งชิงทรัพยากรน้อยกว่า เพื่อให้มั่นใจถึงประสิทธิภาพที่เสถียร
นอกเหนือจาก vCPU: ความสัมพันธ์ NUMA ของพื้นที่จัดเก็บข้อมูลและเครือข่าย
สิ่งที่ทำให้ Sangfor Virtualization โดดเด่นคือการปรับแต่ง NUMA ที่ครอบคลุมมากกว่าแค่การจัดตารางการทำงานของ CPU เส้นทาง I/O ทั้งหมด ตั้งแต่ vCPU ไปจนถึงกระบวนการ QEMU ไปจนถึงบริการจัดเก็บข้อมูล aSAN และแม้กระทั่งกระบวนการส่งต่อข้อมูลเครือข่าย สามารถกำหนดให้ทำงานบนโหนด NUMA เดียวกันได้อย่างชาญฉลาด วิธีการแบบองค์รวมนี้ช่วยขจัดความจำเป็นในการเข้าถึงหน่วยความจำระยะไกลตลอดทั้งสแต็ก I/O ซึ่งช่วยลดภาระการประมวลผลลงอย่างมาก
เมื่อรวมกับหน่วยความจำขนาดใหญ่ (huge pages) การเพิ่มประสิทธิภาพนี้จะส่งผลดีโดยตรงต่อแอปพลิเคชันที่ใช้ฐานข้อมูลและพื้นที่จัดเก็บข้อมูลจำนวนมาก ตัวอย่างเช่น เมื่อฐานข้อมูลดำเนินการเขียนข้อมูล กระบวนการทำงานทั้งหมดจะยังคงอยู่ในโดเมน NUMA เดียวกัน ซึ่งช่วยลดความหน่วงและเพิ่มปริมาณงานให้สูงสุด
หมายเหตุ: การเพิ่มประสิทธิภาพความสัมพันธ์ของ NUMA จะมีผลภายในแต่ละโฮสต์ การเข้าถึงพื้นที่จัดเก็บข้อมูลข้ามโฮสต์ในการกำหนดค่าแบบกระจาย (เช่น aSAN) จะยังคงทำให้เกิดความหน่วงของเครือข่ายตามที่คาดไว้ในสถาปัตยกรรมแบบกระจายใดๆ
การตรวจสอบประสิทธิภาพ
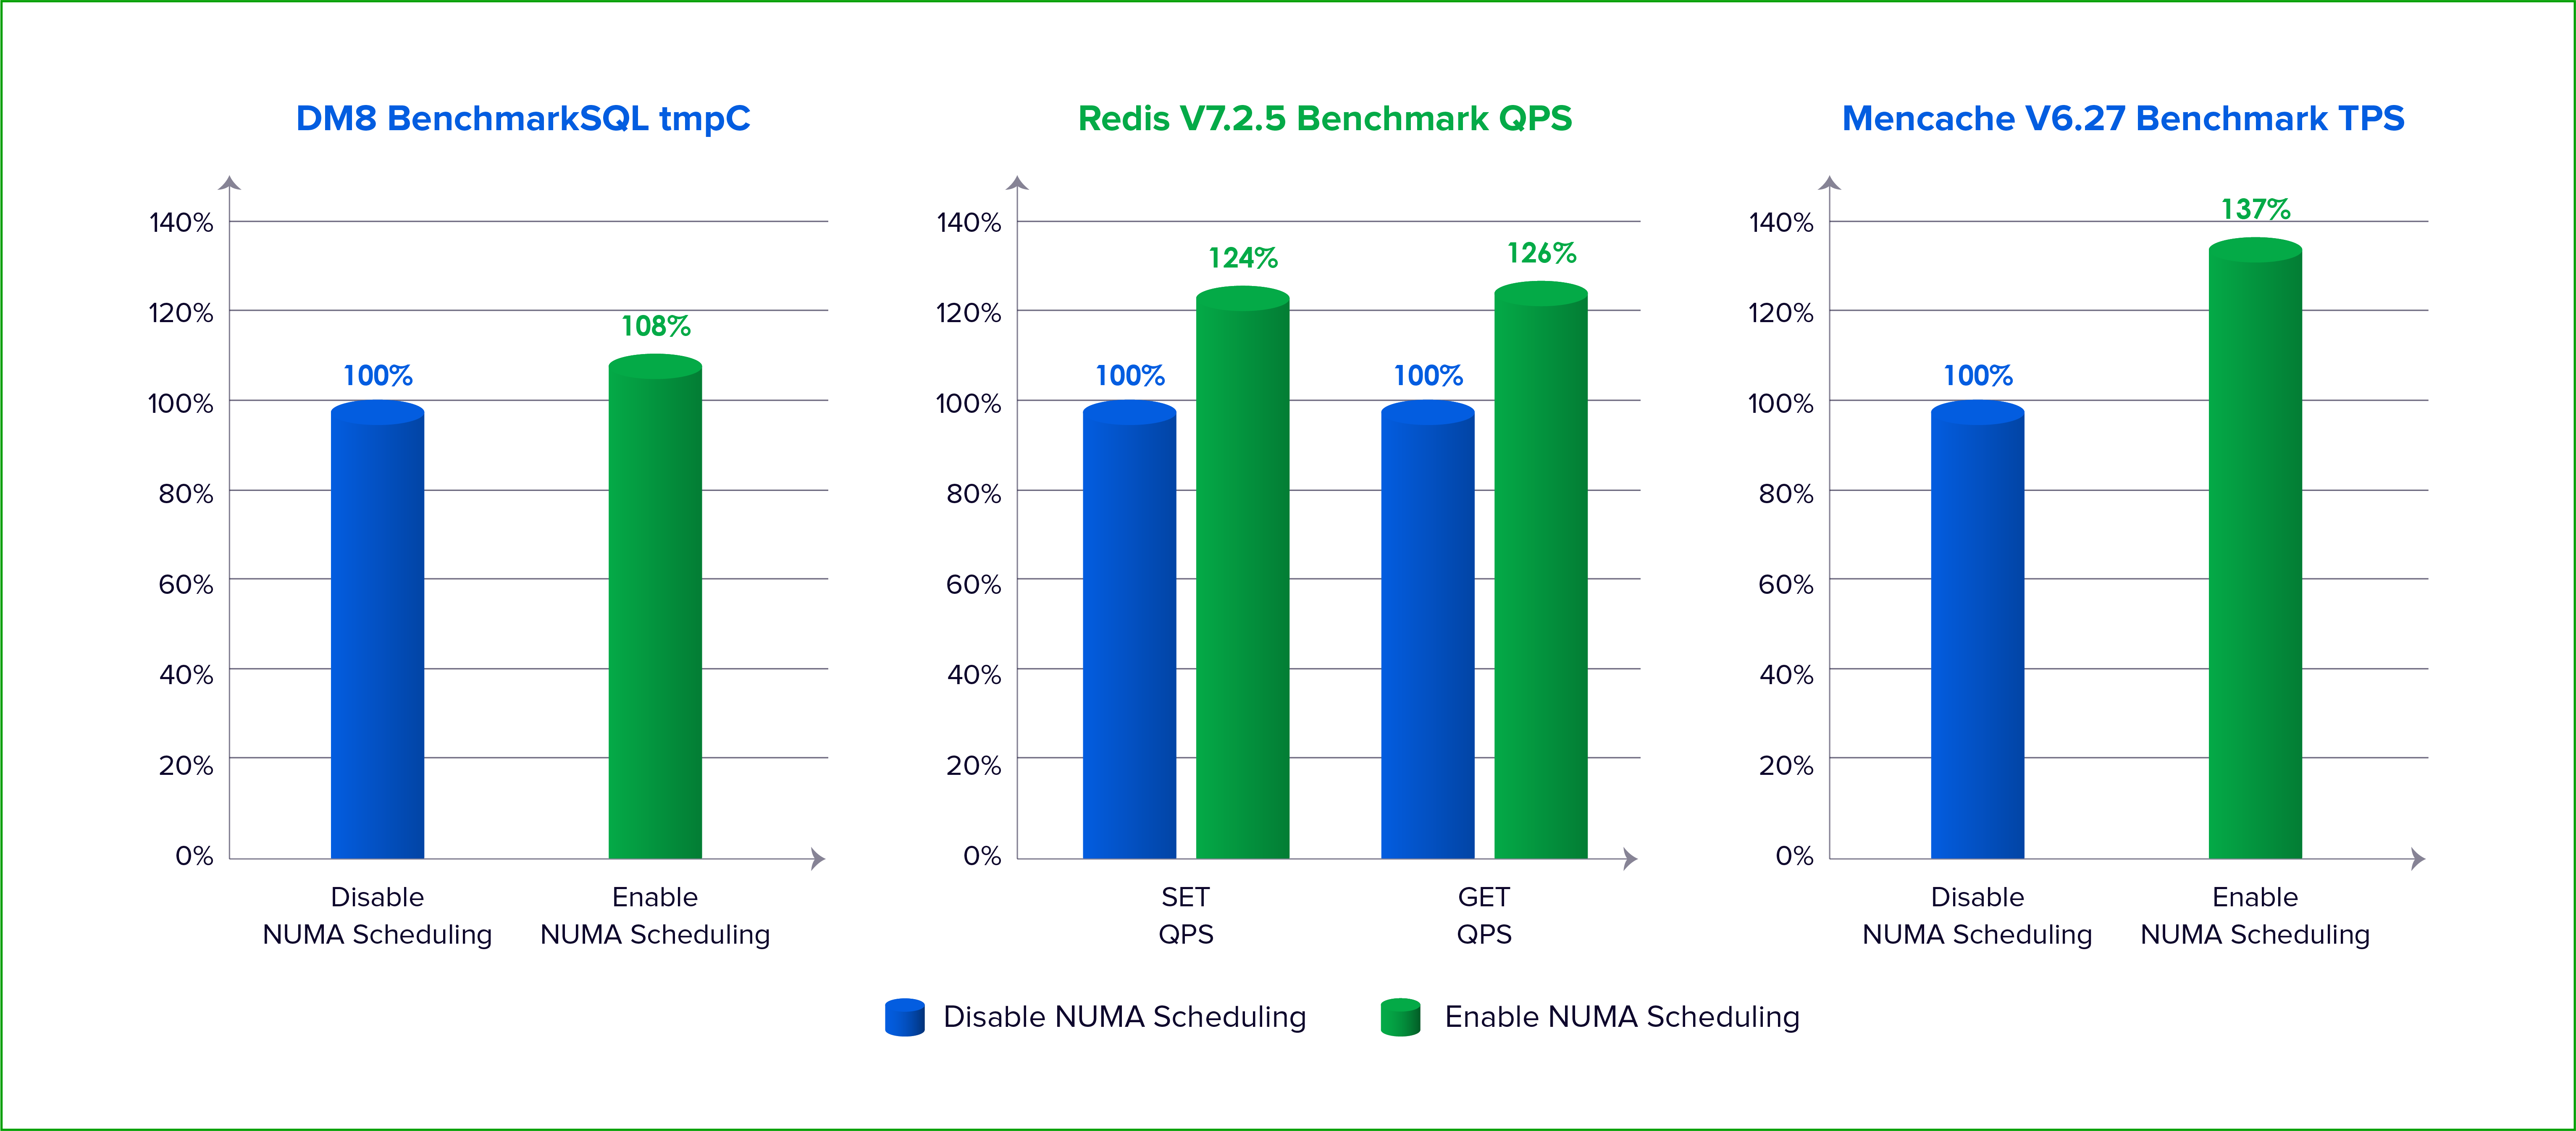
ประสิทธิภาพของการปรับแต่งเหล่านี้ได้รับการตรวจสอบแล้วผ่านการทดสอบอย่างเข้มงวด ในการทดสอบประสิทธิภาพโดยใช้ DM8 (ฐานข้อมูลชั้นนำในประเทศ) และเครื่องมือ BenchmarkSQL มาตรฐาน (โมเดล TPC-C) การเปิดใช้งานการจัดตารางเวลา NUMA ของ Sangfor Virtualization ส่งผลให้ค่า tpmC เพิ่มขึ้นอย่างมาก เมื่อเทียบกับการกำหนดค่าที่ปิดใช้งานการจัดตารางเวลา NUMA
ในทำนองเดียวกัน ในการทดสอบประสิทธิภาพ Redis โดยใช้ redis-benchmark สำหรับการดำเนินการ SET/GET พบว่าจำนวนการสืบค้นต่อวินาที (QPS) ดีขึ้นอย่างเห็นได้ชัดเมื่อเปิดใช้งานการจัดตารางเวลา NUMA การทดสอบ Memcache โดยใช้ memaslap ก็แสดงให้เห็นถึงจำนวนธุรกรรมต่อวินาที (TPS) ที่สูงขึ้นเช่นกัน ผลลัพธ์เหล่านี้แสดงให้เห็นว่าสำหรับเวิร์กโหลดที่ไวต่อการเข้าถึงหน่วยความจำ ซึ่งเป็นแอปพลิเคชันที่อาจได้รับผลกระทบมากที่สุดจากการกำหนดค่า NUMA ที่ไม่ดีนั้น Sangfor Virtualization สามารถมอบประสิทธิภาพที่เพิ่มขึ้นอย่างเป็นรูปธรรมได้
ส่วนที่ 2: การก้าวข้ามขีดจำกัดความจุของหน่วยความจำด้วยการจัดลำดับชั้นหน่วยความจำ
ปัญหาเรื่องต้นทุนหน่วยความจำ
สำหรับฐานข้อมูลและแอปพลิเคชันที่ใช้การรับส่งข้อมูล (I/O) อย่างหนัก หน่วยความจำถือเป็นทรัพยากรที่สำคัญที่สุด หน่วยความจำขนาดใหญ่ช่วยให้สามารถใช้บัฟเฟอร์แคชขนาดใหญ่ขึ้น (เช่น Oracle SGA) ประมวลผลข้อมูลในหน่วยความจำได้มากขึ้น และเพิ่มการทำงานพร้อมกันได้มากขึ้น อย่างไรก็ตาม ราคา DRAM ยังคงผันผวน และข้อจำกัดของห่วงโซ่อุปทานฮาร์ดแวร์อาจทำให้การอัปเกรดหน่วยความจำขนาดใหญ่มีราคาแพงเกินไป
เทคนิคดั้งเดิมที่ใช้ในแพลตฟอร์มต่างๆ เช่น VMware vSphere ซึ่งรวมถึงการบีบอัดหน่วยความจำ การแบ่งปันหน้าหน่วยความจำแบบโปร่งใส และการจัดสรรหน่วยความจำเกินความจำเป็น สามารถปรับปรุงการใช้งานให้ดีขึ้นได้ แต่ก็มีข้อจำกัดในตัวมันเอง เทคนิคเหล่านี้ไม่ได้เพิ่มปริมาณหน่วยความจำที่มีให้แก่ระบบโดยพื้นฐาน เพียงแต่ทำให้ DRAM ที่มีอยู่มีประสิทธิภาพมากขึ้นเท่านั้น เมื่อภาระงานต้องการหน่วยความจำที่ใช้งานได้มากกว่าที่มีอยู่จริง ประสิทธิภาพก็จะลดลงอย่างหลีกเลี่ยงไม่ได้
วิธีการทำงานของระบบจัดลำดับชั้นหน่วยความจำเสมือนของ Sangfor
Sangfor Virtualization นำเสนอการเปลี่ยนแปลงครั้งสำคัญด้วย เทคโนโลยี Memory Tiering เทคโนโลยีนี้สร้างกลุ่มหน่วยความจำแบบรวมศูนย์โดยการผสานรวม DRAM ความเร็วสูงเข้ากับ NVMe SSD ประสิทธิภาพสูง แนวคิดหลักคือการใช้ NVMe SSD เป็นส่วนขยายของหน่วยความจำระบบ ทำให้ความจุที่มีอยู่เพิ่มขึ้นเป็นสองเท่าโดยไม่ต้องเพิ่ม DRAM
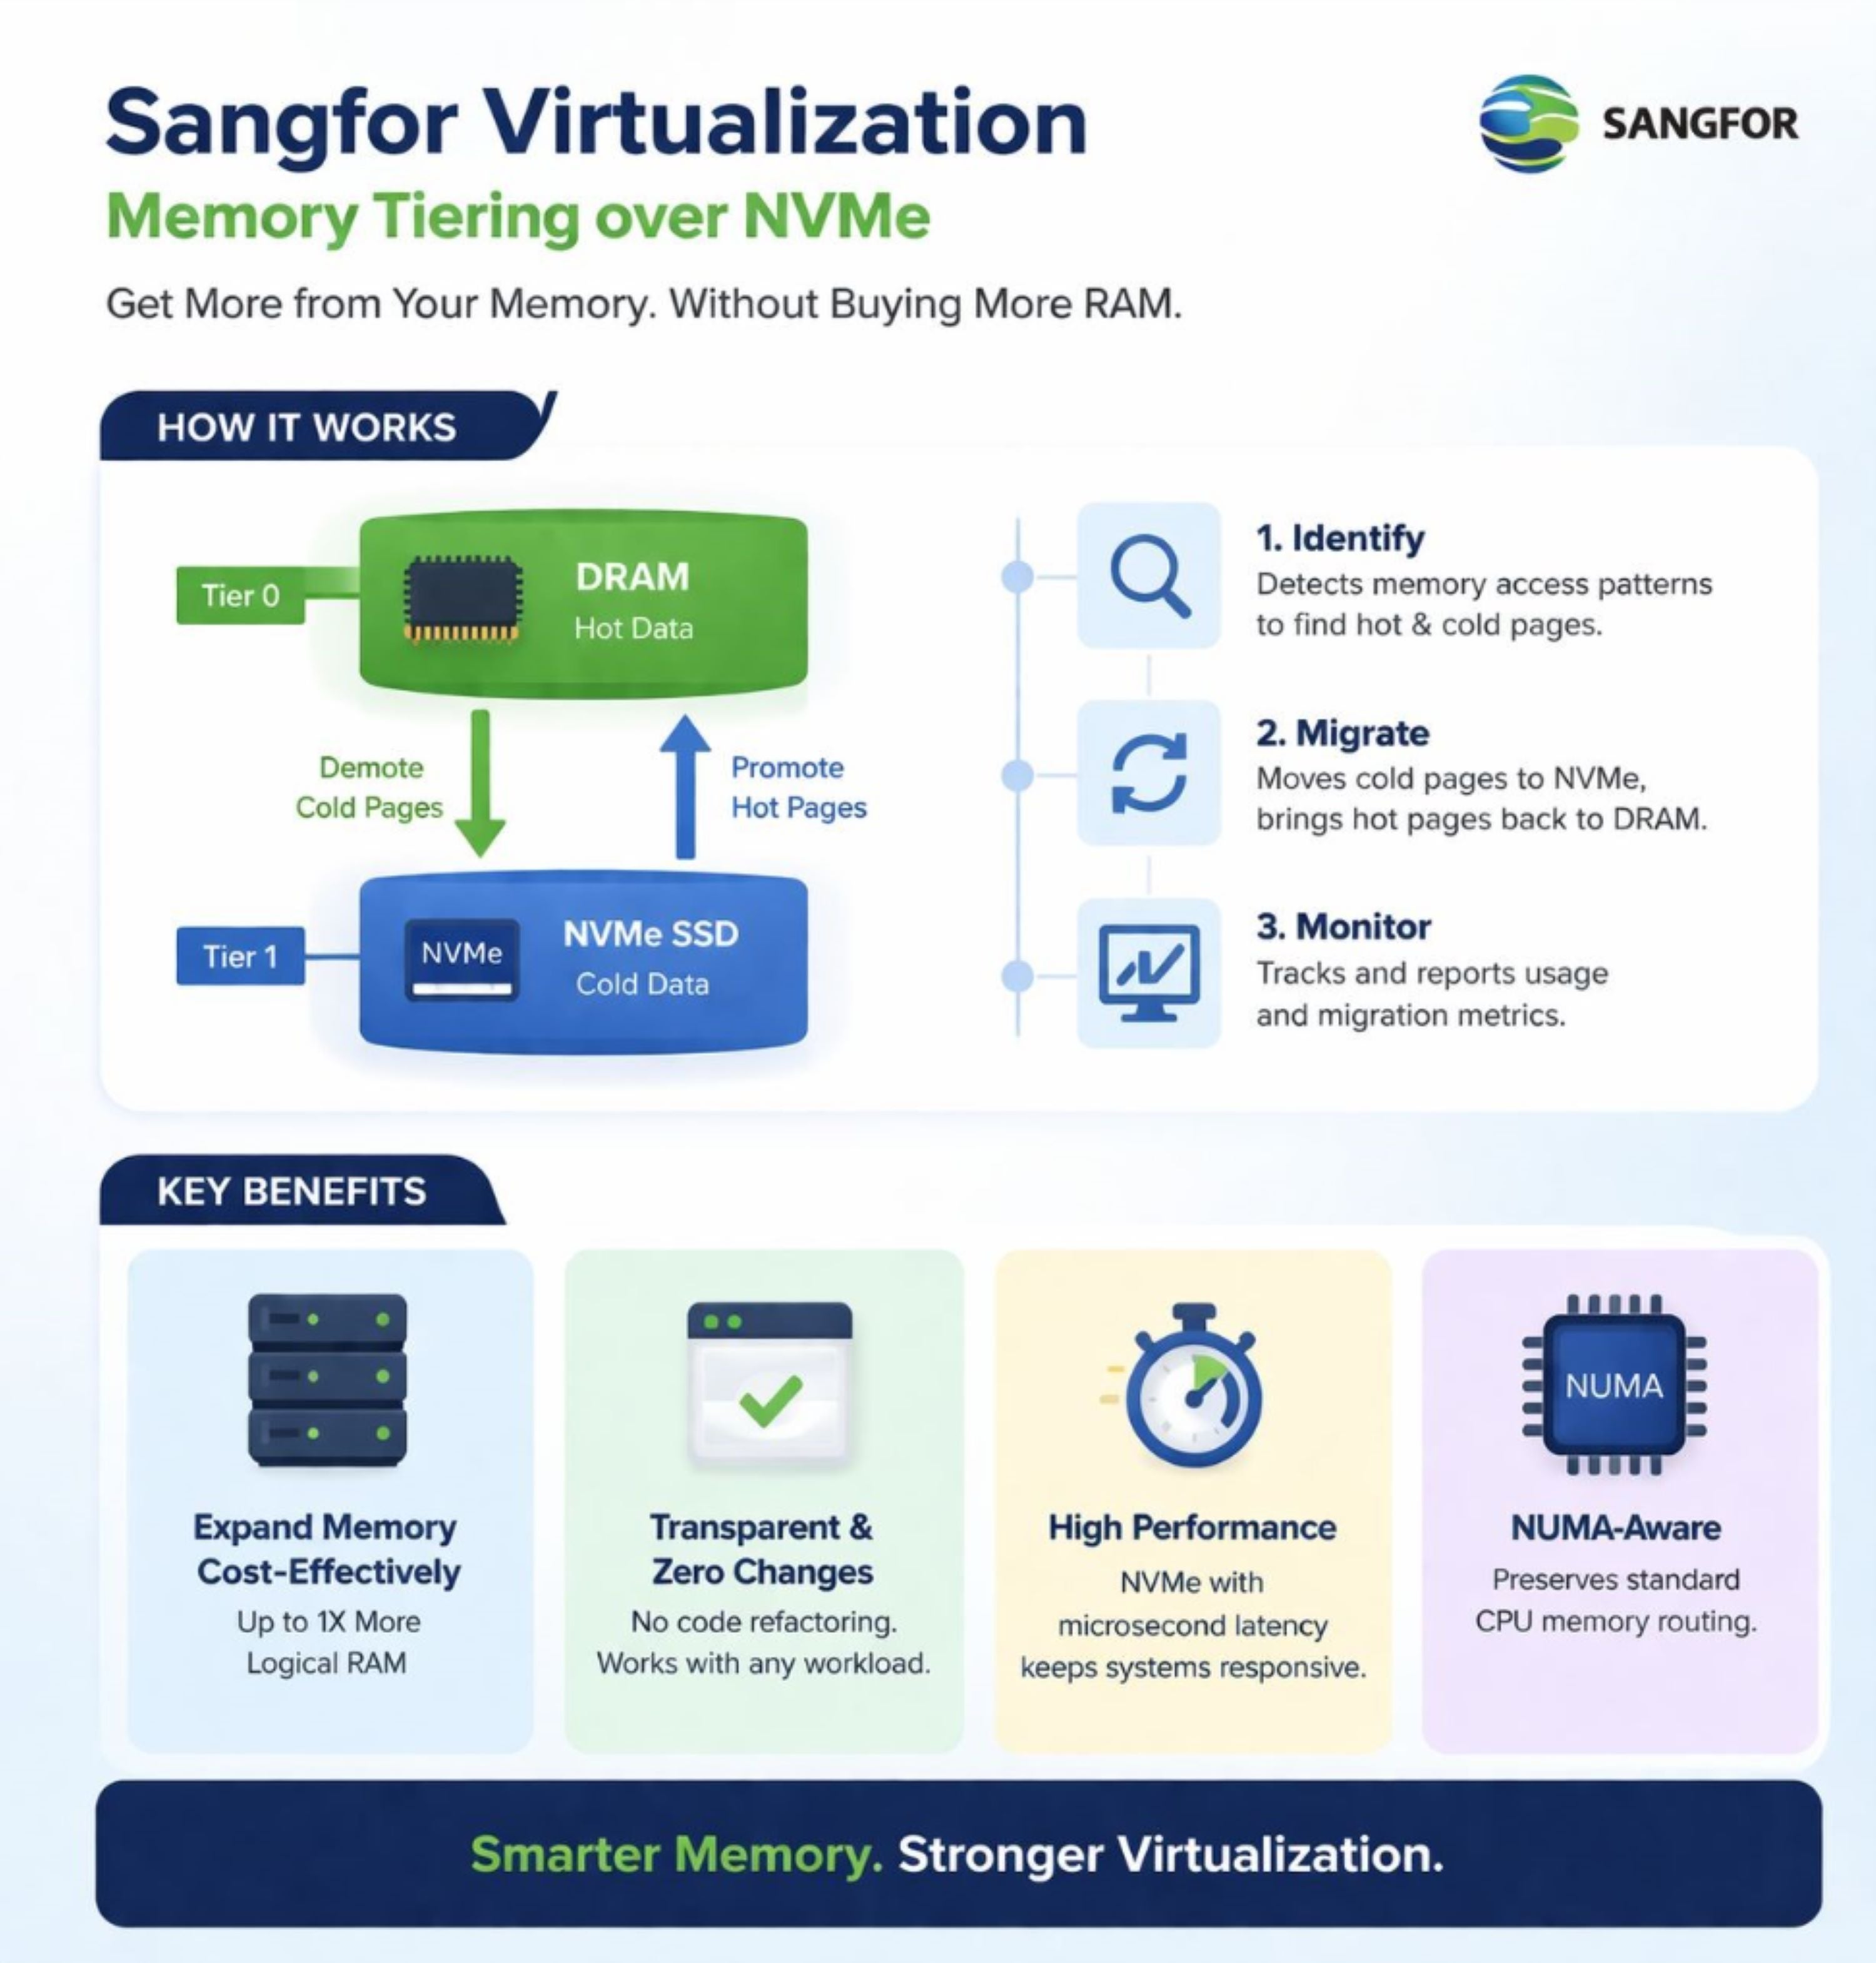
เคล็ดลับสำคัญอยู่ที่การจัดวางข้อมูลอย่างชาญฉลาด ด้วยการใช้กลไก การแบ่งพาร์ติชันแบบไดนามิกที่มีน้ำหนักเบาและการสุ่มตัวอย่างแบบเบาบาง Sangfor Virtualization จะตรวจสอบหน้าหน่วยความจำอย่างต่อเนื่องเพื่อแยกแยะระหว่างข้อมูล "ร้อน" (เข้าถึงบ่อย) และข้อมูล "เย็น" (เข้าถึงไม่บ่อย)
- ข้อมูลที่มีการใช้งานบ่อย เช่น ดัชนีฐานข้อมูลที่ใช้งานอยู่ บันทึกธุรกรรมที่สำคัญ หรือตารางที่มีการเรียกใช้งานบ่อย จะยังคงอยู่ในระดับ DRAM (ระดับ 0) เพื่อให้สามารถเข้าถึงได้ด้วยความหน่วงต่ำ
- ข้อมูลที่ไม่ค่อยได้ใช้งาน เช่น บันทึกประวัติ ข้อมูลที่เกี่ยวข้องกับการสำรองข้อมูล หรือหน่วยความจำของแอปพลิเคชันที่ไม่ได้ใช้งาน จะถูกย้ายไปยังระดับ NVMe (ระดับ 1) โดยอัตโนมัติ การย้ายข้อมูลนี้ดำเนินการอย่างโปร่งใส โดยไม่ต้องมีการแทรกแซงใดๆ จากระบบปฏิบัติการหรือแอปพลิเคชันของเครื่องเสมือน
การควบคุมการเข้าถึงและประสิทธิภาพของ CPU
เมื่อ CPU ร้องขอที่อยู่หน่วยความจำ ระบบจะตรวจสอบระดับ DRAM หากพบเพจ (hot hit) การเข้าถึงจะเกิดขึ้นทันที หากไม่พบ (cold miss) ระบบจะเรียกใช้ page fault แบบโปร่งใส ย้ายเพจที่ต้องการจาก NVMe กลับไปยัง DRAM อย่างรวดเร็ว แล้วจึงดำเนินการเข้าถึง CPU ให้เสร็จสมบูรณ์ จากมุมมองของแอปพลิเคชัน กระบวนการนี้แทบจะแยกไม่ออกจากการทำงานของหน่วยความจำมาตรฐาน
ที่สำคัญคือ NVMe ถูกมองว่าเป็นหน่วยความจำ ไม่ใช่เป็นอุปกรณ์สลับข้อมูล ตัวควบคุม NVMe ใช้ประโยชน์จากแบนด์วิดท์ PCIe ในการย้ายข้อมูลโดยมีการแทรกแซงจาก CPU น้อยที่สุด ด้วยไดรฟ์ NVMe PCIe 4.0/5.0 รุ่นใหม่ที่ให้ความหน่วงเวลาอยู่ในช่วง 10–100 ไมโครวินาที และแบนด์วิดท์สูงถึง 7 GB/s ทำให้ภาระการทำงานของการโปรโมตเพจเย็น (cold-page promotion) อยู่ในระดับต่ำมาก
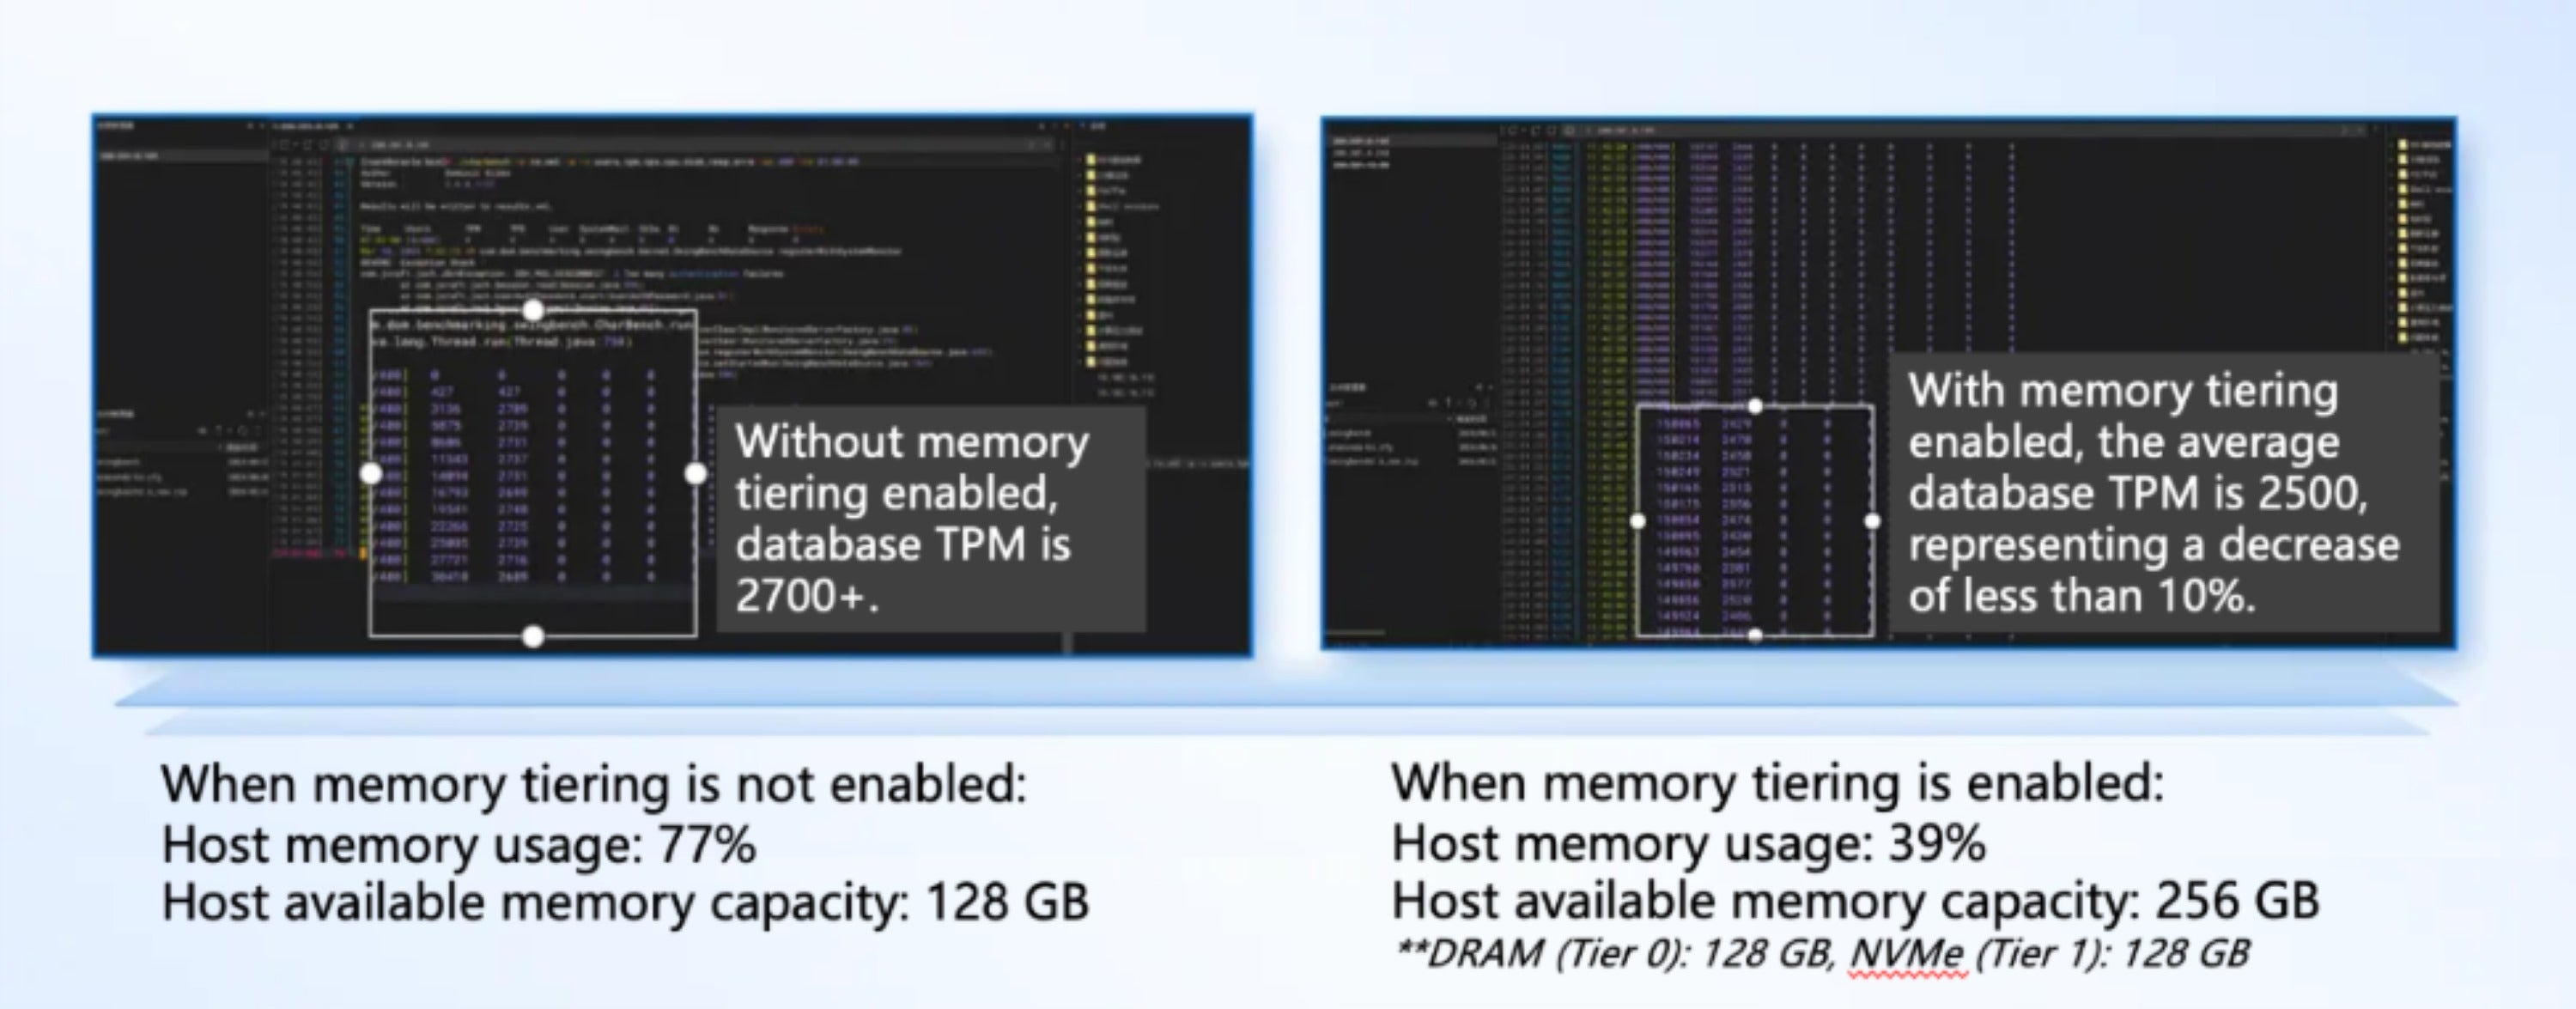
ในการทดสอบฐานข้อมูล Oracle ในโลกแห่งความเป็นจริง การเปิดใช้งานการจัดลำดับชั้นหน่วยความจำช่วยให้เซิร์ฟเวอร์ที่มี DRAM ทางกายภาพ 128 GB สามารถรองรับปริมาณงานที่ปกติแล้วต้องการ 256 GB ได้อย่างมีประสิทธิภาพ ส่งผลให้ TPM (จำนวนธุรกรรมต่อนาที) ลดลงเพียงประมาณ 10% ซึ่งเป็นการแลกเปลี่ยนที่ไม่มากนักเมื่อเทียบกับการเพิ่มความจุหน่วยความจำที่ใช้งานได้ถึงสองเท่า
ความยืดหยุ่นในการใช้งานและแนวปฏิบัติที่ดีที่สุด
ไม่ใช่ทุกภาระงานที่จะเหมาะกับการจัดลำดับชั้นหน่วยความจำ วิธีการนี้เหมาะที่สุดสำหรับสถานการณ์ที่มีรูปแบบข้อมูลร้อน/เย็นที่แตกต่างกันอย่างชัดเจน เช่น:
- การจำลองเดสก์ท็อปเสมือน (VDI)
- สภาพแวดล้อมการพัฒนาและการทดสอบ
- บริการแคชที่ไม่สำคัญ
- กลุ่มไมโครเซอร์วิสขนาดปานกลาง
สำหรับความต้องการความหน่วงต่ำมาก สามารถปิดใช้งานการจัดลำดับชั้นหน่วยความจำได้แบบเลือกเฉพาะต่อ VM:
- ระบบการซื้อขายความถี่สูง
- ฐานข้อมูล OLTP ที่ไวต่อความหน่วงแฝงพร้อมรูปแบบการเข้าถึงที่สม่ำเสมอ
- การวิเคราะห์ข้อมูลแบบเรียลไทม์ พร้อมข้อกำหนด SLA ที่เข้มงวด
Sangfor แนะนำอัตราส่วนความจุ DRAM ต่อระดับชั้นที่ 1:1 เพื่อให้ได้ความสมดุลที่เหมาะสมที่สุด ซึ่งจะให้หน่วยความจำที่มีประสิทธิภาพเพิ่มขึ้นเป็นสองเท่าโดยมีผลกระทบต่อประสิทธิภาพน้อยที่สุด
บทสรุป
การย้ายจาก VMware vSphere ไปยัง Sangfor Virtualization ไม่ใช่แค่การเปลี่ยนระบบในระดับเดียวกันเท่านั้น แต่ยังเป็นโอกาสในการปรับโครงสร้างเลเยอร์เวอร์ชวลไลเซชันใหม่เพื่อให้ได้ประสิทธิภาพที่สูงขึ้นและประสิทธิผลที่มากขึ้น สำหรับเวิร์กโหลดที่ใช้ฐานข้อมูลและ I/O อย่างหนัก เทคโนโลยีทั้งสองที่กล่าวถึง ได้แก่ Adaptive NUMA Scheduling และ Memory Tiering จะช่วยแก้ไขข้อจำกัดที่สำคัญที่สุดของโครงสร้างพื้นฐานสมัยใหม่โดยตรง นั่นคือ ความหน่วงในการเข้าถึงหน่วยความจำและความจุของหน่วยความจำ
การจัดตารางเวลา NUMA แบบปรับได้ช่วยให้ฐานข้อมูล แคชในหน่วยความจำ และมิดเดิลแวร์ของคุณทำงานด้วยการเข้าถึงหน่วยความจำภายในเครื่องที่คาดการณ์ได้และมีความหน่วงต่ำ โดยปรับให้เข้ากับการเปลี่ยนแปลงของปริมาณงานโดยอัตโนมัติโดยไม่จำเป็นต้องมีการแทรกแซงด้วยตนเอง ในทางกลับกัน การจัดลำดับชั้นหน่วยความจำ (Memory Tiering) นำเสนอแนวทางที่เป็นไปได้ในการขยายความจุของหน่วยความจำโดยไม่ต้องเสียค่าใช้จ่ายสูงของ DRAM ช่วยให้คุณสามารถรวมปริมาณงานจำนวนมากขึ้นต่อเซิร์ฟเวอร์ในขณะที่ยังคงรักษาประสิทธิภาพให้อยู่ในขอบเขตที่ยอมรับได้
ด้วยนวัตกรรมเหล่านี้ Sangfor Virtualization จึงนำเสนอแพลตฟอร์มที่ไม่เพียงแต่ตรงตามความคาดหวังด้านประสิทธิภาพที่กำหนดโดย VMware vSphere เท่านั้น แต่ยังเหนือกว่าในหลายกรณี โดยเฉพาะอย่างยิ่งในสถานการณ์ที่ต้องการประสิทธิภาพสูงซึ่งเป็นลักษณะเฉพาะของระบบธุรกิจหลักสมัยใหม่ ในขณะที่คุณกำลังดำเนินการเปลี่ยนระบบจาก VMware ไปสู่ระบบอื่น โปรดมั่นใจได้ว่าแอปพลิเคชันที่สำคัญที่สุดของคุณอยู่ในมือของผู้เชี่ยวชาญ
หากองค์กรของคุณกำลังเผชิญกับความท้าทายที่คล้ายคลึงกัน เราขอเชิญคุณ ติดต่อเรา เราพร้อมที่จะทำการประเมินร่วมกันและพัฒนากลยุทธ์การเปลี่ยนผ่านที่ปรับแต่งให้เหมาะสมกับสภาพแวดล้อมของคุณอย่างแม่นยำ

