
Introducción
A medida que las organizaciones aceleran sus iniciativas de reemplazo de VMware, surge una pregunta recurrente: ¿Mi base de datos y las cargas de trabajo con uso intensivo de E/S tendrán el mismo rendimiento, o incluso mejor, en la nueva plataforma de virtualización? Durante años, VMware vSphere ha sido el referente para la ejecución de aplicaciones de misión crítica, y cualquier migración genera inquietudes sobre la consistencia del rendimiento, los picos de latencia y la eficiencia de los recursos.
Sangfor Virtualization (HCI) no es simplemente un reemplazo directo. Está diseñado para satisfacer los requisitos de rendimiento más exigentes de los sistemas empresariales centrales. Mediante la optimización profunda de la arquitectura subyacente, en particular en lo que respecta a la planificación de acceso a memoria no uniforme (NUMA) y la expansión de la capacidad de memoria, Sangfor Virtualization garantiza que las bases de datos, las cachés en memoria y otras cargas de trabajo sensibles a las E/S no solo mantengan, sino que a menudo superen sus niveles de rendimiento anteriores.
En esta publicación, analizaremos dos tecnologías clave que lo hacen posible: la programación NUMA adaptativa y la estratificación de memoria . Basándonos en datos de pruebas validados y conocimientos arquitectónicos, exploraremos cómo estas características abordan los principales cuellos de botella de rendimiento en los entornos de servidores modernos.
Parte 1: Cómo superar la latencia de acceso a la memoria con la planificación NUMA adaptativa
El desafío NUMA en entornos virtualizados
Los servidores empresariales modernos se basan en la arquitectura NUMA para superar las limitaciones del procesamiento simétrico multiprocesador (SMP) tradicional. En un sistema NUMA, los núcleos del procesador y la memoria se dividen en nodos. Cada nodo tiene su propia memoria local, y si bien el acceso a la memoria local es rápido, el acceso a la memoria de un nodo remoto genera una latencia significativa. Los accesos a la memoria local tardan entre 70 y 90 ns ; los accesos remotos suelen ser entre 1,5 y 2 veces más lentos y pueden degradarse aún más con la contención.
En un entorno virtualizado, cada máquina virtual (VM) se representa como un conjunto de subprocesos de vCPU. Si estos subprocesos se ejecutan en diferentes nodos NUMA o si migran entre nodos, la VM experimentará accesos a memoria remota, lo que provocará una latencia impredecible y una reducción del rendimiento. Esto resulta especialmente perjudicial para sistemas de bases de datos como Oracle, DM8 y PostgreSQL, así como para almacenes de datos en memoria como Redis.
Enfoque de VMware vSphere: vSphere 6.0 y versiones posteriores incluyen un planificador NUMA automático que gestiona eficazmente la mayoría de las cargas de trabajo generales. Ofrece funciones como la exposición de vNUMA y el equilibrio de carga entre nodos. Sin embargo, para cargas de trabajo altamente especializadas con uso intensivo de E/S, es posible que los administradores deban ajustar la configuración de afinidad de la CPU o modificar parámetros avanzados para lograr un rendimiento óptimo.
Programación NUMA adaptativa de Sangfor Virtualization
Sangfor Virtualization adopta un enfoque fundamentalmente diferente. En lugar de depender de la intervención manual, implementa un motor de planificación NUMA totalmente adaptativo que opera de forma automática y dinámica. El planificador analiza continuamente el número de vCPU de cada máquina virtual y la carga en tiempo real de los nodos NUMA físicos, y luego toma decisiones de ubicación óptimas. Como se ilustra en la figura, el sistema selecciona automáticamente el nodo NUMA adecuado para cada máquina virtual. Cuando el número de vCPU de una máquina virtual es menor que el número de núcleos de un nodo NUMA, la máquina virtual se planifica en un único nodo NUMA. Cuando el número de vCPU supera el número de núcleos de un nodo NUMA, la máquina virtual se planifica en varios nodos NUMA y la topología vNUMA se expone al sistema operativo invitado, lo que permite a la máquina virtual tomar decisiones óptimas internamente.
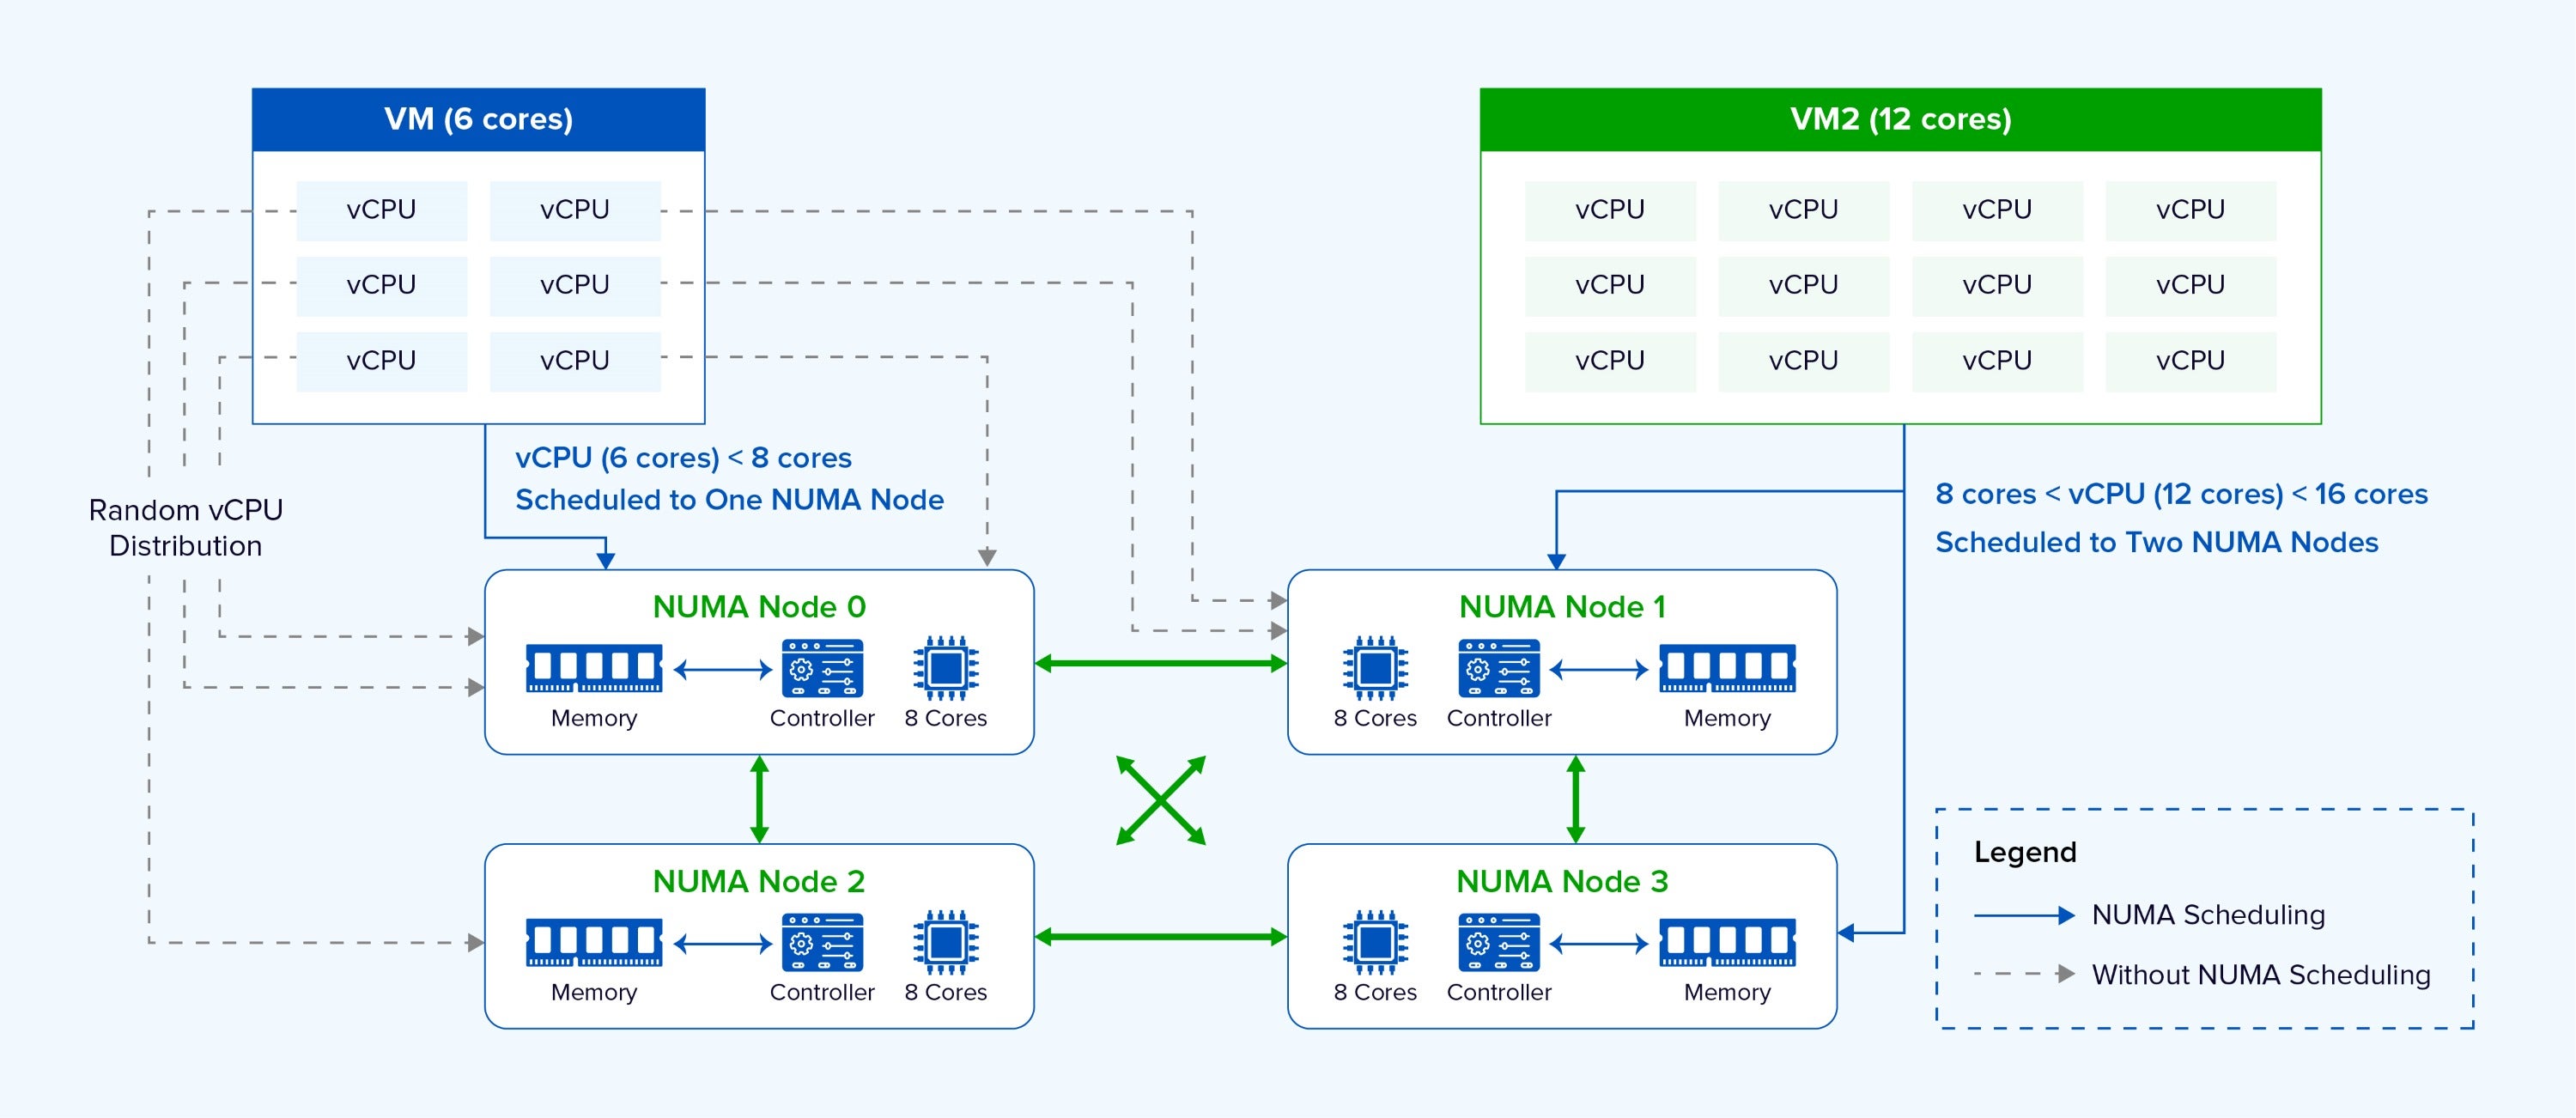
- Consolidación de vCPU: Cuando el número de vCPU de una máquina virtual es menor o igual al número de núcleos de un único nodo NUMA físico, Sangfor Virtualization ubica todas sus vCPU y memoria dentro de ese mismo nodo. Esto garantiza un acceso local del 100 % a la memoria para esa máquina virtual, eliminando la latencia entre nodos.
- Distribución inteligente para máquinas virtuales grandes: Para máquinas virtuales con más vCPU de las que puede soportar un solo nodo, el planificador las distribuye entre varios nodos NUMA. Fundamentalmente, también expone la topología NUMA virtual (vNUMA) al sistema operativo invitado. Esto permite que el sistema operativo dentro de la máquina virtual tome decisiones de planificación informadas, optimizando aún más la localidad de la memoria.
- Balanceo de carga entre nodos: El planificador supervisa la carga de los nodos NUMA y puede migrar máquinas virtuales entre nodos cuando sea necesario para evitar la contención de recursos. También identifica las máquinas virtuales "importantes" (como las que ejecutan bases de datos críticas) y prioriza su ubicación en nodos con menor carga para garantizar un rendimiento estable.
Más allá de la vCPU: Afinidad NUMA de almacenamiento y red
Lo que distingue a Sangfor Virtualization es que sus optimizaciones NUMA van mucho más allá de la planificación de la CPU. Una ruta de E/S completa —desde la vCPU, pasando por el proceso QEMU y el servicio de almacenamiento aSAN, hasta el proceso de reenvío de datos de red— puede asignarse de forma inteligente al mismo nodo NUMA. Este enfoque integral elimina el acceso remoto a la memoria en toda la pila de E/S, reduciendo drásticamente la sobrecarga de procesamiento.
En combinación con páginas de memoria grandes (páginas enormes), esta optimización beneficia directamente a las aplicaciones de bases de datos y de almacenamiento intensivo. Por ejemplo, cuando una base de datos realiza una operación de escritura, todo el flujo de trabajo permanece dentro del mismo dominio NUMA, lo que minimiza la latencia y maximiza el rendimiento.
Nota: La optimización de afinidad NUMA se aplica dentro de cada host individual. El acceso al almacenamiento entre hosts en configuraciones distribuidas (como aSAN) seguirá generando latencia de red, como es de esperar en cualquier arquitectura distribuida.
Validación del rendimiento
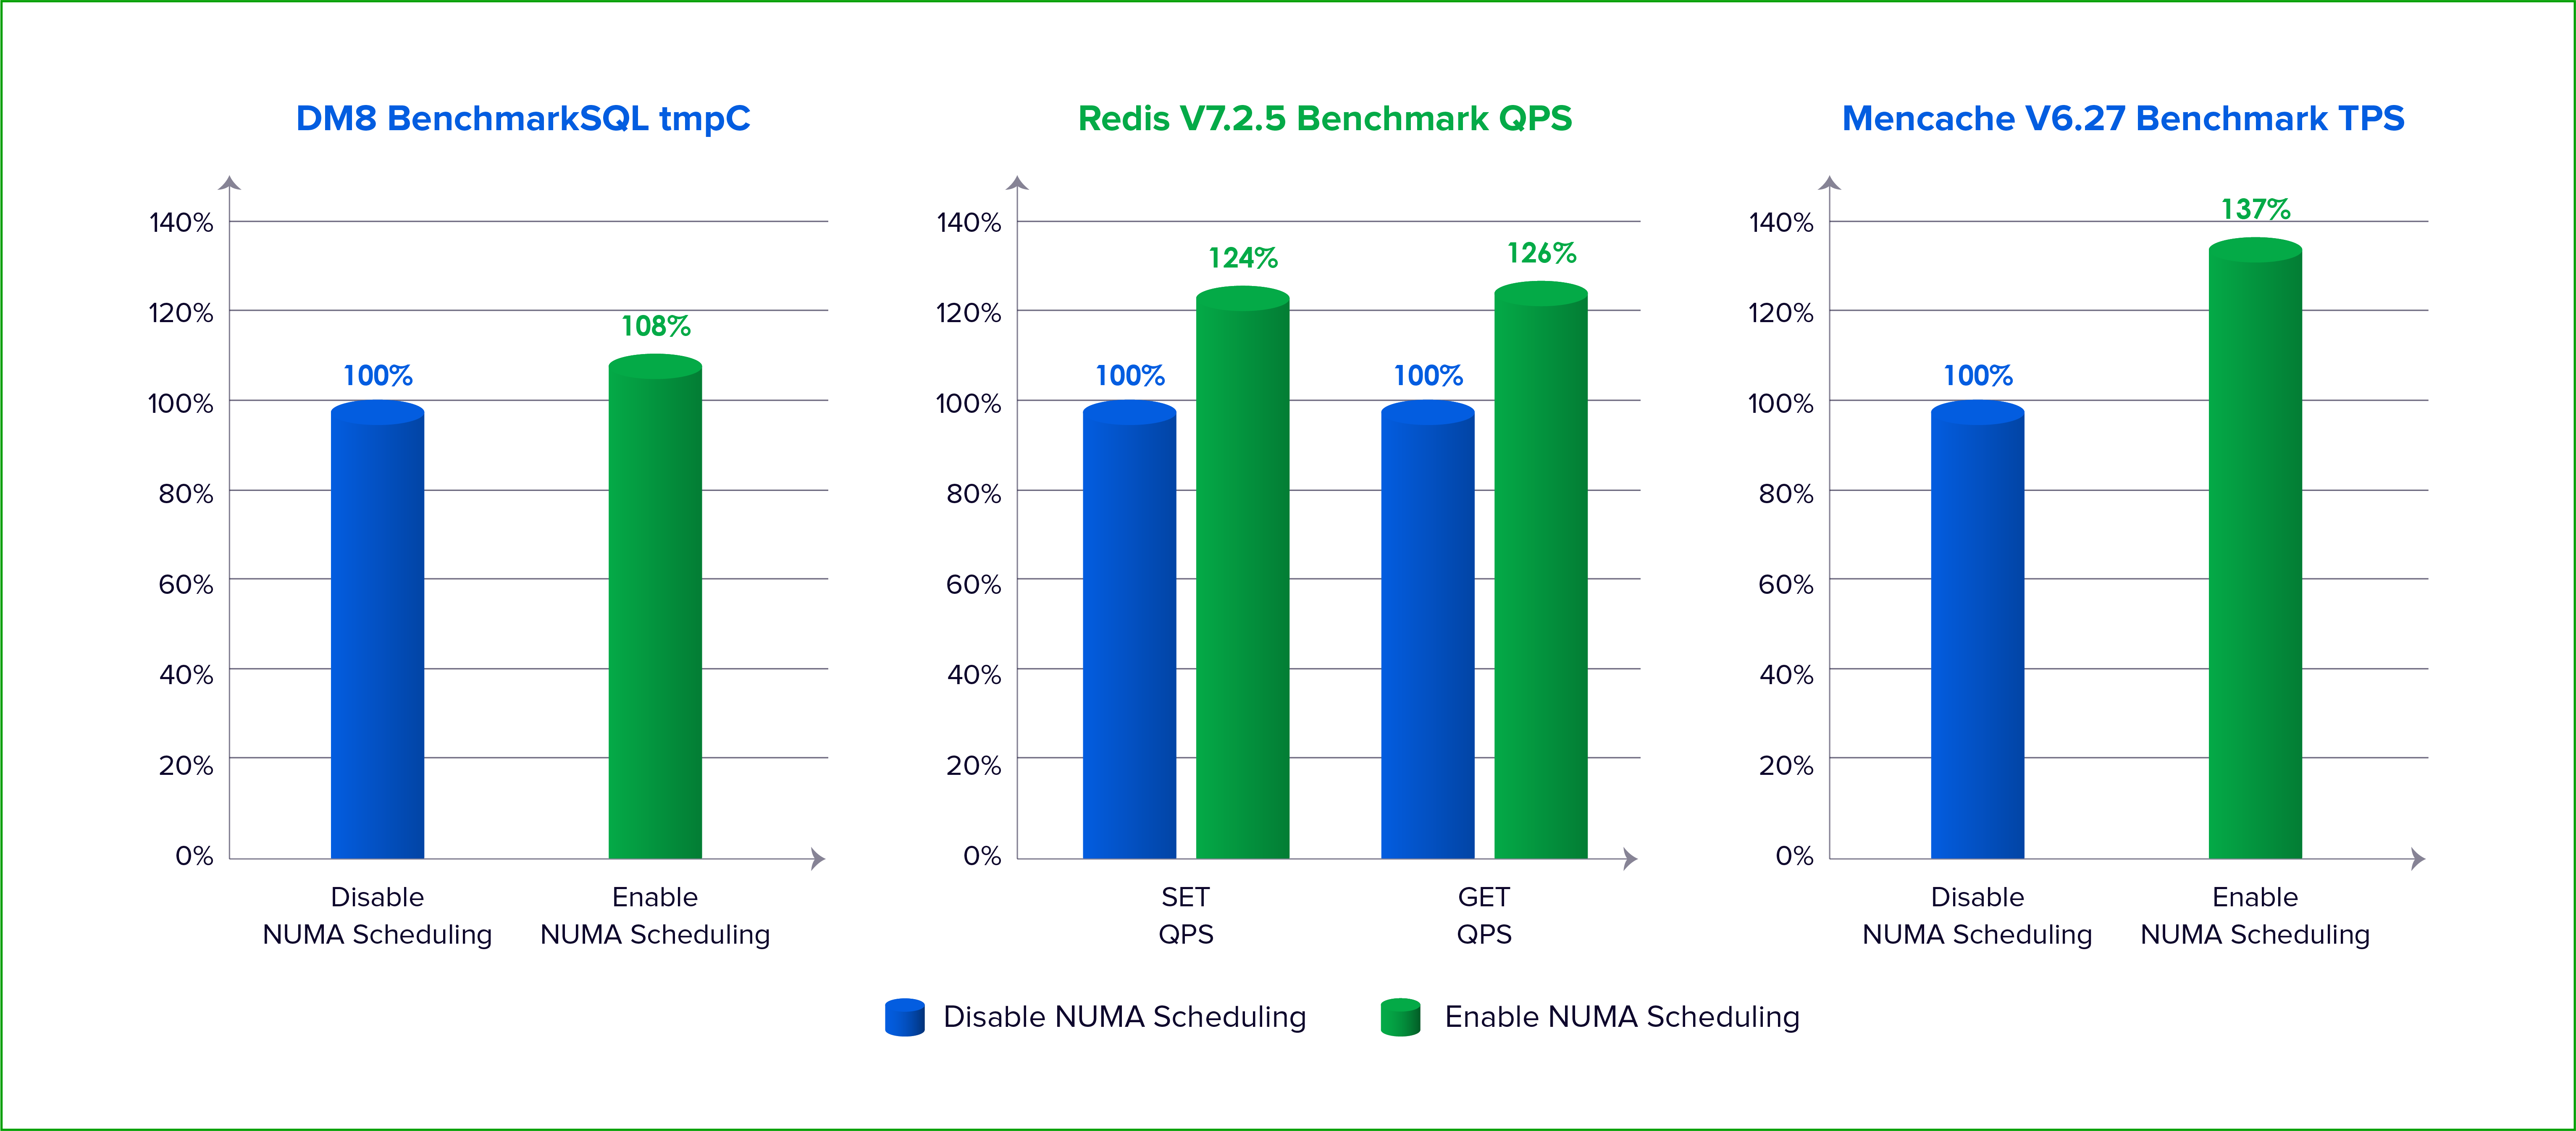
La eficacia de estas optimizaciones se valida mediante pruebas rigurosas. En una prueba comparativa realizada con DM8 (una base de datos líder en el mercado nacional) y la herramienta estándar BenchmarkSQL (modelo TPC-C), la activación de la planificación NUMA de Sangfor Virtualization dio como resultado un aumento sustancial en tpmC en comparación con una configuración en la que la planificación NUMA estaba desactivada.
De forma similar, en las pruebas de rendimiento de Redis realizadas con redis-benchmark para operaciones SET/GET, las consultas por segundo (QPS) mejoraron notablemente cuando la planificación NUMA estaba activa. Las pruebas de Memcache con memaslap también mostraron un mayor número de transacciones por segundo (TPS). Estos resultados demuestran que, para cargas de trabajo sensibles al acceso a la memoria —precisamente las aplicaciones más propensas a verse afectadas por una configuración NUMA deficiente—, Sangfor Virtualization ofrece mejoras de rendimiento tangibles.
Parte 2: Superando la barrera de la capacidad de memoria con la estratificación de memoria.
El dilema del coste de la memoria
Para bases de datos y aplicaciones con uso intensivo de E/S, la capacidad de memoria suele ser el recurso más crítico. Mayores grupos de memoria permiten cachés de búfer más grandes (como Oracle SGA), un mayor procesamiento de datos en memoria y una mayor concurrencia. Sin embargo, los precios de la DRAM siguen siendo volátiles y las limitaciones en la cadena de suministro de hardware pueden encarecer excesivamente las actualizaciones de memoria a gran escala.
Las técnicas tradicionales utilizadas en plataformas como VMware vSphere —que incluyen la compresión de memoria, el uso compartido transparente de páginas y la sobreasignación de memoria— pueden mejorar la utilización, pero tienen limitaciones inherentes. No aumentan fundamentalmente la cantidad de memoria disponible para el sistema; simplemente hacen que la DRAM existente sea más eficiente. Cuando las cargas de trabajo requieren más memoria activa de la físicamente disponible, el rendimiento se degrada inevitablemente.
Cómo funciona la estratificación de memoria de virtualización de Sangfor
Sangfor Virtualization introduce un cambio de paradigma mediante la estratificación de memoria . Esta tecnología crea un conjunto de memoria unificado al combinar DRAM rápida con SSD NVMe de alto rendimiento. La idea principal es utilizar el SSD NVMe como una extensión de la memoria del sistema, duplicando así la capacidad disponible sin necesidad de añadir DRAM.
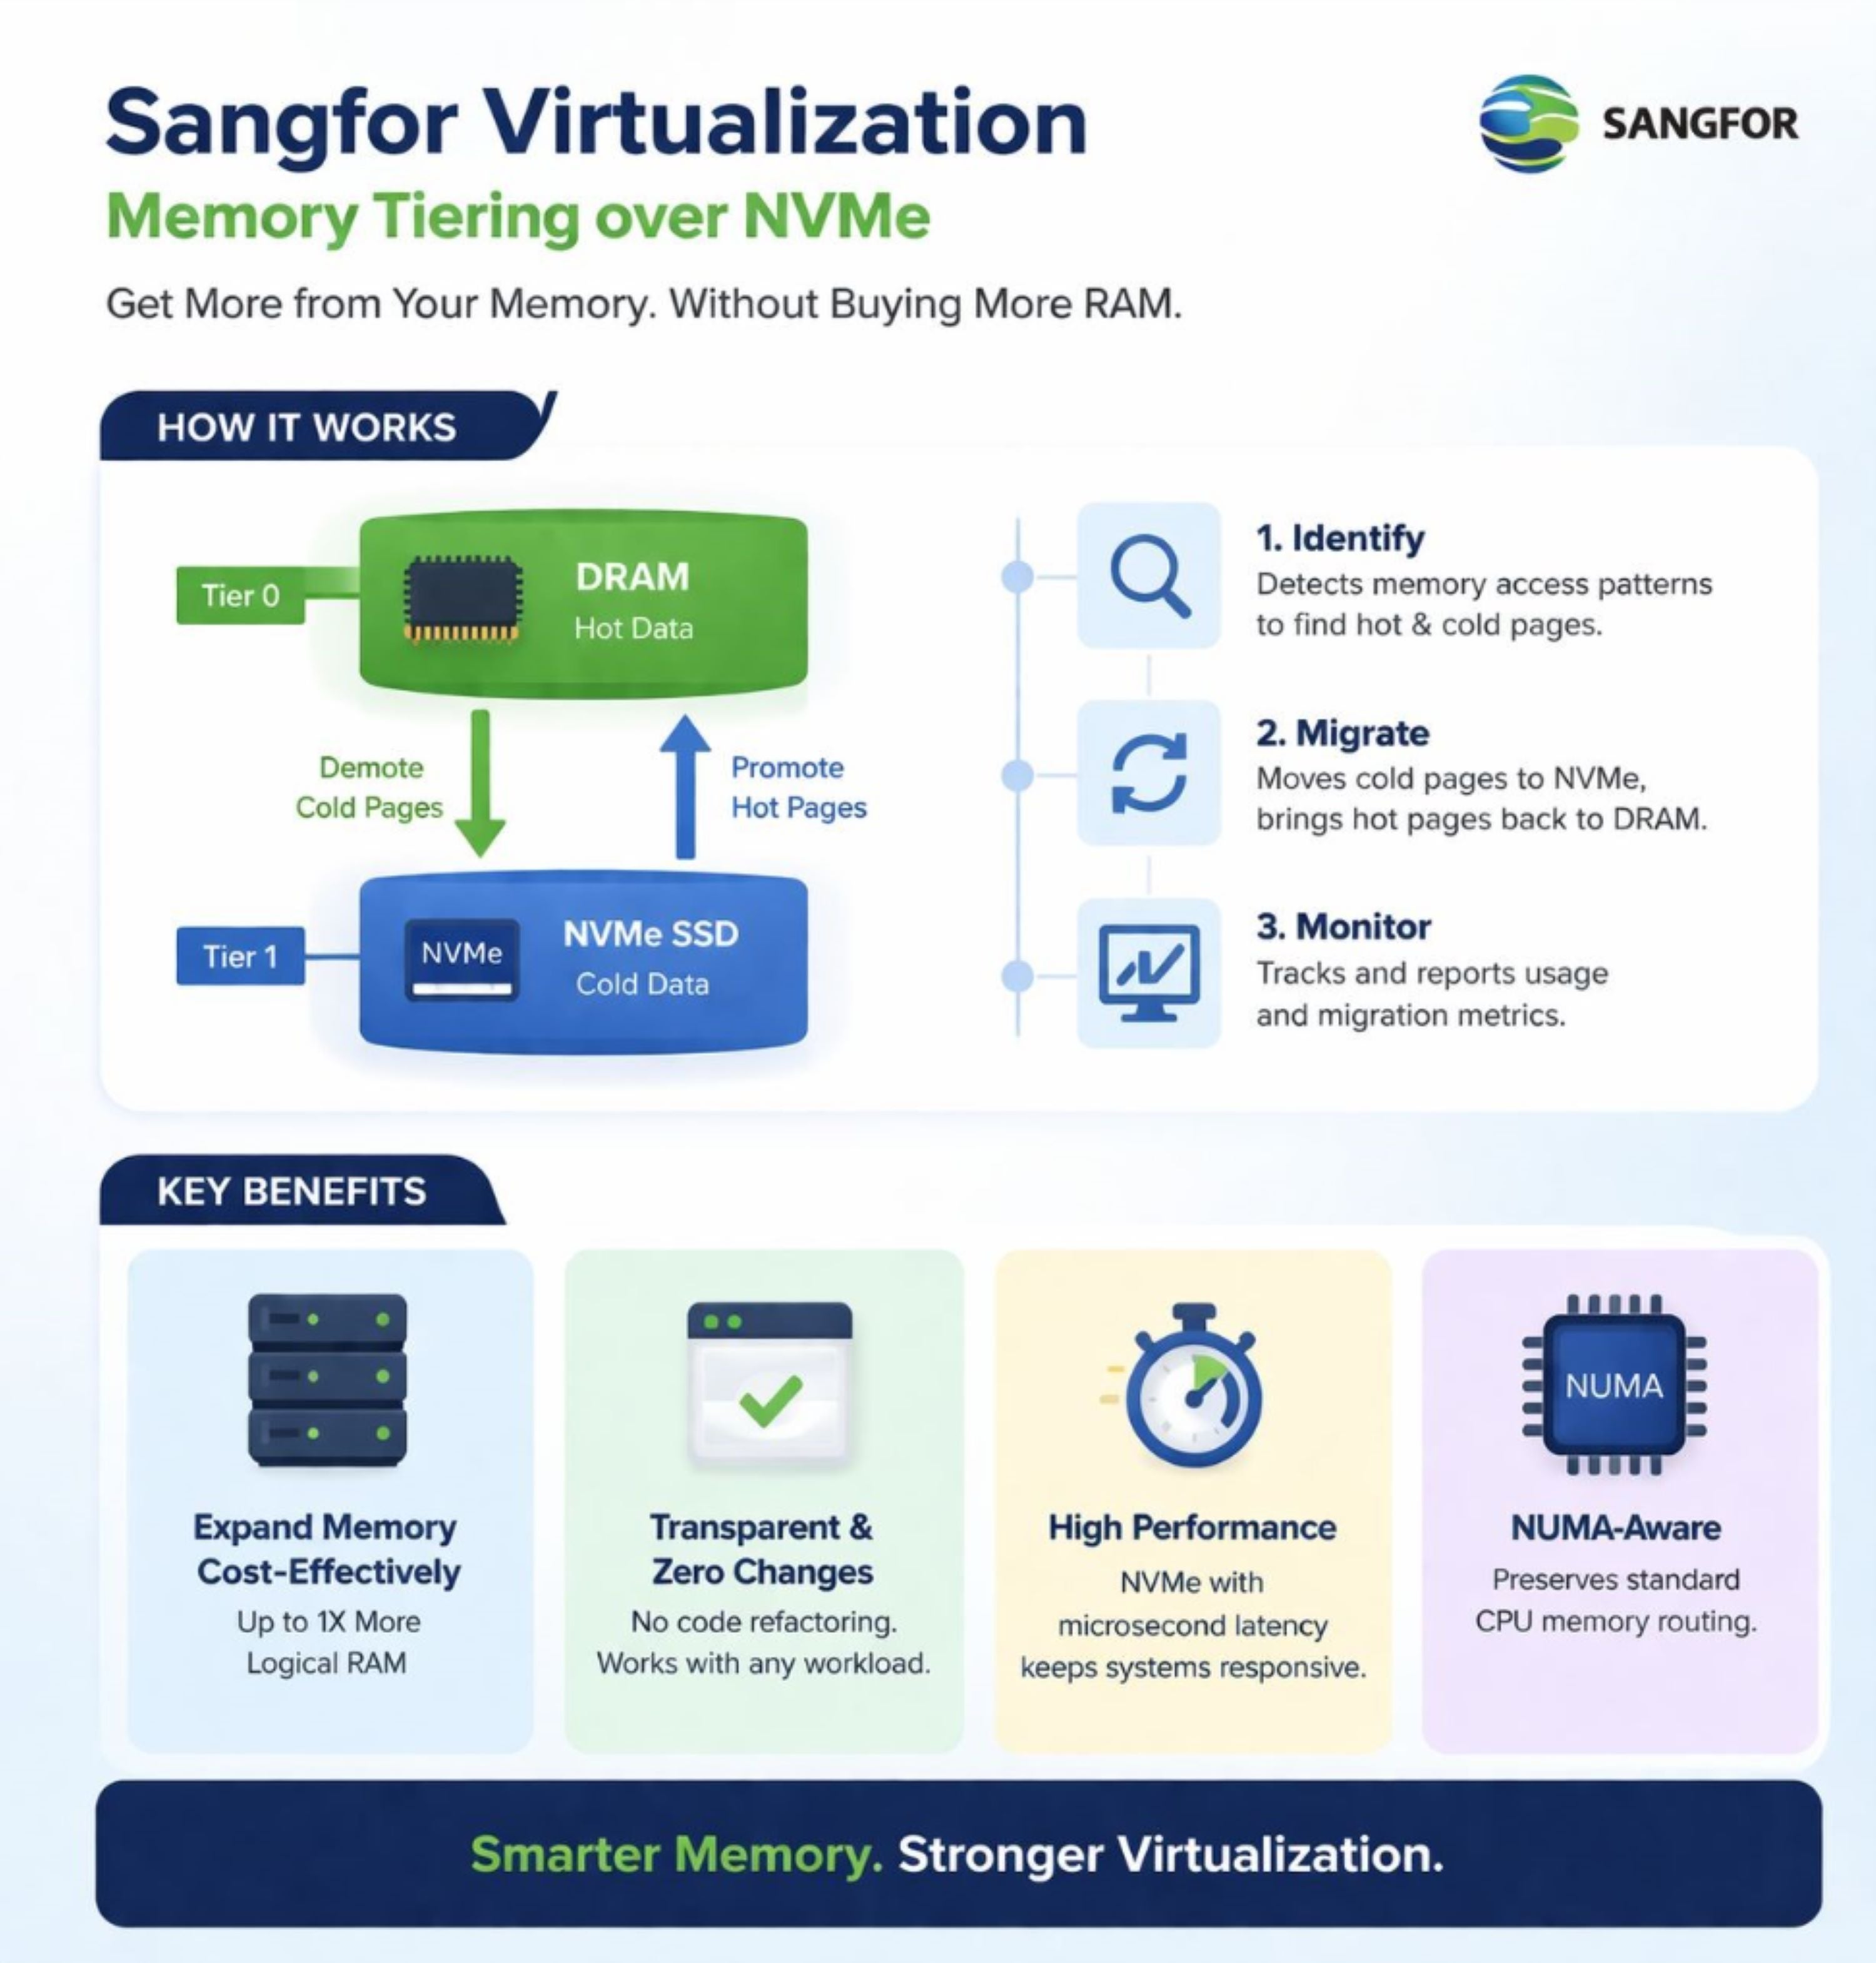
La clave reside en la ubicación inteligente de los datos. Mediante un mecanismo ligero de partición dinámica de regiones y muestreo aleatorio disperso , Sangfor Virtualization supervisa continuamente las páginas de memoria para distinguir entre datos "calientes" (de acceso frecuente) y datos "fríos" (de acceso poco frecuente).
- Los datos de acceso frecuente , como los índices de bases de datos activos, los registros de transacciones críticos o las tablas que se consultan con frecuencia, permanecen en la capa DRAM (Nivel 0) para un acceso de baja latencia.
- Los datos inactivos —como registros históricos, páginas relacionadas con copias de seguridad o memoria de aplicaciones en reposo— se transfieren automáticamente a la capa NVMe (Nivel 1). Esta migración se realiza de forma transparente, sin ninguna intervención del sistema operativo invitado ni de la aplicación.
Control del flujo de acceso a la CPU y del rendimiento
Cuando la CPU solicita una dirección de memoria, el sistema comprueba la capa DRAM. Si encuentra la página (acceso en caliente), el acceso es inmediato. Si no la encuentra (fallo en frío), el sistema activa un fallo de página transparente, transfiere rápidamente la página requerida de NVMe a DRAM y, a continuación, completa el acceso de la CPU. Desde la perspectiva de la aplicación, el proceso es indistinguible de una operación de memoria estándar.
Fundamentalmente, la capa NVMe se trata como memoria, no como un dispositivo de intercambio. El controlador NVMe aprovecha el ancho de banda PCIe para transferir datos con una mínima intervención de la CPU. Gracias a las modernas unidades NVMe PCIe 4.0/5.0, que ofrecen una latencia de entre 10 y 100 µs y un ancho de banda de hasta 7 GB/s, la sobrecarga de la promoción de páginas frías se mantiene extremadamente baja.
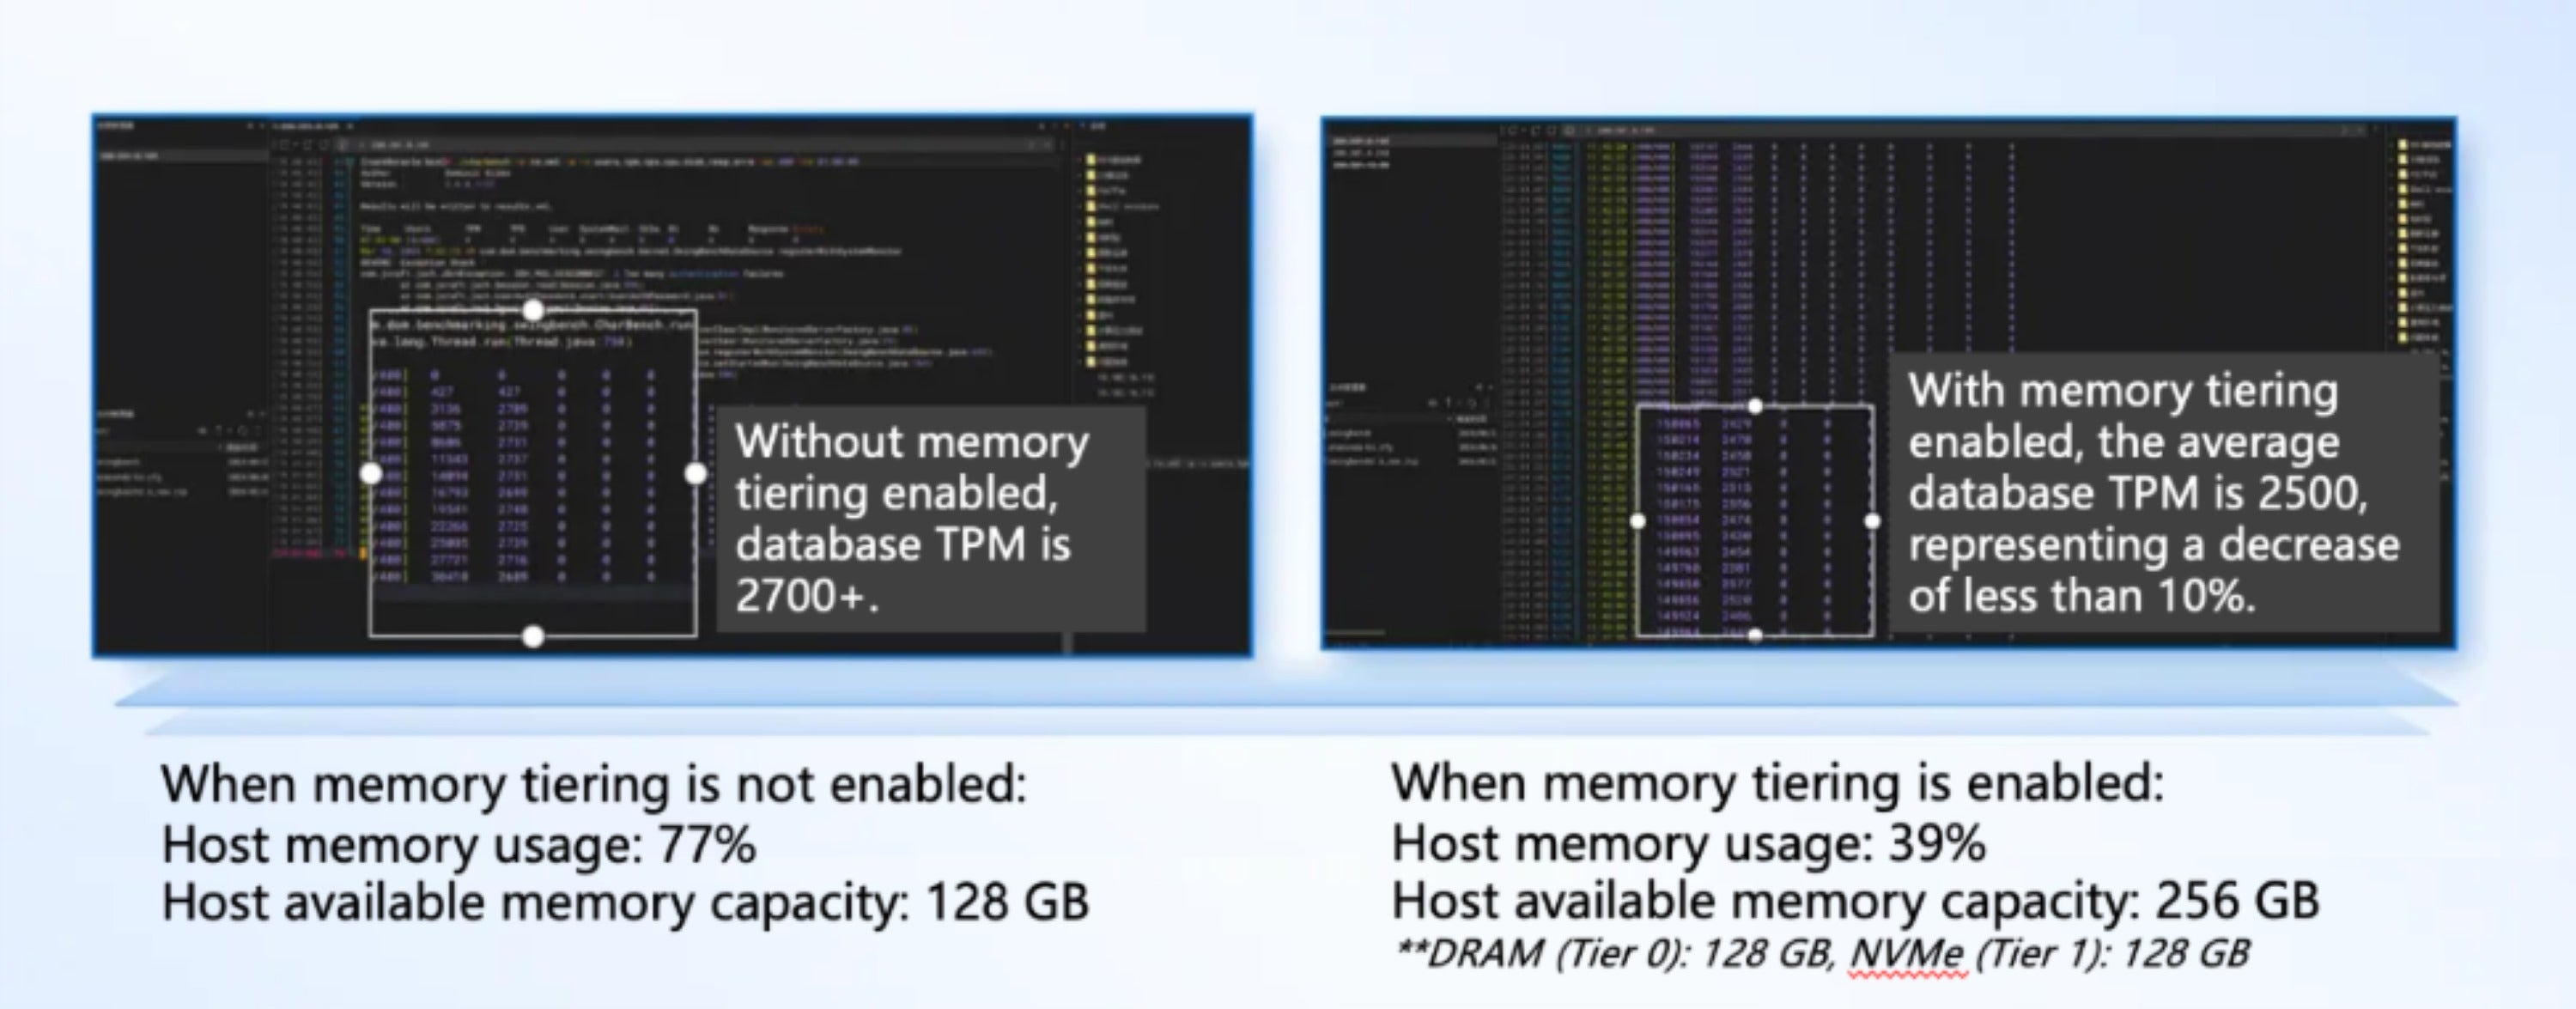
En pruebas reales con bases de datos Oracle, la activación de la estratificación de memoria permitió que un servidor con 128 GB de DRAM física soportara eficazmente una carga de trabajo que normalmente requeriría 256 GB. El TPM (transacciones por minuto) resultante disminuyó solo un 10 % , una compensación modesta por duplicar la capacidad de memoria utilizable.
Flexibilidad de implementación y mejores prácticas
No todas las cargas de trabajo son candidatas ideales para la estratificación de memoria. Es más adecuada para escenarios con patrones de datos calientes/fríos bien definidos, como por ejemplo:
- Virtualización de escritorio (VDI)
- Entornos de desarrollo y prueba
- Servicios de almacenamiento en caché no críticos
- clústeres de microservicios moderados
Para requisitos de latencia ultrabaja, la estratificación de memoria se puede deshabilitar selectivamente para cada máquina virtual:
- Sistemas de negociación de alta frecuencia
- Bases de datos OLTP sensibles a la latencia con patrones de acceso uniformes
- Análisis en tiempo real con estrictos requisitos de SLA.
Sangfor recomienda una relación de capacidad de DRAM a nivelación de 1:1 para lograr un equilibrio óptimo, ofreciendo el doble de memoria efectiva con un impacto mínimo en el rendimiento.
Conclusión
Migrar de VMware vSphere a Sangfor Virtualization no es un simple cambio de arquitectura; es una oportunidad para rediseñar la capa de virtualización y lograr un mayor rendimiento y eficiencia. Para cargas de trabajo con alta intensidad de E/S y bases de datos, las dos tecnologías analizadas —la programación NUMA adaptativa y la gestión de memoria por niveles— abordan directamente las limitaciones más críticas de la infraestructura moderna: la latencia de acceso a la memoria y la capacidad de memoria.
La programación NUMA adaptativa garantiza que sus bases de datos, cachés en memoria y middleware se ejecuten con un acceso predecible y de baja latencia a la memoria local, adaptándose automáticamente a la dinámica de la carga de trabajo sin necesidad de intervención manual. Por otro lado, la estratificación de memoria ofrece una solución práctica para escalar la capacidad de memoria sin el coste prohibitivo de la DRAM, lo que le permite consolidar más cargas de trabajo por servidor manteniendo el rendimiento dentro de límites aceptables.
Con estas innovaciones, Sangfor Virtualization ofrece una plataforma que no solo cumple con las expectativas de rendimiento de VMware vSphere, sino que a menudo las supera, especialmente en los escenarios exigentes que caracterizan a los sistemas empresariales centrales modernos. Al iniciar el proceso de sustitución de VMware, tenga la seguridad de que sus aplicaciones más críticas están en manos expertas.
Si su organización se enfrenta a retos similares, le invitamos a ponerse en contacto con nosotros . Estamos preparados para realizar una evaluación conjunta y desarrollar un plan de transición a medida que se ajuste con precisión a su entorno.

