
À mesure que les entreprises migrent leurs charges de travail critiques vers des infrastructures virtualisées, hyperconvergées et cloud, la performance en cas de forte concurrence est devenue une priorité absolue. Pour les équipes qui évaluent une alternative à VMware , la question n'est pas simplement de savoir si une autre plateforme offre des fonctionnalités similaires, mais aussi si elle peut garantir la latence, le débit et la stabilité requis par les systèmes d'information essentiels.
Ce défi est particulièrement visible dans les applications gourmandes en mémoire, telles que le trading haute fréquence et la gestion des risques dans les services financiers, les systèmes de dossiers médicaux électroniques dans le secteur de la santé et les systèmes de gestion d'entrepôt dans la logistique. Leurs besoins croissants en accès mémoire sont étroitement liés aux composants backend comme Redis, Apache Spark, SAP HANA et les moteurs ou modèles d'IA. Redis, par exemple, est une base de données en mémoire dont les performances sont directement affectées par la vitesse d'accès à la mémoire.
L'architecture NUMA est désormais une architecture courante pour les processeurs de serveurs. Améliorer l'efficacité d'accès à la mémoire sous NUMA est donc un aspect important de l'optimisation des performances de la virtualisation. Cet article explique les technologies d'optimisation NUMA de Sangfor et comment elles aident les plateformes de virtualisation à prendre en charge les charges de travail critiques et hautement concurrentes lors du remplacement de VMware .
PARTIE 1. Contexte de l'architecture NUMA
Les premiers systèmes informatiques utilisaient généralement un seul processeur pour toutes les tâches de calcul. À mesure que les applications devenaient plus complexes et plus exigeantes, un seul processeur ne pouvait plus répondre aux besoins en calcul haute performance, et les systèmes ont progressivement évolué vers des architectures multicœurs.
Les systèmes multicœurs traditionnels utilisaient généralement le multiprocesseur symétrique (SMP). En SMP, tous les processeurs ont un statut égal et les mêmes droits d'accès à la mémoire. Chaque thread peut s'exécuter sur n'importe quel processeur, ce qui permet un équilibrage de charge efficace et améliore les performances et le débit globaux. Cependant, comme plusieurs cœurs partagent le même bus pour accéder à la mémoire, ce bus peut devenir un goulot d'étranglement lorsque le nombre de cœurs augmente, limitant ainsi l'évolutivité et les performances.
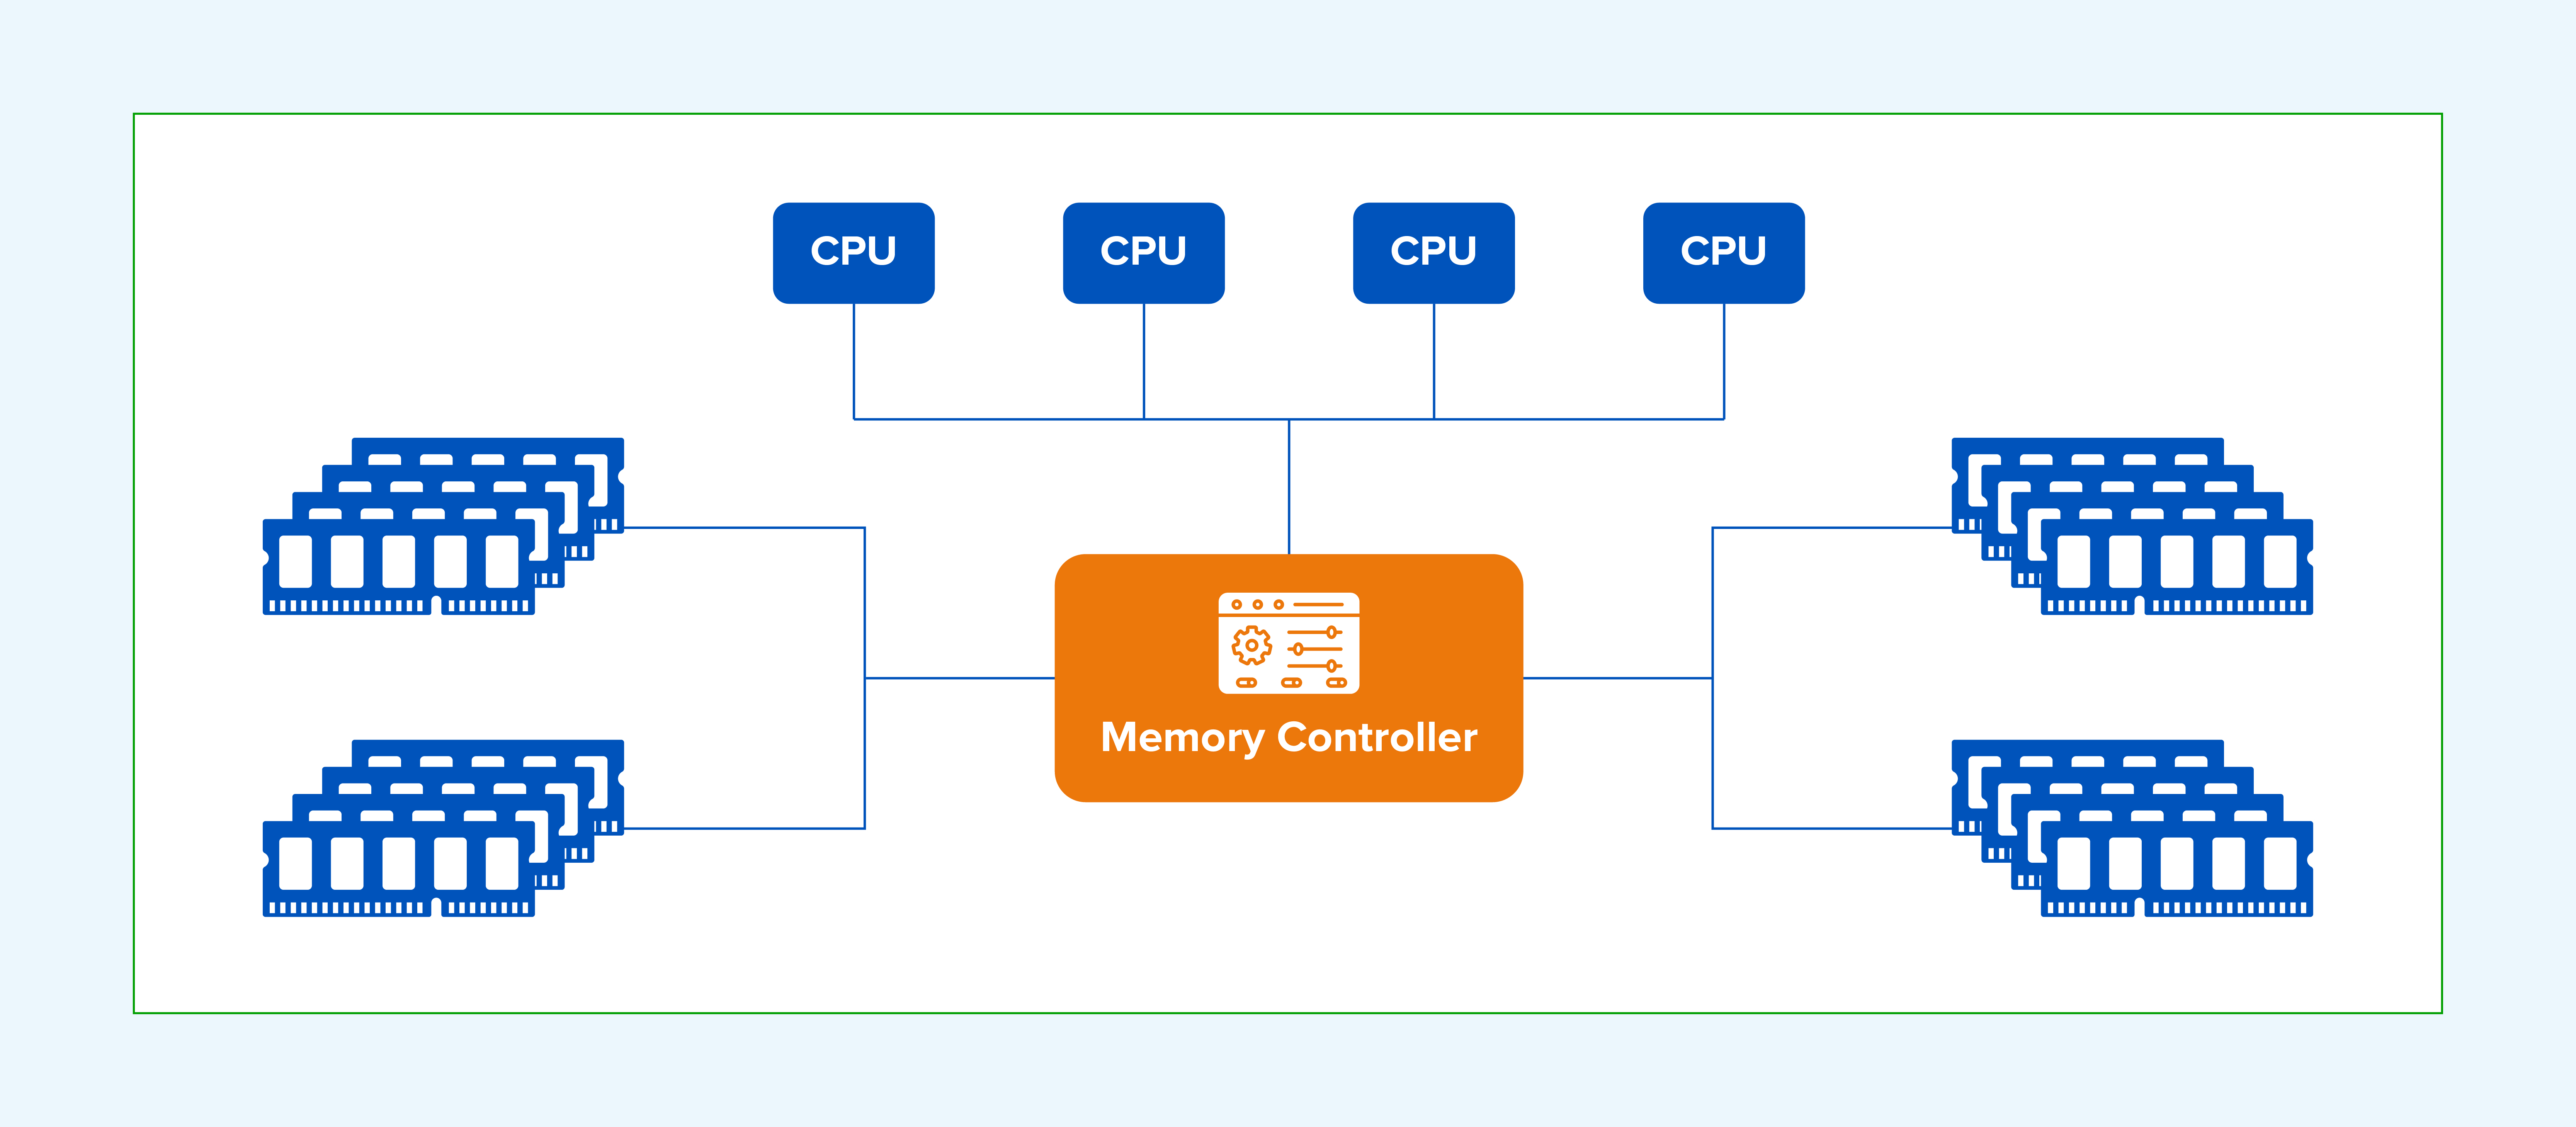
Figure 1 : Goulot d'étranglement de l'accès à la mémoire du bus partagé dans les architectures SMP traditionnelles.
L'architecture NUMA résout le problème de la latence d'accès à la mémoire inhérent aux systèmes SMP. Dans une architecture NUMA, le système est divisé en plusieurs nœuds, chacun contenant un ou plusieurs processeurs, de la mémoire locale et des périphériques d'E/S. Les nœuds communiquent via des interconnexions à haut débit, telles que AMD HyperTransport ou Intel QuickPath Interconnect (QPI), permettant aux processeurs d'accéder en priorité à la mémoire locale. Ceci réduit la latence d'accès à la mémoire et améliore les performances du système multiprocesseur.
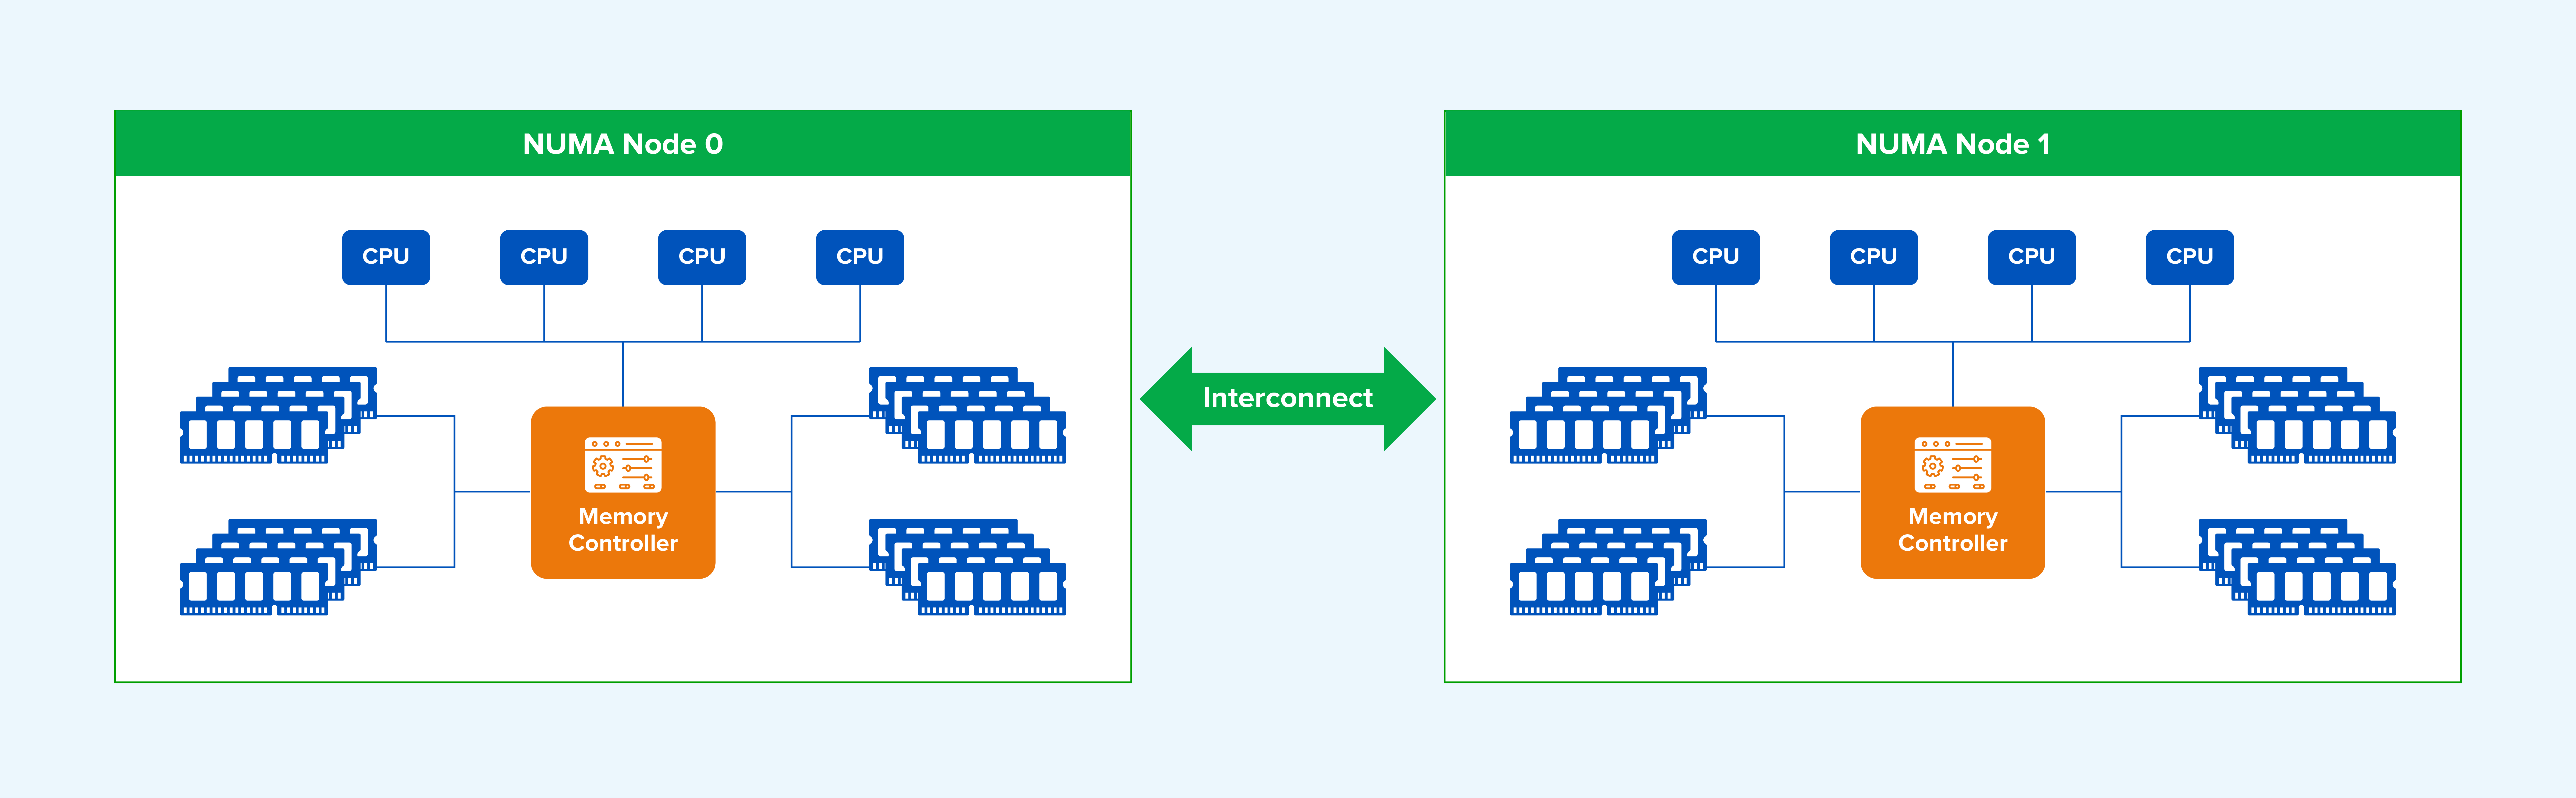
Figure 2 : Architecture NUMA multi-nœuds avec allocations CPU et mémoire locales au nœud.
Un système NUMA comprend trois types de nœuds :
- Nœud local : pour les processeurs situés au sein d’un nœud donné, ce nœud est le nœud local.
- Nœud voisin : un nœud adjacent au nœud local.
- Nœud distant : un nœud qui n’est ni local ni voisin.
La vitesse d'accès au processeur varie selon le type de nœud. La mémoire locale est la plus rapide à accéder, tandis que la mémoire distante est la plus lente. En général, l'accès à la mémoire est plus lent à mesure que la distance topologique augmente.
Dans « NUMA : un aperçu », le Dr Christoph Lameter a noté que, sur un serveur haut de gamme à deux nœuds en 2013, la latence d'accès aléatoire à la mémoire locale était d'environ 100 ns, tandis que l'accès à la mémoire distante ajoutait environ 50 % de latence supplémentaire.
PARTIE 2. Défis soulevés par la NUMA
Sous Linux, un thread est l'unité de base de l'ordonnancement du processeur et correspond à une tâche dans la file d'attente d'exécution. Le noyau sélectionne un processeur relativement inactif pour chaque tâche. La charge du processeur variant dynamiquement, le noyau utilise l'équilibrage de charge pour déplacer les tâches vers des processeurs moins sollicités. Par défaut, une tâche peut donc être déplacée d'un processeur à l'autre.
Sous NUMA, une tâche peut être déplacée d'un processeur du nœud 1 vers un processeur du nœud 2 tout en continuant d'accéder à la mémoire allouée sur le nœud 1, ce qui entraîne un accès inter-nœuds. L'équilibrage NUMA de Linux migre périodiquement les tâches ou les pages mémoire vers le nœud local, mais il ne peut pas éliminer tous les accès à la mémoire distante.
Dans un environnement virtualisé, chaque vCPU de machine virtuelle correspond à un thread du système d'exploitation hôte. Si plusieurs threads vCPU s'exécutent sur différents nœuds NUMA tout en partageant de la mémoire, ou s'ils migrent d'un nœud à l'autre, la machine virtuelle peut accéder à la mémoire sur plusieurs nœuds NUMA et subir une latence plus élevée.
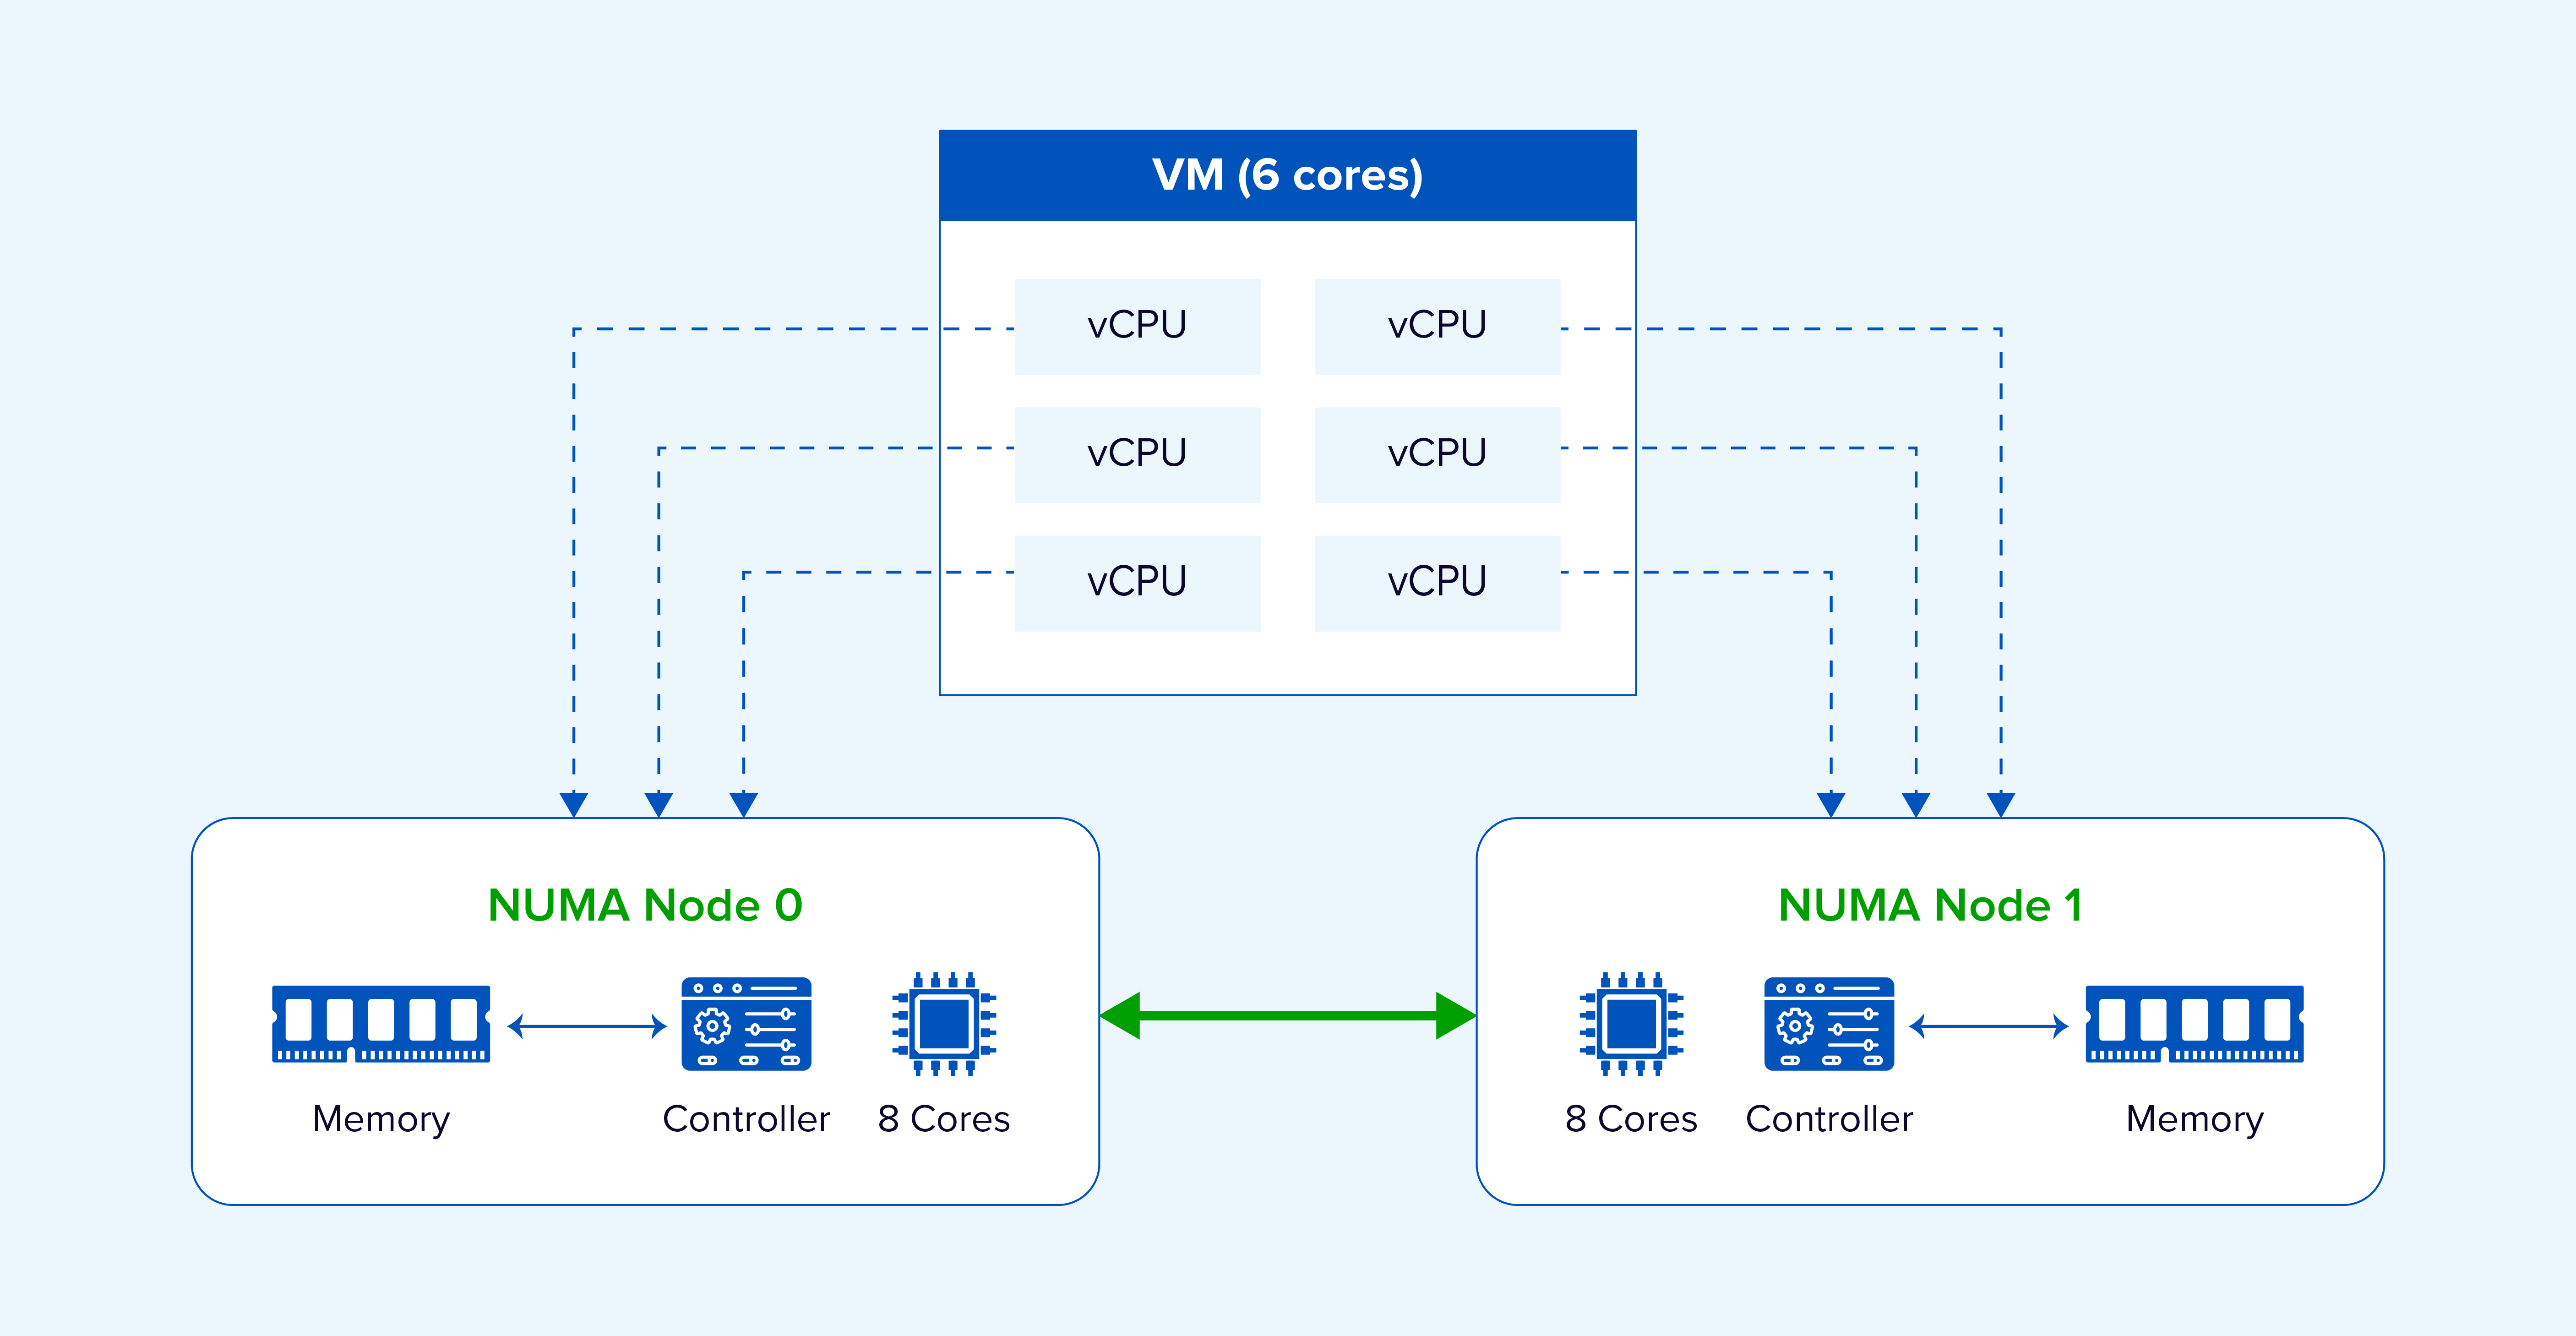
Figure 3 : L'exécution inter-nœuds peut augmenter l'accès à la mémoire distante pour une machine virtuelle.
PARTIE 3. Approches courantes d'ordonnancement NUMA
Le secteur utilise généralement les approches suivantes :
Approche 1 : Associer les vCPU aux cœurs physiques
Les administrateurs configurent manuellement l'épinglage des vCPU afin que les ressources des machines virtuelles s'exécutent de préférence au sein du même nœud NUMA physique.
Approche 2 : Spécifier le nombre de nœuds NUMA attribués à une machine virtuelle
Les administrateurs configurent manuellement le nombre de nœuds NUMA et répartissent uniformément les ressources vCPU et mémoire entre eux.
Approche 3 : Allocation adaptative des nœuds NUMA
Le planificateur attribue automatiquement des nœuds NUMA adaptés à une machine virtuelle. Les processeurs de la machine virtuelle sont limités à ces nœuds et privilégient l'utilisation de la mémoire locale pour optimiser la localité des ressources. Si le nombre de vCPU d'une machine virtuelle dépasse la capacité d'un seul nœud NUMA, il est réparti sur plusieurs nœuds. La topologie NUMA peut être exposée au système d'exploitation invité pour permettre des décisions basées sur cette topologie, tandis que les machines virtuelles peuvent être déplacées entre les nœuds afin de maintenir l'équilibrage de charge.
Les approches 1 et 2 imposent davantage de restrictions, nécessitent un dimensionnement précis du processeur des machines virtuelles et peuvent créer un déséquilibre entre les nœuds NUMA en raison de la liaison statique. L'allocation adaptative est donc plus pratique pour les environnements de production dynamiques.
PARTIE 4. Planification Sangfor NUMA en détail
Sangfor HCI utilise principalement une planification NUMA adaptative. Elle équilibre l'utilisation des nœuds NUMA tout en réduisant l'accès à la mémoire distante par les vCPU des machines virtuelles, améliorant ainsi les performances globales.
L'ordonnancement NUMA adaptatif offre des gains d'optimisation significatifs pour différents types d'applications, notamment les intergiciels effectuant de fréquentes opérations en mémoire. Sangfor a déployé DM8, Redis et Memcached dans des machines virtuelles et a comparé leurs performances avec et sans ordonnancement NUMA. Les résultats ont démontré une nette amélioration des performances des intergiciels lorsque l'ordonnancement NUMA était activé.
Charges de travail de base de données : Dameng DB (DM8) avec BenchmarkSQL
BenchmarkSQL est un outil d'évaluation des performances des bases de données relationnelles. Il exécute un ensemble de transactions de type TPC-C, incluant les nouvelles commandes, les paiements, les requêtes de statut de commande, les livraisons et les requêtes de niveau de stock. La métrique tpmC qui en résulte représente le nombre de transactions de nouvelles commandes traitées par minute ; plus sa valeur est élevée, meilleures sont les performances. BenchmarkSQL 5.0 a été utilisé pour tester la base de données DM8. Le graphique ci-dessous présente les performances relatives, le résultat tpmC (sans NUMA) étant normalisé à 100 %.
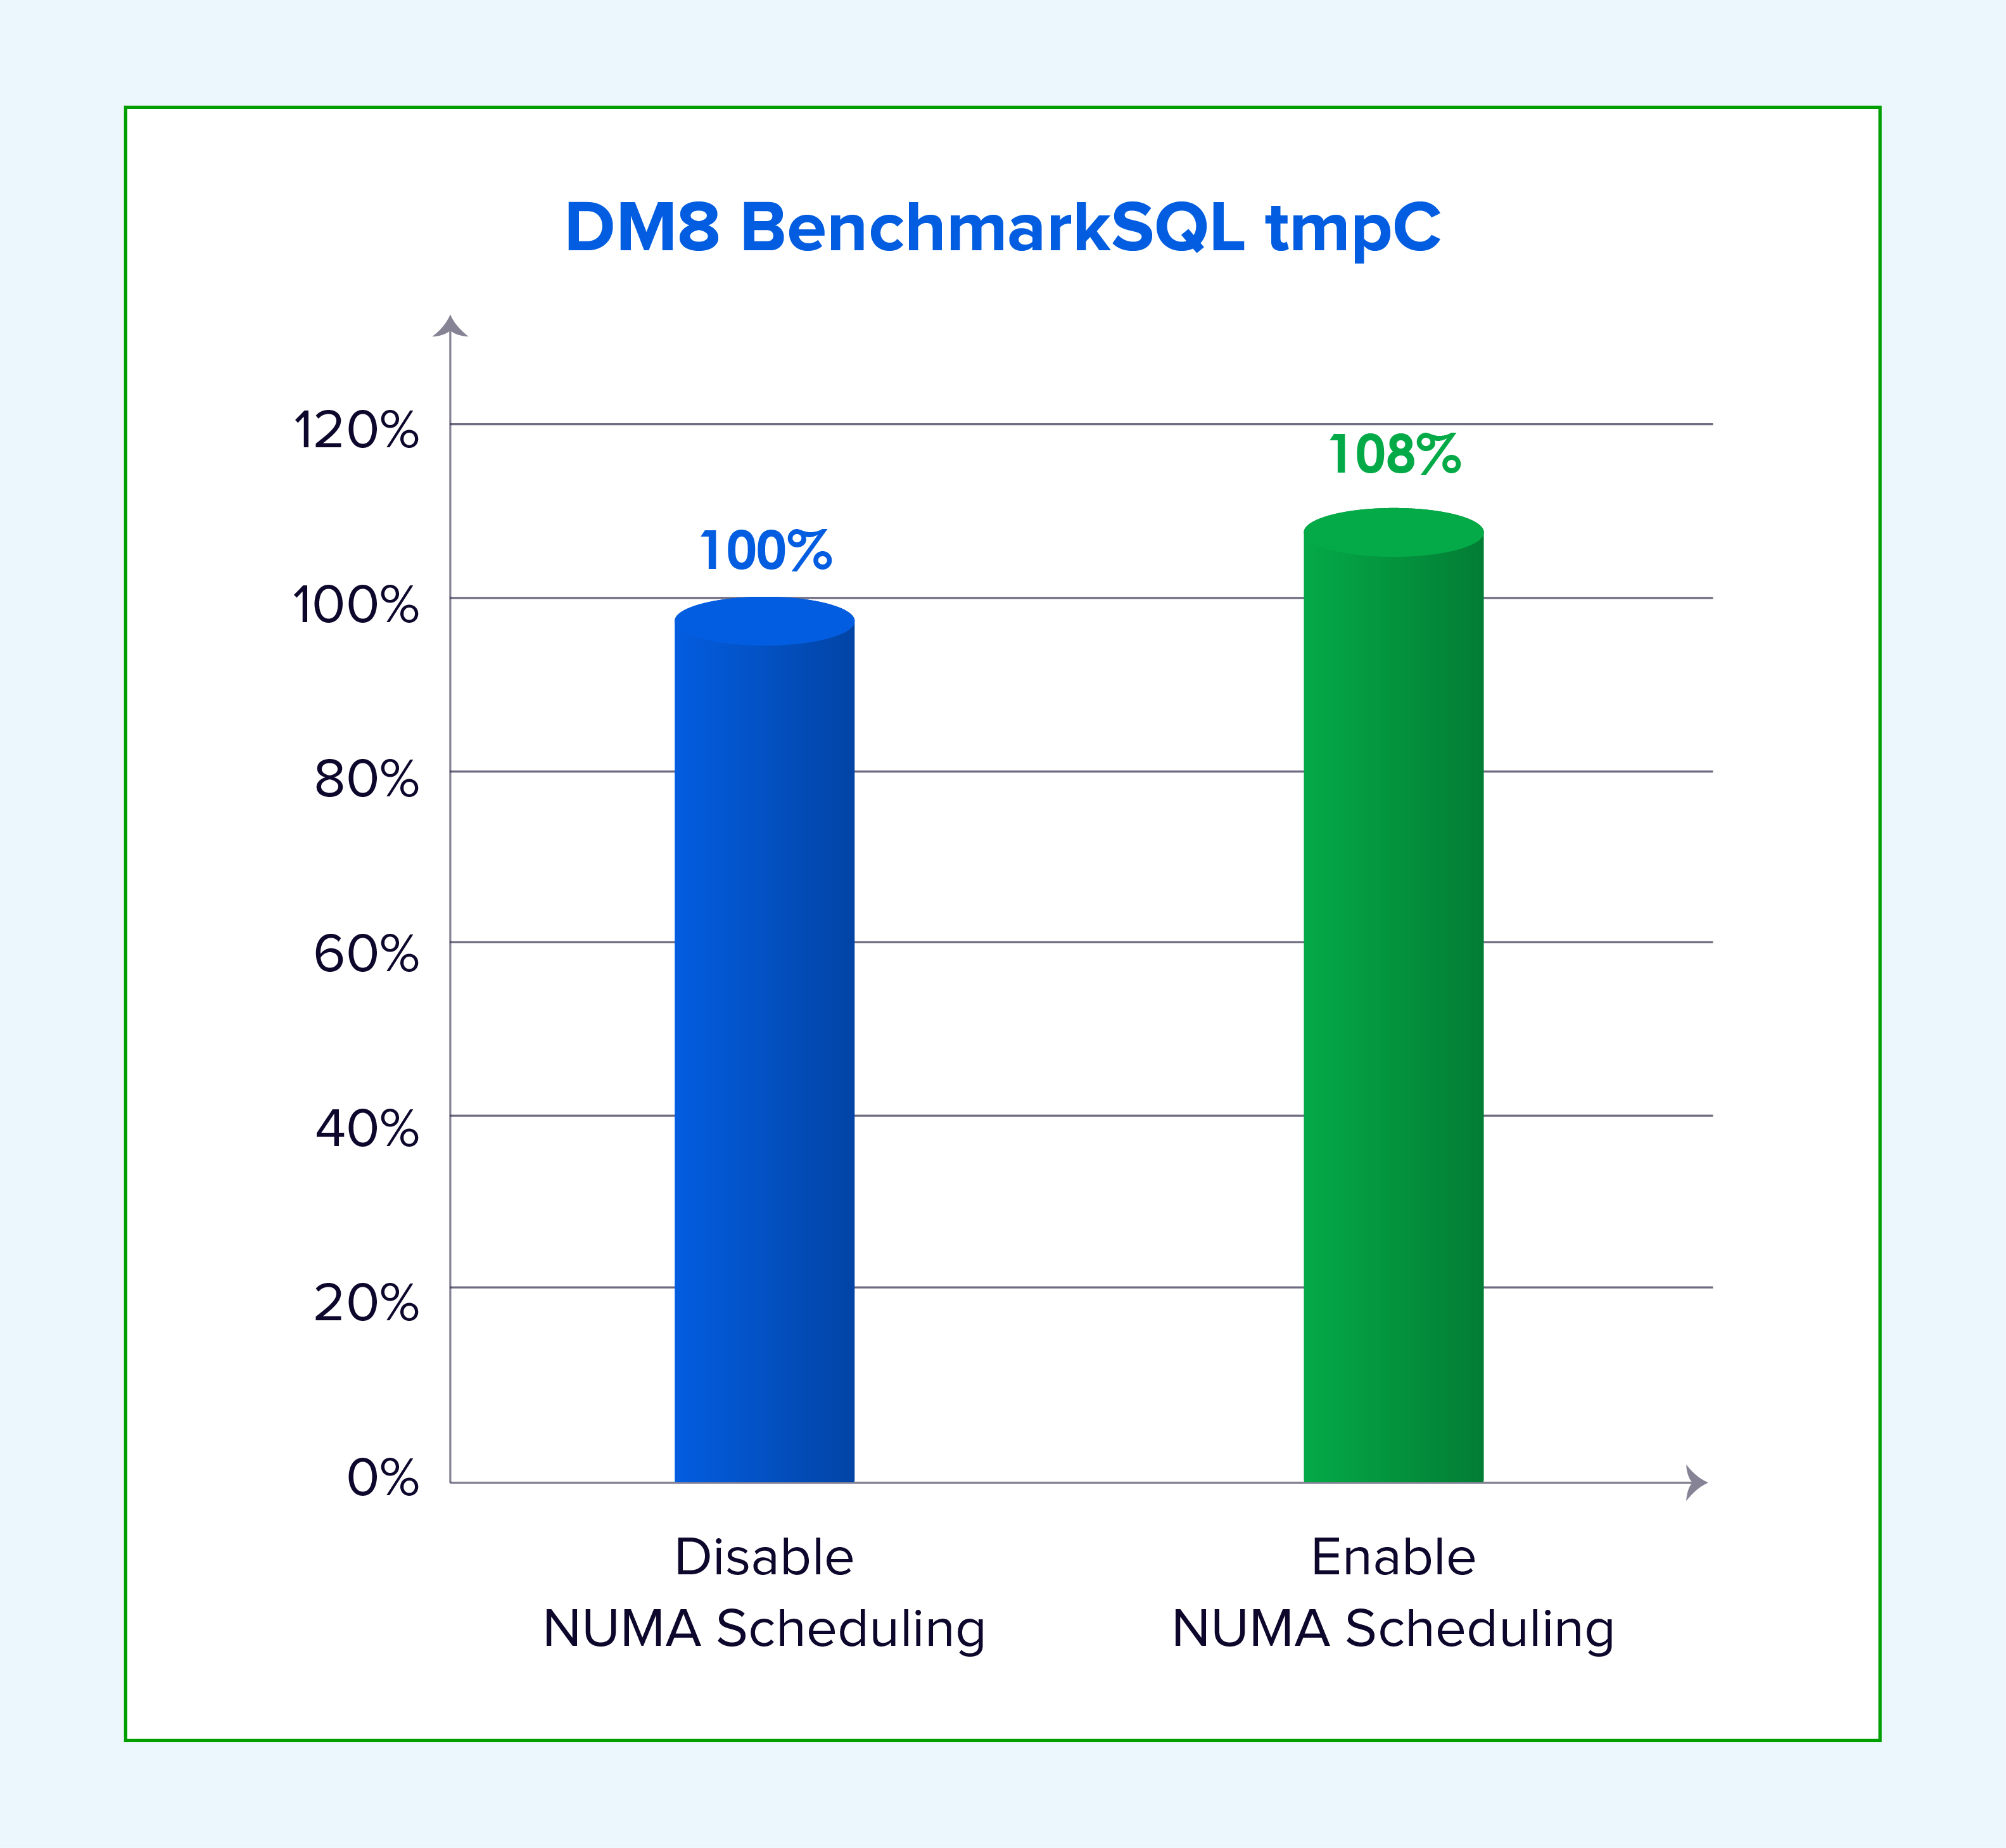
Figure 4 : Débit relatif des transactions DM8 avec la planification NUMA activée par rapport à la désactivation.
Mise en cache en mémoire : Redis 7.2.5
redis-benchmark est l'outil officiel de test de performance de Redis. Sangfor l'a utilisé pour tester le nombre de requêtes par seconde (QPS) des opérations GET et SET pour des valeurs de 1 Ko, avec l'ordonnancement NUMA désactivé et activé. Le QPS représente le nombre d'opérations de lecture ou d'écriture par seconde.
redis-benchmark -t get -d 16 -c 100 -n 6000000 -r 60000000
redis-benchmark -t set -d 16 -c 100 -n 6000000 -r 60000000
Le graphique suivant illustre les performances relatives, le résultat QPS sans NUMA étant normalisé à 100 %.
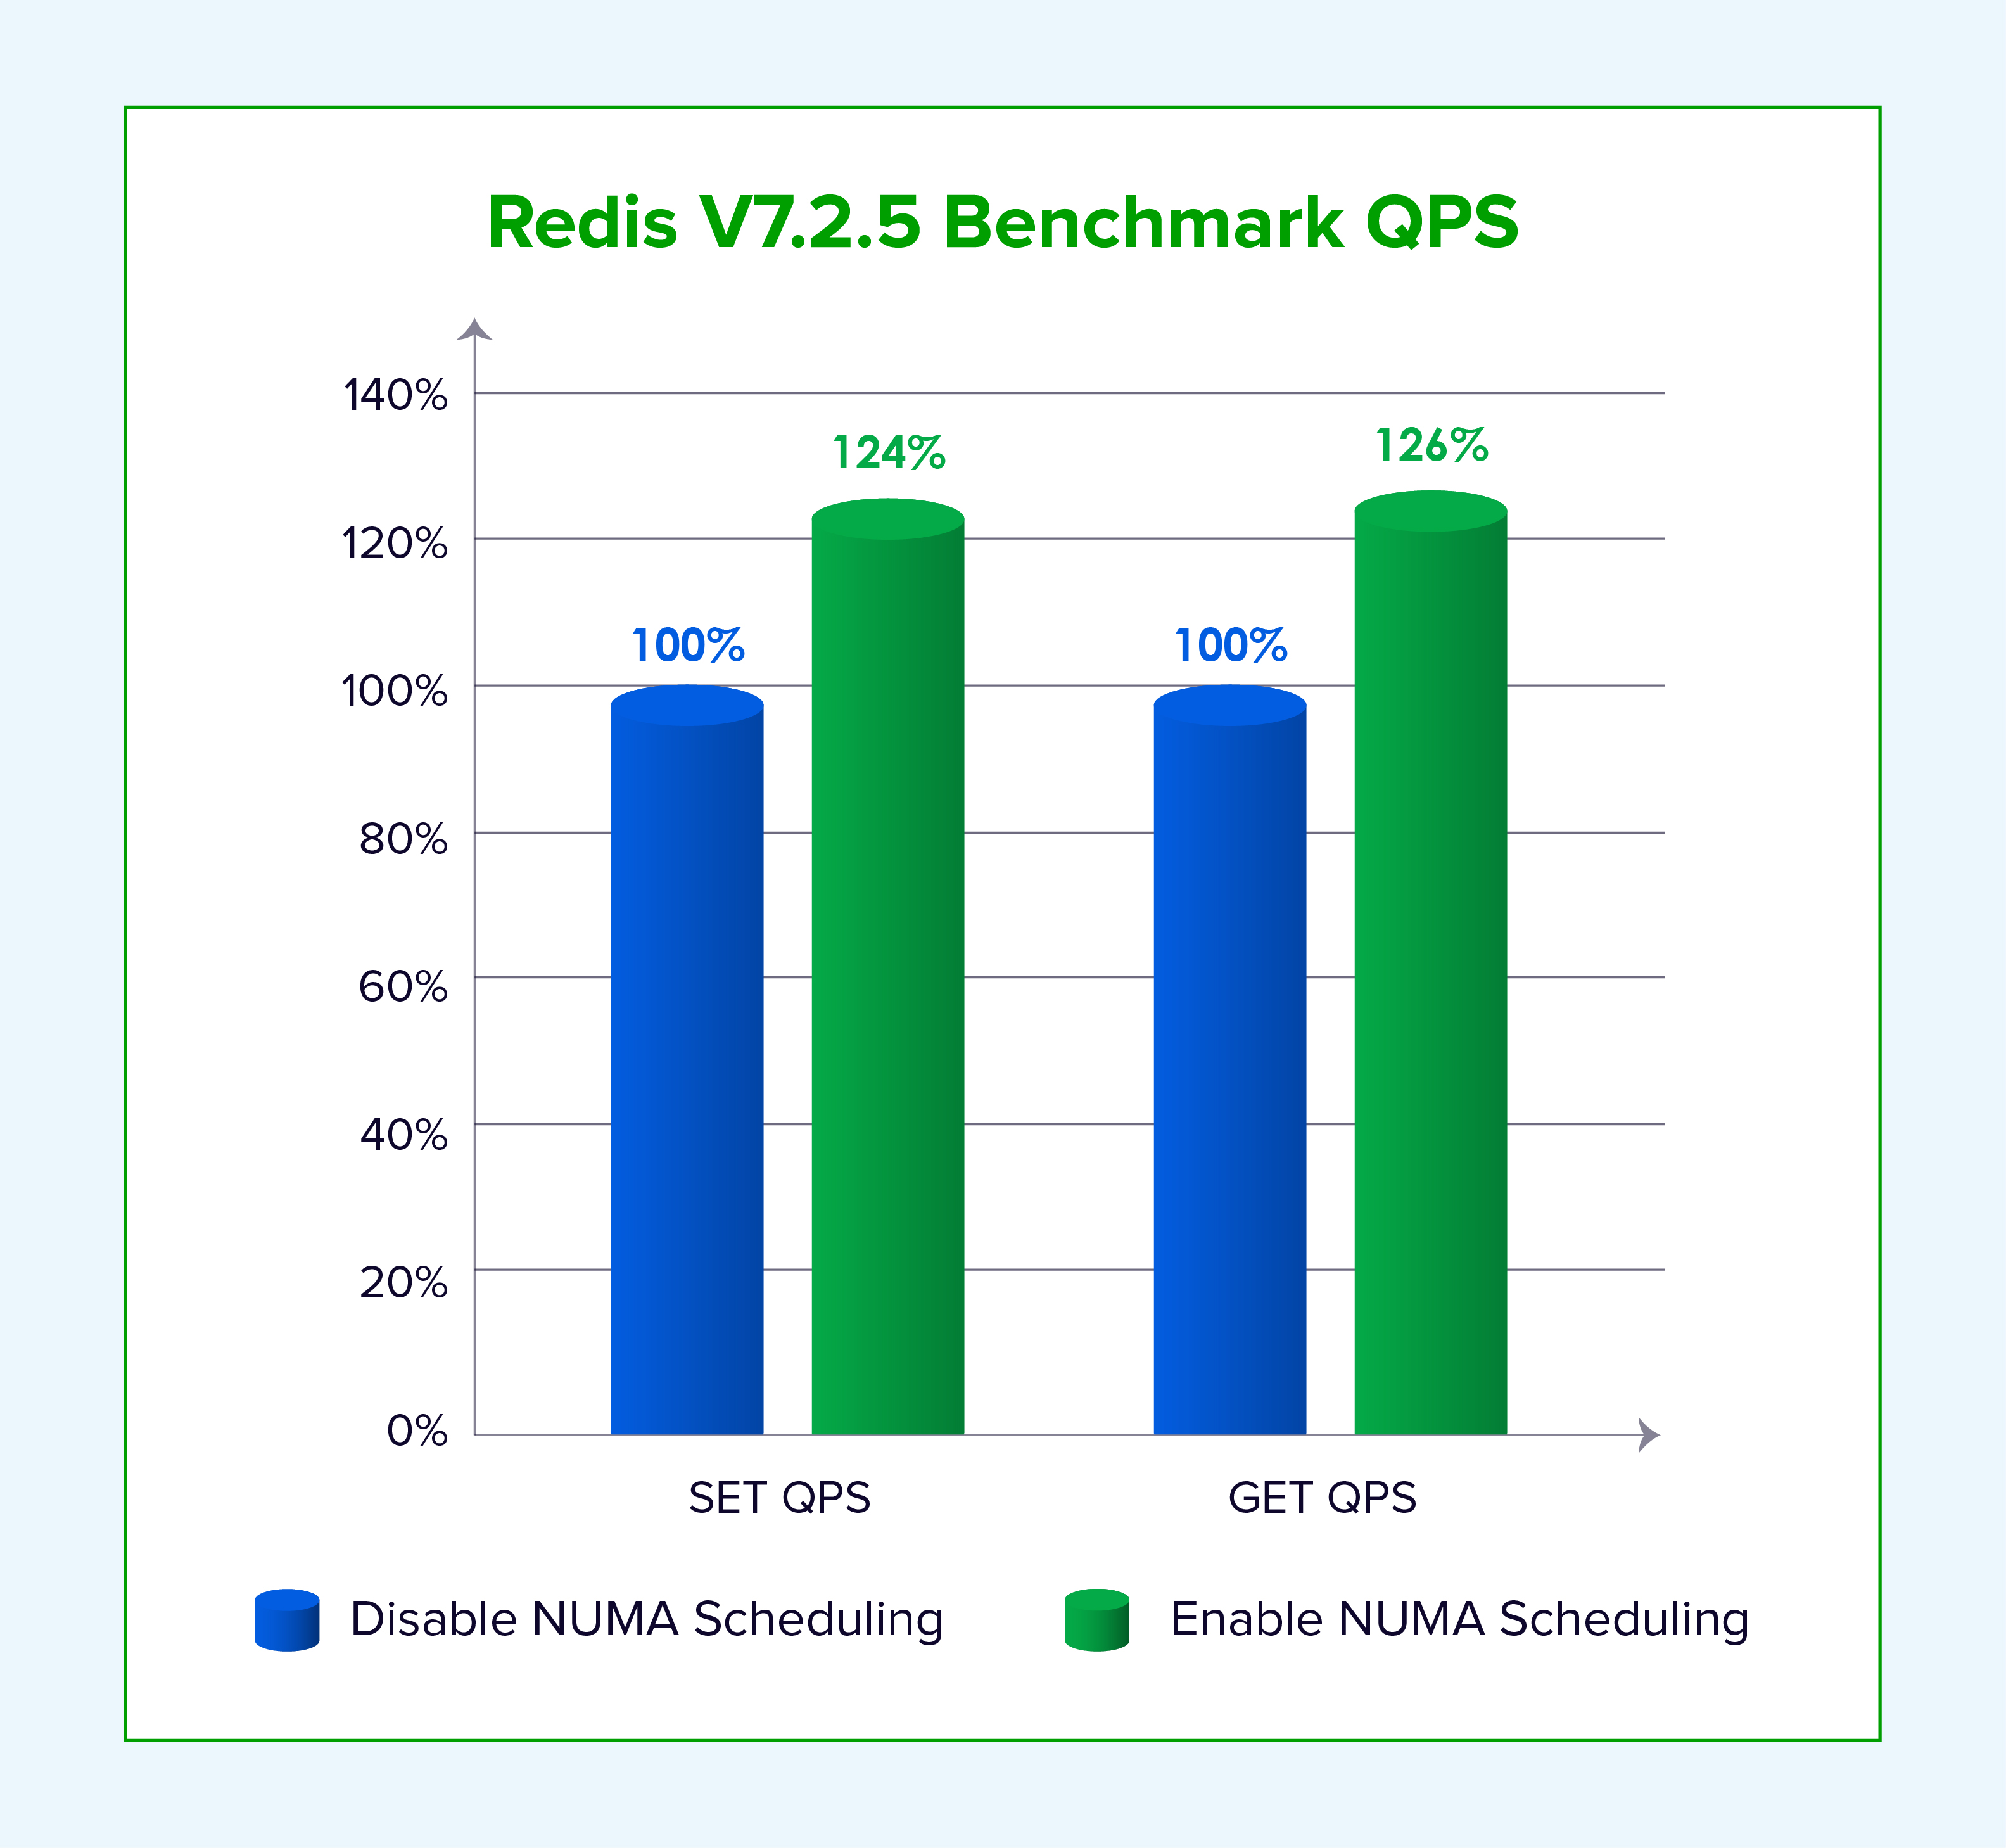
Figure 5 : Gains de performance relatifs en lecture/écriture Redis QPS avec la planification NUMA activée.
Mise en cache clé-valeur : Memcached 6.27
Memaslap est un outil de test de performance inclus dans Memcached. Sangfor l'a utilisé pour tester le TPS (transactions par seconde) pour des valeurs de 1 Ko, avec la planification NUMA désactivée et activée.
memaslap -s 127.0.0.1:11211 -t 300s -T 8
Le graphique suivant illustre les performances relatives, le résultat TPS avec NUMA désactivé étant normalisé à 100 %.
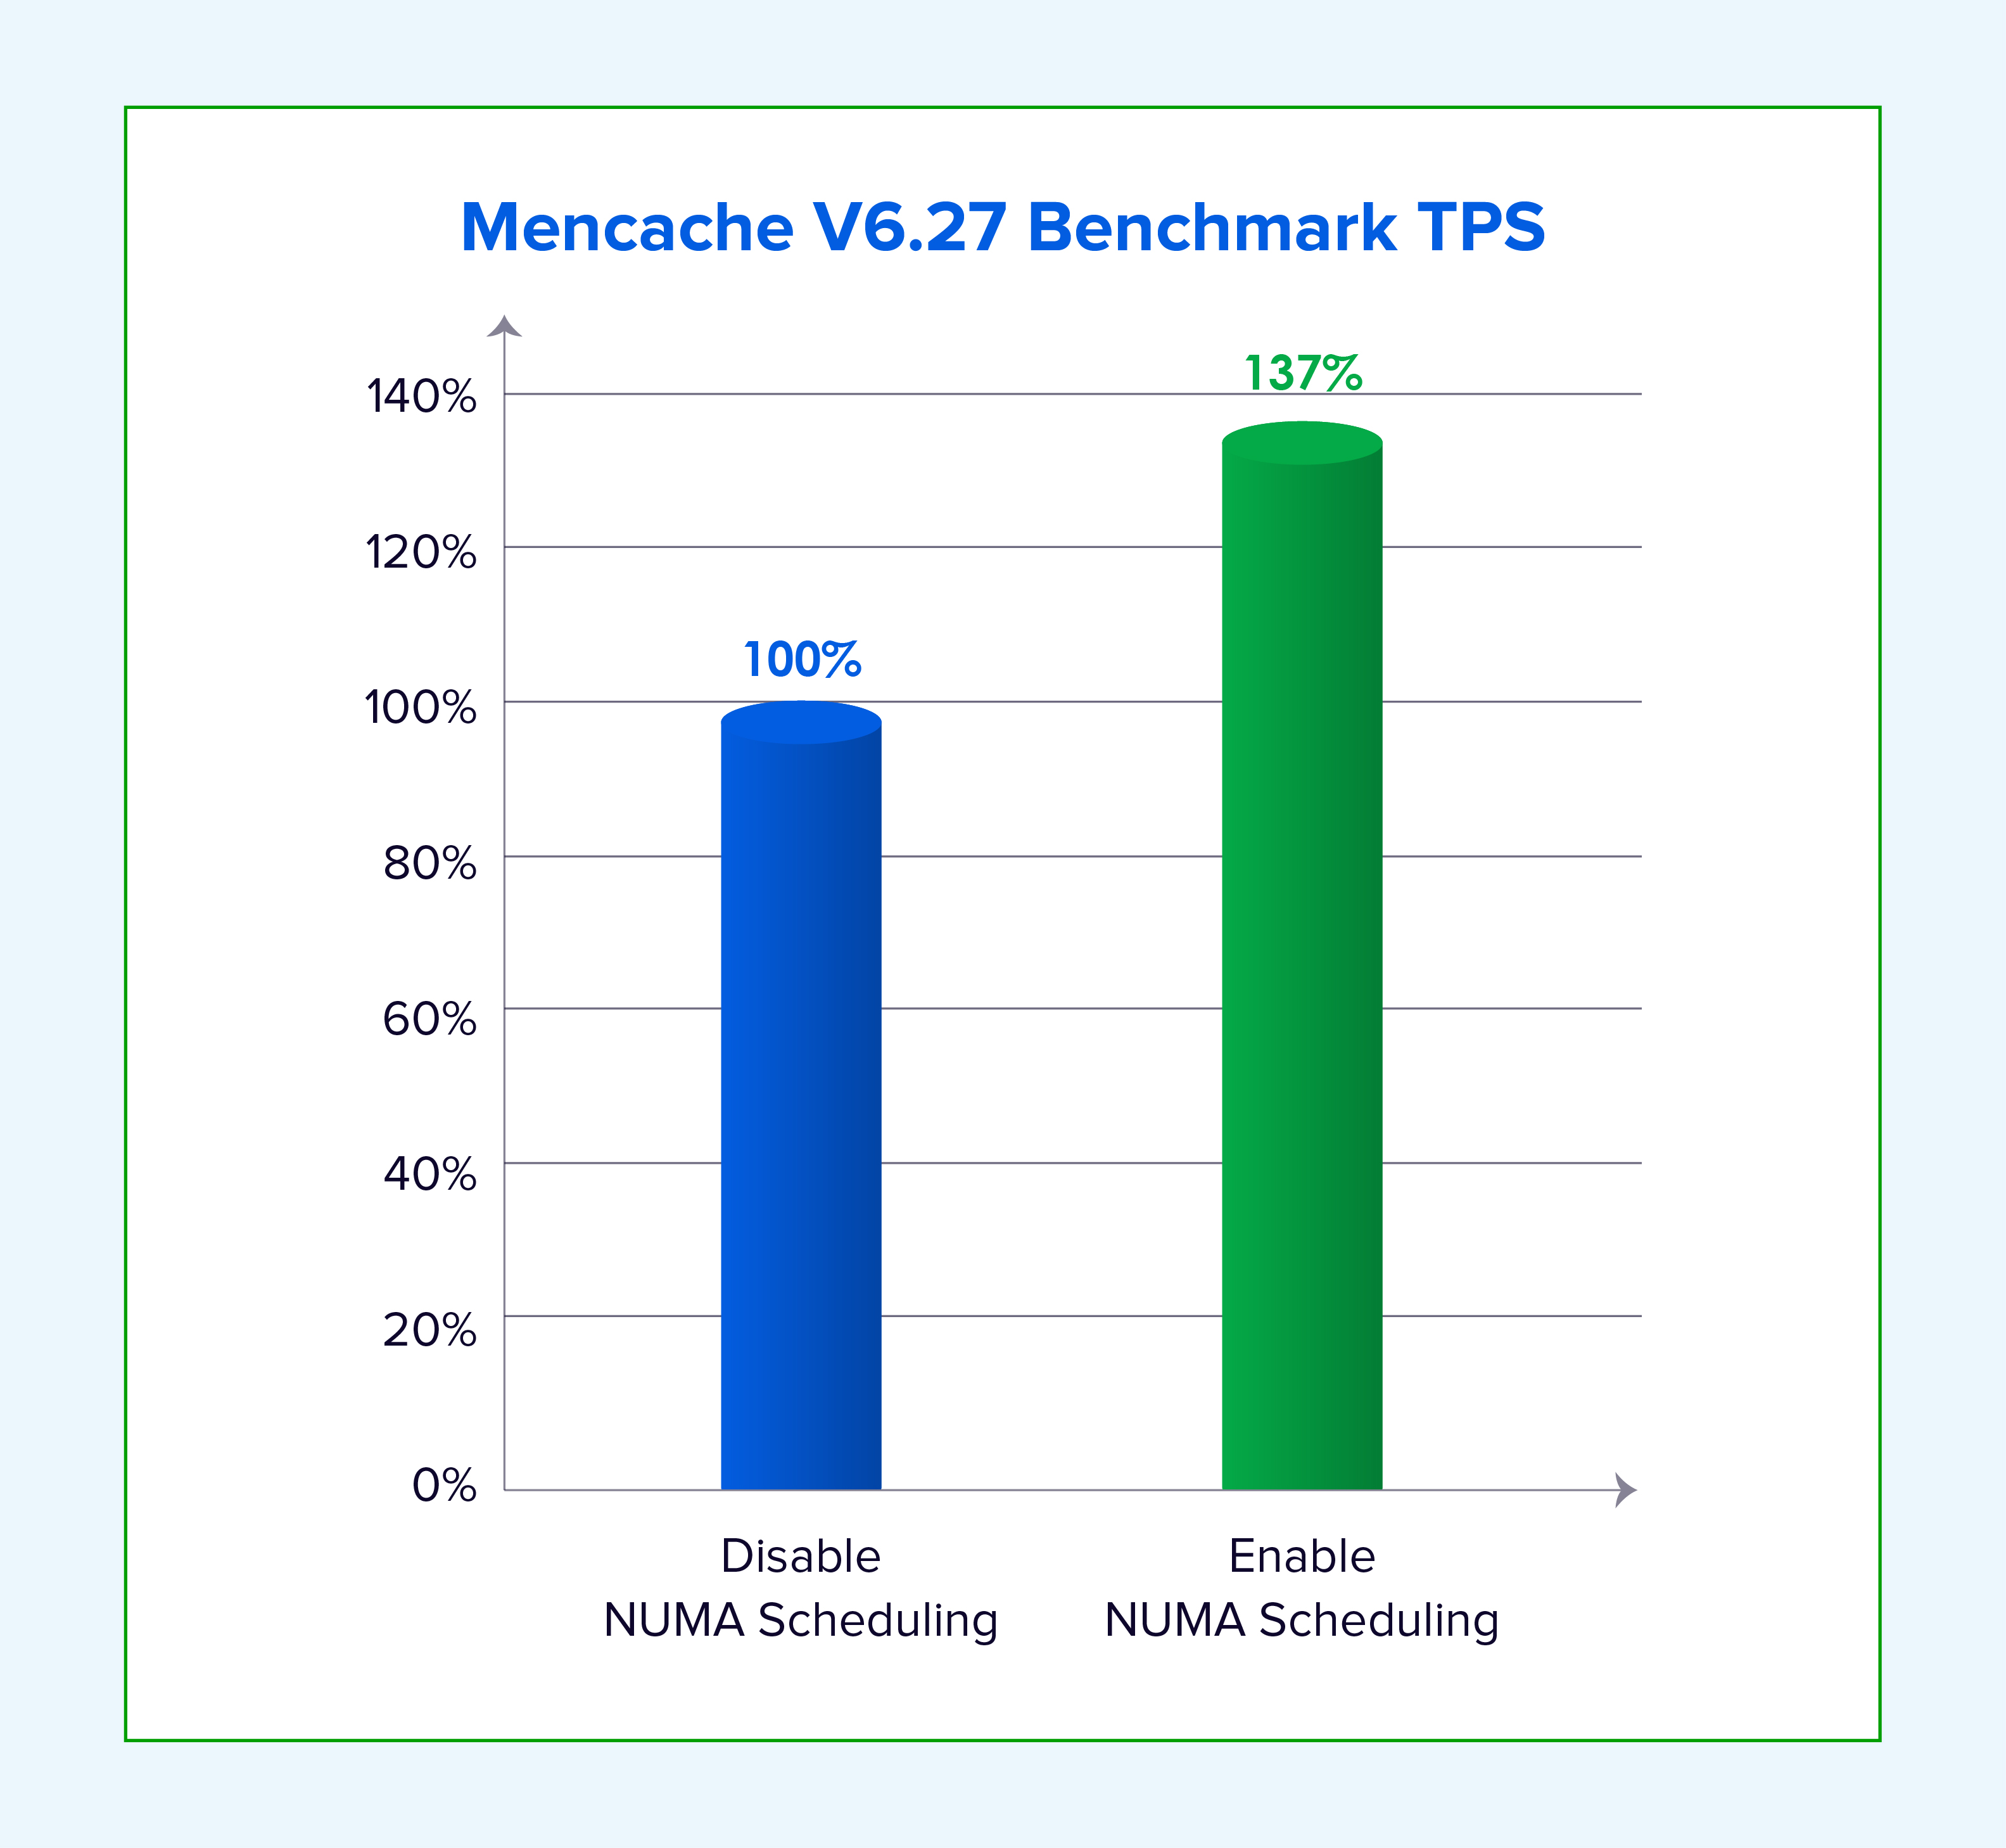
Figure 6 : Gains relatifs de débit transactionnel Memcached avec la planification NUMA activée.
Les résultats ci-dessus démontrent des avantages indéniables pour les applications gourmandes en mémoire. Les sections suivantes expliquent le fonctionnement de cette optimisation.
1. Allocation adaptative des nœuds NUMA
Sangfor répartit de manière adaptative les vCPU des machines virtuelles et les planifie sur des nœuds NUMA appropriés afin de réduire les accès à la mémoire distante. Si le nombre de vCPU de la machine virtuelle est inférieur au nombre de cœurs d'un nœud NUMA, la machine virtuelle est planifiée sur un seul nœud. Si la machine virtuelle nécessite plus de cœurs qu'un seul nœud ne peut en fournir, elle est distribuée sur plusieurs nœuds, et la topologie vNUMA est exposée au système d'exploitation invité pour que celui-ci prenne des décisions en tenant compte de la topologie.
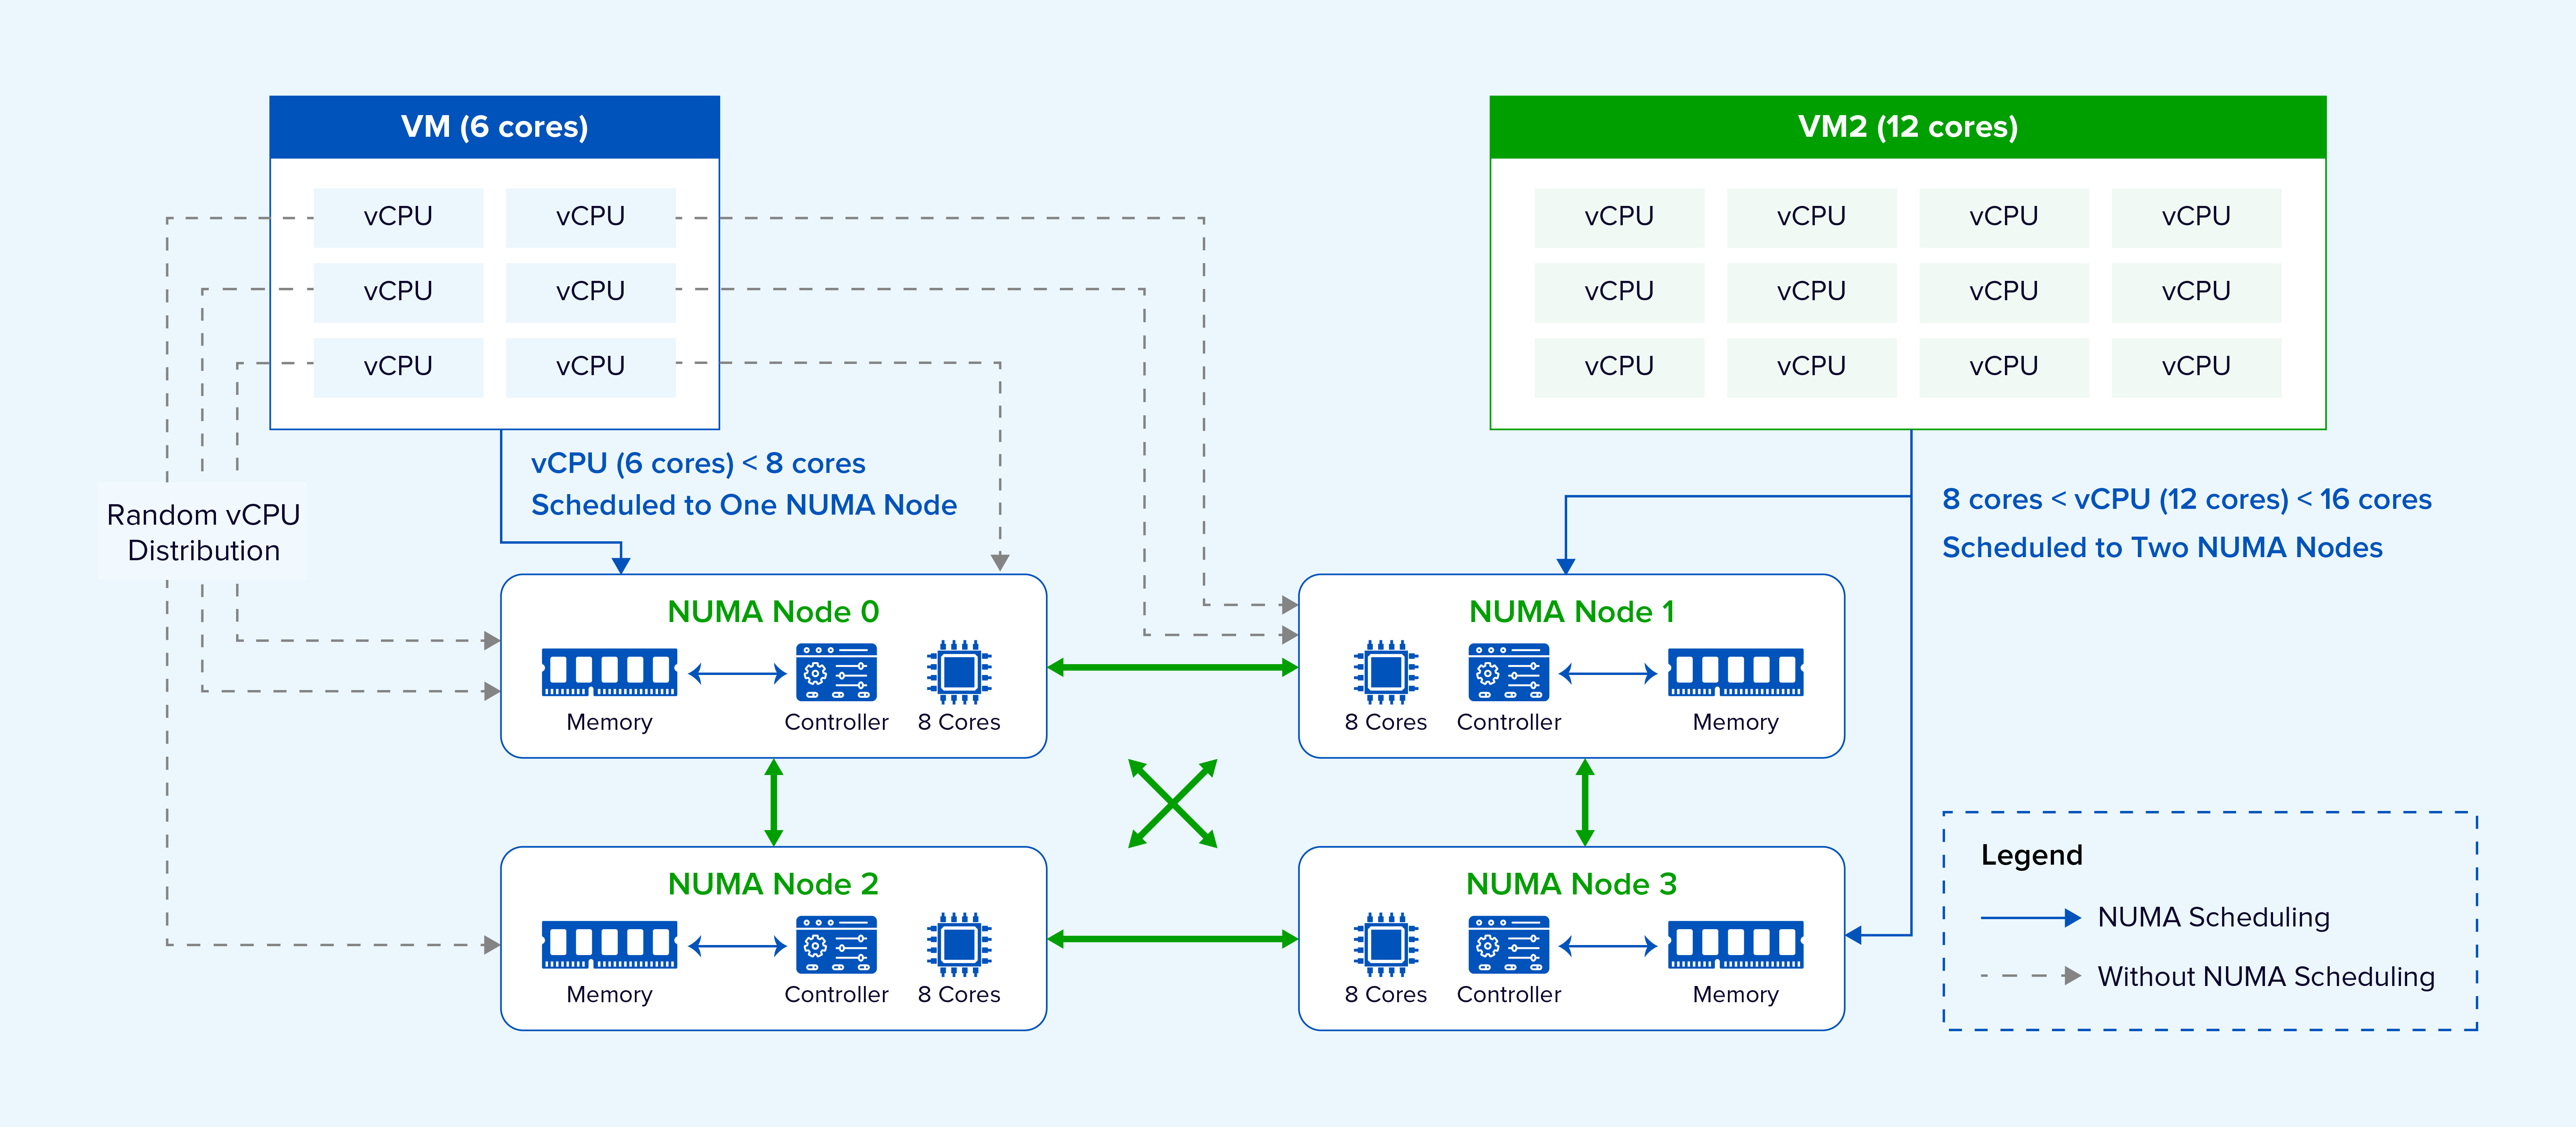
Figure 7 : Partitionnement intelligent vCPU et mappage de la topologie vNUMA de Sangfor.
Pour garantir une utilisation équilibrée, le placement des machines virtuelles (VM) tient compte de la charge actuelle sur les nœuds NUMA et sélectionne un nœud moins sollicité. En cours d'exécution, les VM peuvent être déplacées entre les nœuds en fonction de l'évolution de l'utilisation. Les VM prioritaires sont placées de préférence sur les nœuds les moins sollicités afin de réduire la concurrence pour les ressources du processeur, la bande passante mémoire et le cache.
2. Optimisation pour les plateformes serveur hétérogènes
Certaines plateformes serveur contiennent de nombreux nœuds NUMA, des distances inter-nœuds différentes et relativement peu de cœurs par nœud.
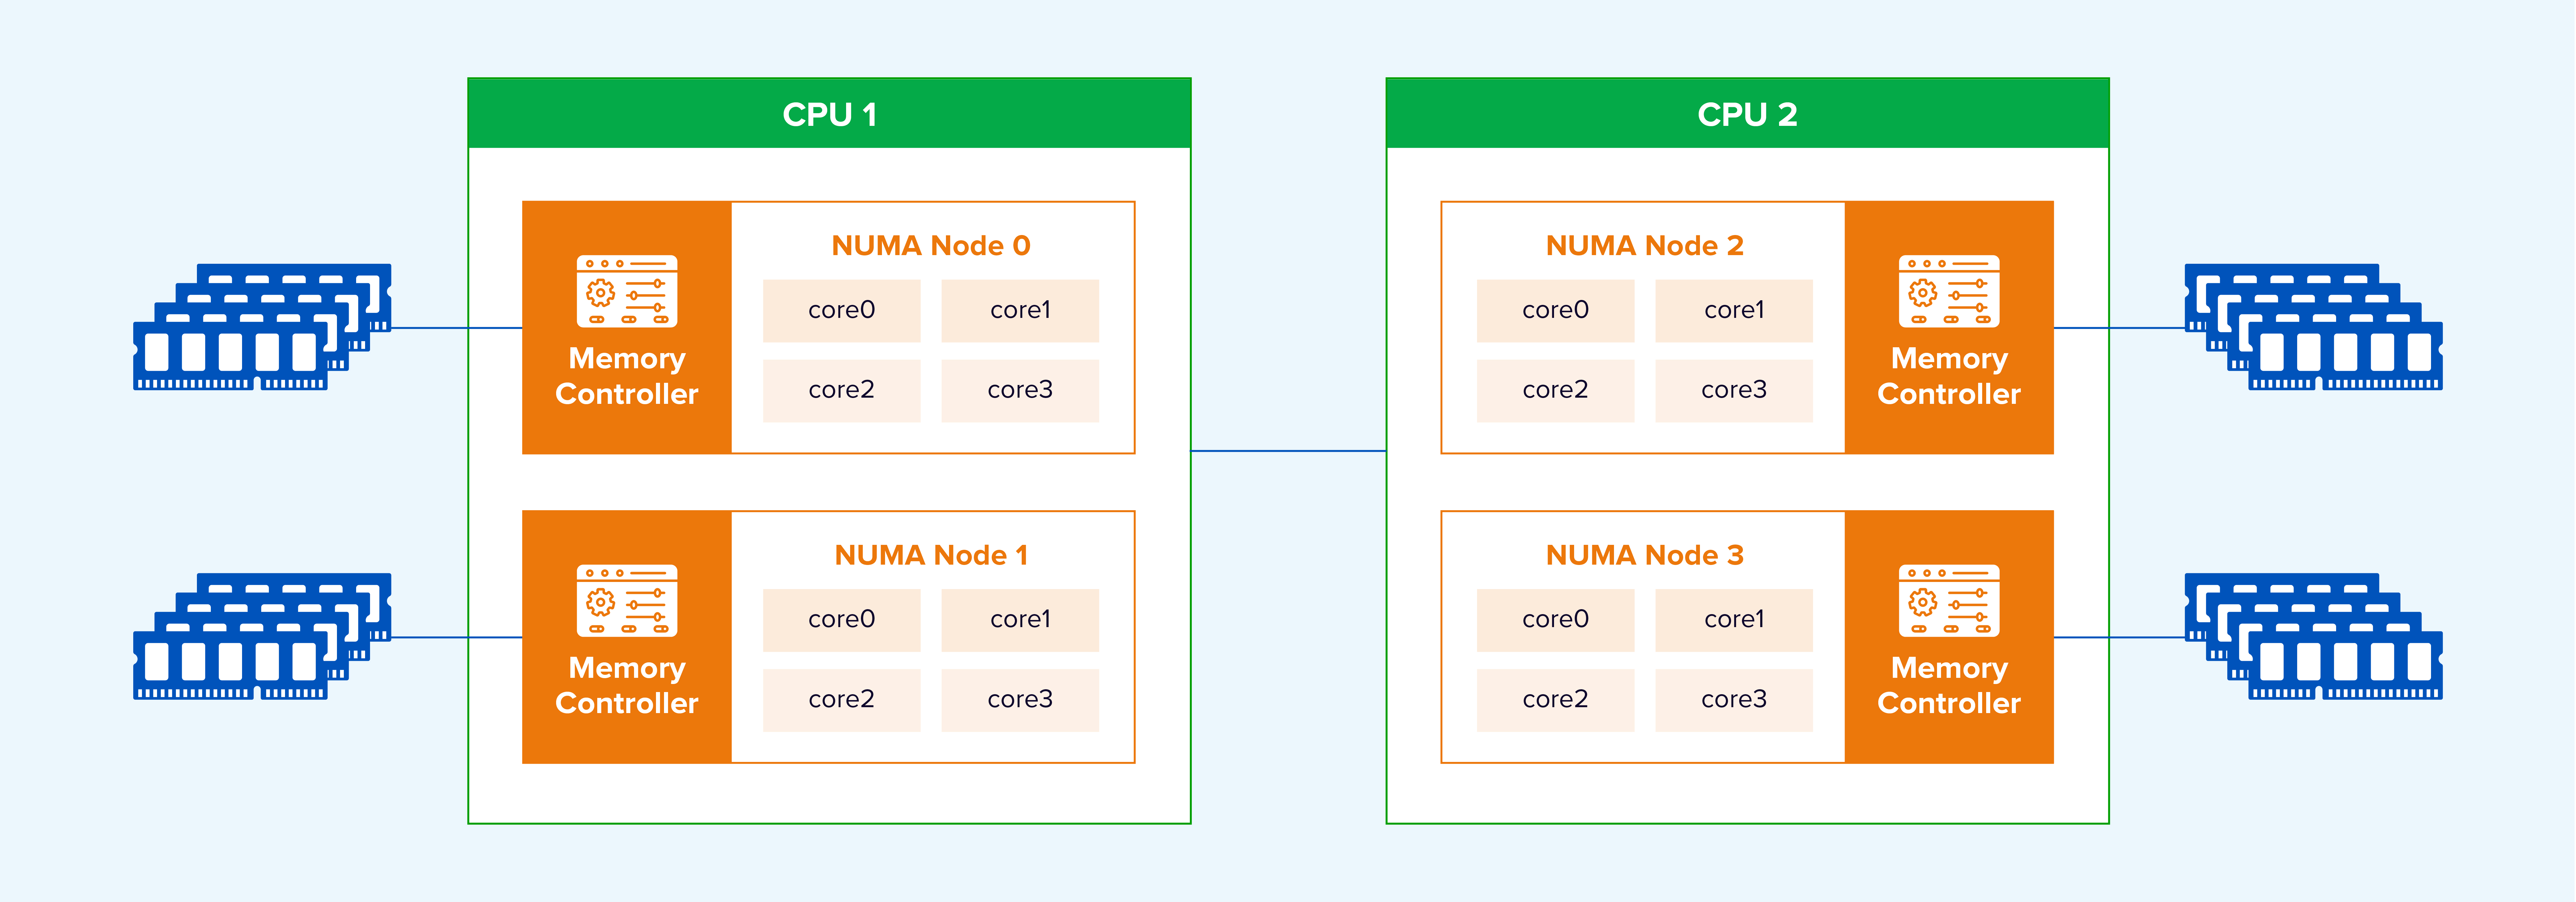
Figure 8. Placement vNUMA tenant compte de la topologie sur un serveur multi-nœuds.
Sangfor identifie la distance entre les nœuds NUMA et place de préférence plusieurs nœuds vNUMA de la même VM sur des nœuds NUMA physiques proches.
Pour améliorer encore les performances de transfert de données, Sangfor a développé l'affinité NUMA entre les machines virtuelles et les processus du plan de données. La machine virtuelle et son processus de transfert de données sont exécutés sur le même nœud NUMA, ce qui augmente l'accès à la mémoire locale. Dans la figure suivante, DP désigne le processus du plan de données.
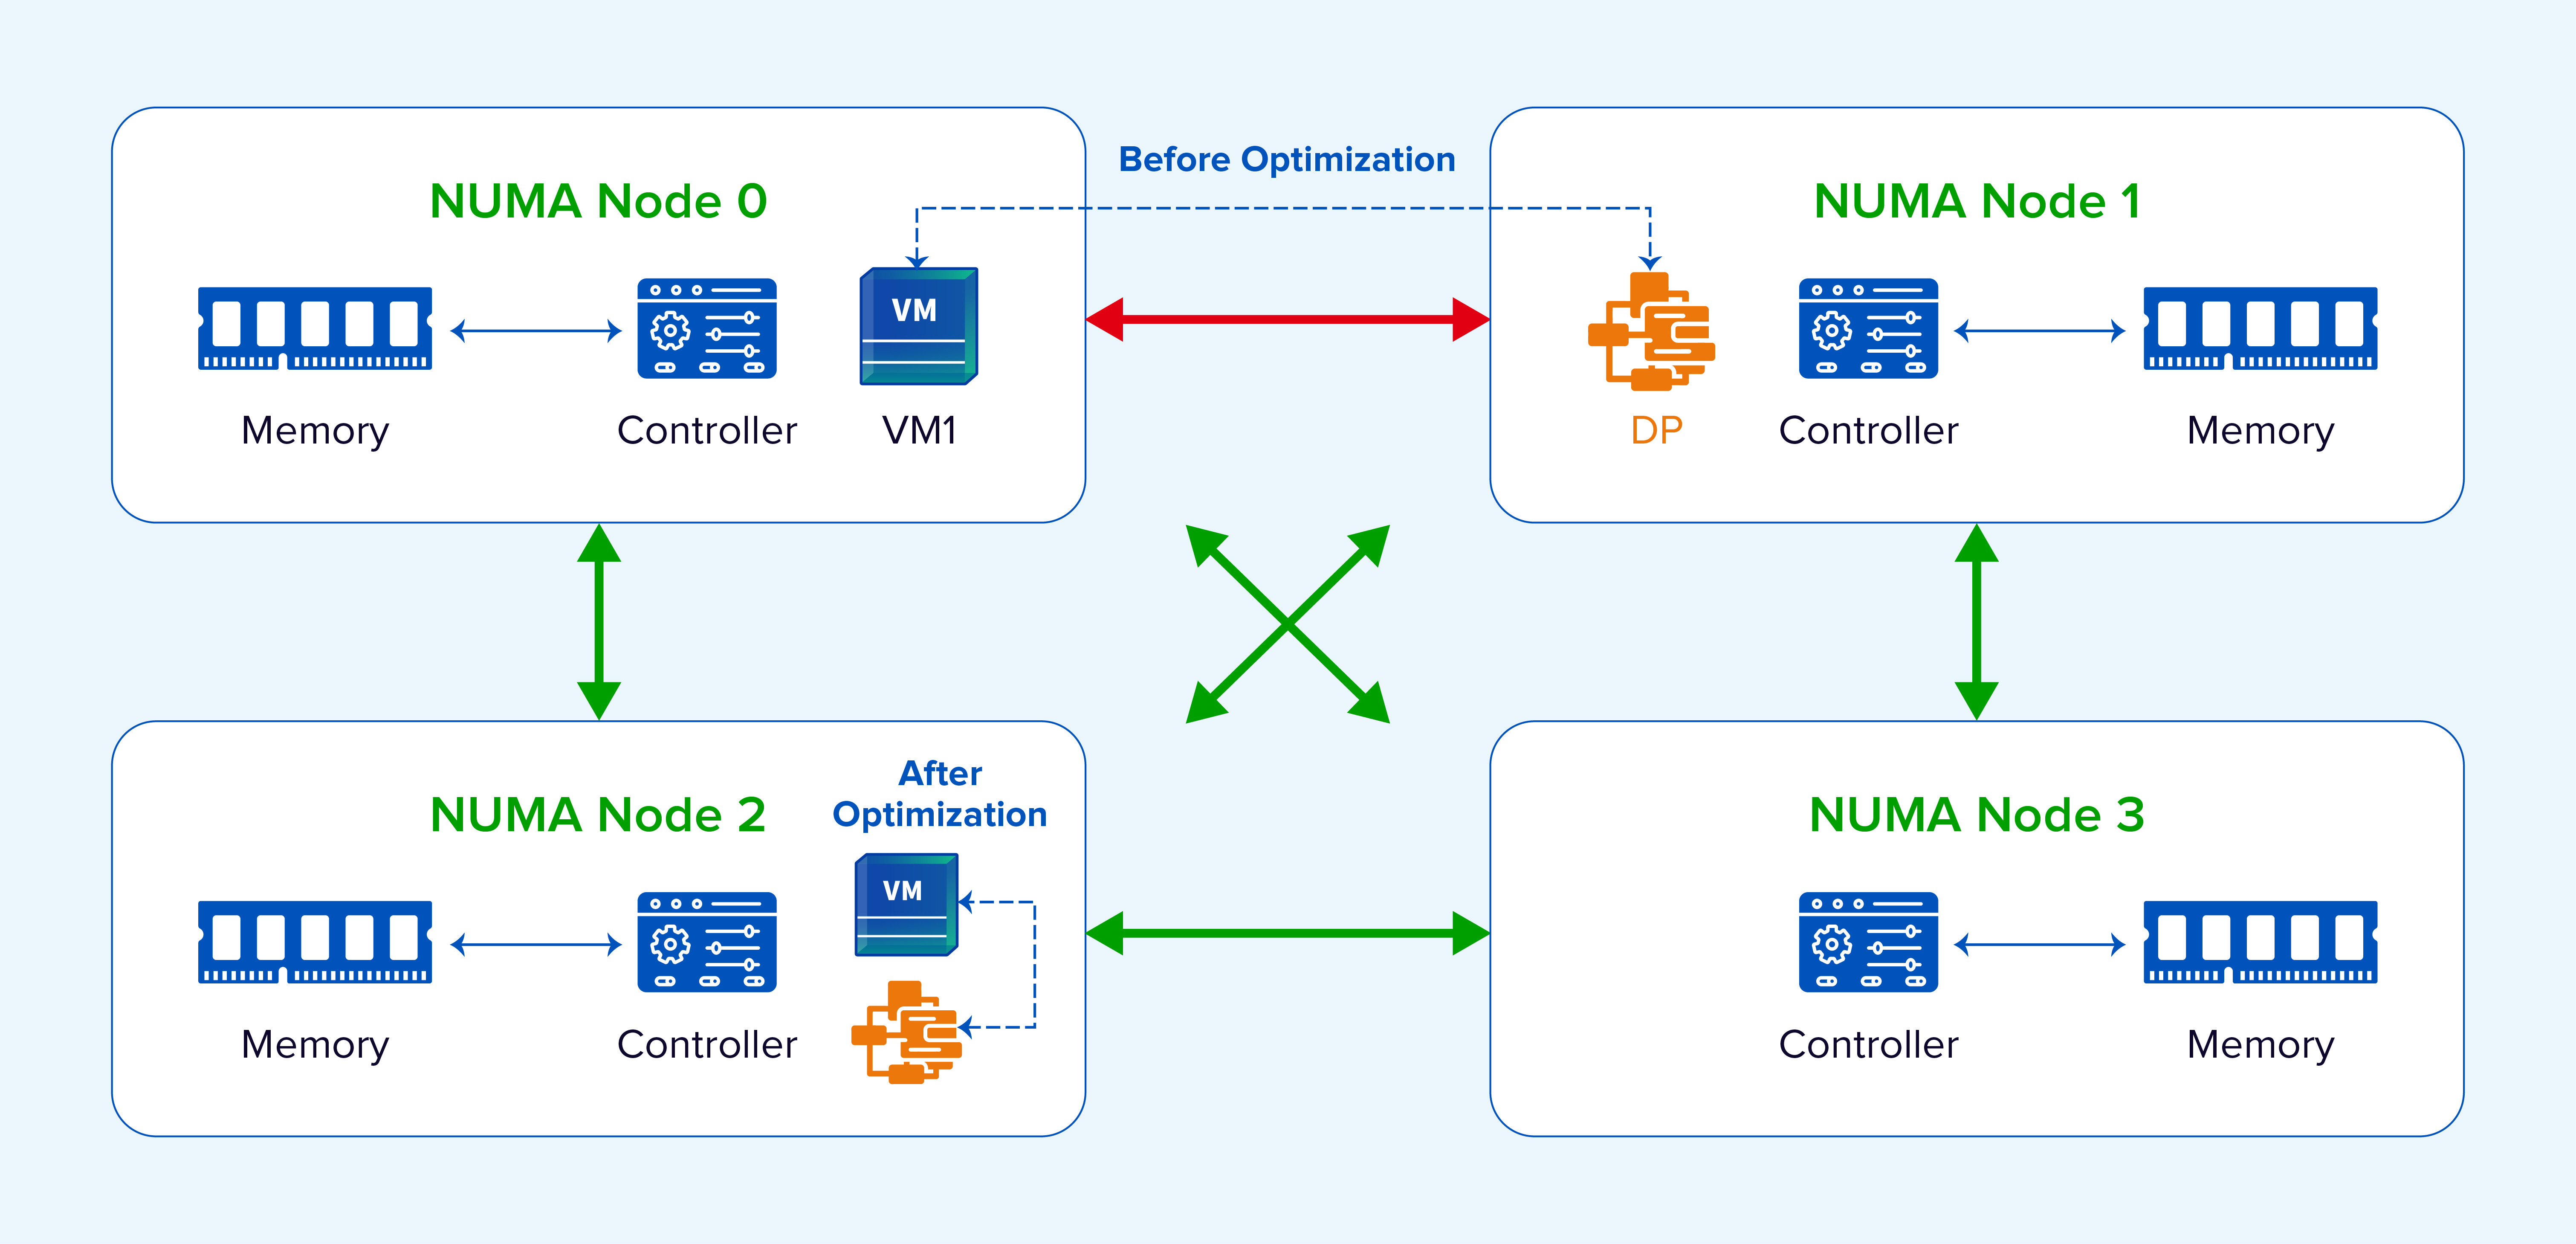
Figure 9. L'affinité VM et plan de données maintient le traitement proche de la mémoire locale.
Pour optimiser les avantages de l'architecture NUMA en matière de stockage, Sangfor place le vCPU, QEMU, libnfs, aSAN et les autres processus impliqués dans un chemin d'E/S complet sur le même nœud NUMA. Ceci évite les accès à la mémoire distante. Les pages mémoire de grande taille améliorent encore les performances d'accès à la mémoire, réduisent la surcharge de traitement et augmentent l'efficacité des flux d'E/S.
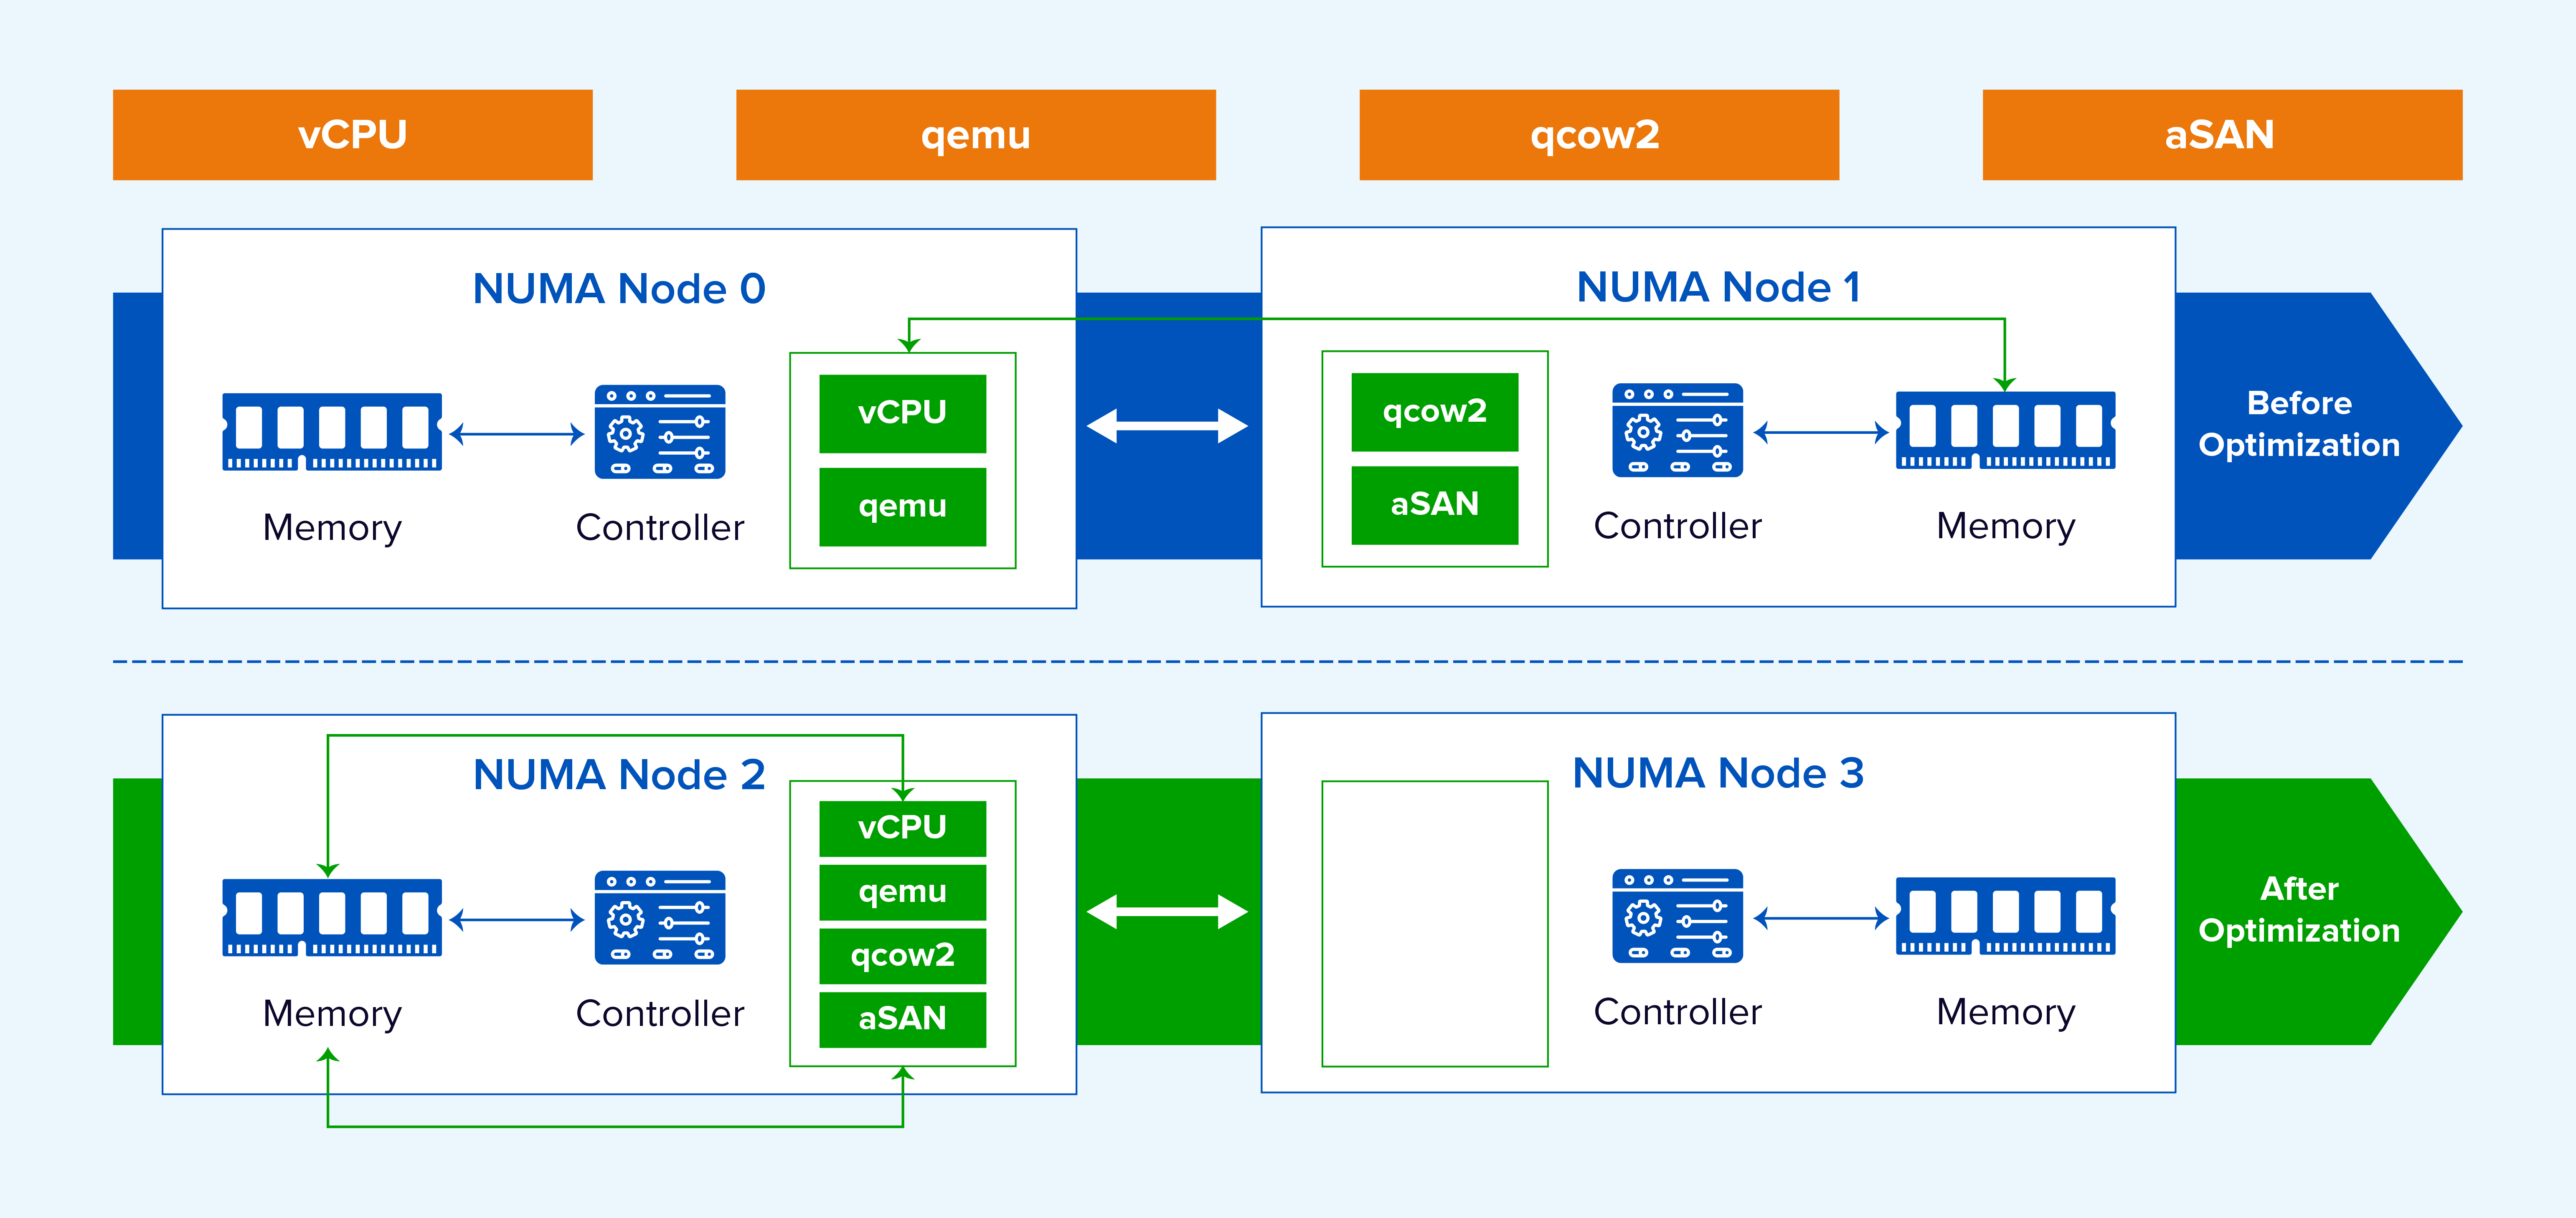
Figure 10. Placement NUMA coordonné sur le chemin d'E/S de stockage virtuel.
Les données transférées du tampon de la carte réseau vers le stockage virtuel doivent être traitées par les threads du processeur. À mesure que les performances du réseau augmentent, l'efficacité de la copie du tampon sur un seul cœur peut devenir un facteur limitant, tandis que l'accès inter-NUMA réduit encore davantage cette efficacité. Sangfor permet à plusieurs cœurs du processeur de traiter le trafic de la carte réseau et applique l'affinité NUMA. Ceci élimine le goulot d'étranglement lié au cœur unique, réduit la latence de transfert et améliore la concurrence. Lors de tests internes, les performances d'écriture de blocs volumineux dans les machines virtuelles avec une profondeur de file d'attente élevée ont été améliorées de plus de 20 %.
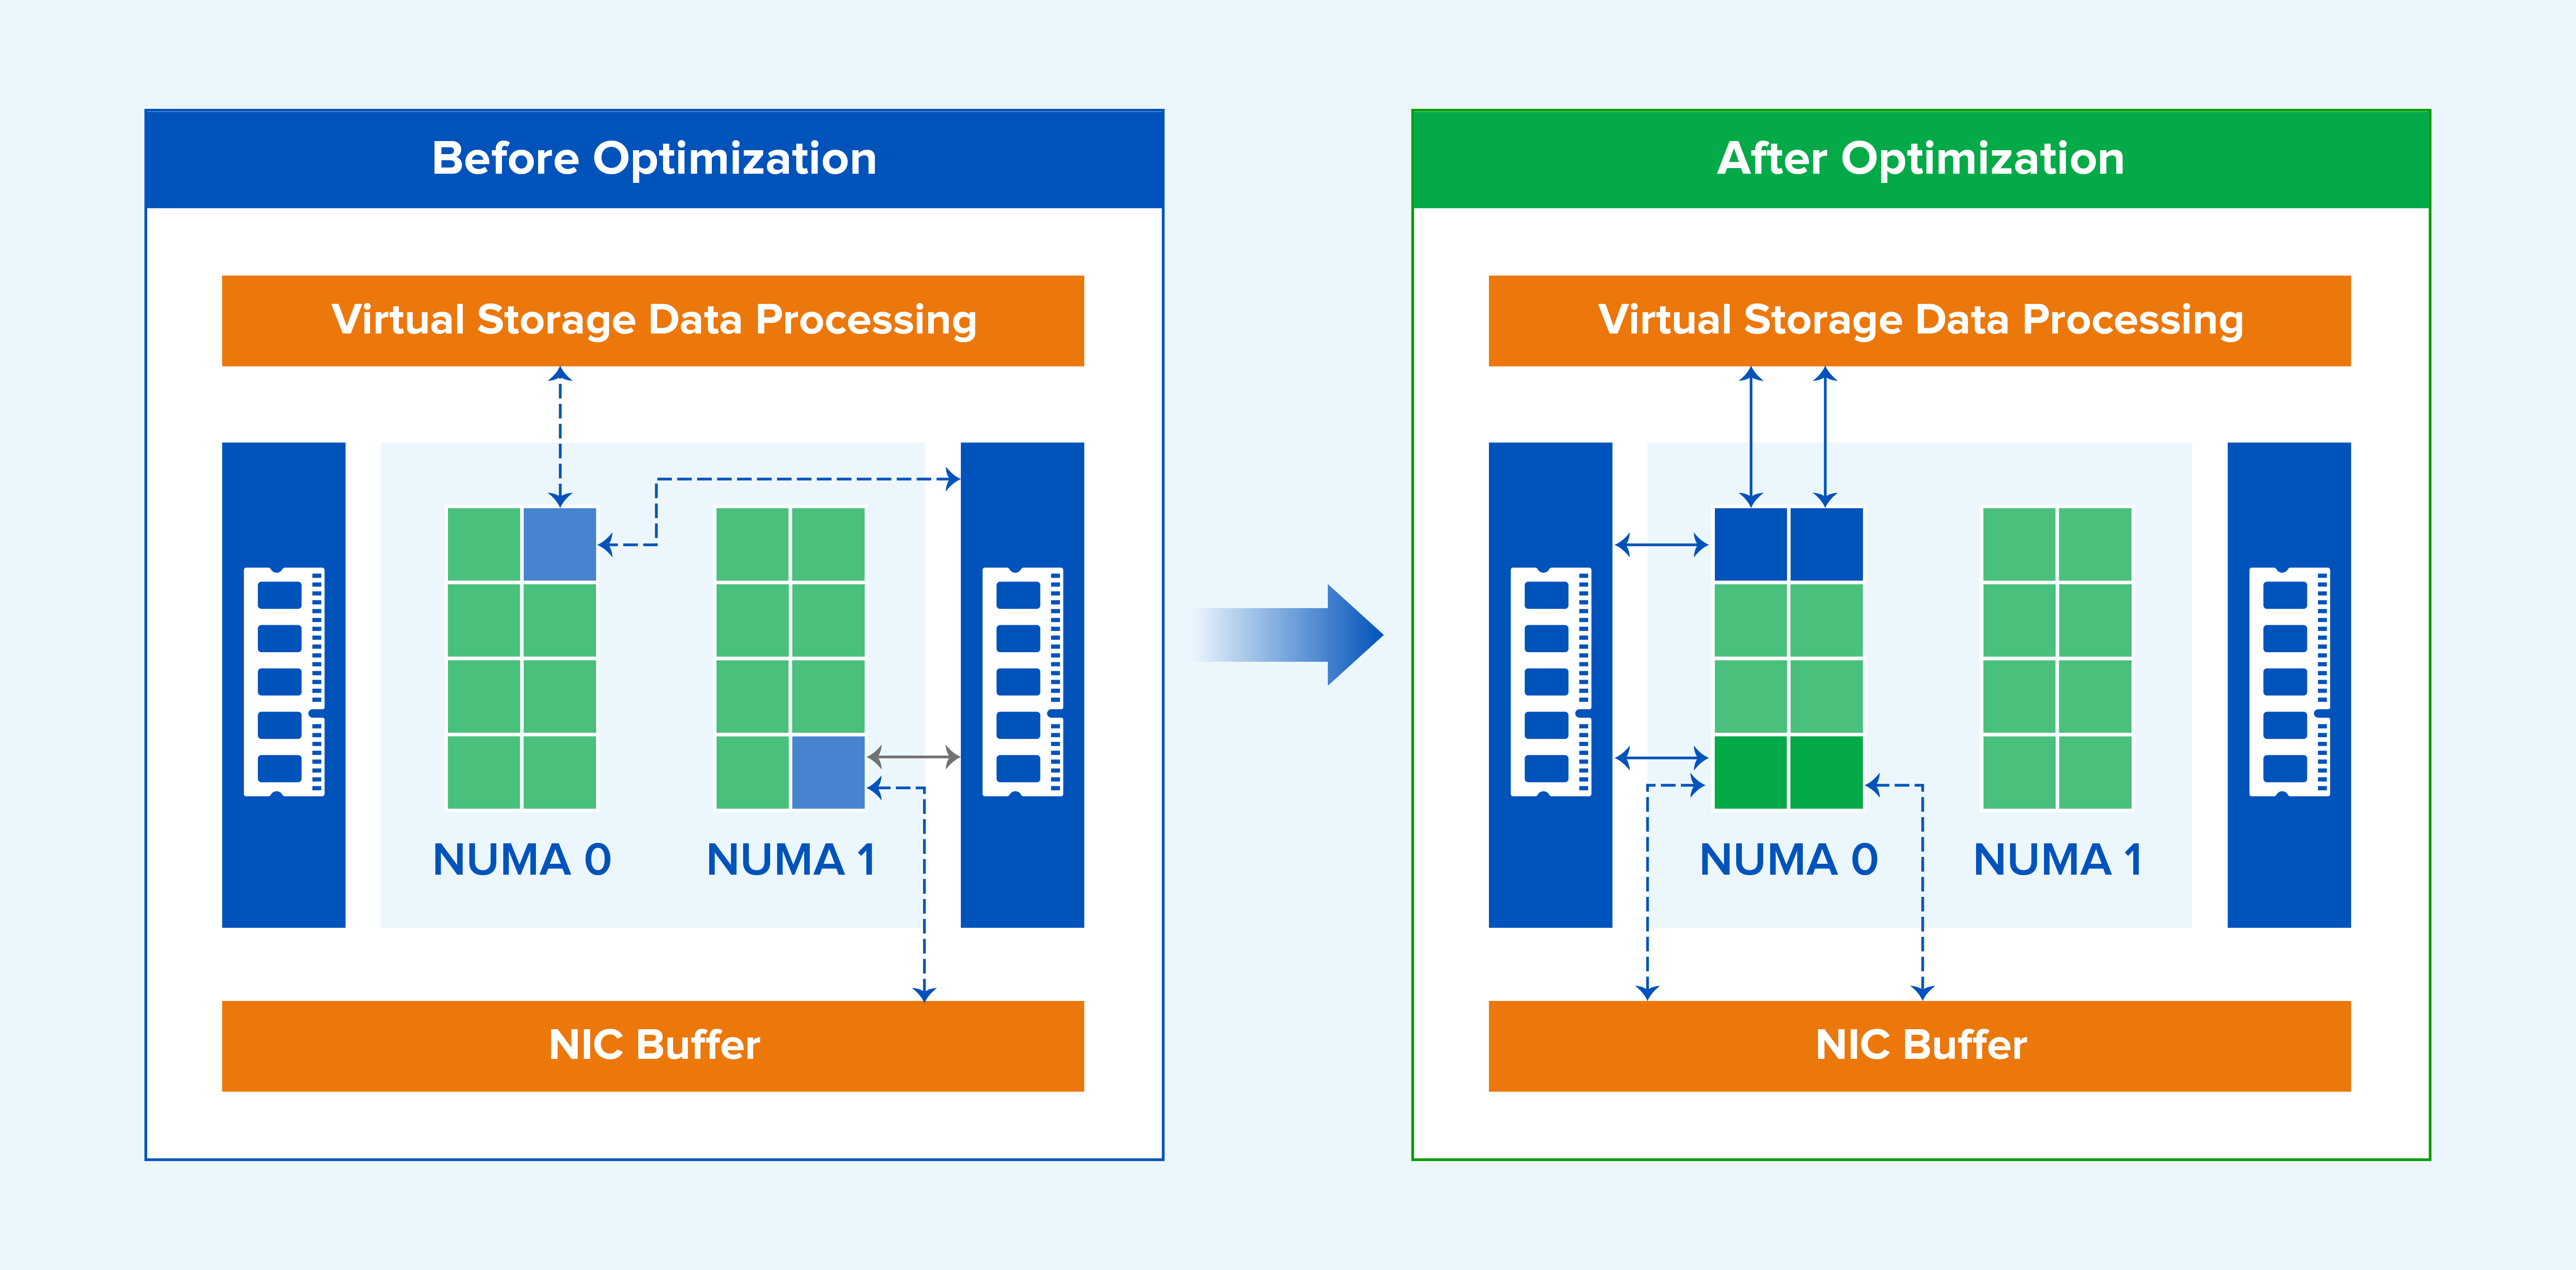
Figure 11. Traitement multicœur NUMA-affine entre les tampons NIC et le stockage virtuel.
3. Comparaison avec d'autres approches sectorielles
La prise en charge par l'industrie varie. Un fournisseur permet aux administrateurs de configurer le nœud NUMA sur lequel s'exécute chaque vCPU de machine virtuelle, un autre ne prend pas en charge cette fonctionnalité, et VMware prend en charge la planification NUMA adaptative.
Sangfor répartit automatiquement les vCPU des machines virtuelles sur les nœuds NUMA afin de réduire les accès à la mémoire distante. Comparée à la configuration manuelle de l'emplacement de chaque vCPU, la planification NUMA adaptative de Sangfor automatise le partitionnement et le placement des vCPU, équilibre leur utilisation entre les nœuds et améliore les performances globales.
Comparativement à une implémentation NUMA adaptative de base, Sangfor étend l'optimisation à la planification des services de stockage, à la reconnaissance des machines virtuelles prioritaires, aux plateformes serveur hétérogènes et à l'affinité réseau des machines virtuelles. Ces améliorations sont le fruit d'une collaboration entre les équipes de recherche et de développement cloud de Sangfor et sont conçues pour refléter le comportement réel des services de plateforme.
PARTIE 5. Résumé
La planification NUMA adaptative de Sangfor est optimisée pour de multiples scénarios d'infrastructure afin d'améliorer l'efficacité d'accès à la mémoire des applications :
- Partitionnez et placez de manière adaptative les vCPU de la VM sur les nœuds NUMA afin de réduire l'accès à la mémoire distante.
- Migrez les machines virtuelles entre les nœuds NUMA afin de maintenir une utilisation équilibrée.
- Identifiez les machines virtuelles prioritaires et conservez-les sur des nœuds moins sollicités, réduisant ainsi la concurrence pour le processeur, la bande passante mémoire et le cache.
- Pour les serveurs comportant de nombreux nœuds NUMA et des distances inter-nœuds différentes, identifiez la distance topologique et placez de préférence les ressources vNUMA associées sur des nœuds NUMA physiques proches.
- Fournir une option d'affinité réseau pour les machines virtuelles qui place une machine virtuelle sur le même nœud NUMA que le plan de données réseau afin d'améliorer les performances de transfert.
- Appliquez la planification prenant en compte NUMA non seulement aux machines virtuelles, mais aussi aux services de stockage.
Exemple de test UnixBench
UnixBench est un outil d'analyse comparative largement utilisé pour les systèmes de type Unix, notamment UNIX, BSD et Linux. Il mesure plusieurs aspects des performances du système, tels que le processeur, le système de fichiers, la mémoire et les processus.
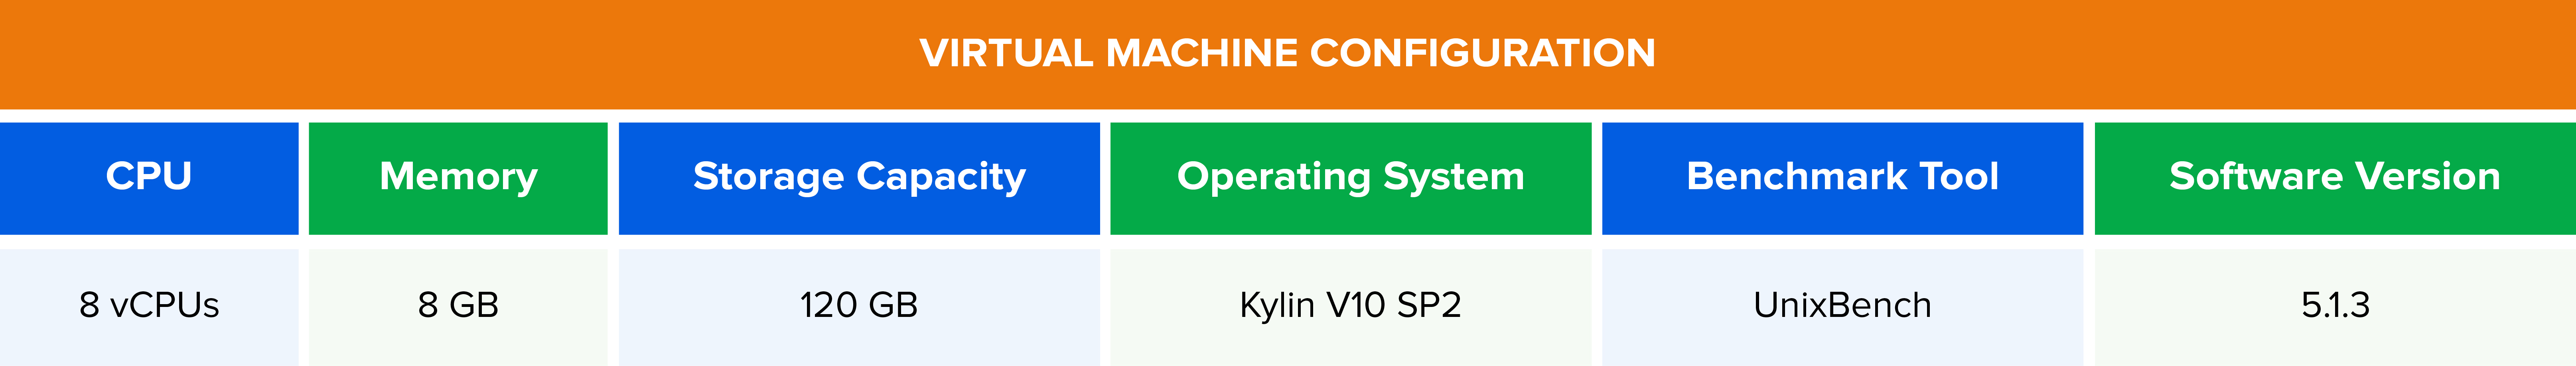
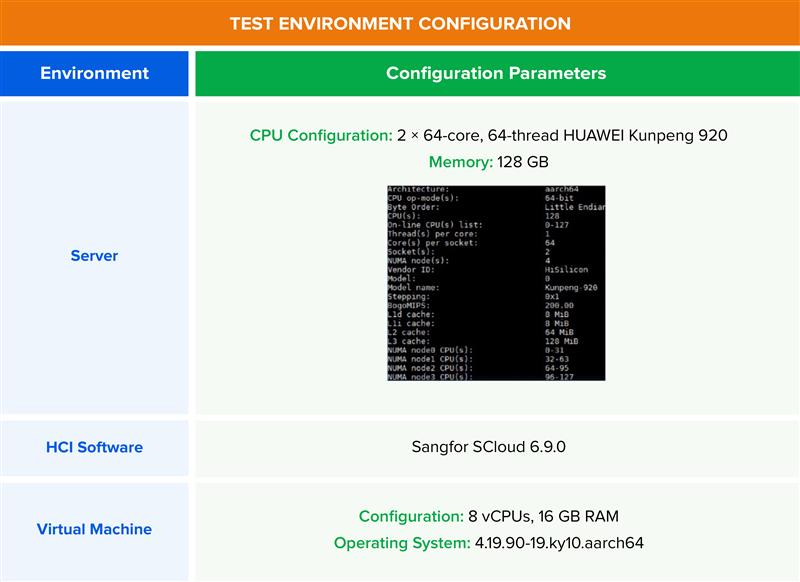
Figure 12. Configuration de la machine virtuelle pour les tests UnixBench.
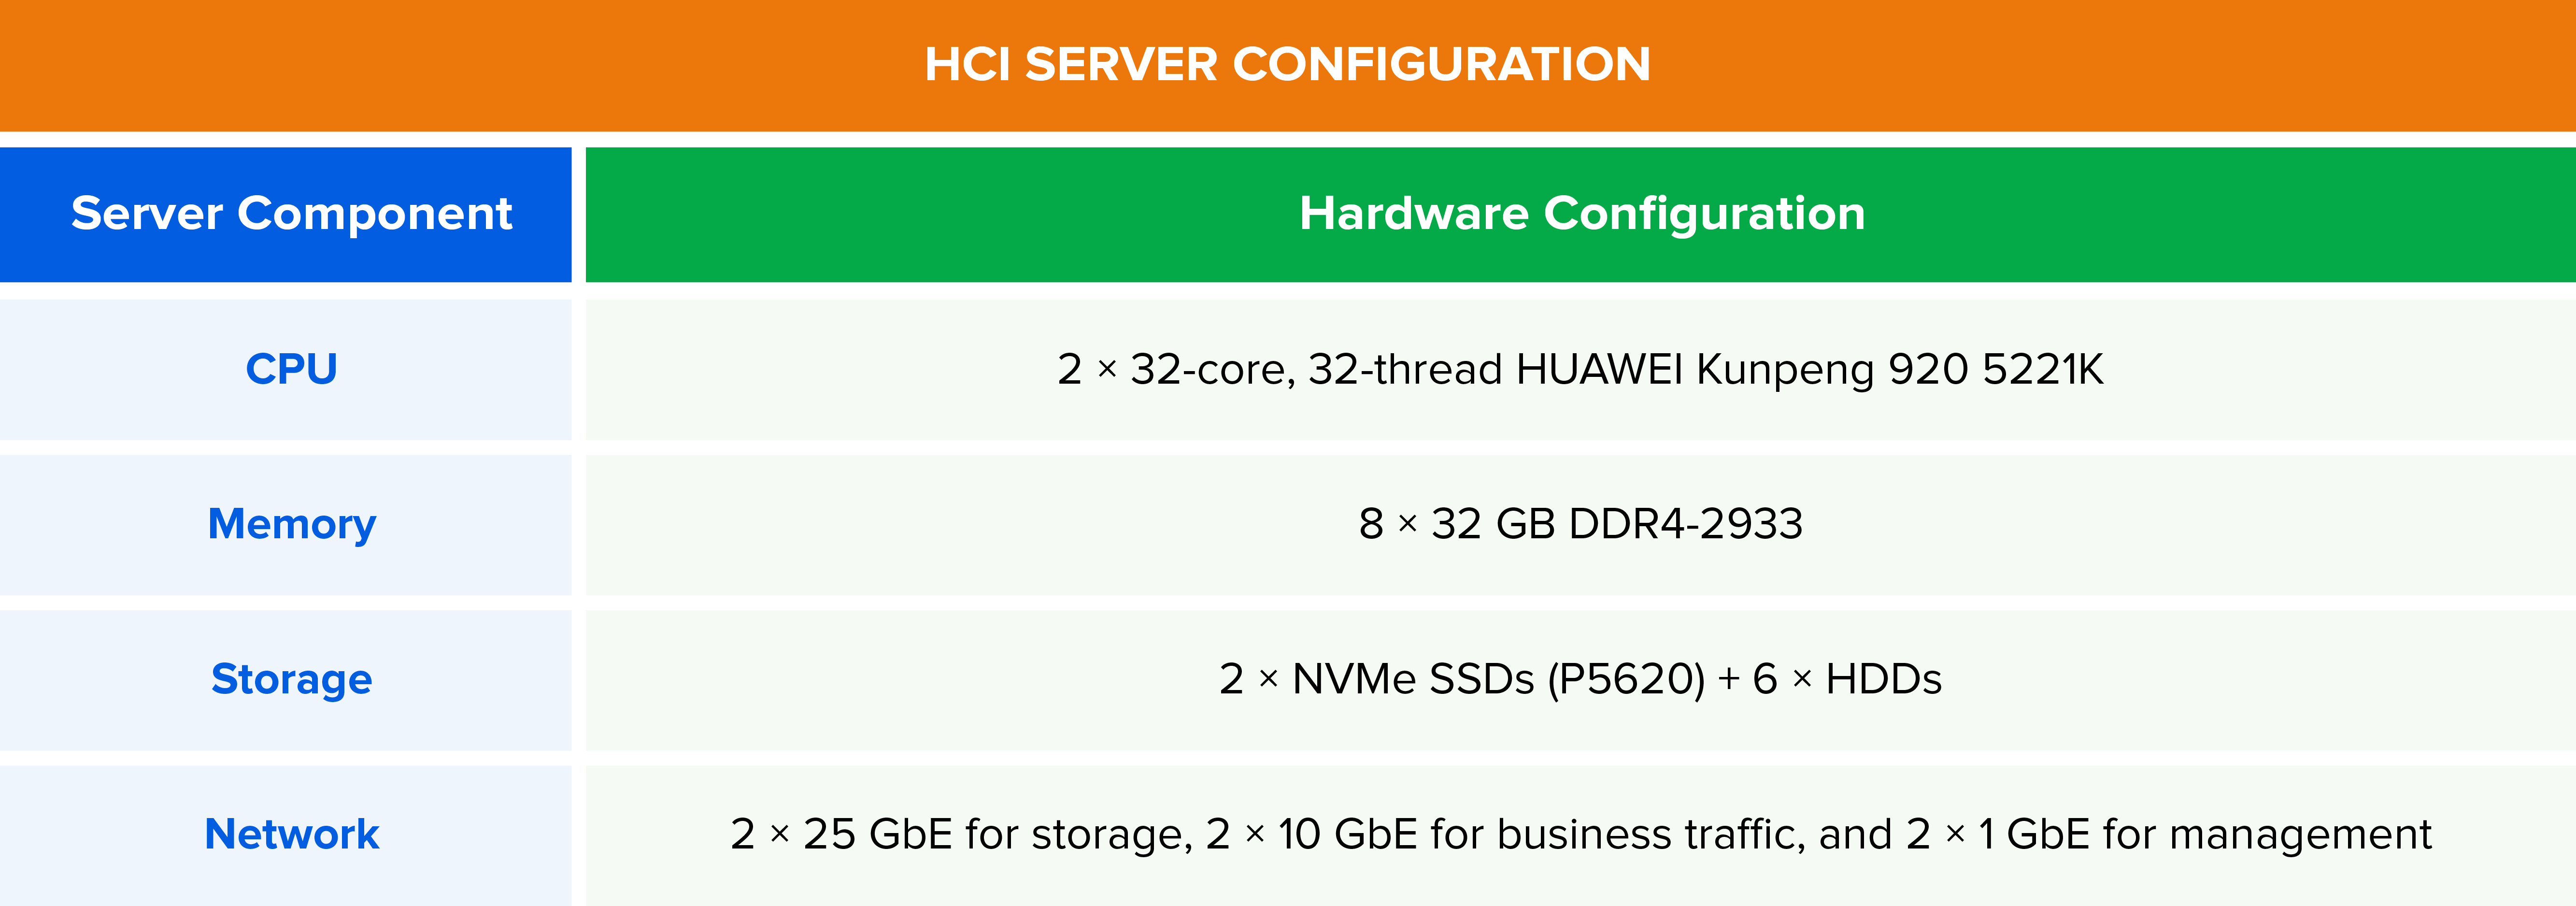
Figure 13. Configuration matérielle du serveur HCI pour les tests UnixBench.
Résultats des tests : Sous Sangfor HCI 6.9.0, avec NUMA activé, le score UnixBench global pour 6 machines virtuelles exécutées simultanément sur le même hôte était supérieur de 20,2 % à celui de la plateforme de comparaison anonymisée. Pour 8 machines virtuelles simultanées, le score global était supérieur de 34,17 %.
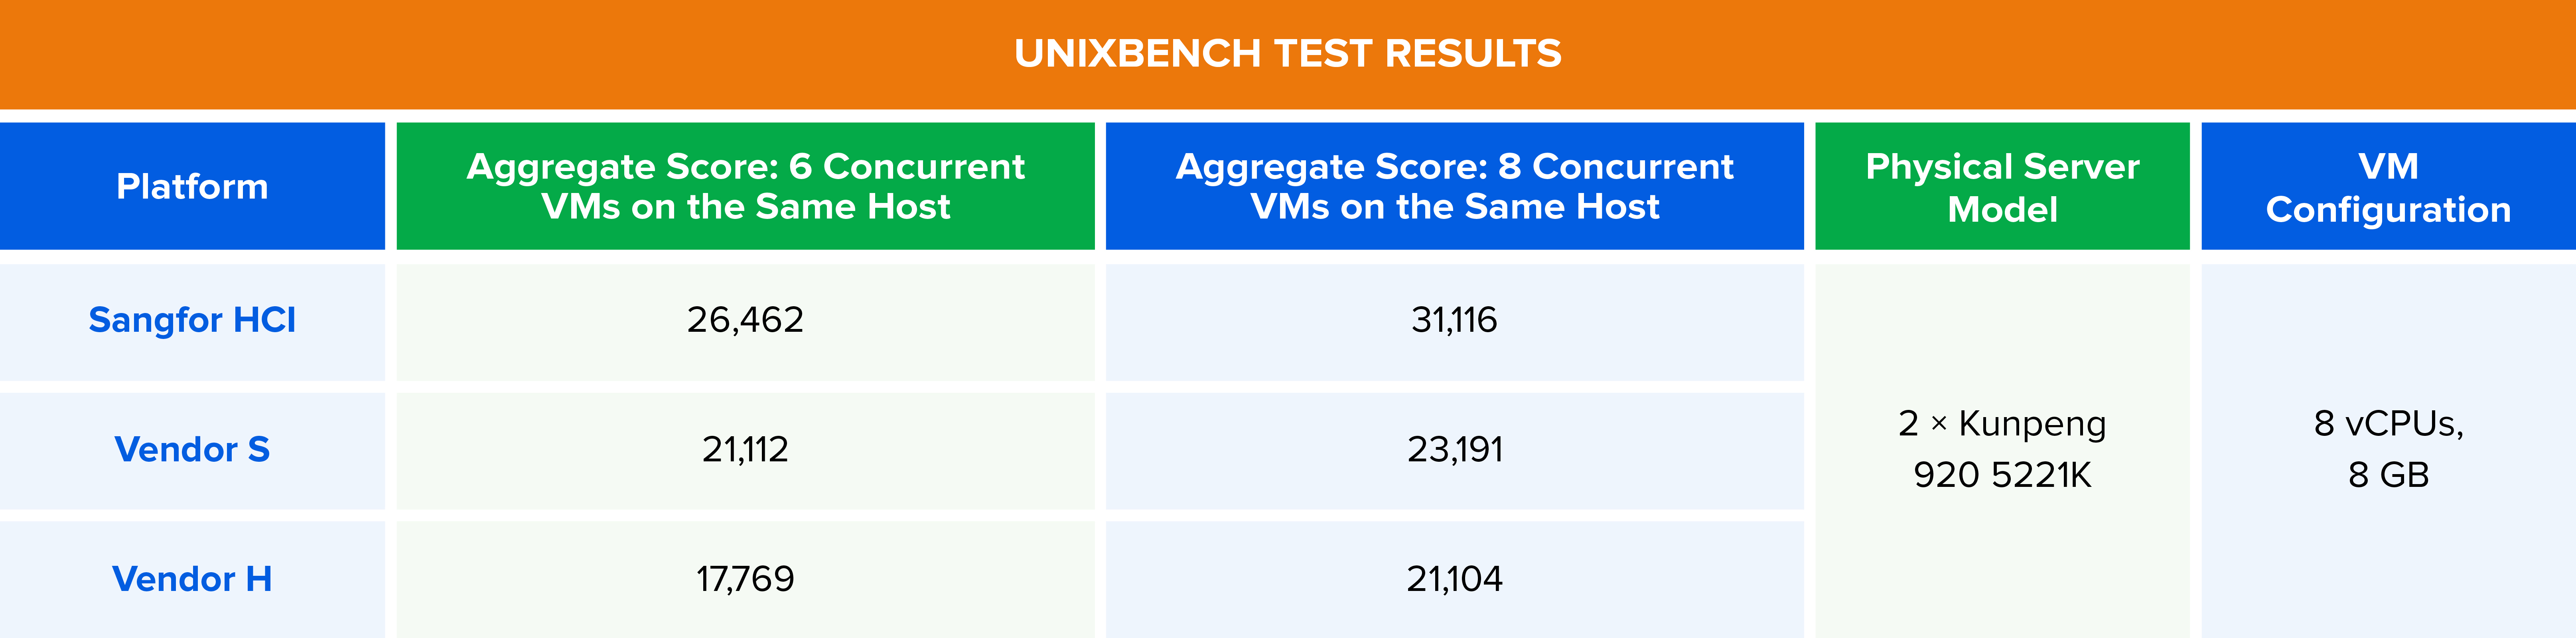
Figure 14. Résultats comparatifs du benchmark UnixBench sous charges de travail de machines virtuelles simultanées.
Les observations comparatives présentées dans cet article reflètent des environnements de test internes spécifiques à Sangfor et sont fournies à titre d'illustration technique. Les résultats réels varient en fonction du matériel, de la version du logiciel, de la configuration et de la charge de travail. Il est recommandé aux clients de valider les applications représentatives par rapport à leurs propres objectifs de niveau de service.

