
Khi ngày càng nhiều tổ chức chuyển các khối lượng công việc quan trọng của doanh nghiệp lên cơ sở hạ tầng ảo hóa, siêu hội tụ và điện toán đám mây, hiệu năng trong điều kiện xử lý đồng thời nhiều yêu cầu đã trở thành ưu tiên hàng đầu. Đối với các nhóm đang đánh giá một giải pháp thay thế VMware , câu hỏi không chỉ đơn giản là liệu nền tảng khác có thể cung cấp chức năng tương tự hay không, mà còn là liệu nó có thể duy trì độ trễ, thông lượng và độ ổn định cần thiết cho các hệ thống kinh doanh cốt lõi hay không.
Thách thức này đặc biệt rõ rệt trong các ứng dụng đòi hỏi nhiều bộ nhớ, bao gồm giao dịch tần suất cao và quản lý rủi ro trong dịch vụ tài chính, hệ thống hồ sơ sức khỏe điện tử trong chăm sóc sức khỏe và hệ thống quản lý kho trong logistics. Nhu cầu truy cập bộ nhớ ngày càng tăng của chúng có liên quan chặt chẽ đến các thành phần phụ trợ như Redis, Apache Spark, SAP HANA và các công cụ hoặc mô hình AI. Ví dụ, Redis là một cơ sở dữ liệu trong bộ nhớ mà hiệu suất của nó bị ảnh hưởng trực tiếp bởi tốc độ truy cập bộ nhớ.
NUMA hiện là kiến trúc CPU máy chủ phổ biến. Do đó, việc cải thiện hiệu quả truy cập bộ nhớ dưới kiến trúc NUMA là một khía cạnh quan trọng trong việc tối ưu hóa hiệu năng ảo hóa. Bài viết này giải thích các công nghệ tối ưu hóa NUMA của Sangfor và cách chúng giúp các nền tảng ảo hóa hỗ trợ các khối lượng công việc quan trọng, có tính đồng thời cao trong quá trình thay thế VMware .
PHẦN 1. Kiến trúc nền tảng NUMA
Các hệ thống máy tính đời đầu thường sử dụng một bộ xử lý duy nhất cho tất cả các tác vụ tính toán. Khi các ứng dụng trở nên phức tạp và đòi hỏi cao hơn, một bộ xử lý đơn lẻ không còn đáp ứng được yêu cầu tính toán hiệu năng cao, và các hệ thống dần dần phát triển theo kiến trúc đa lõi.
Các hệ thống đa lõi truyền thống thường sử dụng xử lý đa luồng đối xứng (SMP). Trong SMP, tất cả các bộ xử lý đều có trạng thái ngang nhau và quyền truy cập bộ nhớ như nhau. Bất kỳ luồng nào cũng có thể chạy trên bất kỳ bộ xử lý nào, cho phép cân bằng tải hiệu quả và cải thiện hiệu suất cũng như thông lượng tổng thể. Tuy nhiên, vì nhiều lõi chia sẻ cùng một bus để truy cập bộ nhớ, bus có thể trở thành nút thắt cổ chai khi số lượng lõi tăng lên, hạn chế khả năng mở rộng và hiệu suất.
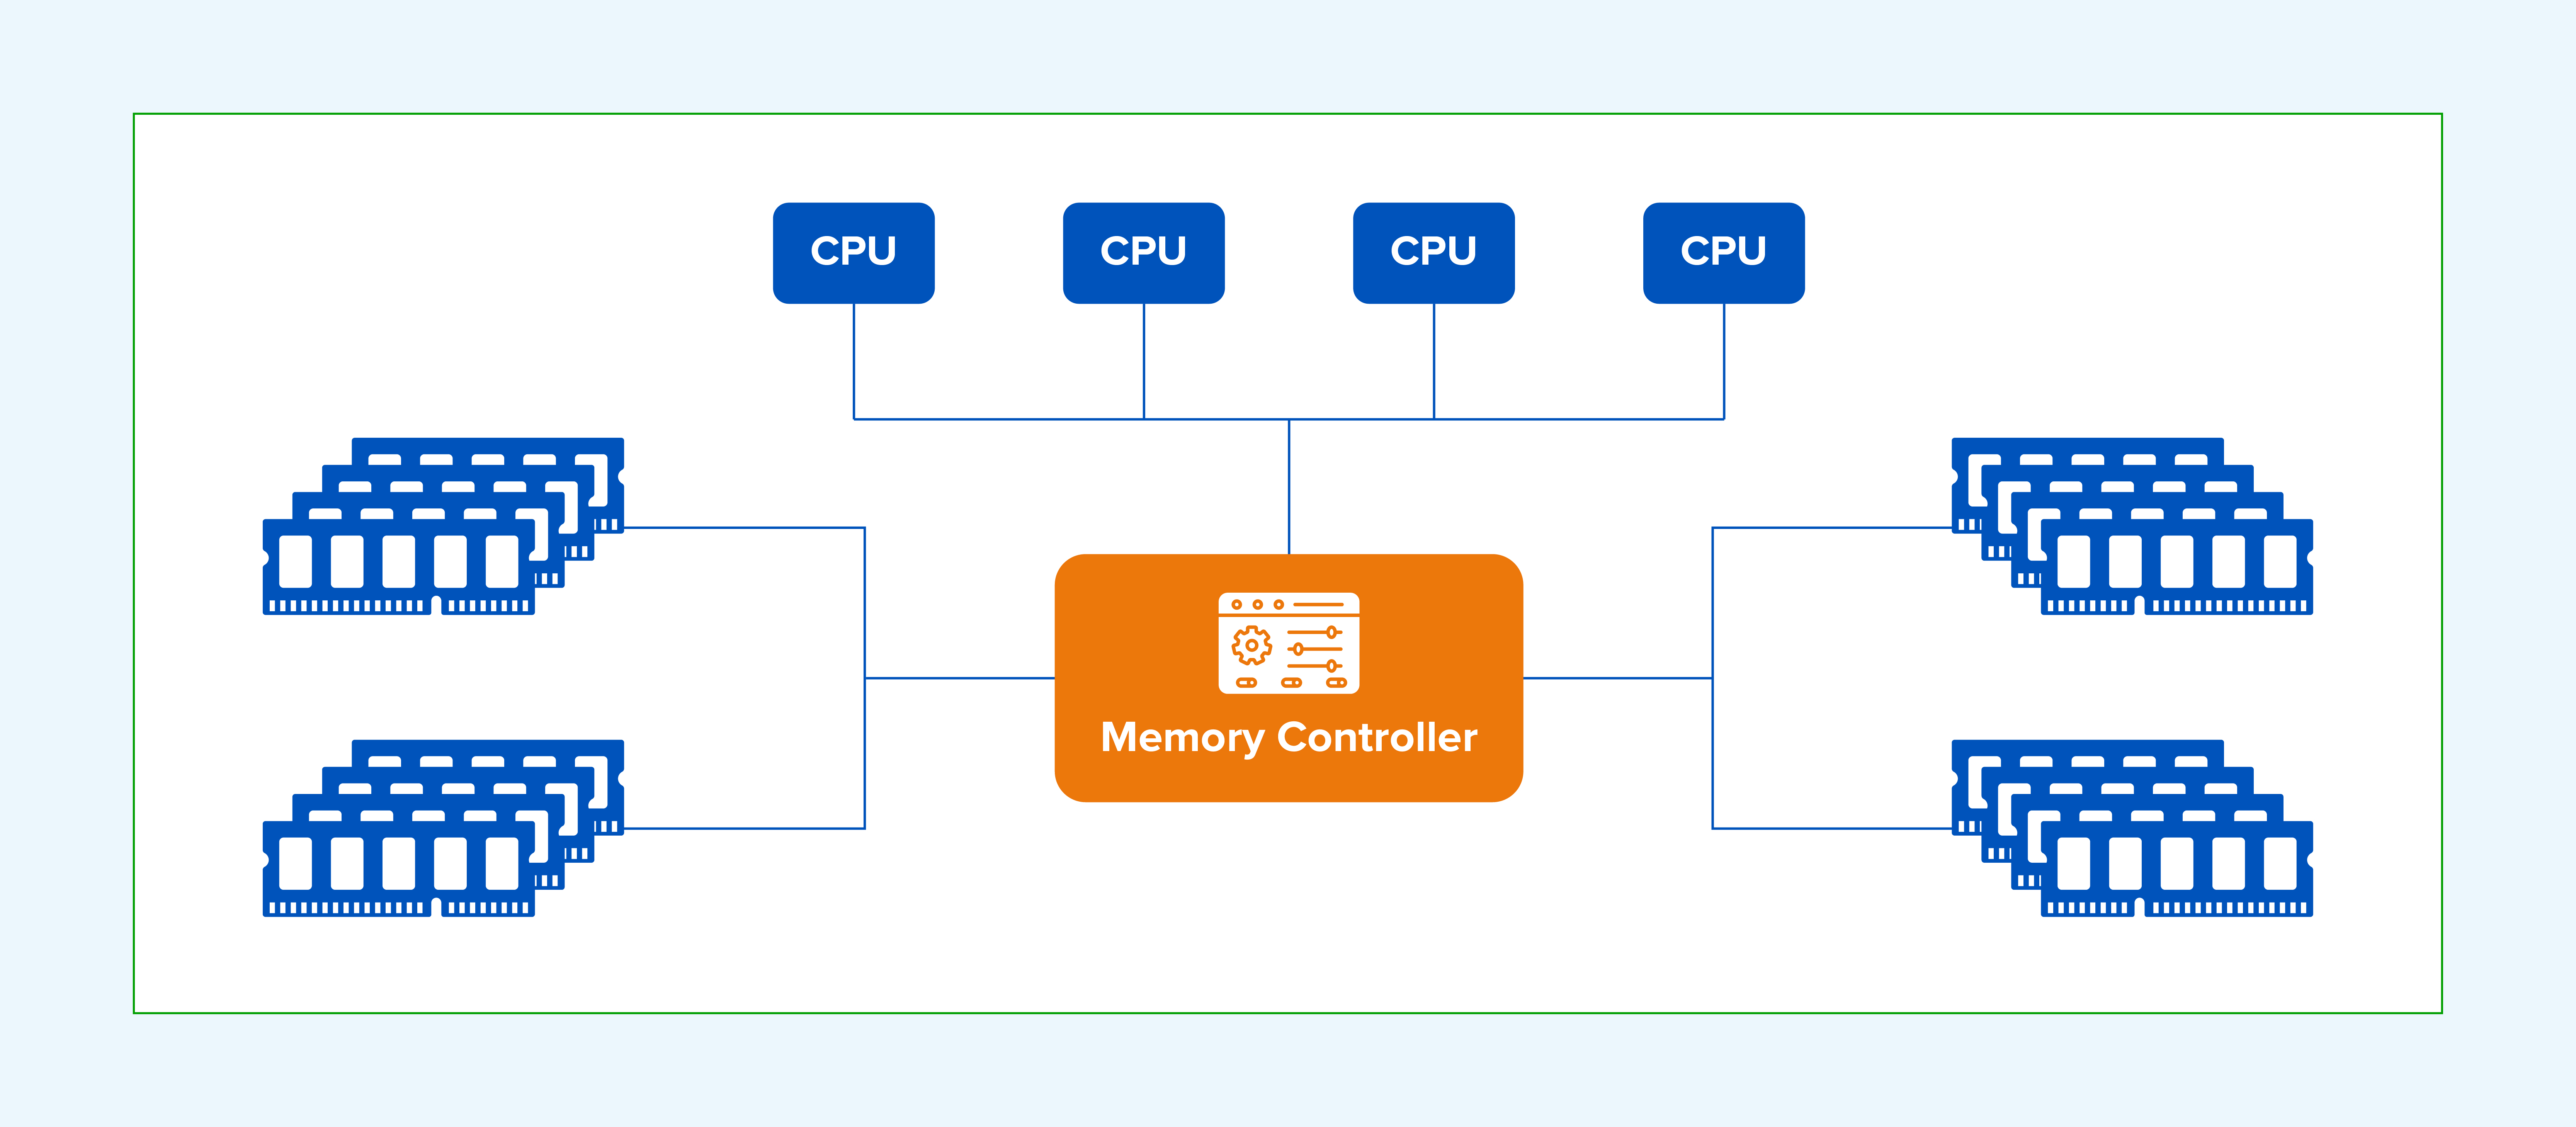
Hình 1: Nút thắt cổ chai trong truy cập bộ nhớ trên bus chia sẻ trong các kiến trúc SMP truyền thống.
Kiến trúc NUMA giải quyết nút thắt cổ chai truy cập bộ nhớ của hệ thống đa xử lý (SMP). Trong kiến trúc NUMA, hệ thống được chia thành nhiều nút, mỗi nút chứa một hoặc nhiều bộ xử lý, bộ nhớ cục bộ và thiết bị I/O. Các nút giao tiếp với nhau thông qua các kết nối tốc độ cao—chẳng hạn như AMD HyperTransport hoặc Intel QuickPath Interconnect (QPI)—cho phép các bộ xử lý truy cập bộ nhớ cục bộ trước, giúp giảm độ trễ truy cập bộ nhớ và cải thiện hiệu suất hệ thống đa xử lý.
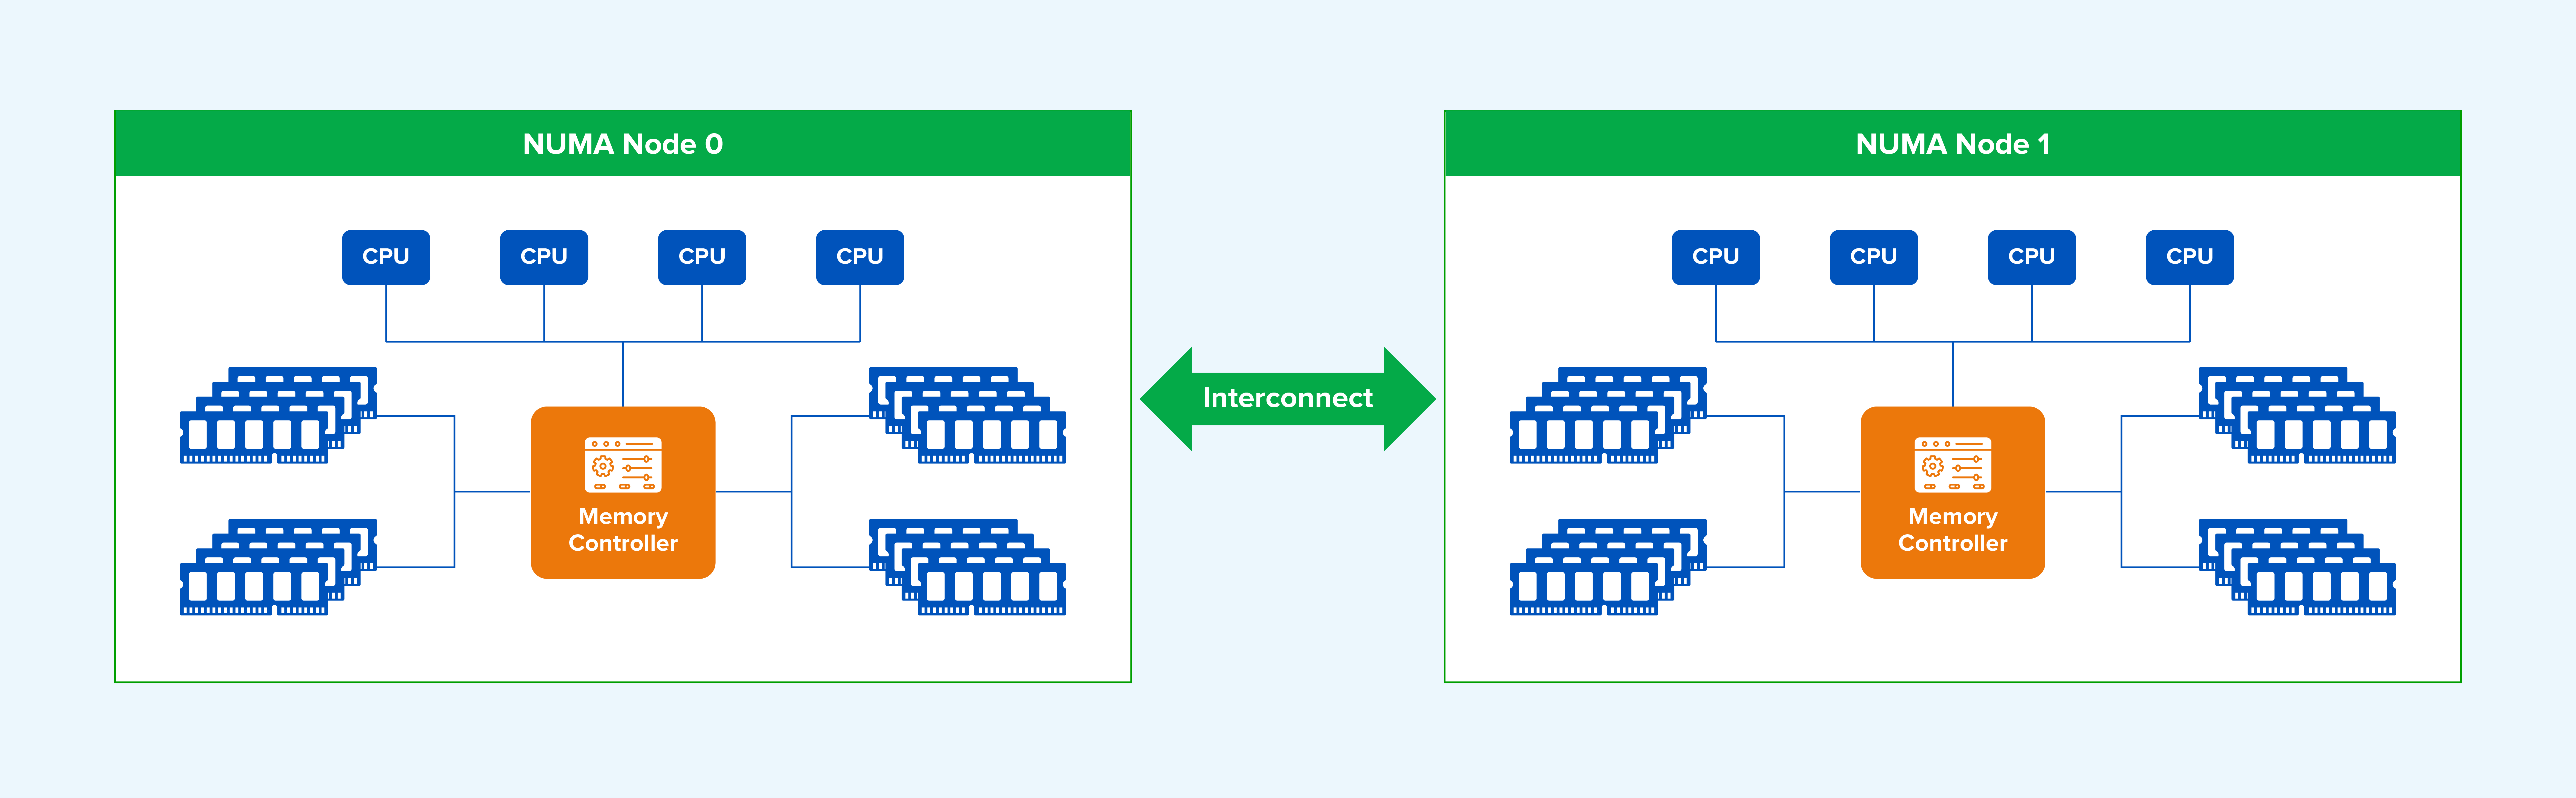
Hình 2: Kiến trúc NUMA đa nút với phân bổ CPU và bộ nhớ cục bộ cho từng nút.
Hệ thống NUMA bao gồm ba loại nút:
- Nút cục bộ: Đối với các CPU nằm trong một nút nhất định, nút đó được gọi là nút cục bộ.
- Nút lân cận: Một nút nằm liền kề với nút cục bộ.
- Nút từ xa: Một nút không nằm trong vùng lân cận cũng không phải là nút cục bộ.
Tốc độ truy cập CPU khác nhau tùy thuộc vào loại nút. Truy cập bộ nhớ cục bộ nhanh nhất, trong khi bộ nhớ từ xa chậm nhất. Nói chung, tốc độ truy cập bộ nhớ sẽ chậm hơn khi khoảng cách topo tăng lên.
Trong bài viết “NUMA: Tổng quan”, Tiến sĩ Christoph Lameter lưu ý rằng, trên một máy chủ hai nút cao cấp vào năm 2013, độ trễ truy cập bộ nhớ cục bộ ngẫu nhiên là khoảng 100 ns, trong khi truy cập bộ nhớ từ xa làm tăng thêm khoảng 50% độ trễ.
PHẦN 2. Những thách thức do NUMA đặt ra
Trong Linux, luồng (thread) là đơn vị cơ bản của việc lập lịch CPU và tương ứng với một tác vụ trong hàng đợi thực thi CPU. Nhân hệ điều hành sẽ chọn một CPU tương đối rảnh rỗi cho mỗi tác vụ. Vì tải CPU thay đổi động, nhân hệ điều hành sử dụng cân bằng tải để chuyển các tác vụ sang các CPU ít bận rộn hơn. Theo mặc định, một tác vụ do đó có thể di chuyển giữa các CPU khác nhau.
Theo kiến trúc NUMA, một tác vụ có thể di chuyển từ CPU trên Node 1 sang CPU trên Node 2 trong khi vẫn tiếp tục truy cập bộ nhớ được cấp phát trên Node 1, dẫn đến truy cập chéo giữa các node. Cơ chế cân bằng NUMA của Linux định kỳ di chuyển các tác vụ hoặc trang bộ nhớ về phía node cục bộ, nhưng nó không thể loại bỏ hoàn toàn việc truy cập bộ nhớ từ xa.
Trong môi trường ảo hóa, mỗi vCPU của máy ảo tương ứng với một luồng hệ điều hành của máy chủ. Nếu nhiều luồng vCPU chạy trên các nút NUMA khác nhau trong khi chia sẻ bộ nhớ, hoặc di chuyển giữa các nút, máy ảo có thể truy cập bộ nhớ trên các nút NUMA khác nhau và gặp phải độ trễ cao hơn.
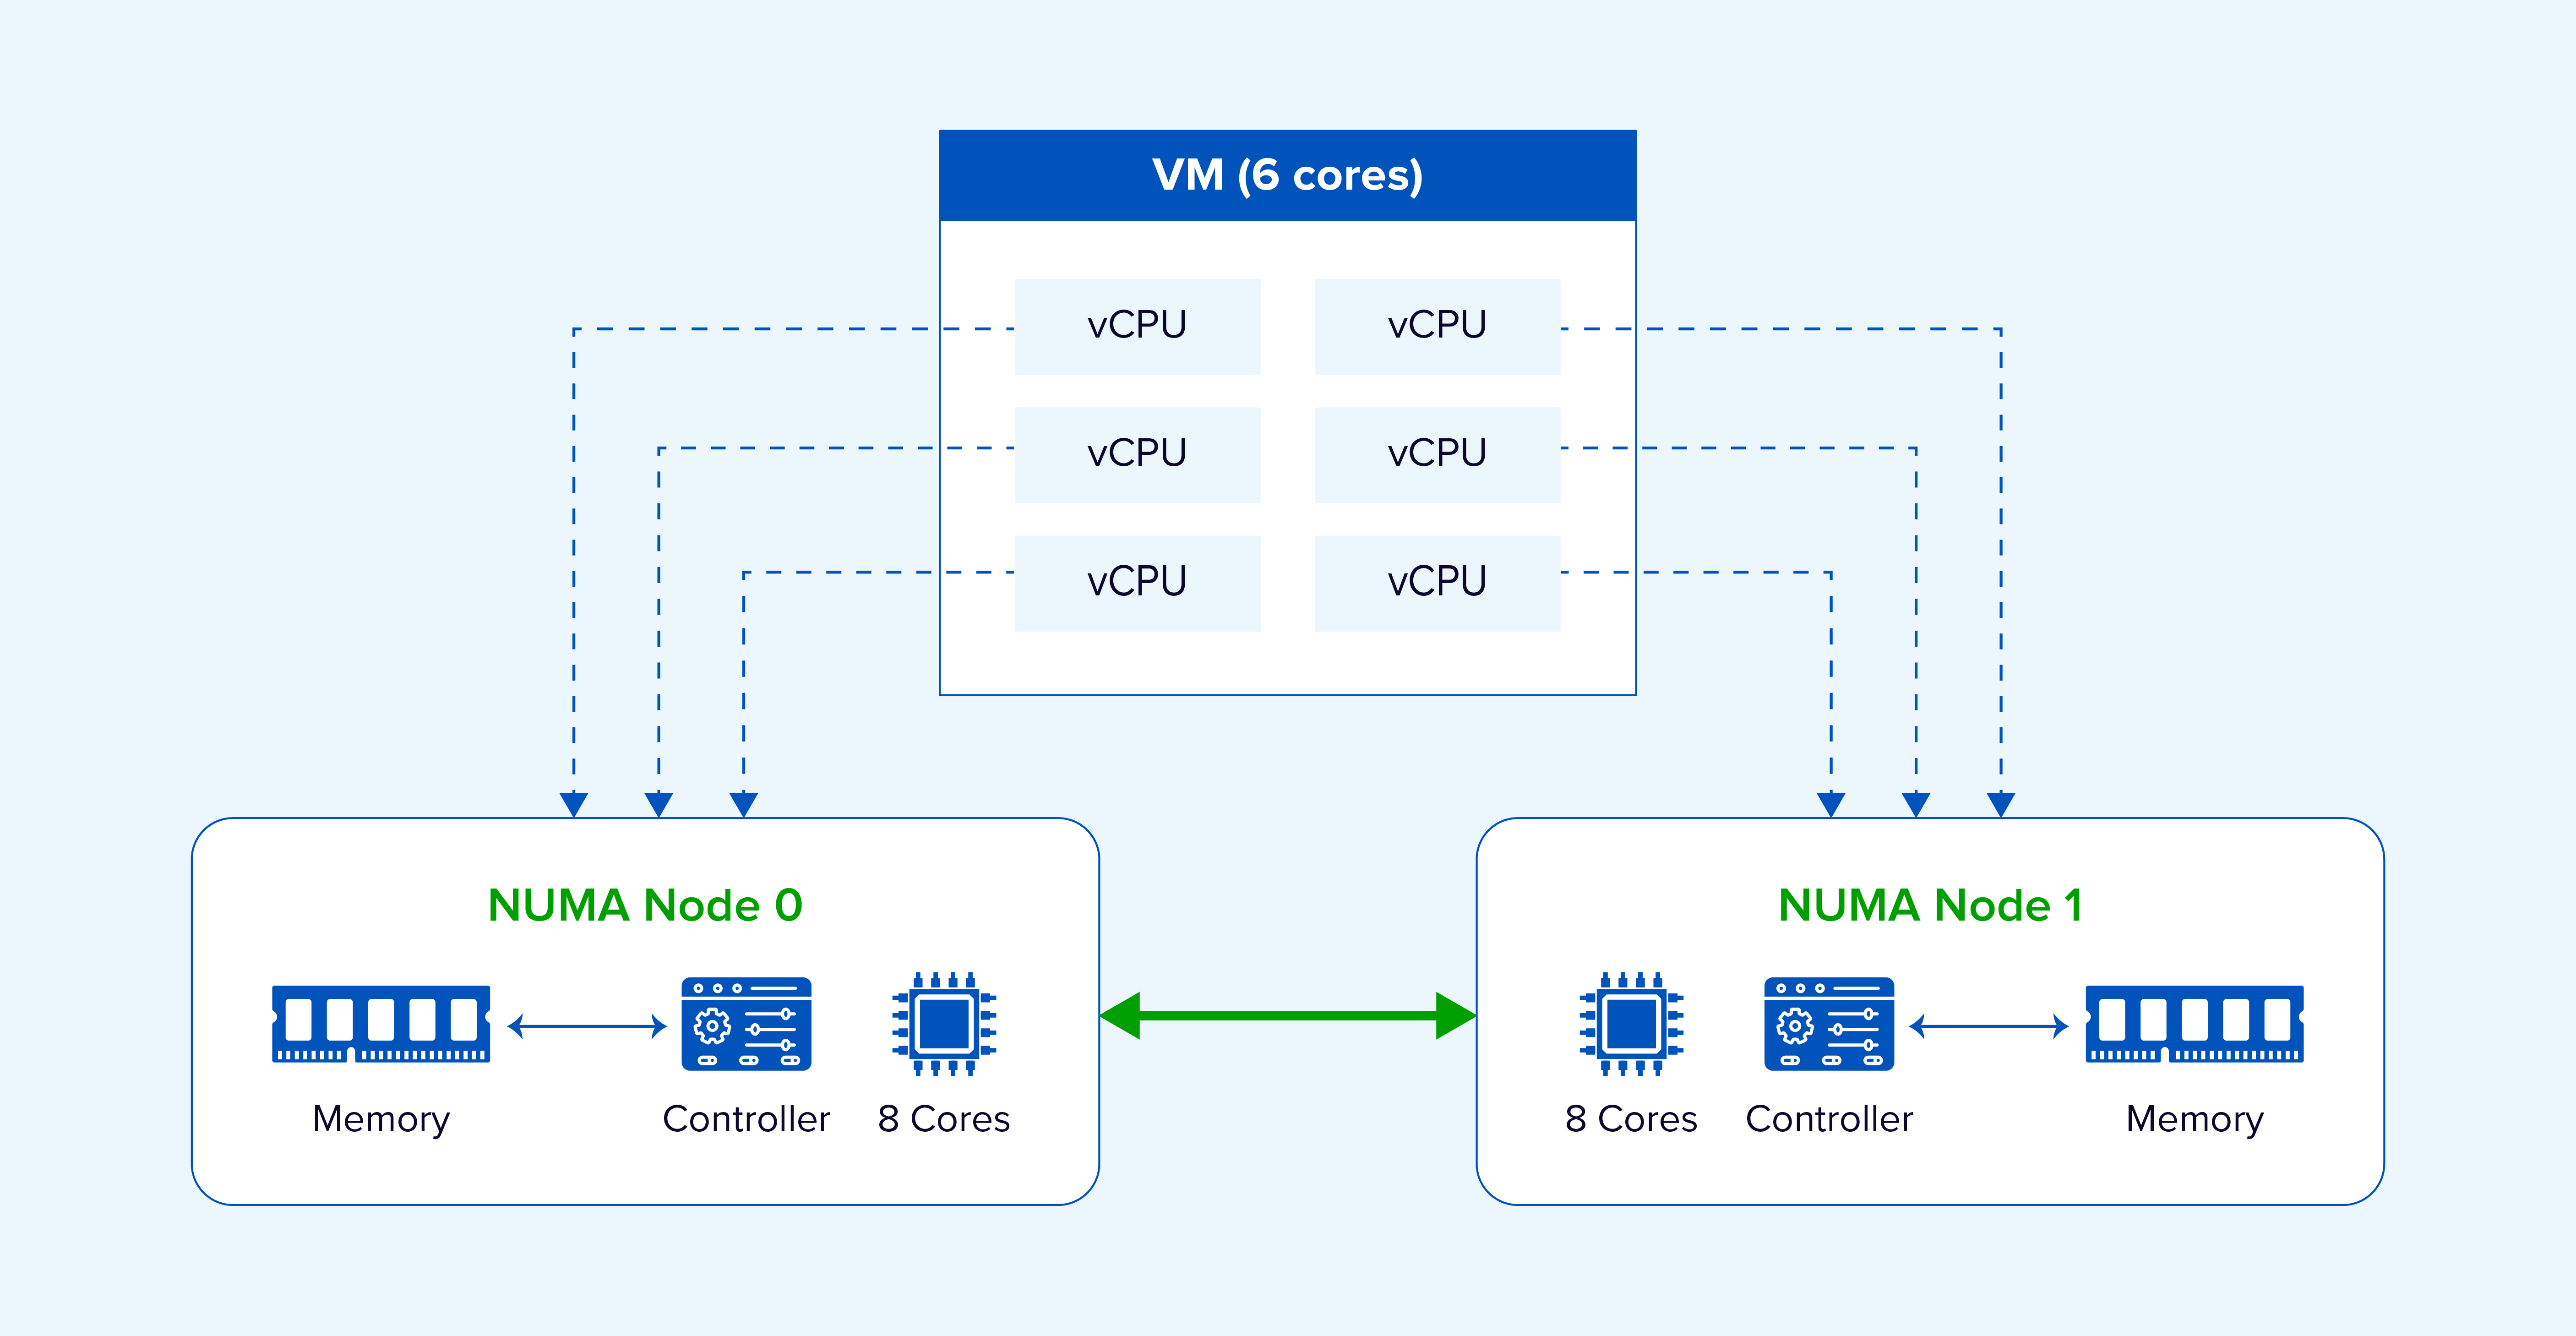
Hình 3: Việc thực thi đa nút có thể tăng khả năng truy cập bộ nhớ từ xa cho máy ảo.
PHẦN 3. Các phương pháp lập lịch NUMA phổ biến
Ngành công nghiệp thường sử dụng các phương pháp sau:
Phương pháp 1: Gán vCPU cho các lõi vật lý
Quản trị viên cấu hình thủ công việc ghim vCPU để các tài nguyên máy ảo ưu tiên chạy trong cùng một nút NUMA vật lý.
Phương pháp 2: Chỉ định số lượng nút NUMA được gán cho máy ảo
Quản trị viên cấu hình thủ công số lượng nút NUMA và phân bổ tài nguyên vCPU và bộ nhớ một cách đồng đều giữa chúng.
Phương pháp 3: Phân bổ các nút NUMA một cách thích ứng
Bộ lập lịch tự động gán các nút NUMA phù hợp cho máy ảo. CPU của máy ảo được giới hạn ở các nút đó và ưu tiên sử dụng bộ nhớ cục bộ để cải thiện tính cục bộ. Nếu máy ảo có nhiều vCPU hơn khả năng chứa của một nút NUMA duy nhất, nó sẽ được phân bổ trên nhiều nút. Cấu trúc liên kết NUMA có thể được hiển thị cho hệ điều hành khách để đưa ra các quyết định dựa trên cấu trúc liên kết, trong khi các máy ảo có thể được di chuyển giữa các nút để duy trì cân bằng tải.
Phương pháp 1 và 2 áp đặt nhiều hạn chế hơn, yêu cầu định cỡ CPU máy ảo cẩn thận và có thể tạo ra sự mất cân bằng giữa các nút NUMA do liên kết tĩnh. Do đó, phân bổ thích ứng thực tế hơn cho môi trường sản xuất năng động.
PHẦN 4. Lập kế hoạch chi tiết cho Sangfor NUMA
Sangfor HCI chủ yếu sử dụng lập lịch NUMA thích ứng. Nó cân bằng việc sử dụng tài nguyên giữa các nút NUMA đồng thời giảm thiểu việc truy cập bộ nhớ từ xa bởi các vCPU của máy ảo, từ đó cải thiện hiệu suất tổng thể.
Lập lịch NUMA thích ứng mang lại lợi ích tối ưu hóa rõ rệt cho nhiều loại ứng dụng khác nhau, đặc biệt là các phần mềm trung gian có các thao tác trong bộ nhớ thường xuyên. Sangfor đã triển khai DM8, Redis và Memcached trên các máy ảo và tiến hành kiểm tra hiệu năng khi bật và tắt lập lịch NUMA. Kết quả cho thấy hiệu năng của phần mềm trung gian được cải thiện rõ rệt khi bật lập lịch NUMA.
Khối lượng công việc cơ sở dữ liệu: Dameng DB (DM8) với BenchmarkSQL
BenchmarkSQL là một công cụ đo hiệu năng cơ sở dữ liệu quan hệ, chạy một loạt các giao dịch kiểu TPC-C, bao gồm đơn đặt hàng mới, thanh toán, truy vấn trạng thái đơn hàng, giao hàng và truy vấn mức tồn kho. Chỉ số tpmC thu được thể hiện số lượng giao dịch đơn đặt hàng mới được xử lý mỗi phút, với giá trị càng cao cho thấy hiệu năng càng tốt. BenchmarkSQL 5.0 đã được sử dụng để kiểm tra cơ sở dữ liệu DM8. Biểu đồ sau đây cho thấy hiệu năng tương đối, với kết quả tpmC khi không hỗ trợ NUMA được chuẩn hóa thành 100%.
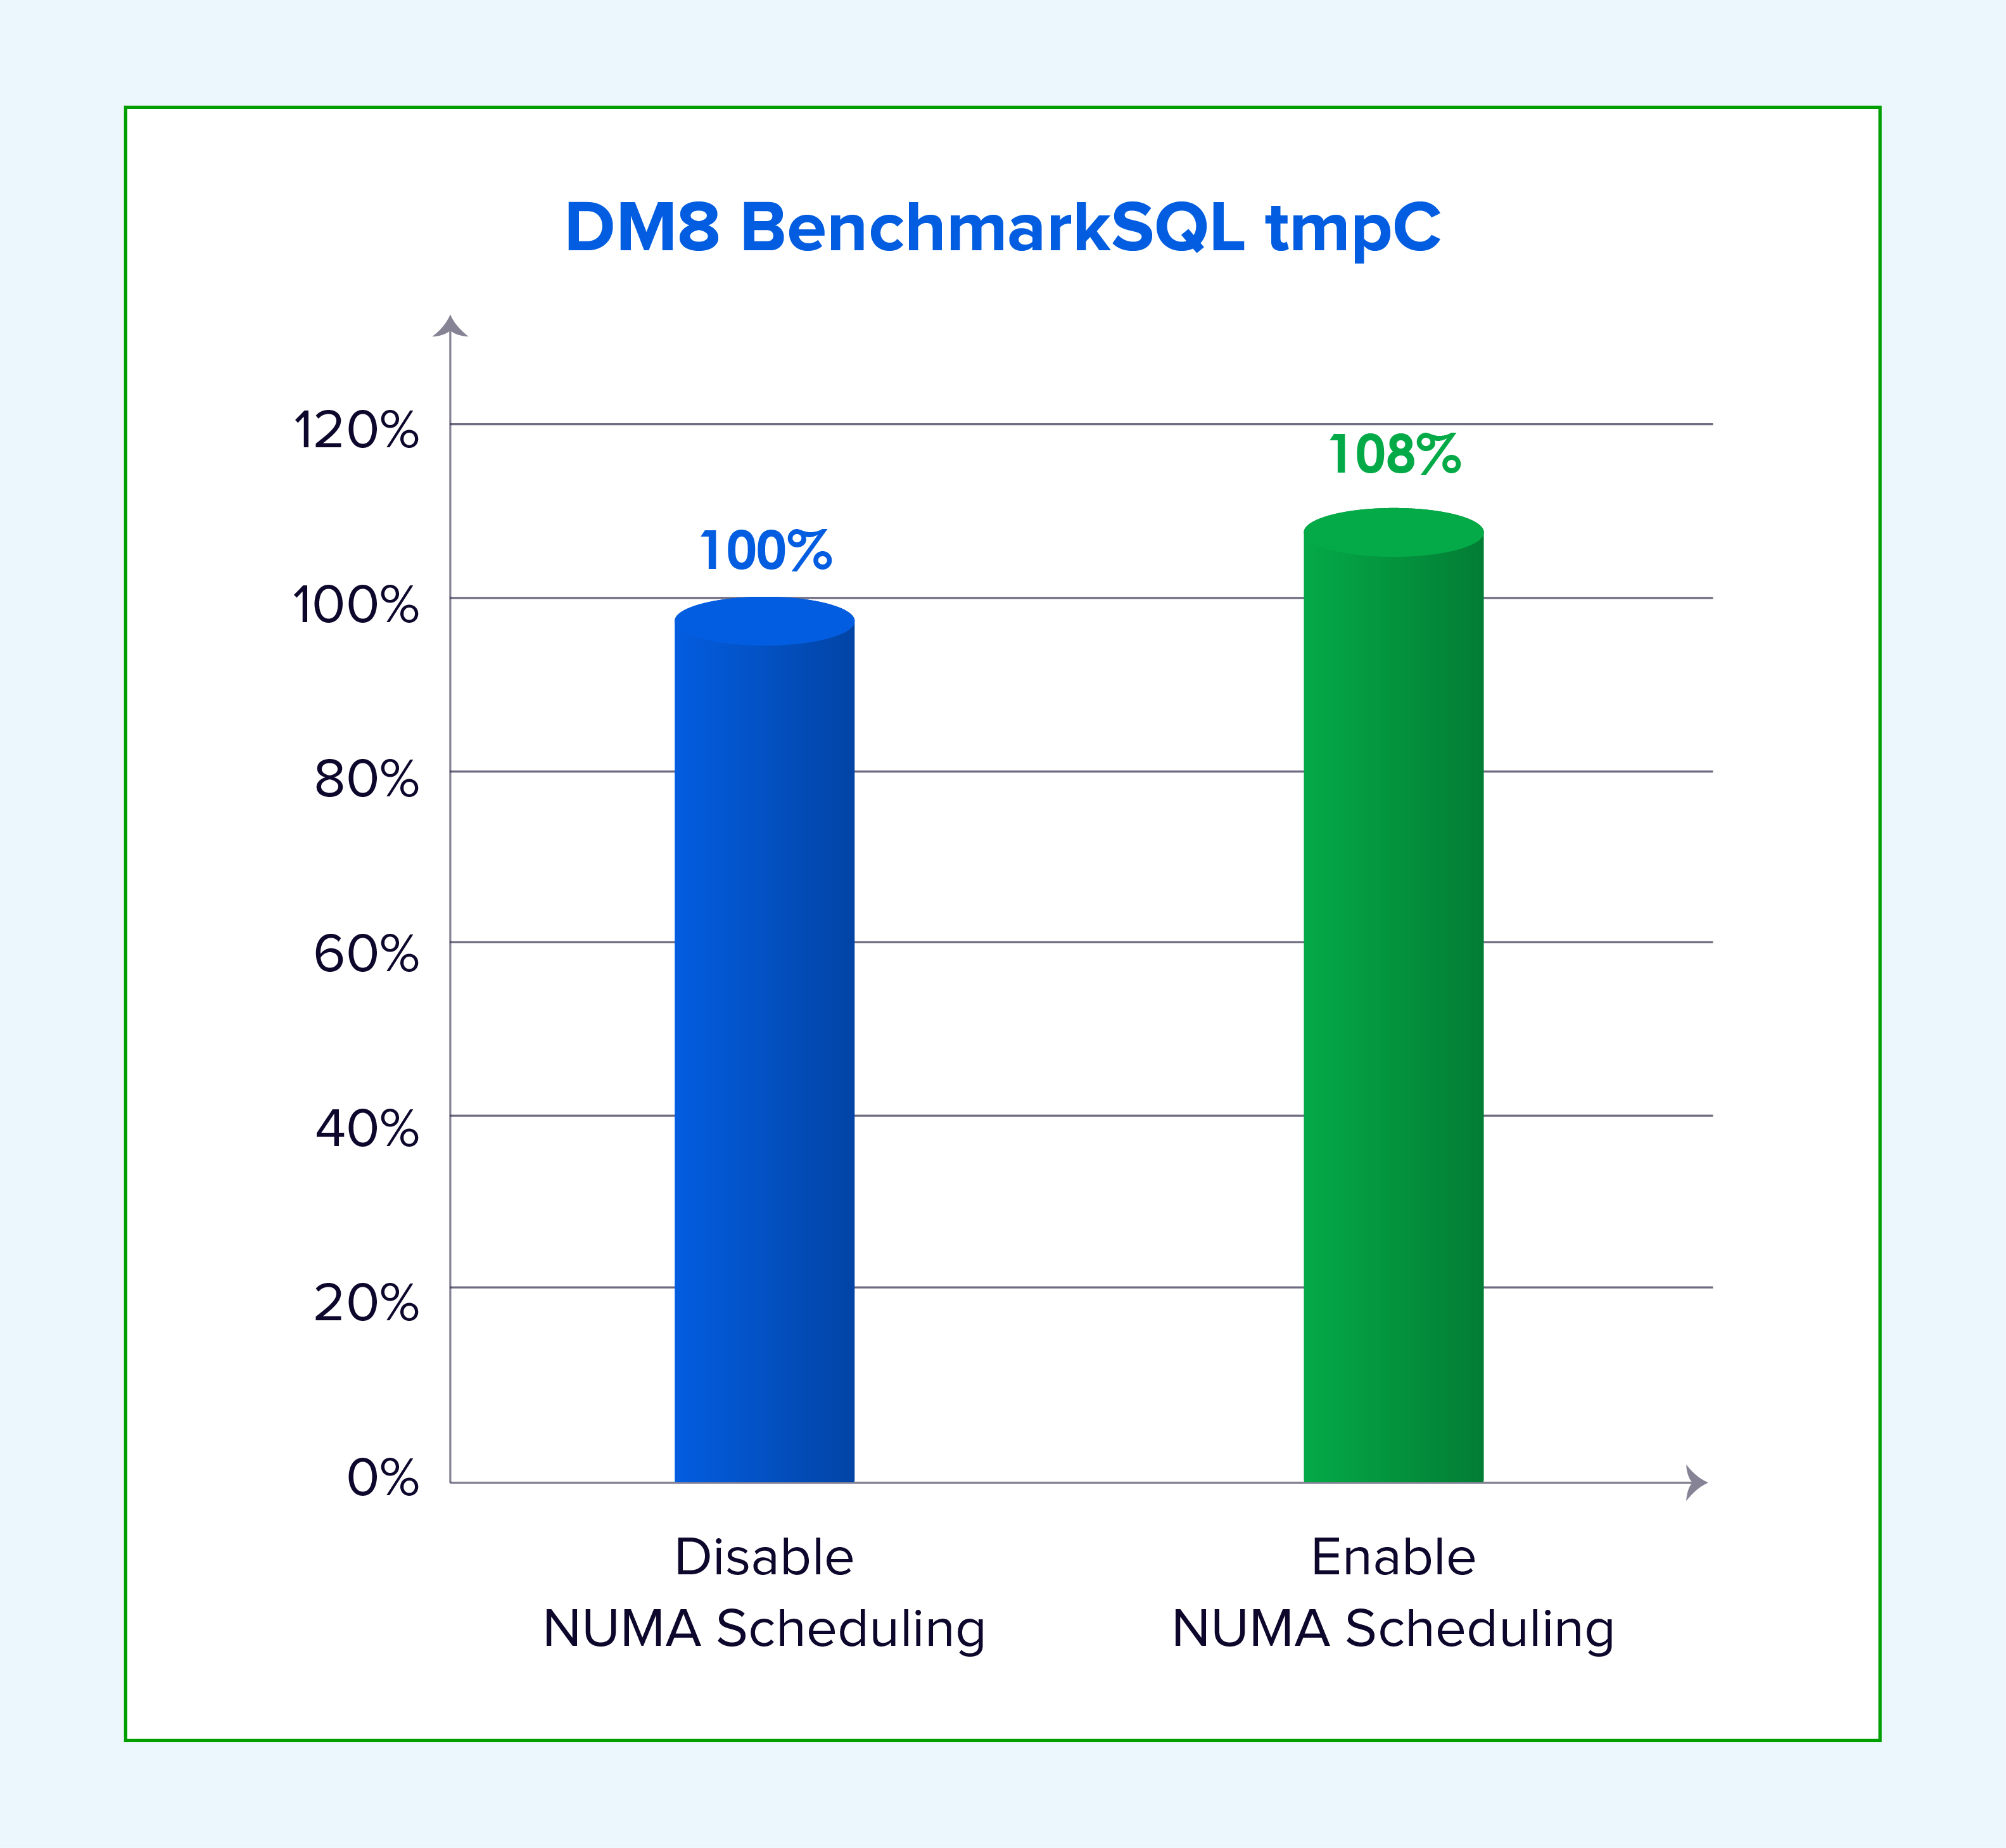
Hình 4: Thông lượng giao dịch DM8 tương đối khi bật và tắt tính năng lập lịch NUMA.
Bộ nhớ đệm trong bộ nhớ: Redis 7.2.5
redis-benchmark là công cụ kiểm tra hiệu năng chính thức của Redis. Sangfor đã sử dụng nó để kiểm tra QPS (Question Per Second) cho các thao tác GET và SET với giá trị 1 KB khi bật và tắt tính năng lập lịch NUMA. QPS thể hiện số lượng thao tác đọc hoặc ghi mỗi giây.
redis-benchmark -t get -d 16 -c 100 -n 6000000 -r 60000000
redis-benchmark -t set -d 16 -c 100 -n 6000000 -r 60000000
Biểu đồ sau đây thể hiện hiệu suất tương đối, với kết quả QPS khi tắt NUMA được chuẩn hóa thành 100%.
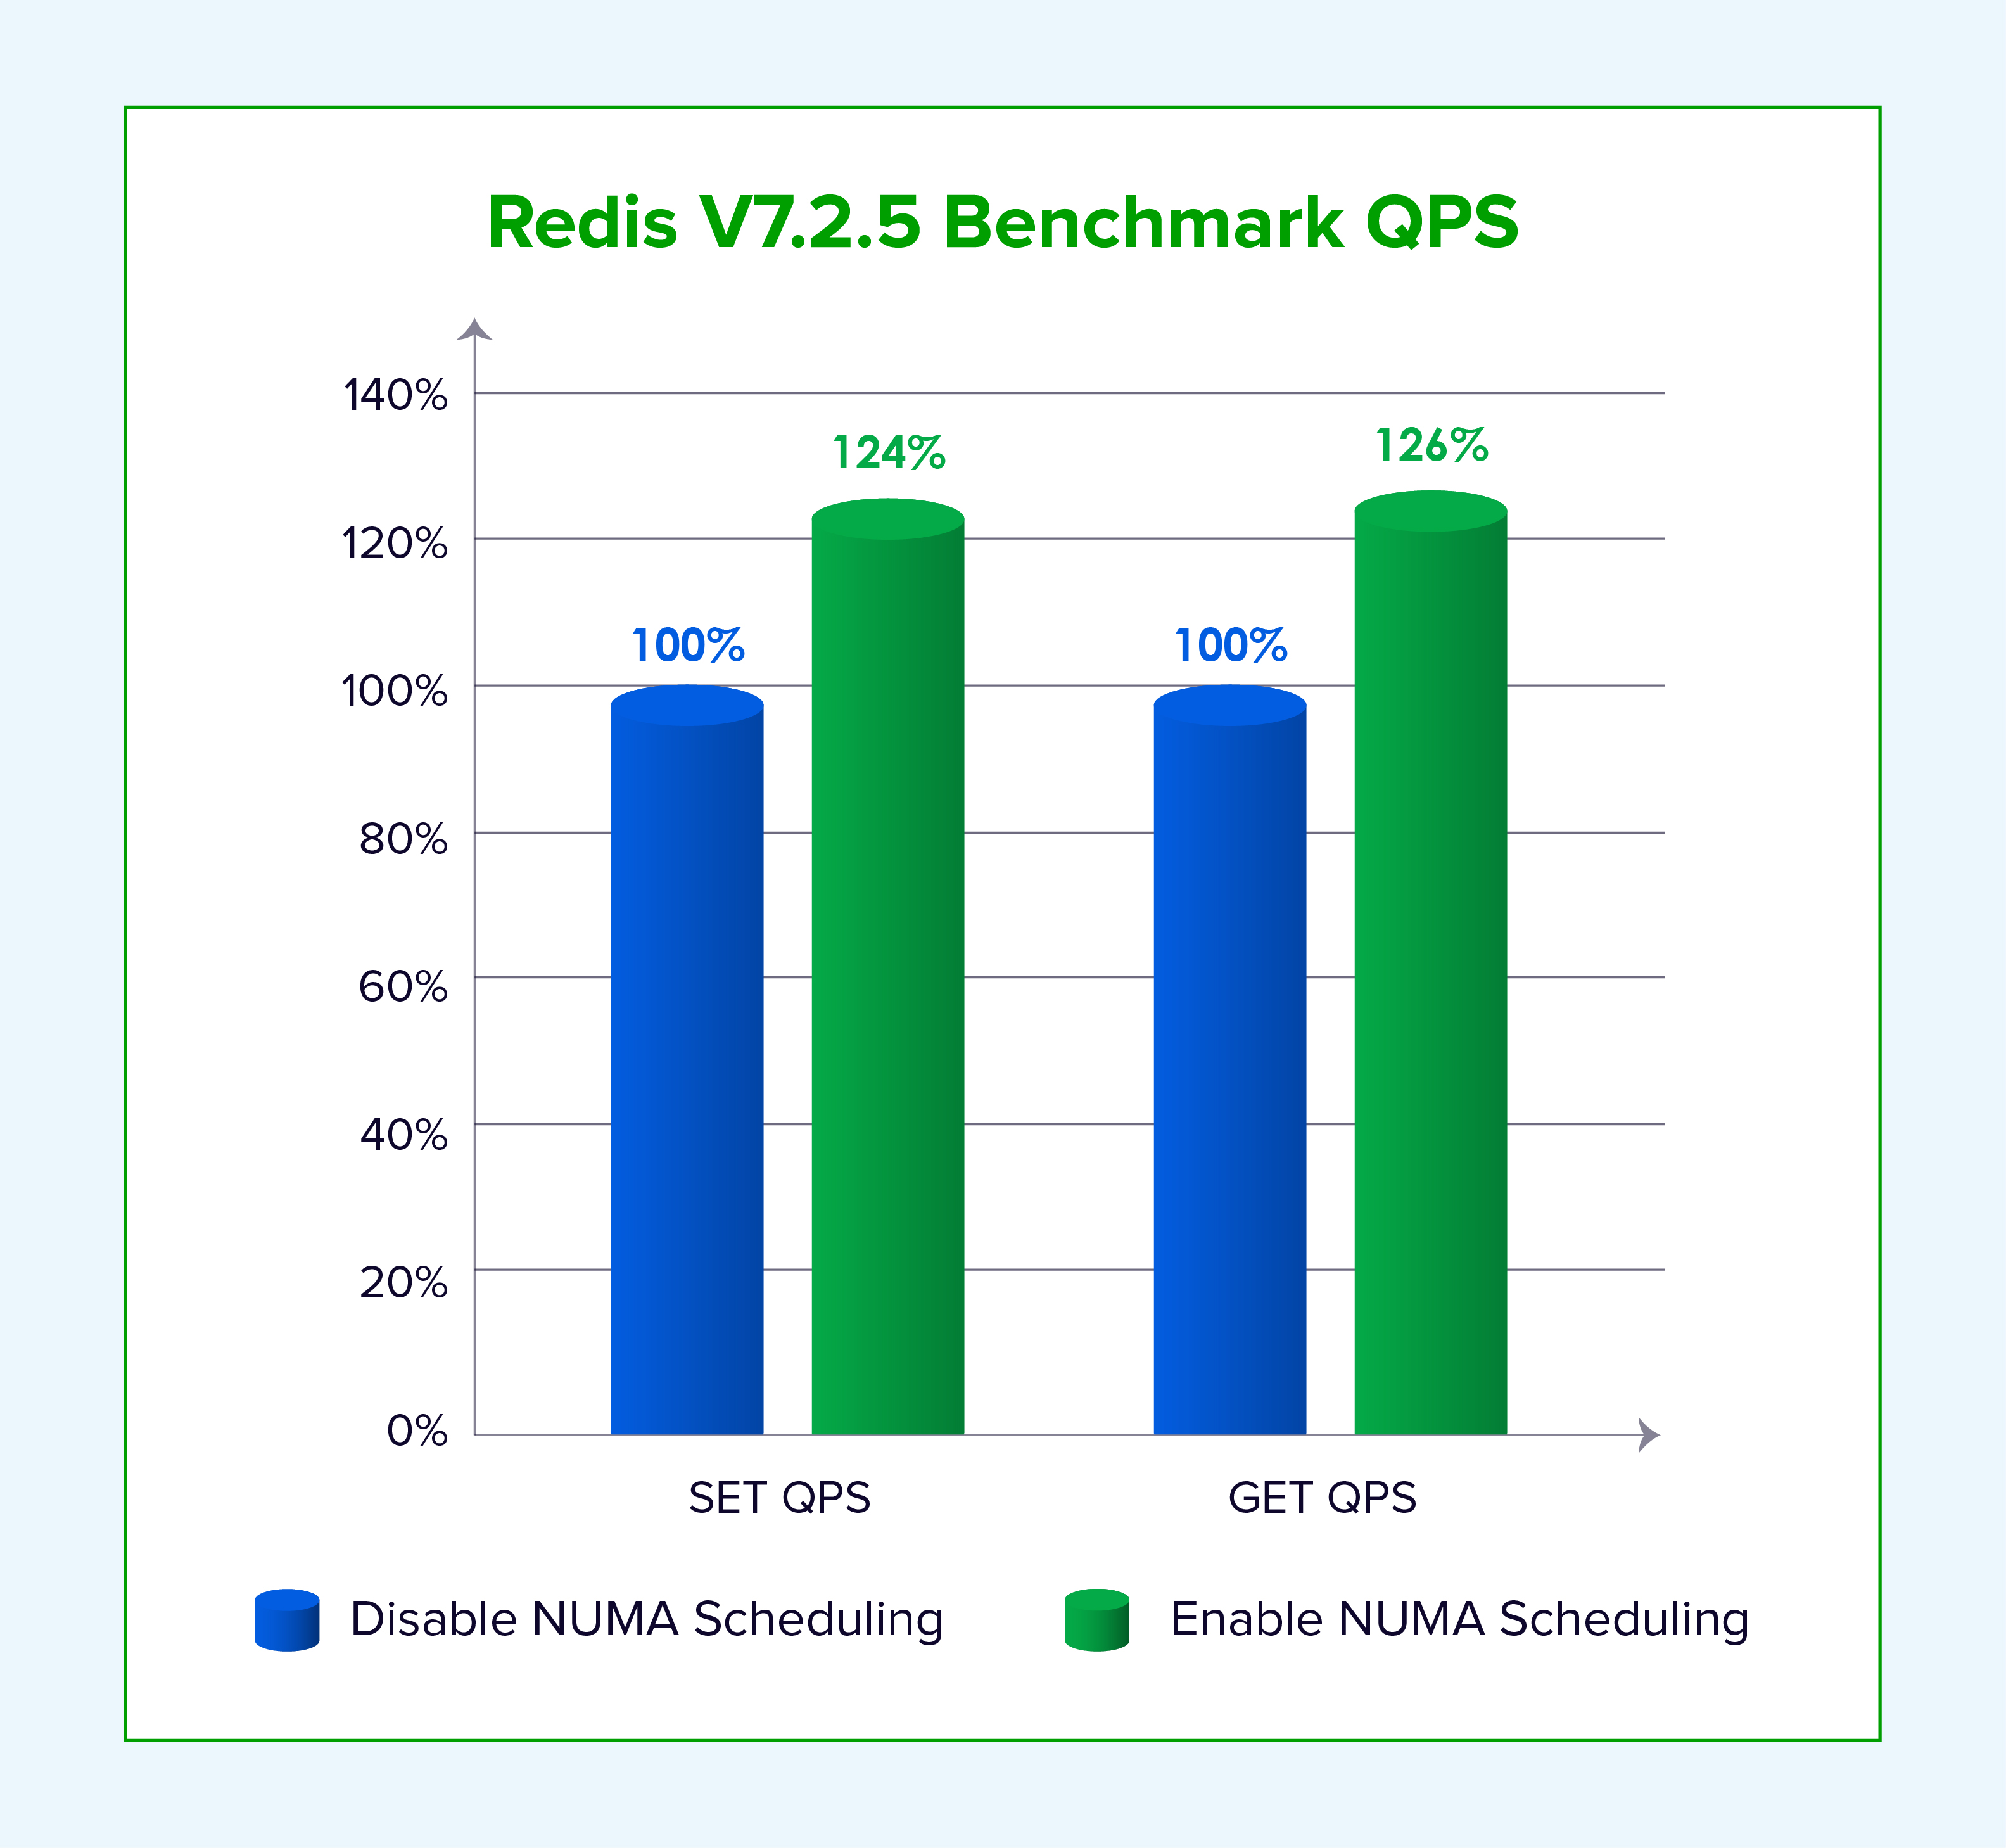
Hình 5: Hiệu suất đọc/ghi QPS tương đối của Redis được cải thiện khi bật tính năng lập lịch NUMA.
Bộ nhớ đệm cặp khóa-giá trị: Memcached 6.27
memaslap là một công cụ kiểm tra hiệu năng được tích hợp sẵn trong Memcached. Sangfor đã sử dụng nó để kiểm tra TPS (số giao dịch mỗi giây) cho các giá trị 1 KB với tính năng lập lịch NUMA bị vô hiệu hóa và được kích hoạt. TPS thể hiện số giao dịch mỗi giây.
memaslap -s 127.0.0.1:11211 -t 300s -T 8
Biểu đồ sau đây thể hiện hiệu suất tương đối, với kết quả TPS khi NUMA bị vô hiệu hóa được chuẩn hóa thành 100%.
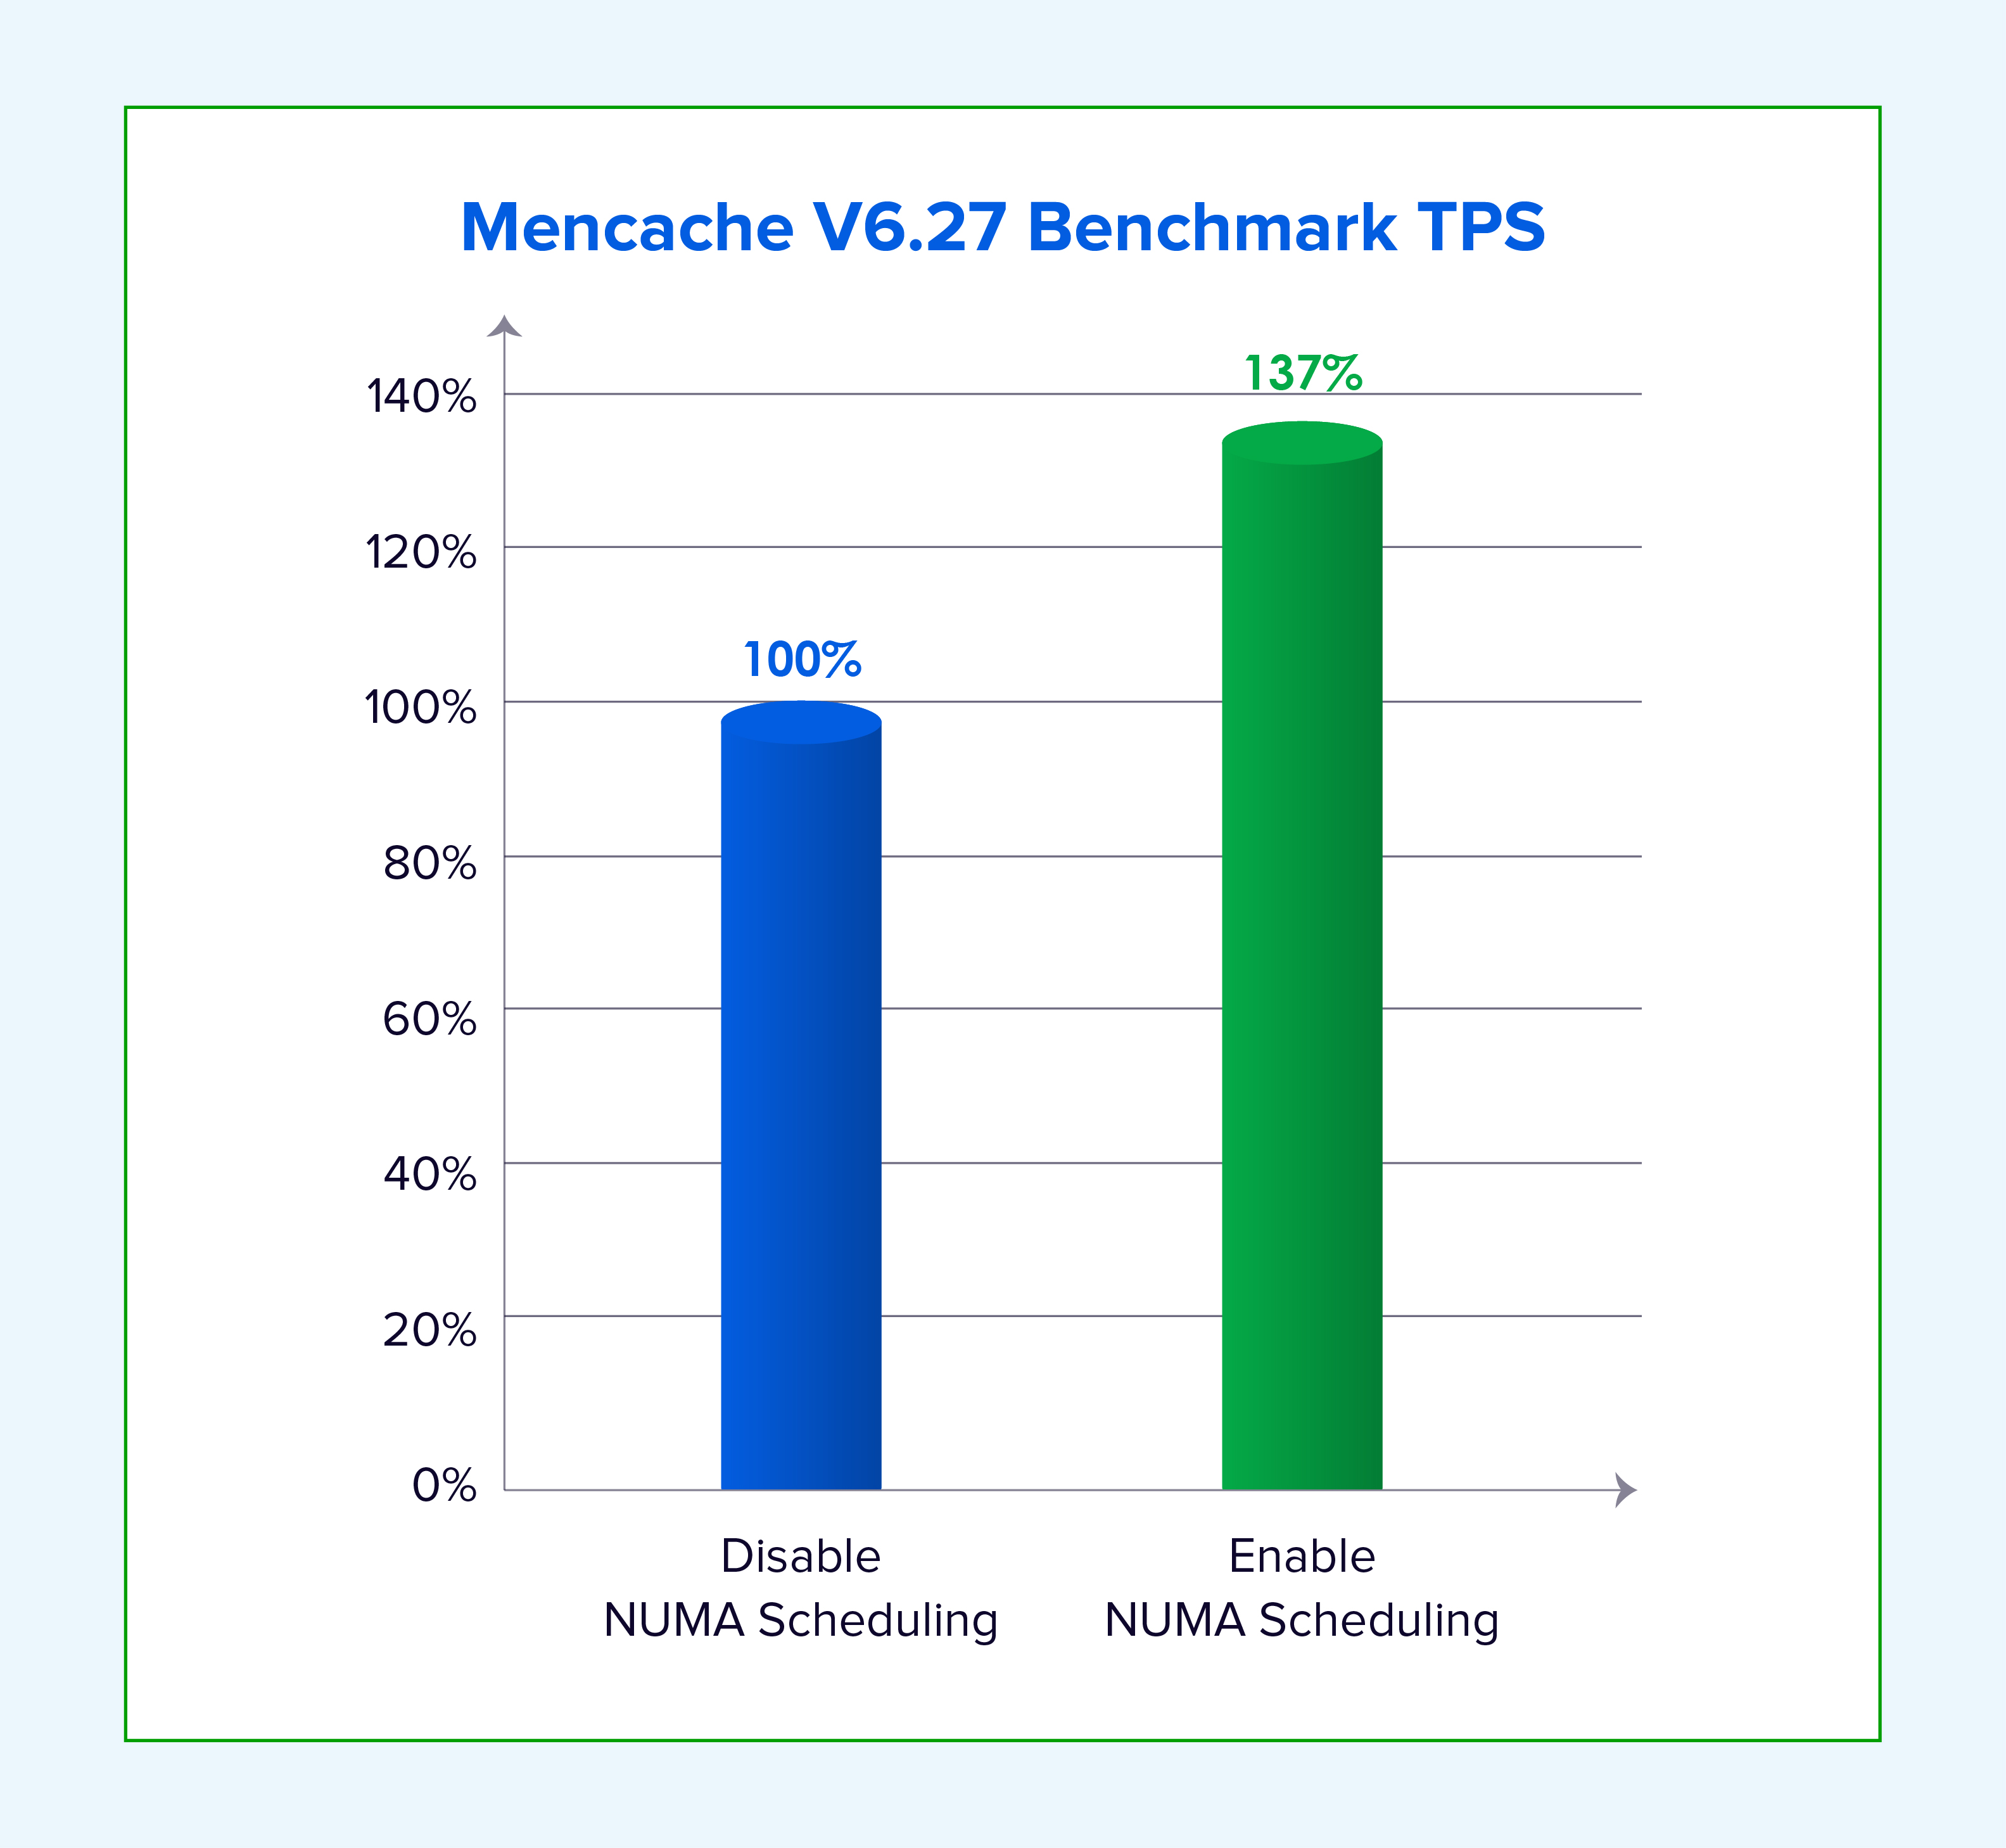
Hình 6: Mức tăng thông lượng giao dịch tương đối của Memcached khi bật tính năng lập lịch NUMA.
Kết quả trên cho thấy lợi ích rõ rệt đối với các ứng dụng tiêu tốn nhiều bộ nhớ. Các phần tiếp theo sẽ giải thích cách thức tối ưu hóa hoạt động.
1. Phân bổ nút NUMA thích ứng
Sangfor phân vùng thích ứng các vCPU của máy ảo và lên lịch cho chúng trên các nút NUMA phù hợp để giảm truy cập bộ nhớ từ xa. Nếu số lượng vCPU của máy ảo thấp hơn số lõi của một nút NUMA, máy ảo sẽ được lên lịch trên một nút duy nhất. Nếu máy ảo yêu cầu nhiều lõi hơn số lõi mà một nút có thể cung cấp, nó sẽ được phân phối trên nhiều nút và cấu trúc liên kết vNUMA được hiển thị cho hệ điều hành khách để đưa ra các quyết định dựa trên cấu trúc liên kết.
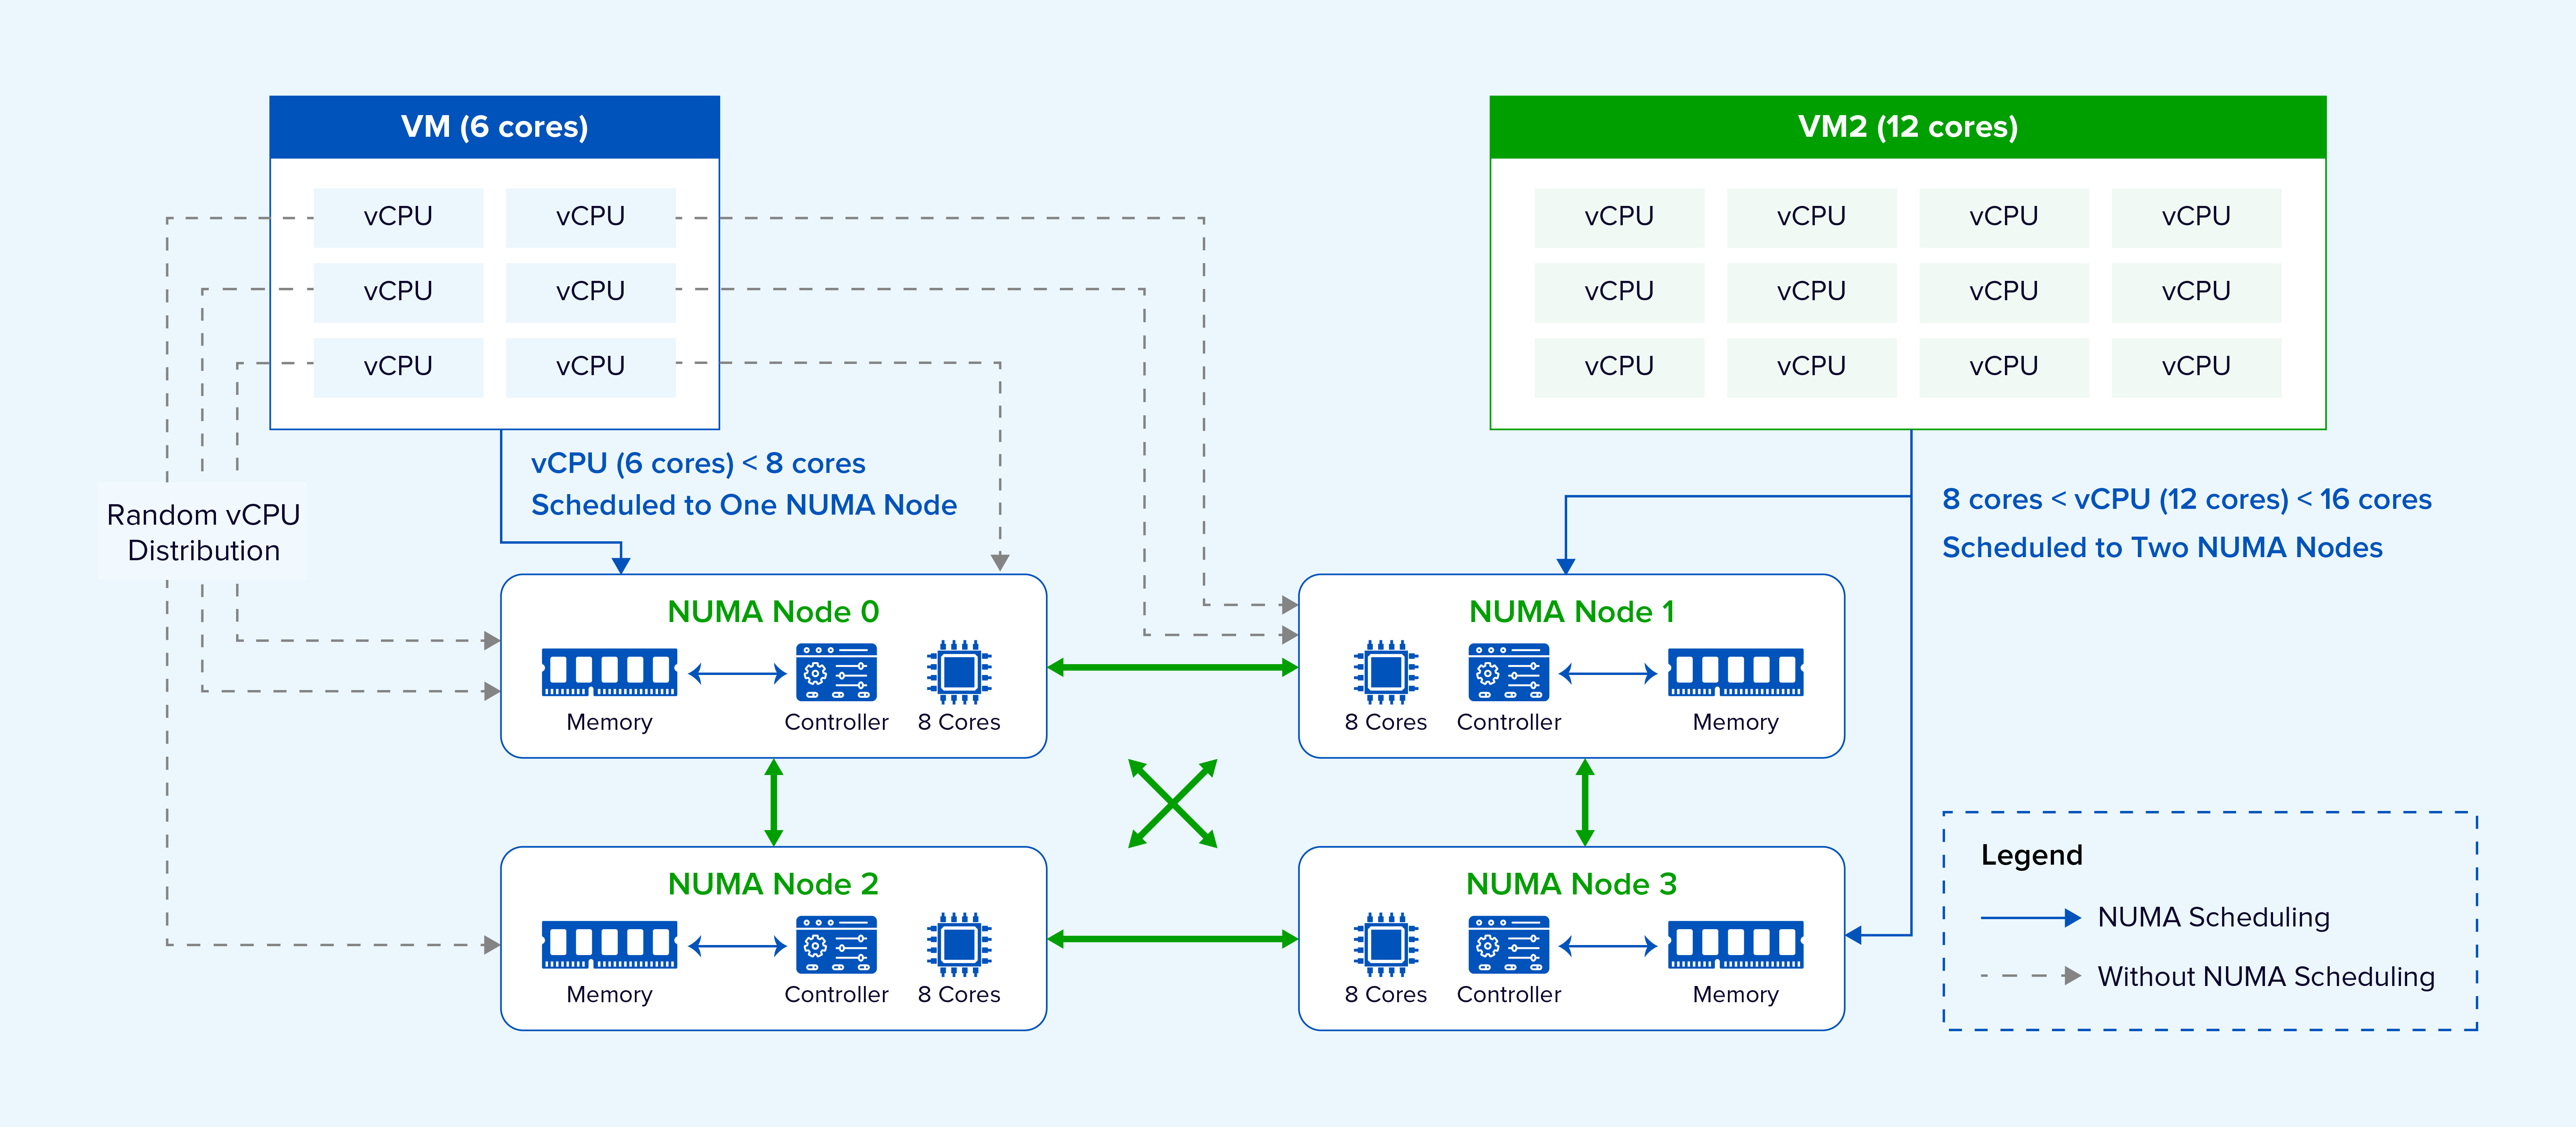
Hình 7: Phân vùng vCPU thông minh của Sangfor và ánh xạ cấu trúc liên kết vNUMA.
Để duy trì sự cân bằng trong việc sử dụng tài nguyên, thuật toán đặt máy ảo (VM placement) xem xét tải hiện tại trên các nút NUMA và chọn nút ít bận rộn hơn. Trong quá trình hoạt động, các VM có thể được di chuyển giữa các nút khi mức độ sử dụng thay đổi. Các VM ưu tiên được đặt trên các nút ít bị tranh chấp hơn để giảm sự cạnh tranh về CPU, băng thông bộ nhớ và tài nguyên bộ nhớ đệm.
2. Tối ưu hóa cho các nền tảng máy chủ không đồng nhất
Một số nền tảng máy chủ chứa nhiều nút NUMA, khoảng cách giữa các nút khác nhau và số lõi xử lý tương đối ít trên mỗi nút.
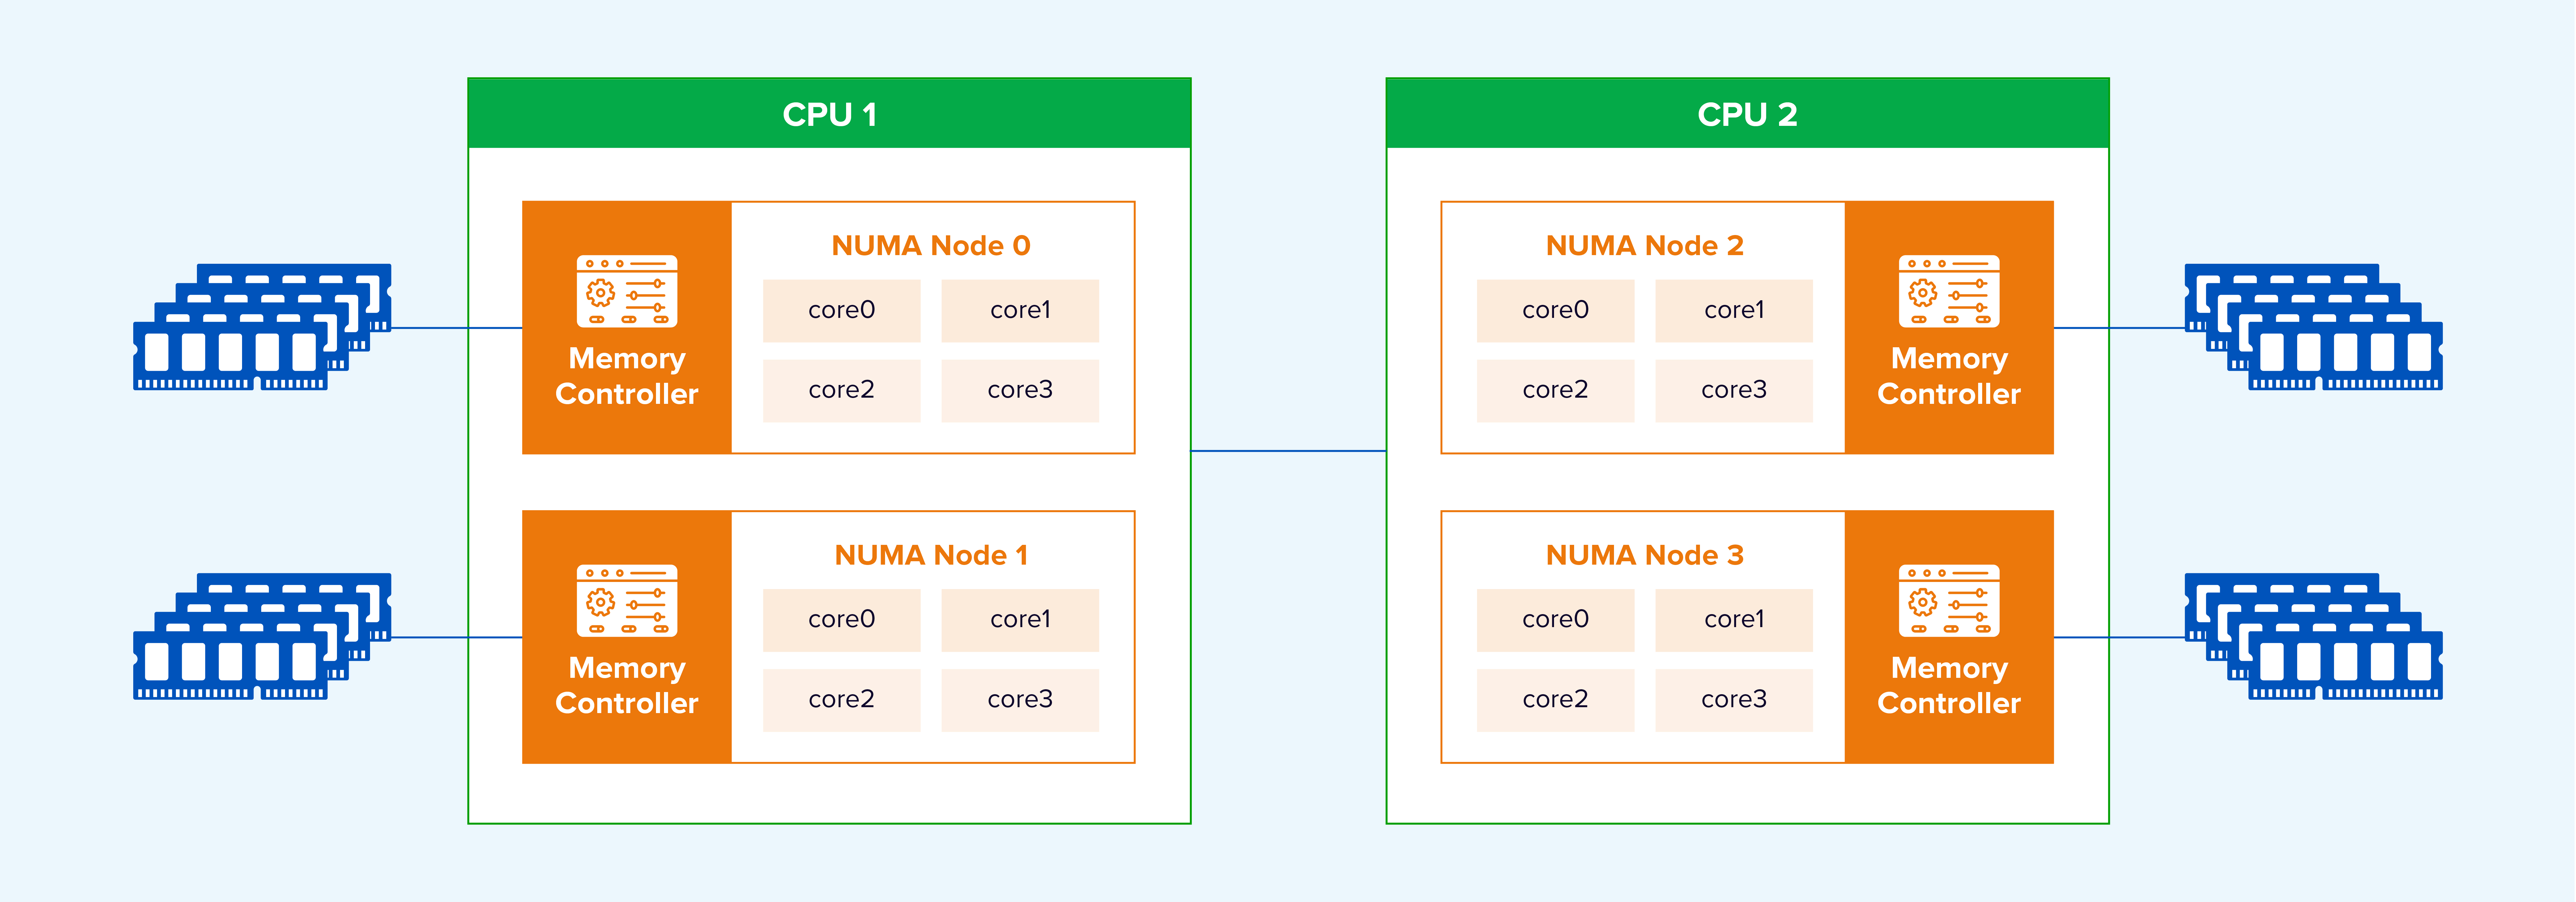
Hình 8. Vị trí đặt vNUMA có tính đến cấu trúc liên kết trên máy chủ đa nút.
Sangfor xác định khoảng cách giữa các nút NUMA và ưu tiên đặt nhiều nút vNUMA từ cùng một máy ảo lên các nút NUMA vật lý gần đó.
Để cải thiện hơn nữa hiệu suất chuyển tiếp dữ liệu, Sangfor đã phát triển tính năng liên kết NUMA giữa các máy ảo (VM) và các tiến trình xử lý dữ liệu. VM và tiến trình chuyển tiếp dữ liệu của nó được lên lịch trên cùng một nút NUMA, giúp tăng khả năng truy cập bộ nhớ cục bộ. Trong hình dưới đây, DP đề cập đến tiến trình xử lý dữ liệu.
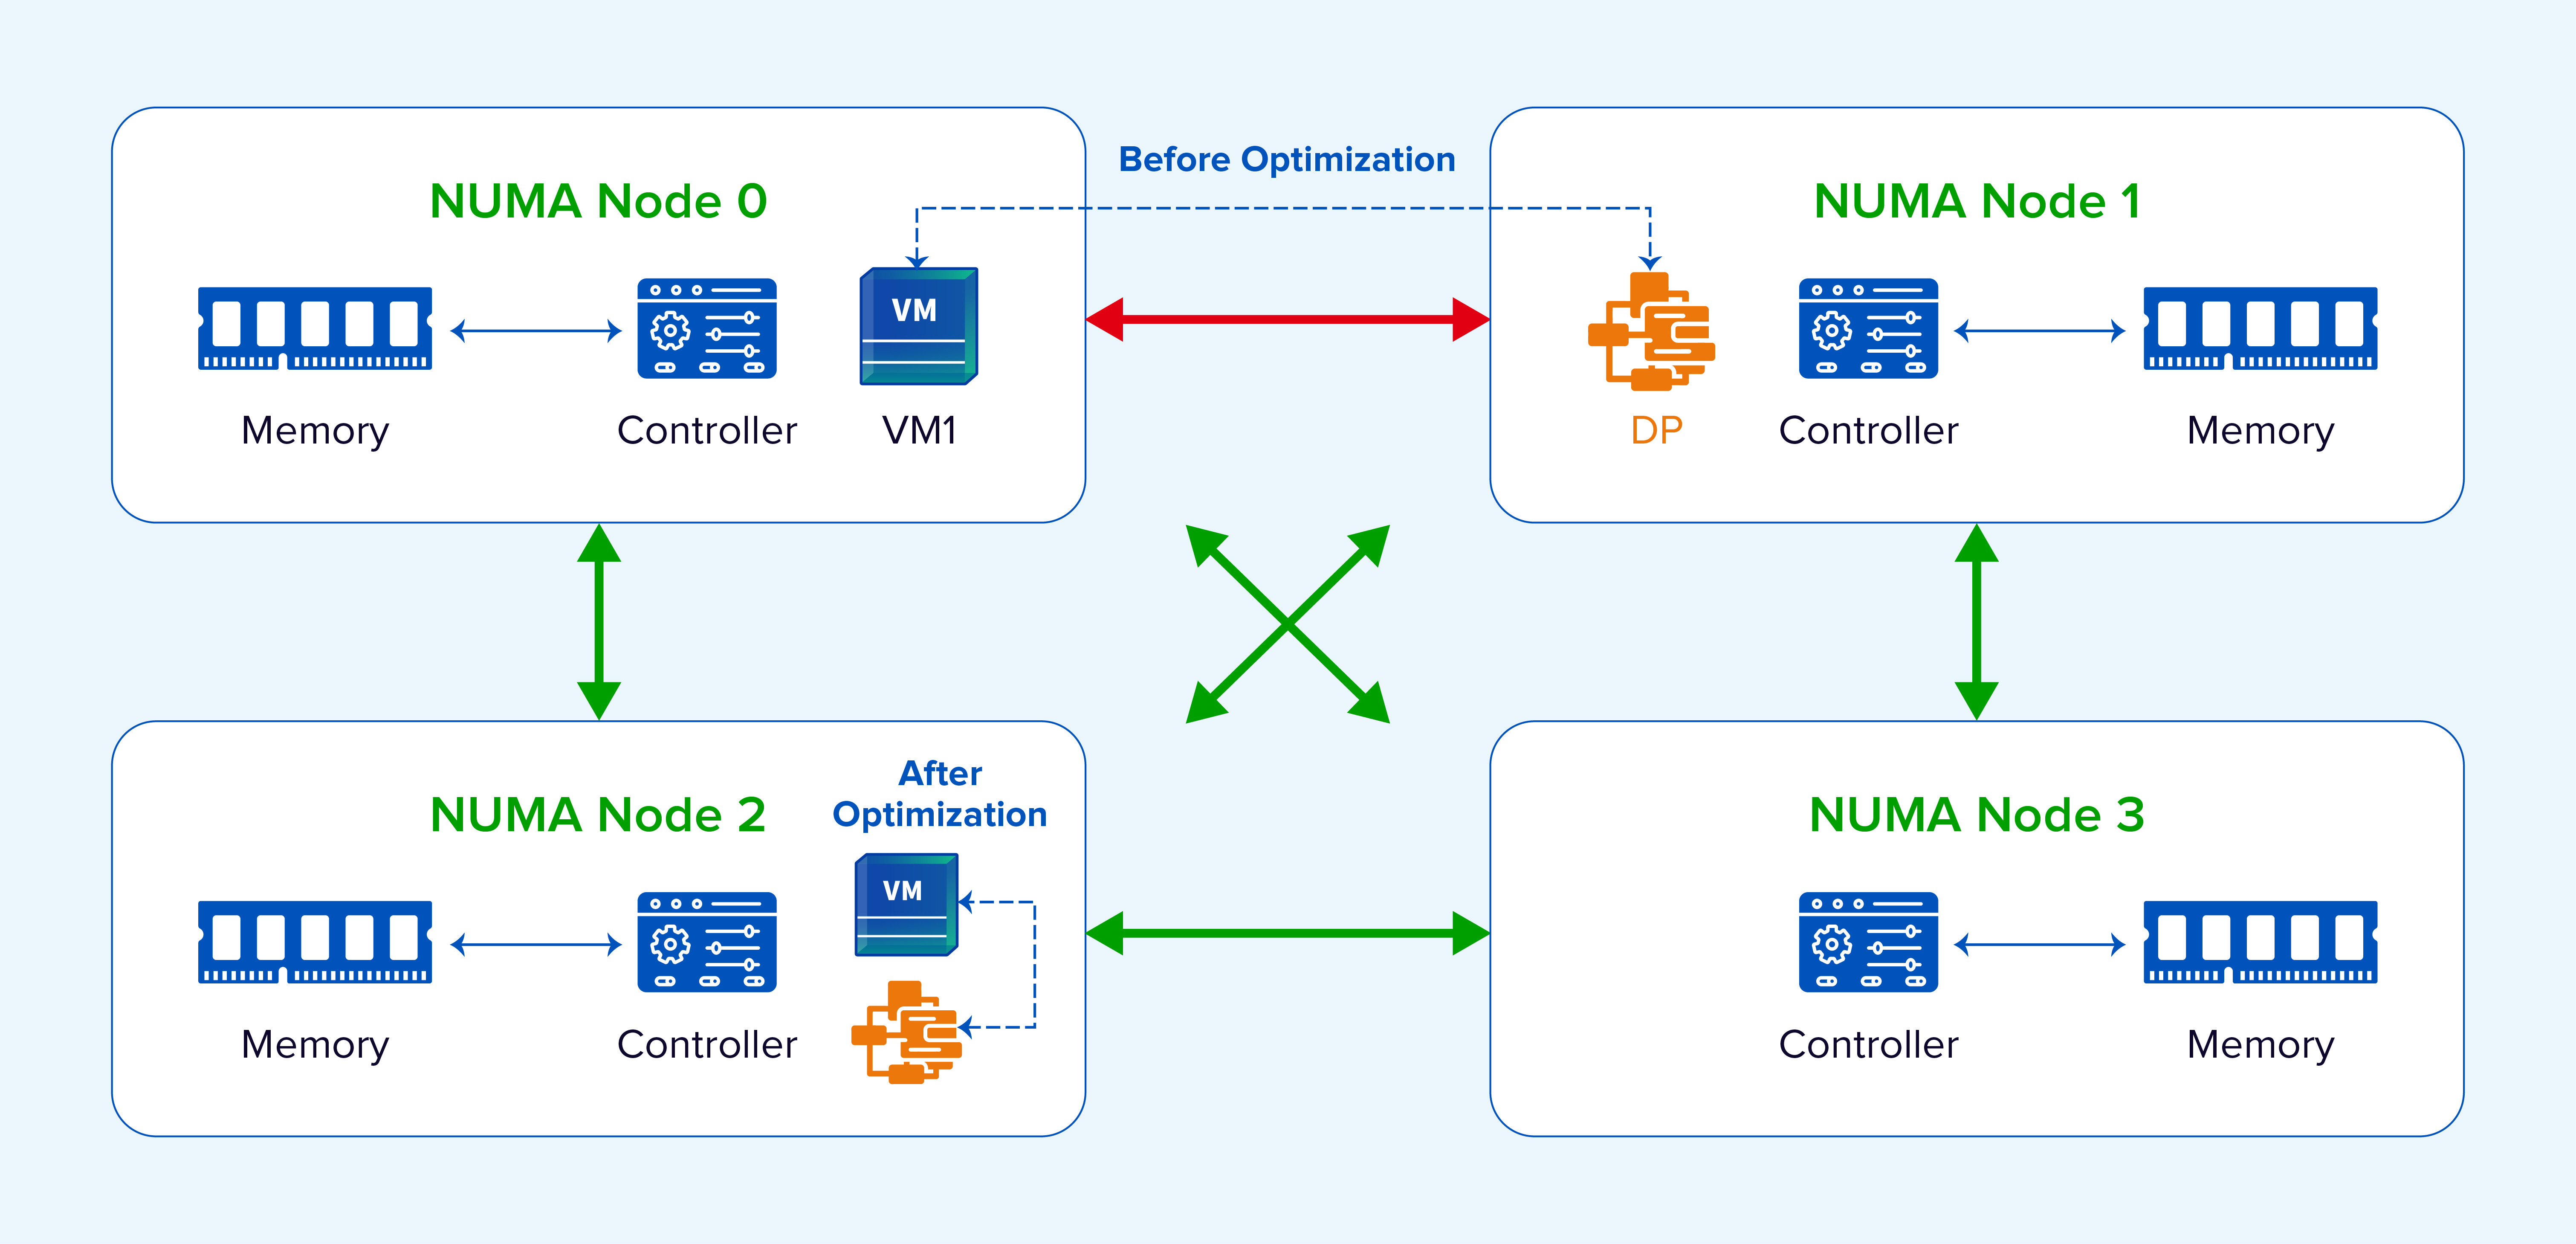
Hình 9. Sự tương thích giữa VM và mặt phẳng dữ liệu giúp duy trì quá trình xử lý gần với bộ nhớ cục bộ.
Để tối đa hóa lợi ích của NUMA trên toàn bộ hệ thống lưu trữ, Sangfor đặt vCPU, QEMU, libnfs, aSAN và các tiến trình khác tham gia vào toàn bộ đường dẫn I/O trên cùng một nút NUMA. Điều này tránh được việc truy cập bộ nhớ từ xa. Các trang bộ nhớ lớn hơn nữa giúp cải thiện hiệu suất truy cập bộ nhớ, giảm chi phí xử lý và tăng hiệu quả luồng I/O.
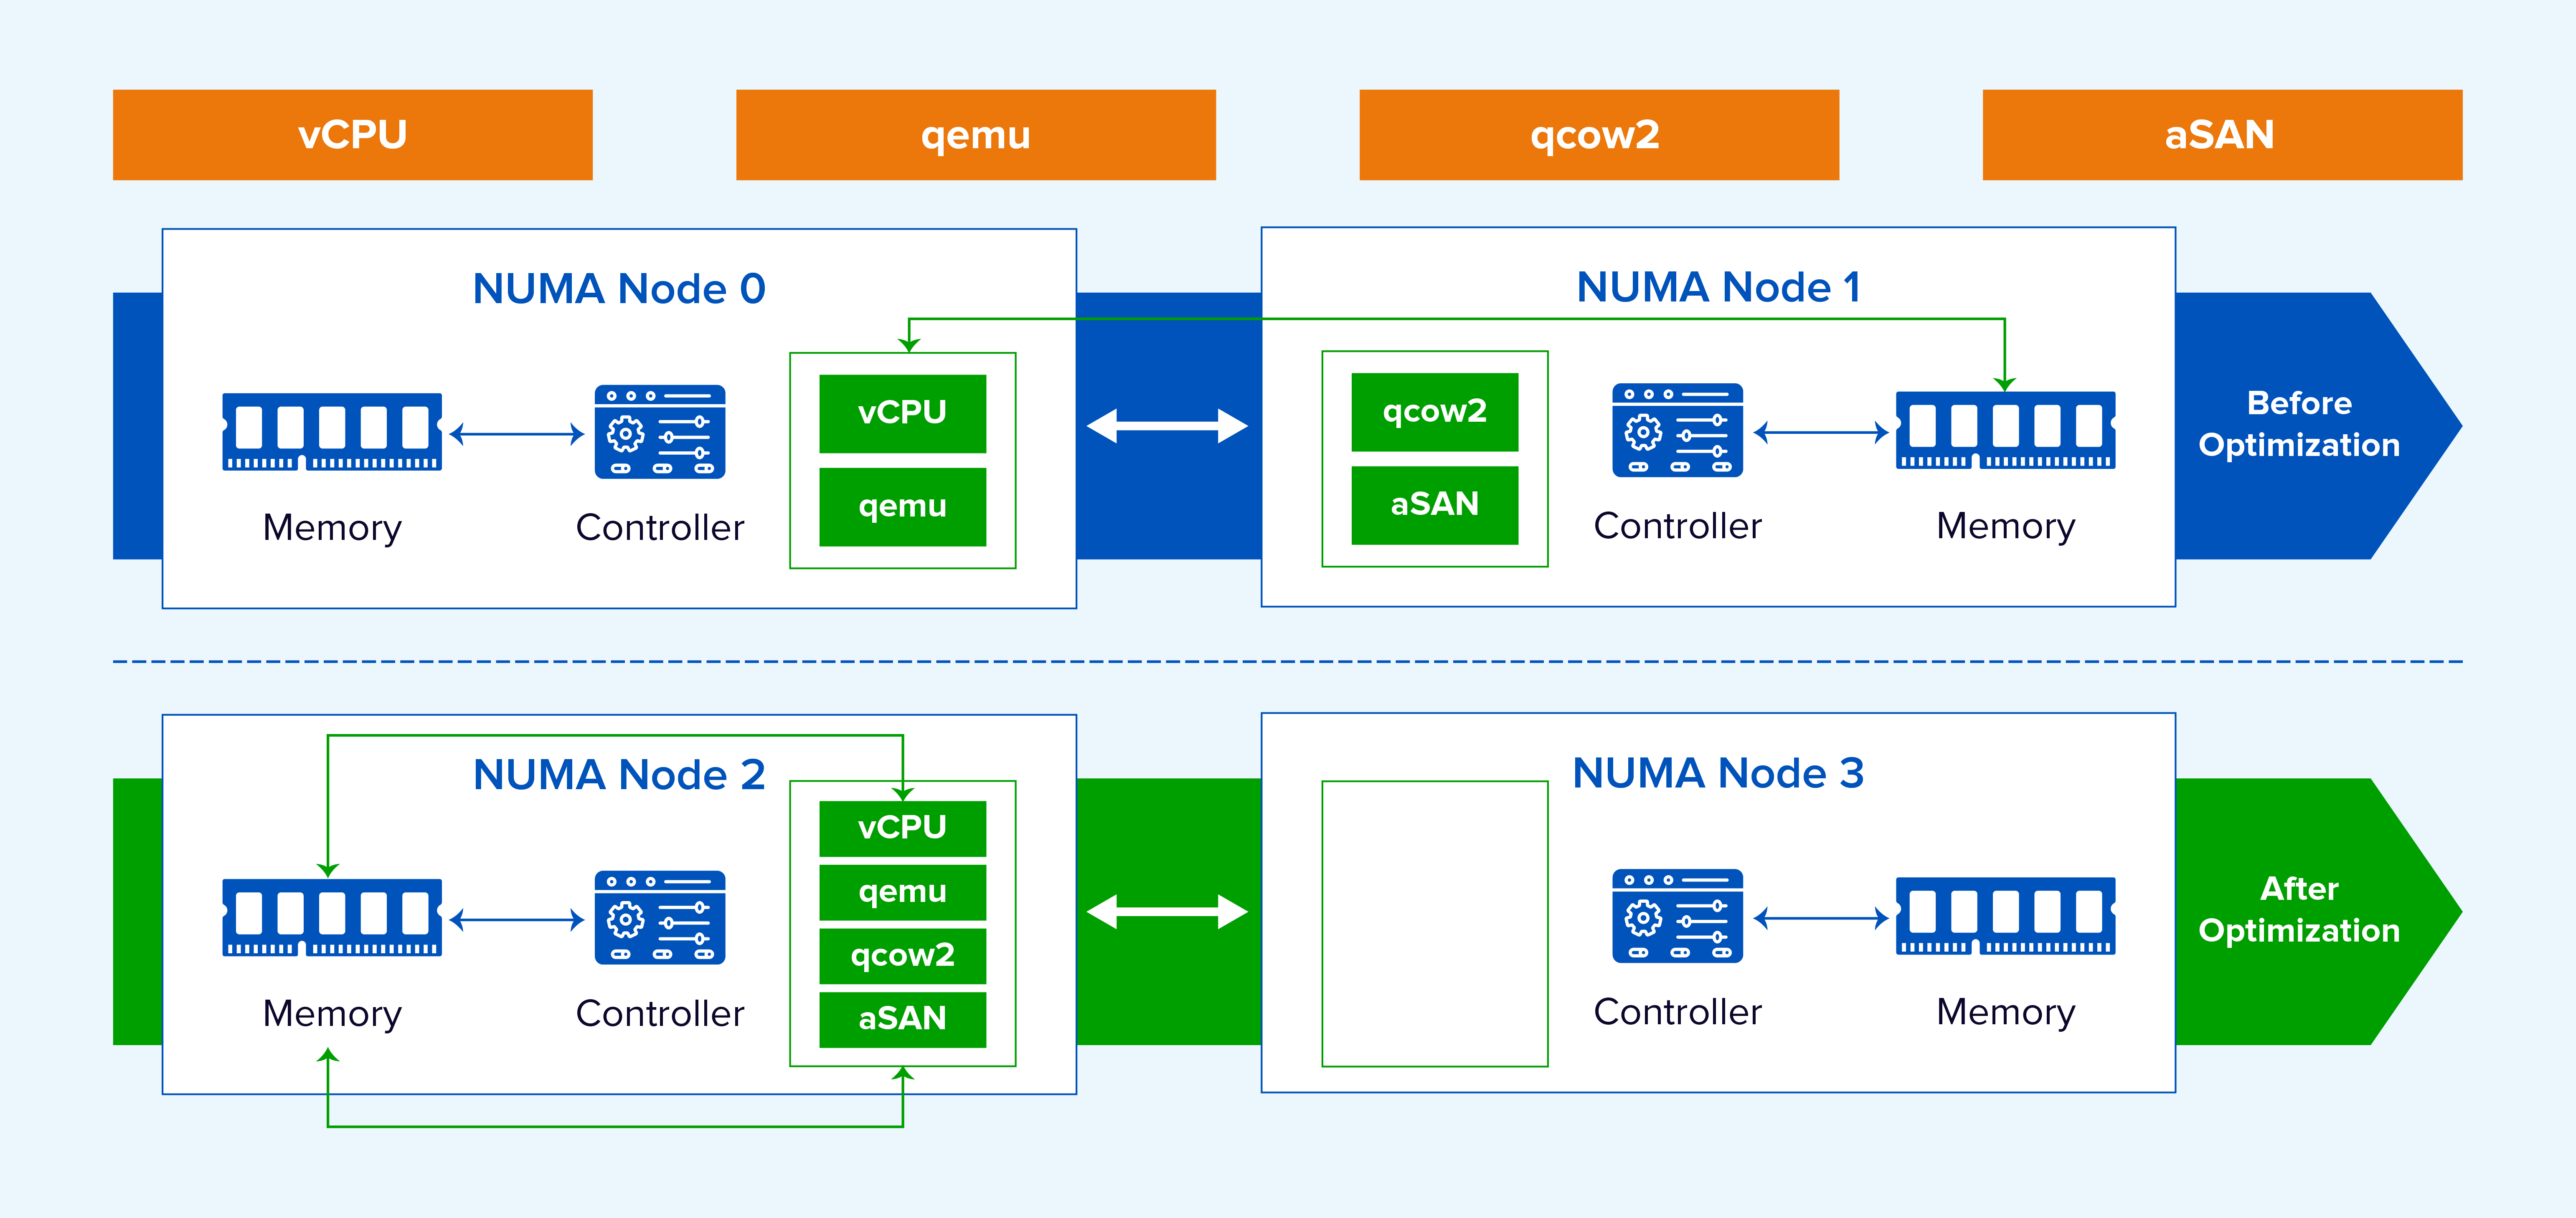
Hình 10. Vị trí NUMA được phối hợp dọc theo đường dẫn I/O lưu trữ ảo.
Dữ liệu di chuyển từ bộ đệm NIC đến bộ nhớ ảo phải được xử lý bởi các luồng CPU. Khi hiệu suất mạng tăng lên, hiệu quả sao chép bộ đệm của một lõi CPU có thể trở thành nút thắt cổ chai, trong khi truy cập đa NUMA càng làm giảm hiệu quả hơn nữa. Sangfor cho phép nhiều lõi CPU xử lý lưu lượng NIC và áp dụng tính năng ưu tiên NUMA. Điều này loại bỏ nút thắt cổ chai của một lõi, giảm độ trễ truyền tải và cải thiện khả năng xử lý đồng thời. Trong các thử nghiệm nội bộ, hiệu suất ghi VM khối lớn, độ sâu hàng đợi cao đã được cải thiện hơn 20%.
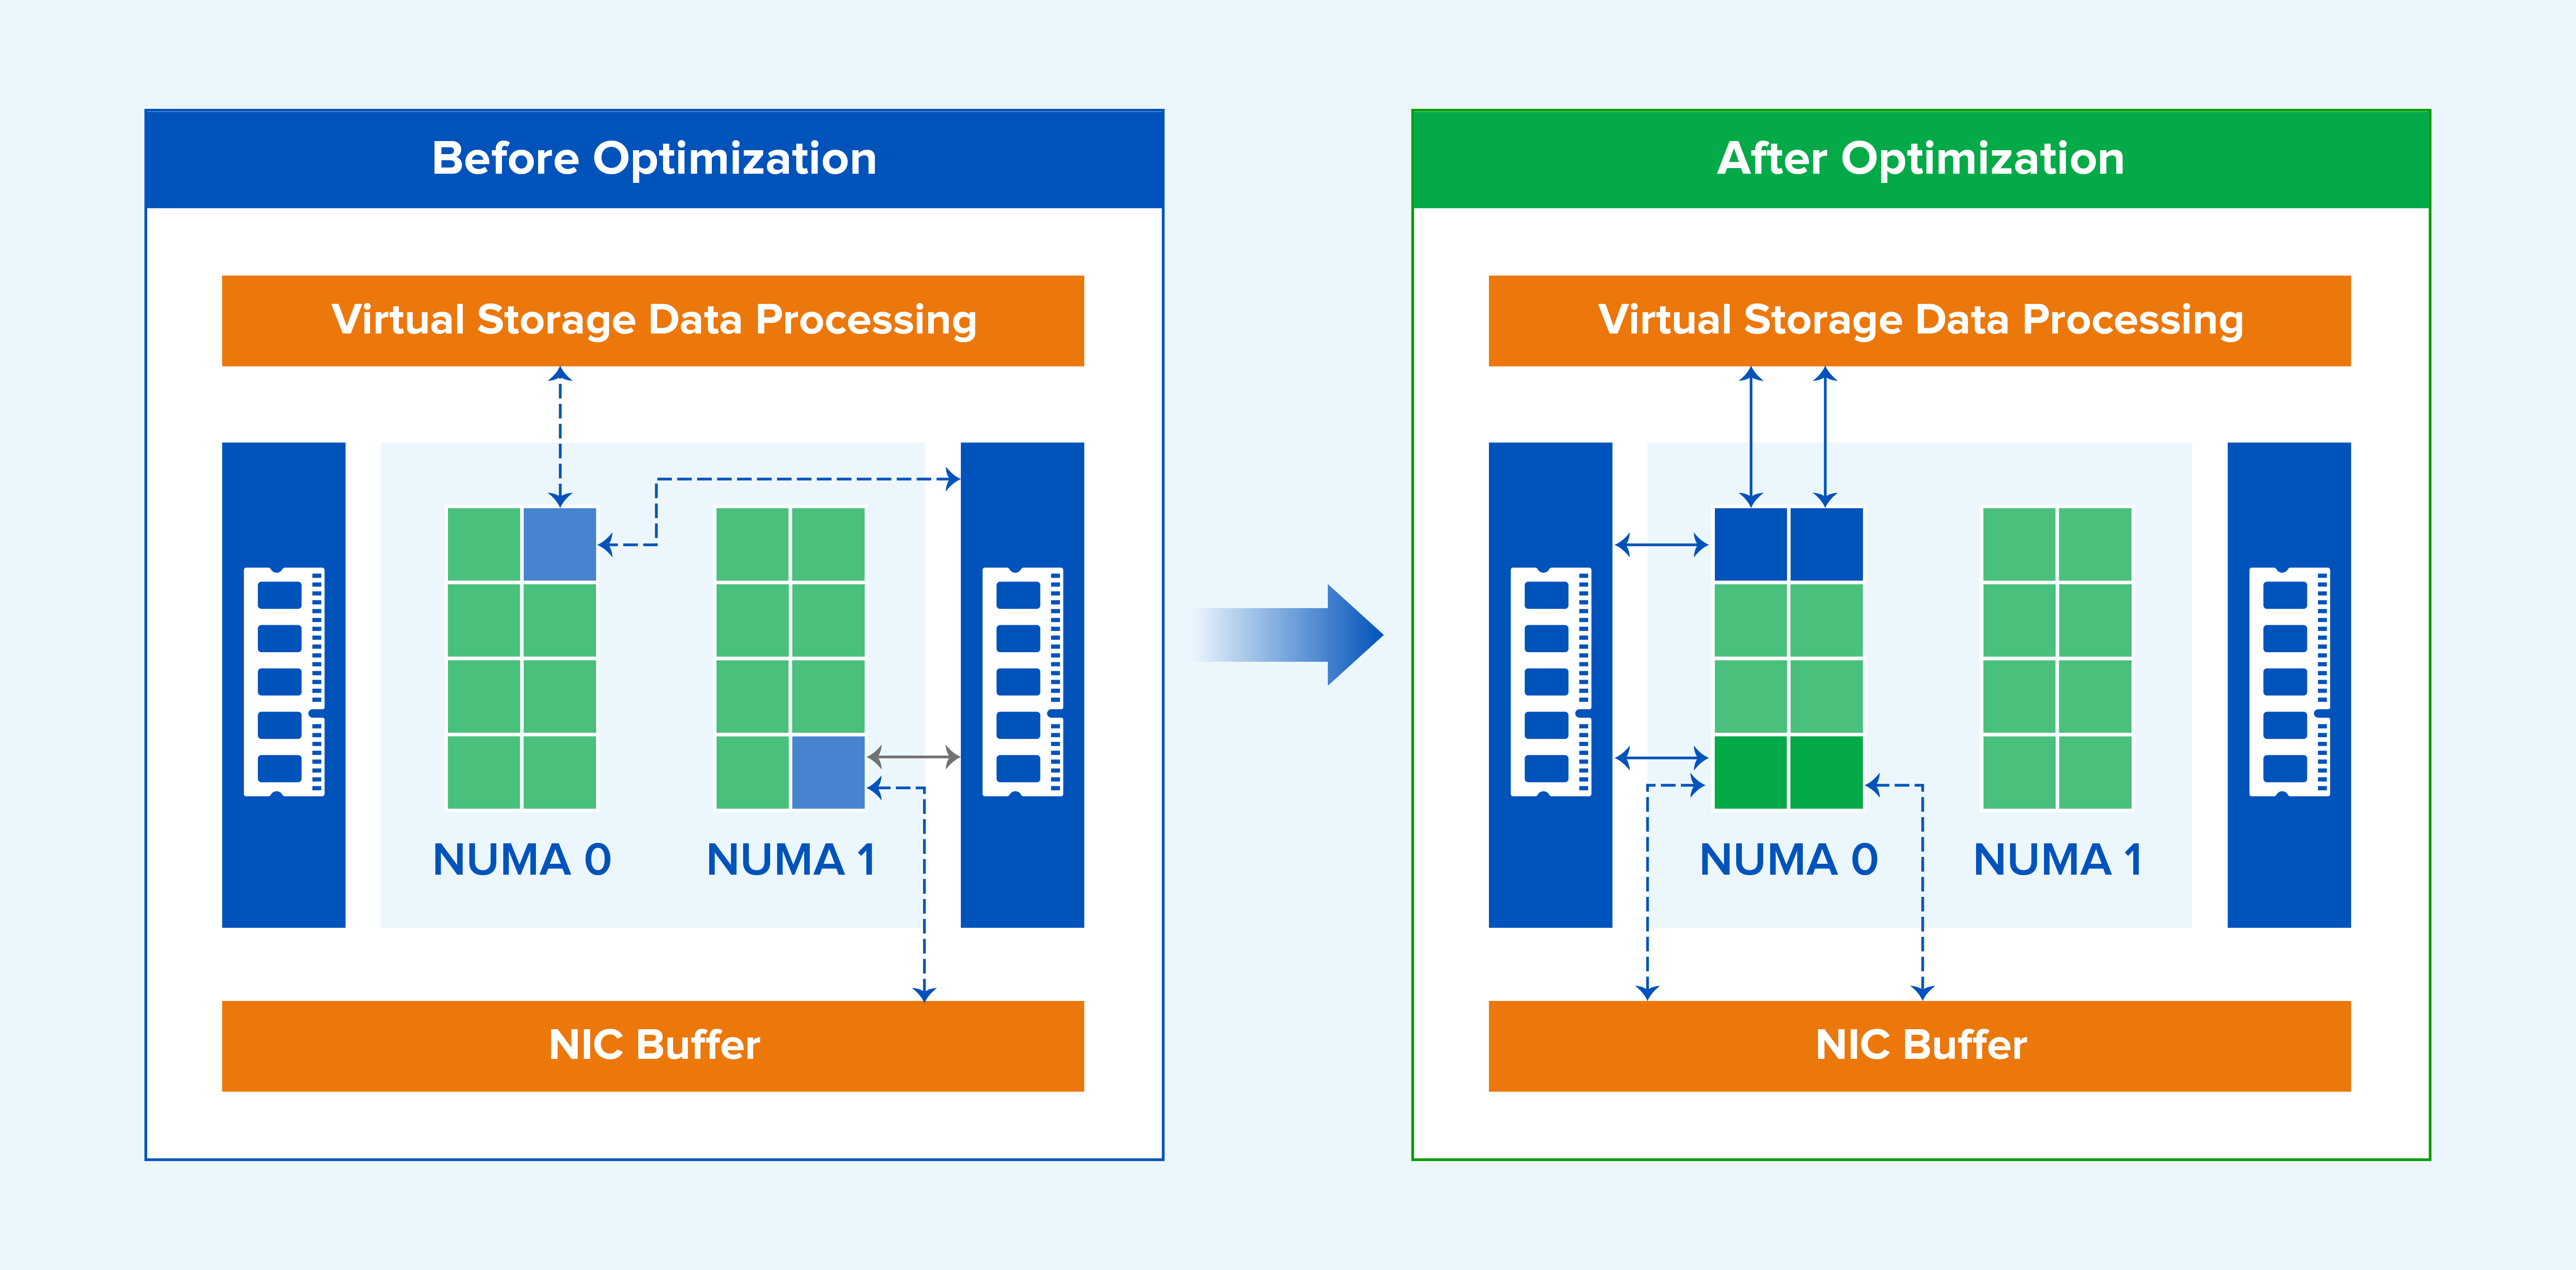
Hình 11. Xử lý đa lõi, tương thích NUMA giữa bộ đệm NIC và bộ nhớ ảo.
3. So sánh với các phương pháp tiếp cận khác trong ngành
Sự hỗ trợ từ các nhà cung cấp khác nhau tùy thuộc vào từng ngành. Một số nhà cung cấp cho phép quản trị viên cấu hình nút NUMA mà mỗi vCPU của máy ảo chạy trên đó, một số khác thì không hỗ trợ khả năng này, và VMware hỗ trợ lập lịch NUMA thích ứng.
Sangfor tự động phân vùng và đặt các vCPU của máy ảo trên các nút NUMA để giảm truy cập bộ nhớ từ xa. So với việc cấu hình thủ công vị trí của từng vCPU, lập lịch NUMA thích ứng của Sangfor tự động hóa việc phân vùng và đặt vCPU, cân bằng việc sử dụng giữa các nút và cải thiện hiệu suất tổng thể.
So với triển khai NUMA thích ứng cơ bản, Sangfor mở rộng khả năng tối ưu hóa sang lập lịch dịch vụ lưu trữ, nhận diện máy ảo ưu tiên, nền tảng máy chủ không đồng nhất và liên kết mạng máy ảo. Những cải tiến này phản ánh sự hợp tác kỹ thuật giữa nhóm nghiên cứu Sangfor và nhóm sản phẩm đám mây, được thiết kế dựa trên hành vi dịch vụ nền tảng thực tế.
PHẦN 5. Tóm tắt
Thuật toán lập lịch NUMA thích ứng của Sangfor được tối ưu hóa cho nhiều kịch bản cơ sở hạ tầng khác nhau nhằm cải thiện hiệu quả truy cập bộ nhớ của ứng dụng:
- Phân vùng và đặt vCPU của máy ảo một cách thích ứng trên các nút NUMA để giảm truy cập bộ nhớ từ xa.
- Di chuyển máy ảo giữa các nút NUMA để duy trì sự cân bằng sử dụng tài nguyên.
- Xác định các máy ảo ưu tiên và đặt chúng trên các máy chủ ít bị tranh chấp hơn, giảm sự cạnh tranh về CPU, băng thông bộ nhớ và bộ nhớ đệm.
- Đối với các máy chủ có nhiều nút NUMA và khoảng cách giữa các nút khác nhau, hãy xác định khoảng cách cấu trúc liên kết và ưu tiên đặt các tài nguyên vNUMA liên quan trên các nút NUMA vật lý gần đó.
- Cung cấp tùy chọn liên kết mạng VM để đặt VM trên cùng một nút NUMA với mặt phẳng dữ liệu mạng nhằm cải thiện hiệu suất chuyển tiếp.
- Áp dụng lập lịch nhận biết NUMA không chỉ cho máy ảo mà còn cho các dịch vụ lưu trữ.
Ví dụ kiểm thử UnixBench
UnixBench là một công cụ đo hiệu năng được sử dụng rộng rãi cho các hệ thống giống Unix, bao gồm UNIX, BSD và Linux. Nó đo lường nhiều khía cạnh hiệu năng của hệ thống, bao gồm hiệu năng CPU, hệ thống tập tin, bộ nhớ và tiến trình.
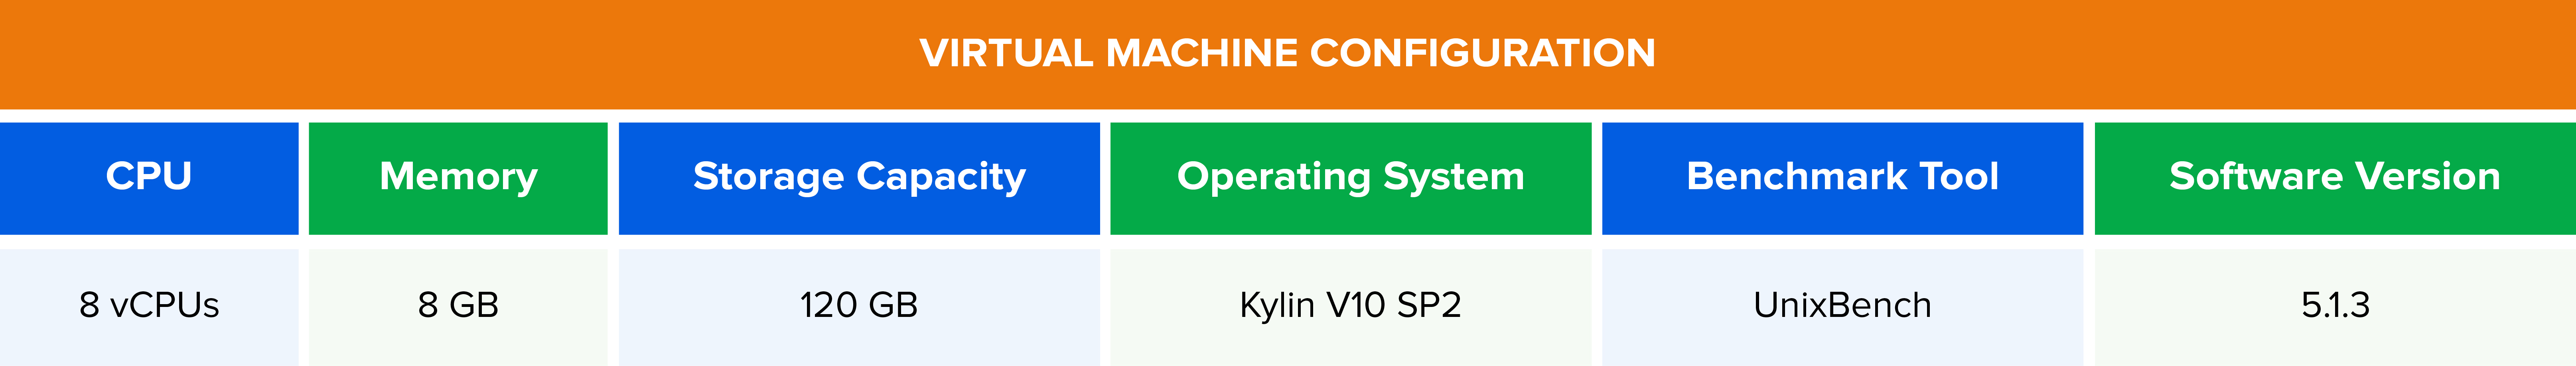
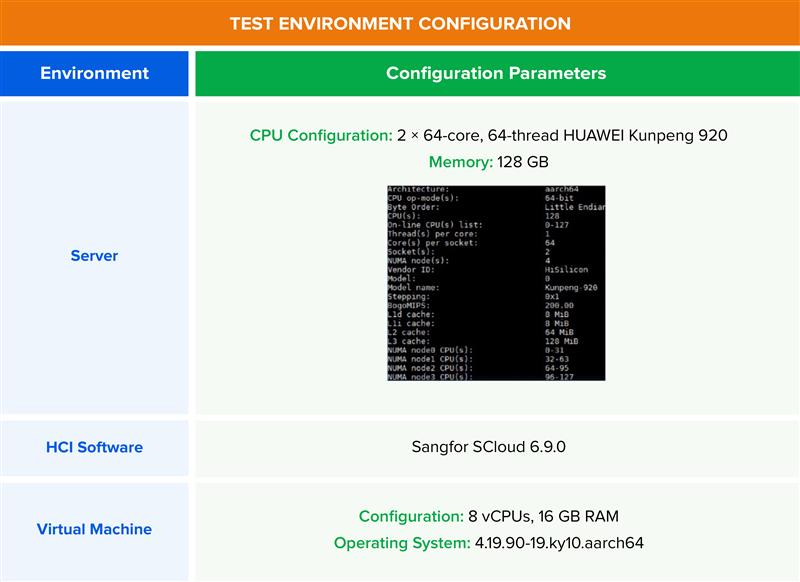
Hình 12. Cấu hình máy ảo để kiểm thử UnixBench.
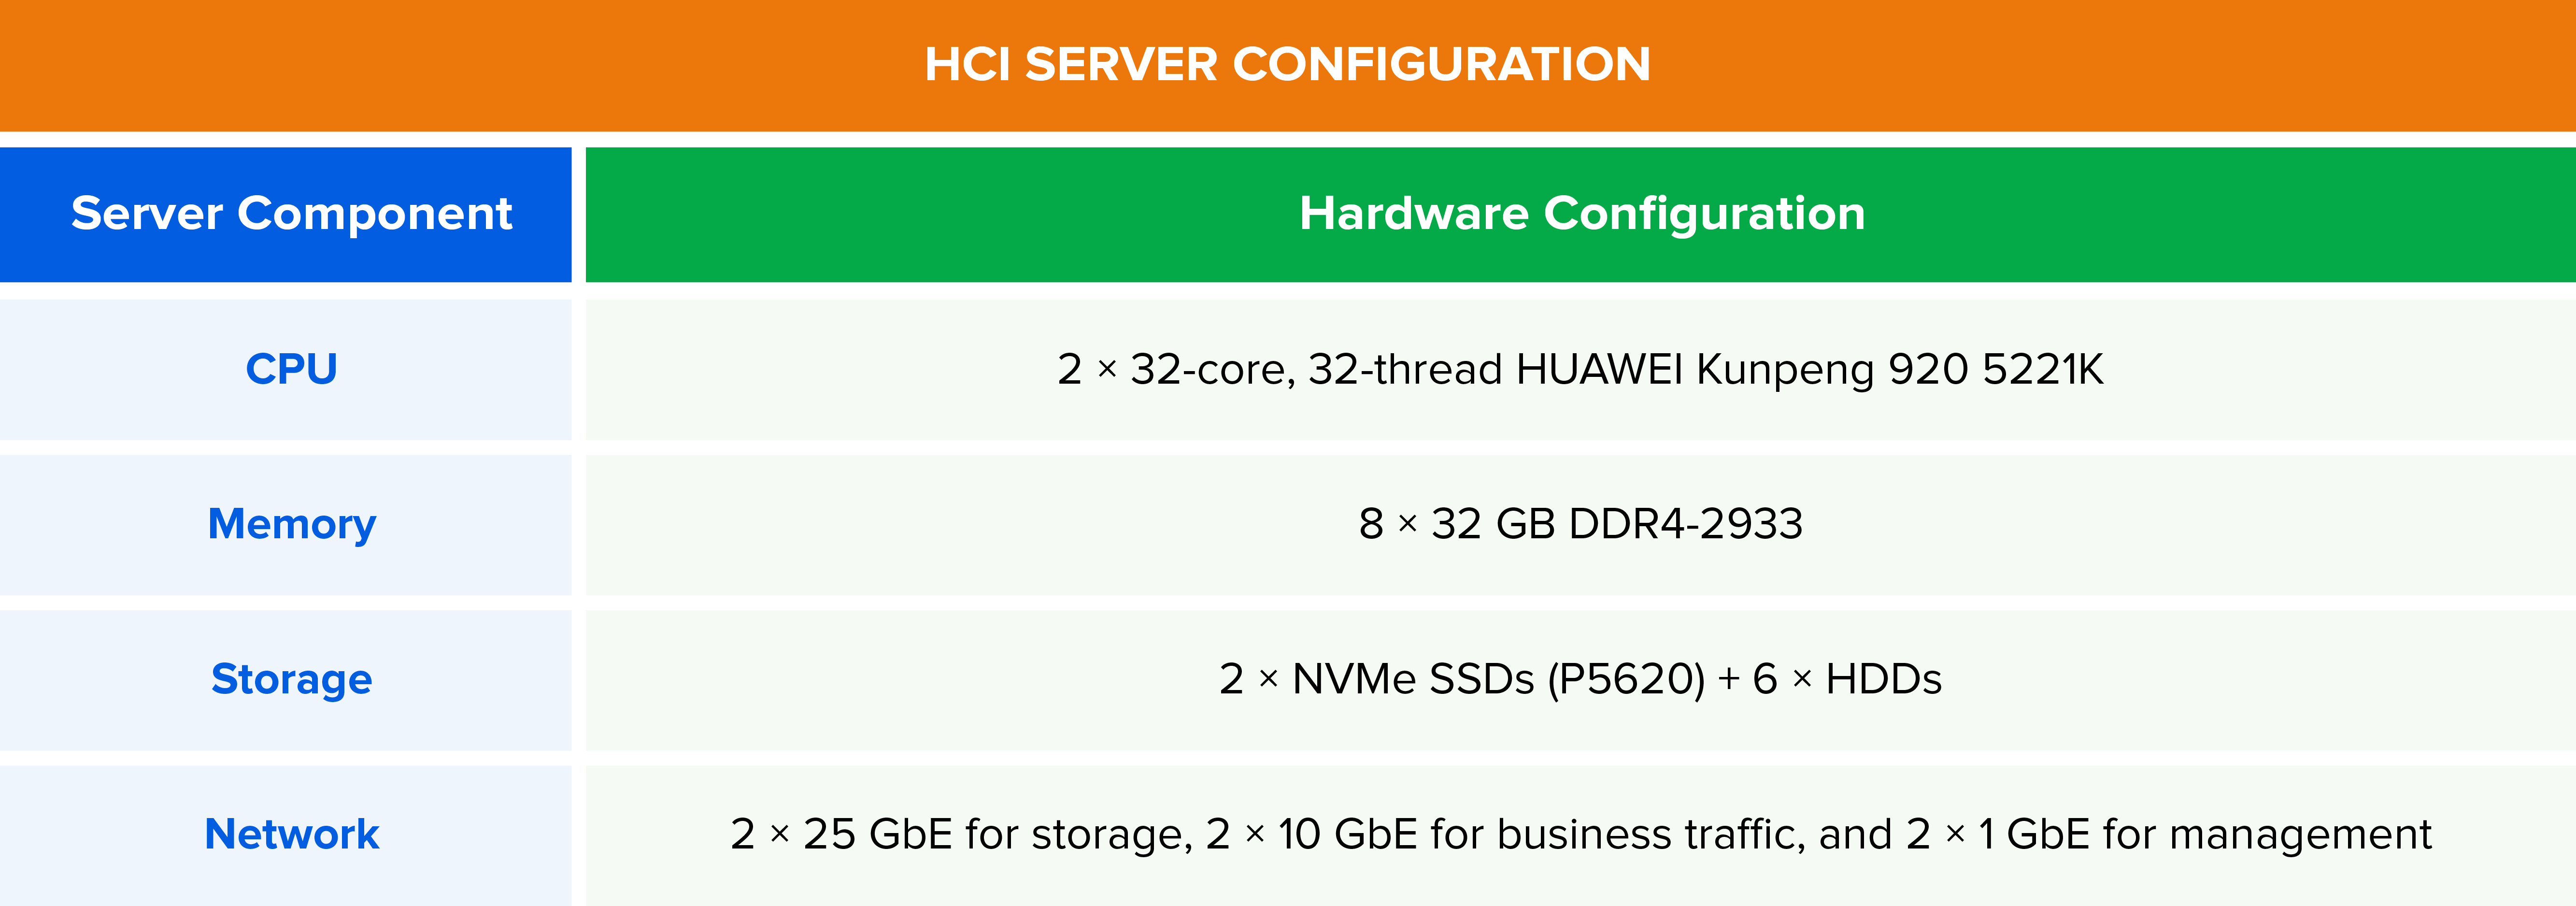
Hình 13. Cấu hình phần cứng máy chủ HCI để kiểm thử UnixBench.
Kết quả kiểm tra: Trong Sangfor HCI 6.9.0, với NUMA được bật, điểm số UnixBench tổng hợp cho 6 máy ảo chạy đồng thời trên cùng một máy chủ cao hơn 20,2% so với nền tảng so sánh ẩn danh. Đối với 8 máy ảo chạy đồng thời, điểm số tổng hợp cao hơn 34,17%.
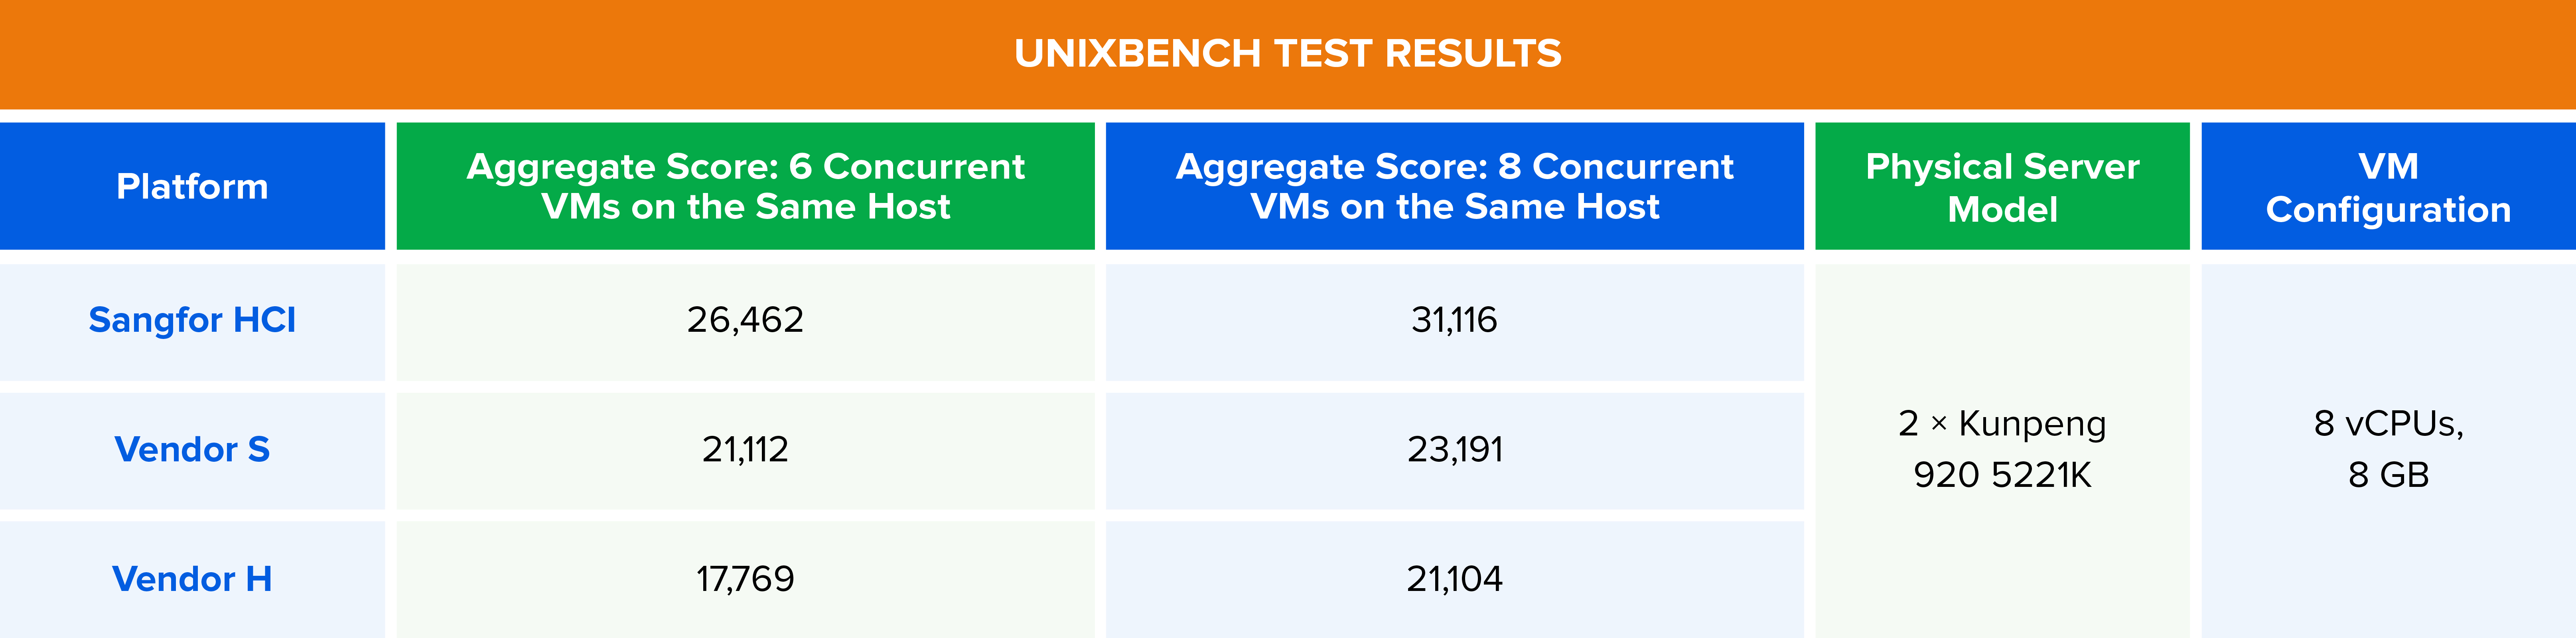
Hình 14. Kết quả so sánh hiệu năng UnixBench dưới tải trọng máy ảo đồng thời.
Các kết quả kiểm tra hiệu năng trong bài viết này phản ánh môi trường thử nghiệm nội bộ cụ thể của Sangfor và được cung cấp để minh họa kỹ thuật. Kết quả thực tế có thể khác nhau tùy thuộc vào phần cứng, phiên bản phần mềm, cấu hình và khối lượng công việc. Khách hàng nên tự đánh giá các ứng dụng tiêu biểu so với mục tiêu mức độ dịch vụ của riêng mình.

