
เนื่องจากองค์กรต่างๆ ย้ายเวิร์กโหลดที่สำคัญต่อธุรกิจไปยังโครงสร้างพื้นฐานเสมือนจริง ไฮเปอร์คอนเวอร์เจนซ์ และคลาวด์มากขึ้นเรื่อยๆ ประสิทธิภาพภายใต้การทำงานพร้อมกันจำนวนมากจึงกลายเป็นสิ่งสำคัญอันดับต้นๆ สำหรับทีมที่กำลังประเมินหาแพลตฟอร์ม ทดแทน VMware คำถามไม่ได้อยู่ที่ว่าแพลตฟอร์มอื่นสามารถให้ฟังก์ชันการทำงานที่คล้ายคลึงกันได้หรือไม่ แต่ยังอยู่ที่ว่าแพลตฟอร์มนั้นสามารถรองรับความหน่วงแฝง ปริมาณงาน และความเสถียรที่ระบบธุรกิจหลักต้องการได้หรือไม่
ความท้าทายนี้เห็นได้ชัดเจนเป็นพิเศษในแอปพลิเคชันที่ใช้หน่วยความจำสูง เช่น การซื้อขายความถี่สูงและการจัดการความเสี่ยงในบริการทางการเงิน ระบบบันทึกสุขภาพอิเล็กทรอนิกส์ในด้านการดูแลสุขภาพ และระบบจัดการคลังสินค้าในด้านโลจิสติกส์ ความต้องการการเข้าถึงหน่วยความจำที่เพิ่มขึ้นนั้นเกี่ยวข้องอย่างใกล้ชิดกับส่วนประกอบแบ็กเอนด์ เช่น Redis, Apache Spark, SAP HANA และเครื่องมือหรือโมเดล AI ตัวอย่างเช่น Redis เป็นฐานข้อมูลในหน่วยความจำที่ประสิทธิภาพได้รับผลกระทบโดยตรงจากความเร็วในการเข้าถึงหน่วยความจำ
NUMA เป็นสถาปัตยกรรม CPU เซิร์ฟเวอร์หลักในปัจจุบัน ดังนั้น การปรับปรุงประสิทธิภาพการเข้าถึงหน่วยความจำภายใต้ NUMA จึงเป็นสิ่งสำคัญในการเพิ่มประสิทธิภาพการทำงานของเวอร์ชวลไลเซชัน บทความนี้จะอธิบายเทคโนโลยีการเพิ่มประสิทธิภาพ NUMA ของ Sangfor และวิธีที่เทคโนโลยีเหล่านี้ช่วยให้แพลตฟอร์มเวอร์ชวลไลเซชันรองรับเวิร์กโหลดที่สำคัญต่อธุรกิจและมีการทำงานพร้อมกันสูงในระหว่างการเปลี่ยนผ่านไปสู่ VMware
ส่วนที่ 1. ข้อมูลเบื้องต้นเกี่ยวกับสถาปัตยกรรม NUMA
ระบบคอมพิวเตอร์ในยุคแรกมักใช้โปรเซสเซอร์ตัวเดียวสำหรับงานประมวลผลทั้งหมด เมื่อแอปพลิเคชันมีความซับซ้อนและต้องการประสิทธิภาพสูงมากขึ้น โปรเซสเซอร์ตัวเดียวจึงไม่สามารถตอบสนองความต้องการด้านการประมวลผลประสิทธิภาพสูงได้อีกต่อไป และระบบจึงค่อยๆ พัฒนาไปสู่สถาปัตยกรรมแบบมัลติคอร์
ระบบมัลติคอร์แบบดั้งเดิมมักใช้การประมวลผลแบบสมมาตร (SMP) ภายใต้ SMP โปรเซสเซอร์ทุกตัวมีสถานะเท่าเทียมกันและมีสิทธิ์เข้าถึงหน่วยความจำเหมือนกัน เธรดใดๆ ก็สามารถทำงานบนโปรเซสเซอร์ใดก็ได้ ทำให้สามารถกระจายภาระงานได้อย่างมีประสิทธิภาพและปรับปรุงประสิทธิภาพและปริมาณงานโดยรวม อย่างไรก็ตาม เนื่องจากหลายคอร์ใช้บัสเดียวกันในการเข้าถึงหน่วยความจำ บัสจึงอาจกลายเป็นคอขวดเมื่อจำนวนคอร์เพิ่มขึ้น ซึ่งจำกัดความสามารถในการขยายขนาดและประสิทธิภาพ
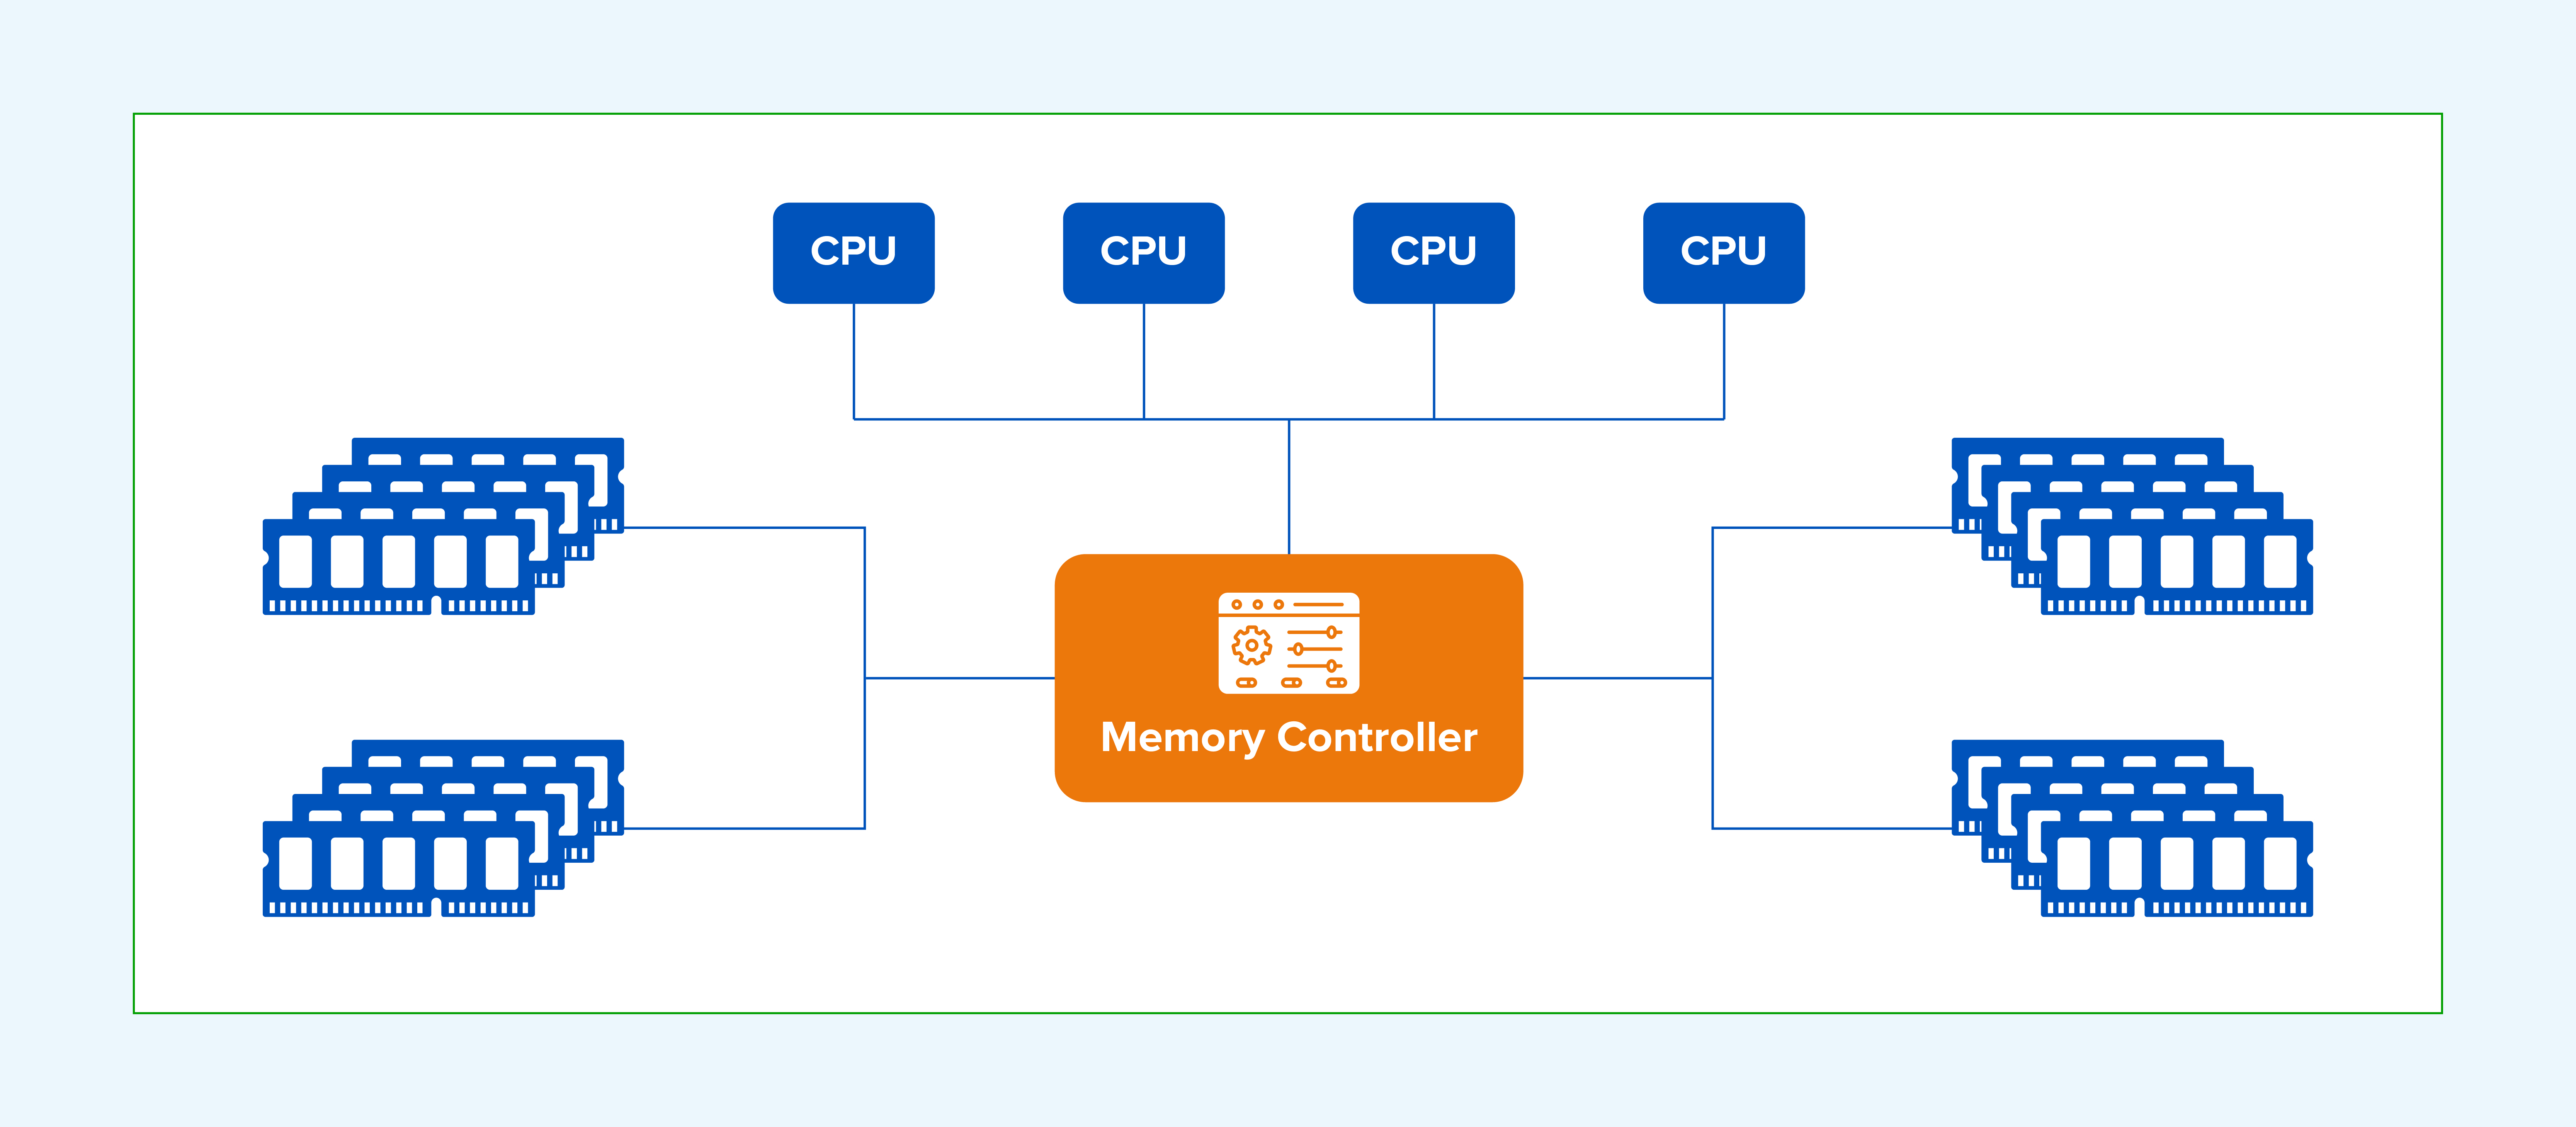
รูปที่ 1: ปัญหาคอขวดในการเข้าถึงหน่วยความจำแบบใช้บัสร่วมในสถาปัตยกรรม SMP แบบดั้งเดิม
สถาปัตยกรรม NUMA ช่วยแก้ปัญหาคอขวดในการเข้าถึงหน่วยความจำของระบบมัลติโปรเซสเซอร์ (SMP) ในสถาปัตยกรรม NUMA ระบบจะถูกแบ่งออกเป็นหลายโหนด แต่ละโหนดประกอบด้วยโปรเซสเซอร์อย่างน้อยหนึ่งตัว หน่วยความจำภายใน และอุปกรณ์ I/O โหนดต่างๆ สื่อสารกันผ่านการเชื่อมต่อความเร็วสูง เช่น AMD HyperTransport หรือ Intel QuickPath Interconnect (QPI) ทำให้โปรเซสเซอร์สามารถเข้าถึงหน่วยความจำภายในได้ก่อน ซึ่งช่วยลดความหน่วงในการเข้าถึงหน่วยความจำและปรับปรุงประสิทธิภาพของระบบมัลติโปรเซสเซอร์
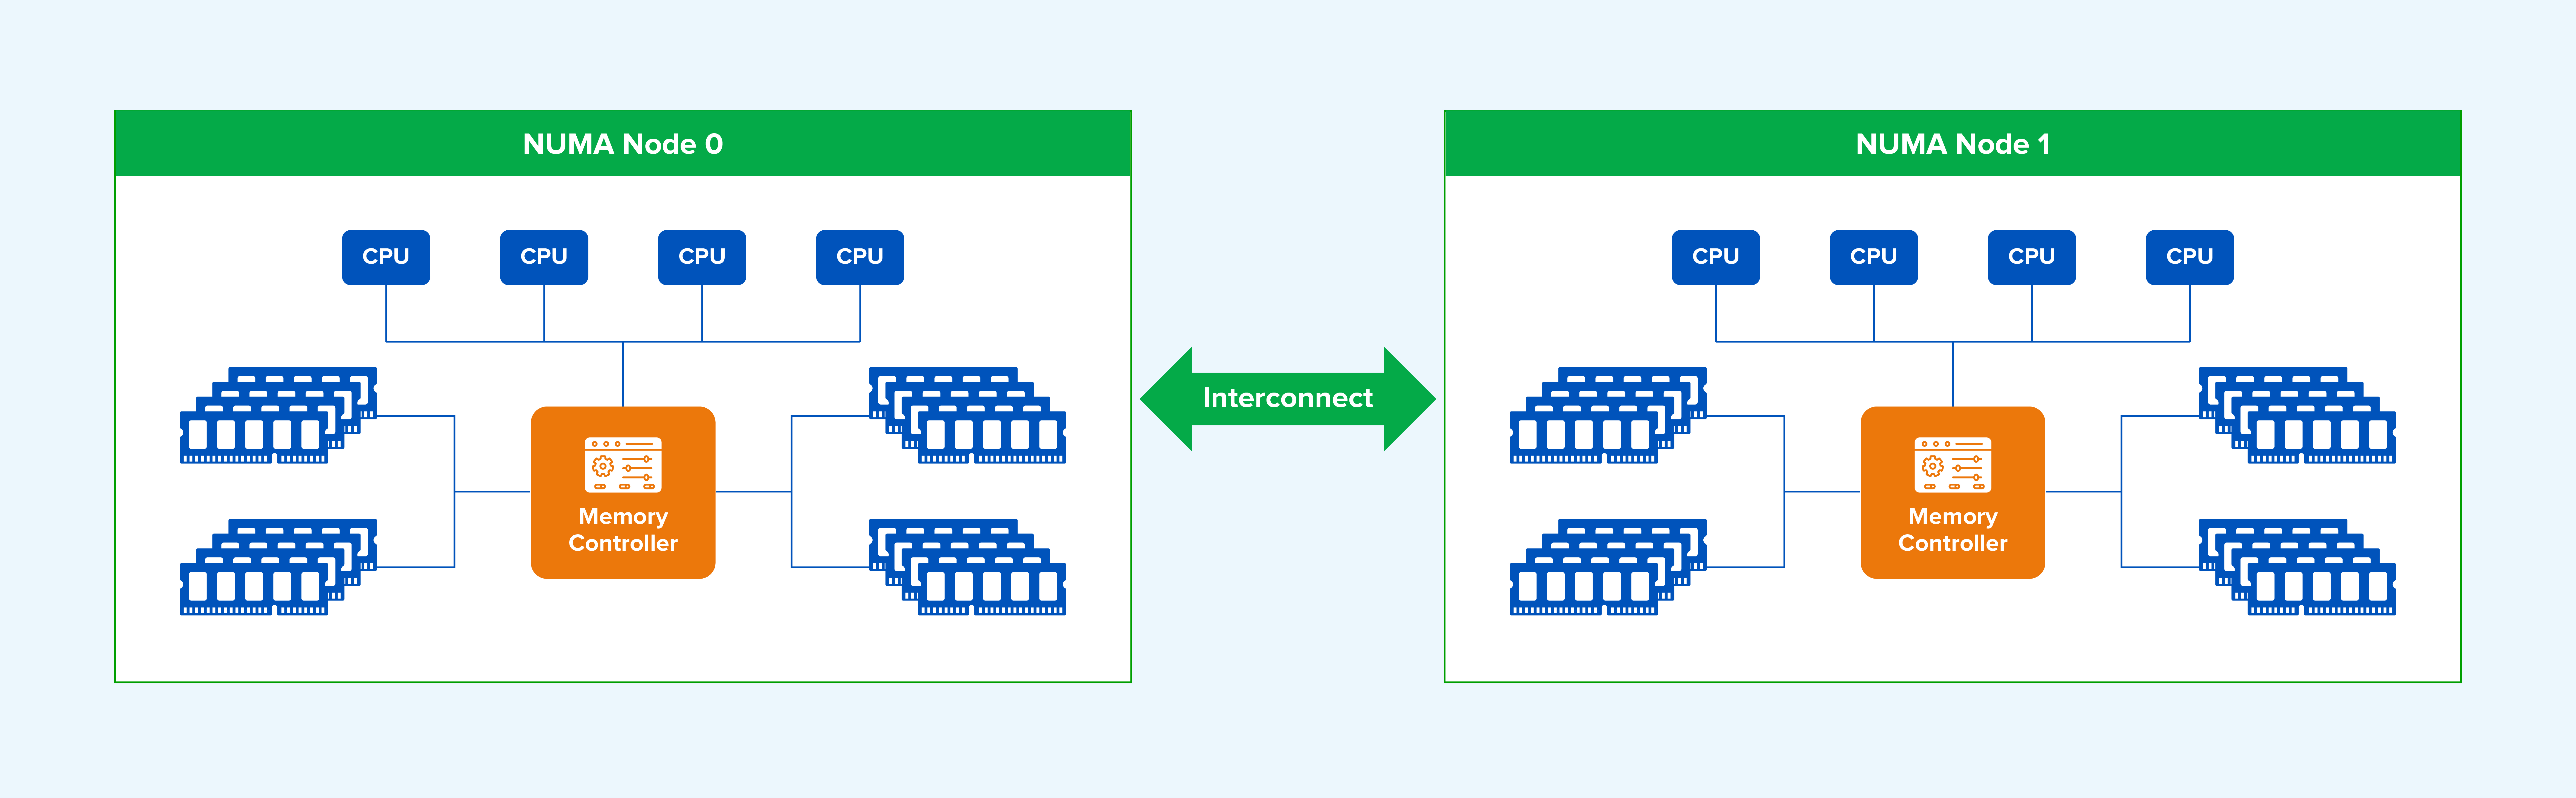
รูปที่ 2: สถาปัตยกรรม NUMA แบบหลายโหนด ซึ่งมีการจัดสรร CPU และหน่วยความจำเฉพาะโหนด
ระบบ NUMA ประกอบด้วยโหนดสามประเภท:
- โหนดท้องถิ่น: สำหรับซีพียูภายในโหนดใดโหนดหนึ่ง โหนดนั้นเรียกว่าโหนดท้องถิ่น
- โหนดข้างเคียง: โหนดที่อยู่ติดกับโหนดท้องถิ่น
- โหนดระยะไกล: โหนดที่ไม่ใช่ทั้งโหนดในพื้นที่และโหนดข้างเคียง
ความเร็วในการเข้าถึงข้อมูลของ CPU แตกต่างกันไปตามประเภทของโหนด หน่วยความจำภายในเครื่องจะเข้าถึงได้เร็วที่สุด ในขณะที่หน่วยความจำระยะไกลจะเข้าถึงได้ช้าที่สุด โดยทั่วไปแล้ว การเข้าถึงหน่วยความจำจะช้าลงเมื่อระยะทางเชิงโครงสร้างเพิ่มขึ้น
ในบทความ “NUMA: ภาพรวม” ดร. คริสตอฟ ลาเมเตอร์ ตั้งข้อสังเกตว่า ในปี 2013 บนเซิร์ฟเวอร์สองโหนดระดับสูง ความหน่วงในการเข้าถึงหน่วยความจำภายในแบบสุ่มอยู่ที่ประมาณ 100 นาโนวินาที ในขณะที่การเข้าถึงหน่วยความจำระยะไกลเพิ่มความหน่วงขึ้นประมาณ 50%
ส่วนที่ 2. ความท้าทายที่เกิดจาก NUMA
ในลินุกซ์ เธรดเป็นหน่วยพื้นฐานของการจัดตารางการทำงานของซีพียู และสอดคล้องกับงานในคิวการทำงานของซีพียู เคอร์เนลจะเลือกซีพียูที่ค่อนข้างว่างสำหรับแต่ละงาน เนื่องจากภาระการทำงานของซีพียูเปลี่ยนแปลงแบบไดนามิก เคอร์เนลจึงใช้การปรับสมดุลภาระการทำงานเพื่อย้ายงานไปยังซีพียูที่มีภาระการทำงานน้อยกว่า ดังนั้นโดยค่าเริ่มต้น งานจึงอาจย้ายไปมาระหว่างซีพียูได้
ภายใต้ระบบ NUMA งานอาจย้ายจาก CPU บนโหนด 1 ไปยัง CPU บนโหนด 2 ในขณะที่ยังคงเข้าถึงหน่วยความจำที่จัดสรรไว้บนโหนด 1 ส่งผลให้เกิดการเข้าถึงข้ามโหนด การปรับสมดุล NUMA ของ Linux จะย้ายงานหรือหน้าหน่วยความจำไปยังโหนดท้องถิ่นเป็นระยะ แต่ไม่สามารถกำจัดการเข้าถึงหน่วยความจำระยะไกลทั้งหมดได้
ในสภาพแวดล้อมเสมือนจริง vCPU แต่ละตัว ของ VM จะสอดคล้องกับเธรดของระบบปฏิบัติการโฮสต์ หากมีเธรด vCPU หลายเธรดทำงานบนโหนด NUMA ที่แตกต่างกันในขณะที่ใช้หน่วยความจำร่วมกัน หรือมีการย้ายระหว่างโหนด VM อาจเข้าถึงหน่วยความจำข้ามโหนด NUMA และประสบกับความหน่วงที่สูงขึ้น
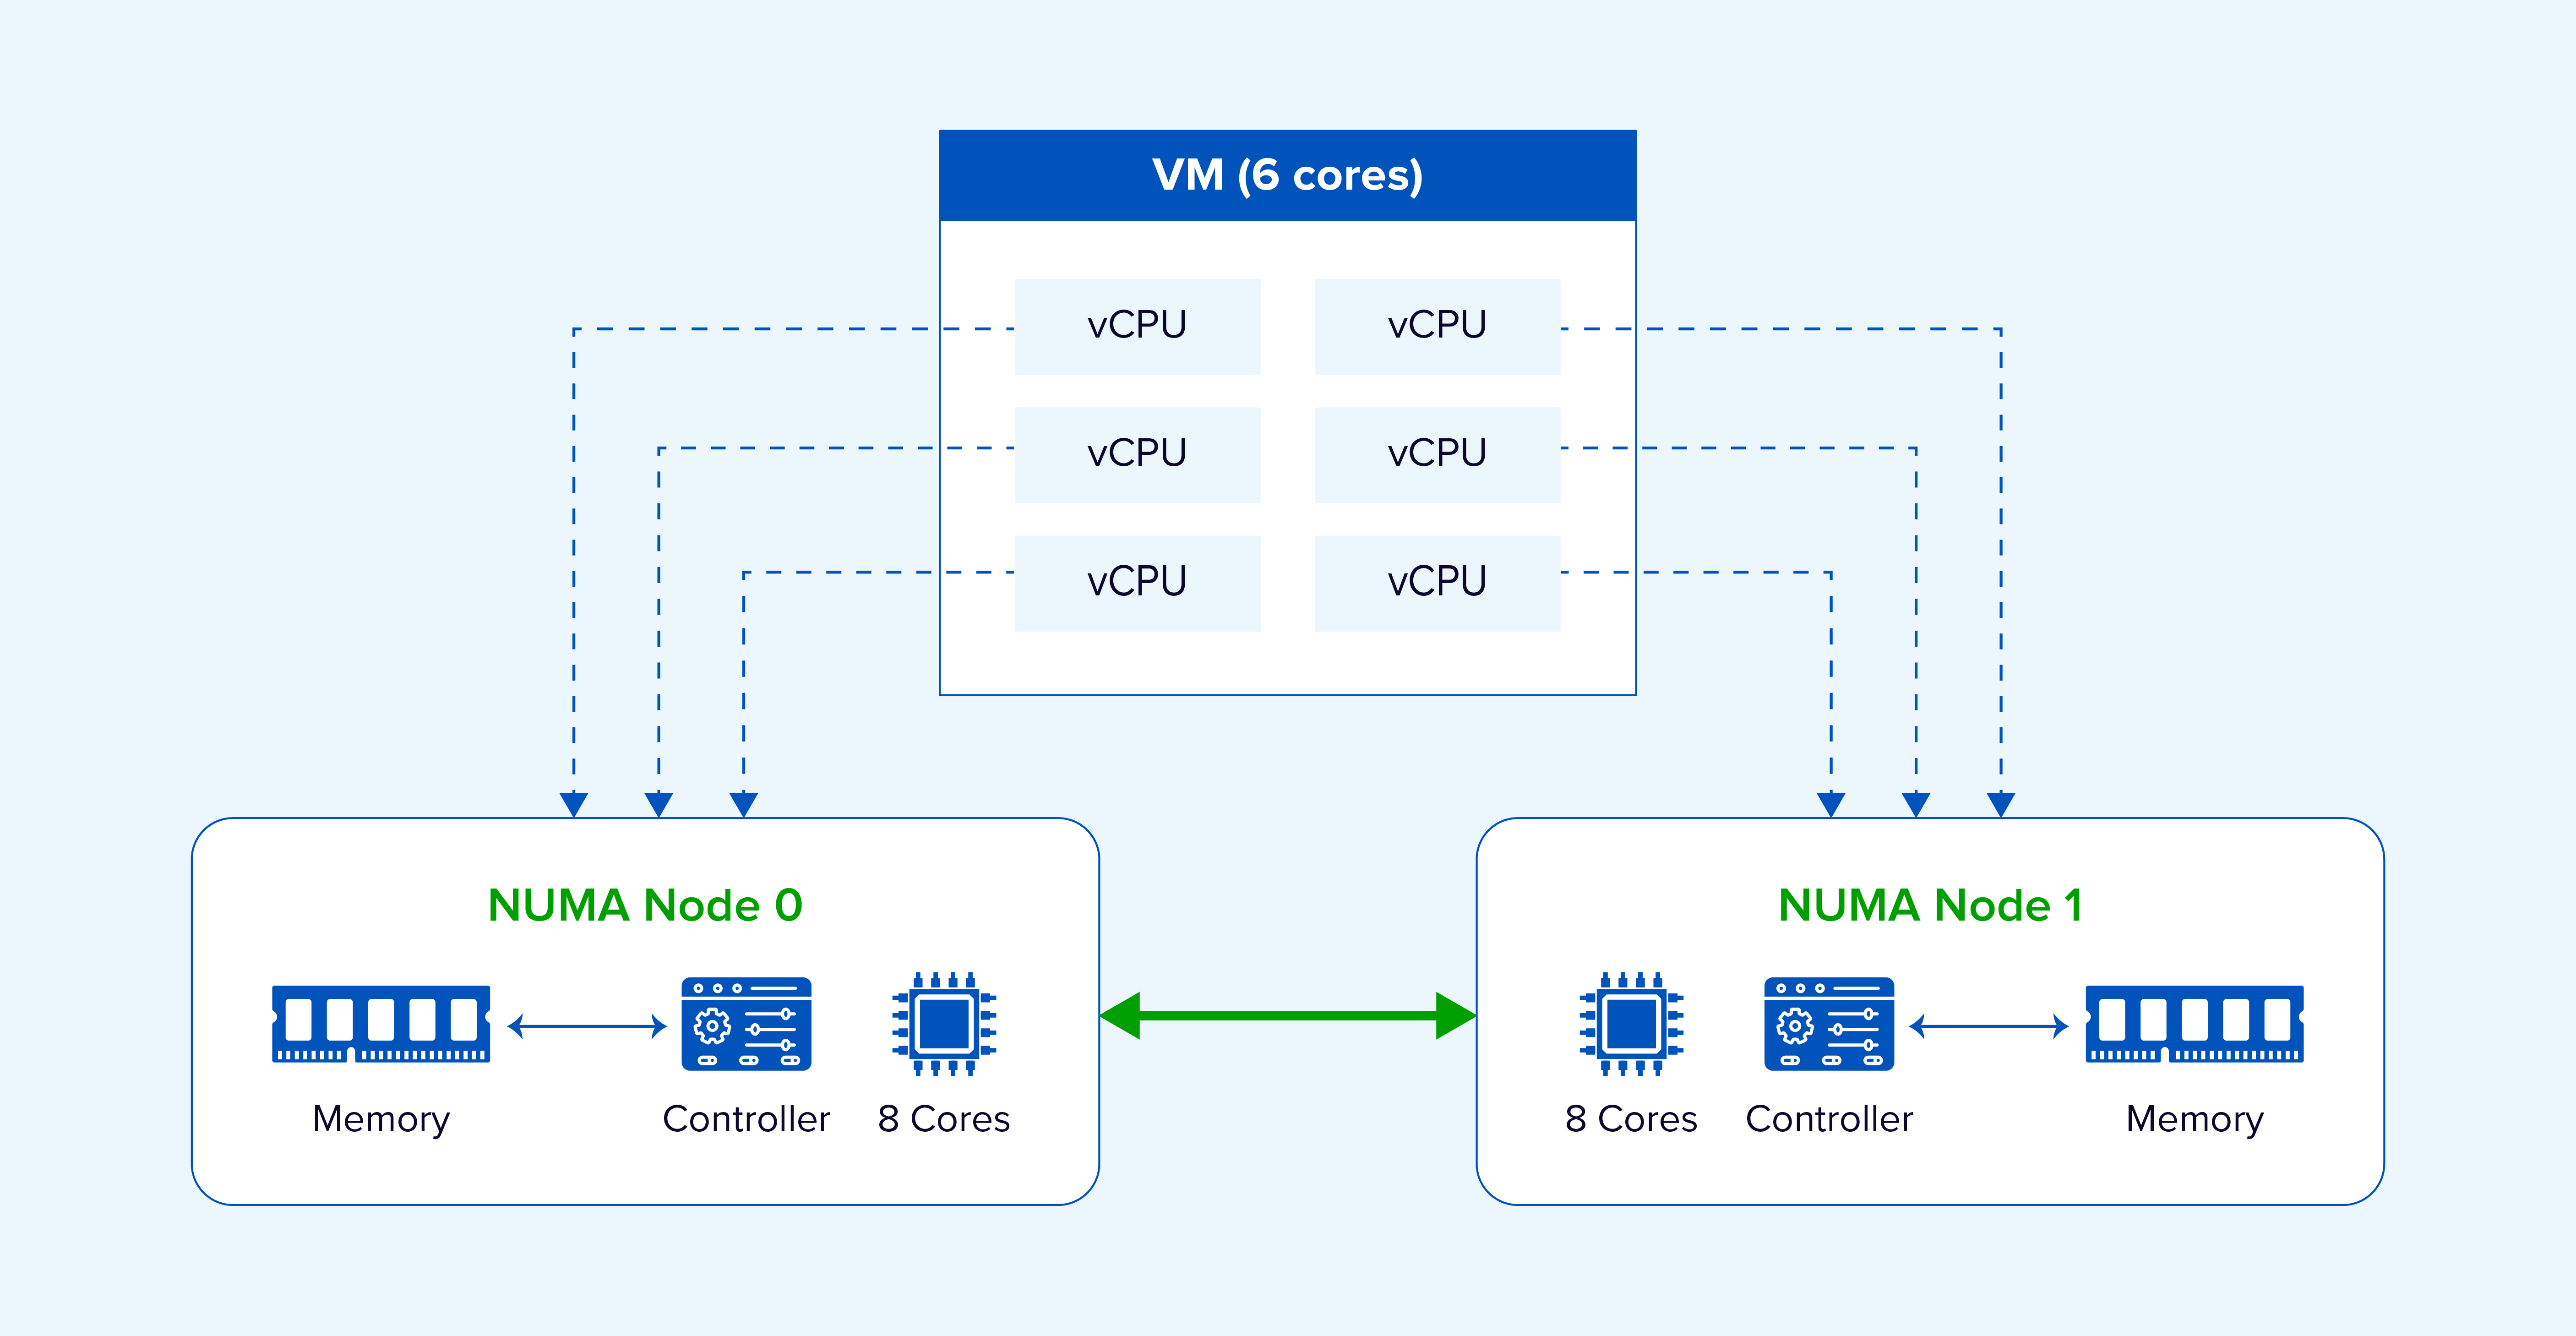
รูปที่ 3: การประมวลผลข้ามโหนดสามารถเพิ่มการเข้าถึงหน่วยความจำระยะไกลสำหรับเครื่องเสมือนได้
ส่วนที่ 3. แนวทางการจัดตารางงาน NUMA ทั่วไป
โดยทั่วไปแล้วอุตสาหกรรมนี้มักใช้วิธีการดังต่อไปนี้:
แนวทางที่ 1: กำหนด vCPU ให้กับคอร์ทางกายภาพ
ผู้ดูแลระบบกำหนดค่าการตรึง vCPU ด้วยตนเอง เพื่อให้ทรัพยากร VM ทำงานภายในโหนด NUMA ทางกายภาพเดียวกันเป็นหลัก
แนวทางที่ 2: ระบุจำนวนโหนด NUMA ที่กำหนดให้กับ VM
ผู้ดูแลระบบจะกำหนดค่าจำนวนโหนด NUMA ด้วยตนเอง และกระจายทรัพยากร vCPU และหน่วยความจำอย่างเท่าเทียมกันไปยังโหนดเหล่านั้น
แนวทางที่ 3: จัดสรรโหนด NUMA แบบปรับเปลี่ยนได้
ตัวจัดตารางเวลาจะกำหนดโหนด NUMA ที่เหมาะสมให้กับ VM โดยอัตโนมัติ CPU ของ VM จะถูกจำกัดไว้ที่โหนดเหล่านั้นและจะใช้หน่วยความจำภายในเครื่องเป็นหลักเพื่อปรับปรุงประสิทธิภาพการใช้งาน หาก VM มี vCPU มากกว่าที่โหนด NUMA เดียวจะรองรับได้ ระบบจะกระจาย VM ไปยังหลายโหนด โครงสร้าง NUMA สามารถเปิดเผยให้กับระบบปฏิบัติการของเครื่องเสมือนเพื่อการตัดสินใจที่คำนึงถึงโครงสร้าง ในขณะที่ VM สามารถย้ายระหว่างโหนดเพื่อรักษาสมดุลของภาระงานได้
แนวทางที่ 1 และ 2 กำหนดข้อจำกัดมากกว่า ต้องกำหนดขนาด CPU ของ VM อย่างระมัดระวัง และอาจทำให้เกิดความไม่สมดุลระหว่างโหนด NUMA เนื่องจากการผูกแบบคงที่ ดังนั้น การจัดสรรแบบปรับเปลี่ยนได้จึงเหมาะสมกว่าสำหรับสภาพแวดล้อมการผลิตที่มีการเปลี่ยนแปลงตลอดเวลา
ตอนที่ 4. รายละเอียดกำหนดการ Sangfor NUMA
Sangfor HCI ใช้การจัดตารางเวลา NUMA แบบปรับได้เป็นหลัก โดยจะปรับสมดุลการใช้งานระหว่างโหนด NUMA ในขณะเดียวกันก็ลดการเข้าถึงหน่วยความจำระยะไกลโดย vCPU ของ VM ซึ่งจะช่วยปรับปรุงประสิทธิภาพโดยรวม
การจัดตารางเวลา NUMA แบบปรับได้ให้ประโยชน์ด้านการเพิ่มประสิทธิภาพอย่างชัดเจนในแอปพลิเคชันประเภทต่างๆ โดยเฉพาะอย่างยิ่งมิดเดิลแวร์ที่มีการทำงานภายในหน่วยความจำบ่อยครั้ง Sangfor ได้ติดตั้ง DM8, Redis และ Memcached ใน VM และทำการทดสอบประสิทธิภาพโดยเปิดและปิดใช้งานการจัดตารางเวลา NUMA ผลลัพธ์แสดงให้เห็นถึงการปรับปรุงประสิทธิภาพของมิดเดิลแวร์อย่างชัดเจนเมื่อเปิดใช้งานการจัดตารางเวลา NUMA
ปริมาณงานฐานข้อมูล: Dameng DB (DM8) พร้อม BenchmarkSQL
BenchmarkSQL เป็นโปรแกรมทดสอบประสิทธิภาพฐานข้อมูลเชิงสัมพันธ์ที่รันธุรกรรมแบบ TPC-C ซึ่งรวมถึงคำสั่งซื้อใหม่ การชำระเงิน การสอบถามสถานะคำสั่งซื้อ การจัดส่ง และการสอบถามระดับสต็อก ค่าเมตริก tpmC ที่ได้จะแสดงจำนวนธุรกรรมคำสั่งซื้อใหม่ที่ประมวลผลต่อนาที โดยค่าที่สูงกว่าแสดงถึงประสิทธิภาพที่ดีกว่า เราใช้ BenchmarkSQL 5.0 ในการทดสอบฐานข้อมูล DM8 แผนภูมิAต่อไปนี้แสดงประสิทธิภาพเชิงเปรียบเทียบ โดยค่า tpmC ที่ปิดใช้งาน NUMA ถูกปรับให้เป็น 100%
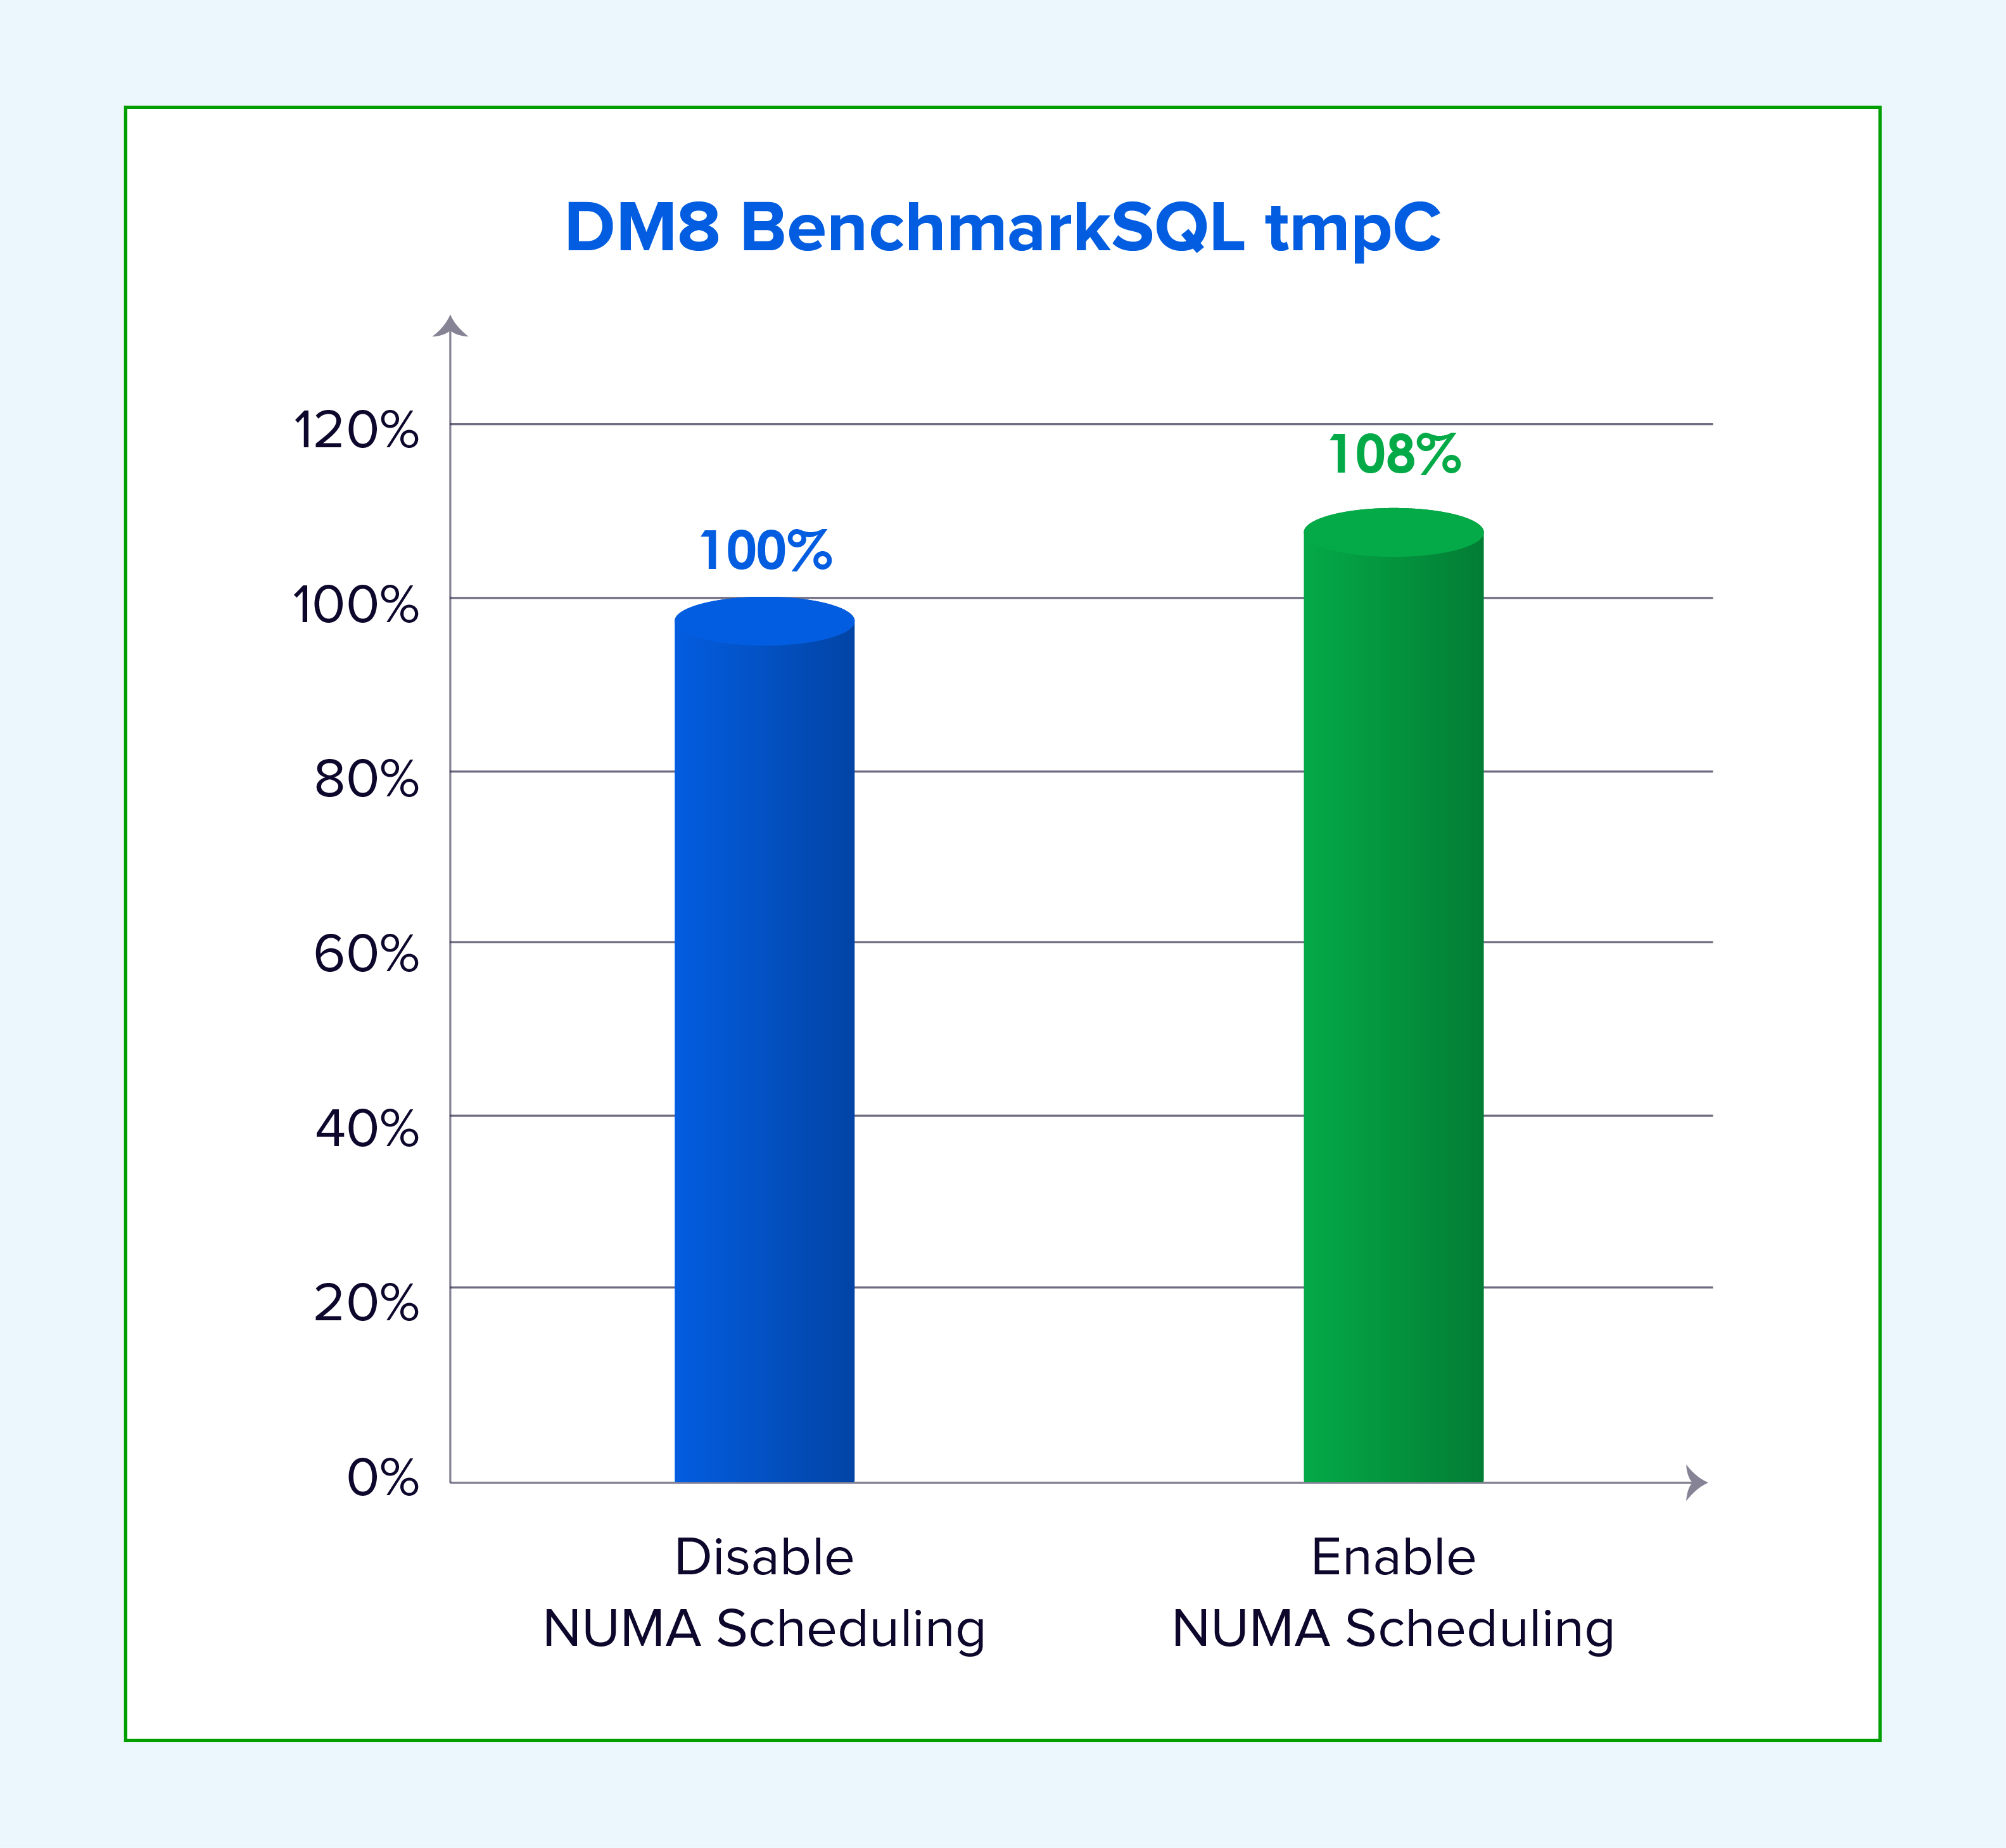
รูปที่ 4: อัตราการประมวลผลธุรกรรม DM8 สัมพัทธ์เมื่อเปิดใช้งานการจัดตารางเวลา NUMA เทียบกับเมื่อปิดใช้งาน
การแคชในหน่วยความจำ: Redis 7.2.5
redis-benchmark เป็นเครื่องมือทดสอบประสิทธิภาพ Redis อย่างเป็นทางการ Sangfor ใช้เครื่องมือนี้เพื่อทดสอบค่า GET และ SET QPS สำหรับค่า 1 KB โดยปิดและเปิดใช้งานการจัดตารางเวลา NUMA QPS หมายถึงจำนวนการอ่านหรือเขียนข้อมูลต่อวินาที
redis-benchmark -t get -d 16 -c 100 -n 6000000 -r 60000000
redis-benchmark -t set -d 16 -c 100 -n 6000000 -r 60000000
แผนภูมิAต่อไปนี้แสดงประสิทธิภาพเชิงเปรียบเทียบ โดยผลลัพธ์ QPS ที่ปิดใช้งาน NUMA จะถูกปรับให้เป็น 100%
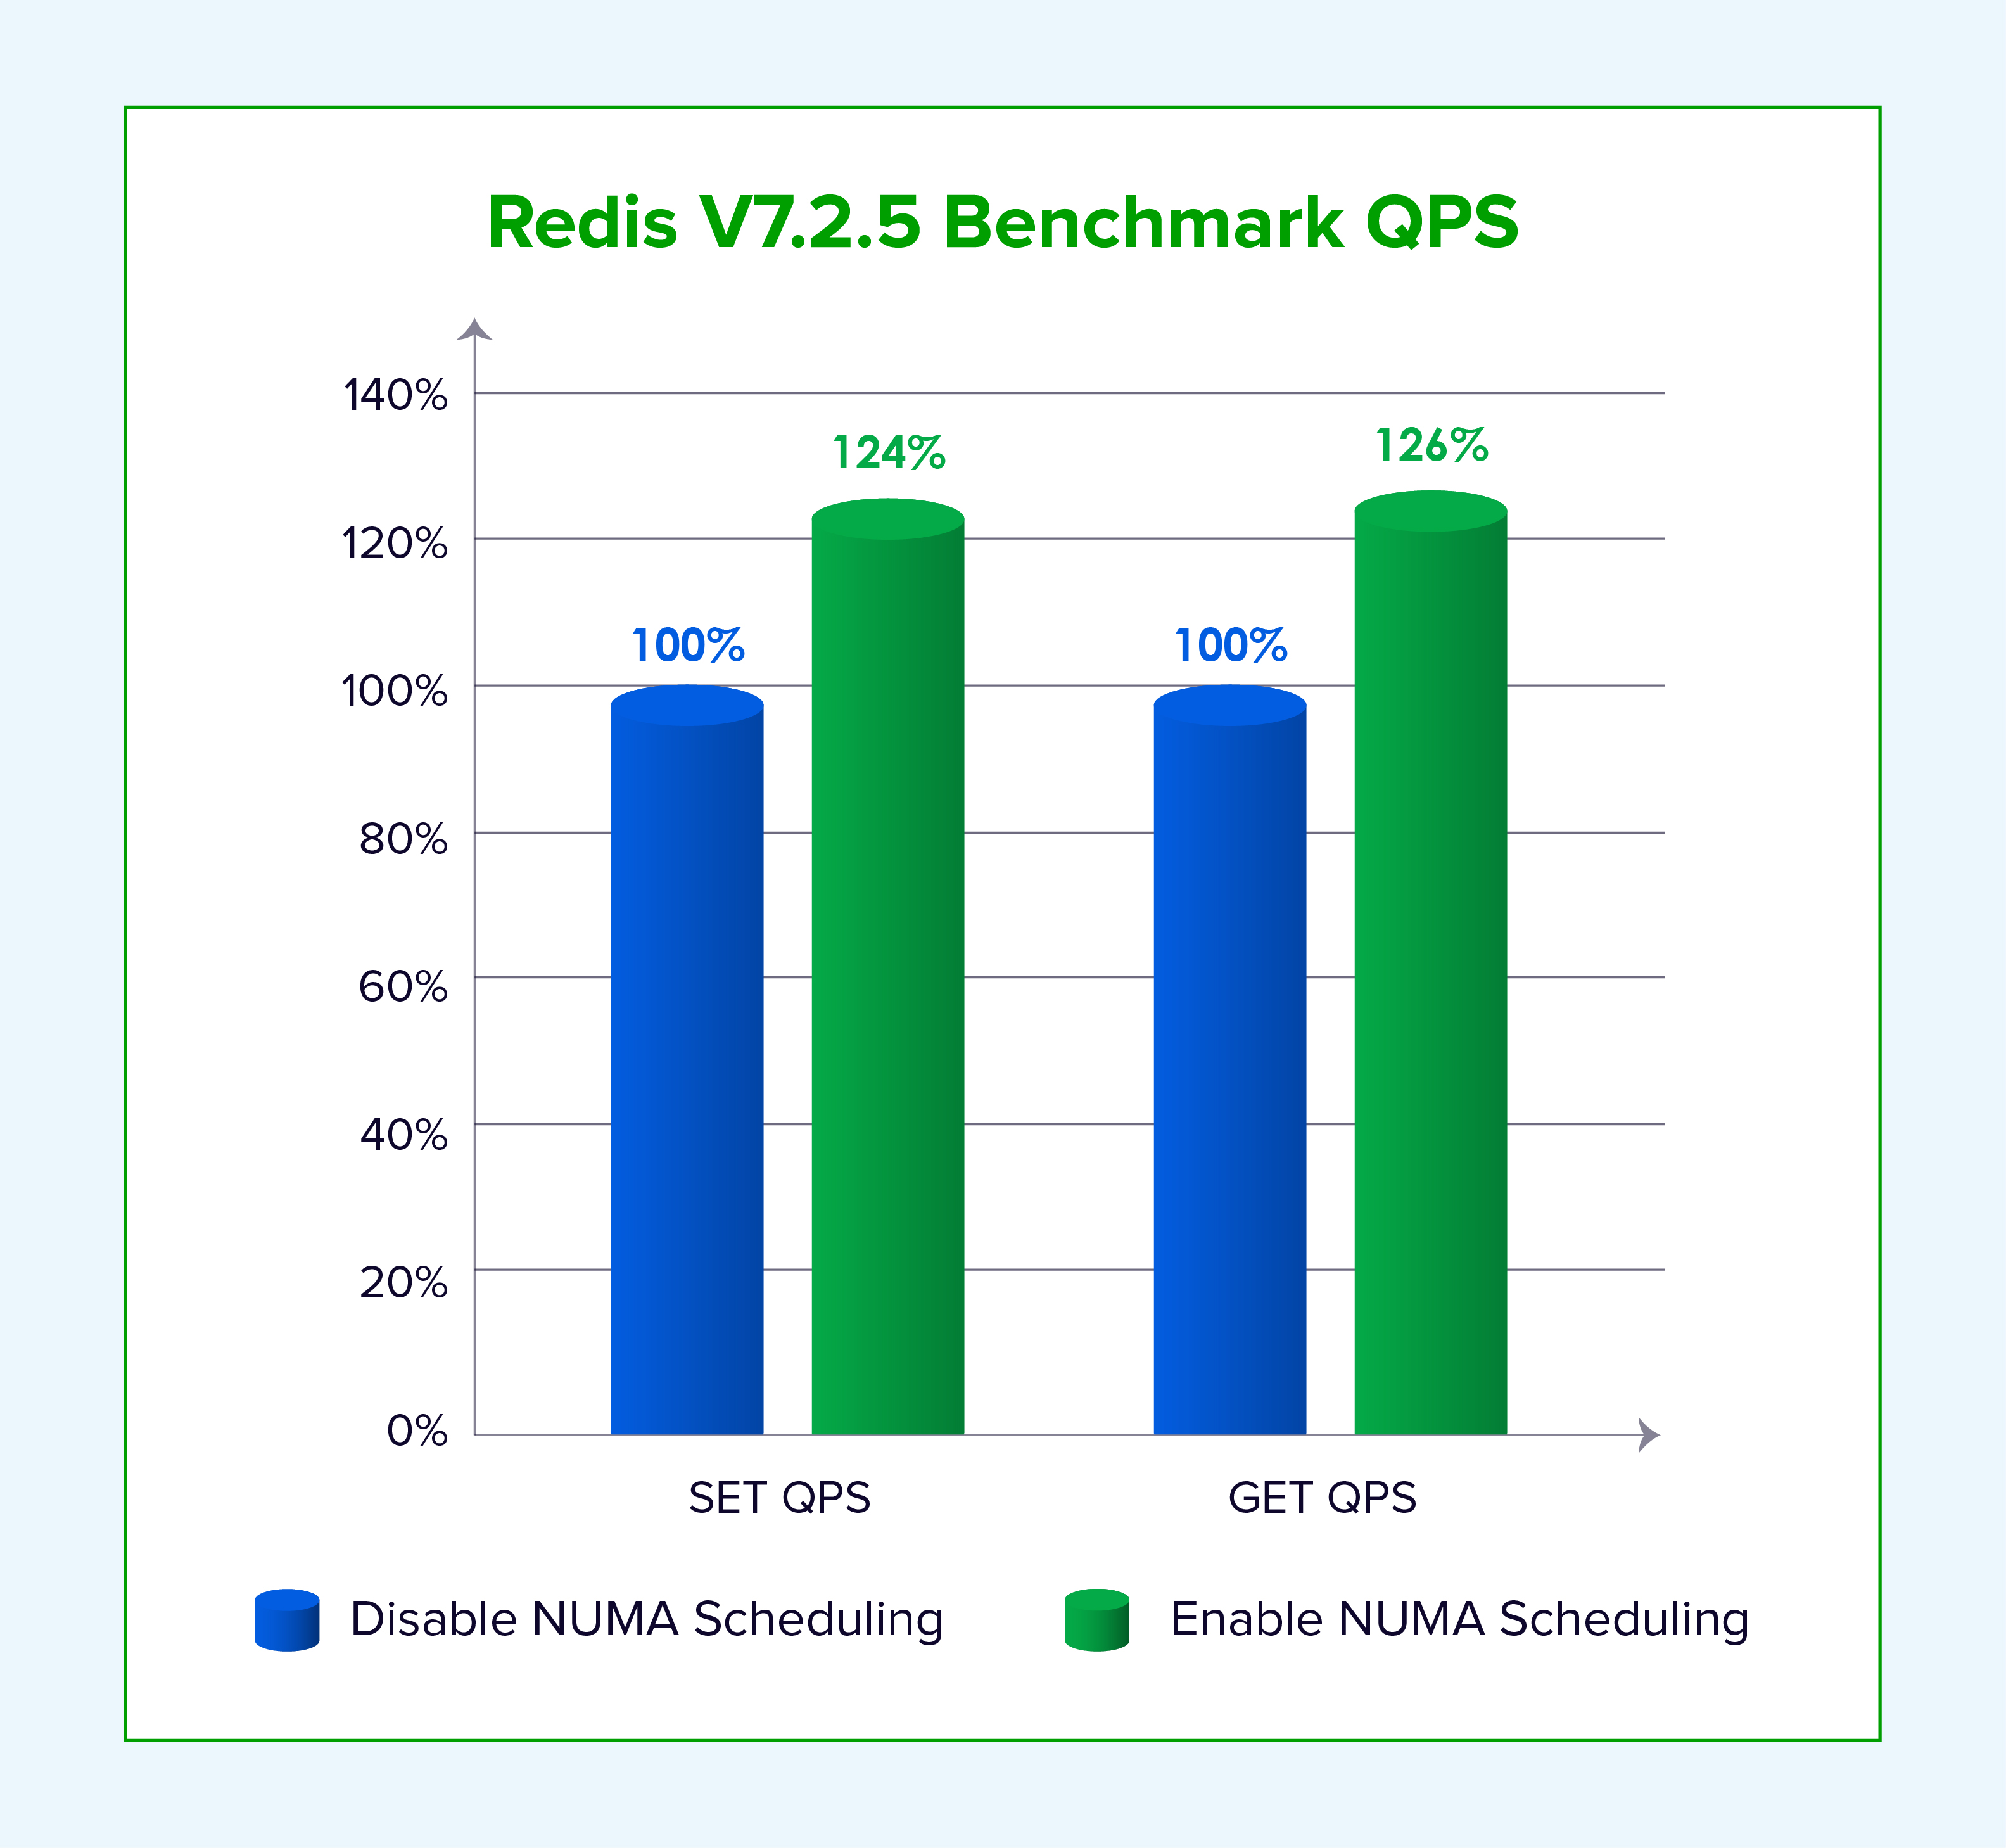
รูปที่ 5: ประสิทธิภาพการอ่าน/เขียนข้อมูล Redis ที่เพิ่มขึ้นเมื่อเปิดใช้งานการจัดตารางเวลาแบบ NUMA
การแคชแบบคีย์-ค่า: Memcached 6.27
memaslap เป็นเครื่องมือทดสอบประสิทธิภาพที่รวมอยู่ใน Memcached บริษัท Sangfor ใช้เครื่องมือนี้เพื่อทดสอบ TPS สำหรับค่า 1 KB โดยปิดและเปิดใช้งานการจัดตารางเวลา NUMA TPS ย่อมาจากจำนวนธุรกรรมต่อวินาที
memaslap -s 127.0.0.1:11211 -t 300s -T 8
แผนภูมิAต่อไปนี้แสดงประสิทธิภาพเชิงเปรียบเทียบ โดยผลลัพธ์ TPS ที่ปิดใช้งาน NUMA จะถูกปรับให้เป็น 100%
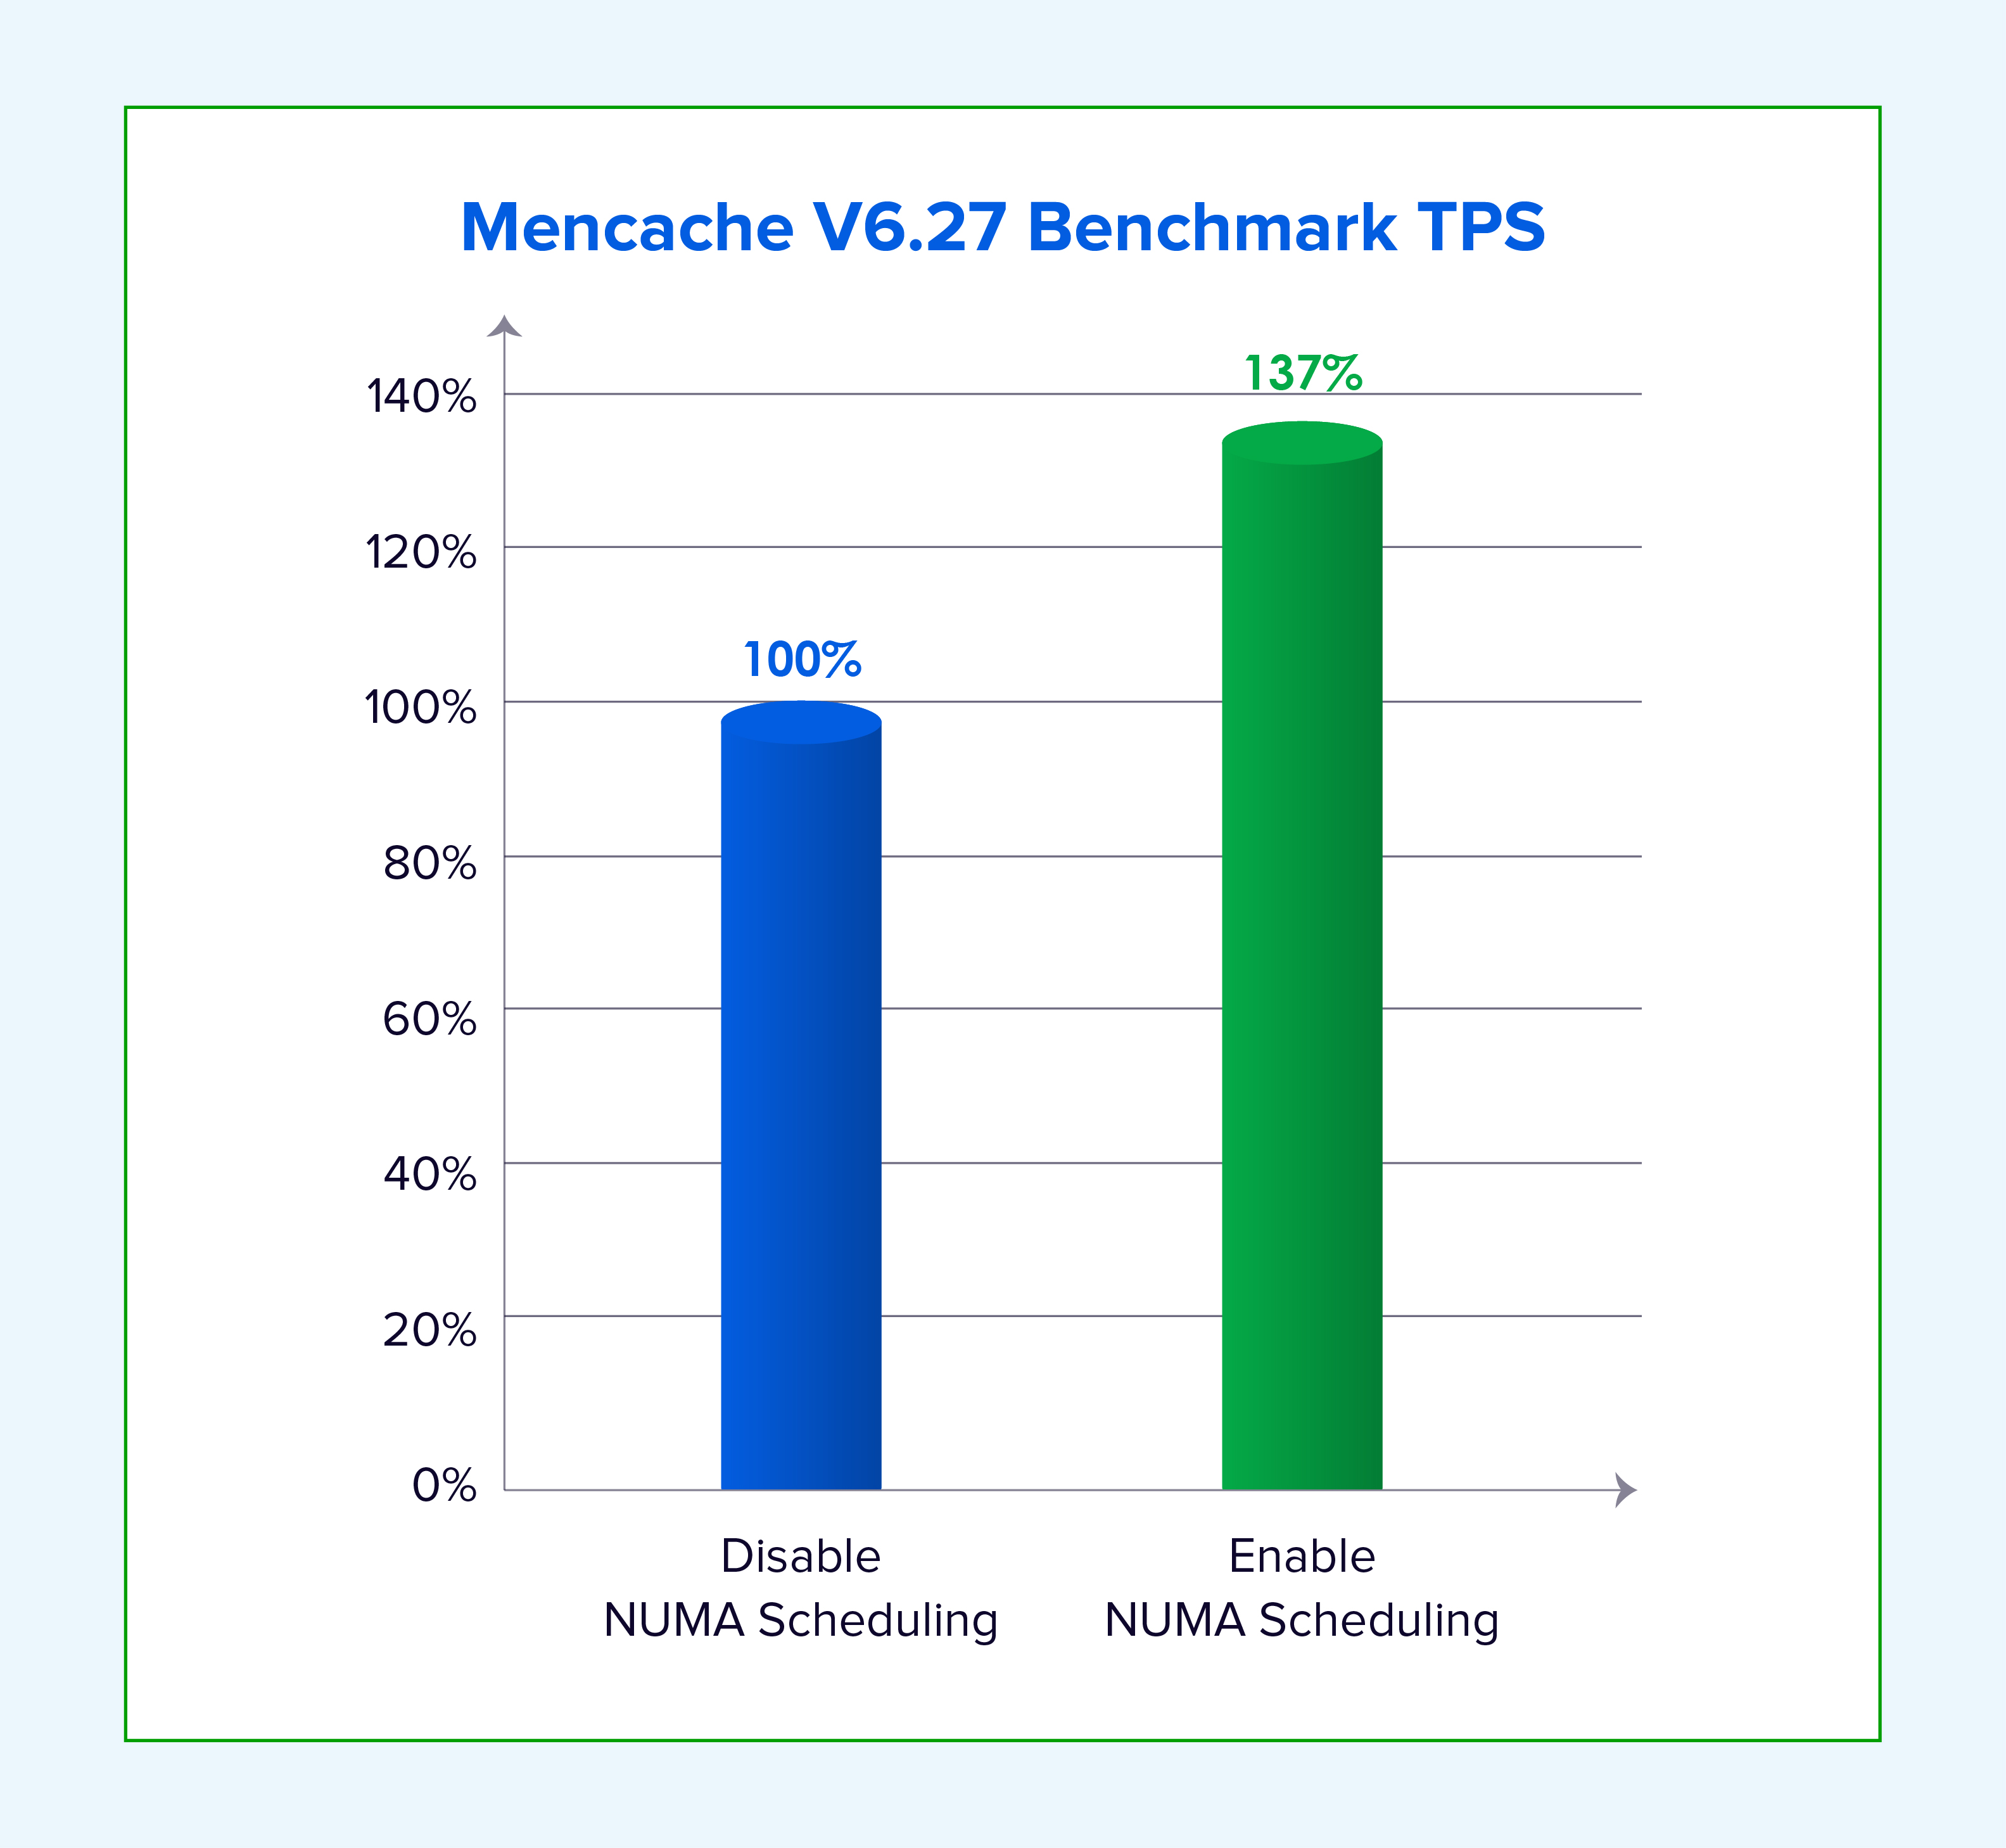
รูปที่ 6: ประสิทธิภาพการประมวลผลธุรกรรมของ Memcached ที่เพิ่มขึ้นเมื่อเปิดใช้งานการจัดตารางเวลา NUMA
ผลลัพธ์ข้างต้นแสดงให้เห็นถึงประโยชน์ที่ชัดเจนสำหรับแอปพลิเคชันที่ใช้หน่วยความจำมาก ส่วนต่อไปนี้จะอธิบายวิธีการทำงานของการเพิ่มประสิทธิภาพ
1. การจัดสรรโหนด NUMA แบบปรับเปลี่ยนได้
Sangfor จะแบ่งพาร์ติชัน vCPU ของ VM อย่างเหมาะสมและจัดสรรไปยังโหนด NUMA ที่เหมาะสมเพื่อลดการเข้าถึงหน่วยความจำระยะไกล หากจำนวน vCPU ของ VM น้อยกว่าจำนวนคอร์ของโหนด NUMA หนึ่งโหนด VM จะถูกจัดสรรไว้บนโหนดเดียว หาก VM ต้องการคอร์มากกว่าที่โหนดเดียวสามารถให้ได้ VM จะถูกกระจายไปยังหลายโหนด และโครงสร้าง vNUMA จะถูกเปิดเผยต่อระบบปฏิบัติการของเครื่องเสมือนเพื่อการตัดสินใจที่คำนึงถึงโครงสร้างนั้น
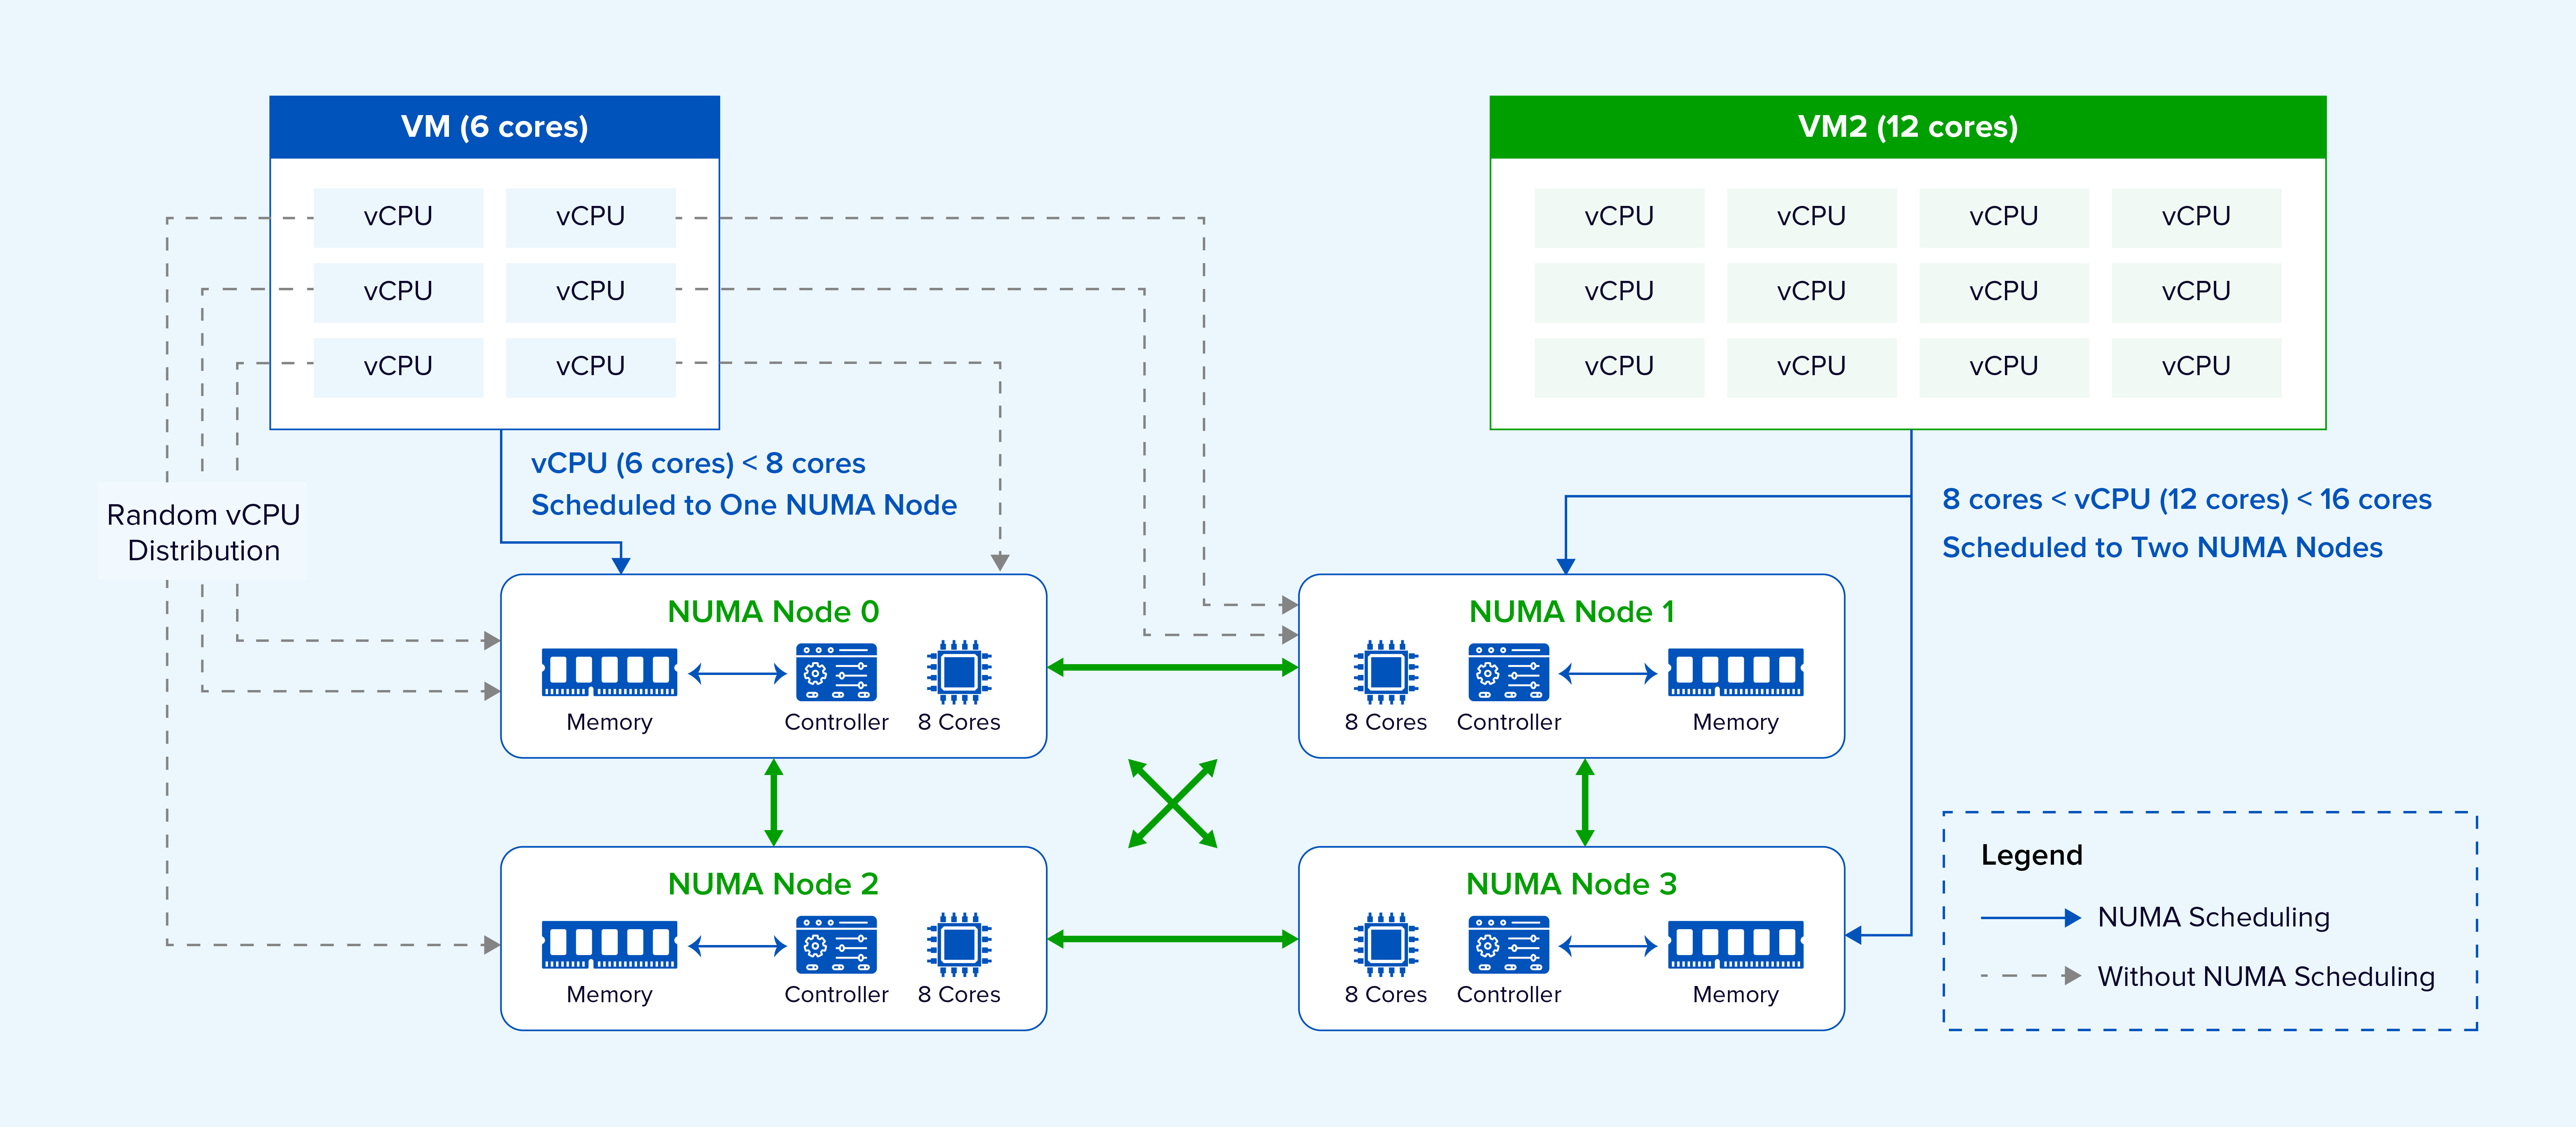
รูปที่ 7: การแบ่งพาร์ติชั่น vCPU อัจฉริยะของ Sangfor และการแมปโทโพโลยี vNUMA
เพื่อรักษาสมดุลการใช้งาน การจัดวาง VM จะพิจารณาภาระงานปัจจุบันในโหนด NUMA และเลือกโหนดที่มีการใช้งานน้อยกว่า ในระหว่างการทำงาน VM อาจถูกย้ายระหว่างโหนดตามการเปลี่ยนแปลงการใช้งาน VM ที่มีความสำคัญจะถูกจัดวางไว้ในโหนดที่มีการแข่งขันน้อยกว่าเพื่อลดการแข่งขันสำหรับทรัพยากร CPU แบนด์วิดท์หน่วยความจำ และแคช
2. การเพิ่มประสิทธิภาพสำหรับแพลตฟอร์มเซิร์ฟเวอร์ที่หลากหลาย
แพลตฟอร์มเซิร์ฟเวอร์บางแพลตฟอร์มมีโหนด NUMA จำนวนมาก ระยะห่างระหว่างโหนดแตกต่างกัน และมีจำนวนคอร์ต่อโหนดค่อนข้างน้อย
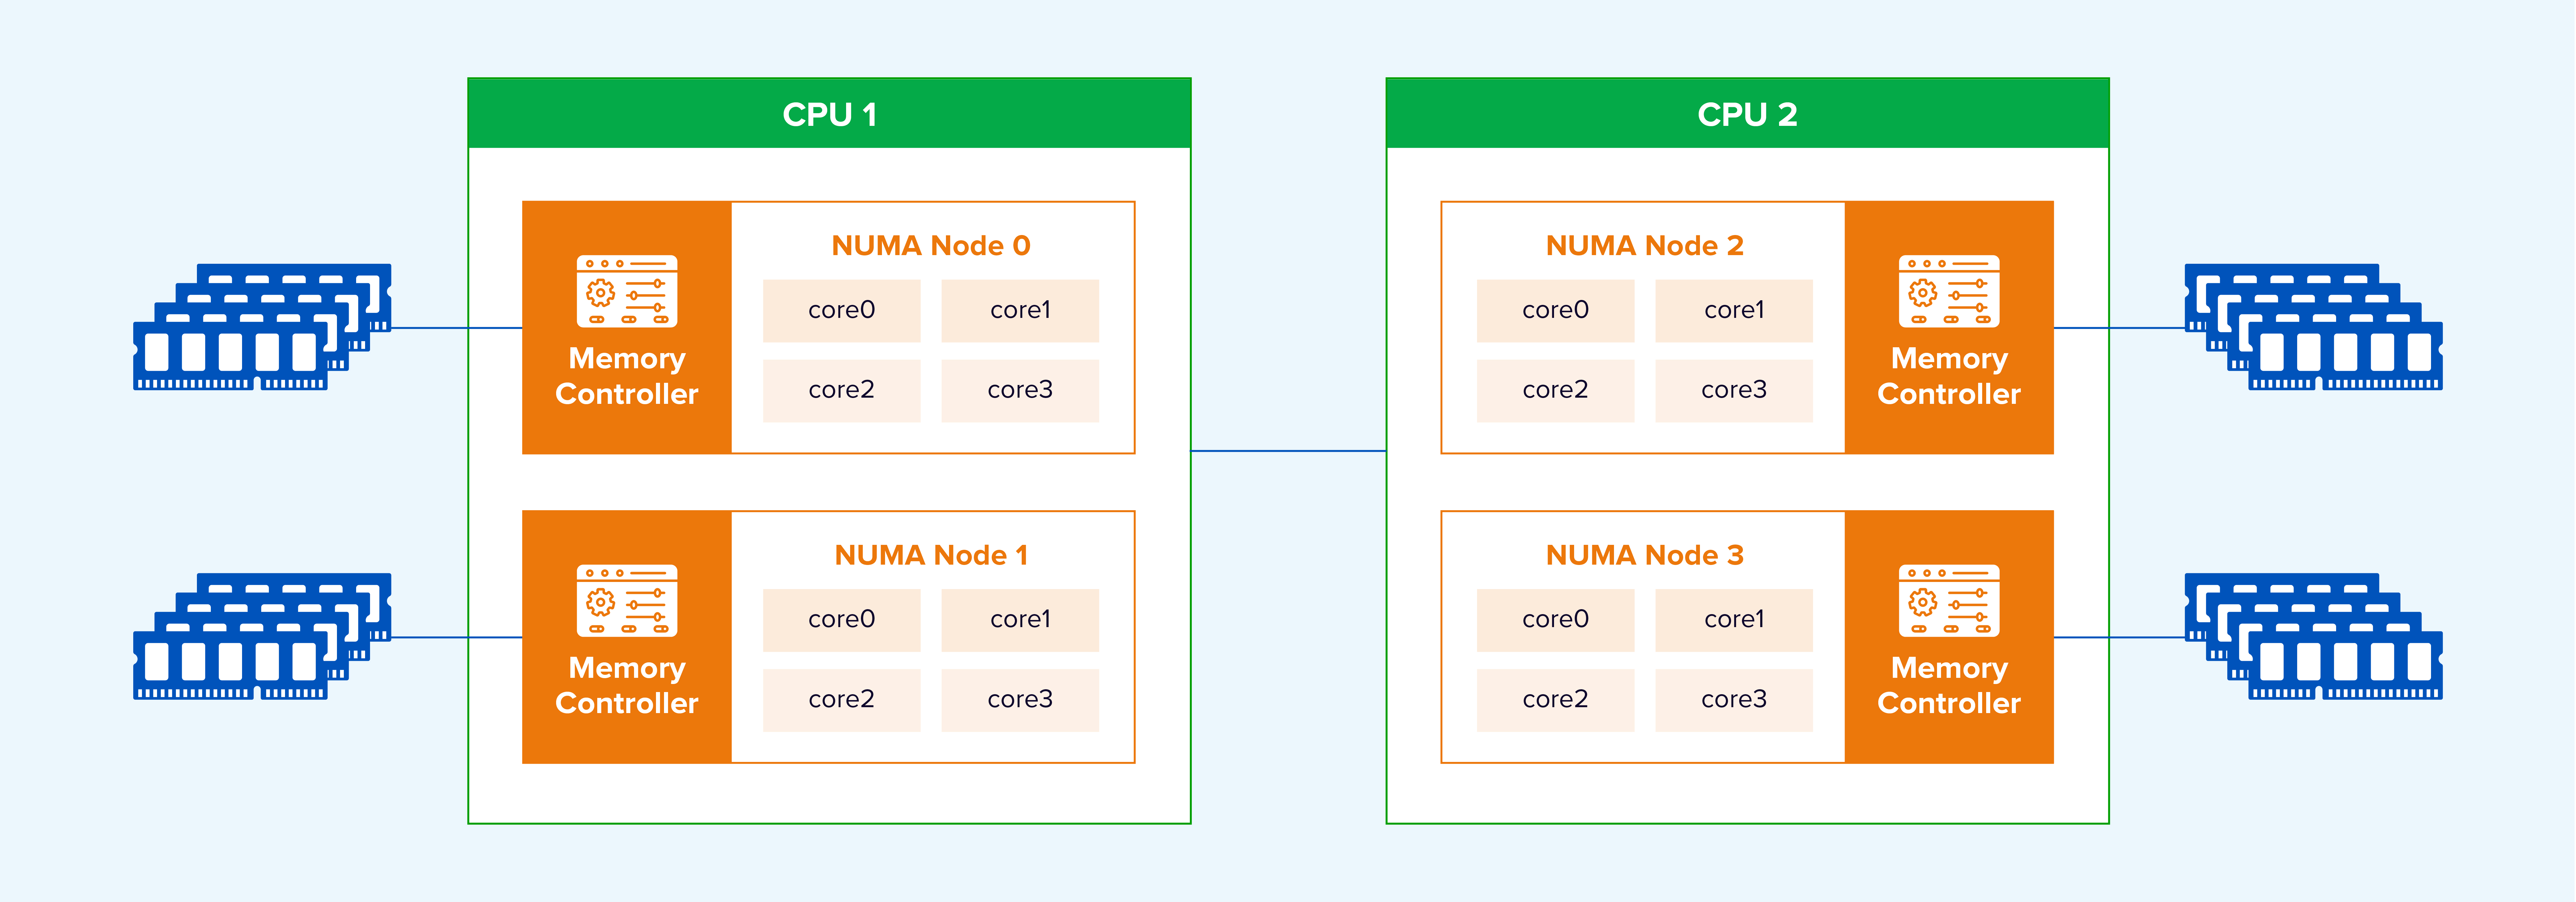
รูปที่ 8 การจัดวาง vNUMA ที่คำนึงถึงโทโพโลยีบนเซิร์ฟเวอร์แบบหลายโหนด
Sangfor จะระบุระยะห่างระหว่างโหนด NUMA และจัดวางโหนด vNUMA หลายโหนดจาก VM เดียวกันไว้บนโหนด NUMA ทางกายภาพที่อยู่ใกล้เคียงกันเป็นหลัก
เพื่อปรับปรุงประสิทธิภาพการส่งต่อข้อมูลให้ดียิ่งขึ้น Sangfor ได้พัฒนาความสัมพันธ์แบบ NUMA ระหว่าง VM และกระบวนการส่งข้อมูล โดย VM และกระบวนการส่งต่อข้อมูลจะถูกจัดสรรให้อยู่ในโหนด NUMA เดียวกัน ซึ่งจะเพิ่มการเข้าถึงหน่วยความจำภายใน ในรูปต่อไปนี้ DP หมายถึงกระบวนการส่งข้อมูล
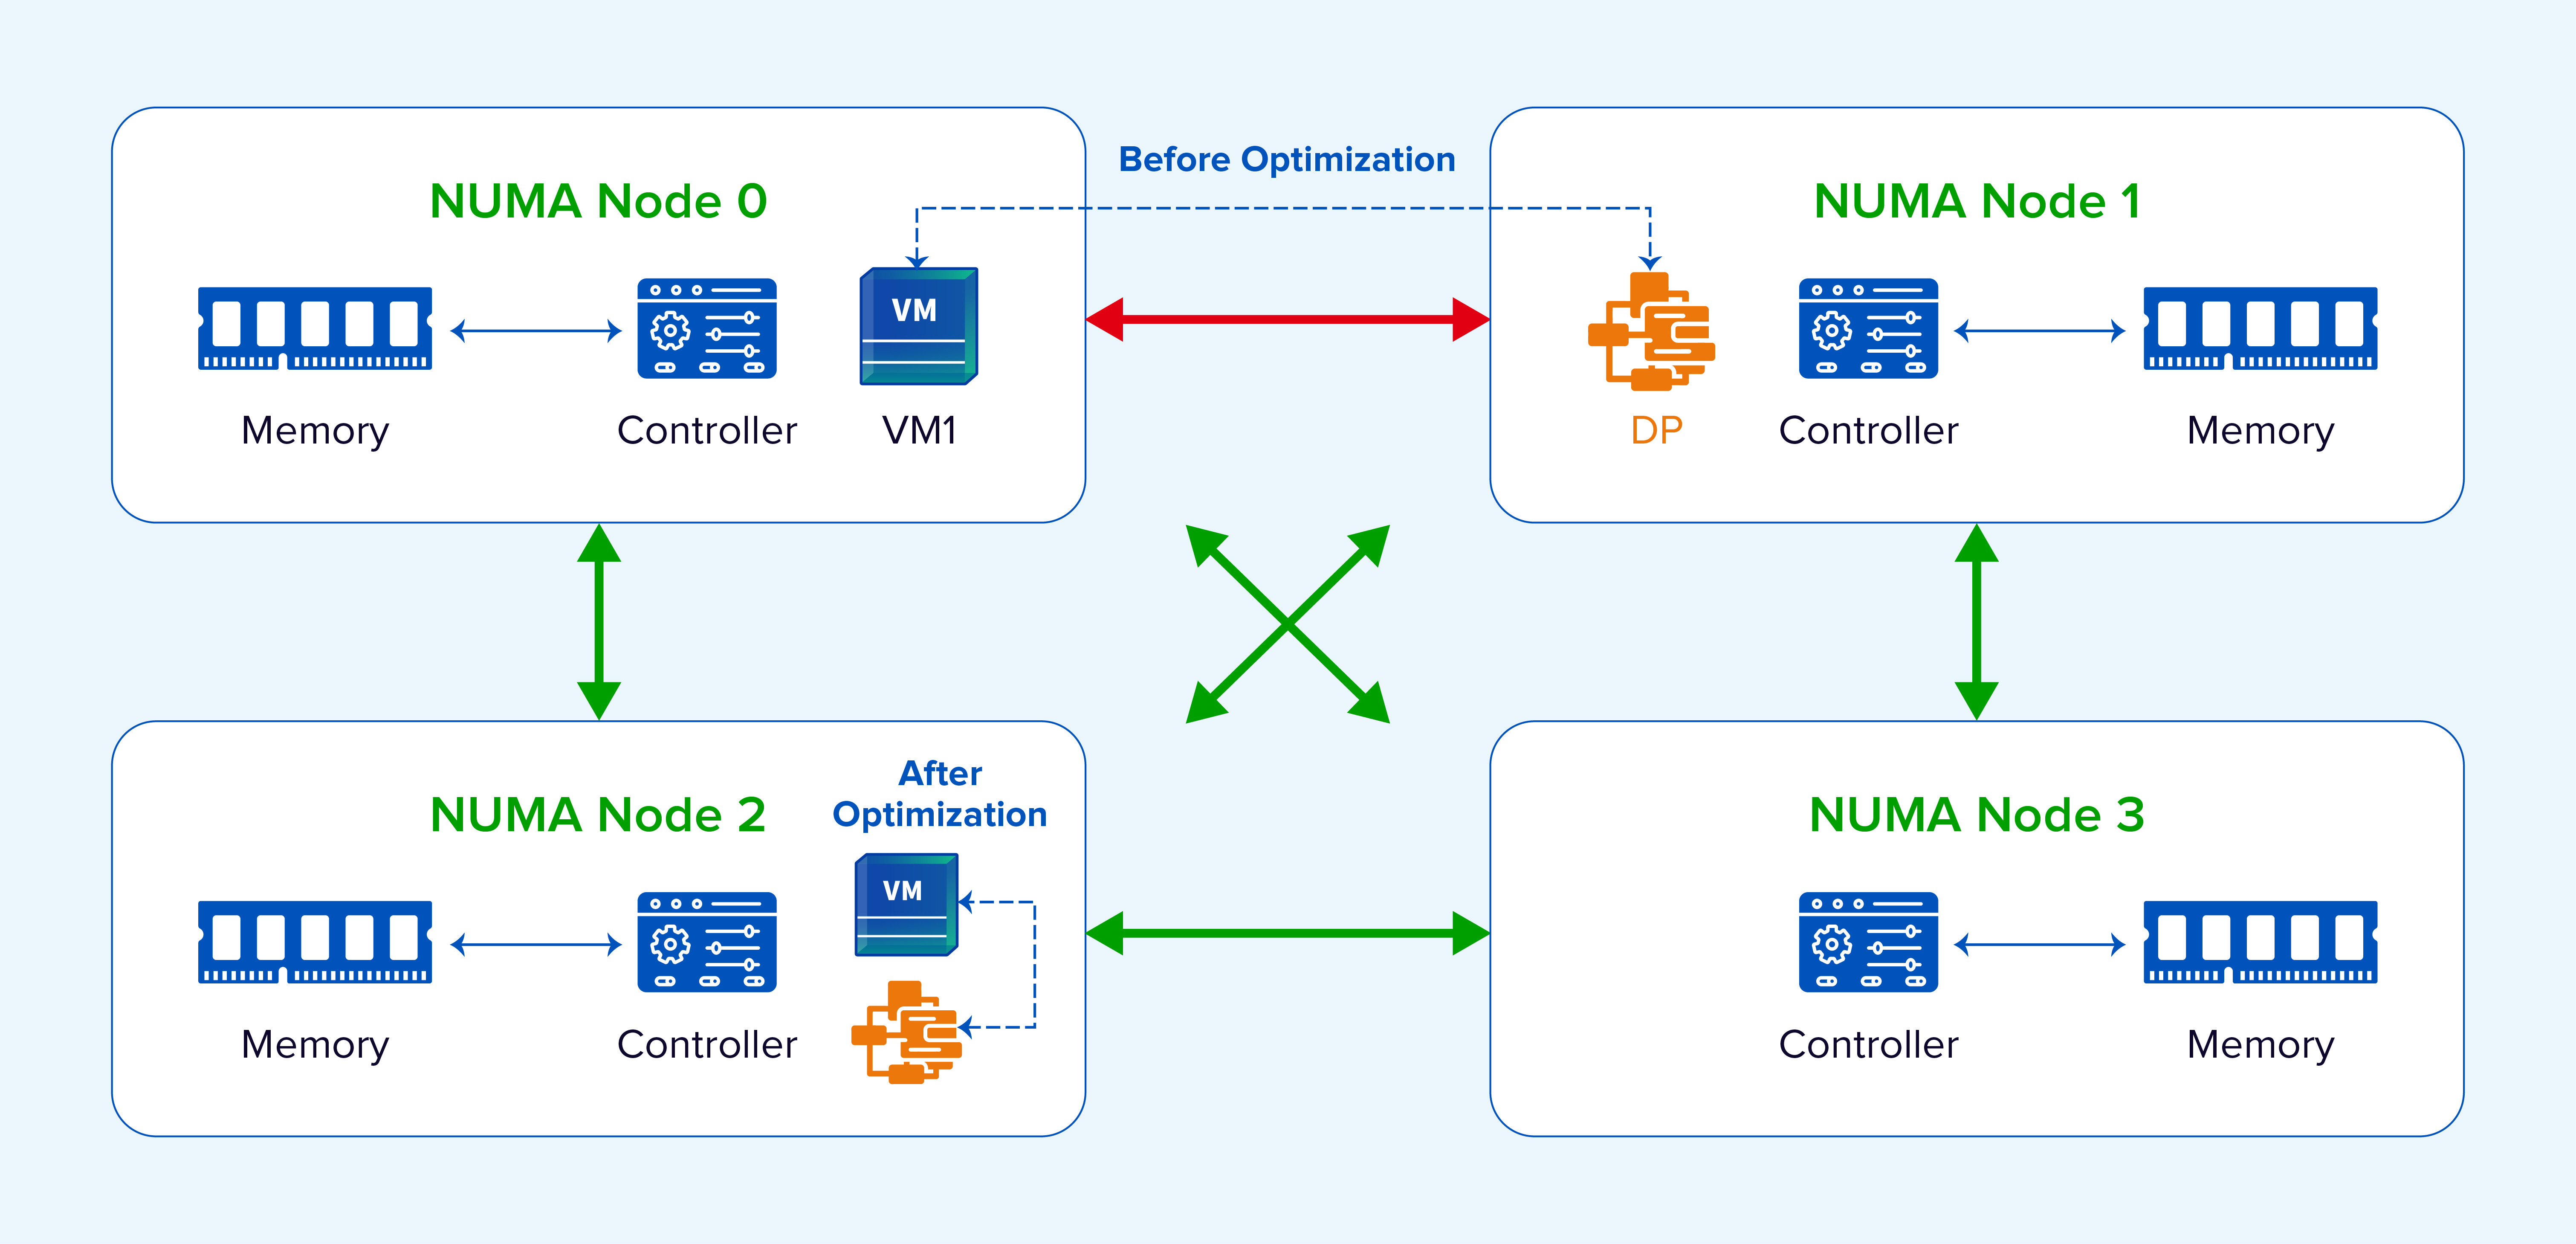
รูปที่ 9. ความสัมพันธ์ระหว่าง VM และระนาบข้อมูลช่วยให้การประมวลผลอยู่ใกล้กับหน่วยความจำภายในเครื่อง
เพื่อเพิ่มประโยชน์สูงสุดของ NUMA ในการจัดเก็บข้อมูล Sangfor จึงวาง vCPU, QEMU, libnfs, aSAN และกระบวนการอื่นๆ ที่เกี่ยวข้องในเส้นทาง I/O ที่สมบูรณ์ไว้บนโหนด NUMA เดียวกัน ซึ่งจะช่วยหลีกเลี่ยงการเข้าถึงหน่วยความจำระยะไกล นอกจากนี้ หน้าหน่วยความจำขนาดใหญ่ยังช่วยปรับปรุงประสิทธิภาพการเข้าถึงหน่วยความจำ ลดภาระการประมวลผล และเพิ่มประสิทธิภาพการไหลของ I/O อีกด้วย
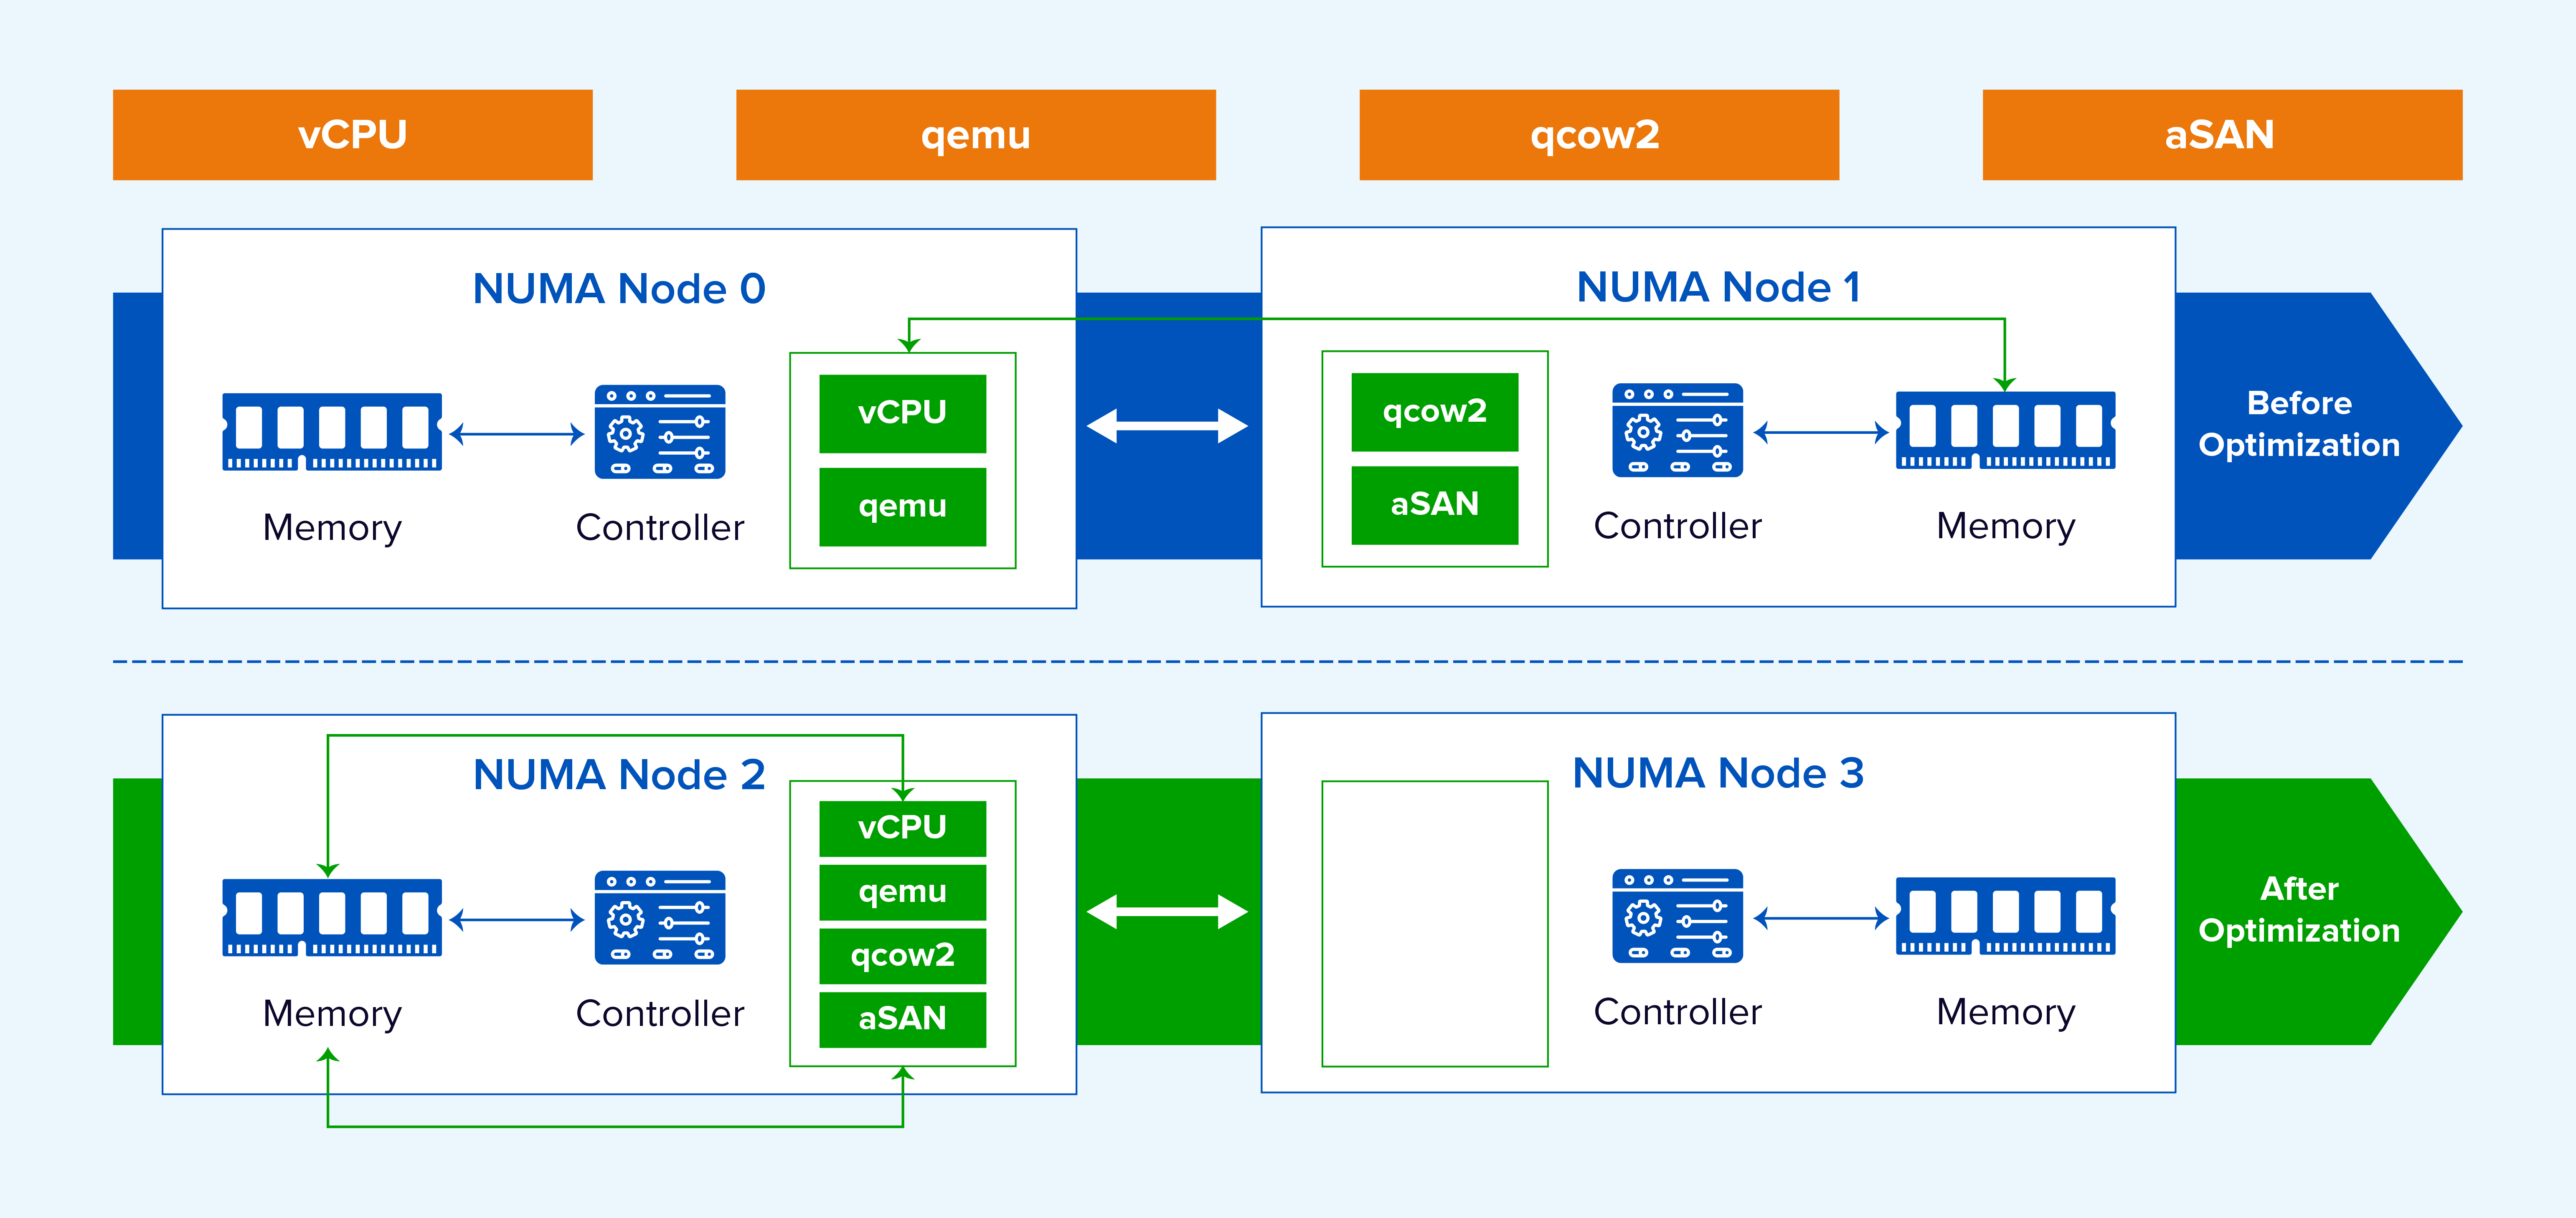
รูปที่ 10. การจัดวาง NUMA แบบประสานงานตลอดเส้นทาง I/O ของพื้นที่จัดเก็บข้อมูลเสมือน
การถ่ายโอนข้อมูลจากบัฟเฟอร์ของ NIC ไปยังพื้นที่จัดเก็บข้อมูลเสมือนจะต้องได้รับการประมวลผลโดยเธรดของ CPU เมื่อประสิทธิภาพของเครือข่ายเพิ่มขึ้น ประสิทธิภาพการคัดลอกบัฟเฟอร์แบบแกนเดียวอาจกลายเป็นคอขวด ในขณะที่การเข้าถึงข้าม NUMA จะลดประสิทธิภาพลงไปอีก Sangfor ช่วยให้แกน CPU หลายแกนสามารถประมวลผลทราฟฟิกของ NIC และใช้ความสัมพันธ์ของ NUMA ซึ่งจะช่วยขจัดคอขวดของแกนเดียว ลดความหน่วงในการถ่ายโอน และปรับปรุงการทำงานพร้อมกัน จากการทดสอบภายใน ประสิทธิภาพการเขียนข้อมูลขนาดใหญ่และจำนวนคิวสูงไปยัง VM ดีขึ้นกว่า 20%
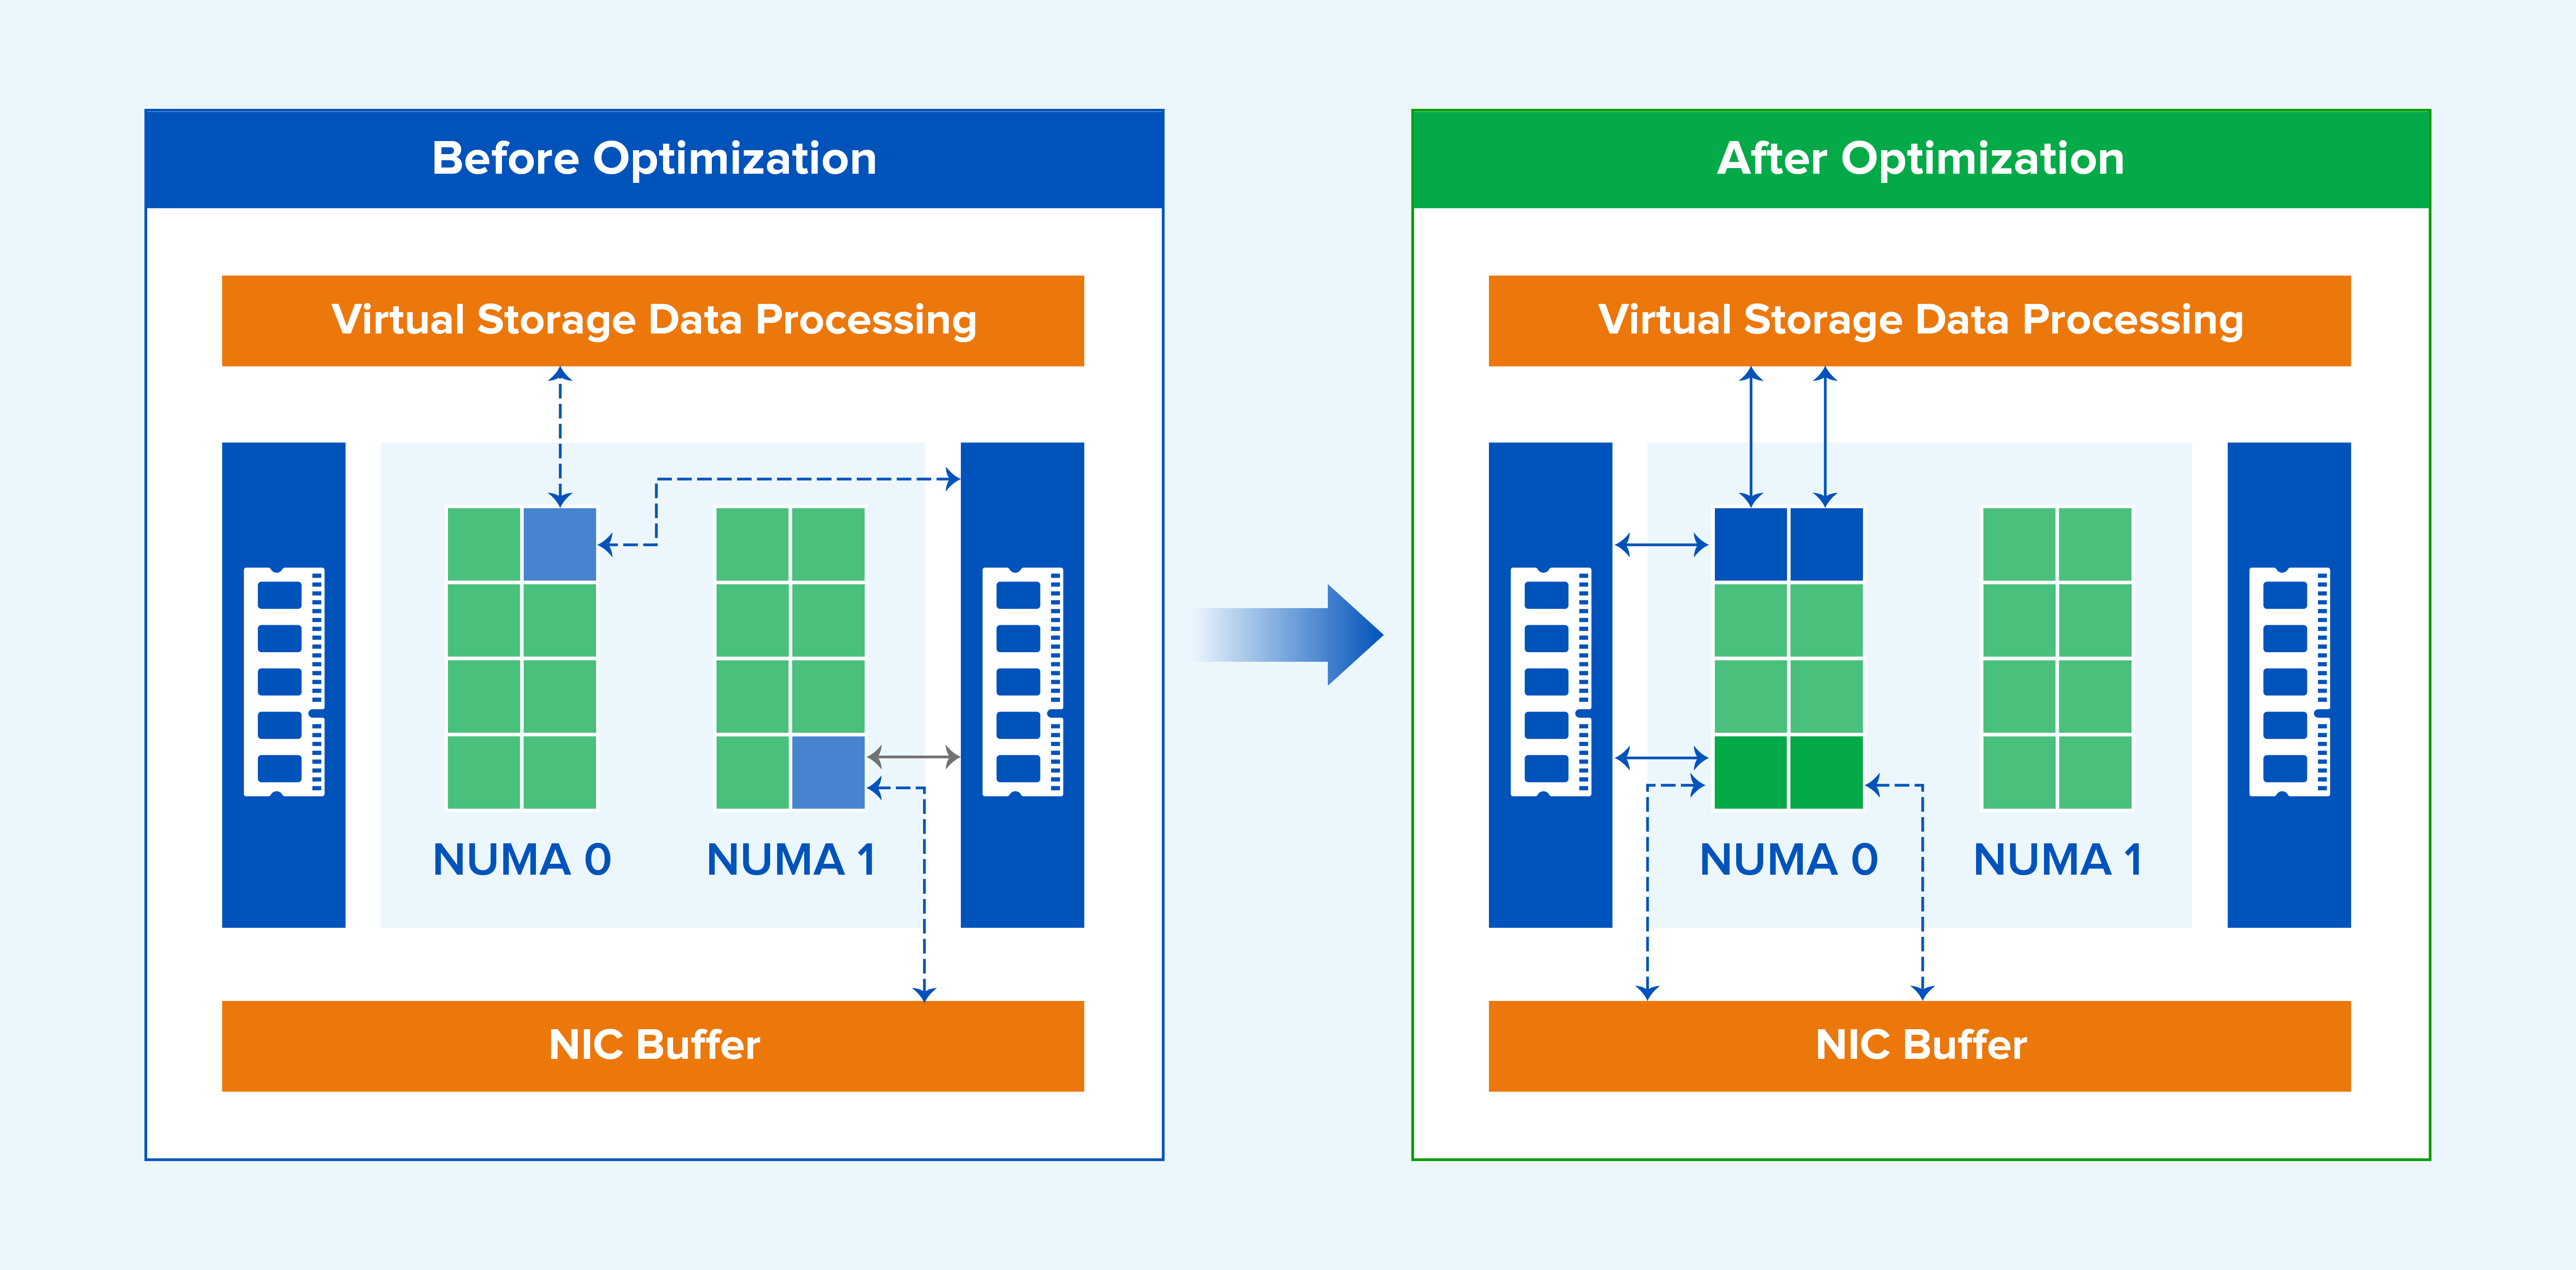
รูปที่ 11 การประมวลผลแบบมัลติคอร์และ NUMA-affine ระหว่างบัฟเฟอร์ NIC และหน่วยเก็บข้อมูลเสมือน
3. การเปรียบเทียบกับแนวทางปฏิบัติอื่นๆ ในอุตสาหกรรม
การสนับสนุนจากผู้ผลิตในอุตสาหกรรมมีความแตกต่างกันไป ผู้จำหน่ายรายหนึ่งอนุญาตให้ผู้ดูแลระบบกำหนดค่าโหนด NUMA ที่แต่ละ vCPU ของ VM ทำงาน ในขณะที่ผู้จำหน่ายรายอื่นไม่รองรับความสามารถนี้ และ VMware รองรับการจัดตารางเวลา NUMA แบบปรับเปลี่ยนได้
Sangfor จะแบ่งพาร์ติชันและจัดวาง vCPU ของ VM บนโหนด NUMA โดยอัตโนมัติเพื่อลดการเข้าถึงหน่วยความจำระยะไกล เมื่อเปรียบเทียบกับการกำหนดค่าตำแหน่งของ vCPU แต่ละตัวด้วยตนเอง การจัดตารางเวลา NUMA แบบปรับได้ของ Sangfor จะทำการแบ่งพาร์ติชันและจัดวาง vCPU โดยอัตโนมัติ ปรับสมดุลการใช้งานระหว่างโหนด และปรับปรุงประสิทธิภาพโดยรวม
เมื่อเปรียบเทียบกับการใช้งาน NUMA แบบปรับตัวพื้นฐาน Sangfor ได้ขยายการเพิ่มประสิทธิภาพไปสู่การจัดตารางเวลาบริการจัดเก็บข้อมูล การรับรู้ลำดับความสำคัญของ VM แพลตฟอร์มเซิร์ฟเวอร์ที่หลากหลาย และความสัมพันธ์ของเครือข่าย VM การปรับปรุงเหล่านี้สะท้อนให้เห็นถึงการทำงานร่วมกันทางวิศวกรรมระหว่างทีมวิจัยและทีมผลิตภัณฑ์คลาวด์ของ Sangfor และได้รับการออกแบบโดยคำนึงถึงพฤติกรรมของแพลตฟอร์มและบริการในความเป็นจริง
ส่วนที่ 5. บทสรุป
ระบบการจัดตารางเวลา NUMA แบบปรับได้ของ Sangfor ได้รับการปรับให้เหมาะสมสำหรับสถานการณ์โครงสร้างพื้นฐานหลายรูปแบบ เพื่อปรับปรุงประสิทธิภาพการเข้าถึงหน่วยความจำของแอปพลิเคชัน:
- แบ่งพาร์ติชันและจัดวาง vCPU ของ VM บนโหนด NUMA อย่างเหมาะสม เพื่อลดการเข้าถึงหน่วยความจำระยะไกล
- ย้ายเครื่องเสมือน (VM) ระหว่างโหนด NUMA เพื่อรักษาสมดุลการใช้งาน
- ระบุ VM ที่มีความสำคัญและจัดเก็บไว้ในโหนดที่มีการใช้งานน้อยกว่า เพื่อลดการแข่งขันด้าน CPU, แบนด์วิดท์หน่วยความจำ และแคช
- สำหรับเซิร์ฟเวอร์ที่มีโหนด NUMA จำนวนมากและระยะห่างระหว่างโหนดแตกต่างกัน ให้ระบุระยะทางโทโพโลยีและวางทรัพยากร vNUMA ที่เกี่ยวข้องไว้บนโหนด NUMA ทางกายภาพที่อยู่ใกล้เคียงเป็นลำดับแรก
- จัดเตรียมตัวเลือกการจัดวางเครือข่าย VM ไว้ในโหนด NUMA เดียวกันกับระนาบข้อมูลเครือข่าย เพื่อปรับปรุงประสิทธิภาพการส่งต่อข้อมูล
- นำการจัดตารางเวลาที่รองรับ NUMA มาใช้ไม่เพียงแต่กับ VM เท่านั้น แต่ยังรวมถึงบริการจัดเก็บข้อมูลด้วย
ตัวอย่างการทดสอบ UnixBench
UnixBench เป็นโปรแกรมทดสอบประสิทธิภาพที่ใช้กันอย่างแพร่หลายสำหรับระบบปฏิบัติการที่คล้าย Unix รวมถึง UNIX, BSD และ Linux โดยจะวัดประสิทธิภาพของระบบในหลายด้าน เช่น ประสิทธิภาพของ CPU, ระบบไฟล์, หน่วยความจำ และกระบวนการทำงาน
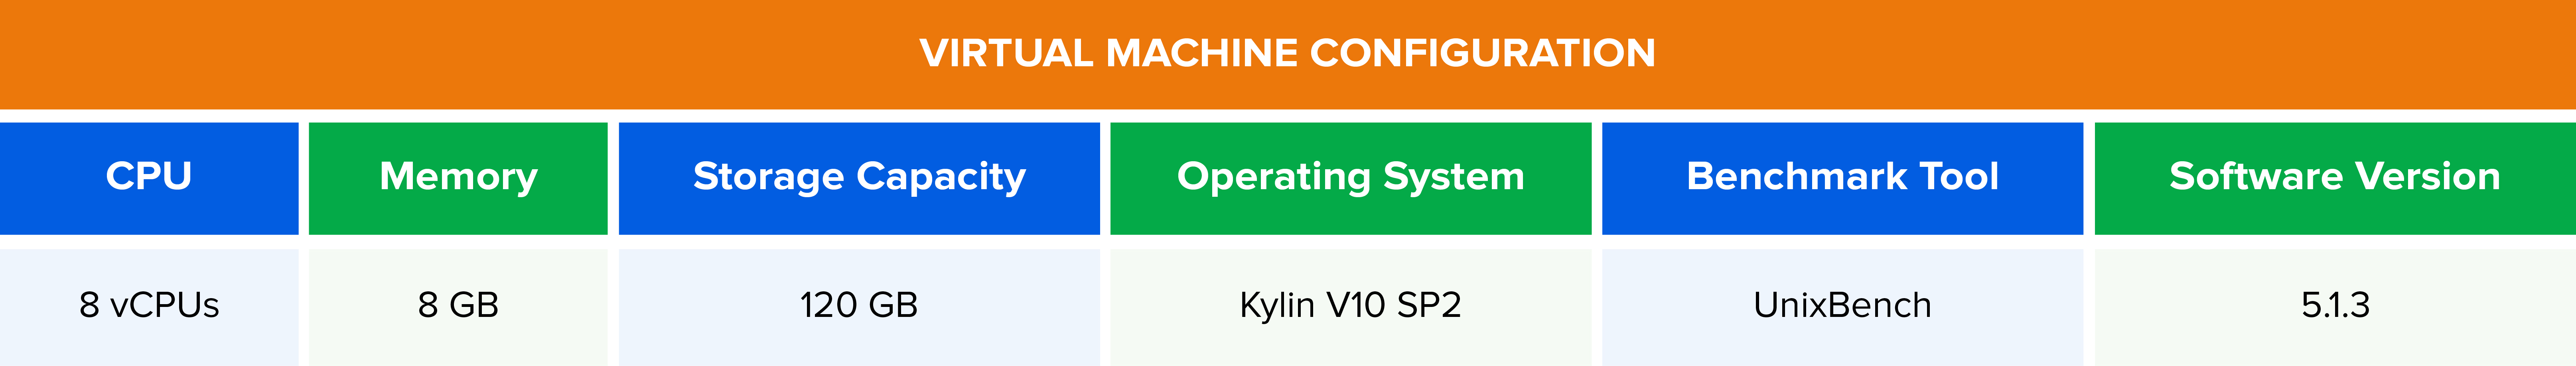
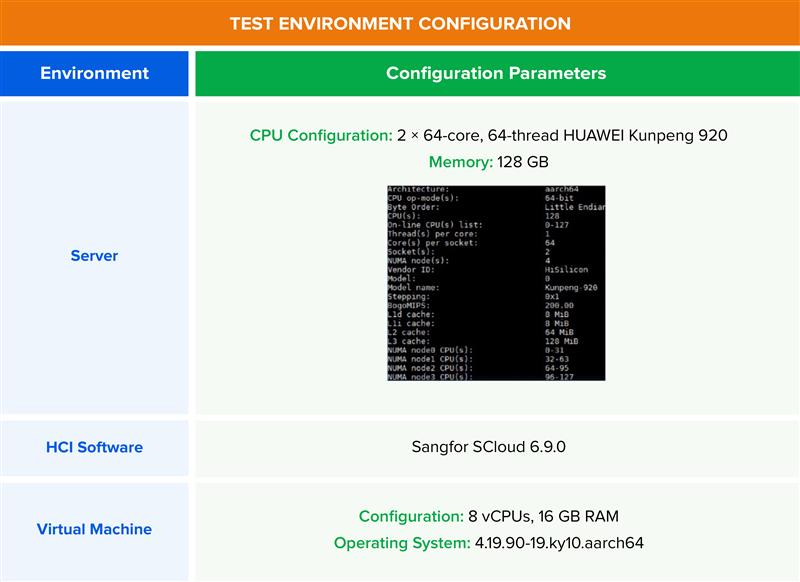
รูปที่ 12 การกำหนดค่าเครื่องเสมือนสำหรับการทดสอบ UnixBench
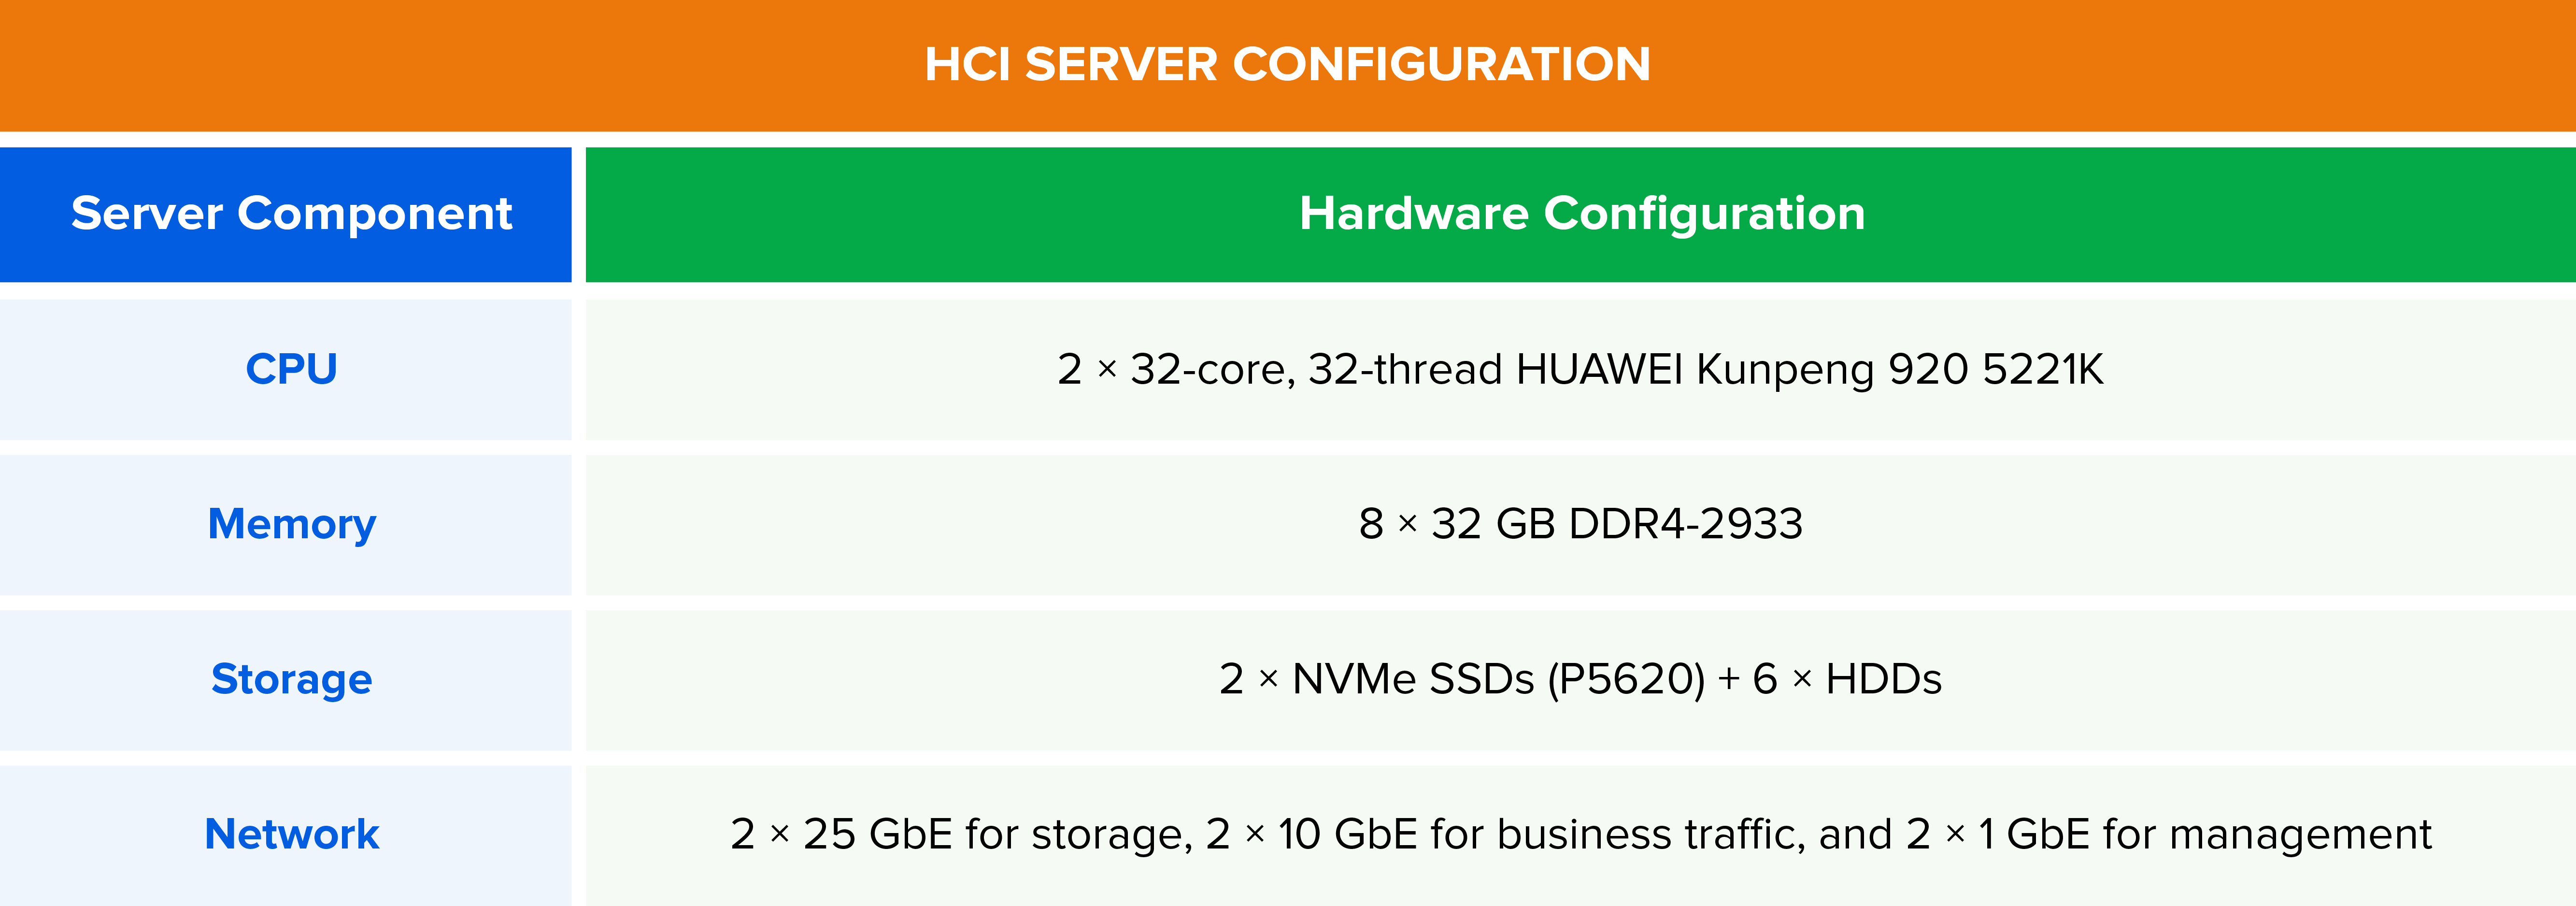
รูปที่ 13 การกำหนดค่าฮาร์ดแวร์เซิร์ฟเวอร์ HCI สำหรับการทดสอบ UnixBench
ผลการทดสอบ: ใน Sangfor HCI 6.9.0 เมื่อเปิดใช้งาน NUMA คะแนนรวมของ UnixBench สำหรับ VM 6 เครื่องที่ทำงานพร้อมกันบนโฮสต์เดียวกันนั้นสูงกว่าแพลตฟอร์มเปรียบเทียบแบบไม่ระบุตัวตนถึง 20.2% สำหรับ VM 8 เครื่องที่ทำงานพร้อมกัน คะแนนรวมสูงกว่าถึง 34.17%
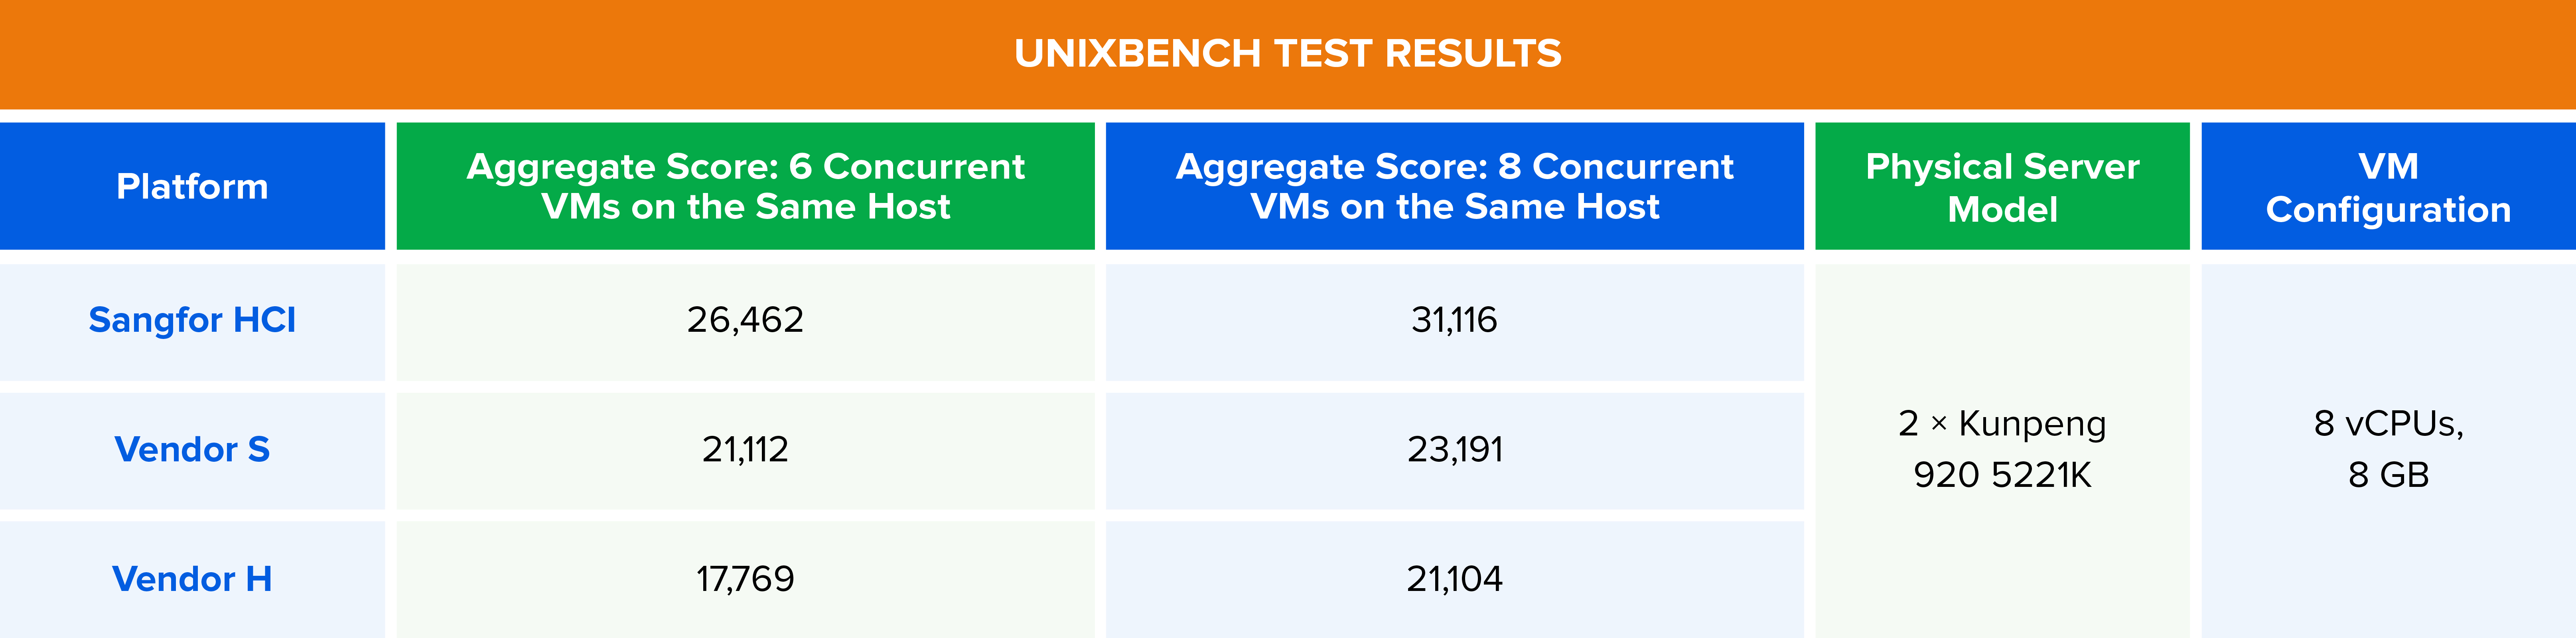
รูปที่ 14 ผลการเปรียบเทียบประสิทธิภาพของ UnixBench ภายใต้ภาระงานของเครื่องเสมือนพร้อมกัน
ผลการทดสอบเปรียบเทียบในบทความนี้สะท้อนถึงสภาพแวดล้อมการทดสอบภายในของ Sangfor โดยเฉพาะ และจัดทำขึ้นเพื่อเป็นตัวอย่างทางเทคนิคเท่านั้น ผลลัพธ์ที่แท้จริงจะแตกต่างกันไปตามฮาร์ดแวร์ เวอร์ชันซอฟต์แวร์ การกำหนดค่า และปริมาณงาน ลูกค้าควรตรวจสอบความถูกต้องของแอปพลิเคชันที่เป็นตัวแทนเทียบกับวัตถุประสงค์ระดับบริการของตนเอง

