
より多くの組織が、ビジネスに不可欠なワークロードを仮想化、ハイパーコンバージド、クラウドインフラストラクチャに移行するにつれて、高同時実行環境下でのパフォーマンスが最優先事項となっています。VMware の代替プラットフォームを検討するチームにとって、問題は単に別のプラットフォームが同様の機能を提供できるかどうかではなく、基幹業務システムに必要なレイテンシ、スループット、安定性を維持できるかどうかです。
この課題は、金融サービスにおける高頻度取引やリスク管理、医療における電子カルテシステム、物流における倉庫管理システムなど、メモリを大量に消費するアプリケーションで特に顕著です。これらのアプリケーションにおけるメモリアクセス要件の増大は、Redis、Apache Spark、SAP HANA、AIエンジンやモデルといったバックエンドコンポーネントと密接に関連しています。例えば、Redisはインメモリデータベースであり、そのパフォーマンスはメモリアクセス速度に直接影響されます。
NUMAは現在、主流のサーバーCPUアーキテクチャとなっています。そのため、NUMA環境におけるメモリアクセス効率の向上は、仮想化パフォーマンス最適化において重要な要素です。本稿では、SangforのNUMA最適化技術と、 VMwareからの移行時に仮想化プラットフォームが高度な同時実行性とビジネス上重要なワークロードをサポートする上で、これらの技術がどのように役立つかを解説します。
パート1. NUMAアーキテクチャの背景
初期のコンピュータシステムでは、通常、すべての計算タスクに単一のプロセッサが使用されていました。しかし、アプリケーションがより複雑化し、要求される性能が高まるにつれて、単一のプロセッサでは高性能な計算要件を満たせなくなり、システムは徐々にマルチコアアーキテクチャへと進化していきました。
従来のマルチコアシステムでは、対称型マルチプロセッシング(SMP)が一般的に使用されていました。SMPでは、すべてのプロセッサが同等の地位を持ち、メモリへのアクセス権も同じです。どのスレッドもどのプロセッサでも実行できるため、効果的な負荷分散が可能になり、全体的なパフォーマンスとスループットが向上します。しかし、複数のコアが同じバスを共有してメモリにアクセスするため、コア数が増えるにつれてバスがボトルネックとなり、拡張性とパフォーマンスが制限される可能性があります。
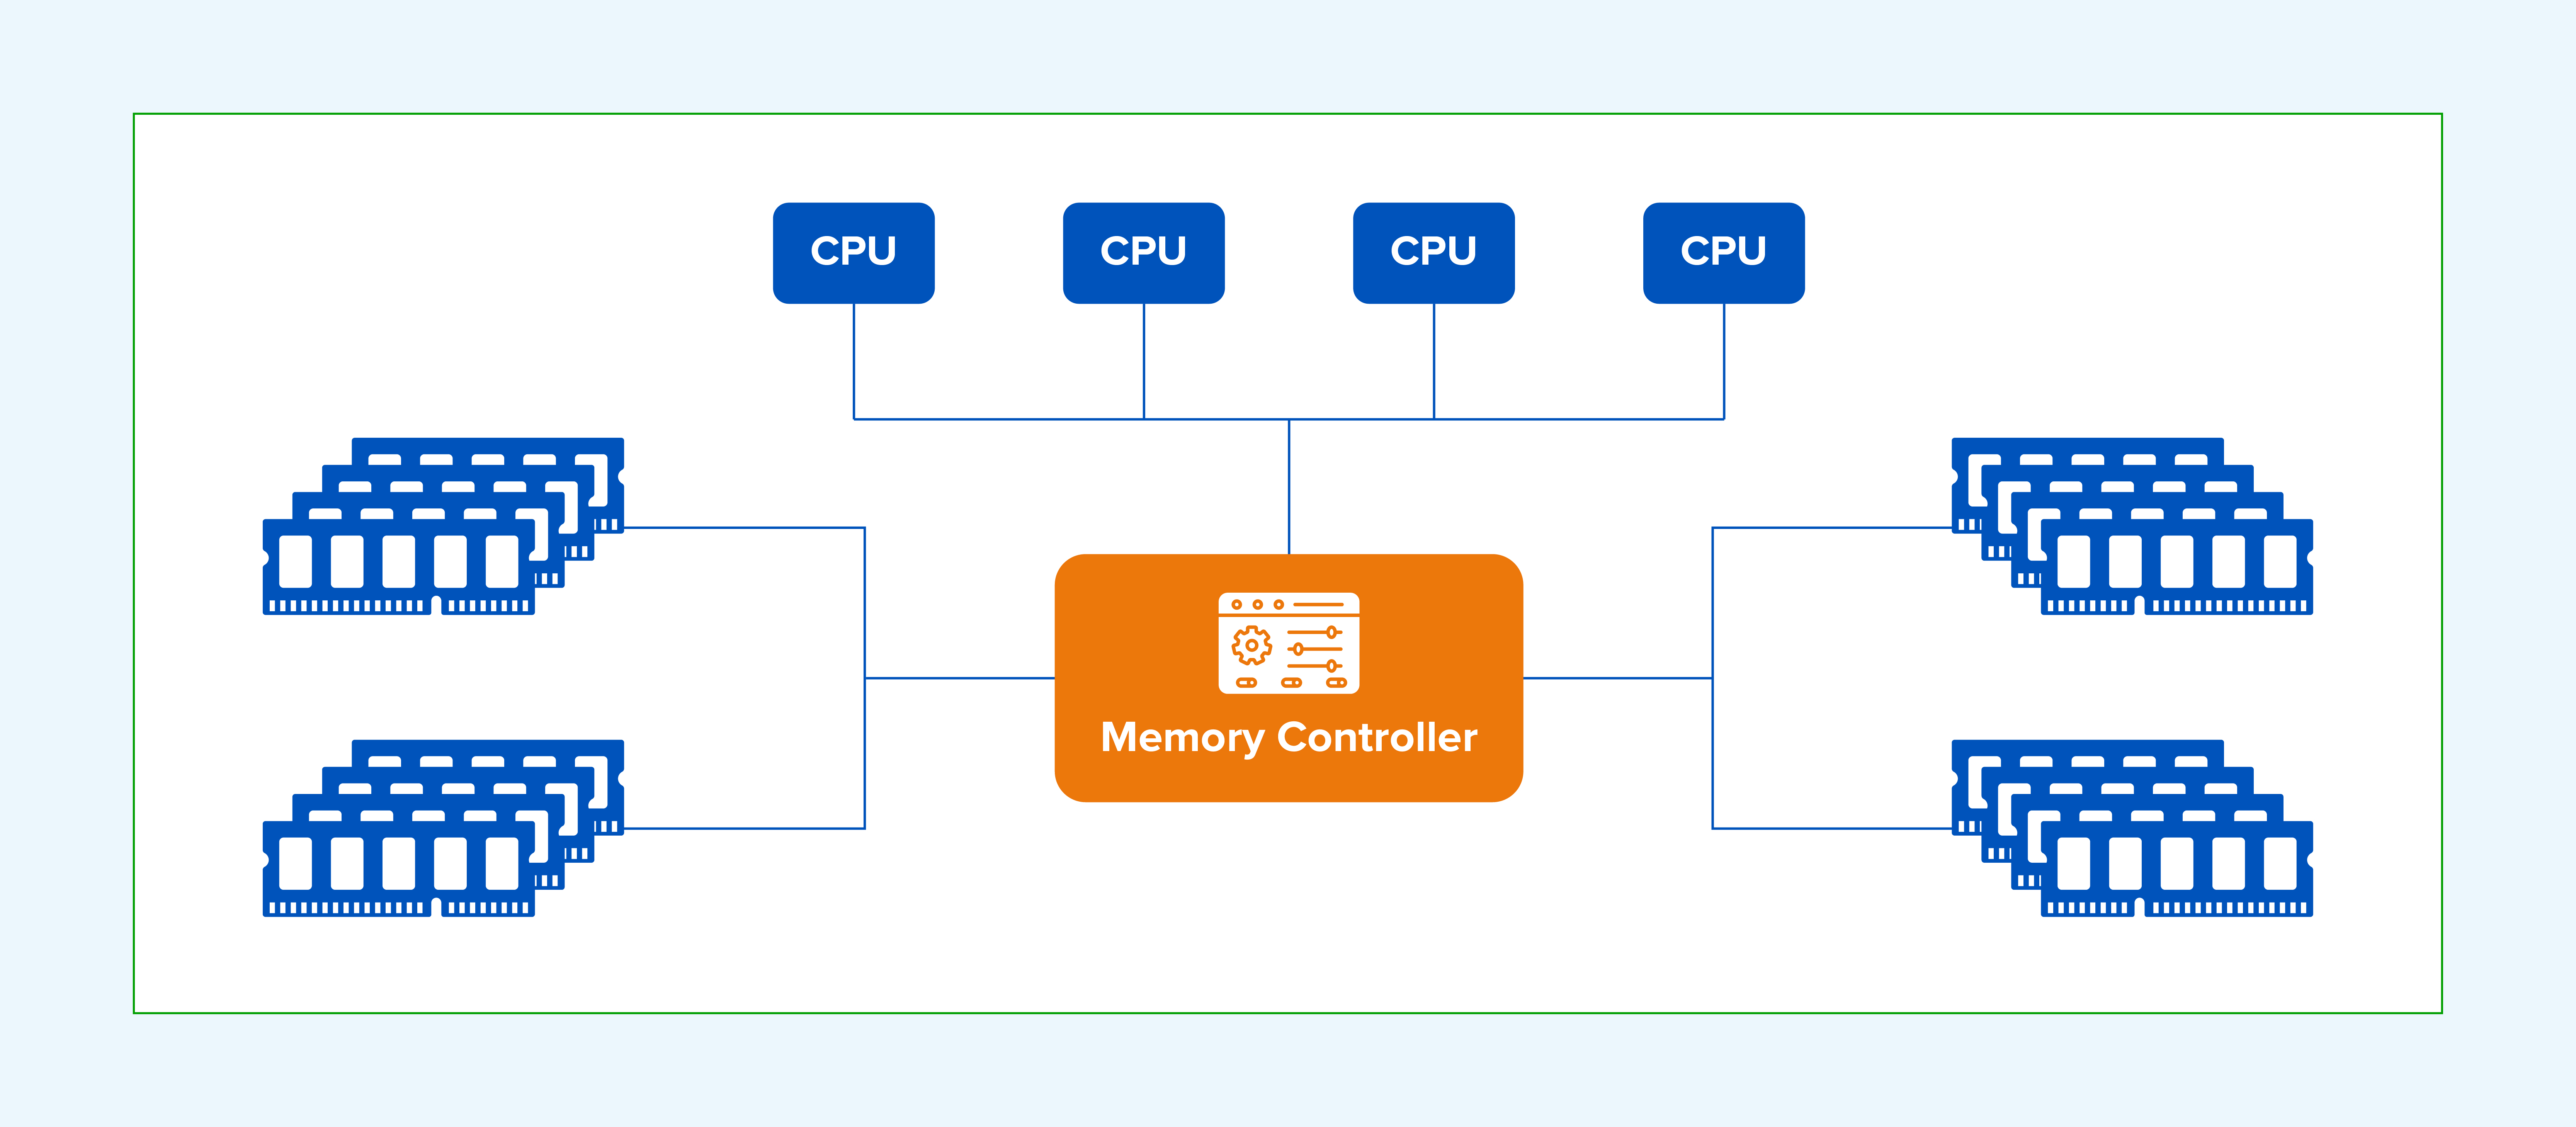
図1:従来のSMPアーキテクチャにおける共有バスメモリアクセスのボトルネック。
NUMAは、SMPにおけるメモリアクセスのボトルネックを解消します。NUMAアーキテクチャでは、システムは複数のノードに分割され、各ノードには1つ以上のプロセッサ、ローカルメモリ、およびI/Oデバイスが含まれます。ノードは、AMD HyperTransportやIntel QuickPath Interconnect(QPI)などの高速インターコネクトを介して通信し、プロセッサが最初にローカルメモリにアクセスできるようにすることで、メモリアクセスのレイテンシを低減し、マルチプロセッサシステムのパフォーマンスを向上させます。
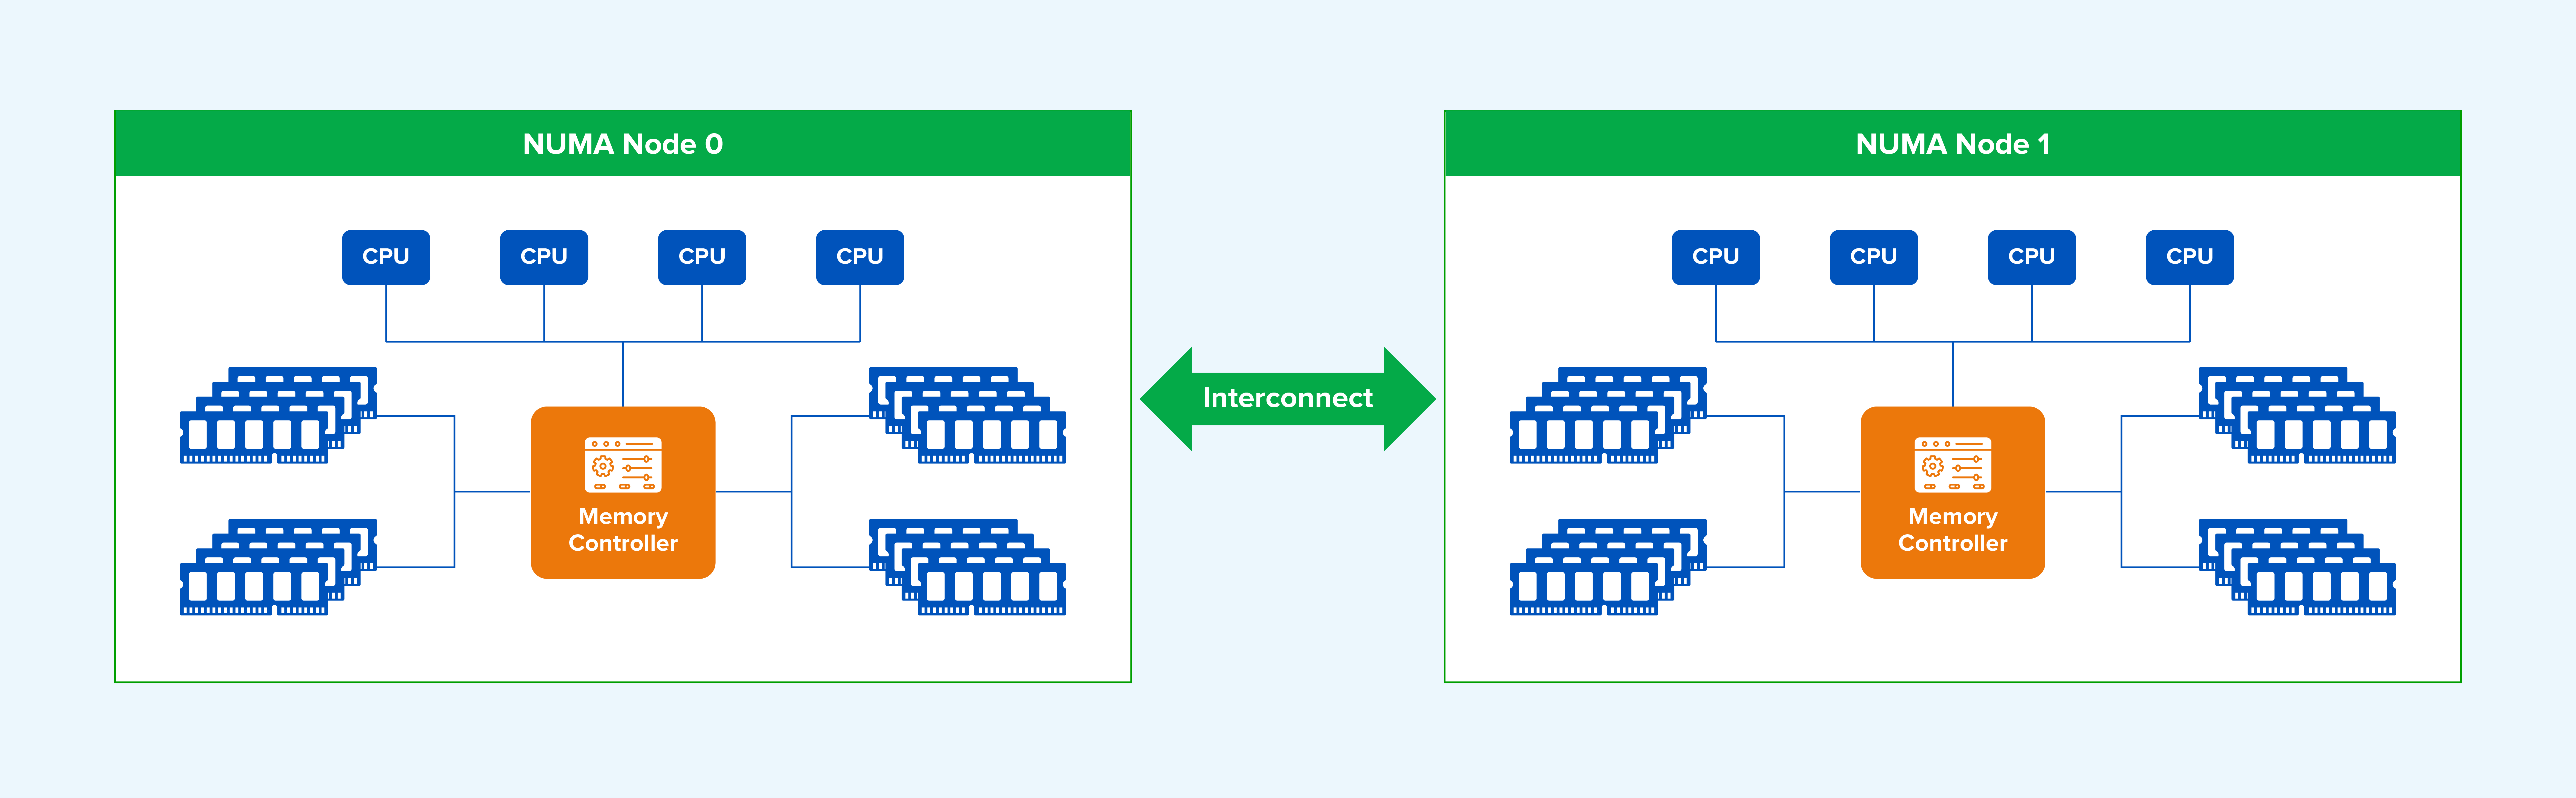
図2:ノードローカルなCPUおよびメモリ割り当てを特徴とするマルチノードNUMAアーキテクチャ。
NUMAシステムには3種類のノードタイプがあります。
- ローカルノード:特定のノード内のCPUにとって、そのノードはローカルノードです。
- 隣接ノード:ローカルノードに隣接するノード。
- リモートノード:ローカルノードでも近隣ノードでもないノード。
CPUのアクセス速度はノードの種類によって異なります。ローカルメモリへのアクセスが最も速く、リモートメモリへのアクセスが最も遅いです。一般的に、トポロジー上の距離が大きくなるにつれて、メモリへのアクセス速度は低下します。
「NUMA:概要」の中で、クリストフ・ラメーター博士は、2013年のハイエンド2ノードサーバーにおいて、ランダムなローカルメモリへのアクセス遅延は約100ナノ秒であったのに対し、リモートメモリへのアクセスではさらに約50%の遅延が加わったと指摘した。
パート2. NUMAによってもたらされた課題
Linuxでは、スレッドはCPUスケジューリングの基本単位であり、CPU実行キュー上のタスクに対応します。カーネルは各タスクに対して、比較的アイドル状態のCPUを選択します。CPU負荷は動的に変化するため、カーネルは負荷分散を使用してタスクを負荷の低いCPUに移行します。そのため、デフォルトでは、タスクは複数のCPU間を移動する可能性があります。
NUMAでは、タスクがノード1のCPUからノード2のCPUに移動しても、ノード1に割り当てられたメモリへのアクセスを継続する可能性があり、結果としてノード間アクセスが発生します。LinuxのNUMAバランシングは、タスクやメモリページを定期的にローカルノードに移行しますが、リモートメモリへのアクセスを完全に排除することはできません。
仮想化環境では、各VMのvCPUはホストオペレーティングシステムのスレッドに対応します。複数のvCPUスレッドが異なるNUMAノード上でメモリを共有しながら実行されている場合、またはノード間を移行する場合、VMはNUMAノードをまたいでメモリにアクセスし、レイテンシが高くなる可能性があります。
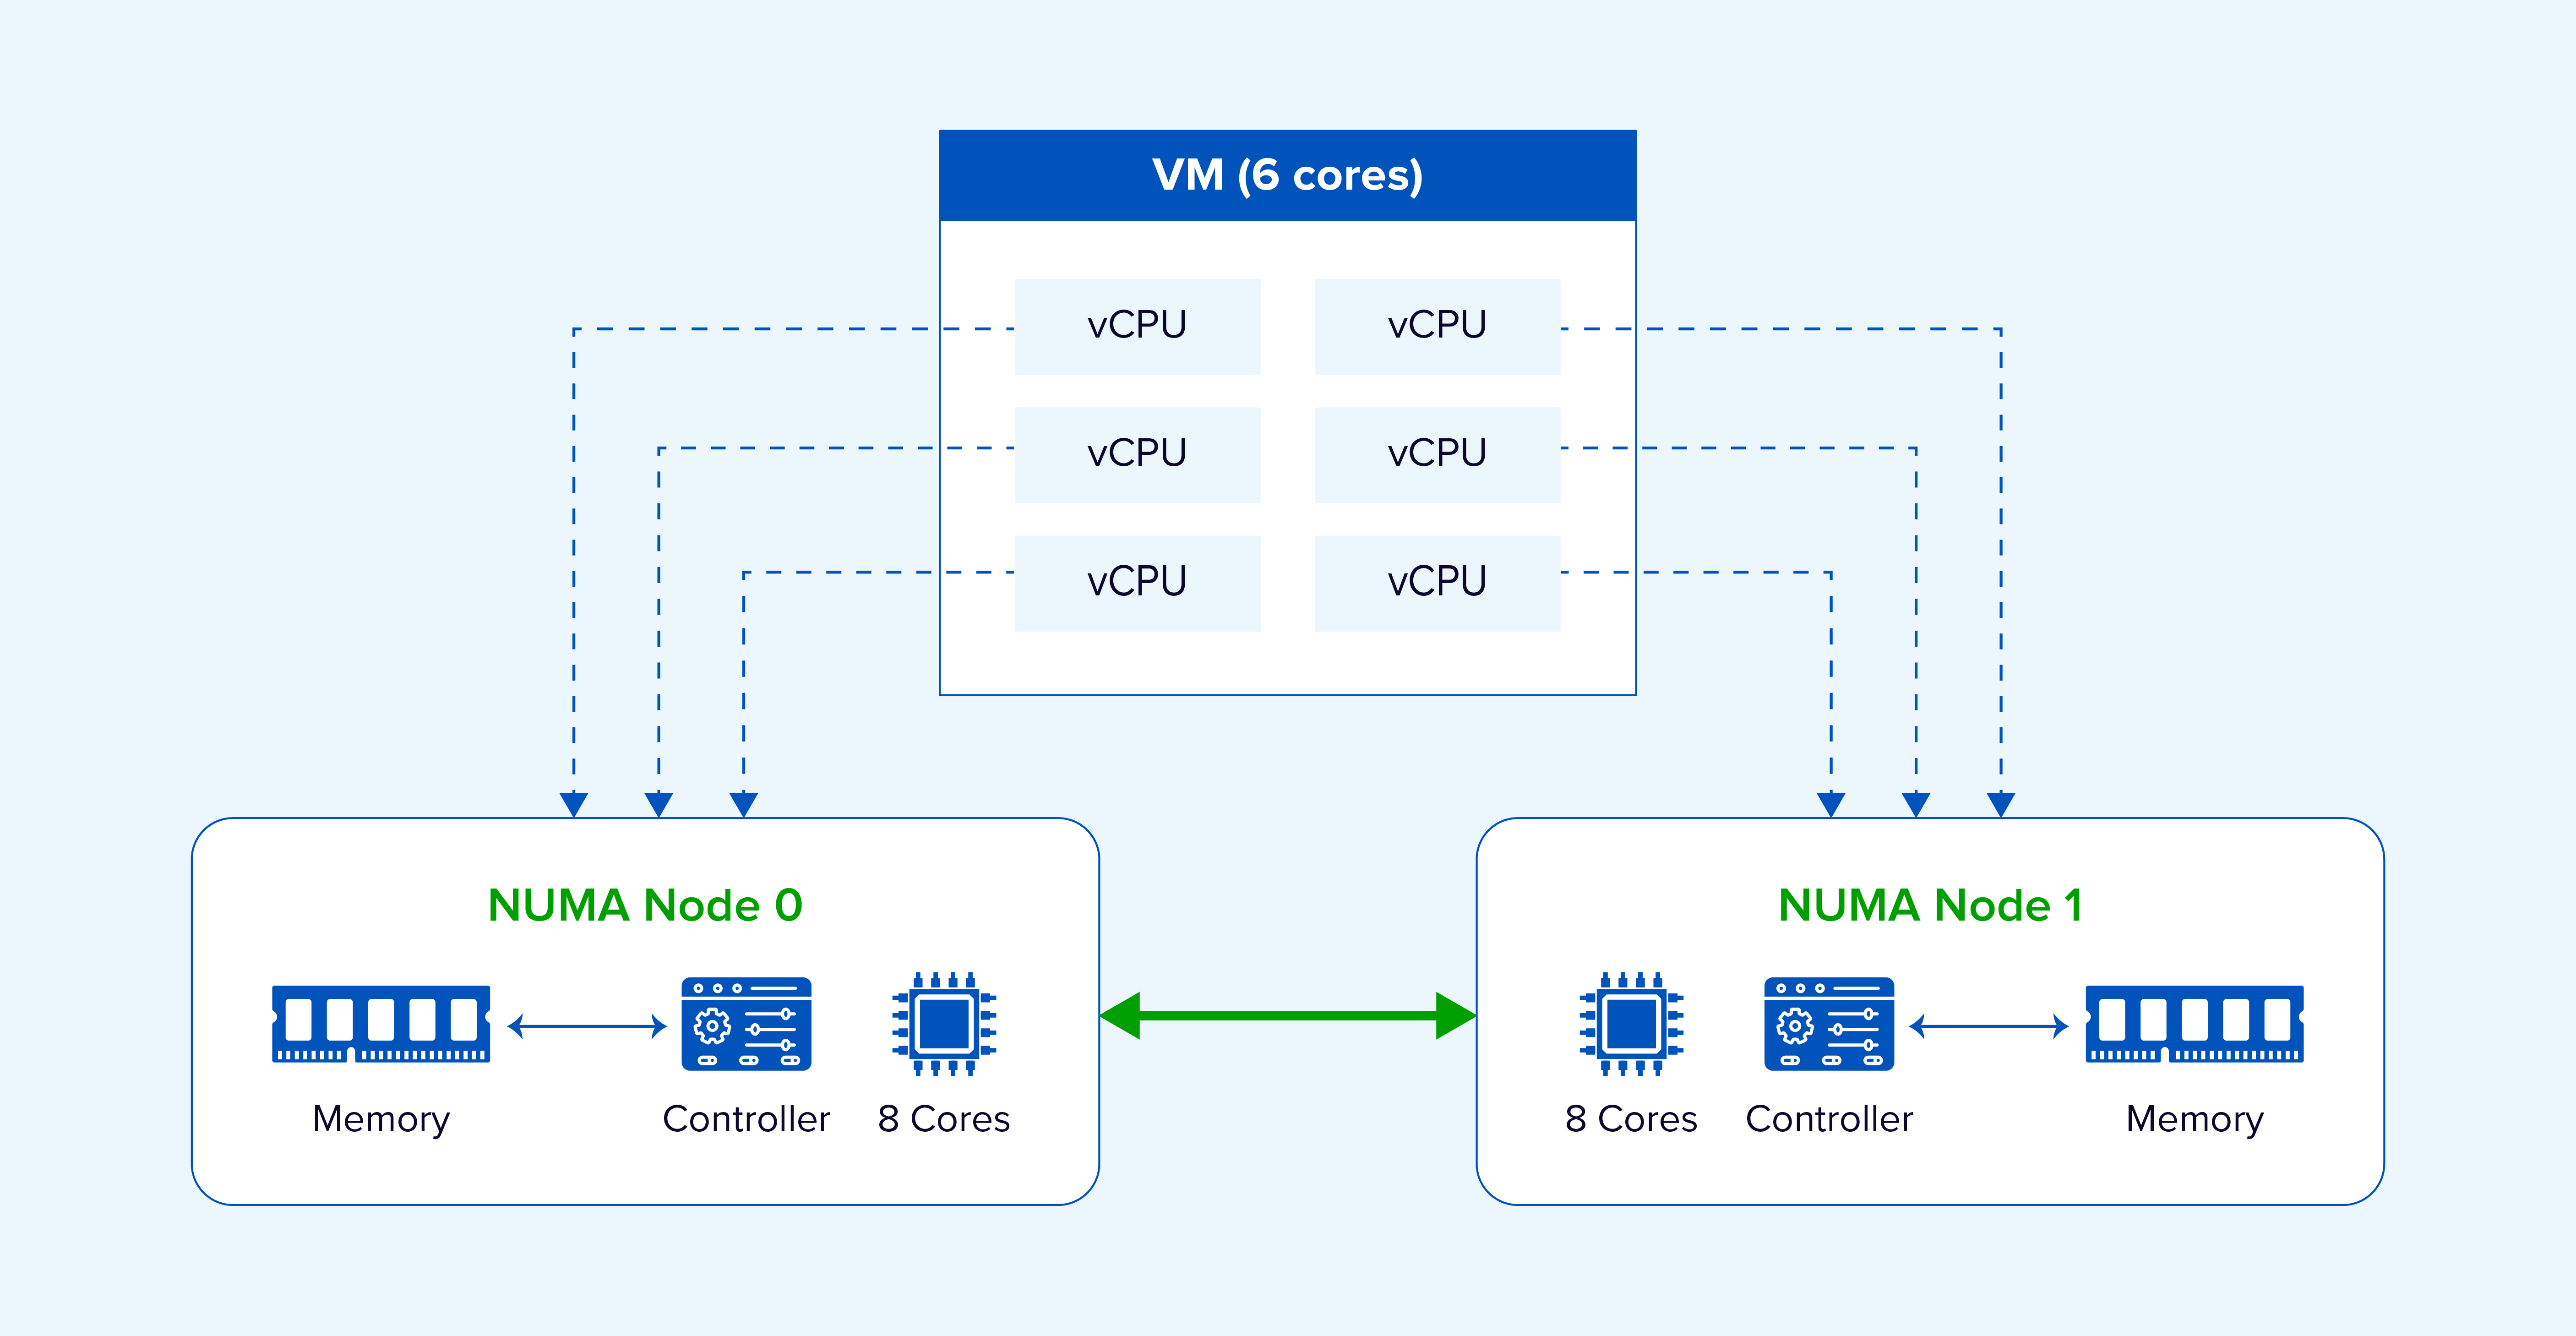
図3:クロスノード実行は、仮想マシンのリモートメモリへのアクセスを増加させることができます。
パート3. 一般的なNUMAスケジューリング手法
業界では一般的に以下の手法が用いられています。
アプローチ1:vCPUを物理コアに固定する
管理者は、VMリソースが同じ物理NUMAノード内で優先的に実行されるように、vCPUのピンニングを手動で構成します。
アプローチ2:VMに割り当てられるNUMAノード数を指定する
管理者はNUMAノードの数を手動で設定し、vCPUとメモリのリソースをそれらのノードに均等に分配します。
アプローチ3:NUMAノードを適応的に割り当てる
スケジューラは、適切なNUMAノードを自動的にVMに割り当てます。VMのCPUはこれらのノードに限定され、ローカルメモリを優先的に使用して局所性を向上させます。VMのvCPU数が単一のNUMAノードで収容できる数を超える場合は、複数のノードに分散されます。NUMAトポロジーは、トポロジーを考慮した意思決定のためにゲストオペレーティングシステムに公開することができ、VMは負荷分散を維持するためにノード間で移行できます。
アプローチ1と2はより多くの制約を課し、VMのCPUサイズを慎重に選定する必要があり、静的バインディングのためにNUMAノード間の不均衡が生じる可能性があります。したがって、動的な本番環境においては、適応型割り当ての方がより実用的です。
パート 4. Sangfor NUMA スケジューリングの詳細
Sangfor HCIは主にアダプティブNUMAスケジューリングを採用しています。これにより、NUMAノード間の利用率をバランスよく調整しつつ、VMのvCPUによるリモートメモリへのアクセスを削減することで、全体的なパフォーマンスを向上させています。
適応型NUMAスケジューリングは、さまざまなアプリケーションタイプ、特にインメモリ操作が頻繁に発生するミドルウェアにおいて、明確な最適化効果をもたらします。Sangforは、DM8、Redis、Memcachedを仮想マシンにデプロイし、NUMAスケジューリングを有効にした場合と無効にした場合でベンチマークテストを実施しました。その結果、NUMAスケジューリングを有効にすることで、ミドルウェアのパフォーマンスが明らかに向上することが示されました。
データベースワークロード:BenchmarkSQLを使用したDameng DB(DM8)
BenchmarkSQLは、新規注文、支払い、注文ステータス照会、配送、在庫レベル照会など、TPC-Cスタイルのトランザクションミックスを実行するリレーショナルデータベースベンチマークです。結果として得られるtpmCメトリックは、1分あたりに処理される新規注文トランザクションの数を表し、値が高いほどパフォーマンスが優れていることを示します。BenchmarkSQL 5.0を使用してDM8データベースをテストしました。次のグラフは相対的なパフォーマンスを示しており、NUMAを無効にしたtpmCの結果を100%に正規化しています。
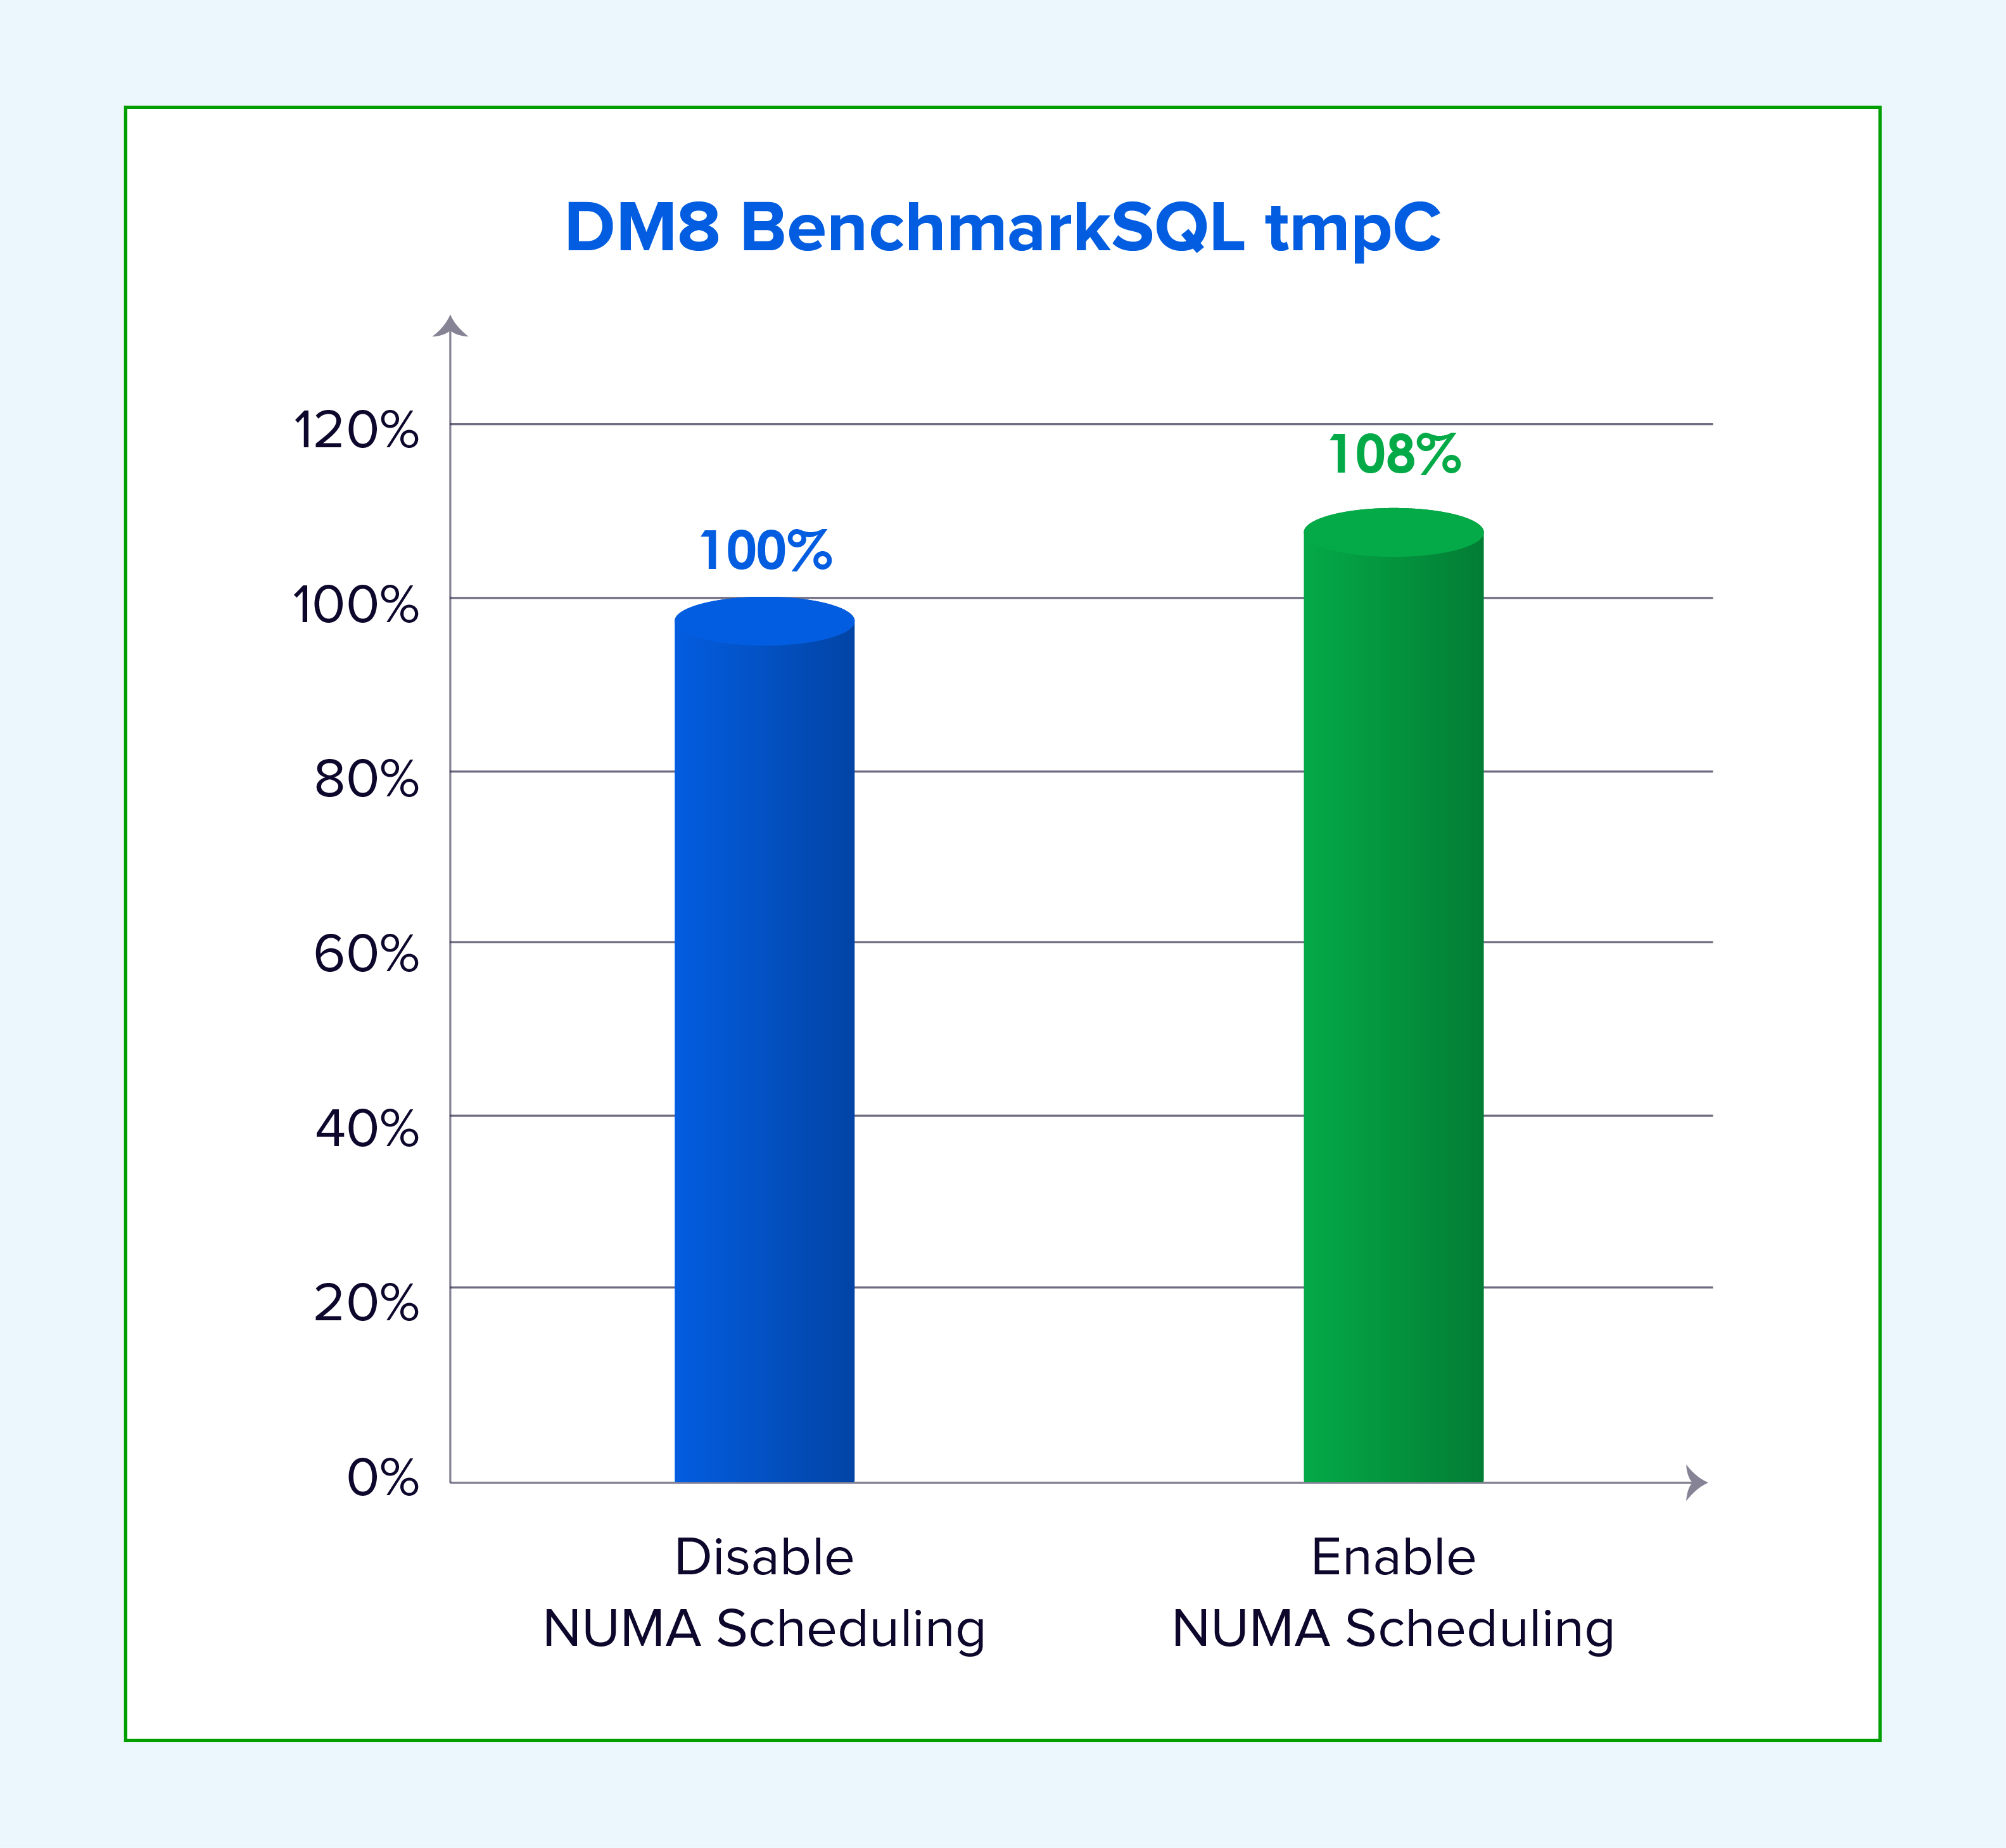
図4:NUMAスケジューリングを有効にした場合と無効にした場合のDM8トランザクションスループットの相対値。
インメモリキャッシング:Redis 7.2.5
redis-benchmarkは、Redisの公式パフォーマンステストツールです。Sangforはこのツールを使用して、NUMAスケジューリングを無効にした場合と有効にした場合の両方で、1KBの値に対するGETおよびSETのQPS(1秒あたりの読み取りまたは書き込み操作数)をテストしました。
redis-benchmark -t get -d 16 -c 100 -n 6000000 -r 60000000
redis-benchmark -t set -d 16 -c 100 -n 6000000 -r 60000000
以下のグラフは相対的なパフォーマンスを示しており、NUMAを無効にした状態でのQPSの結果を100%に正規化しています。
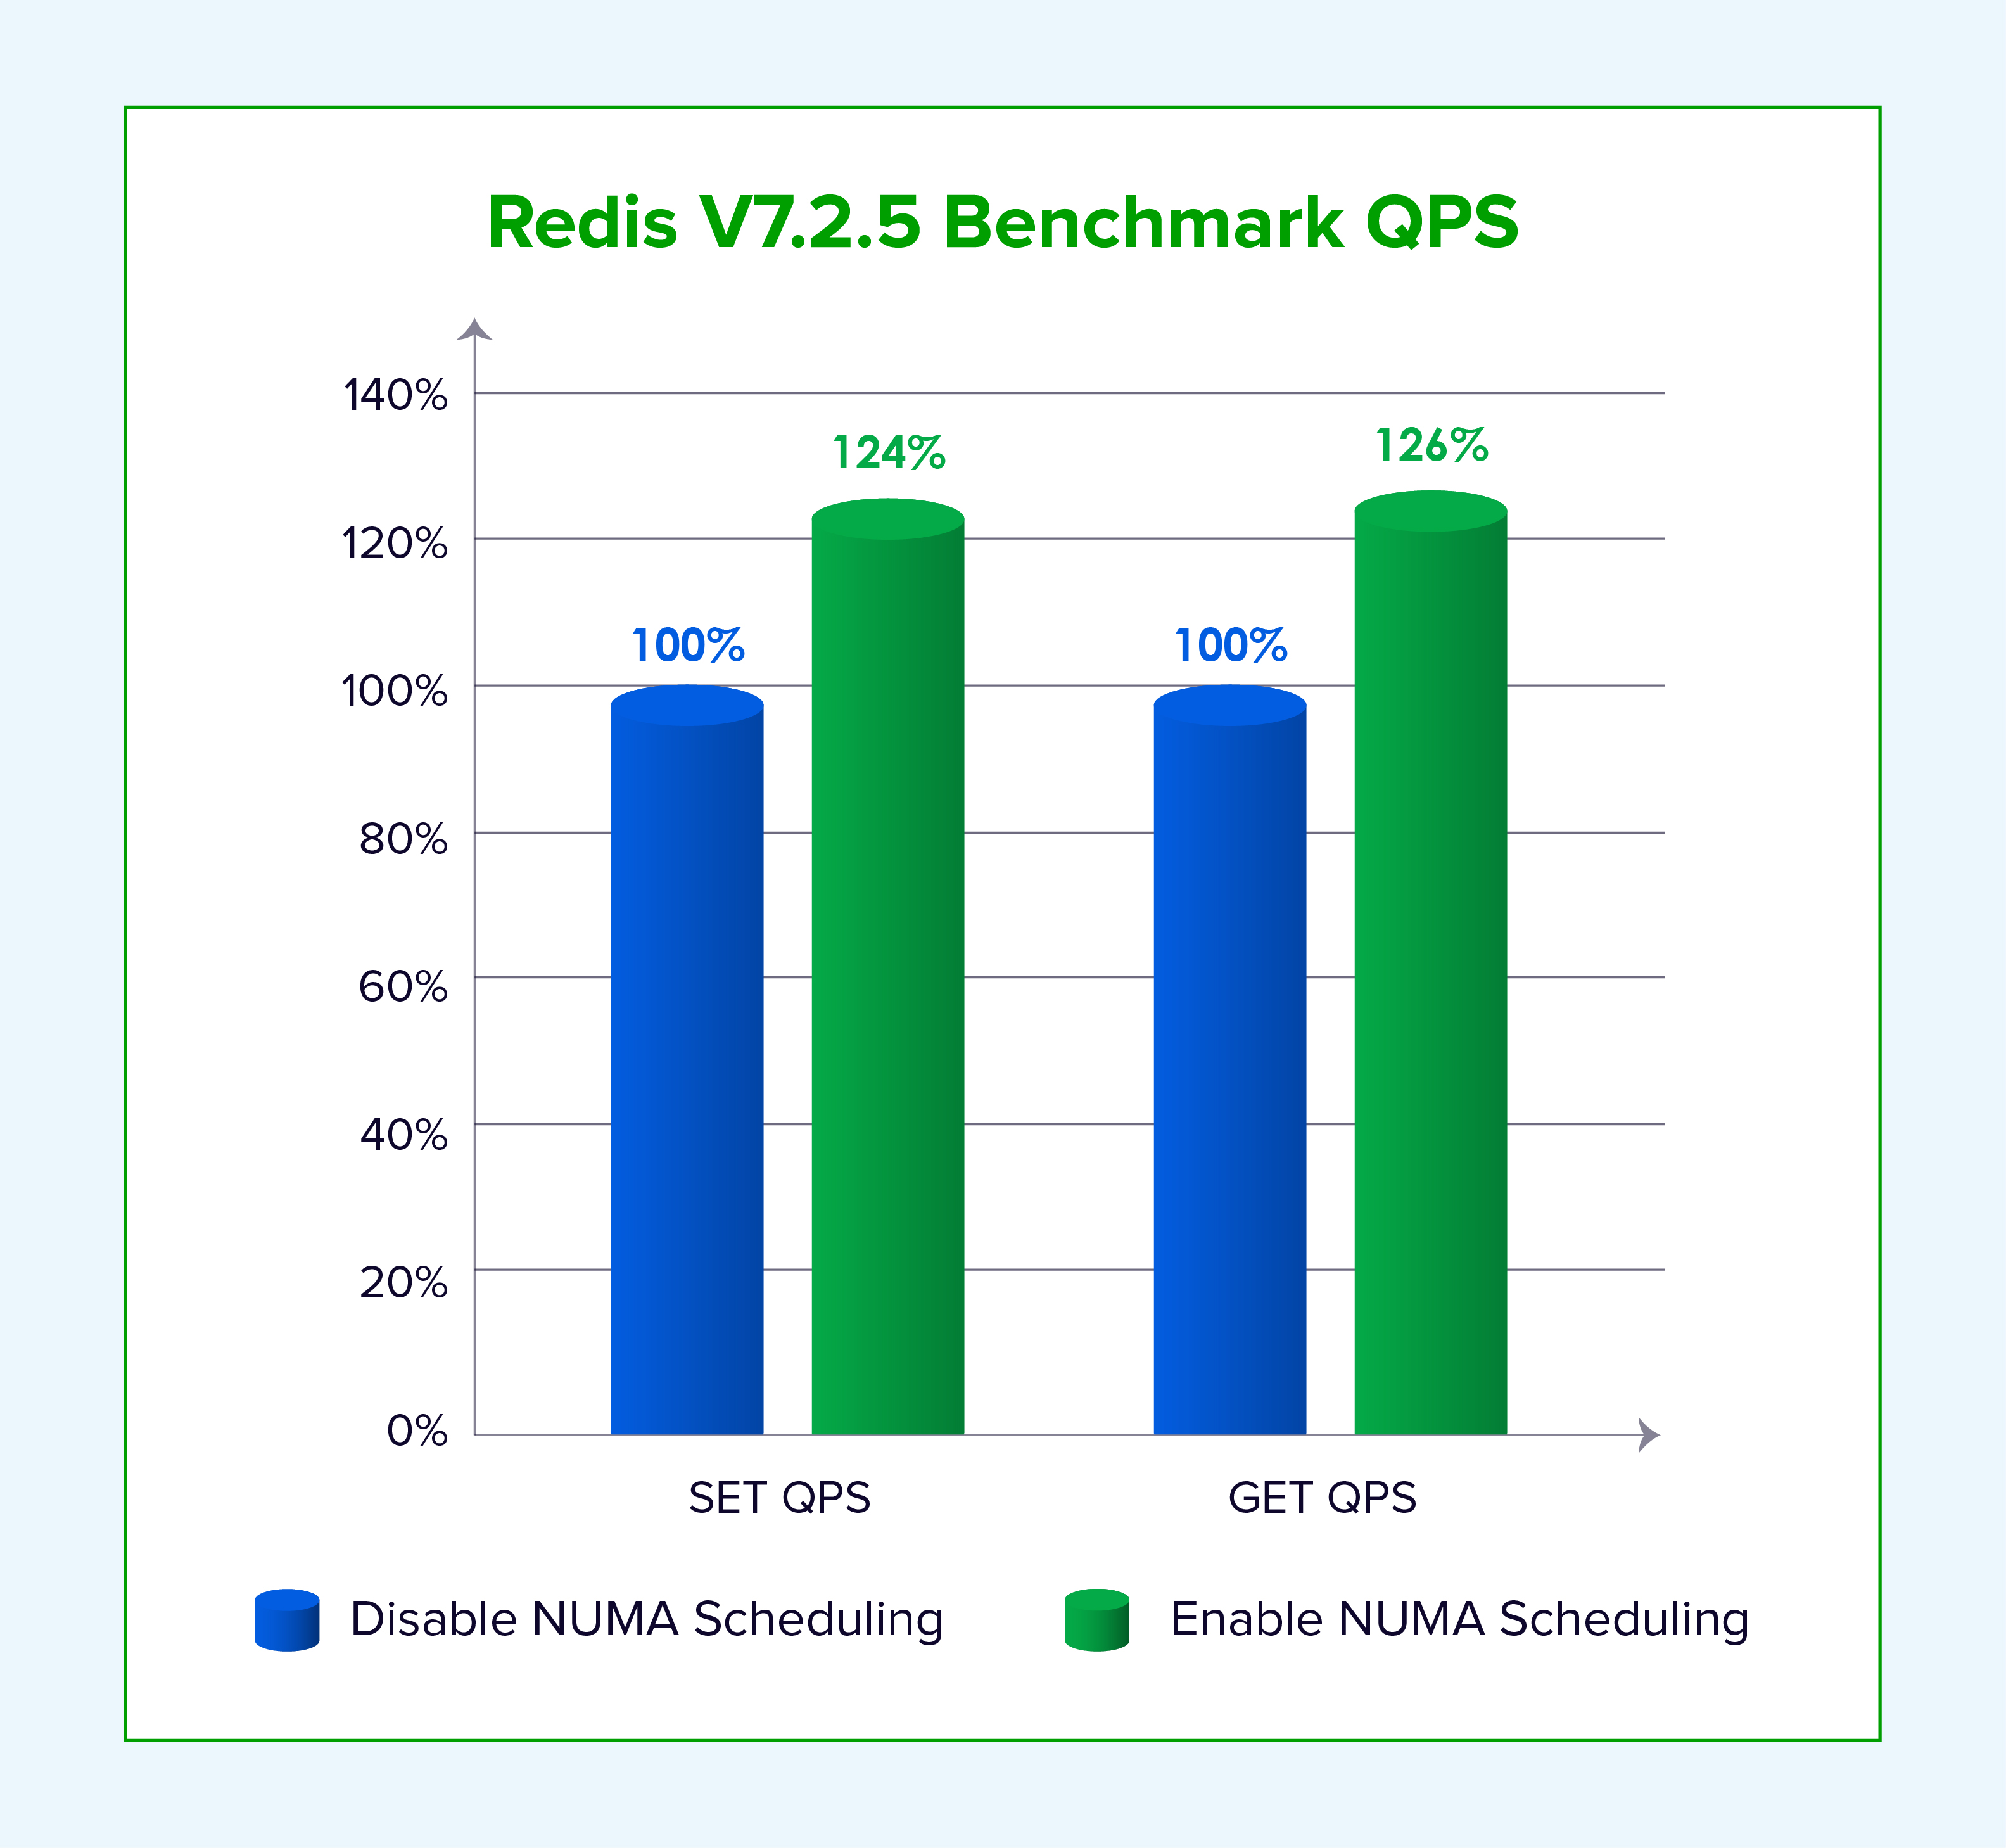
図5:NUMAスケジューリングを有効にした場合の、Redisの相対的な読み書きQPSパフォーマンスの向上。
キーバリューキャッシュ:Memcached 6.27
memaslapは、Memcachedに付属するパフォーマンス テスト ツールです。Sangfor はこれを使用して、NUMA スケジューリングを無効にした場合と有効にした場合の 1KB 値に対する TPS をテストしました。TPS は、1 秒あたりのトランザクション数を表します。
memaslap -s 127.0.0.1:11211 -t 300s -T 8
以下のグラフは相対的なパフォーマンスを示しており、NUMAを無効にした状態でのTPSの結果を100%として正規化しています。
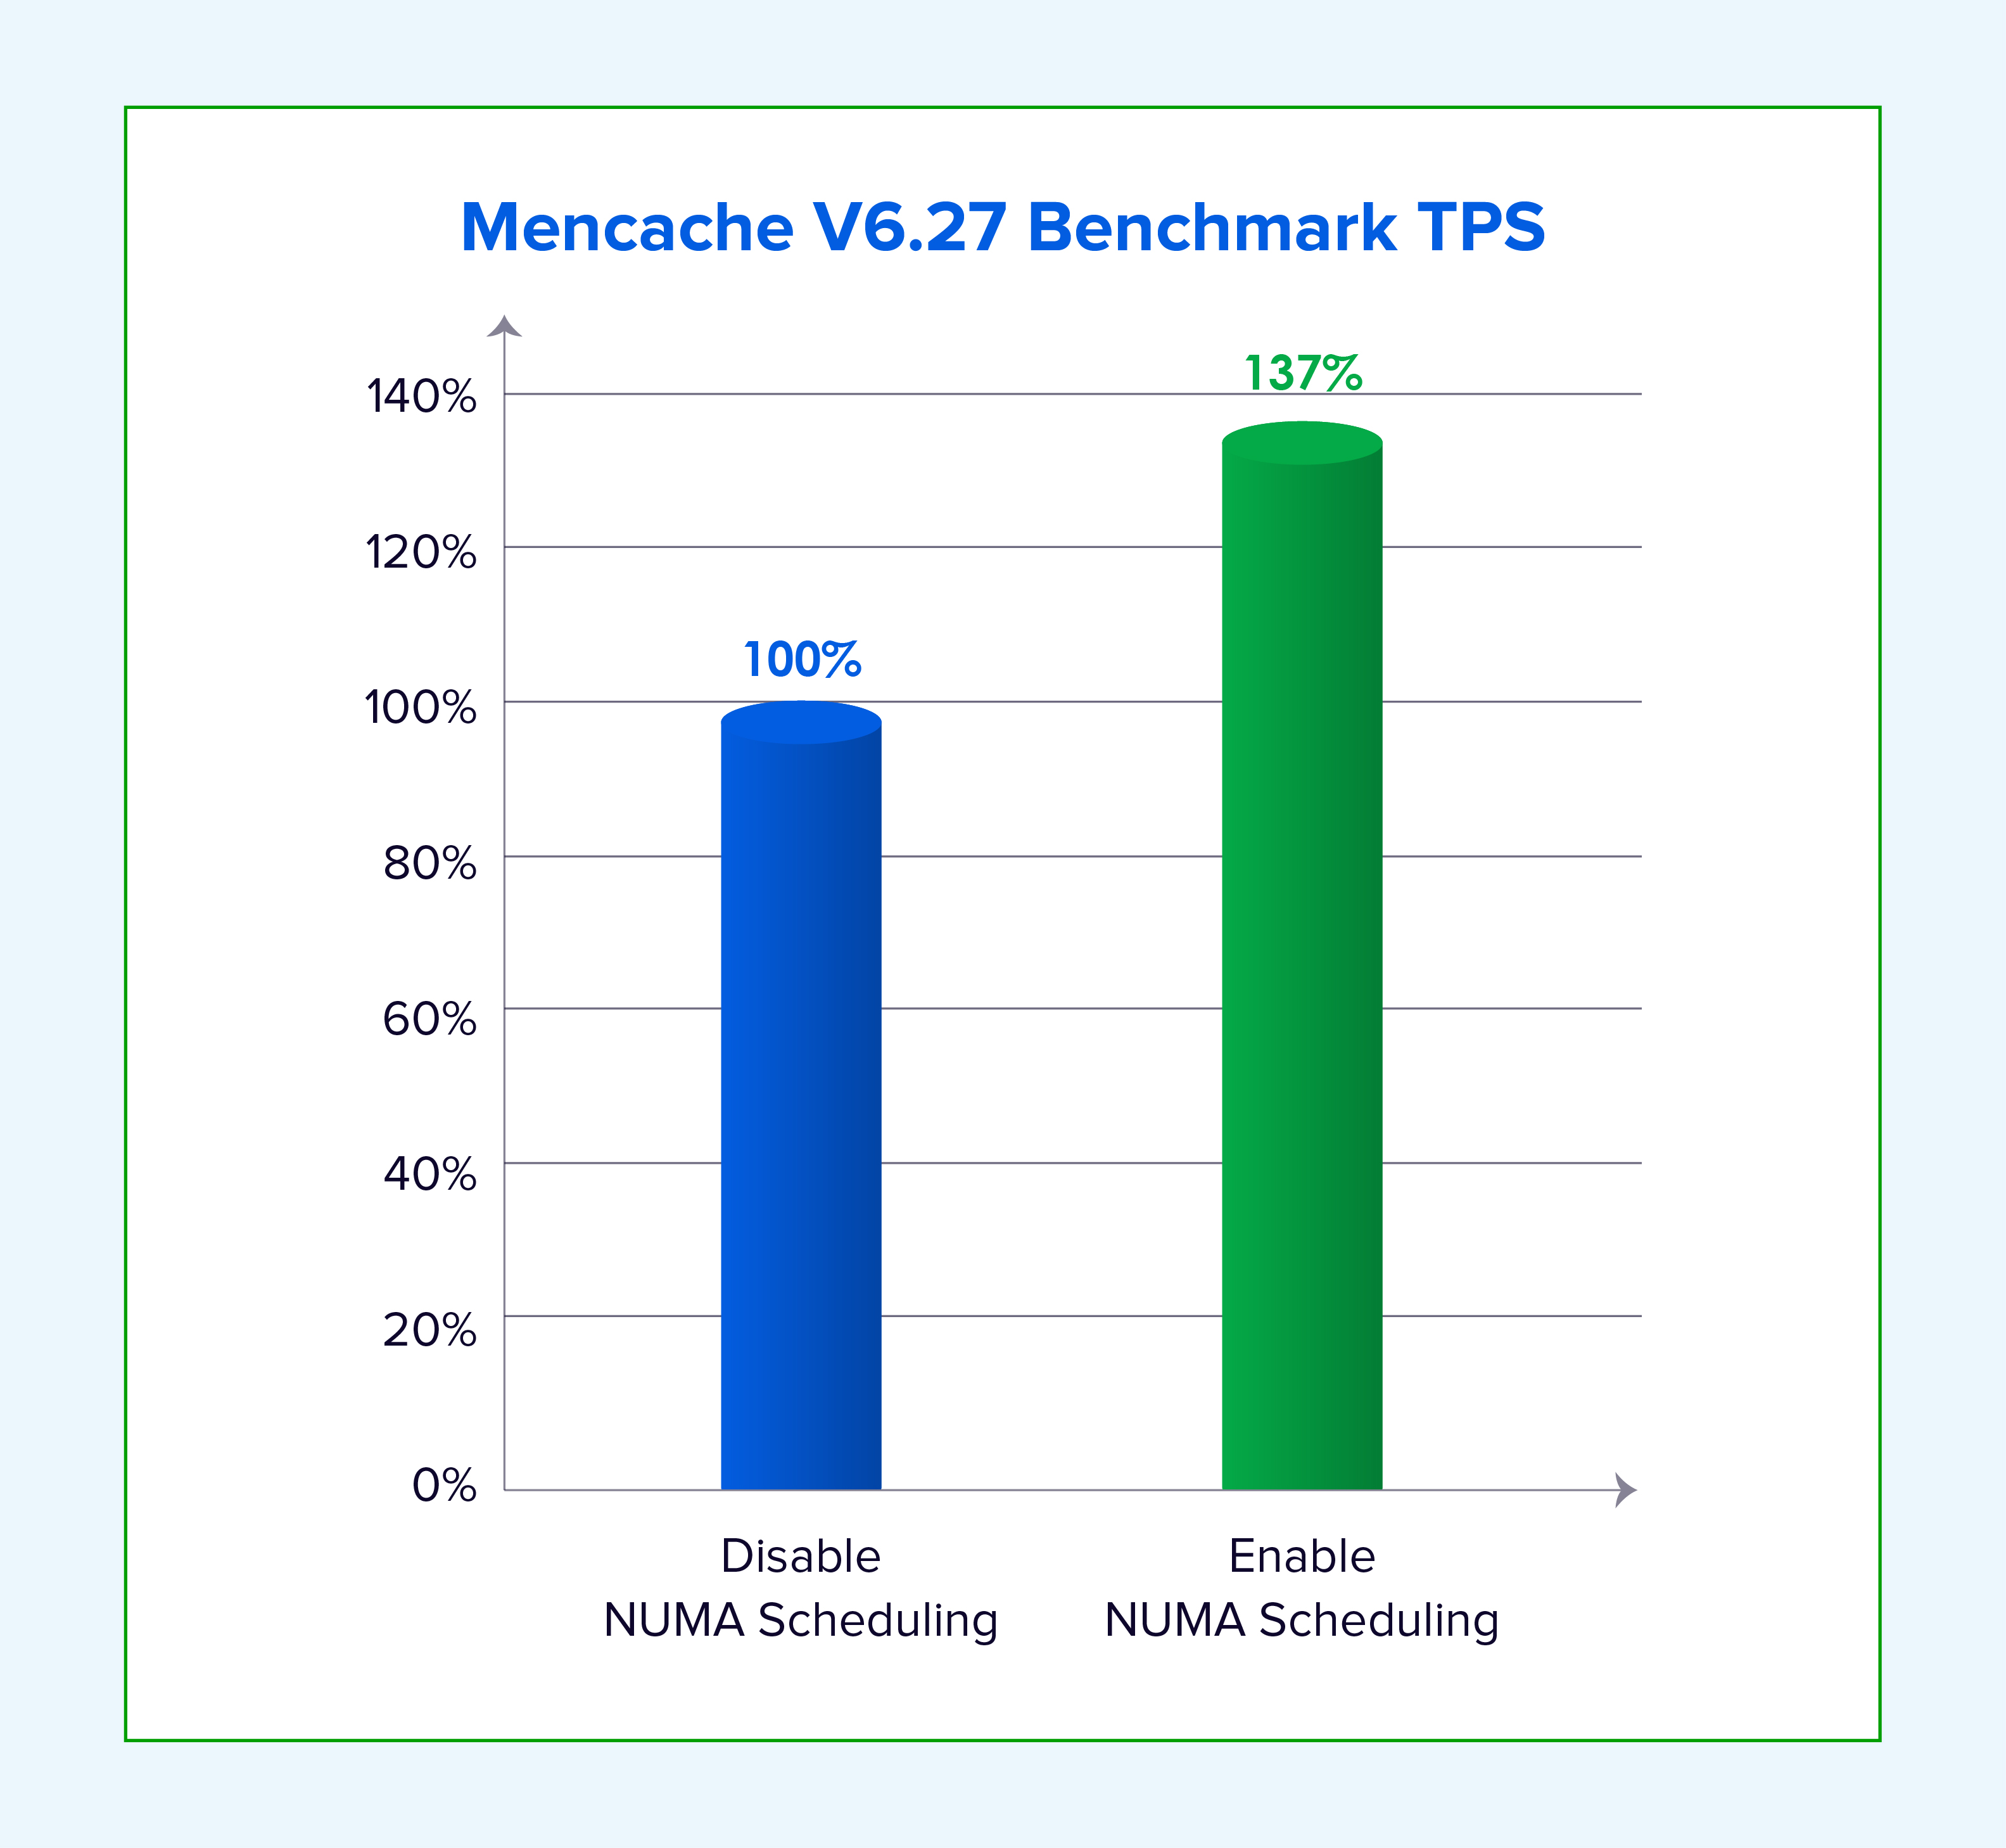
図6:NUMAスケジューリングを有効にした場合のMemcachedのトランザクションスループットの相対的な向上。
上記の結果は、メモリを大量に消費するアプリケーションにとって明確なメリットがあることを示しています。以下のセクションでは、最適化の仕組みについて説明します。
1. 適応型NUMAノード割り当て
Sangforは、VMのvCPUを適応的に分割し、適切なNUMAノードにスケジュールすることで、リモートメモリへのアクセスを削減します。VMのvCPU数が1つのNUMAノードのコア数よりも少ない場合、VMは単一のノードにスケジュールされます。VMが必要とするコア数が1つのノードで提供できる数よりも多い場合は、複数のノードに分散され、vNUMAトポロジーがゲストオペレーティングシステムに公開され、トポロジーを考慮した意思決定が行われます。
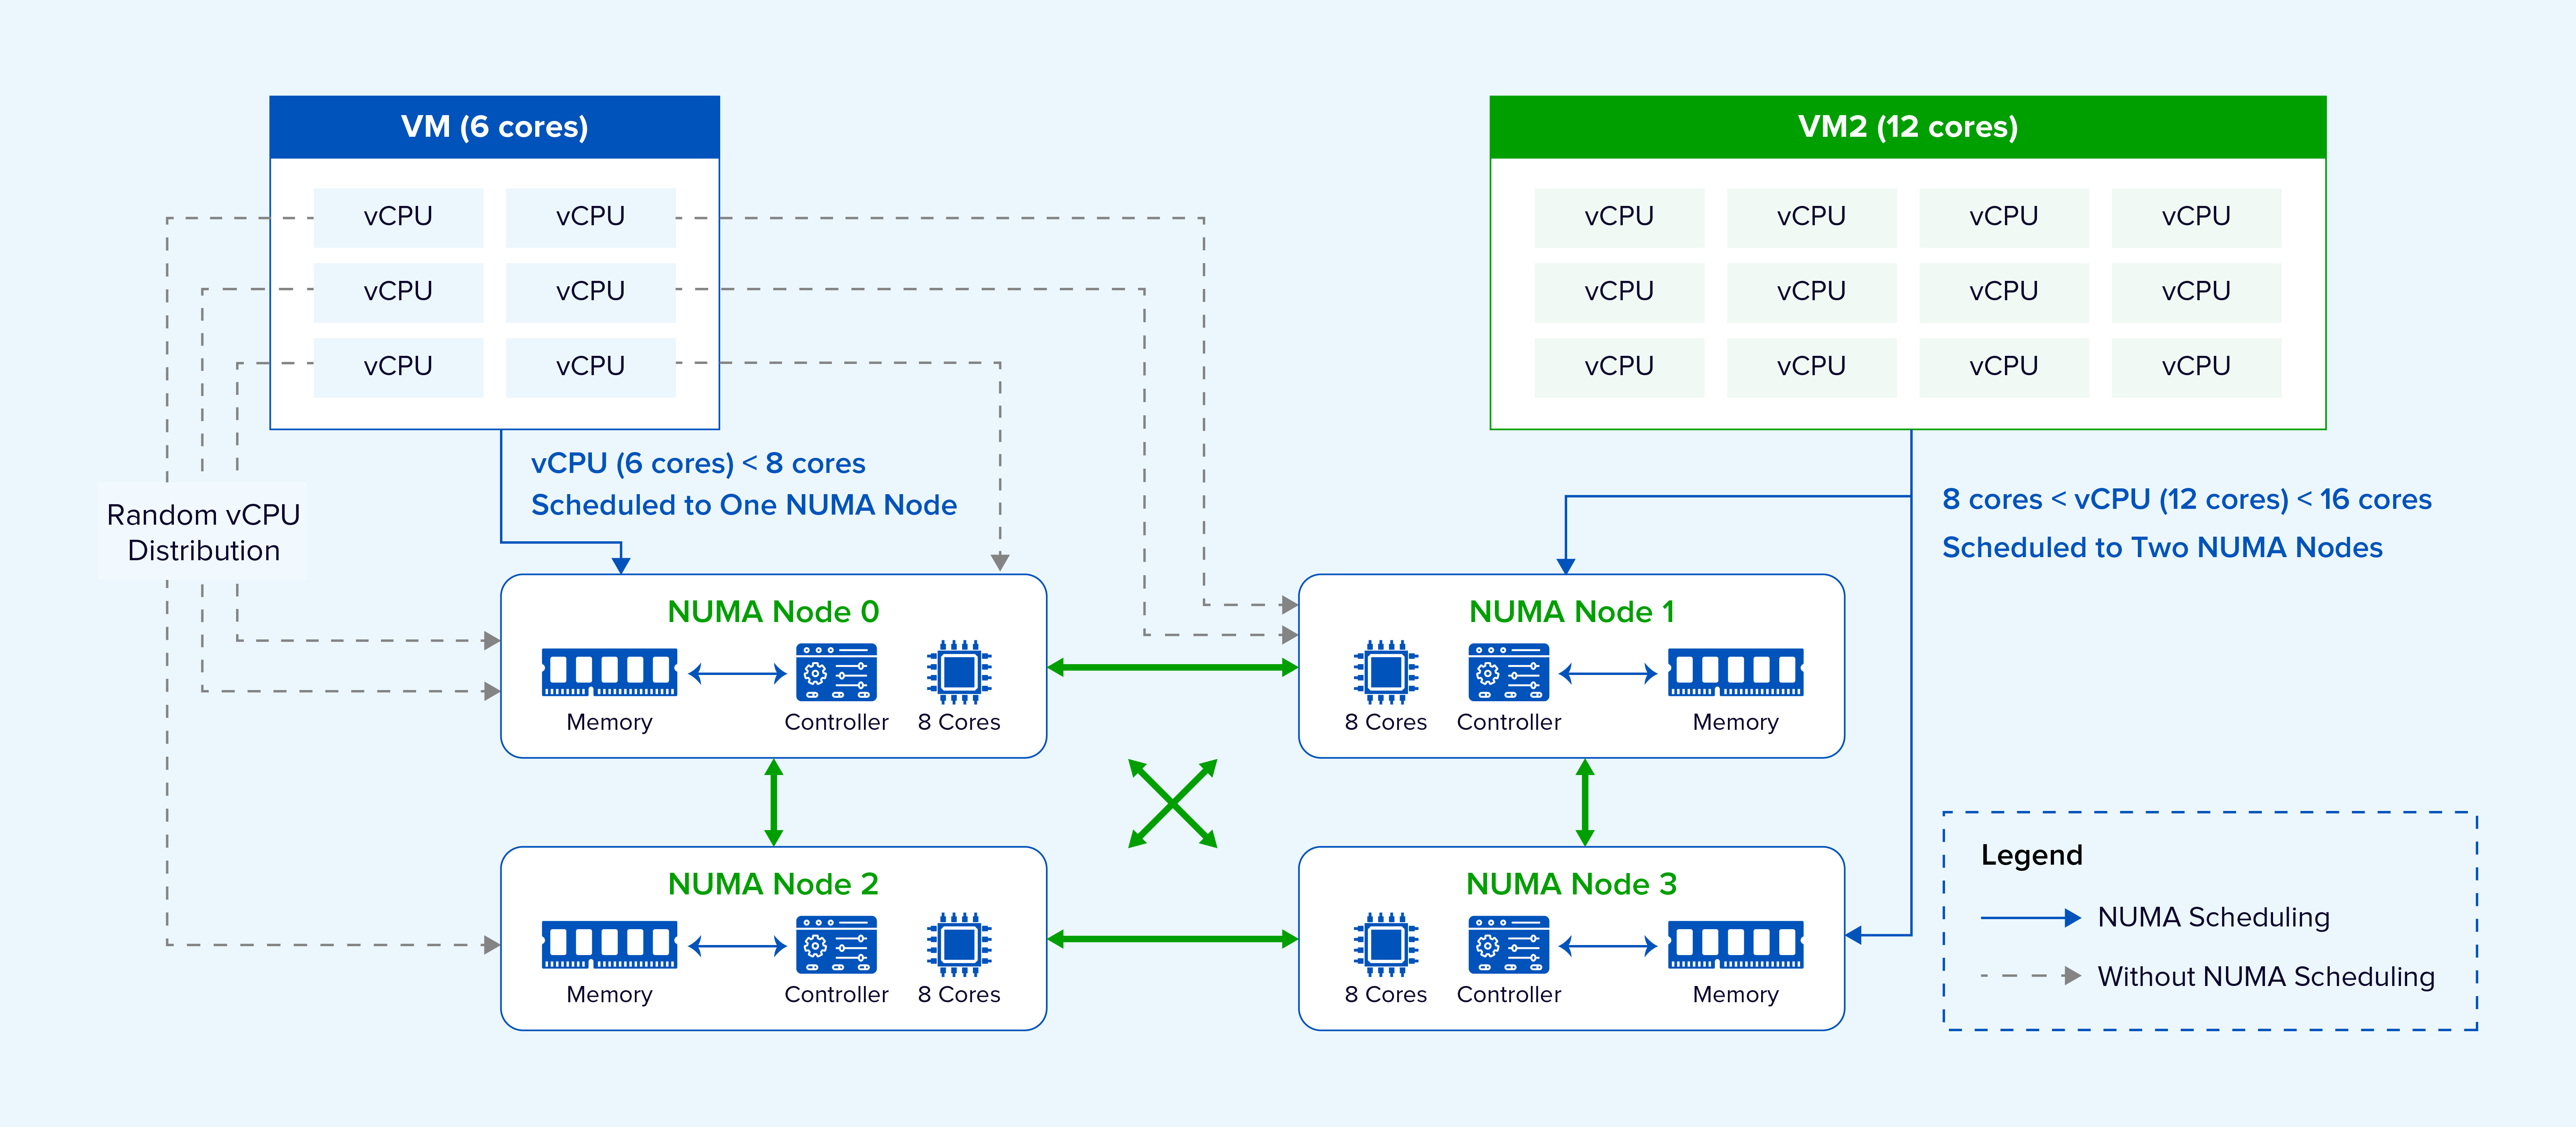
図7:SangforのインテリジェントなvCPUパーティショニングとvNUMAトポロジーマッピング。
バランスの取れた利用率を維持するため、VM配置ではNUMAノード全体の現在の負荷を考慮し、負荷の低いノードを選択します。実行時には、利用率の変化に応じてVMがノード間で移行される場合があります。優先度の高いVMは、CPU、メモリ帯域幅、キャッシュリソースの競合を軽減するため、競合の少ないノードに優先的に配置されます。
2. 異種サーバープラットフォームの最適化
一部のサーバープラットフォームは、多数のNUMAノード、異なるノード間距離、およびノードあたりのコア数が比較的少ないという特徴を持つ。
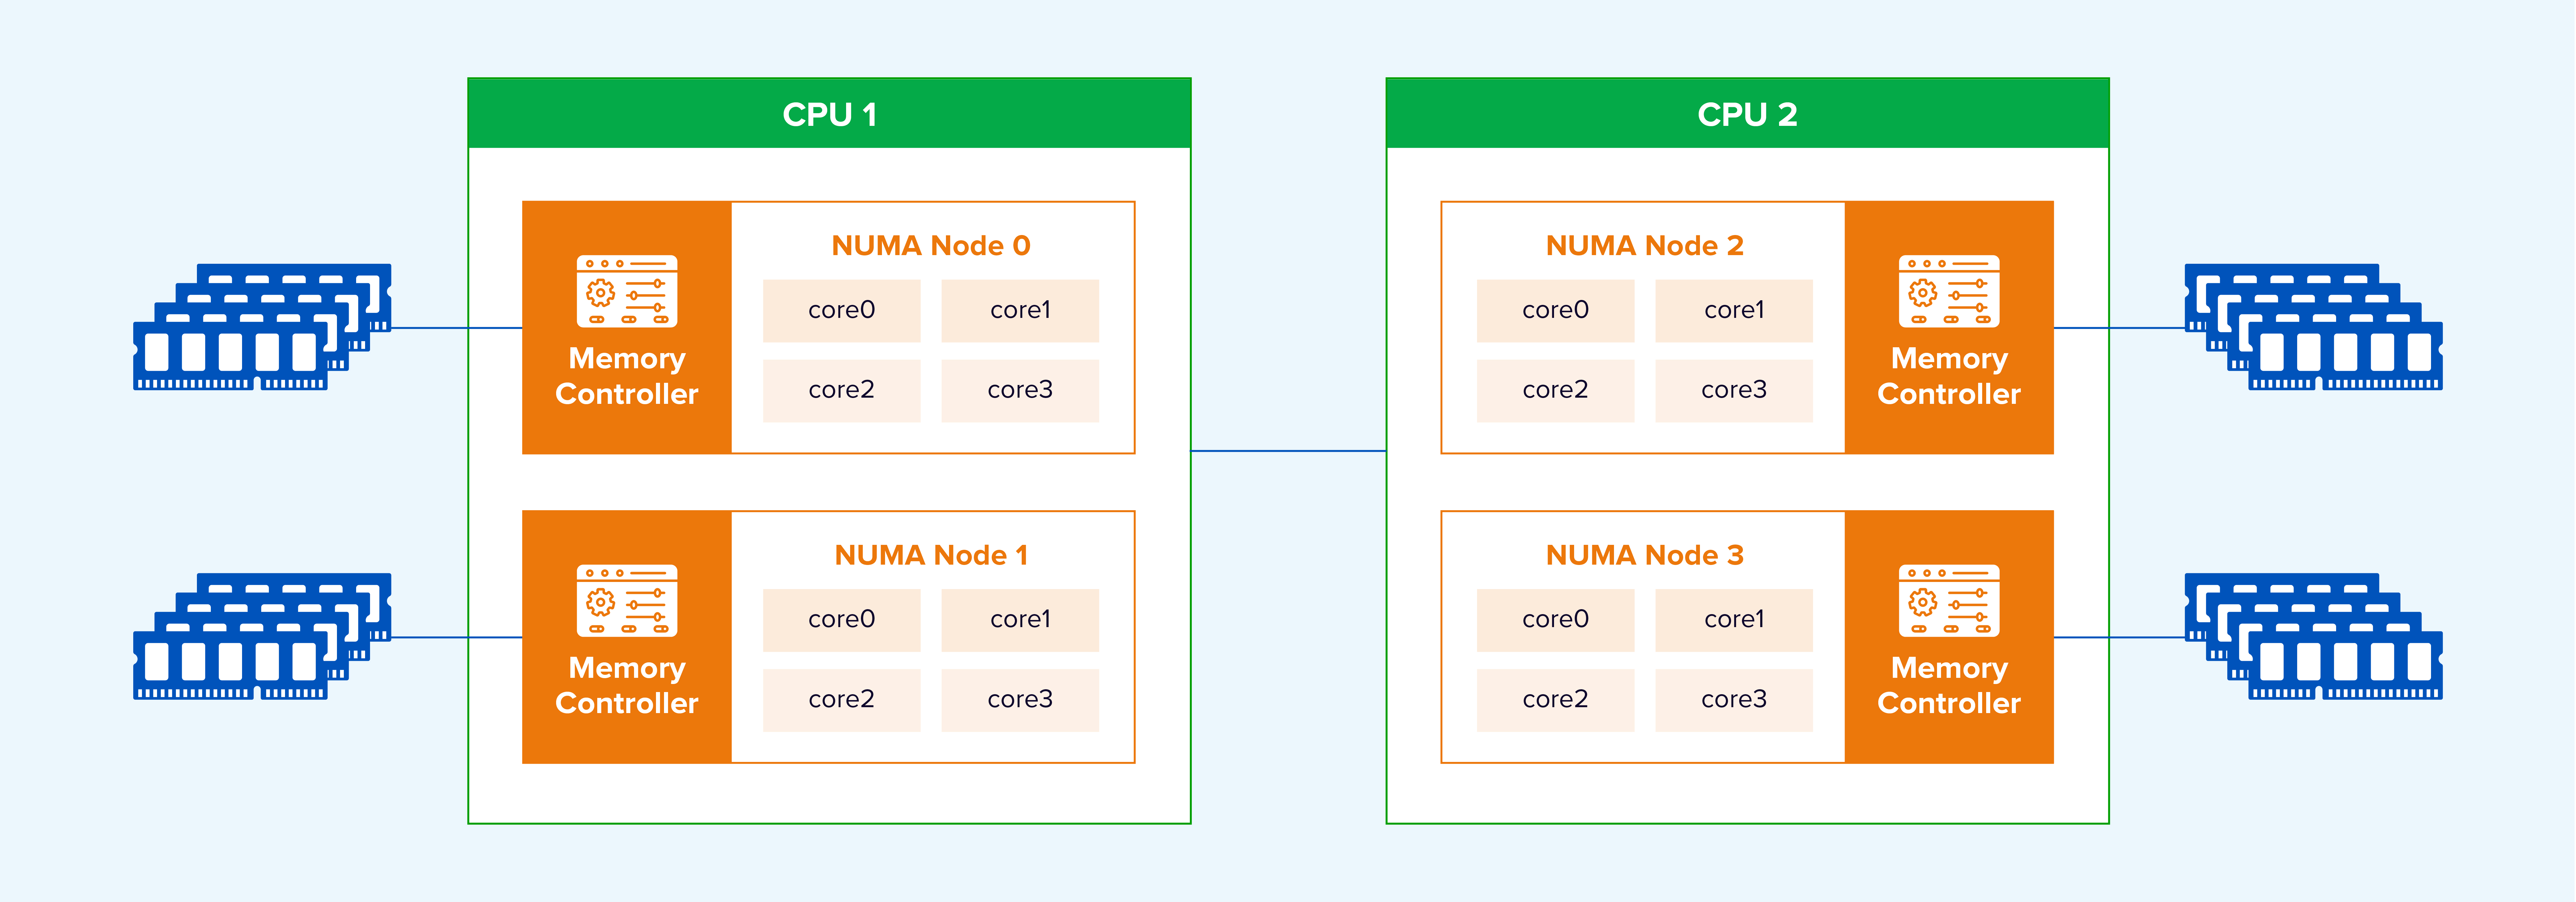
図8. マルチノードサーバーにおけるトポロジーを考慮したvNUMA配置。
SangforはNUMAノード間の距離を識別し、同じVMに属する複数のvNUMAノードを、近くの物理NUMAノードに優先的に配置します。
データ転送パフォーマンスをさらに向上させるため、SangforはVMとデータプレーンプロセス間のNUMAアフィニティを開発しました。VMとそのデータ転送プロセスは同じNUMAノードにスケジュールされるため、ローカルメモリへのアクセスが増加します。以下の図では、DPはデータプレーンプロセスを指します。
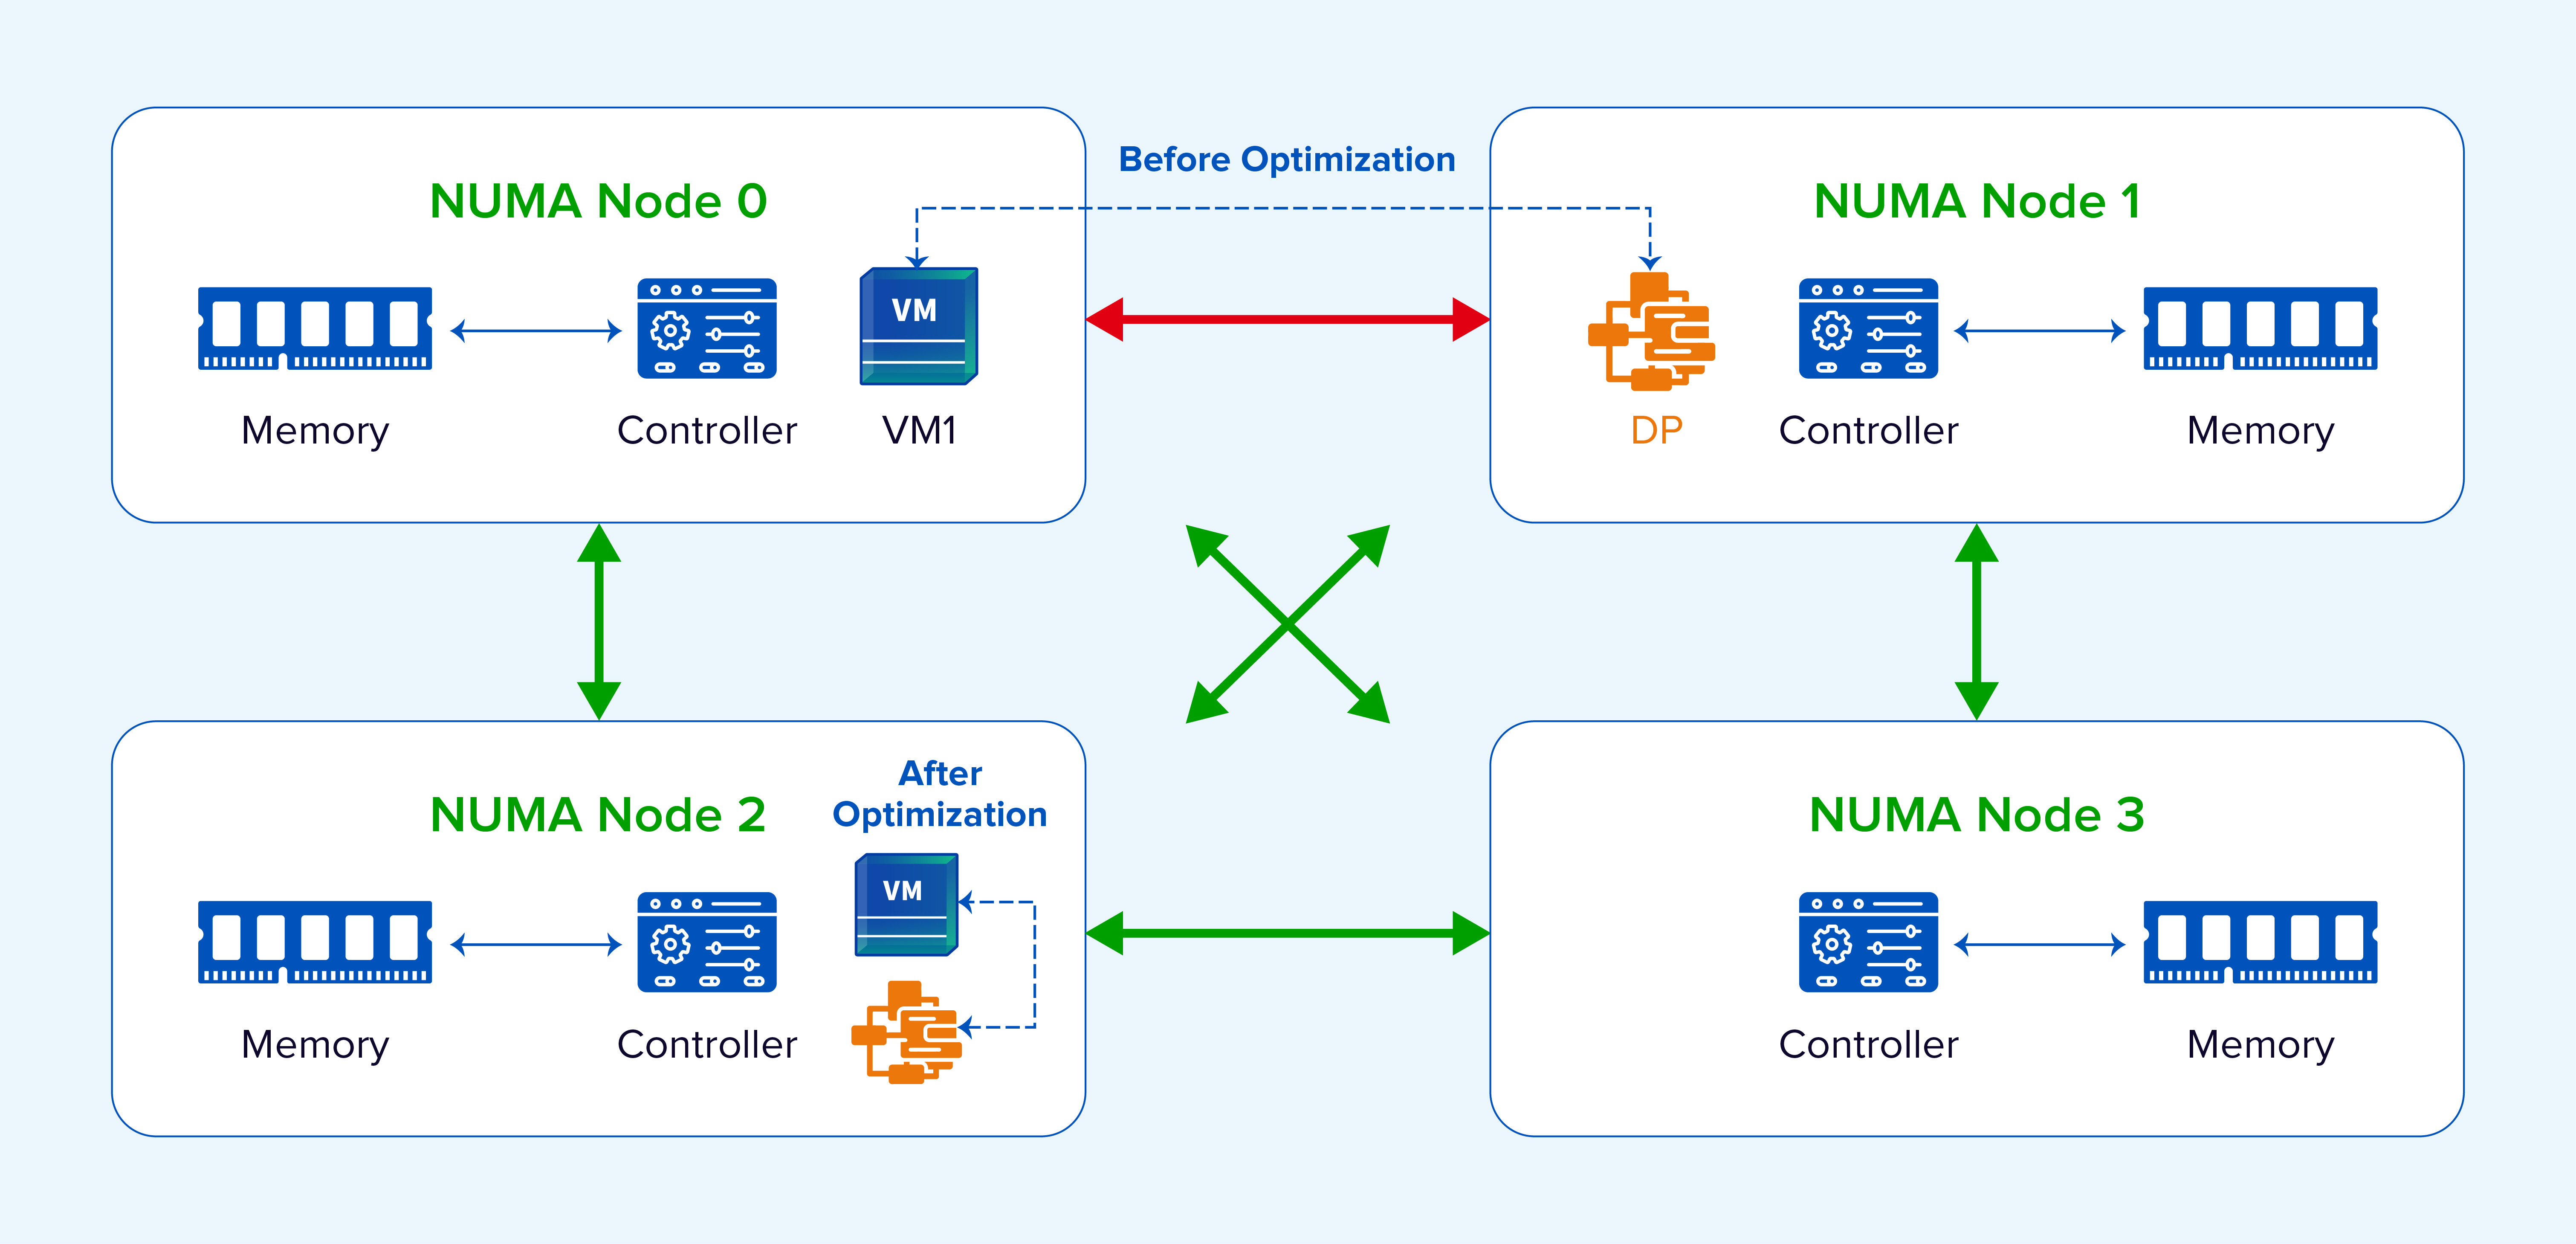
図9. VMとデータプレーンの親和性により、処理がローカルメモリに近い場所で行われる。
ストレージ全体でNUMAのメリットを最大限に引き出すため、SangforはvCPU、QEMU、libnfs、aSAN、および完全なI/Oパスに関わるその他のプロセスを同一のNUMAノードに配置します。これにより、リモートメモリへのアクセスが回避されます。大きなメモリページは、メモリアクセス性能をさらに向上させ、処理オーバーヘッドを削減し、I/Oフロー効率を高めます。
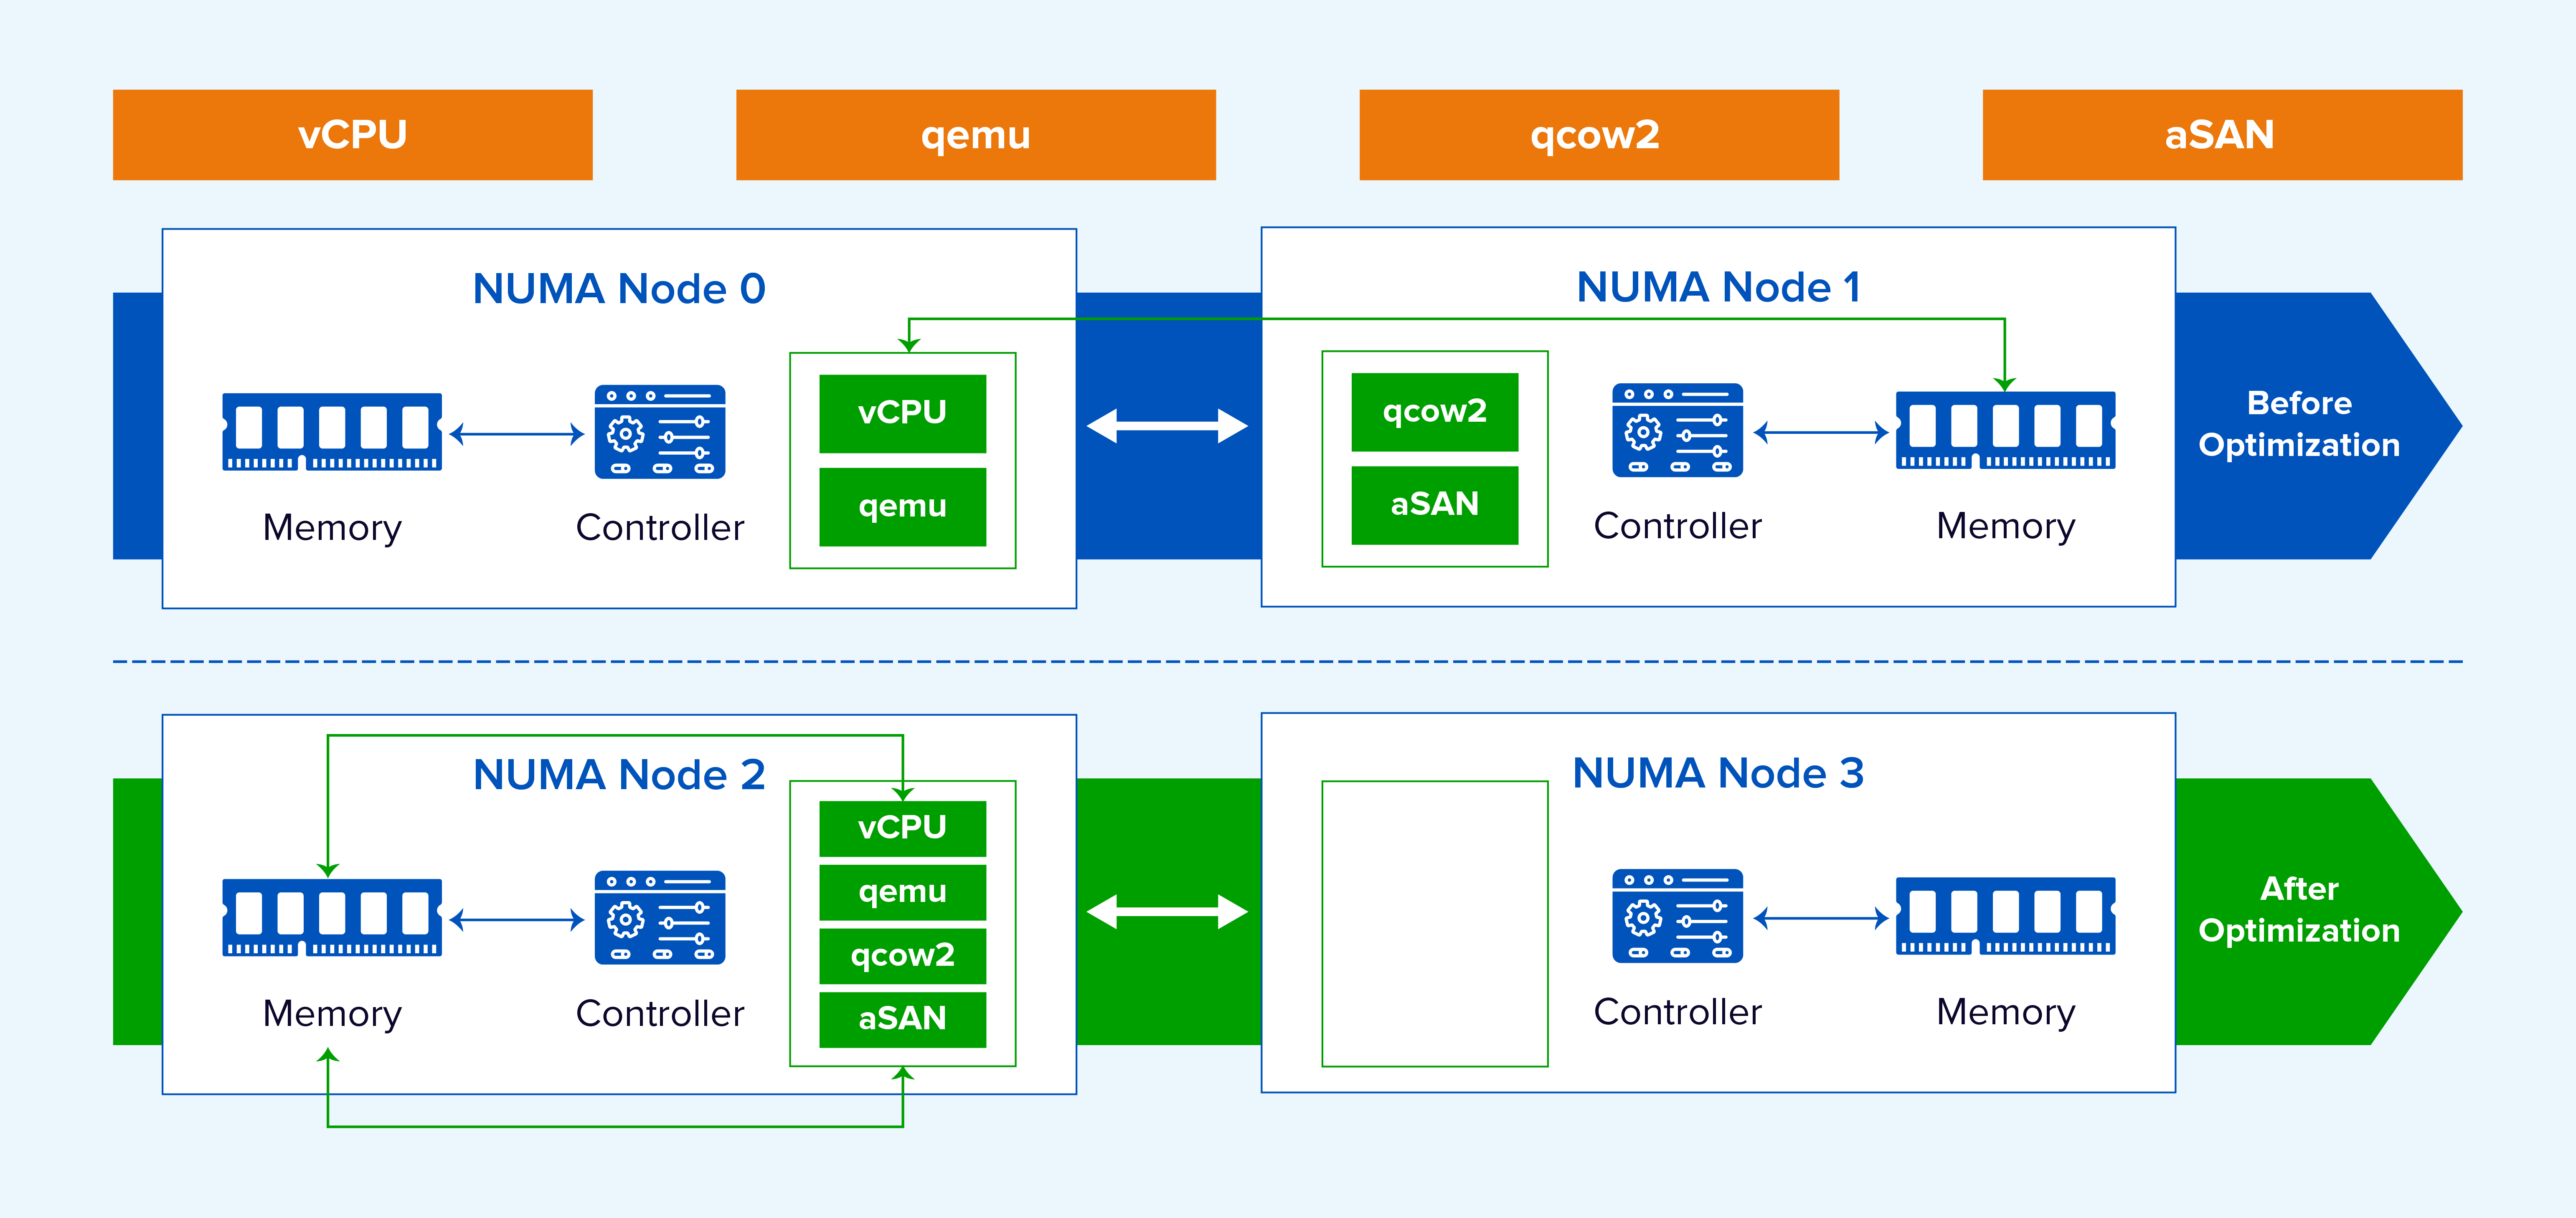
図10.仮想ストレージI/Oパス全体にわたる協調的なNUMA配置。
NICバッファから仮想ストレージへ転送されるデータは、CPUスレッドによって処理される必要があります。ネットワーク性能が向上するにつれて、シングルコアのバッファコピー効率がボトルネックになる可能性があり、さらにNUMA間のアクセスによって効率が低下します。Sangforは、複数のCPUコアでNICトラフィックを処理できるようにし、NUMAアフィニティを適用します。これにより、シングルコアのボトルネックが解消され、転送遅延が短縮され、並列処理性能が向上します。社内テストでは、キュー深度が高く、ブロックサイズが大きいVMへの書き込み性能が20%以上向上しました。
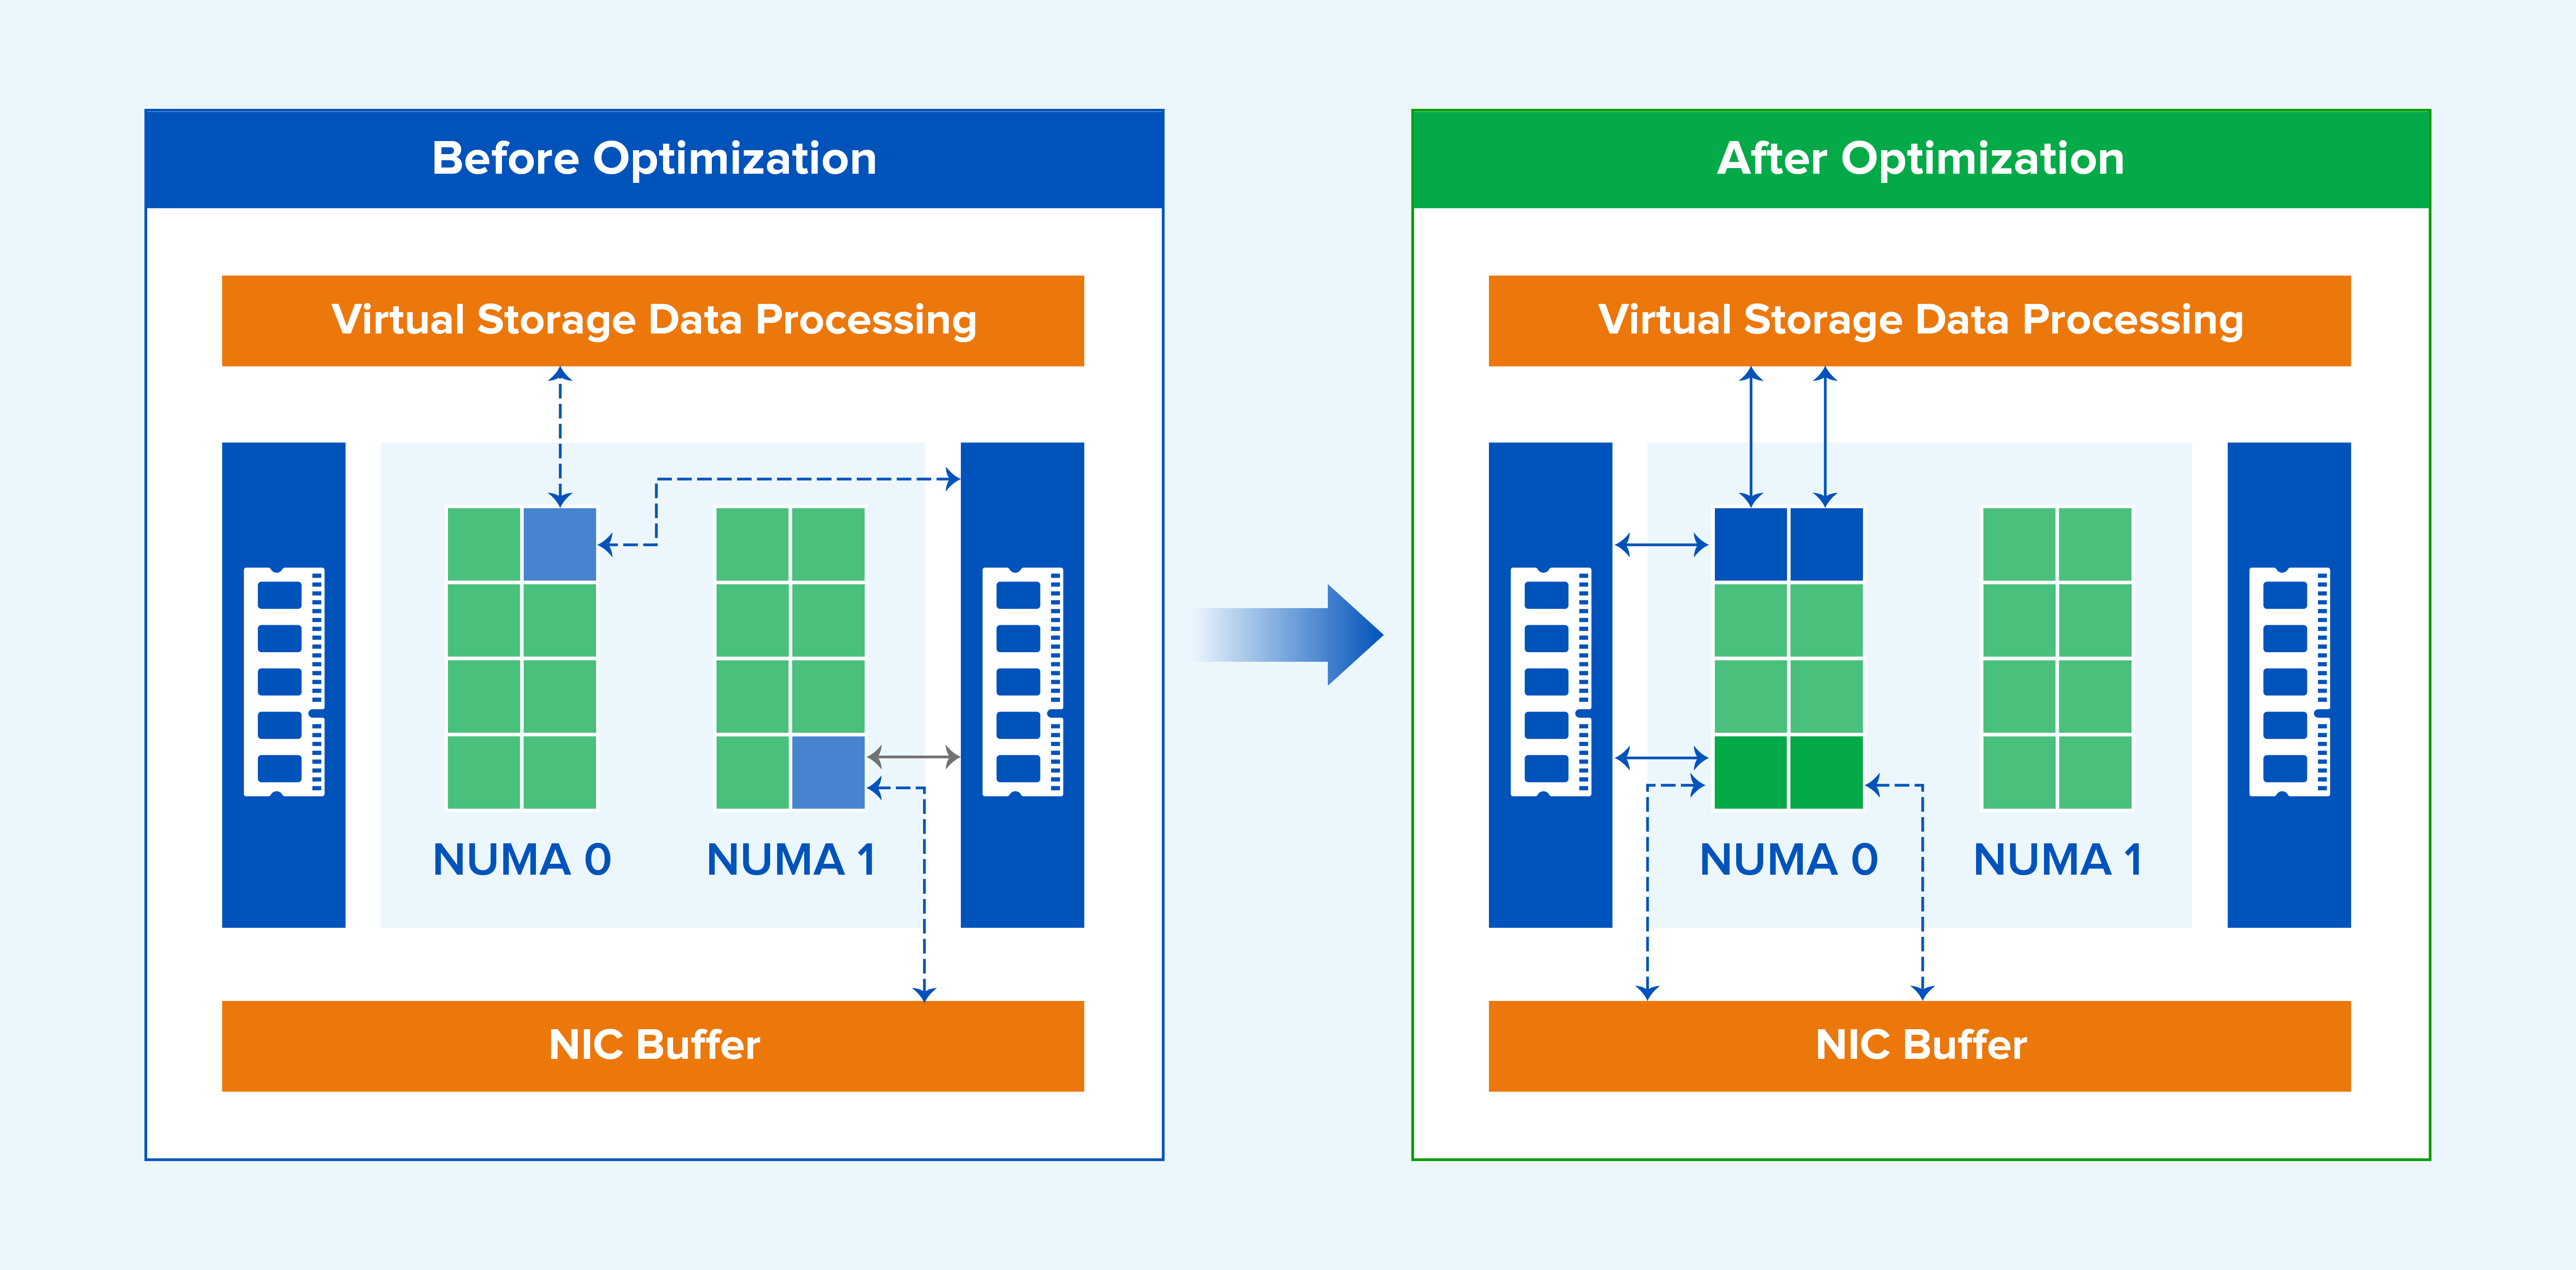
図11. NICバッファと仮想ストレージ間のマルチコア、NUMAアフィン処理。
3.他の業界手法との比較
業界によってサポート状況は異なります。あるベンダーは、各VMのvCPUが実行されるNUMAノードを管理者が構成できるようにしていますが、別のベンダーはこの機能をサポートしておらず、VMwareは適応型NUMAスケジューリングをサポートしています。
Sangforは、リモートメモリへのアクセスを削減するために、VMのvCPUをNUMAノード上に自動的に分割して配置します。各vCPUの場所を手動で設定する場合と比較して、Sangforの適応型NUMAスケジューリングはvCPUの分割と配置を自動化し、ノード間の利用率を均等化し、全体的なパフォーマンスを向上させます。
基本的な適応型NUMA実装と比較して、Sangforはストレージサービススケジューリング、優先度付きVMの認識、異種サーバープラットフォーム、およびVMネットワークアフィニティに最適化を拡張しています。これらの機能強化は、Sangforの研究チームとクラウド製品チームによる共同エンジニアリングの成果であり、実際のプラットフォームサービスの動作に基づいて設計されています。
第5部 要約
Sangforの適応型NUMAスケジューリングは、複数のインフラストラクチャシナリオに合わせて最適化されており、アプリケーションのメモリアクセス効率を向上させます。
- リモートメモリへのアクセスを削減するために、VMのvCPUをNUMAノードに適応的に分割して配置します。
- 仮想マシンをNUMAノード間で移行し、バランスの取れた利用率を維持する。
- 優先度の高い仮想マシンを特定し、競合の少ないノードに配置することで、CPU、メモリ帯域幅、キャッシュの競合を軽減します。
- NUMAノードが多く、ノード間の距離が異なるサーバーの場合、トポロジー上の距離を特定し、関連するvNUMAリソースを近隣の物理NUMAノードに優先的に配置します。
- 転送パフォーマンスを向上させるため、VMをネットワークデータプレーンと同じNUMAノードに配置するVMネットワークアフィニティオプションを提供します。
- NUMA対応スケジューリングを仮想マシンだけでなく、ストレージサービスにも適用する。
UnixBenchのテスト例
UnixBenchは、UNIX、BSD、LinuxなどのUnix系システムで広く使用されているベンチマークツールです。CPU、ファイルシステム、メモリ、プロセス性能など、複数のシステム性能指標を測定します。
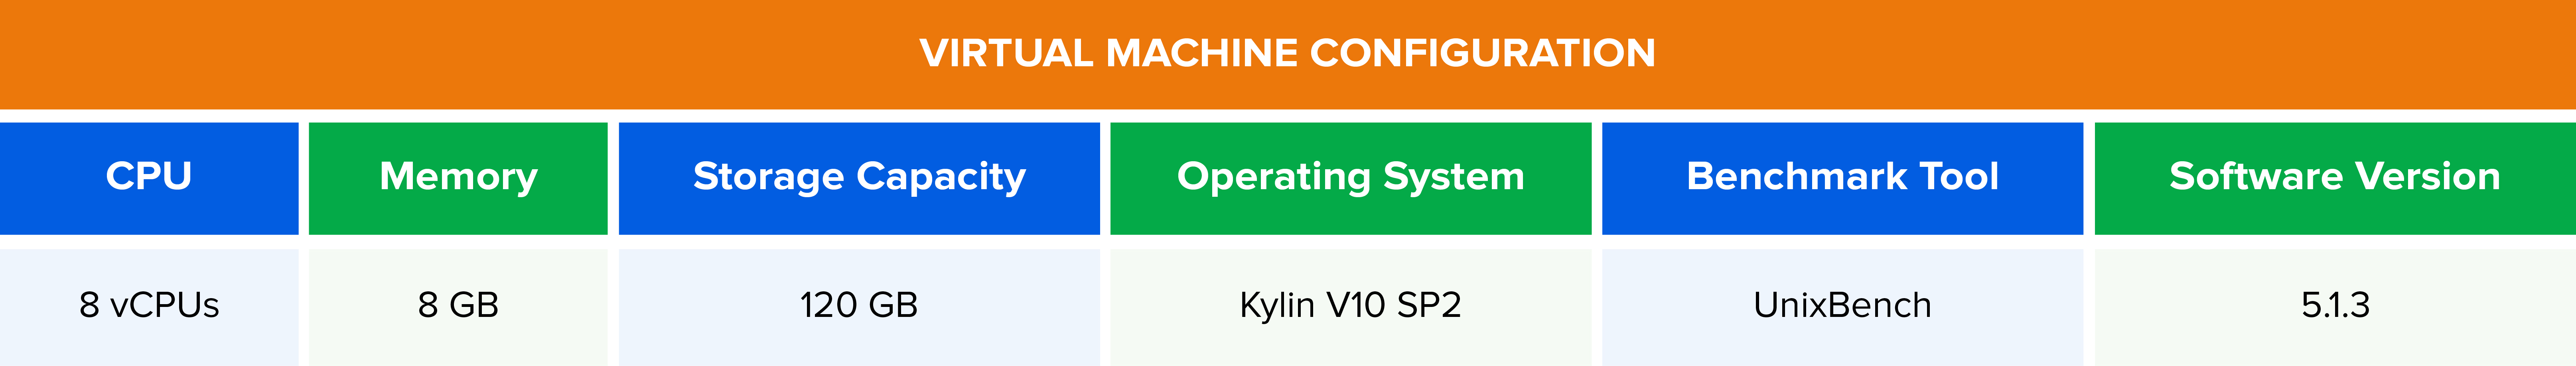
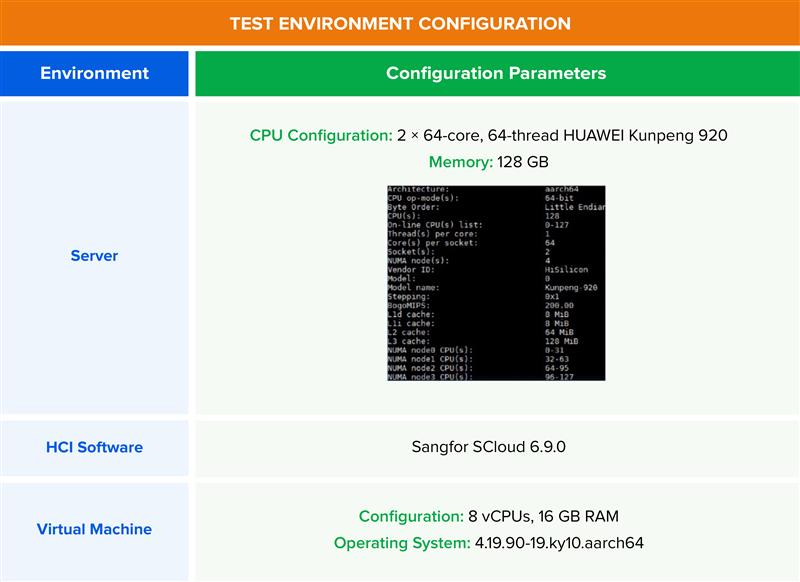
図12.UnixBenchテスト用の仮想マシン構成。
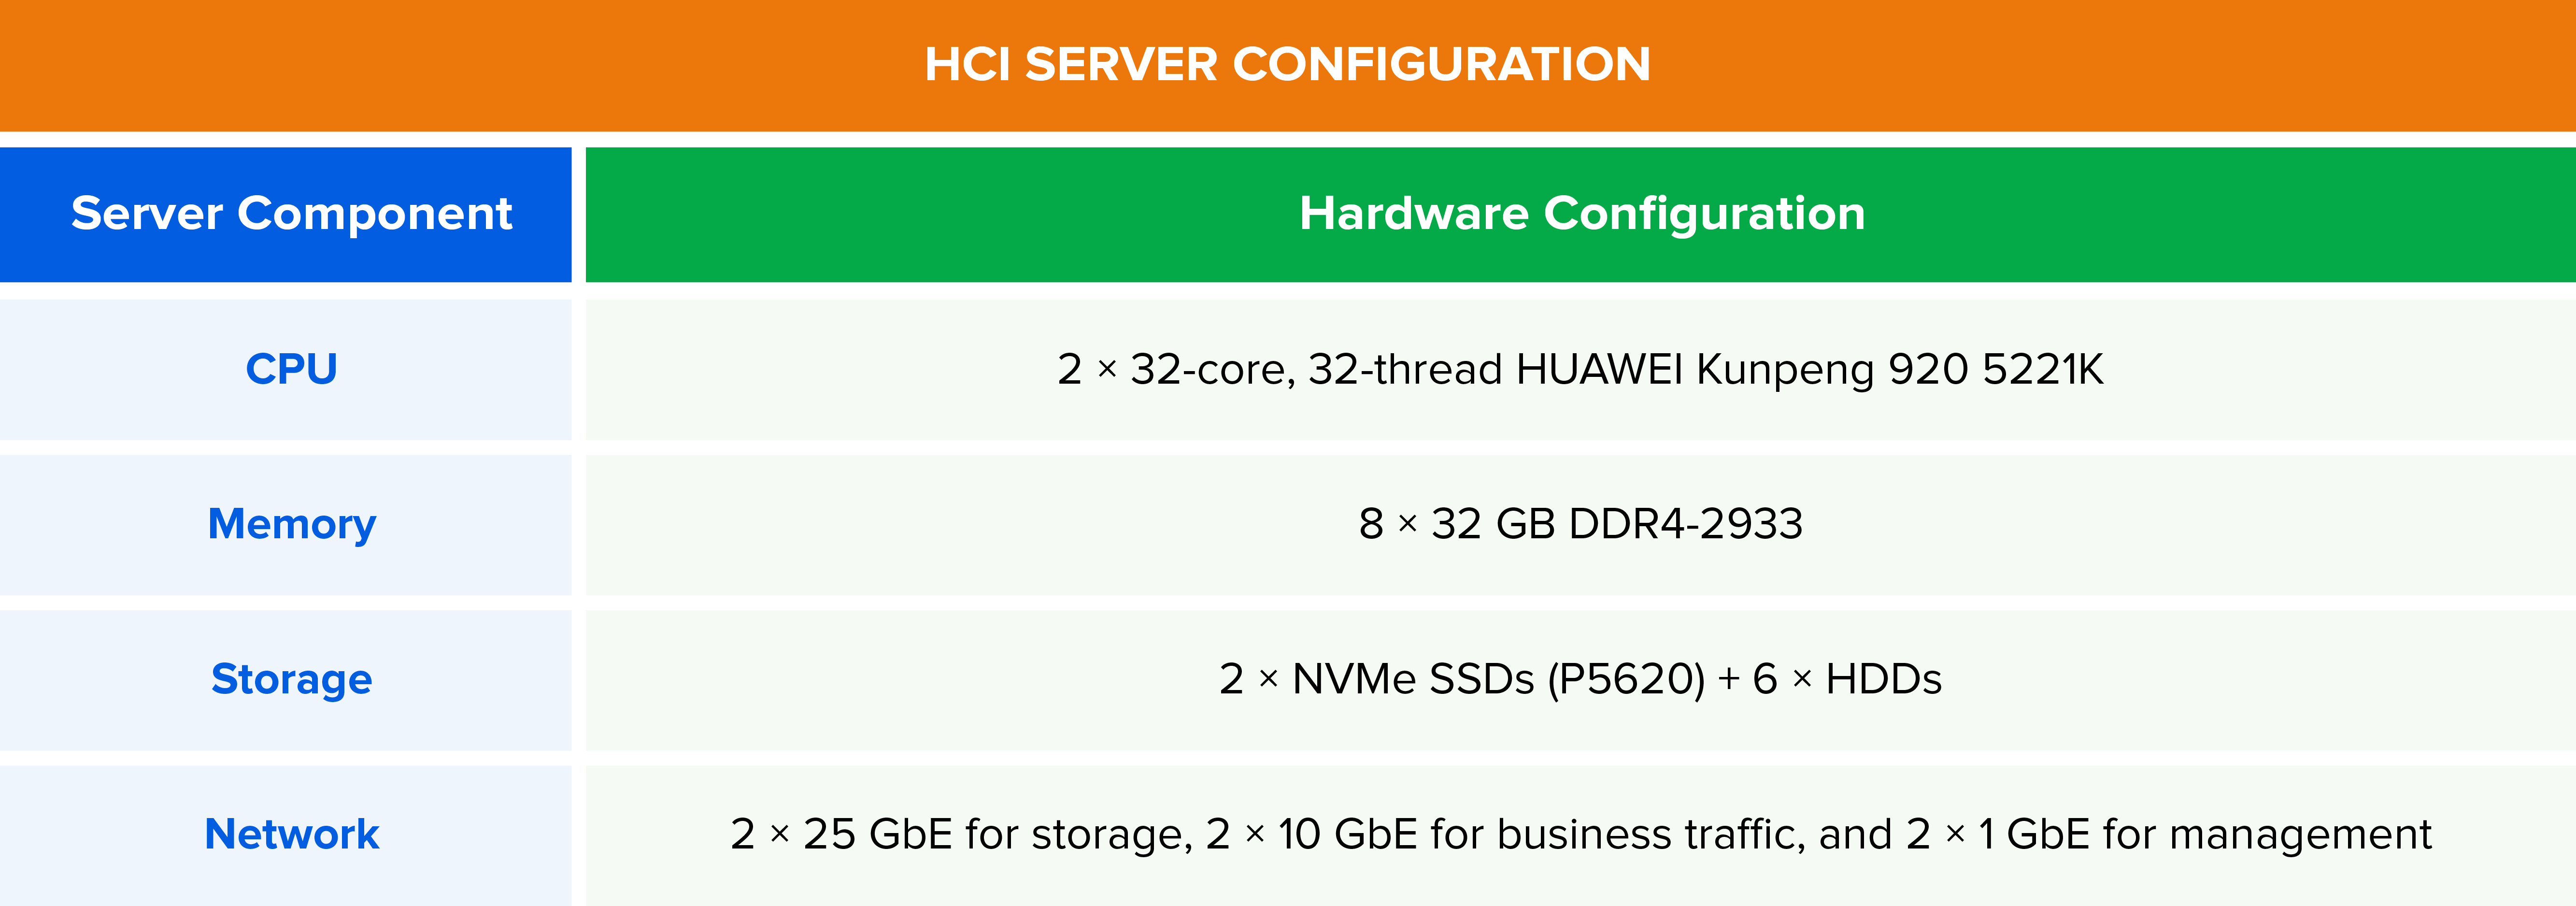
図13.UnixBenchテスト用のHCIサーバーのハードウェア構成。
テスト結果:Sangfor HCI 6.9.0において、NUMAを有効にした場合、同一ホスト上で同時に実行される6台の仮想マシンのUnixBenchスコアは、匿名化された比較プラットフォームよりも20.2%高くなりました。8台の仮想マシンを同時に実行した場合、スコアは34.17%高くなりました。
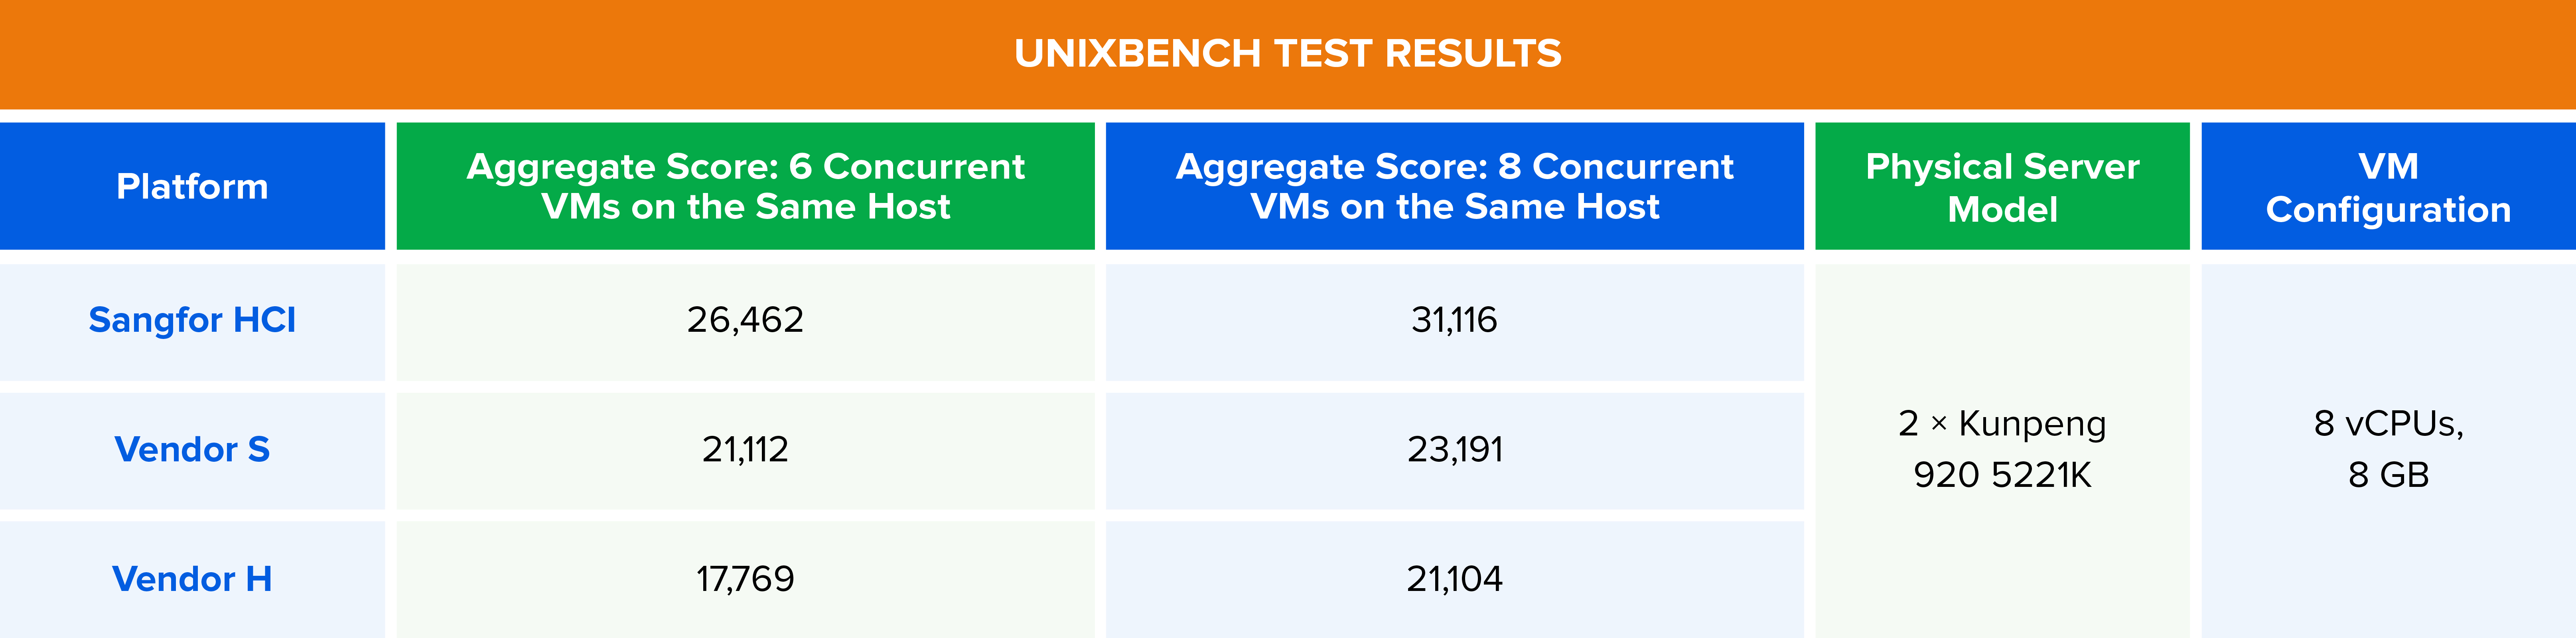
図14.同時実行仮想マシンワークロードにおけるUnixBenchベンチマーク結果の比較。
本記事におけるベンチマーク結果は、Sangfor社内の特定のテスト環境を反映したものであり、技術的な説明のために提供されています。実際の結果は、ハードウェア、ソフトウェアのバージョン、構成、ワークロードによって異なります。お客様は、代表的なアプリケーションを自社のサービスレベル目標に照らし合わせて検証する必要があります。

