
Daha fazla kuruluş, iş açısından kritik iş yüklerini sanallaştırılmış, hiper birleşik ve bulut altyapısına taşıdıkça, yüksek eşzamanlılık altında performans en önemli öncelik haline geldi. VMware'in yerine geçecek bir platformu değerlendiren ekipler için soru, başka bir platformun benzer işlevsellik sağlayıp sağlayamayacağı değil, temel iş sistemlerinin gerektirdiği gecikme süresini, veri aktarım hızını ve istikrarı sürdürüp sürdüremeyeceğidir.
Bu zorluk, özellikle yüksek frekanslı işlemler ve finansal hizmetlerde risk yönetimi, sağlık sektöründe elektronik sağlık kayıt sistemleri ve lojistikte depo yönetim sistemleri gibi bellek yoğun uygulamalarda belirgindir. Artan bellek erişim gereksinimleri, Redis, Apache Spark, SAP HANA ve yapay zeka motorları veya modelleri gibi arka uç bileşenleriyle yakından ilişkilidir. Örneğin Redis, performansı doğrudan bellek erişim hızından etkilenen bellek içi bir veritabanıdır.
NUMA artık yaygın bir sunucu CPU mimarisi haline geldi. Bu nedenle, NUMA altında bellek erişim verimliliğini artırmak, sanallaştırma performans optimizasyonunun önemli bir yönüdür. Bu makale, Sangfor NUMA optimizasyon teknolojilerini ve bunların sanallaştırma platformlarının VMware değişimi sırasında yüksek eşzamanlı, iş açısından kritik iş yüklerini desteklemesine nasıl yardımcı olduğunu açıklamaktadır.
BÖLÜM 1. NUMA Mimarlık Arka Planı
İlk bilgisayar sistemleri genellikle tüm hesaplama görevleri için tek bir işlemci kullanıyordu. Uygulamalar daha karmaşık ve talepkar hale geldikçe, tek bir işlemci artık yüksek performanslı hesaplama gereksinimlerini karşılayamaz hale geldi ve sistemler kademeli olarak çok çekirdekli mimarilere doğru evrildi.
Geleneksel çok çekirdekli sistemler genellikle simetrik çoklu işlem (SMP) kullanırdı. SMP altında, tüm işlemciler eşit statüye ve belleğe aynı erişim haklarına sahiptir. Herhangi bir iş parçacığı herhangi bir işlemcide çalışabilir, bu da etkili yük dengelemesini sağlar ve genel performansı ve verimliliği artırır. Bununla birlikte, birden fazla çekirdek belleğe erişmek için aynı veri yolunu paylaştığından, çekirdek sayısı arttıkça veri yolu darboğaz haline gelebilir, bu da ölçeklenebilirliği ve performansı sınırlar.
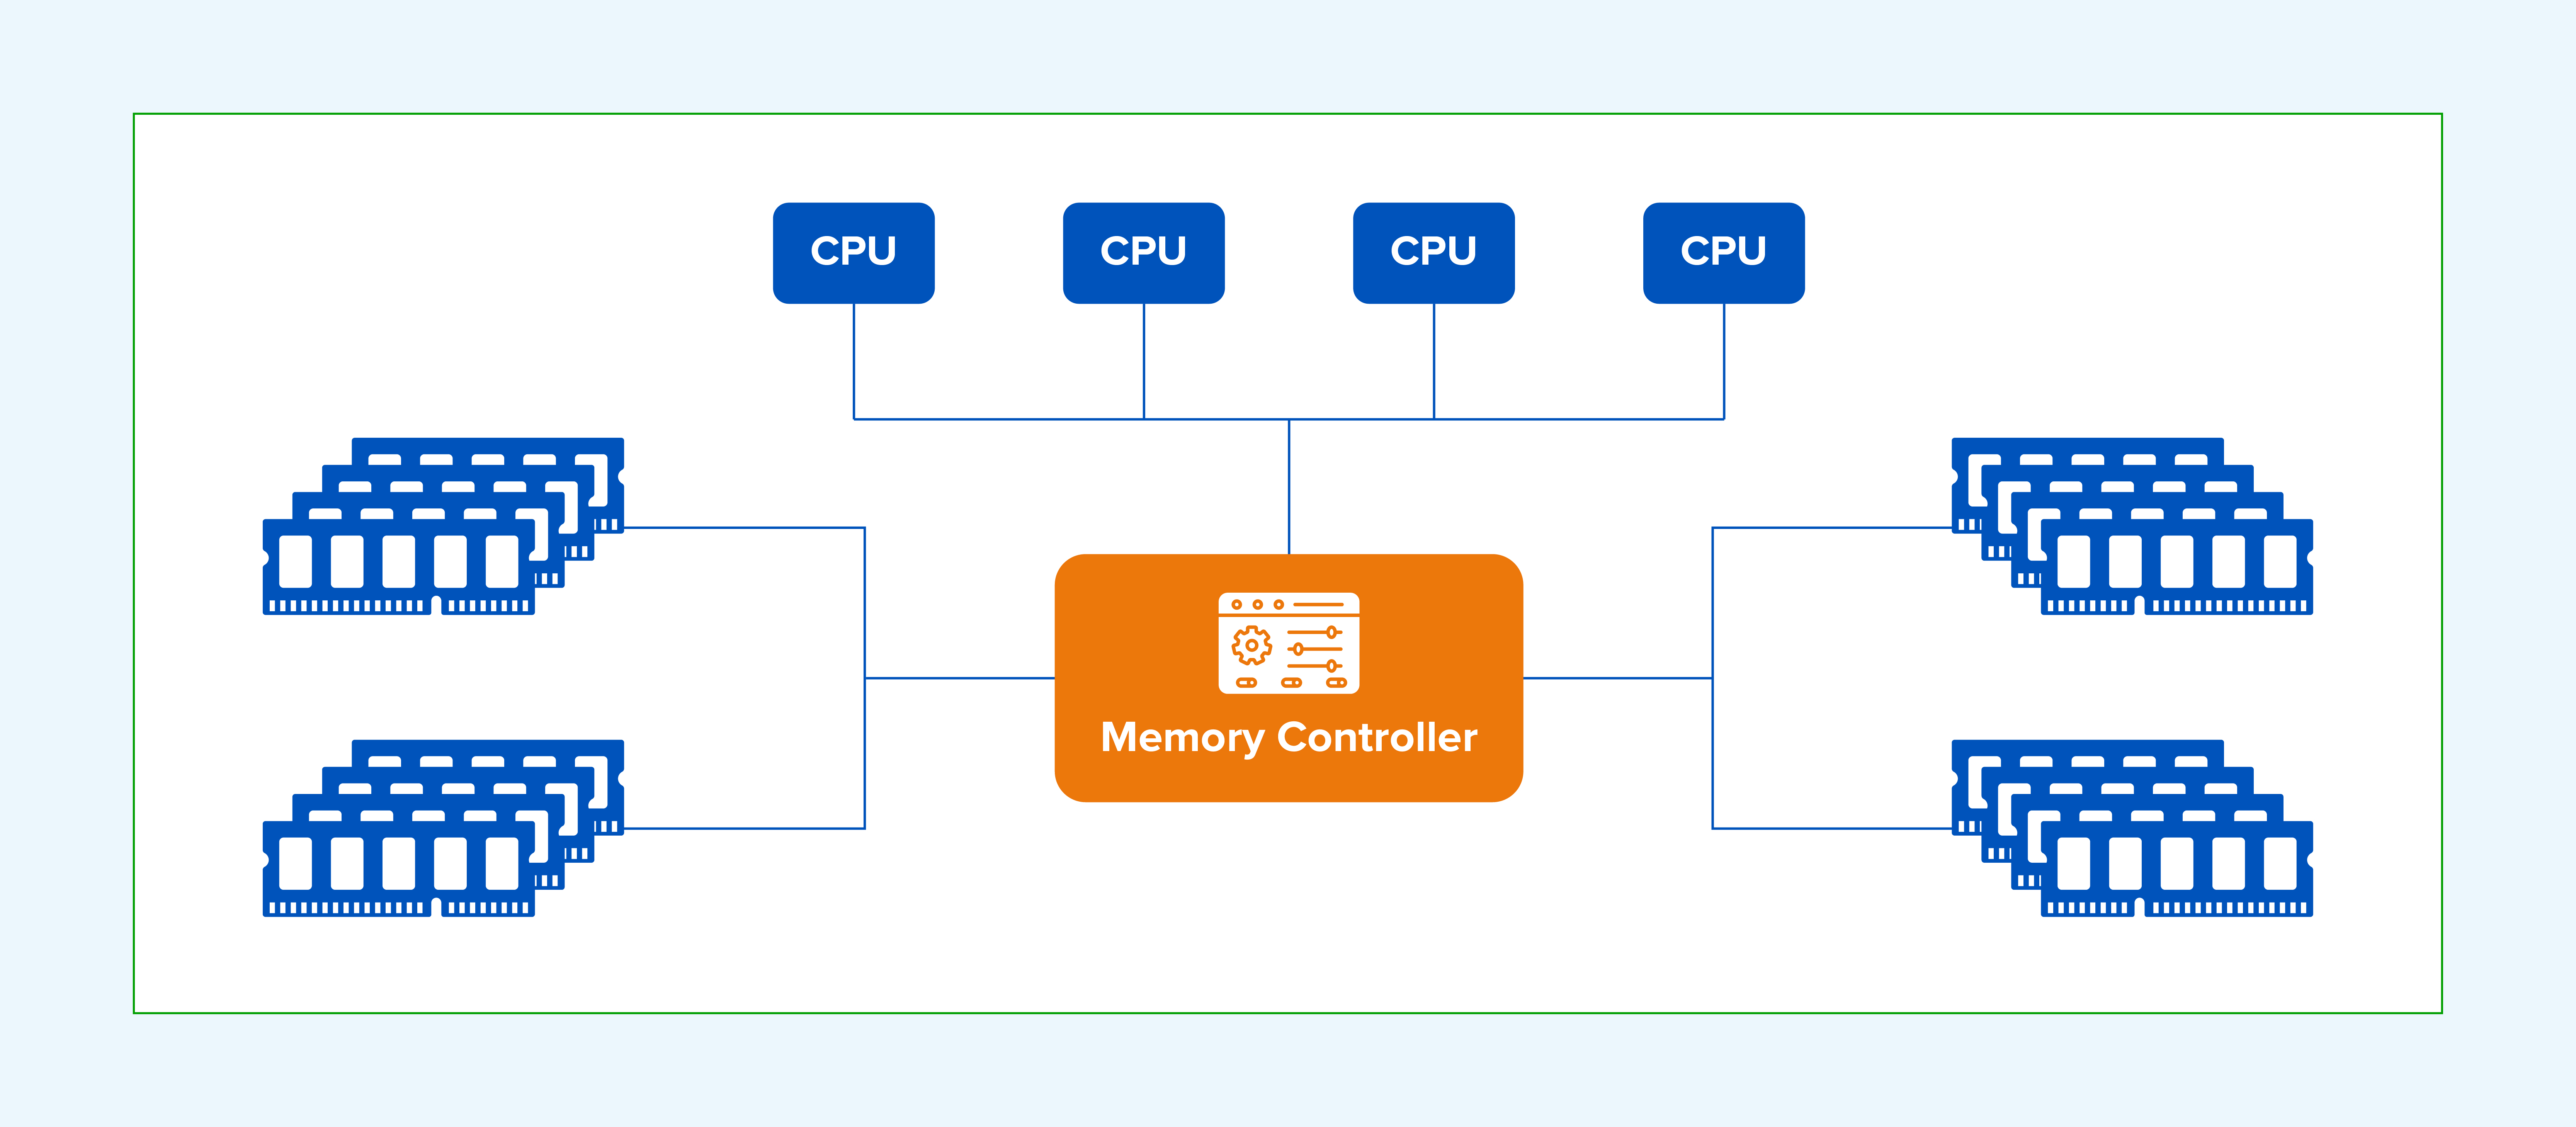
Şekil 1: Geleneksel SMP mimarilerinde paylaşımlı veri yolu bellek erişiminde yaşanan darboğaz.
NUMA, SMP'nin bellek erişim darboğazını ele alır. Bir NUMA mimarisinde, sistem birden fazla düğüme bölünür ve her düğüm bir veya daha fazla işlemci, yerel bellek ve G/Ç aygıtı içerir. Düğümler, AMD HyperTransport veya Intel QuickPath Interconnect (QPI) gibi yüksek hızlı ara bağlantılar üzerinden iletişim kurar; bu da işlemcilerin önce yerel belleğe erişmesine olanak tanır, böylece bellek erişim gecikmesi azalır ve çok işlemcili sistem performansı artar.
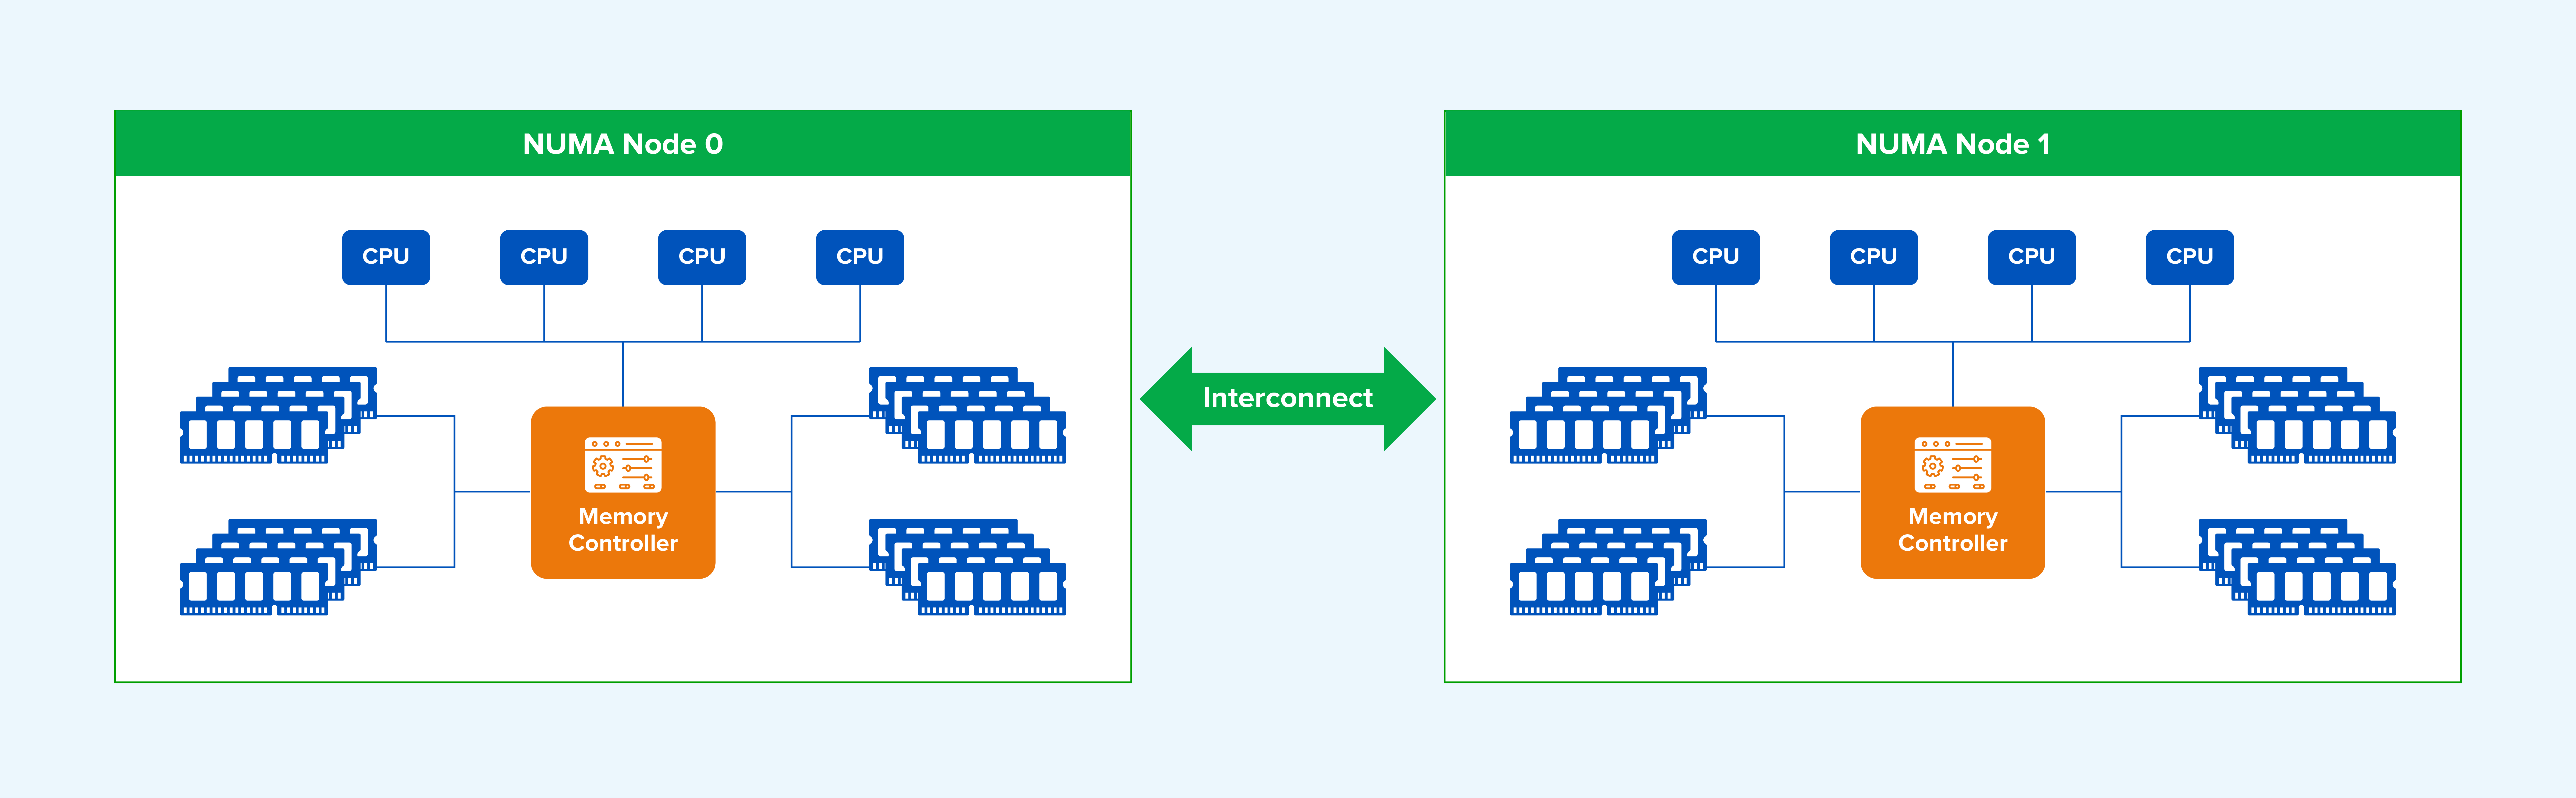
Şekil 2: Düğüm bazlı CPU ve bellek tahsislerini içeren çok düğümlü NUMA mimarisi.
Bir NUMA sistemi üç düğüm türü içerir:
- Yerel düğüm: Belirli bir düğüm içindeki işlemciler için, o düğüm yerel düğümdür.
- Komşu düğüm: Yerel düğüme bitişik olan düğüm.
- Uzak düğüm: Ne yerel ne de komşu olmayan bir düğüm.
CPU erişim hızı, düğüm türüne göre farklılık gösterir. Yerel belleğe erişim en hızlı, uzak belleğe erişim ise en yavaştır. Genel olarak, topolojik mesafe arttıkça bellek erişimi yavaşlar.
Dr. Christoph Lameter, “NUMA: Genel Bakış” adlı çalışmasında, 2013 yılında yüksek performanslı iki düğümlü bir sunucuda rastgele yerel bellek erişim gecikmesinin yaklaşık 100 ns olduğunu, uzak bellek erişiminin ise yaklaşık %50 daha fazla gecikmeye neden olduğunu belirtmiştir.
BÖLÜM 2. NUMA'nın Getirdiği Zorluklar
Linux'ta, iş parçacığı (thread), CPU zamanlamasının temel birimidir ve bir CPU çalışma kuyruğundaki bir göreve karşılık gelir. Çekirdek, her görev için nispeten boşta olan bir CPU seçer. CPU yükü dinamik olarak değiştiği için, çekirdek görevleri daha az meşgul olan CPU'lara taşımak için yük dengelemesi kullanır. Varsayılan olarak, bir görev bu nedenle CPU'lar arasında hareket edebilir.
NUMA mimarisi altında, bir görev, 1. Düğümdeki bir CPU'dan 2. Düğümdeki bir CPU'ya geçerken, 1. Düğümde ayrılan belleğe erişmeye devam edebilir; bu da düğümler arası erişime neden olur. Linux NUMA dengelemesi, görevleri veya bellek sayfalarını periyodik olarak yerel düğüme doğru taşır, ancak tüm uzaktan bellek erişimini ortadan kaldıramaz.
Sanallaştırılmış bir ortamda, her sanal makine (VM) sanal işlemcisi (vCPU), ana işletim sisteminin bir iş parçacığına karşılık gelir. Birden fazla vCPU iş parçacığı, belleği paylaşırken farklı NUMA düğümlerinde çalışıyorsa veya düğümler arasında geçiş yapıyorsa, sanal makine NUMA düğümleri genelinde belleğe erişebilir ve daha yüksek gecikme yaşayabilir.
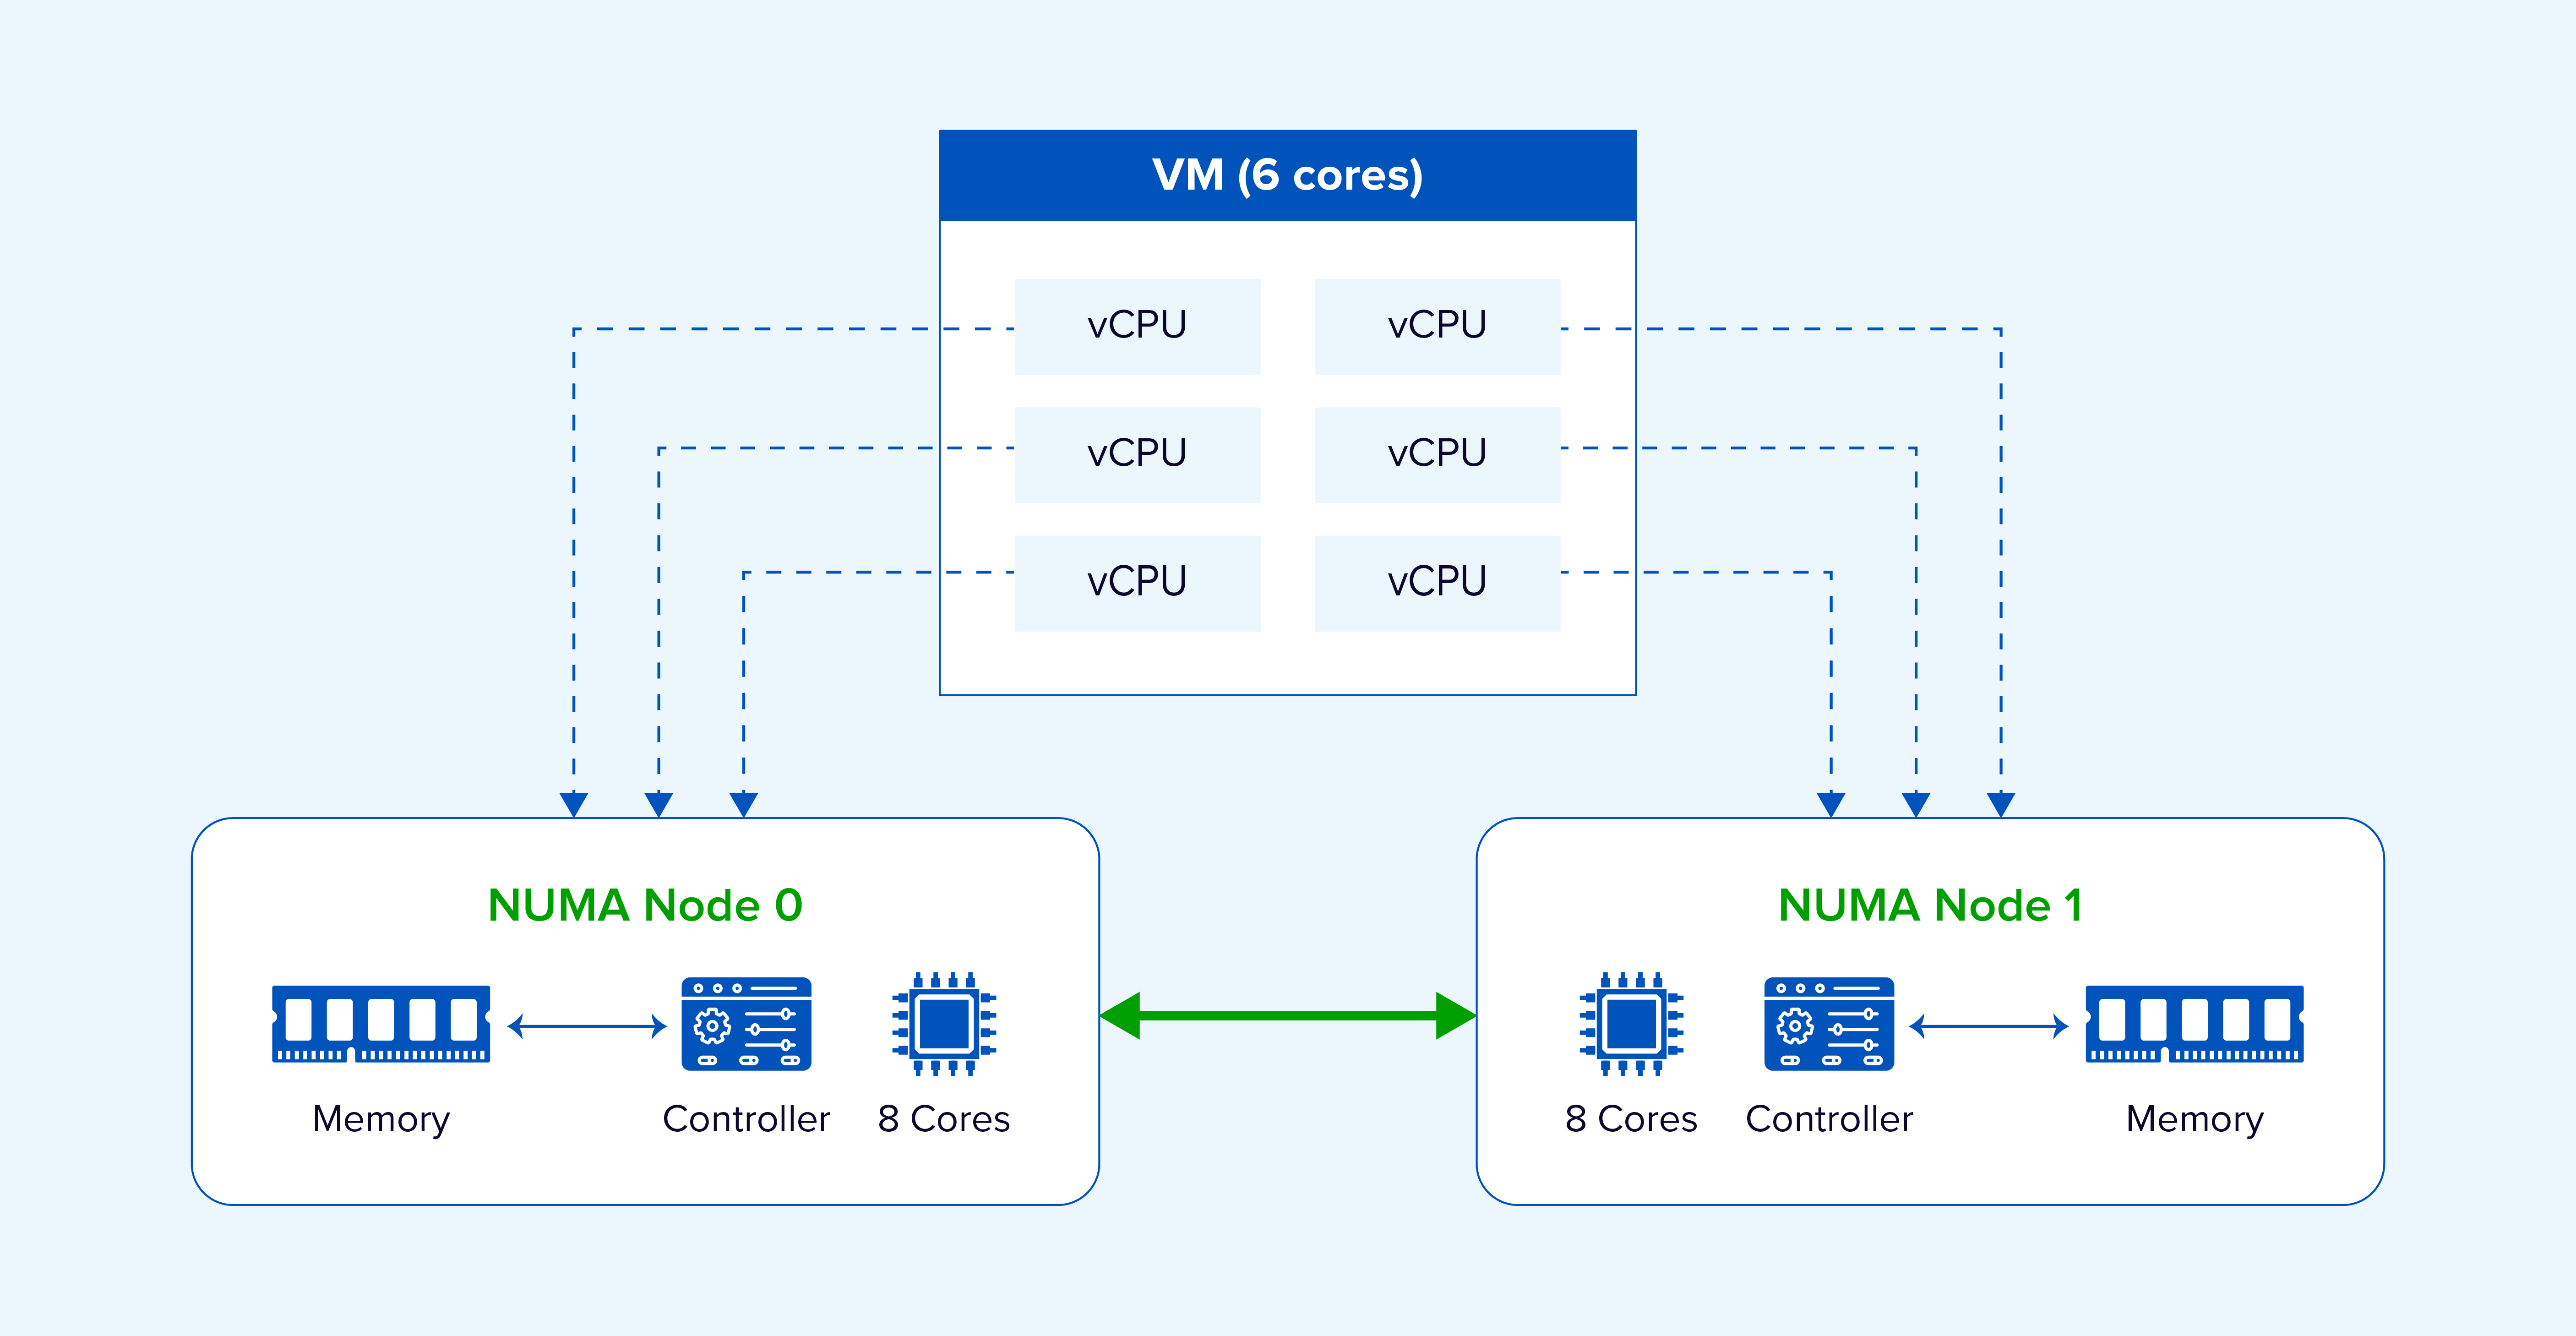
Şekil 3: Düğümler arası yürütme, sanal makine için uzaktan bellek erişimini artırabilir.
BÖLÜM 3. Yaygın NUMA Planlama Yaklaşımları
Sektörde yaygın olarak kullanılan yaklaşımlar şunlardır:
Yaklaşım 1: Sanal CPU'ları Fiziksel Çekirdeklere Sabitleme
Yöneticiler, sanal makine kaynaklarının öncelikli olarak aynı fiziksel NUMA düğümü içinde çalışması için vCPU sabitlemesini manuel olarak yapılandırır.
Yaklaşım 2: Bir Sanal Makineye Atanan NUMA Düğümlerinin Sayısını Belirtin
Yöneticiler, NUMA düğümlerinin sayısını manuel olarak yapılandırır ve vCPU ile bellek kaynaklarını bunlar arasında eşit olarak dağıtır.
Yaklaşım 3: NUMA Düğümlerini Uyarlanabilir Şekilde Tahsis Etme
Zamanlayıcı, uygun NUMA düğümlerini otomatik olarak bir sanal makineye atar. Sanal makine işlemcileri bu düğümlere atanır ve yerelliği artırmak için öncelikli olarak yerel belleği kullanır. Sanal makinenin tek bir NUMA düğümünün barındırabileceğinden daha fazla sanal işlemcisi varsa, bu işlemciler birden fazla düğüme dağıtılır. NUMA topolojisi, topolojiye duyarlı kararlar için konuk işletim sistemine gösterilebilirken, yük dengesini korumak için sanal makineler düğümler arasında taşınabilir.
1. ve 2. yaklaşımlar daha fazla kısıtlama getirir, dikkatli sanal makine CPU boyutlandırması gerektirir ve statik bağlama nedeniyle NUMA düğümleri arasında dengesizlik yaratabilir. Bu nedenle, uyarlanabilir tahsis, dinamik üretim ortamları için daha pratiktir.
BÖLÜM 4. Ayrıntılı Olarak Sangfor NUMA Planlaması
Sangfor HCI öncelikle uyarlanabilir NUMA zamanlaması kullanır. Bu, NUMA düğümleri arasında kullanımı dengeleyerek sanal makine vCPU'larının uzaktan bellek erişimini azaltır ve genel performansı artırır.
Uyarlanabilir NUMA zamanlaması, özellikle sık bellek içi işlemler gerçekleştiren ara yazılımlar olmak üzere, farklı uygulama türlerinde belirgin optimizasyon avantajları sunar. Sangfor, DM8, Redis ve Memcached'i sanal makinelerde dağıttı ve NUMA zamanlaması etkinleştirilmiş ve devre dışı bırakılmış haldeyken performanslarını test etti. Sonuçlar, NUMA zamanlaması etkinleştirildiğinde ara yazılım performansında belirgin iyileşmeler olduğunu gösterdi.
Veritabanı İş Yükleri: BenchmarkSQL ile Dameng DB (DM8)
BenchmarkSQL, yeni siparişler, ödemeler, sipariş durumu sorguları, teslimat ve stok seviyesi sorguları da dahil olmak üzere TPC-C tarzı bir işlem karışımı çalıştıran ilişkisel bir veritabanı performans testidir. Elde edilen tpmC metriği, dakikada işlenen yeni sipariş işlemlerinin sayısını temsil eder ve daha yüksek bir değer daha iyi performansı gösterir. DM8 veritabanını test etmek için BenchmarkSQL 5.0 kullanılmıştır. Aşağıdaki grafik, NUMA devre dışı bırakılmış tpmC sonucunun %100'e normalize edilmesiyle elde edilen göreceli performansı göstermektedir.
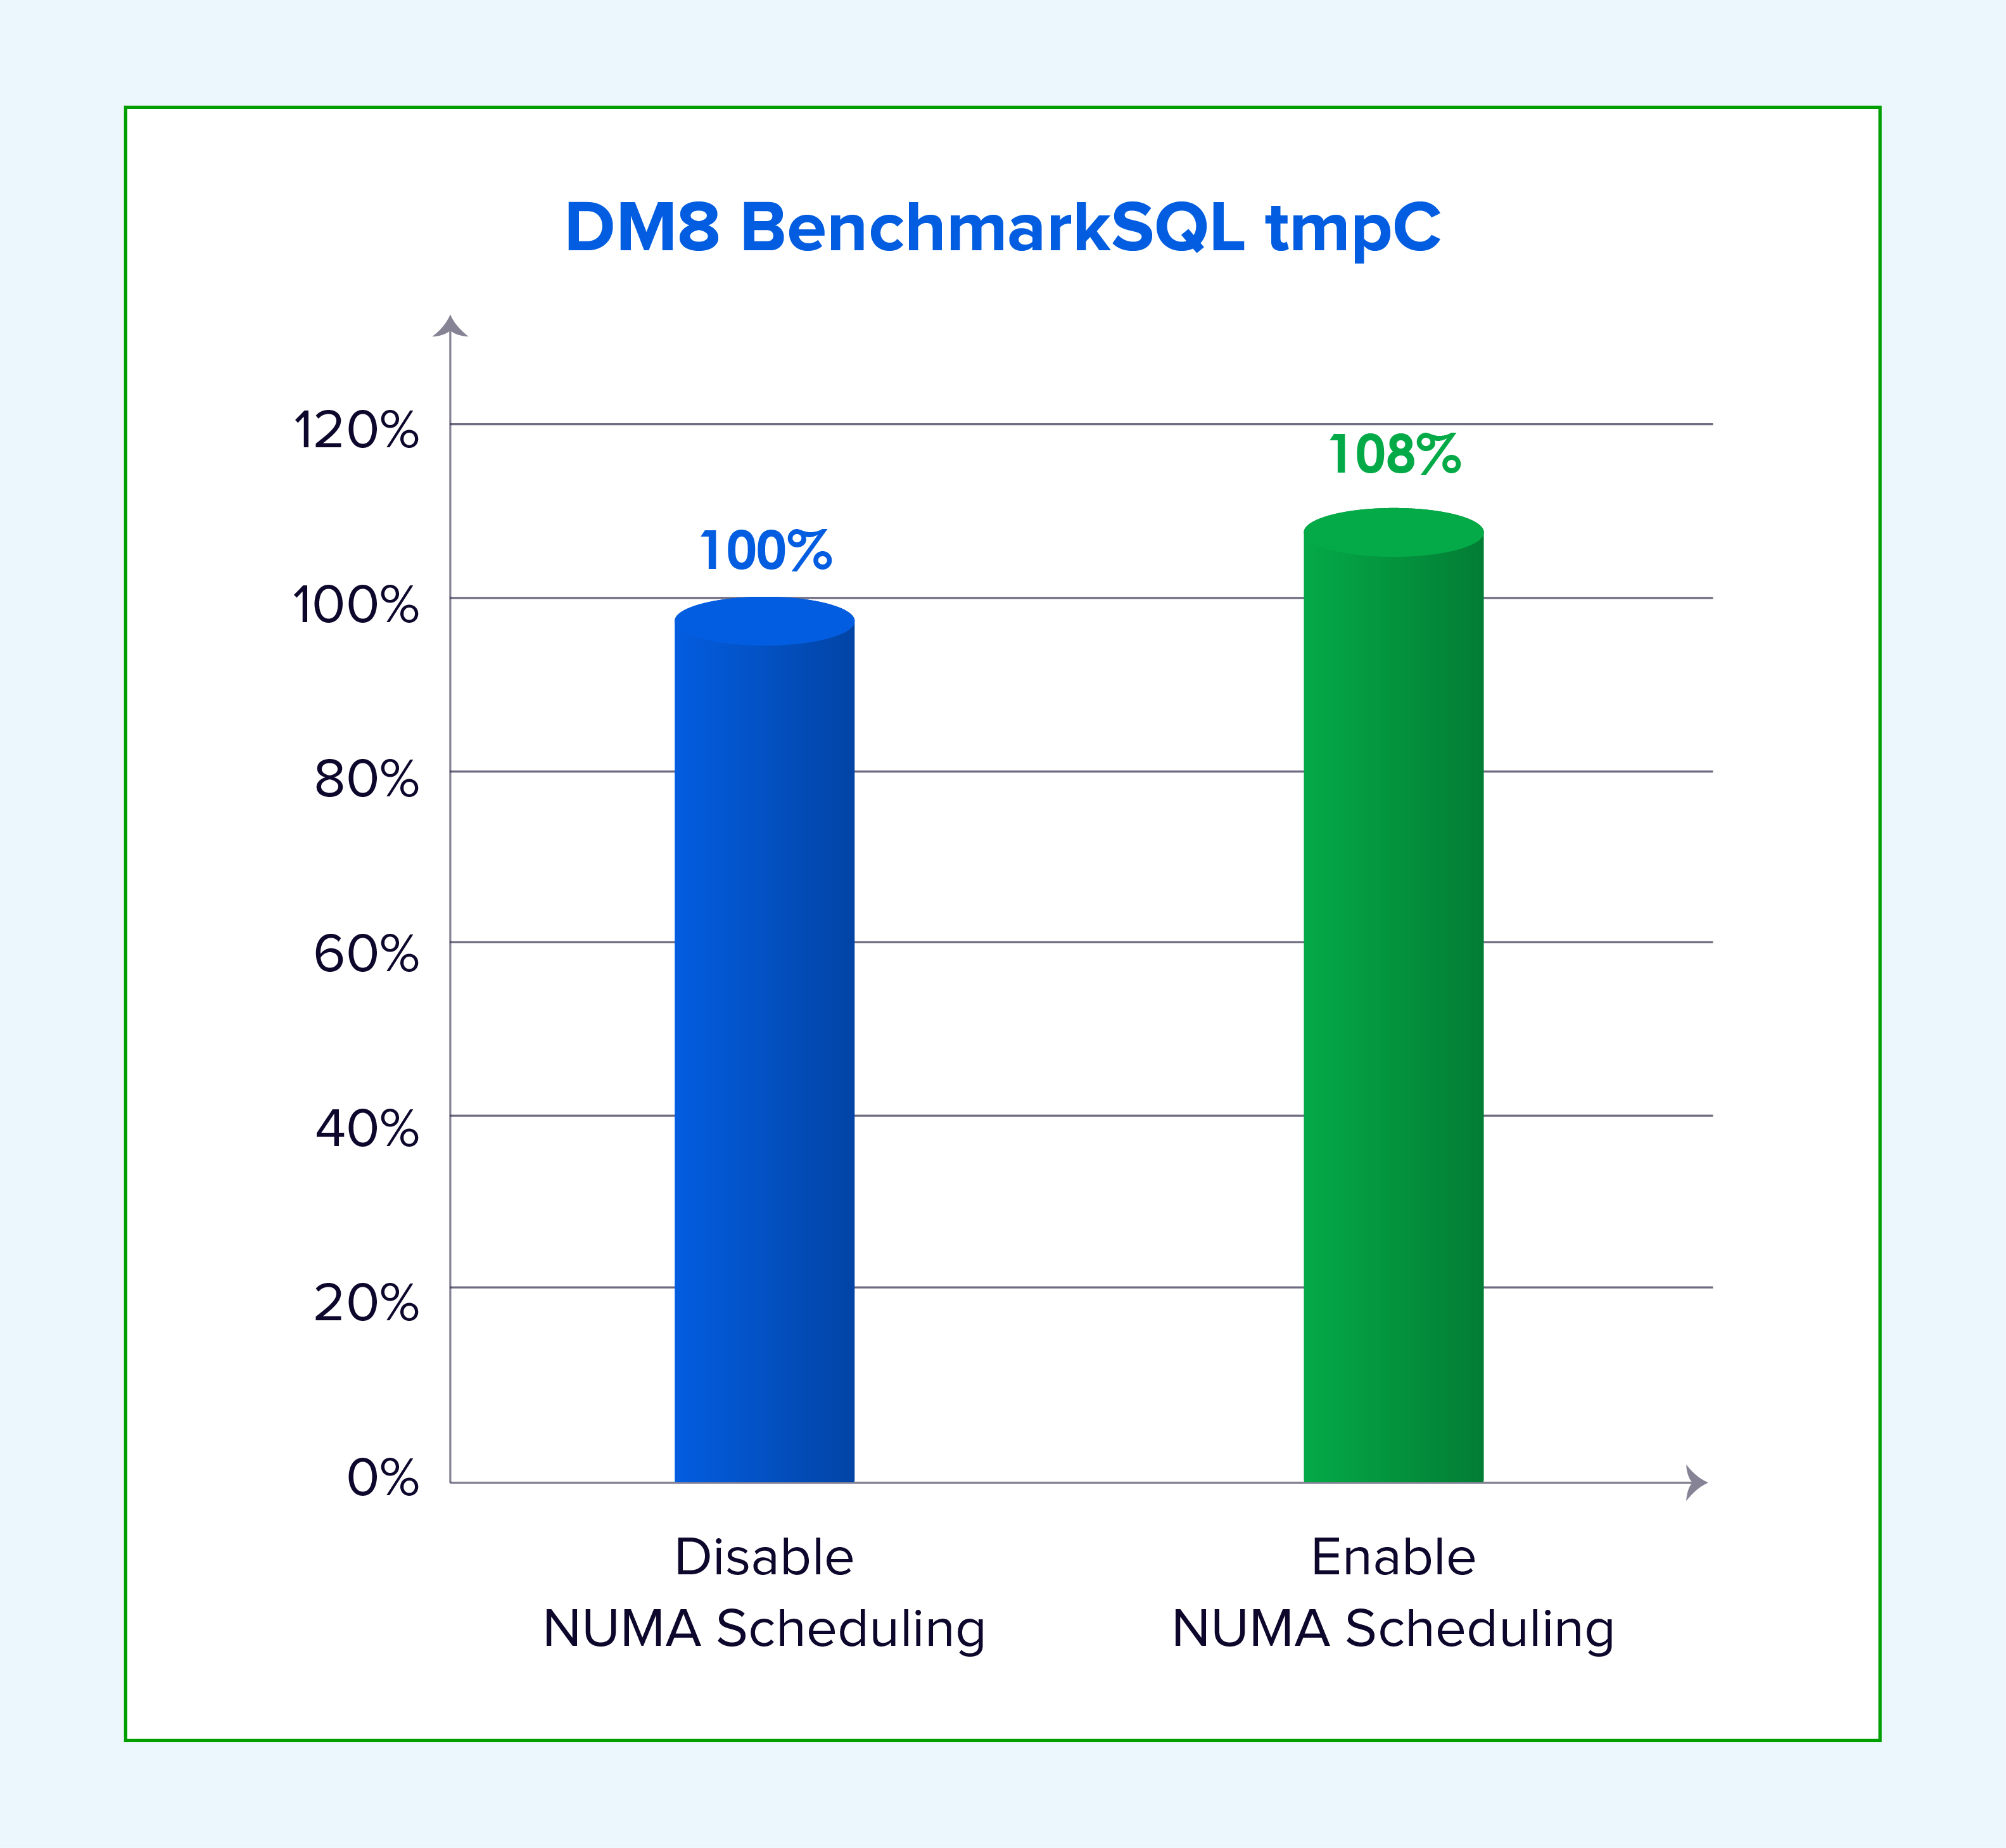
Şekil 4: NUMA zamanlaması etkinleştirildiğinde ve devre dışı bırakıldığında DM8 işlem hızının göreli gösterimi.
Bellek İçi Önbellekleme: Redis 7.2.5
redis-benchmark, resmi Redis performans test aracıdır. Sangfor, NUMA zamanlaması devre dışı bırakılmış ve etkinleştirilmiş haldeyken 1 KB'lık değerler için GET ve SET QPS'yi test etmek için bu aracı kullandı. QPS, saniyedeki okuma veya yazma işlemi sayısını temsil eder.
redis-benchmark -t get -d 16 -c 100 -n 6000000 -r 60000000
redis-benchmark -t set -d 16 -c 100 -n 6000000 -r 60000000
Aşağıdaki grafik, NUMA devre dışı bırakılmış QPS sonucunun %100'e normalize edilmesiyle elde edilen göreceli performansı göstermektedir.
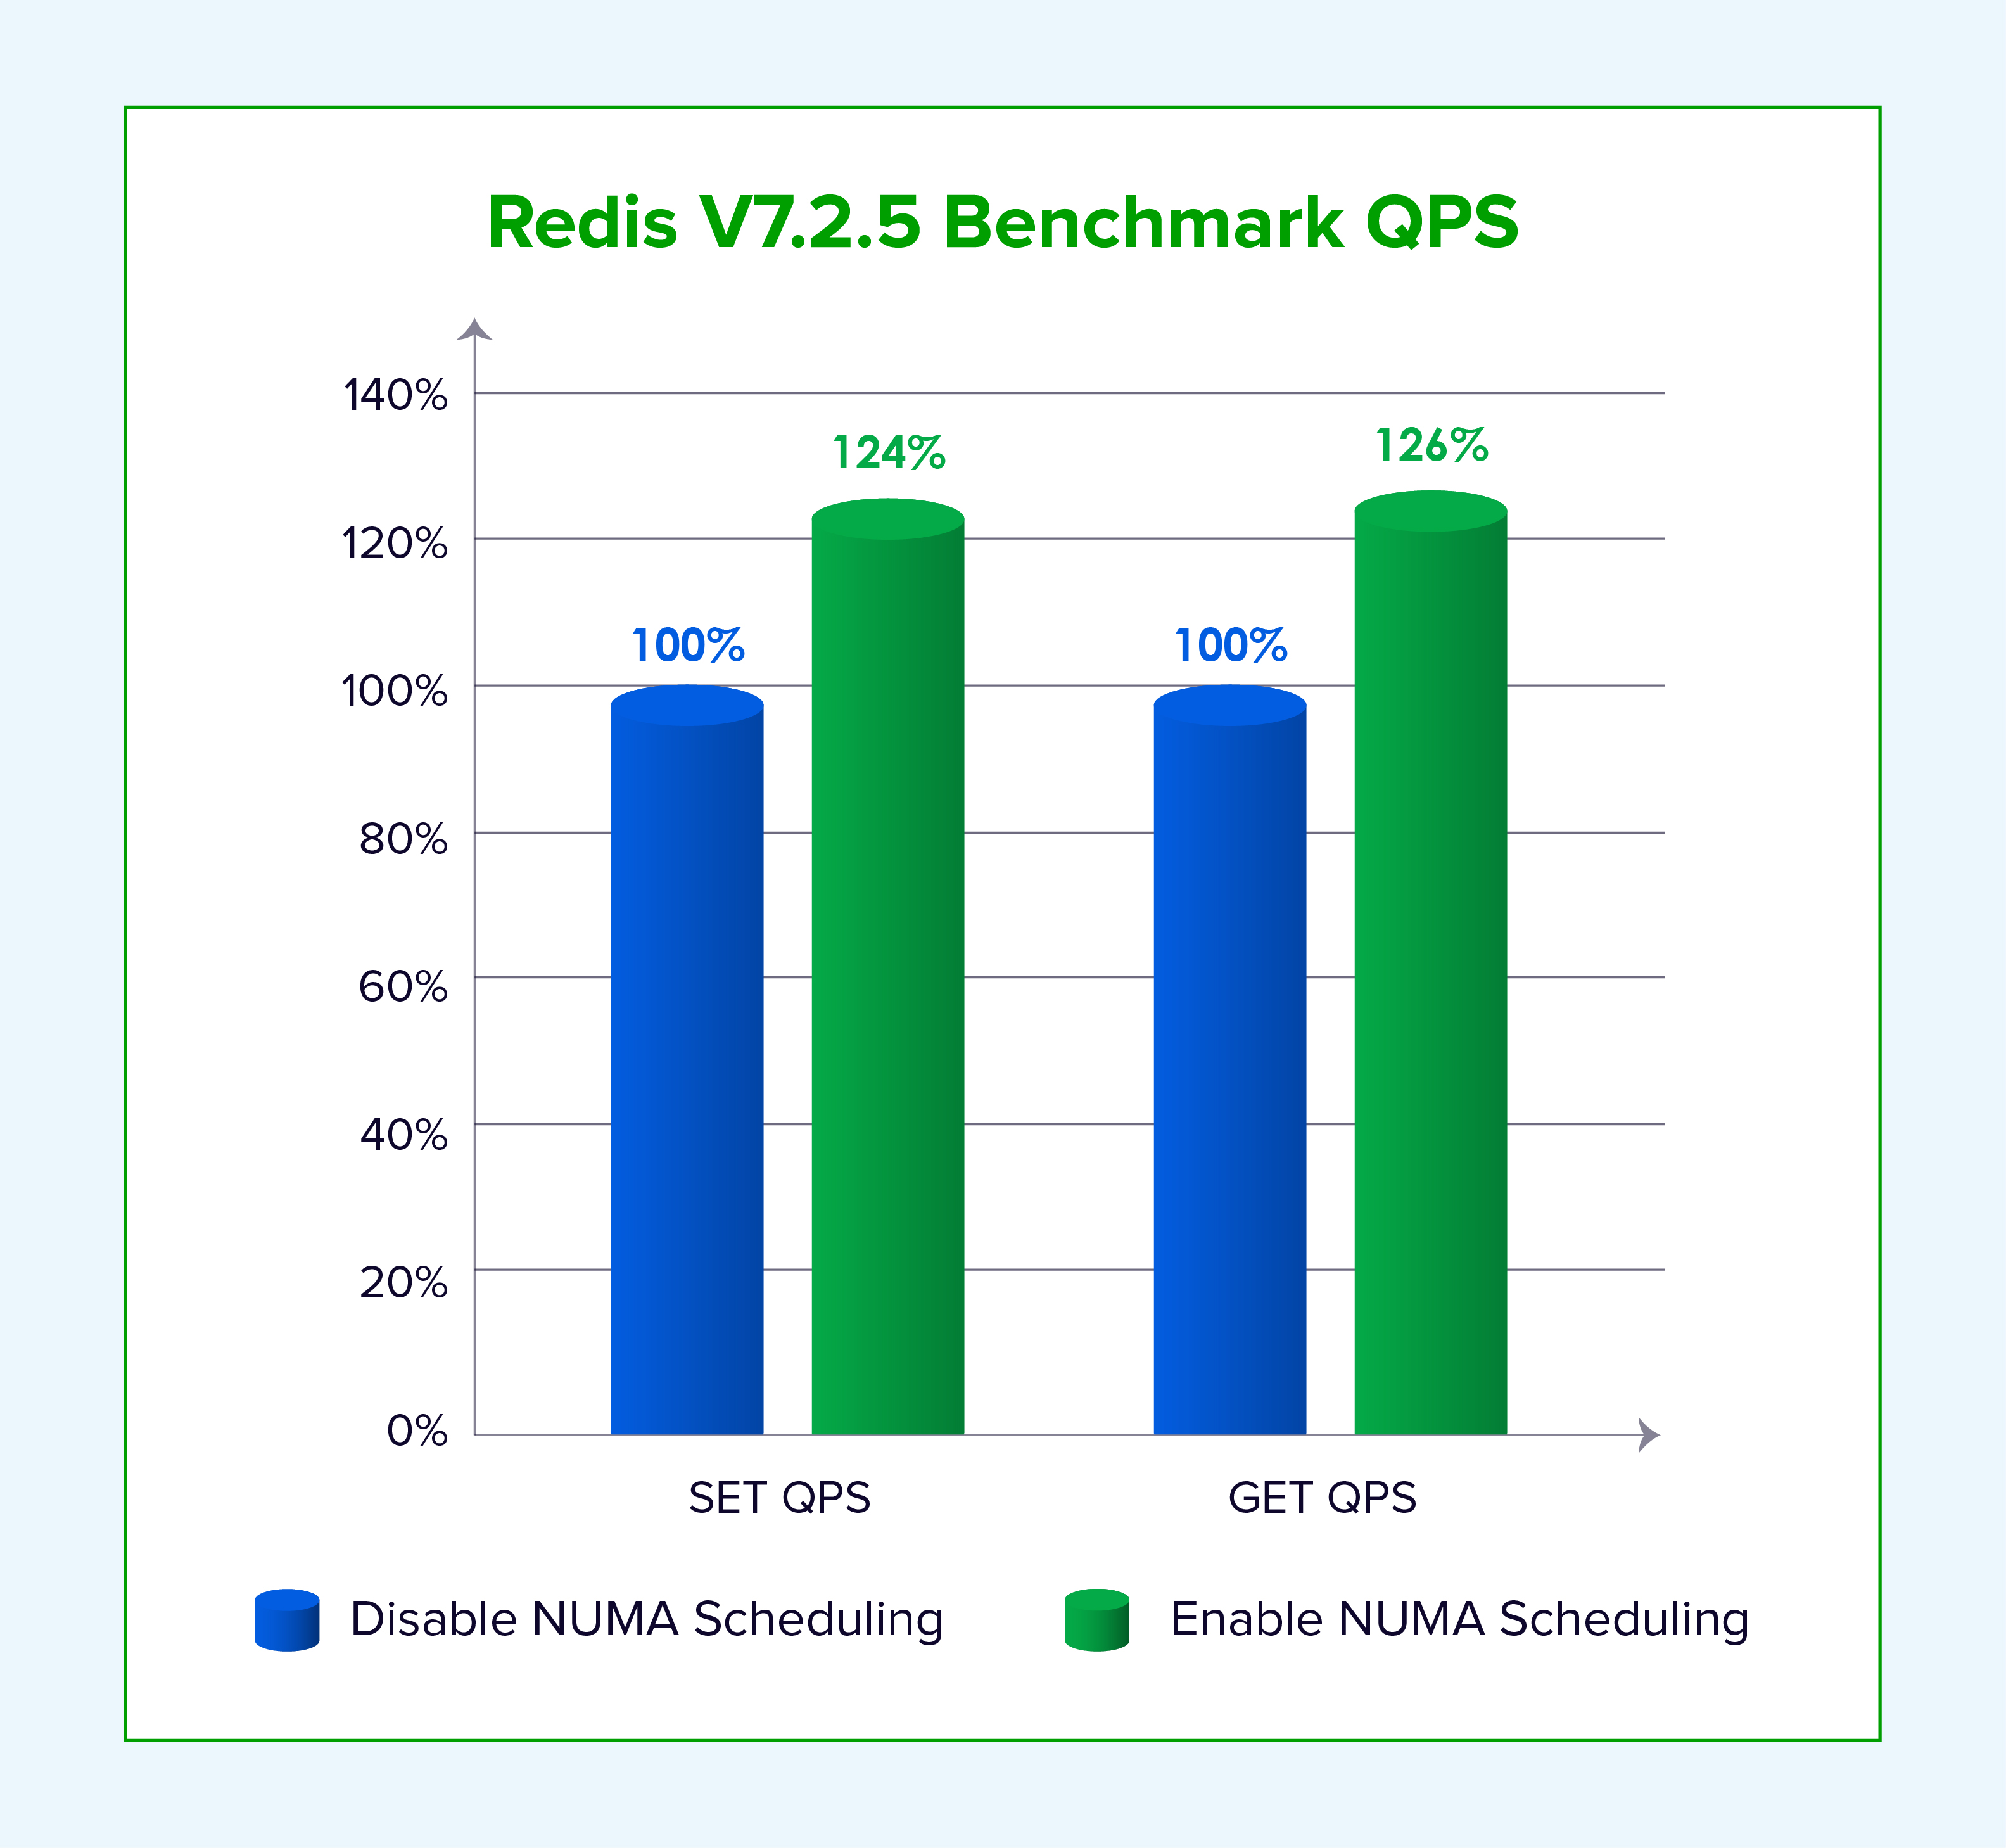
Şekil 5: NUMA zamanlaması etkinleştirildiğinde Redis okuma/yazma QPS performansındaki göreceli kazanımlar.
Anahtar-Değer Önbellekleme: Memcached 6.27
Memaslap, Memcached ile birlikte gelen bir performans test aracıdır. Sangfor, NUMA zamanlaması devre dışı bırakılmış ve etkinleştirilmiş haldeyken 1 KB değerleri için TPS'yi test etmek için bu aracı kullandı. TPS, saniyedeki işlem sayısını ifade eder.
memaslap -s 127.0.0.1:11211 -t 300s -T 8
Aşağıdaki grafik, NUMA devre dışı bırakılmış TPS sonucunun %100'e normalize edilmesiyle elde edilen göreceli performansı göstermektedir.
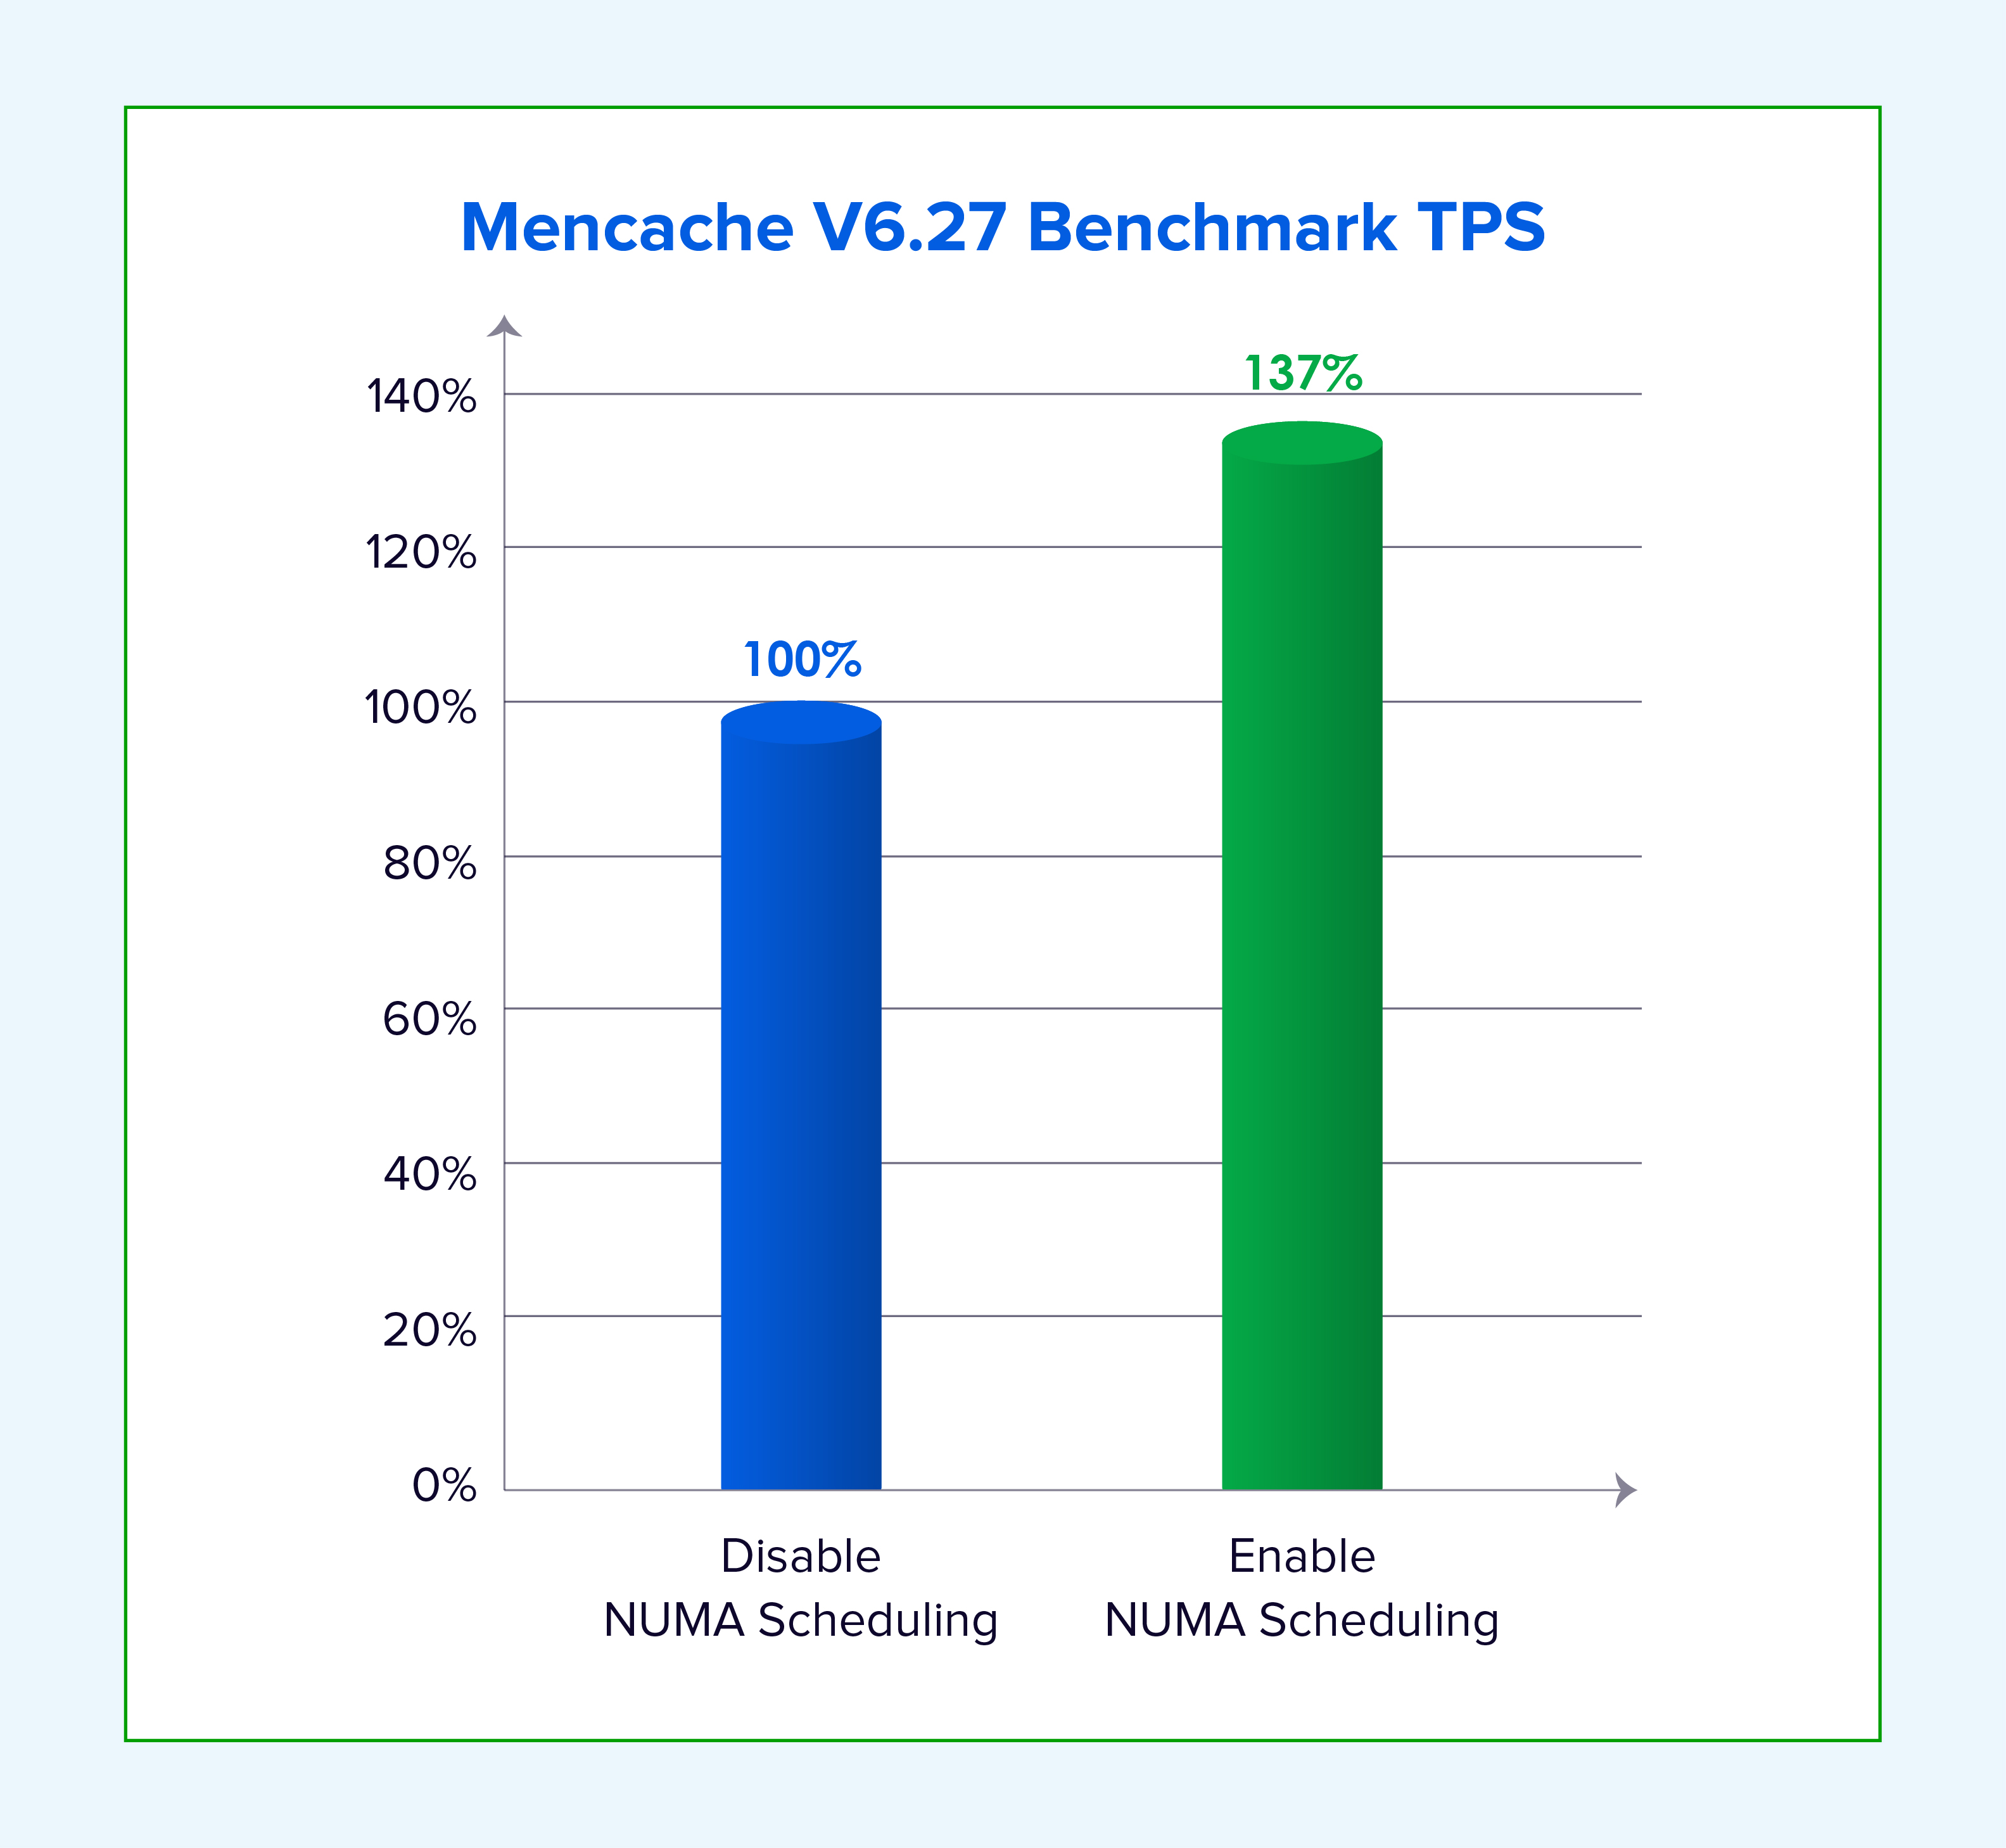
Şekil 6: NUMA zamanlaması etkinleştirildiğinde Memcached işlemsel verimliliğindeki göreceli kazanımlar.
Yukarıdaki sonuçlar, bellek yoğun uygulamalar için açık avantajlar göstermektedir. Aşağıdaki bölümlerde optimizasyonun nasıl çalıştığı açıklanmaktadır.
1. Uyarlanabilir NUMA Düğüm Tahsisi
Sangfor, uzaktan bellek erişimini azaltmak için sanal makine vCPU'larını uyarlanabilir şekilde bölümlere ayırır ve uygun NUMA düğümlerine planlar. Sanal makine vCPU sayısı bir NUMA düğümünün çekirdek sayısından düşükse, sanal makine tek bir düğüme planlanır. Sanal makine, bir düğümün sağlayabileceğinden daha fazla çekirdek gerektiriyorsa, birden fazla düğüme dağıtılır ve vNUMA topolojisi, topolojiye duyarlı kararlar için konuk işletim sistemine sunulur.
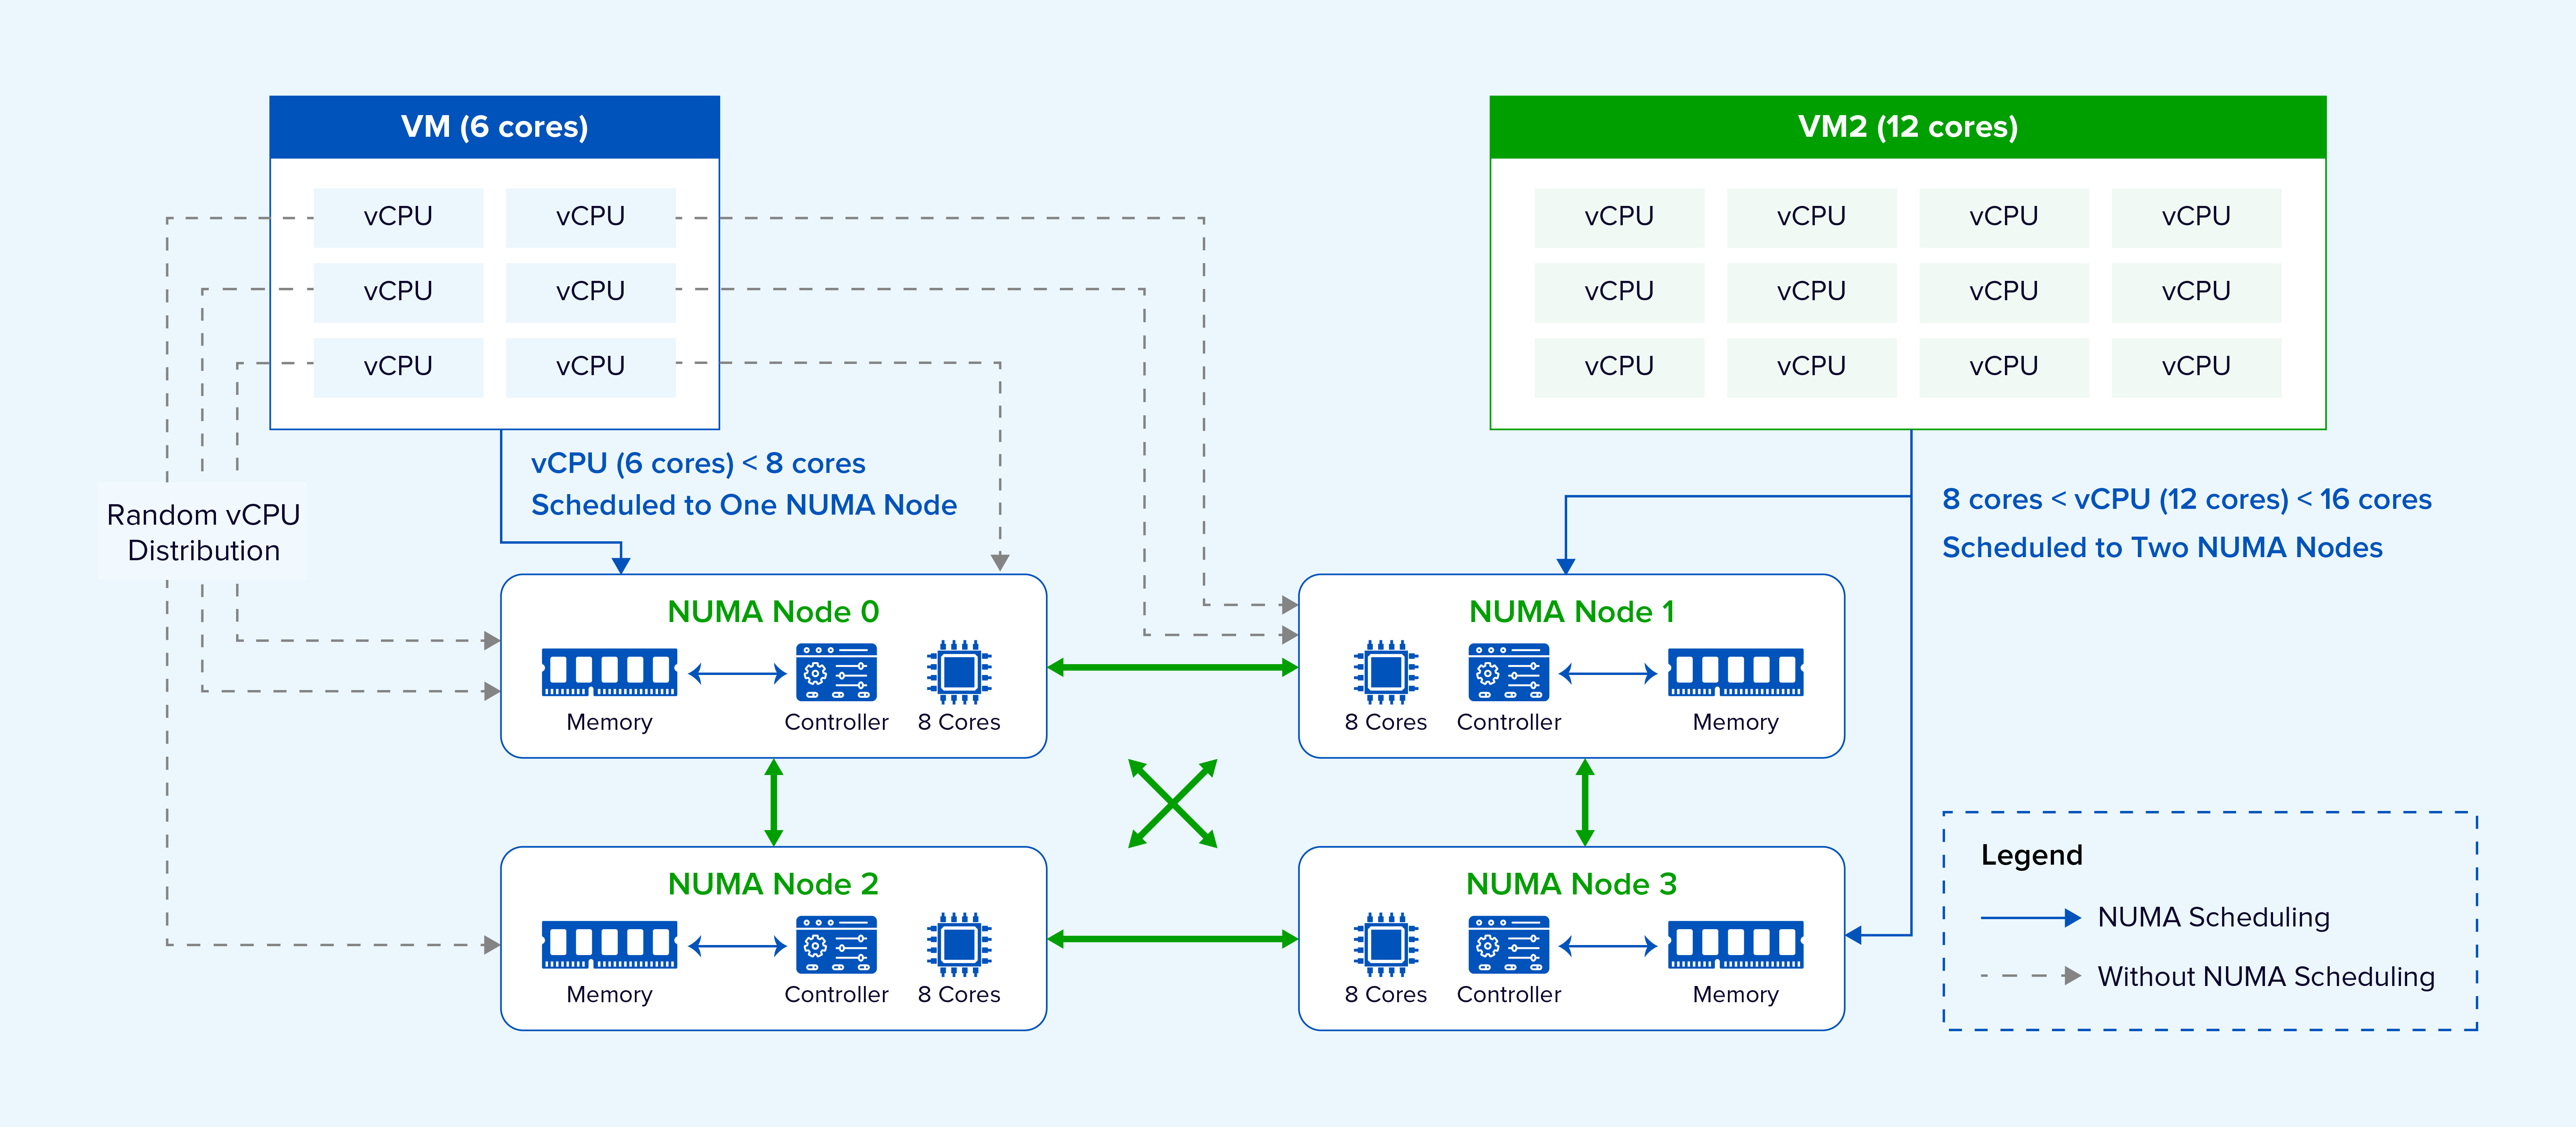
Şekil 7: Sangfor akıllı vCPU bölümleme ve vNUMA topoloji eşlemesi.
Dengeli kullanım sağlamak için, sanal makine yerleşimi NUMA düğümlerindeki mevcut yükü dikkate alır ve daha az yoğun bir düğüm seçer. Çalışma zamanında, kullanım değiştikçe sanal makineler düğümler arasında taşınabilir. Öncelikli sanal makineler, CPU, bellek bant genişliği ve önbellek kaynakları için rekabeti azaltmak amacıyla daha az yoğun düğümlere yerleştirilir.
2. Farklı Sunucu Platformları için Optimizasyon
Bazı sunucu platformları çok sayıda NUMA düğümü, farklı düğümler arası mesafeler ve düğüm başına nispeten az sayıda çekirdek içerir.
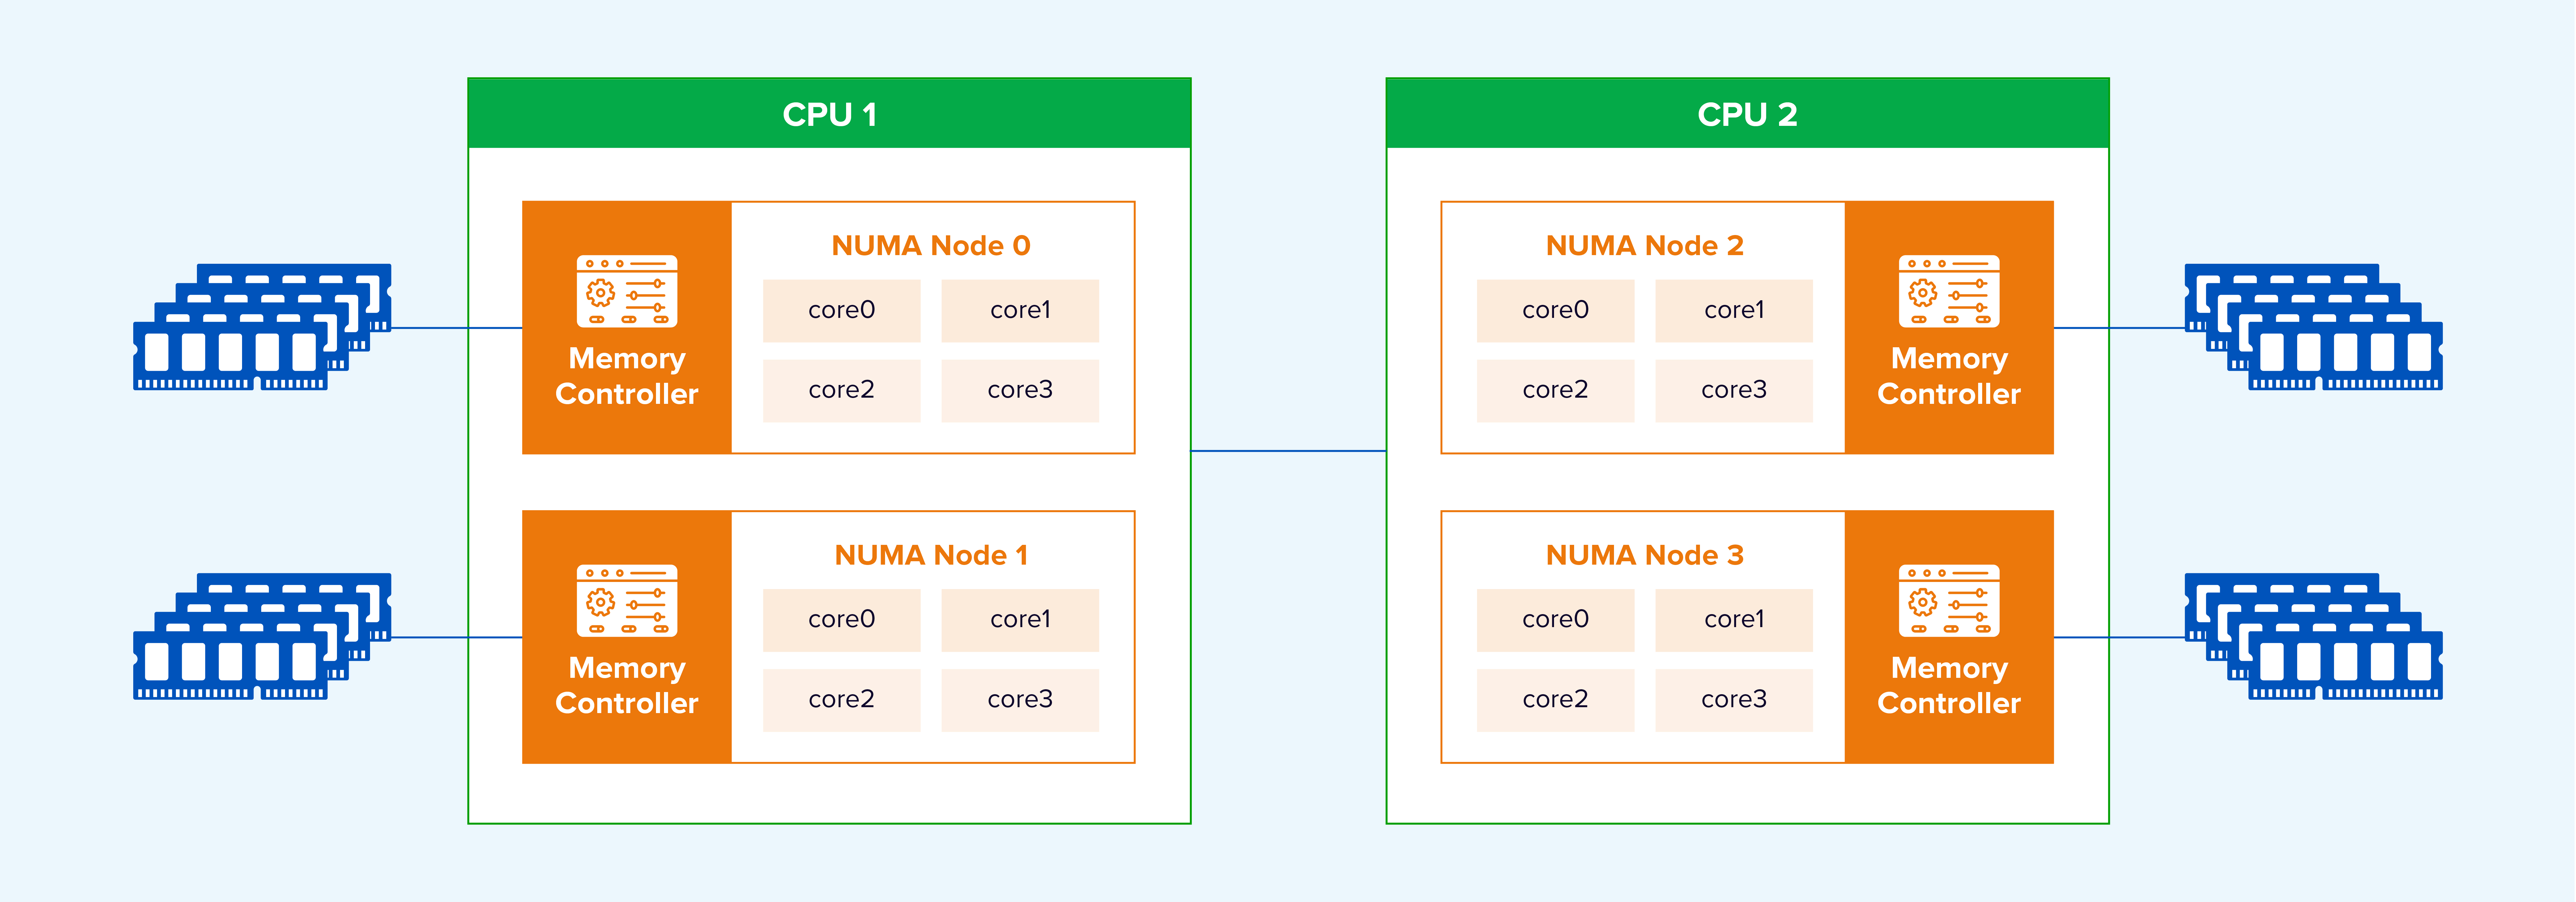
Şekil 8. Çok düğümlü bir sunucuda topolojiye duyarlı vNUMA yerleşimi.
Sangfor, NUMA düğümleri arasındaki mesafeyi belirler ve aynı sanal makineden gelen birden fazla vNUMA düğümünü tercihen yakındaki fiziksel NUMA düğümlerine yerleştirir.
Veri iletim performansını daha da iyileştirmek için Sangfor, sanal makineler (VM'ler) ve veri düzlemi süreçleri arasında NUMA yakınlığı geliştirdi. VM ve veri iletim süreci aynı NUMA düğümünde planlanarak yerel bellek erişimi artırılıyor. Aşağıdaki şekilde, DP veri düzlemi sürecini ifade etmektedir.
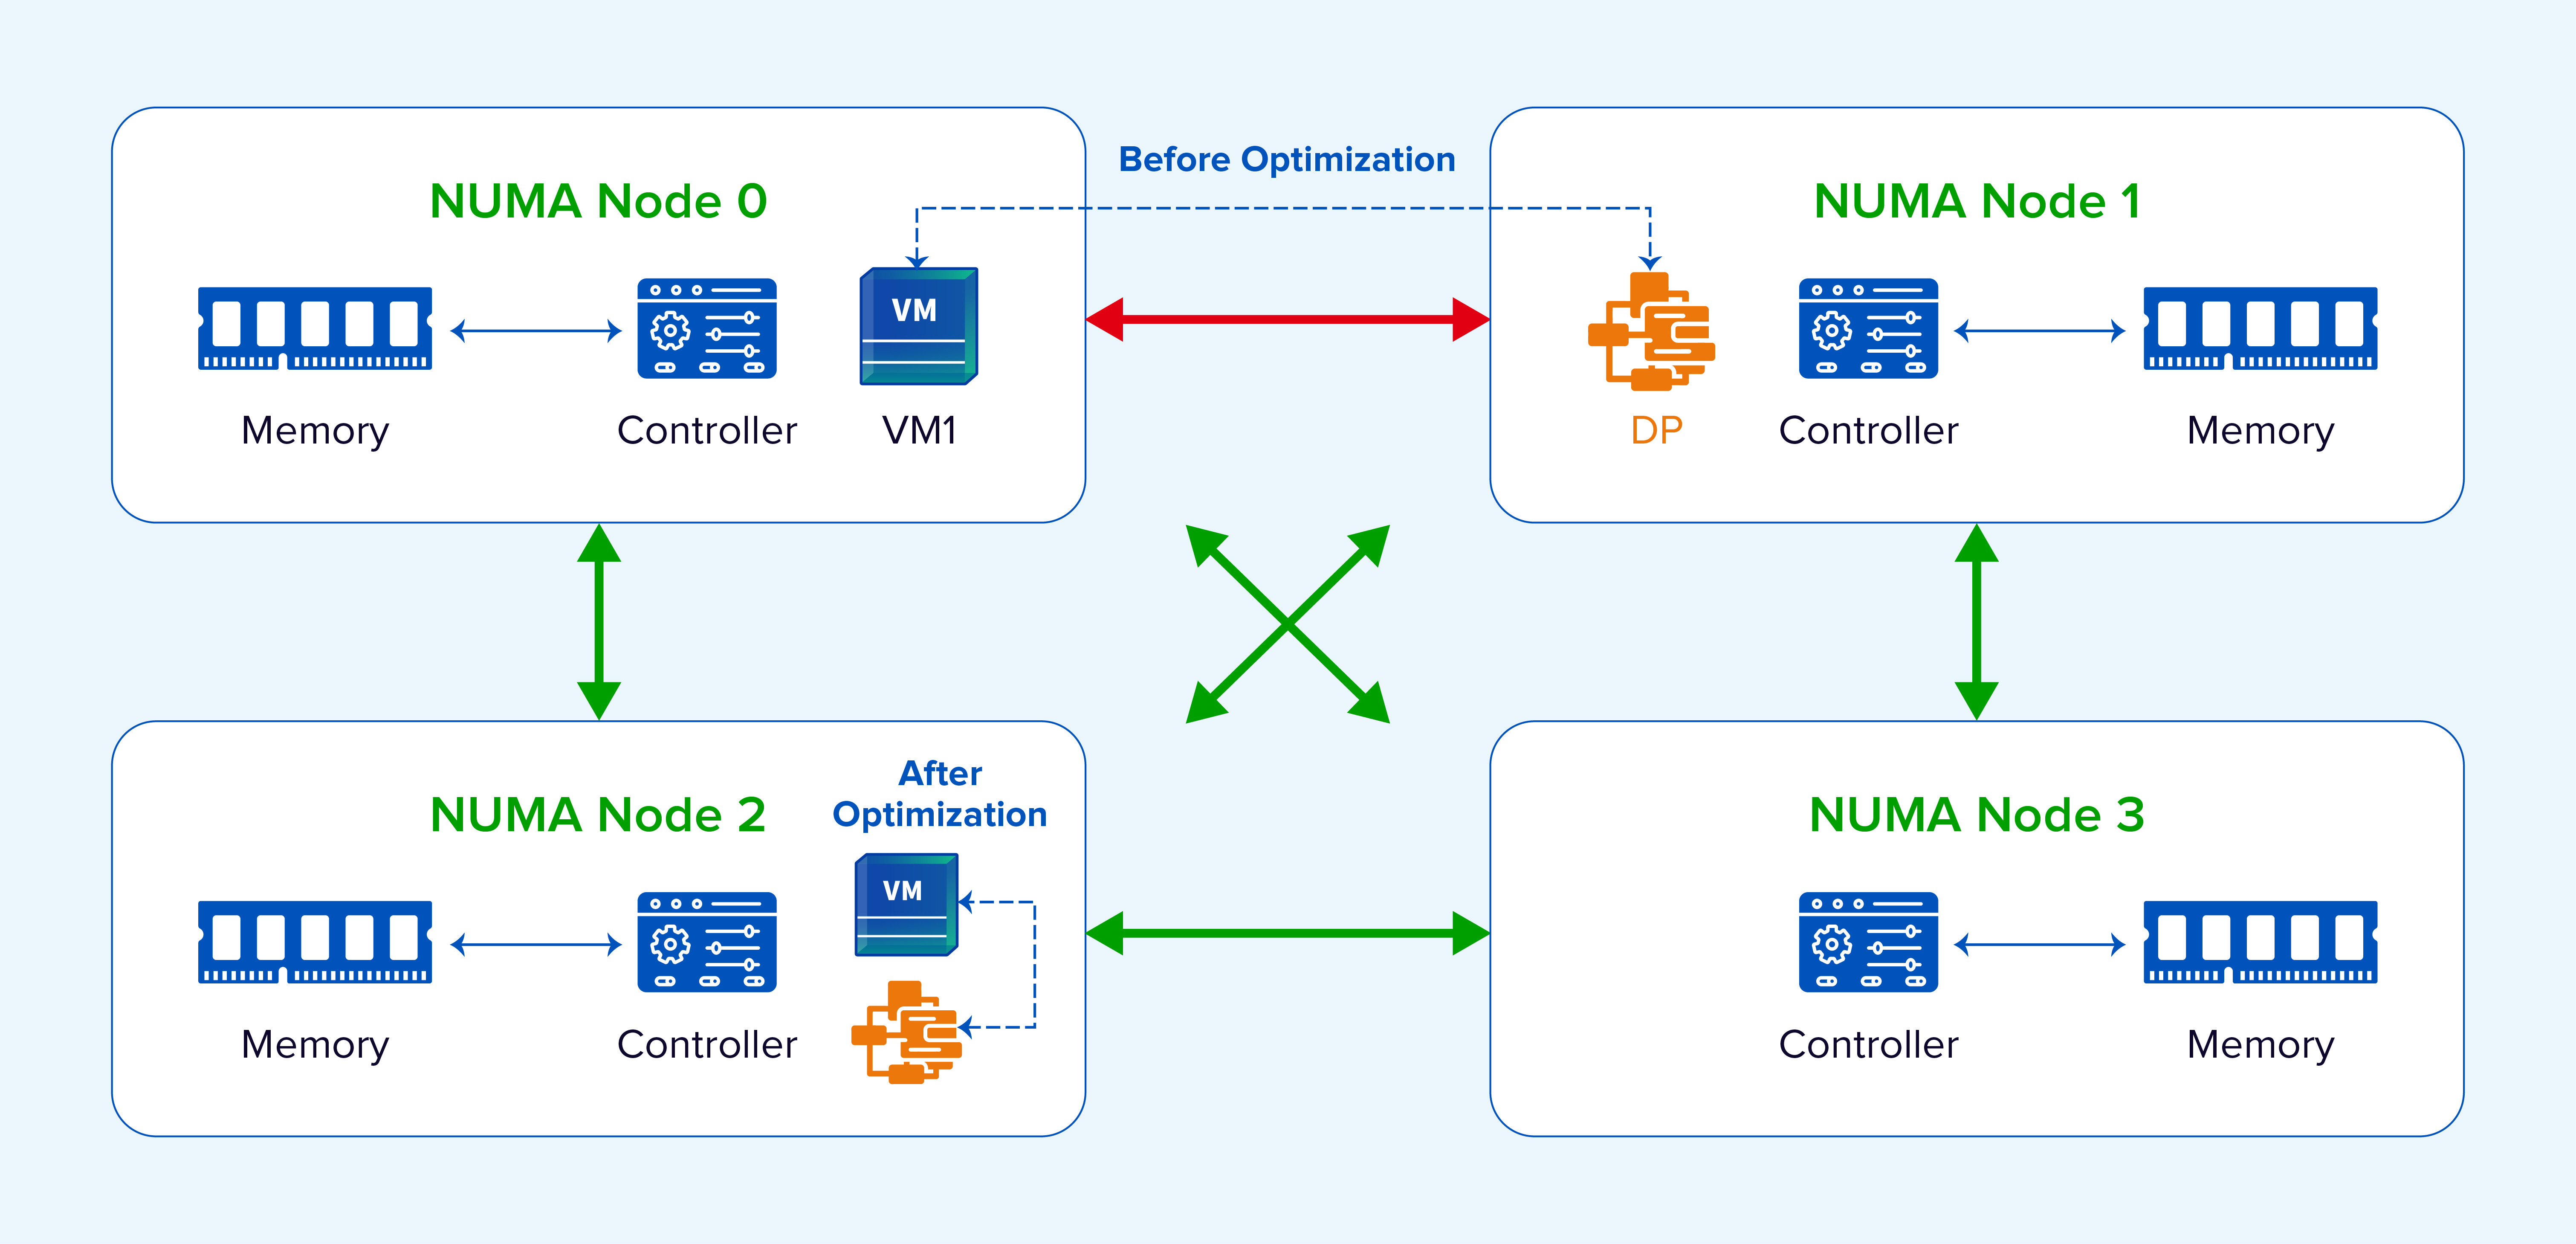
Şekil 9. Sanal makine ve veri düzlemi yakınlığı, işlemeyi yerel belleğe yakın tutar.
Depolama genelinde NUMA avantajlarını en üst düzeye çıkarmak için Sangfor, vCPU, QEMU, libnfs, aSAN ve tam bir G/Ç yolunda yer alan diğer süreçleri aynı NUMA düğümüne yerleştirir. Bu, uzaktan bellek erişimini önler. Büyük bellek sayfaları, bellek erişim performansını daha da iyileştirir, işlem yükünü azaltır ve G/Ç akışı verimliliğini artırır.
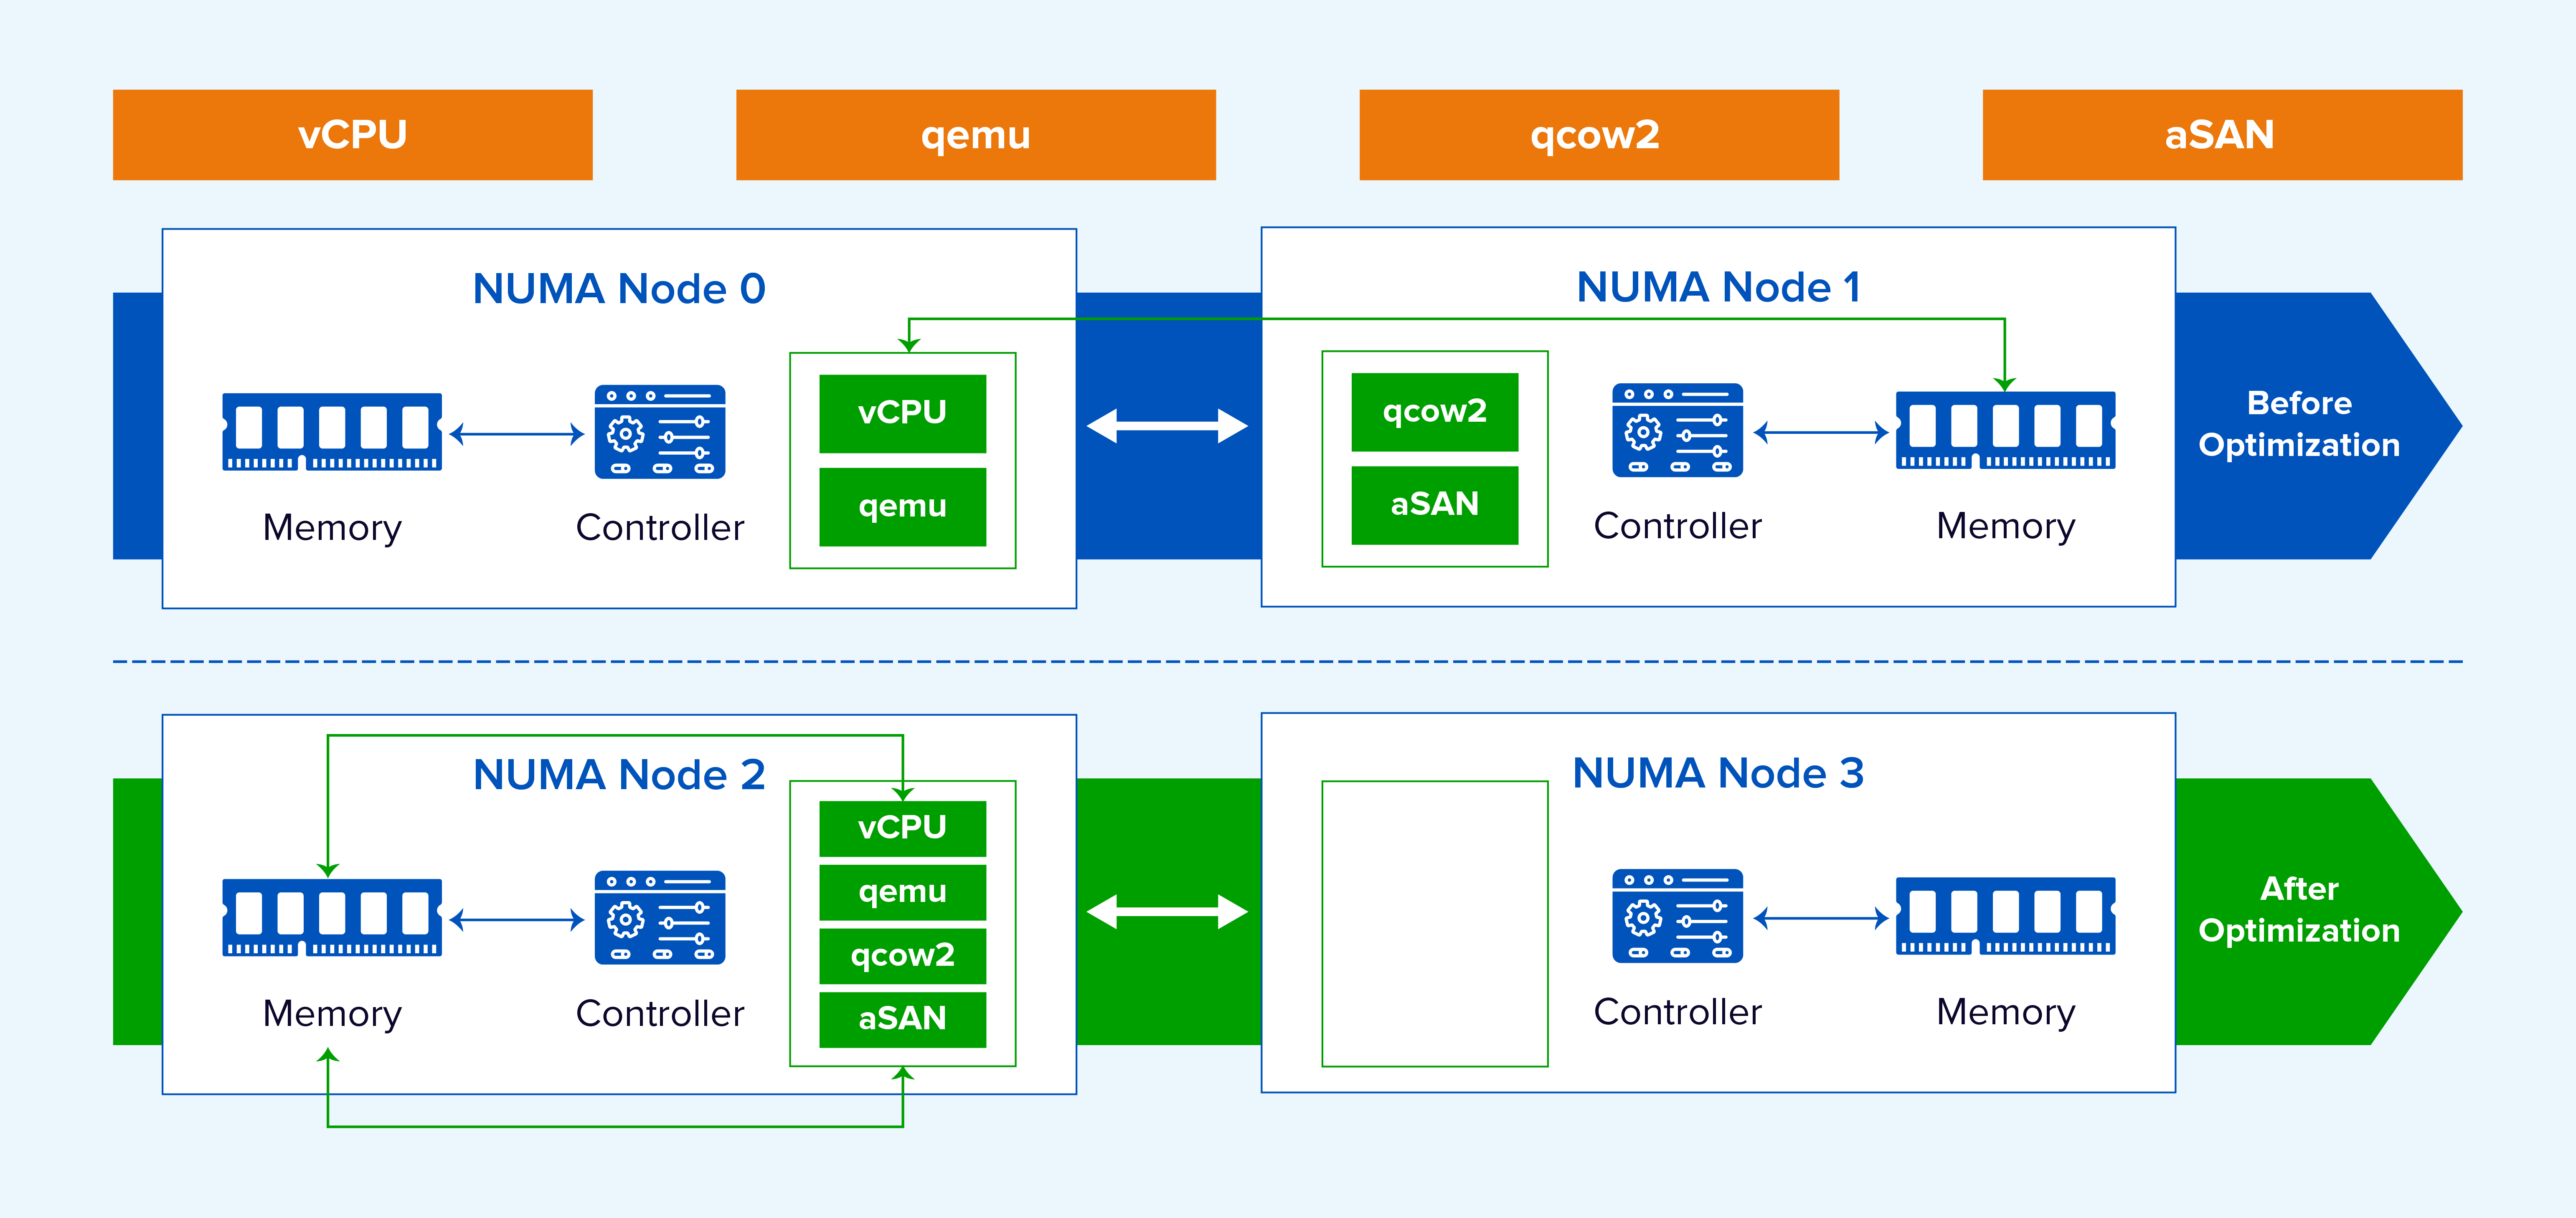
Şekil 10. Sanal depolama G/Ç yolu boyunca koordineli NUMA yerleşimi.
Ağ arayüz kartı (NIC) tamponundan sanal depolamaya taşınan verilerin CPU iş parçacıkları tarafından işlenmesi gerekir. Ağ performansı arttıkça, tek çekirdekli tampon kopyalama verimliliği bir darboğaz haline gelebilirken, NUMA'lar arası erişim verimliliği daha da düşürür. Sangfor, NIC trafiğini işlemek için birden fazla CPU çekirdeğini etkinleştirir ve NUMA yakınlığını uygular. Bu, tek çekirdekli darboğazı ortadan kaldırır, aktarım gecikmesini azaltır ve eşzamanlılığı artırır. Dahili testlerde, yüksek kuyruk derinliğine sahip, büyük bloklu VM yazma performansı %20'den fazla iyileşmiştir.
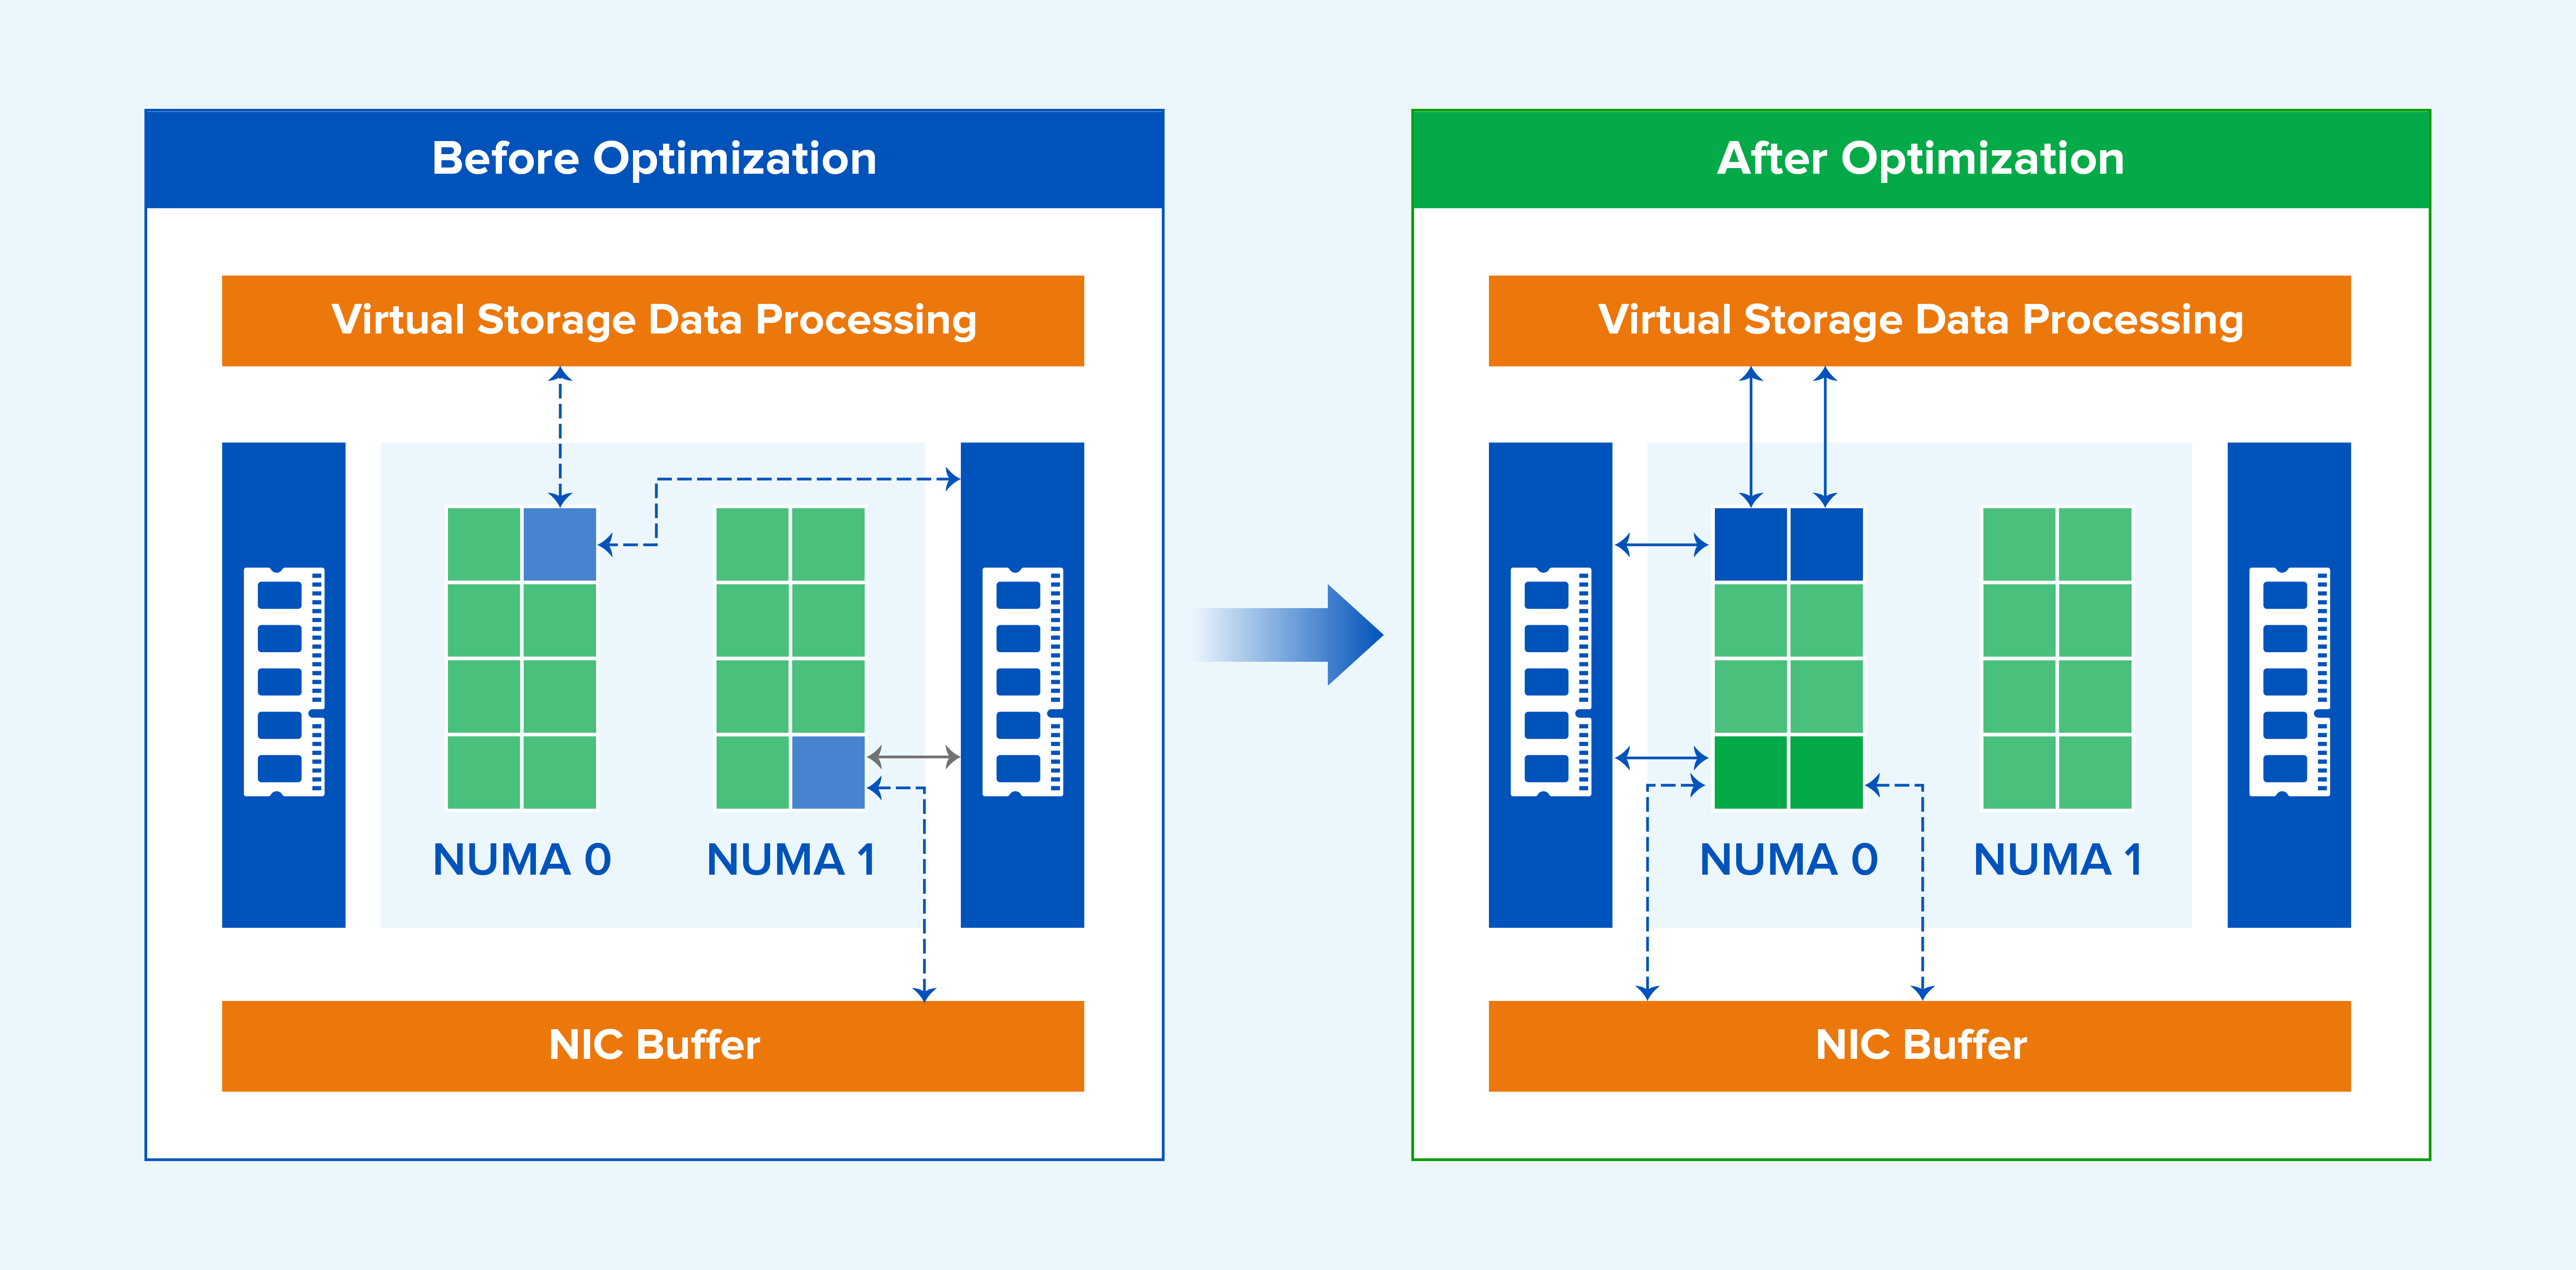
Şekil 11. NIC tamponları ve sanal depolama arasında çok çekirdekli, NUMA uyumlu işlem.
3. Diğer Sektör Yaklaşımlarıyla Karşılaştırma
Sektör desteği farklılık gösteriyor. Bir tedarikçi, yöneticilerin her bir sanal makine vCPU'sunun çalıştığı NUMA düğümünü yapılandırmasına izin verirken, bir diğeri bu özelliği desteklemiyor ve VMware uyarlanabilir NUMA zamanlamasını destekliyor.
Sangfor, uzaktan bellek erişimini azaltmak için sanal makine vCPU'larını otomatik olarak bölümlendirir ve NUMA düğümlerine yerleştirir. Her bir vCPU'nun konumunu manuel olarak yapılandırmaya kıyasla, Sangfor'un uyarlanabilir NUMA zamanlaması vCPU bölümlendirmesini ve yerleştirmesini otomatikleştirir, düğümler arasında kullanımı dengeler ve genel performansı iyileştirir.
Temel bir uyarlanabilir NUMA uygulamasına kıyasla, Sangfor optimizasyonu depolama hizmeti planlamasına, öncelikli sanal makine tanımına, heterojen sunucu platformlarına ve sanal makine ağ uyumluluğuna kadar genişletiyor. Bu geliştirmeler, Sangfor araştırma ve bulut ürün ekipleri arasındaki ortak mühendisliği yansıtıyor ve gerçek platform-hizmet davranışına göre tasarlanmıştır.
BÖLÜM 5. Özet
Sangfor'un uyarlanabilir NUMA zamanlama çözümü, uygulama bellek erişim verimliliğini artırmak için birden fazla altyapı senaryosuna optimize edilmiştir:
- Uzaktan bellek erişimini azaltmak için sanal makine vCPU'larını uyarlanabilir şekilde bölümlendirin ve NUMA düğümlerine yerleştirin.
- Dengeli kullanım sağlamak için sanal makineleri NUMA düğümleri arasında taşıyın.
- Öncelikli sanal makineleri belirleyin ve bunları daha az rekabetin olduğu düğümlerde tutarak CPU, bellek bant genişliği ve önbellek için rekabeti azaltın.
- Çok sayıda NUMA düğümüne ve farklı düğümler arası mesafelere sahip sunucular için, topoloji mesafesini belirleyin ve ilgili vNUMA kaynaklarını öncelikli olarak yakındaki fiziksel NUMA düğümlerine yerleştirin.
- İletim performansını iyileştirmek için sanal makineyi ağ veri düzlemiyle aynı NUMA düğümüne yerleştiren bir sanal makine ağ yakınlığı seçeneği sağlayın.
- NUMA uyumlu zamanlamayı yalnızca sanal makineler için değil, depolama hizmetleri için de uygulayın.
UnixBench Test Örneği
UnixBench, UNIX, BSD ve Linux dahil olmak üzere Unix benzeri sistemler için yaygın olarak kullanılan bir performans test aracıdır. CPU, dosya sistemi, bellek ve işlem performansı dahil olmak üzere sistem performansının birçok boyutunu ölçer.
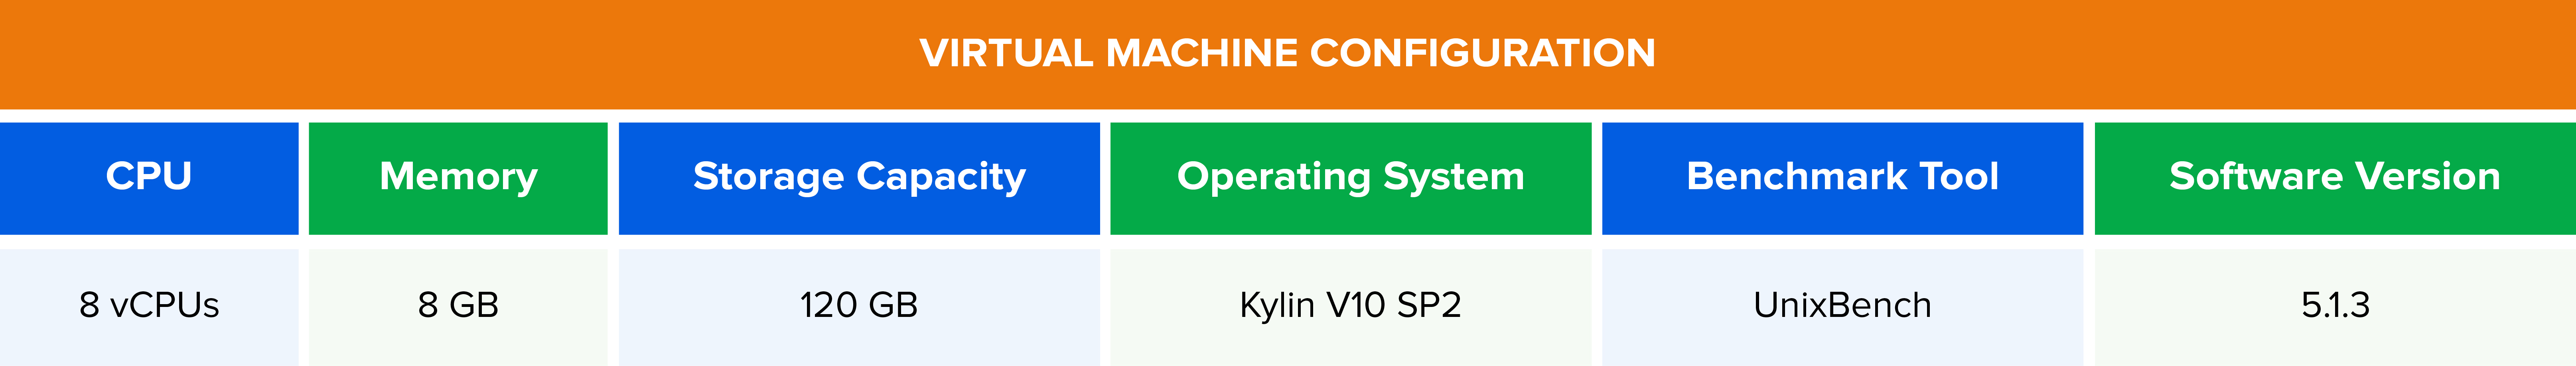
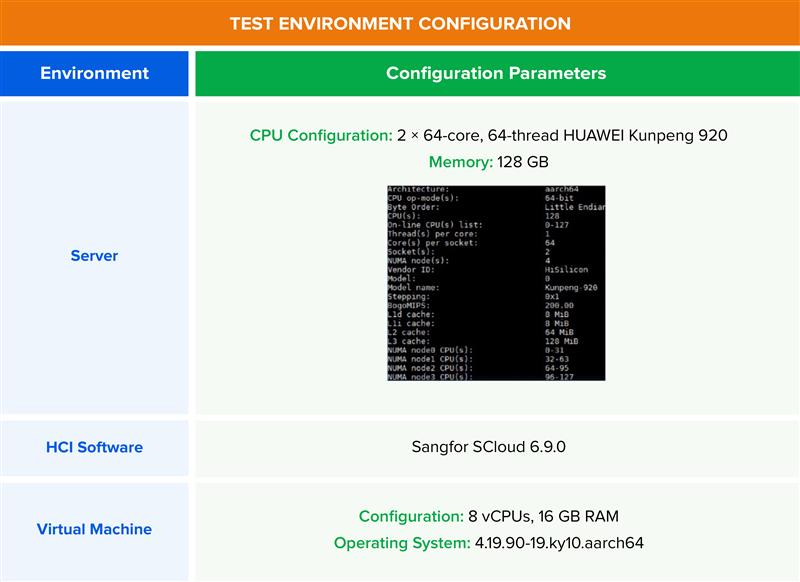
Şekil 12. UnixBench testleri için sanal makine yapılandırması.
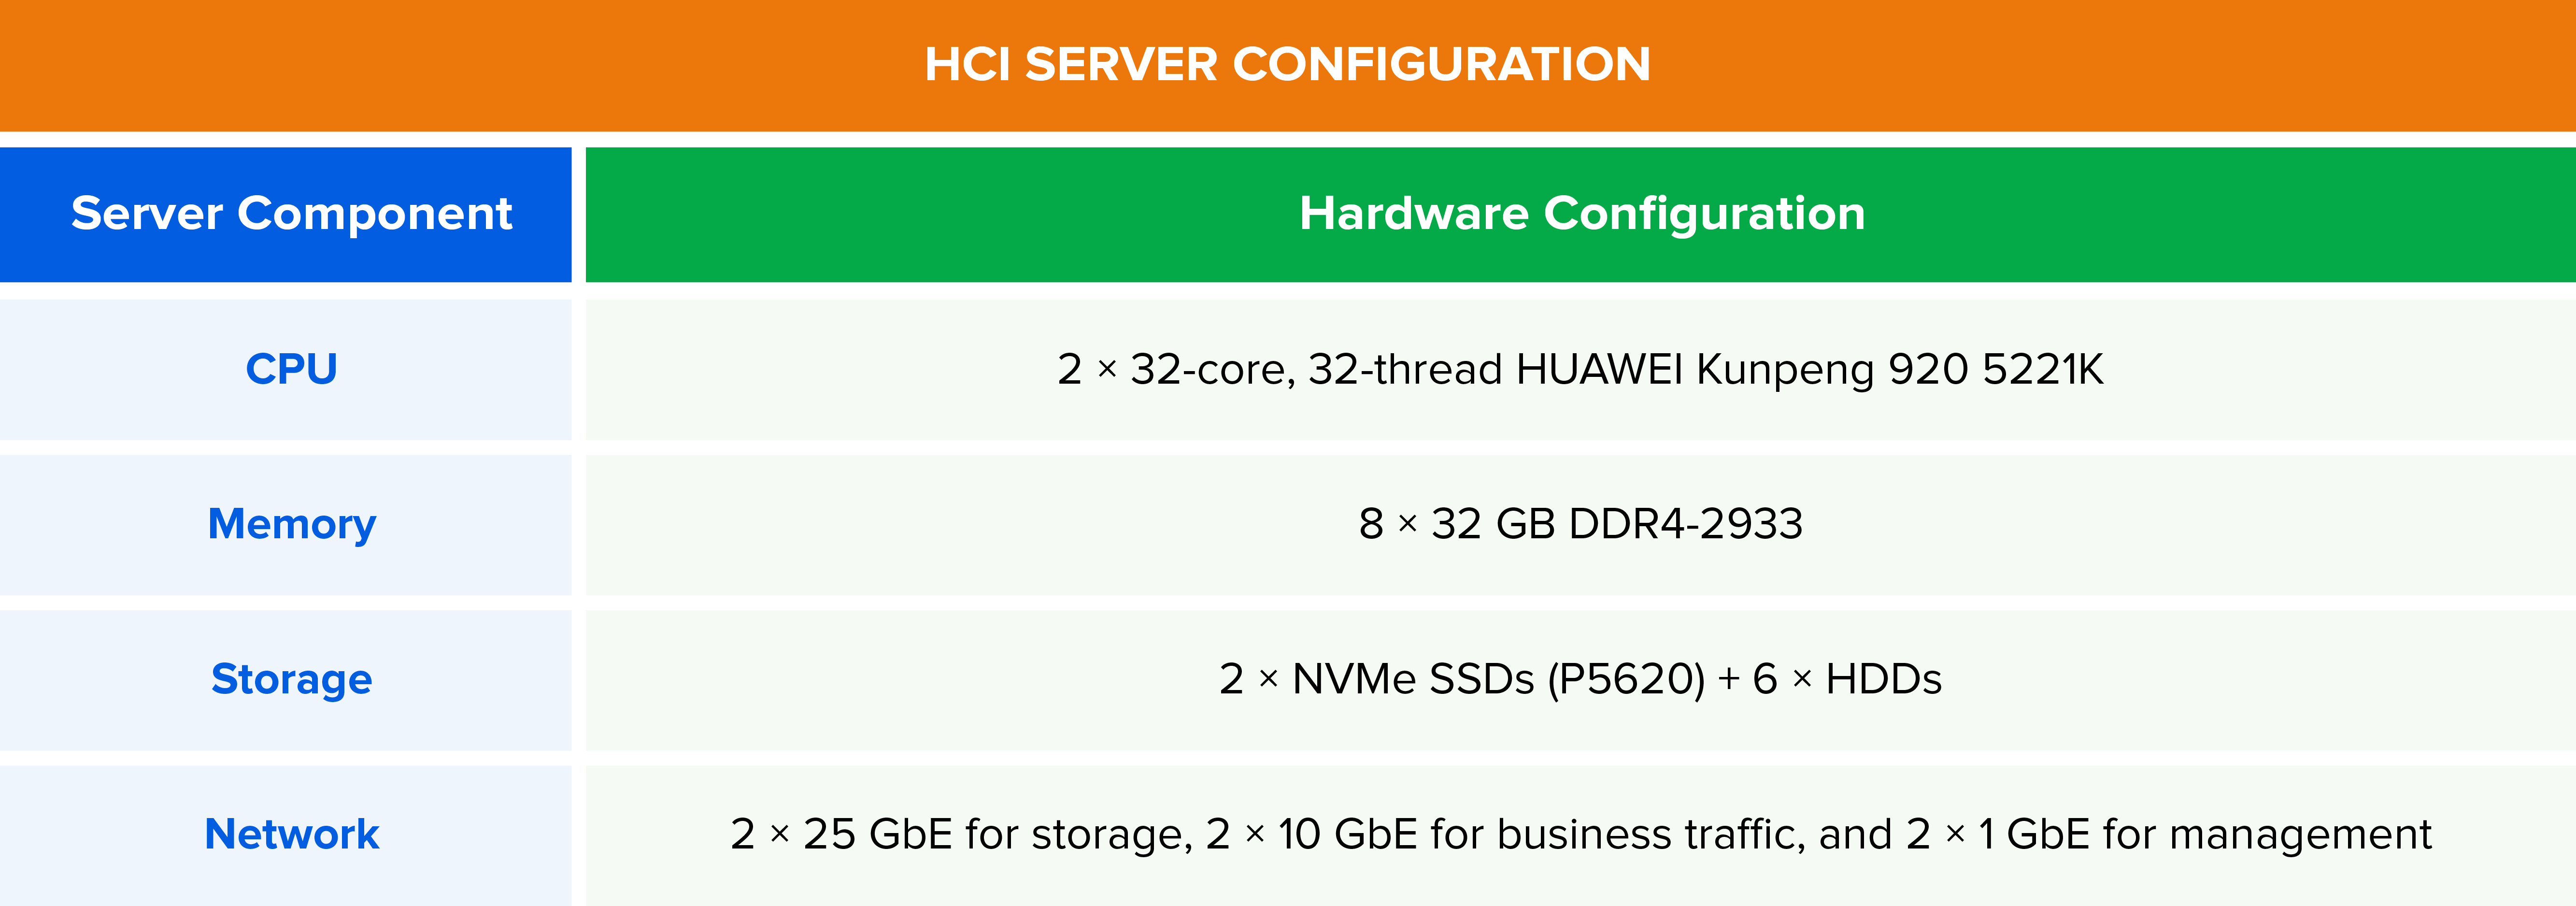
Şekil 13. UnixBench testi için HCI sunucu donanım yapılandırması.
Test Sonuçları: Sangfor HCI 6.9.0'da, NUMA etkinleştirildiğinde, aynı sunucuda eş zamanlı olarak çalışan 6 sanal makinenin toplam UnixBench puanı, anonimleştirilmiş karşılaştırma platformuna göre %20,2 daha yüksekti. Eş zamanlı 8 sanal makine için ise toplam puan %34,17 daha yüksekti.
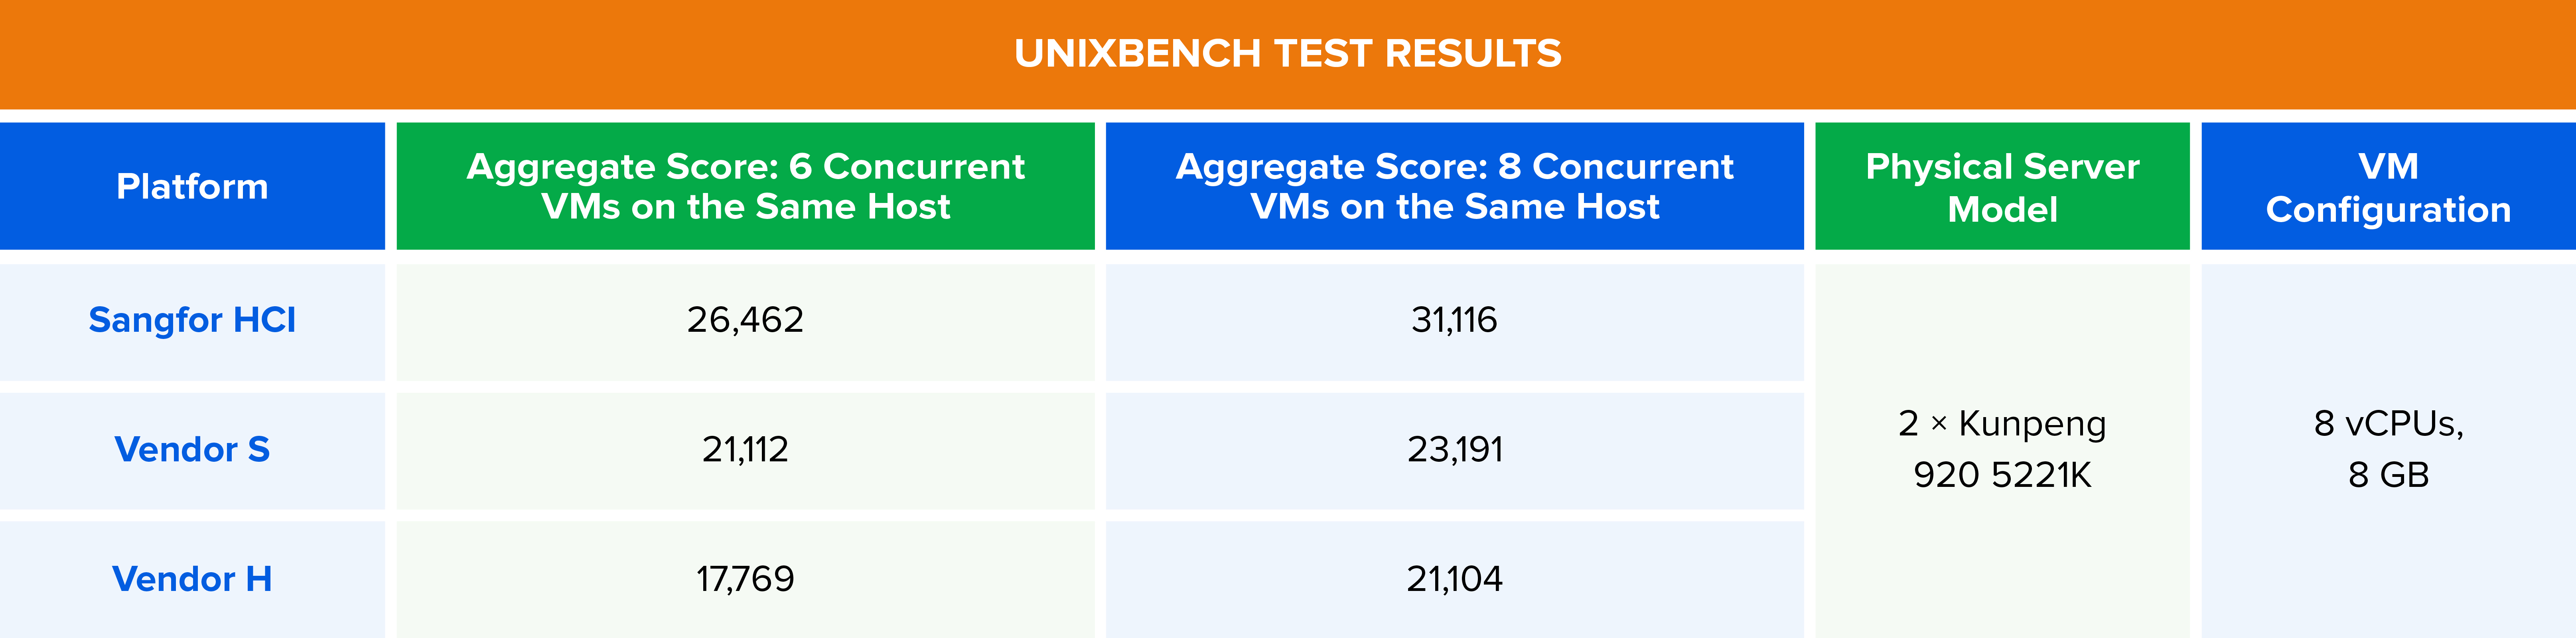
Şekil 14. Eş zamanlı sanal makine iş yükleri altında UnixBench kıyaslama sonuçlarının karşılaştırmalı gösterimi.
Bu makaledeki kıyaslama gözlemleri, Sangfor'un belirli dahili test ortamlarını yansıtmaktadır ve teknik açıklama amacıyla sunulmuştur. Gerçek sonuçlar donanım, yazılım sürümü, yapılandırma ve iş yüküne göre değişiklik gösterebilir. Müşteriler, temsili uygulamaları kendi hizmet düzeyi hedeflerine göre doğrulamalıdır.

