Riassumi questo articolo di notizie con l'intelligenza artificiale:
 Chiedi a ChatGPT
 Chiedi a Grok
 Chiedi a Perplexity
 Chiedi a Claude
 Chiedi a Google AI
Con un numero sempre maggiore di organizzazioni che spostano i carichi di lavoro business-critical su infrastrutture virtualizzate, iperconvergenti e cloud, le prestazioni in condizioni di elevata concorrenza sono diventate una priorità assoluta. Per le aziende che stanno valutando un'alternativa a VMware, la domanda non è semplicemente se un'altra piattaforma possa offrire funzionalità simili, ma se sia in grado di garantire la latenza, il throughput e la stabilità necessari per supportare i sistemi aziendali più critici.
Questa sfida è particolarmente evidente nelle applicazioni ad alta intensità di memoria, tra cui il trading ad alta frequenza e la gestione del rischio nei servizi finanziari, i sistemi di cartella clinica elettronica nel settore sanitario e i sistemi di gestione del magazzino nella logistica. Le loro crescenti esigenze di accesso alla memoria sono strettamente legate a componenti di backend come Redis, Apache Spark, SAP HANA e motori o modelli di intelligenza artificiale. Redis, ad esempio, è un database in-memory le cui prestazioni dipendono direttamente dalla velocità di accesso alla memoria.
Oggi NUMA rappresenta l'architettura di riferimento per le moderne CPU server. Migliorare l'efficienza dell'accesso alla memoria in ambienti NUMA è quindi un aspetto fondamentale dell'ottimizzazione delle prestazioni della virtualizzazione. Questo articolo descrive le tecnologie di ottimizzazione NUMA sviluppate da Sangfor e spiega come aiutino le piattaforme di virtualizzazione a supportare carichi di lavoro business-critical ad alta concorrenza durante la sostituzione di VMware.
PARTE 1. Le basi dell'architettura NUMA
I primi sistemi informatici utilizzavano generalmente un singolo processore per eseguire tutte le operazioni di calcolo. Con l'aumento della complessità delle applicazioni e della richiesta di potenza elaborativa, un unico processore non è stato più sufficiente per soddisfare le esigenze dell'high-performance computing, portando all'evoluzione verso architetture multicore.
Le tradizionali architetture multicore adottavano comunemente il modello di Symmetric Multiprocessing (SMP). In un sistema SMP, tutti i processori hanno lo stesso livello di priorità e gli stessi diritti di accesso alla memoria. Qualsiasi thread può essere eseguito su qualsiasi processore, consentendo un efficace bilanciamento del carico e migliorando le prestazioni complessive e il throughput del sistema.
Tuttavia, poiché tutti i core condividono lo stesso bus per accedere alla memoria, all'aumentare del numero di core il bus può trasformarsi in un collo di bottiglia, limitando la scalabilità e le prestazioni.
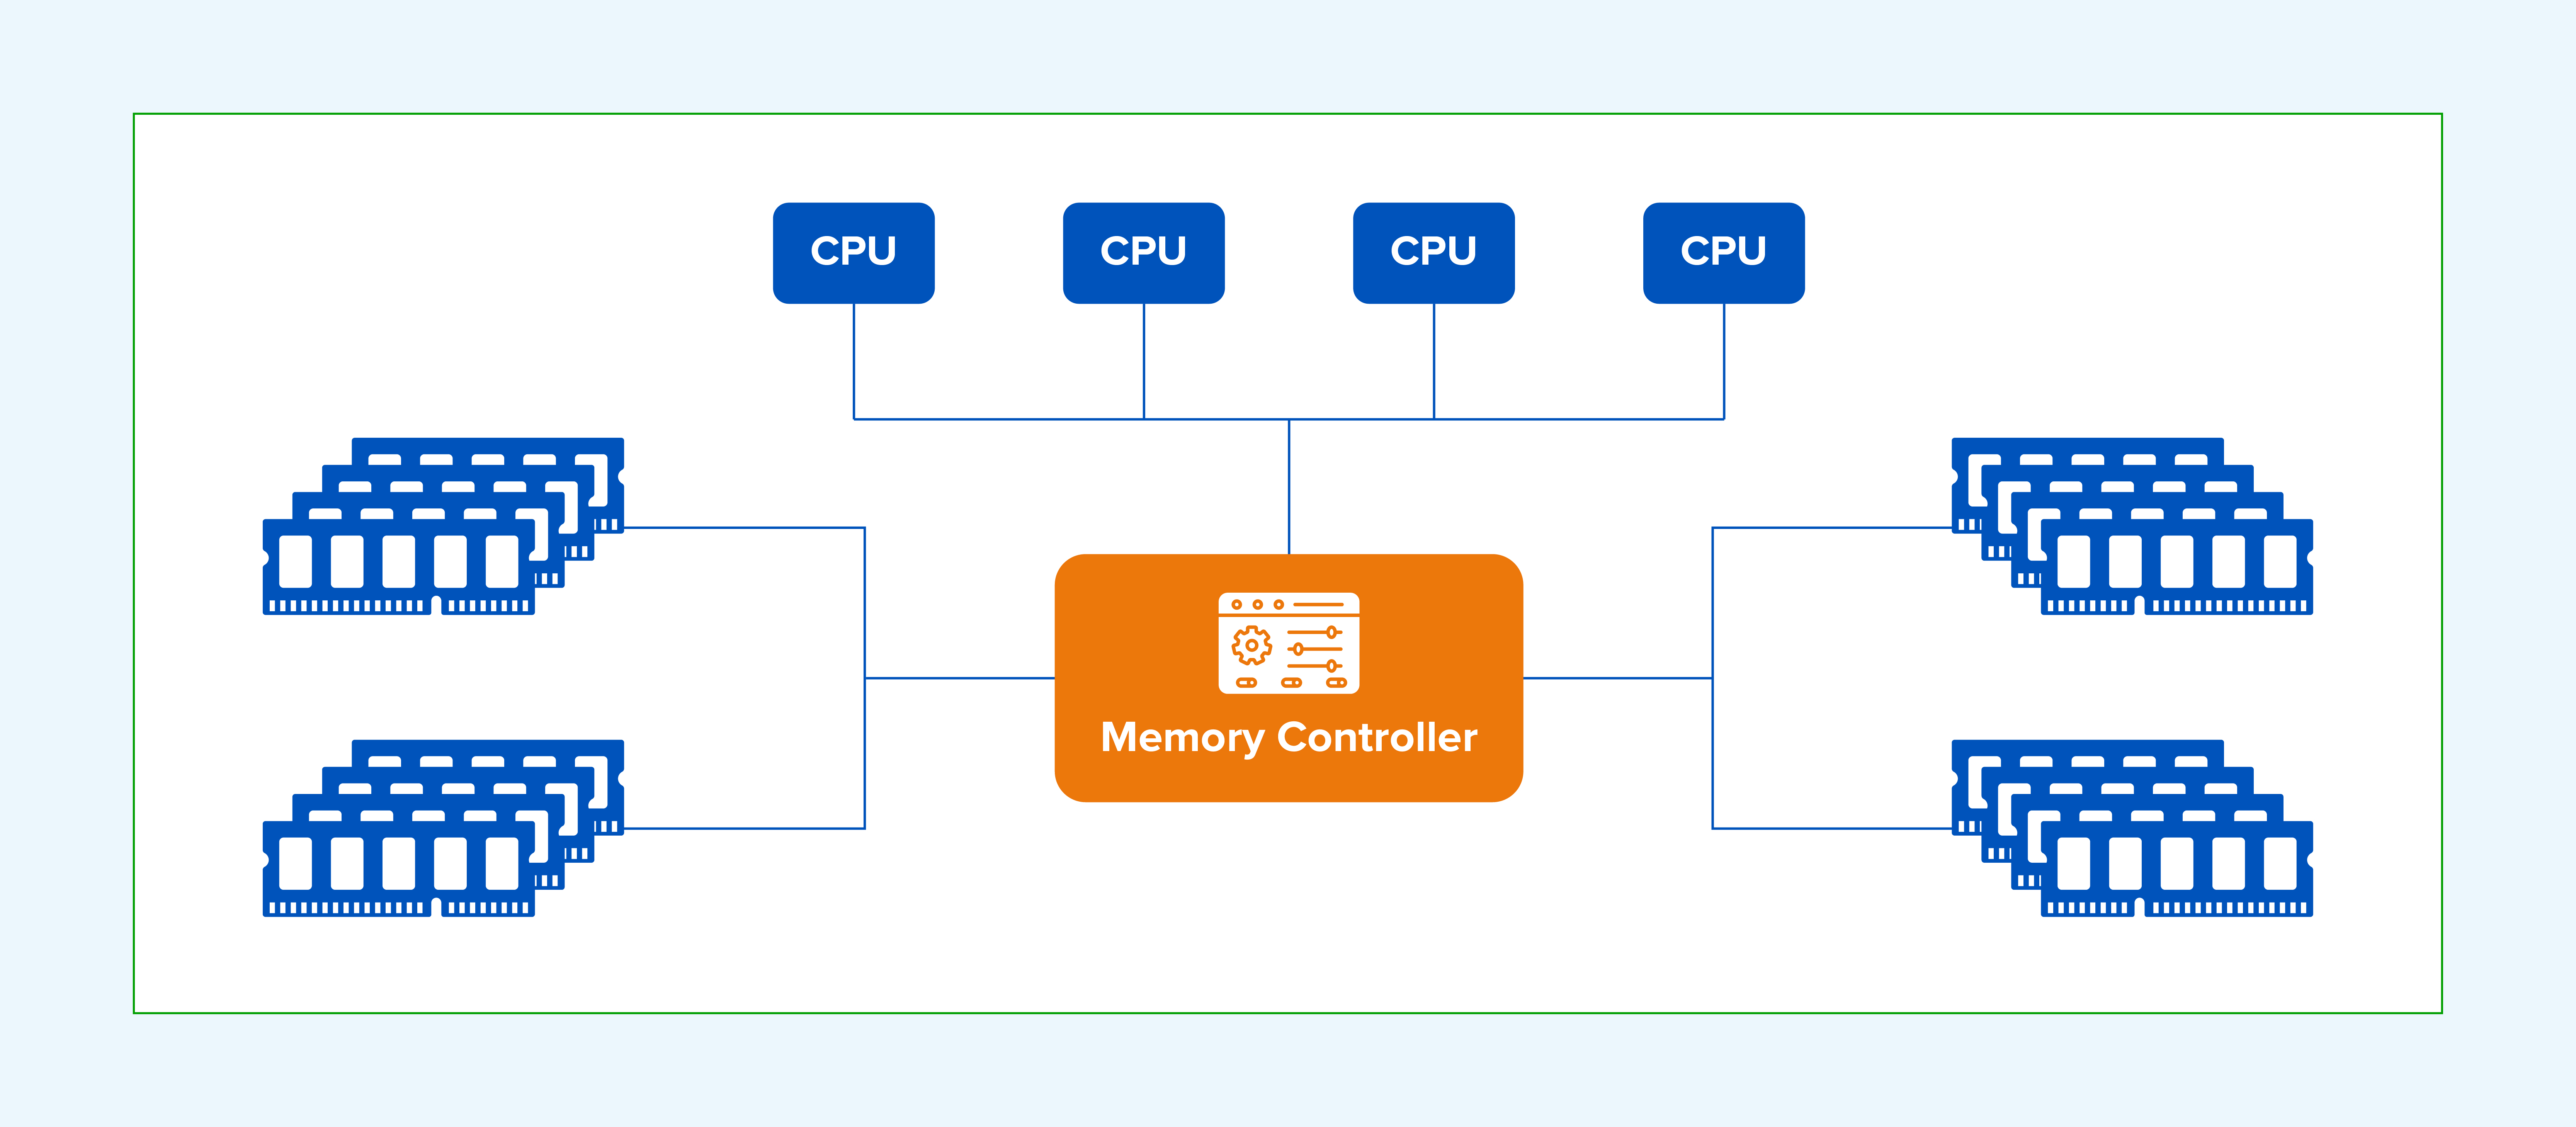
Figura 1. Collo di bottiglia nell'accesso alla memoria tramite bus condiviso nelle tradizionali architetture SMP.
NUMA nasce proprio per risolvere questo limite. In un'architettura NUMA, il sistema viene suddiviso in più nodi, ciascuno dei quali comprende uno o più processori, memoria locale e dispositivi di I/O.
I nodi comunicano tra loro attraverso interconnessioni ad alta velocità, come AMD HyperTransport o Intel QuickPath Interconnect (QPI), consentendo ai processori di accedere prioritariamente alla memoria locale. Questo riduce la latenza di accesso alla memoria e migliora le prestazioni complessive dei sistemi multiprocessore.
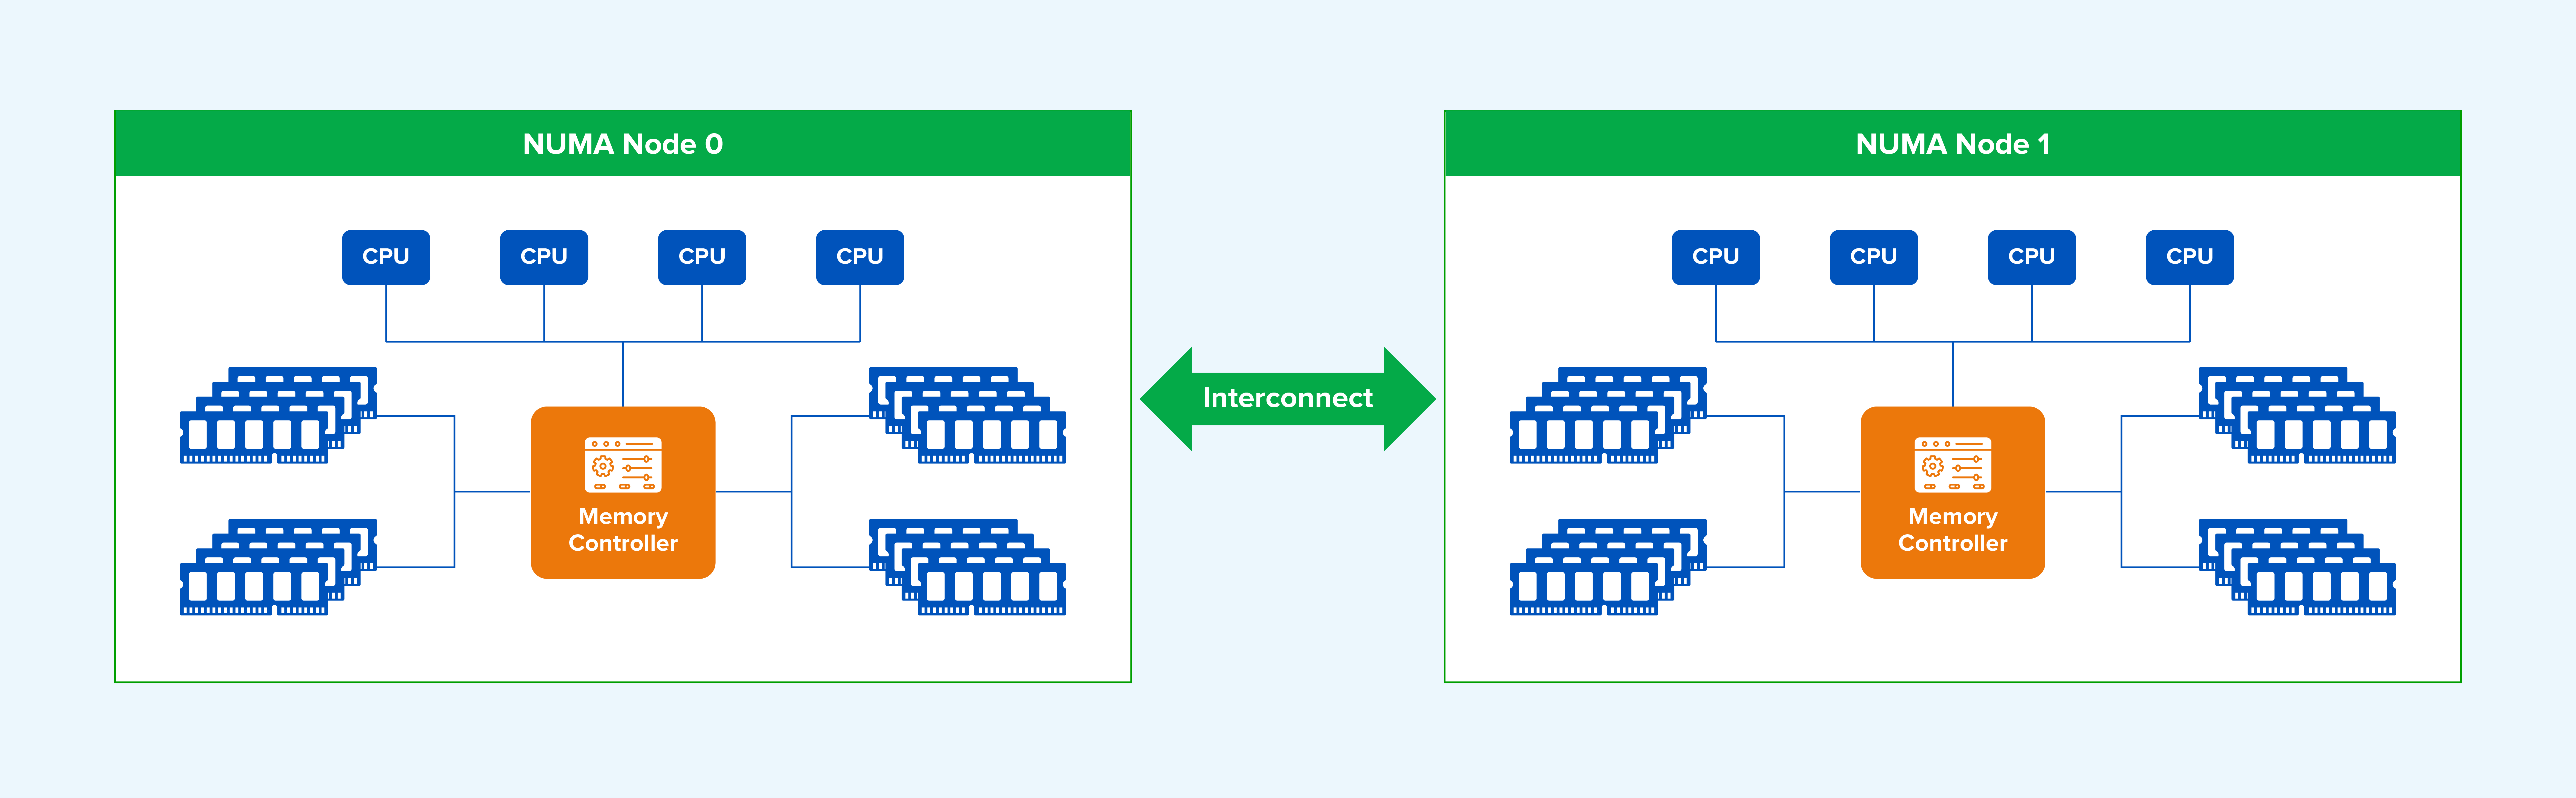
Figura 2: Architettura NUMA multi-nodo con CPU e memoria allocate localmente a ciascun nodo.
Un sistema NUMA comprende tre tipologie di nodi:
- Nodo locale (Local node): il nodo a cui appartengono le CPU in esecuzione.
- Nodo adiacente (Neighboring node): un nodo direttamente collegato al nodo locale.
- Nodo remoto (Remote node): qualsiasi nodo che non sia né locale né adiacente.
La velocità di accesso alla memoria varia in funzione del tipo di nodo. La memoria locale è la più veloce da raggiungere, mentre quella remota è la più lenta. In generale, la latenza aumenta all'aumentare della distanza topologica tra CPU e memoria.
Nel documento NUMA: An Overview, il Dr. Christoph Lameter osservava che, su un server high-end a due nodi del 2013, la latenza di accesso casuale alla memoria locale era di circa 100 ns, mentre l'accesso alla memoria remota comportava un incremento della latenza di circa il 50%.
PARTE 2. Le sfide introdotte dall'architettura NUMA
In Linux, un thread rappresenta l'unità fondamentale della pianificazione della CPU e corrisponde a un task presente nella coda di esecuzione di un processore. Il kernel assegna ogni task a una CPU relativamente poco occupata.
Poiché il carico delle CPU varia continuamente, il kernel utilizza meccanismi di load balancing per spostare le attività verso processori meno impegnati. Di conseguenza, per impostazione predefinita un task può migrare da una CPU a un'altra.
In un sistema NUMA, può quindi accadere che un task venga spostato da una CPU appartenente al Nodo 1 ad una CPU del Nodo 2, continuando però ad accedere alla memoria originariamente allocata sul Nodo 1. Questo comporta un accesso alla memoria tra nodi (cross-node), con un conseguente aumento della latenza.
Linux implementa un meccanismo di NUMA Balancing, che migra periodicamente task o pagine di memoria verso il nodo locale. Tuttavia, questo sistema non è in grado di eliminare completamente gli accessi alla memoria remota.
In un ambiente virtualizzato, ogni vCPU di una macchina virtuale corrisponde a un thread del sistema operativo host. Se più thread vCPU vengono eseguiti su nodi NUMA differenti pur condividendo la stessa memoria, oppure migrano tra nodi diversi durante l'esecuzione, la macchina virtuale finirà per accedere frequentemente alla memoria remota, con un conseguente aumento della latenza.
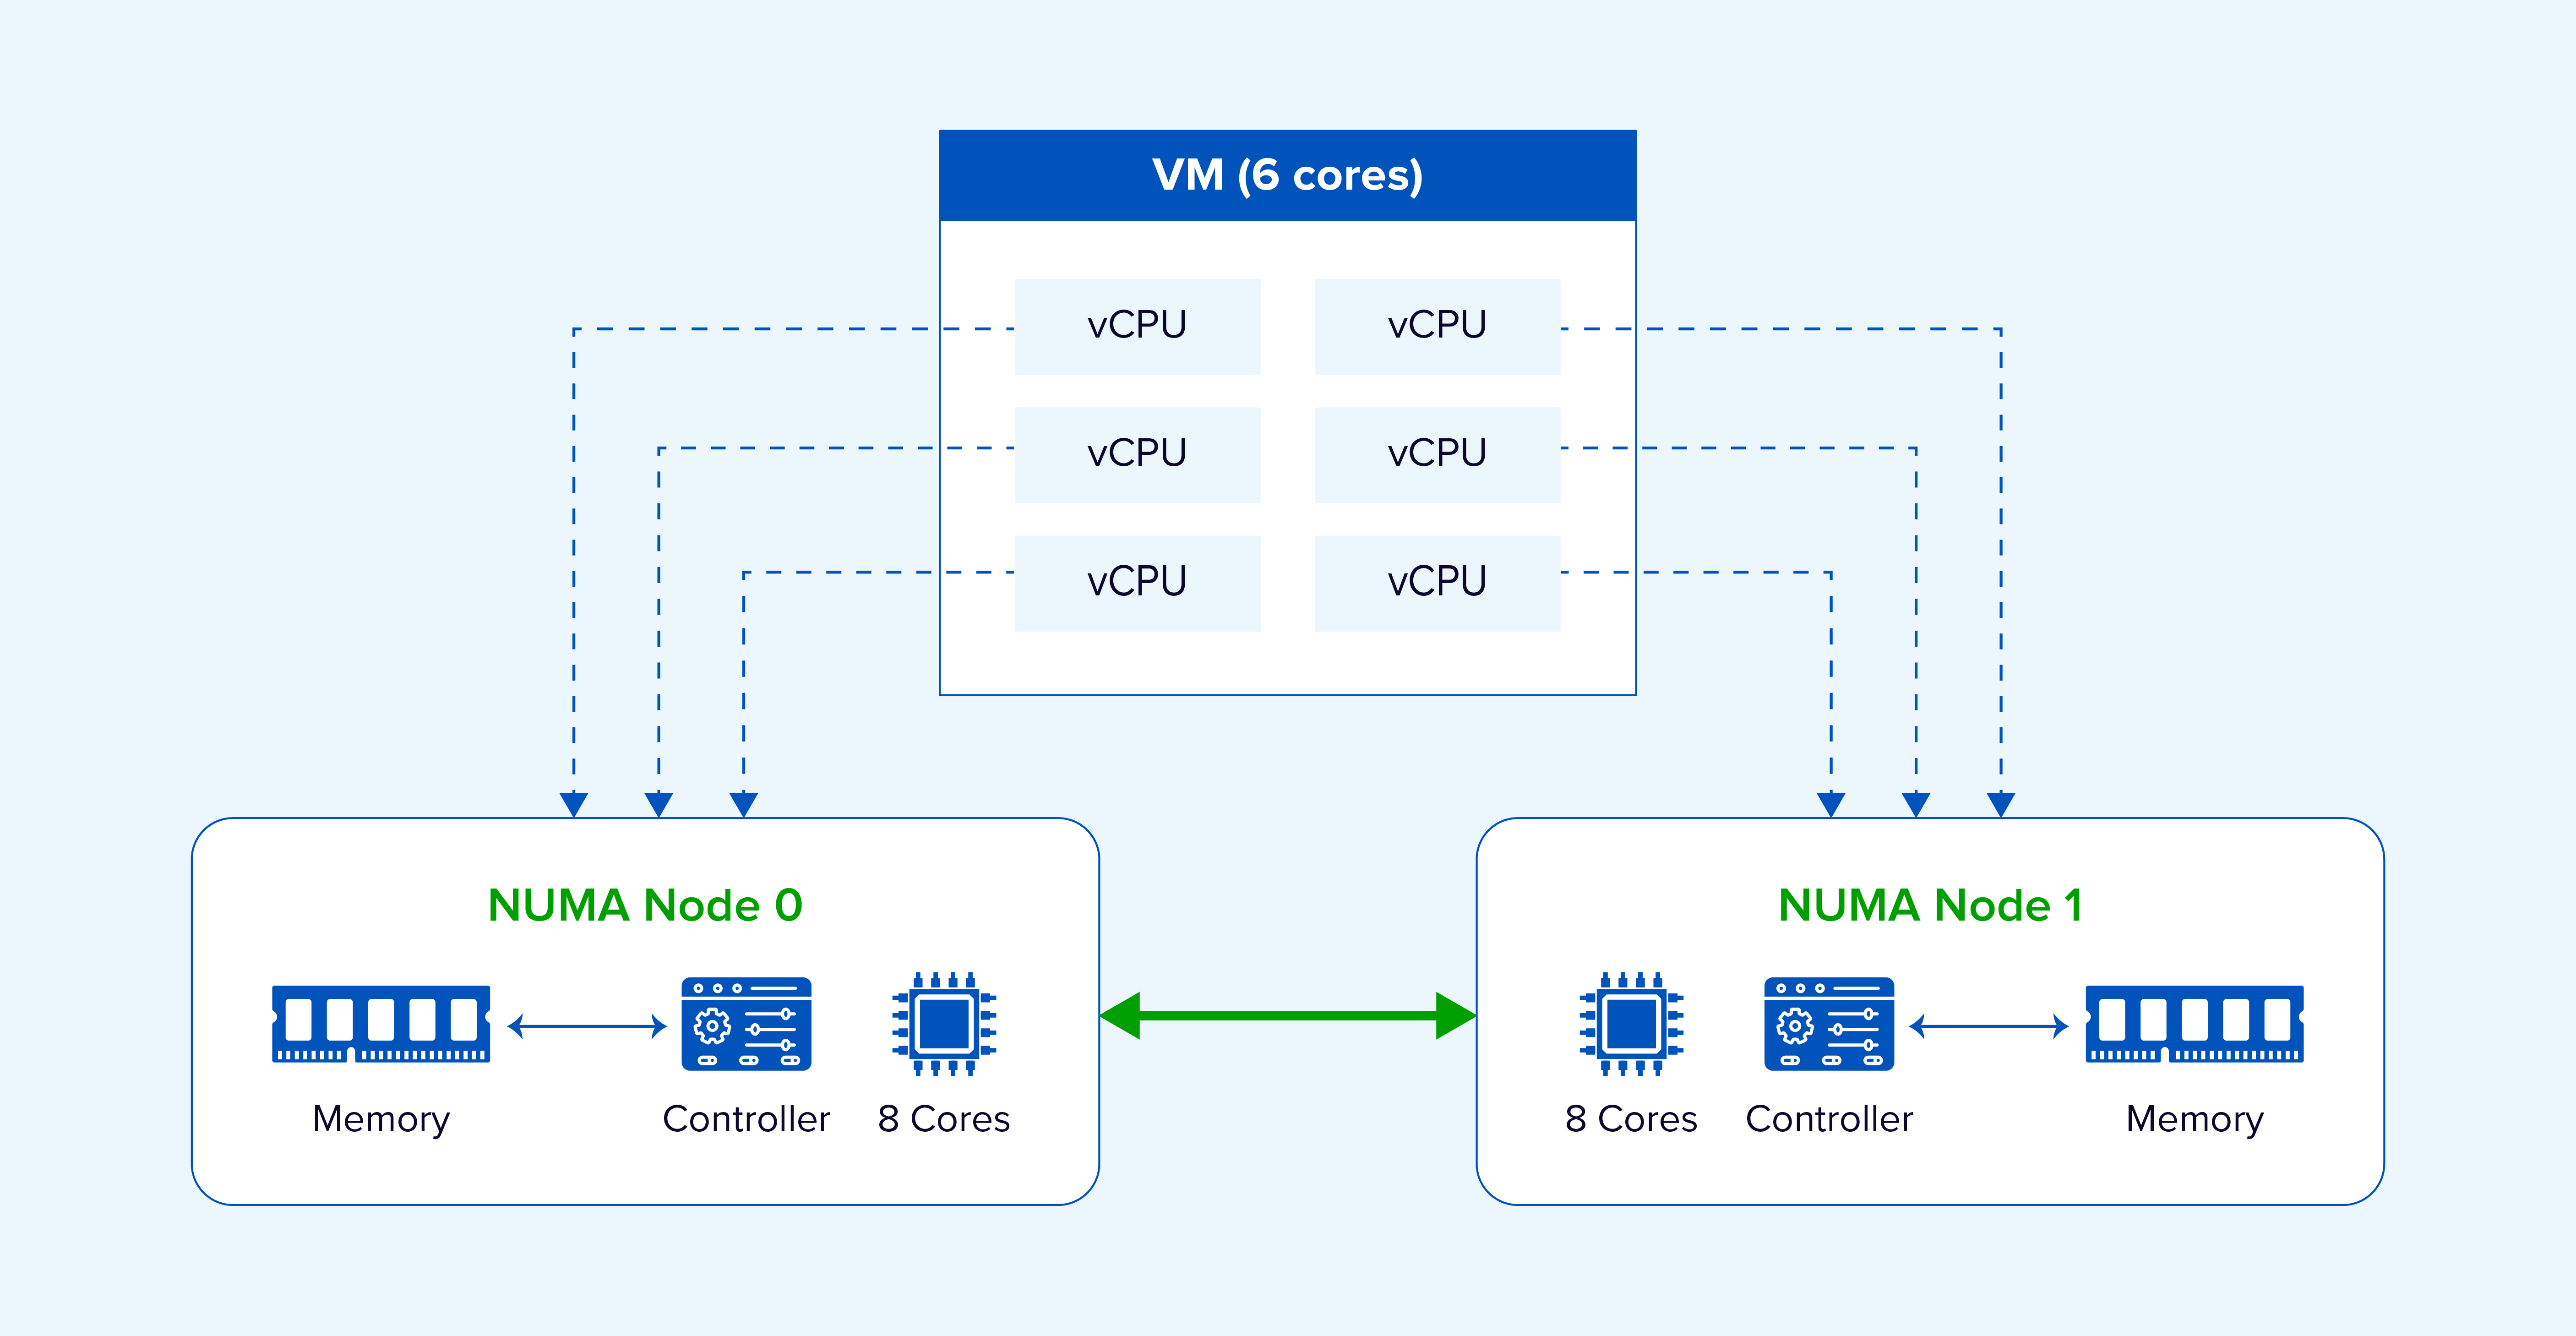
Figura 3. L'esecuzione su nodi differenti può aumentare gli accessi alla memoria remota da parte di una macchina virtuale.
PARTE 3. I principali approcci di scheduling NUMA
Nel settore vengono comunemente adottati tre approcci per la gestione delle risorse NUMA.
Approccio 1 – Pinning delle vCPU ai core fisici
L'amministratore configura manualmente il pinning delle vCPU affinché le risorse della macchina virtuale vengano eseguite preferibilmente all'interno dello stesso nodo NUMA fisico.
Approccio 2 – Definizione del numero di nodi NUMA assegnati alla VM
L'admin configura manualmente il numero di nodi NUMA assegnati alla macchina virtuale, distribuendo in modo uniforme vCPU e memoria tra i diversi nodi.
Approccio 3 – Allocazione NUMA adattiva
Lo scheduler assegna automaticamente alla VM i nodi NUMA più appropriati.
Le CPU della macchina virtuale vengono vincolate a tali nodi e utilizzano preferenzialmente la memoria locale, migliorando la località dei dati (memory locality).
Se il numero di vCPU supera la capacità di un singolo nodo NUMA, la VM viene distribuita su più nodi. Inoltre, la topologia NUMA virtuale (vNUMA) può essere esposta al sistema operativo guest affinché quest'ultimo possa prendere decisioni ottimizzate in base alla topologia disponibile.
Le macchine virtuali possono anche essere migrate tra nodi NUMA per mantenere un corretto bilanciamento del carico.
I primi due approcci risultano piuttosto rigidi, richiedono un dimensionamento accurato delle CPU delle VM e possono creare squilibri tra i nodi NUMA a causa dei vincoli statici.
Per questo motivo, l'allocazione adattiva rappresenta generalmente la soluzione più adatta agli ambienti di produzione dinamici.
PARTE 4. Lo scheduling NUMA di Sangfor nel dettaglio
Sangfor HCI utilizza principalmente uno scheduling NUMA adattivo. Questo approccio bilancia l'utilizzo dei nodi NUMA riducendo al contempo gli accessi alla memoria remota da parte delle vCPU delle macchine virtuali, migliorando così le prestazioni complessive del sistema.
Lo scheduling NUMA adattivo offre evidenti vantaggi di ottimizzazione per diversi tipi di applicazioni, in particolare per i middleware che eseguono frequenti operazioni in memoria. Sangfor ha distribuito DM8, Redis e Memcached in macchine virtuali e ne ha misurato le prestazioni con lo scheduling NUMA abilitato e disabilitato. I risultati hanno evidenziato un netto miglioramento delle prestazioni dei middleware con lo scheduling NUMA attivo.
Carichi di lavoro su database: Dameng DB (DM8) con BenchmarkSQL
BenchmarkSQL è uno strumento di benchmark per database relazionali che esegue un insieme di transazioni ispirato al benchmark TPC-C, comprendente nuovi ordini, pagamenti, interrogazioni sullo stato degli ordini, consegne e verifiche del livello delle scorte. La metrica risultante, denominata tpmC, rappresenta il numero di transazioni "New Order" elaborate ogni minuto; un valore più elevato indica prestazioni migliori. Per i test sul database DM8 è stato utilizzato BenchmarkSQL 5.0. Il grafico seguente mostra le prestazioni relative, assumendo come riferimento pari al 100% il valore di tpmC ottenuto con NUMA disabilitato.
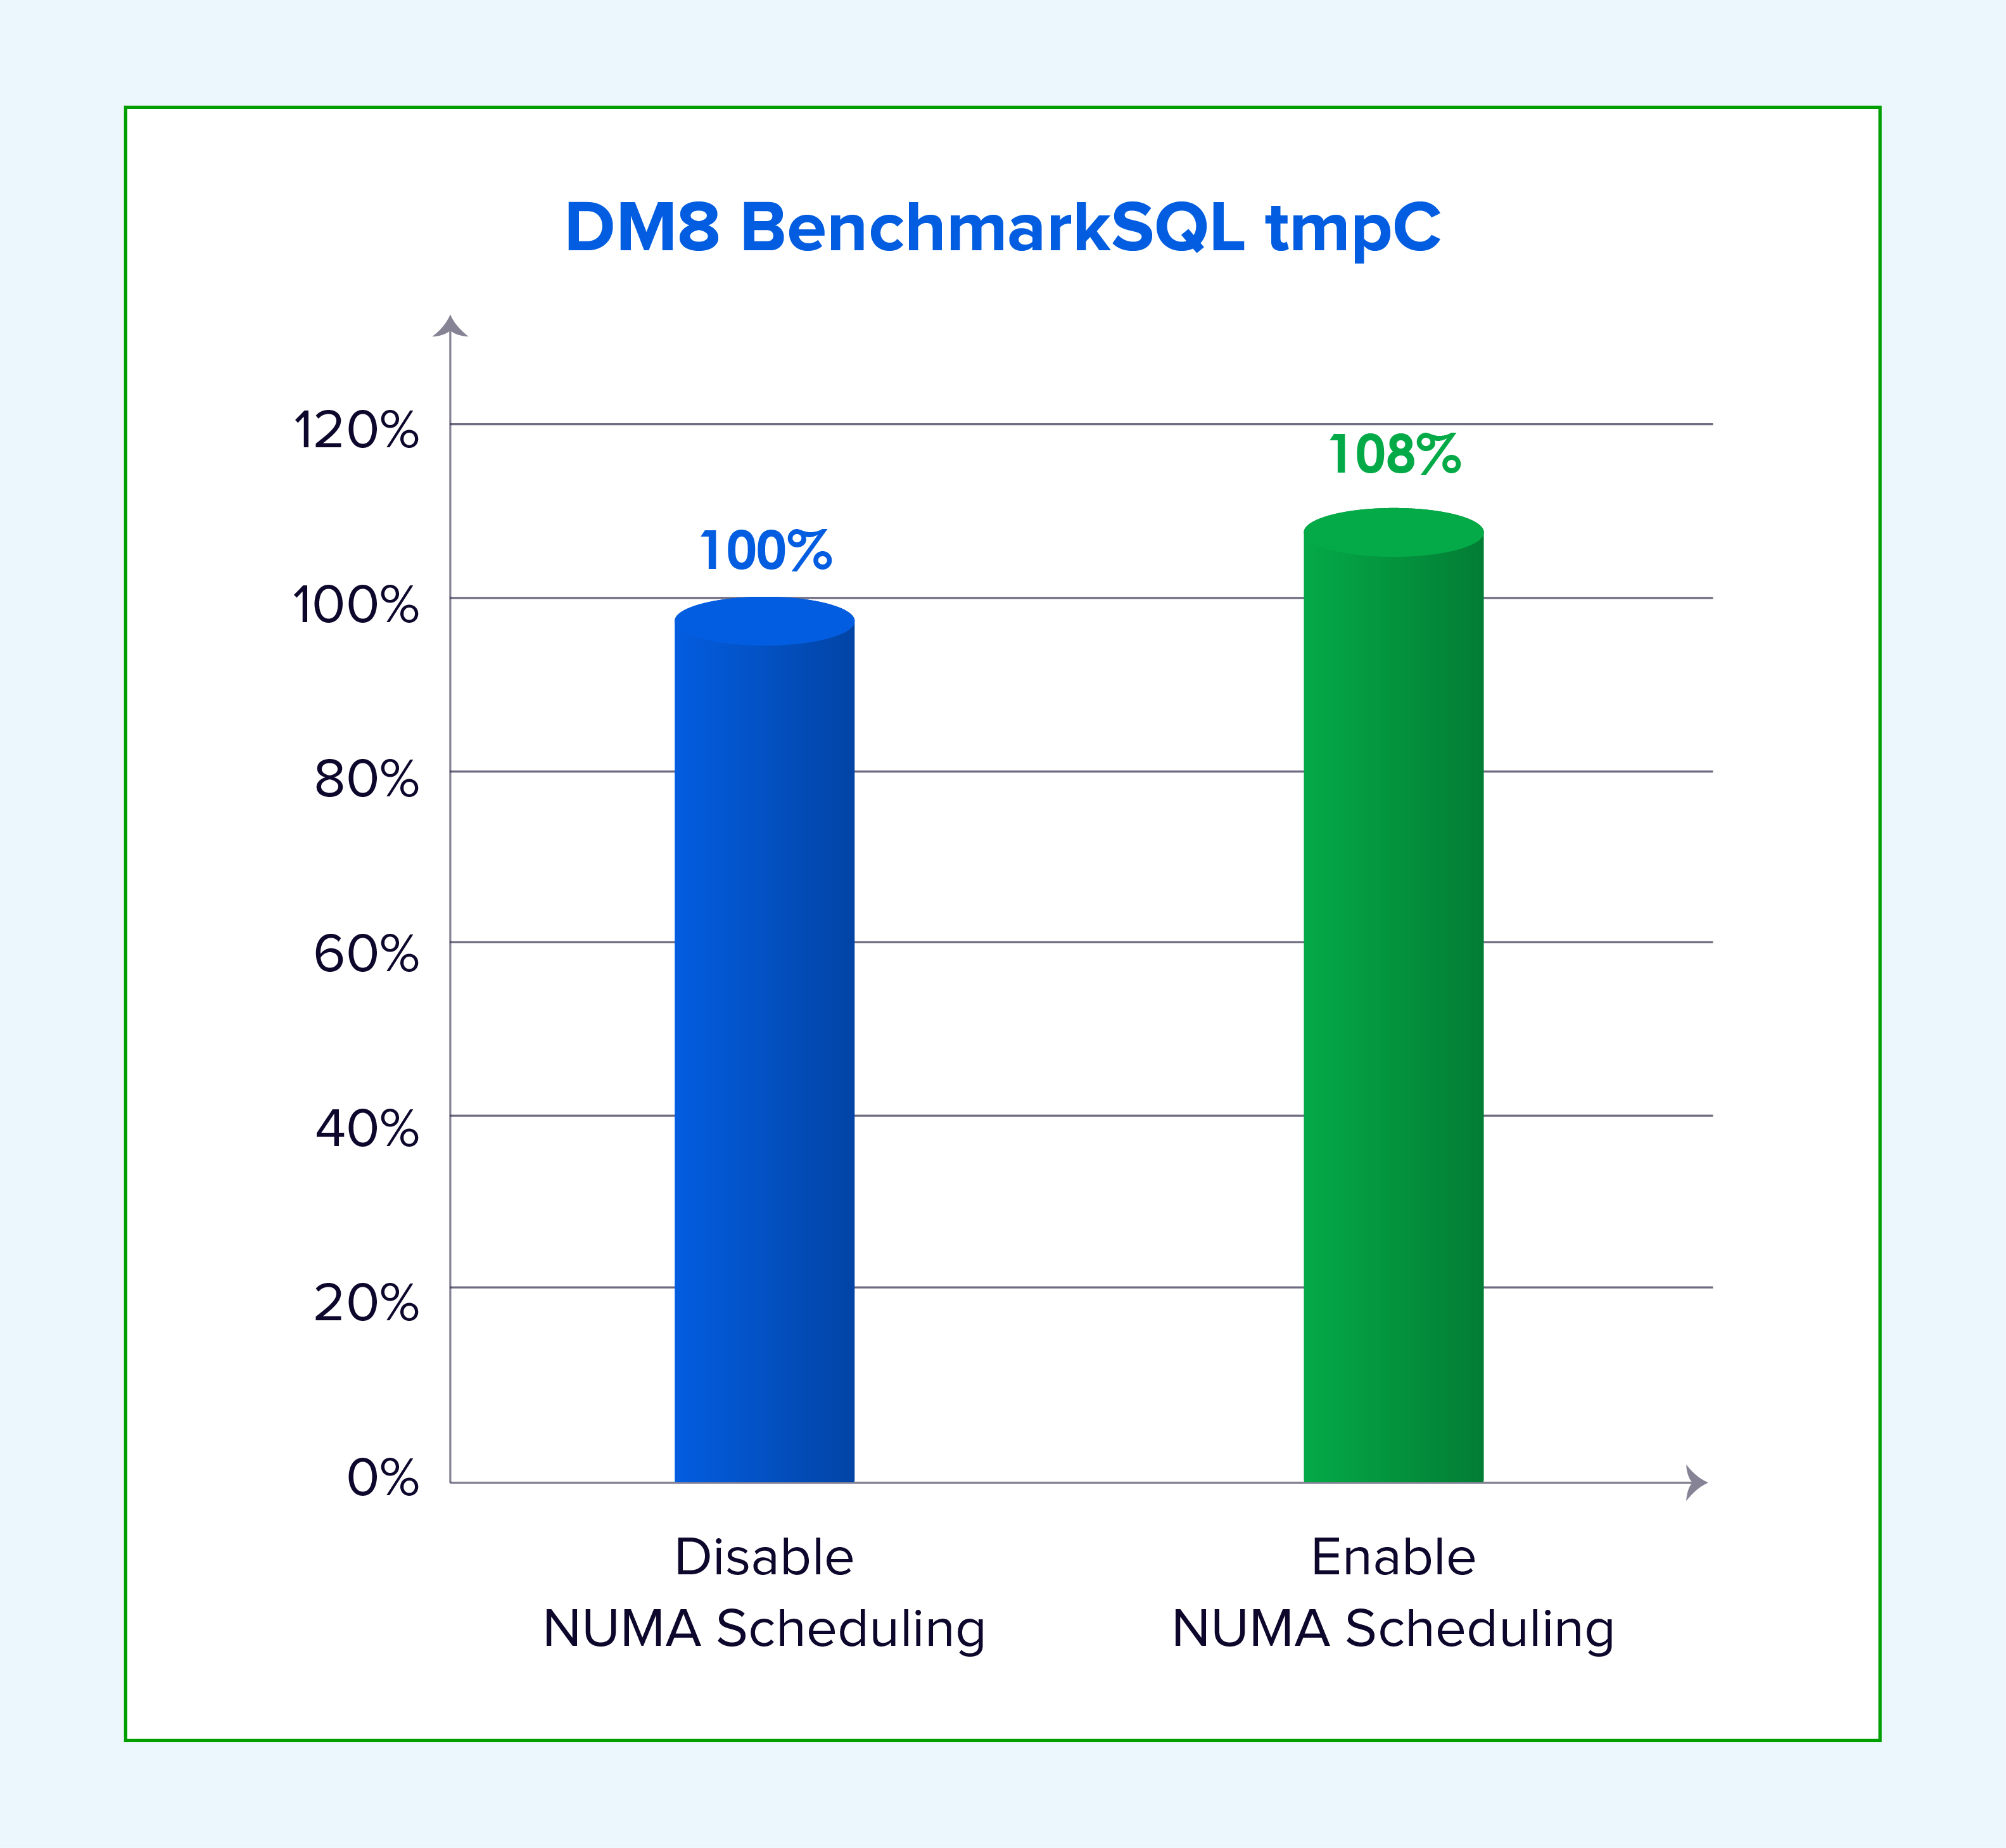
Figura 4. Throughput transazionale relativo di DM8 con scheduling NUMA abilitato e disabilitato.
Caching in-memory: Redis 7.2.5
redis-benchmark è lo strumento ufficiale per la misurazione delle prestazioni di Redis. Sangfor lo ha utilizzato per testare il QPS delle operazioni GET e SET su valori da 1 KB, confrontando le configurazioni con scheduling NUMA disabilitato e abilitato. Il QPS (Queries Per Second) rappresenta il numero di operazioni di lettura o scrittura eseguite ogni secondo.
redis-benchmark -t get -d 16 -c 100 -n 6000000 -r 60000000
redis-benchmark -t set -d 16 -c 100 -n 6000000 -r 60000000
Il grafico seguente mostra le prestazioni relative, assumendo come riferimento pari al 100% il valore di QPS ottenuto con NUMA disabilitato.
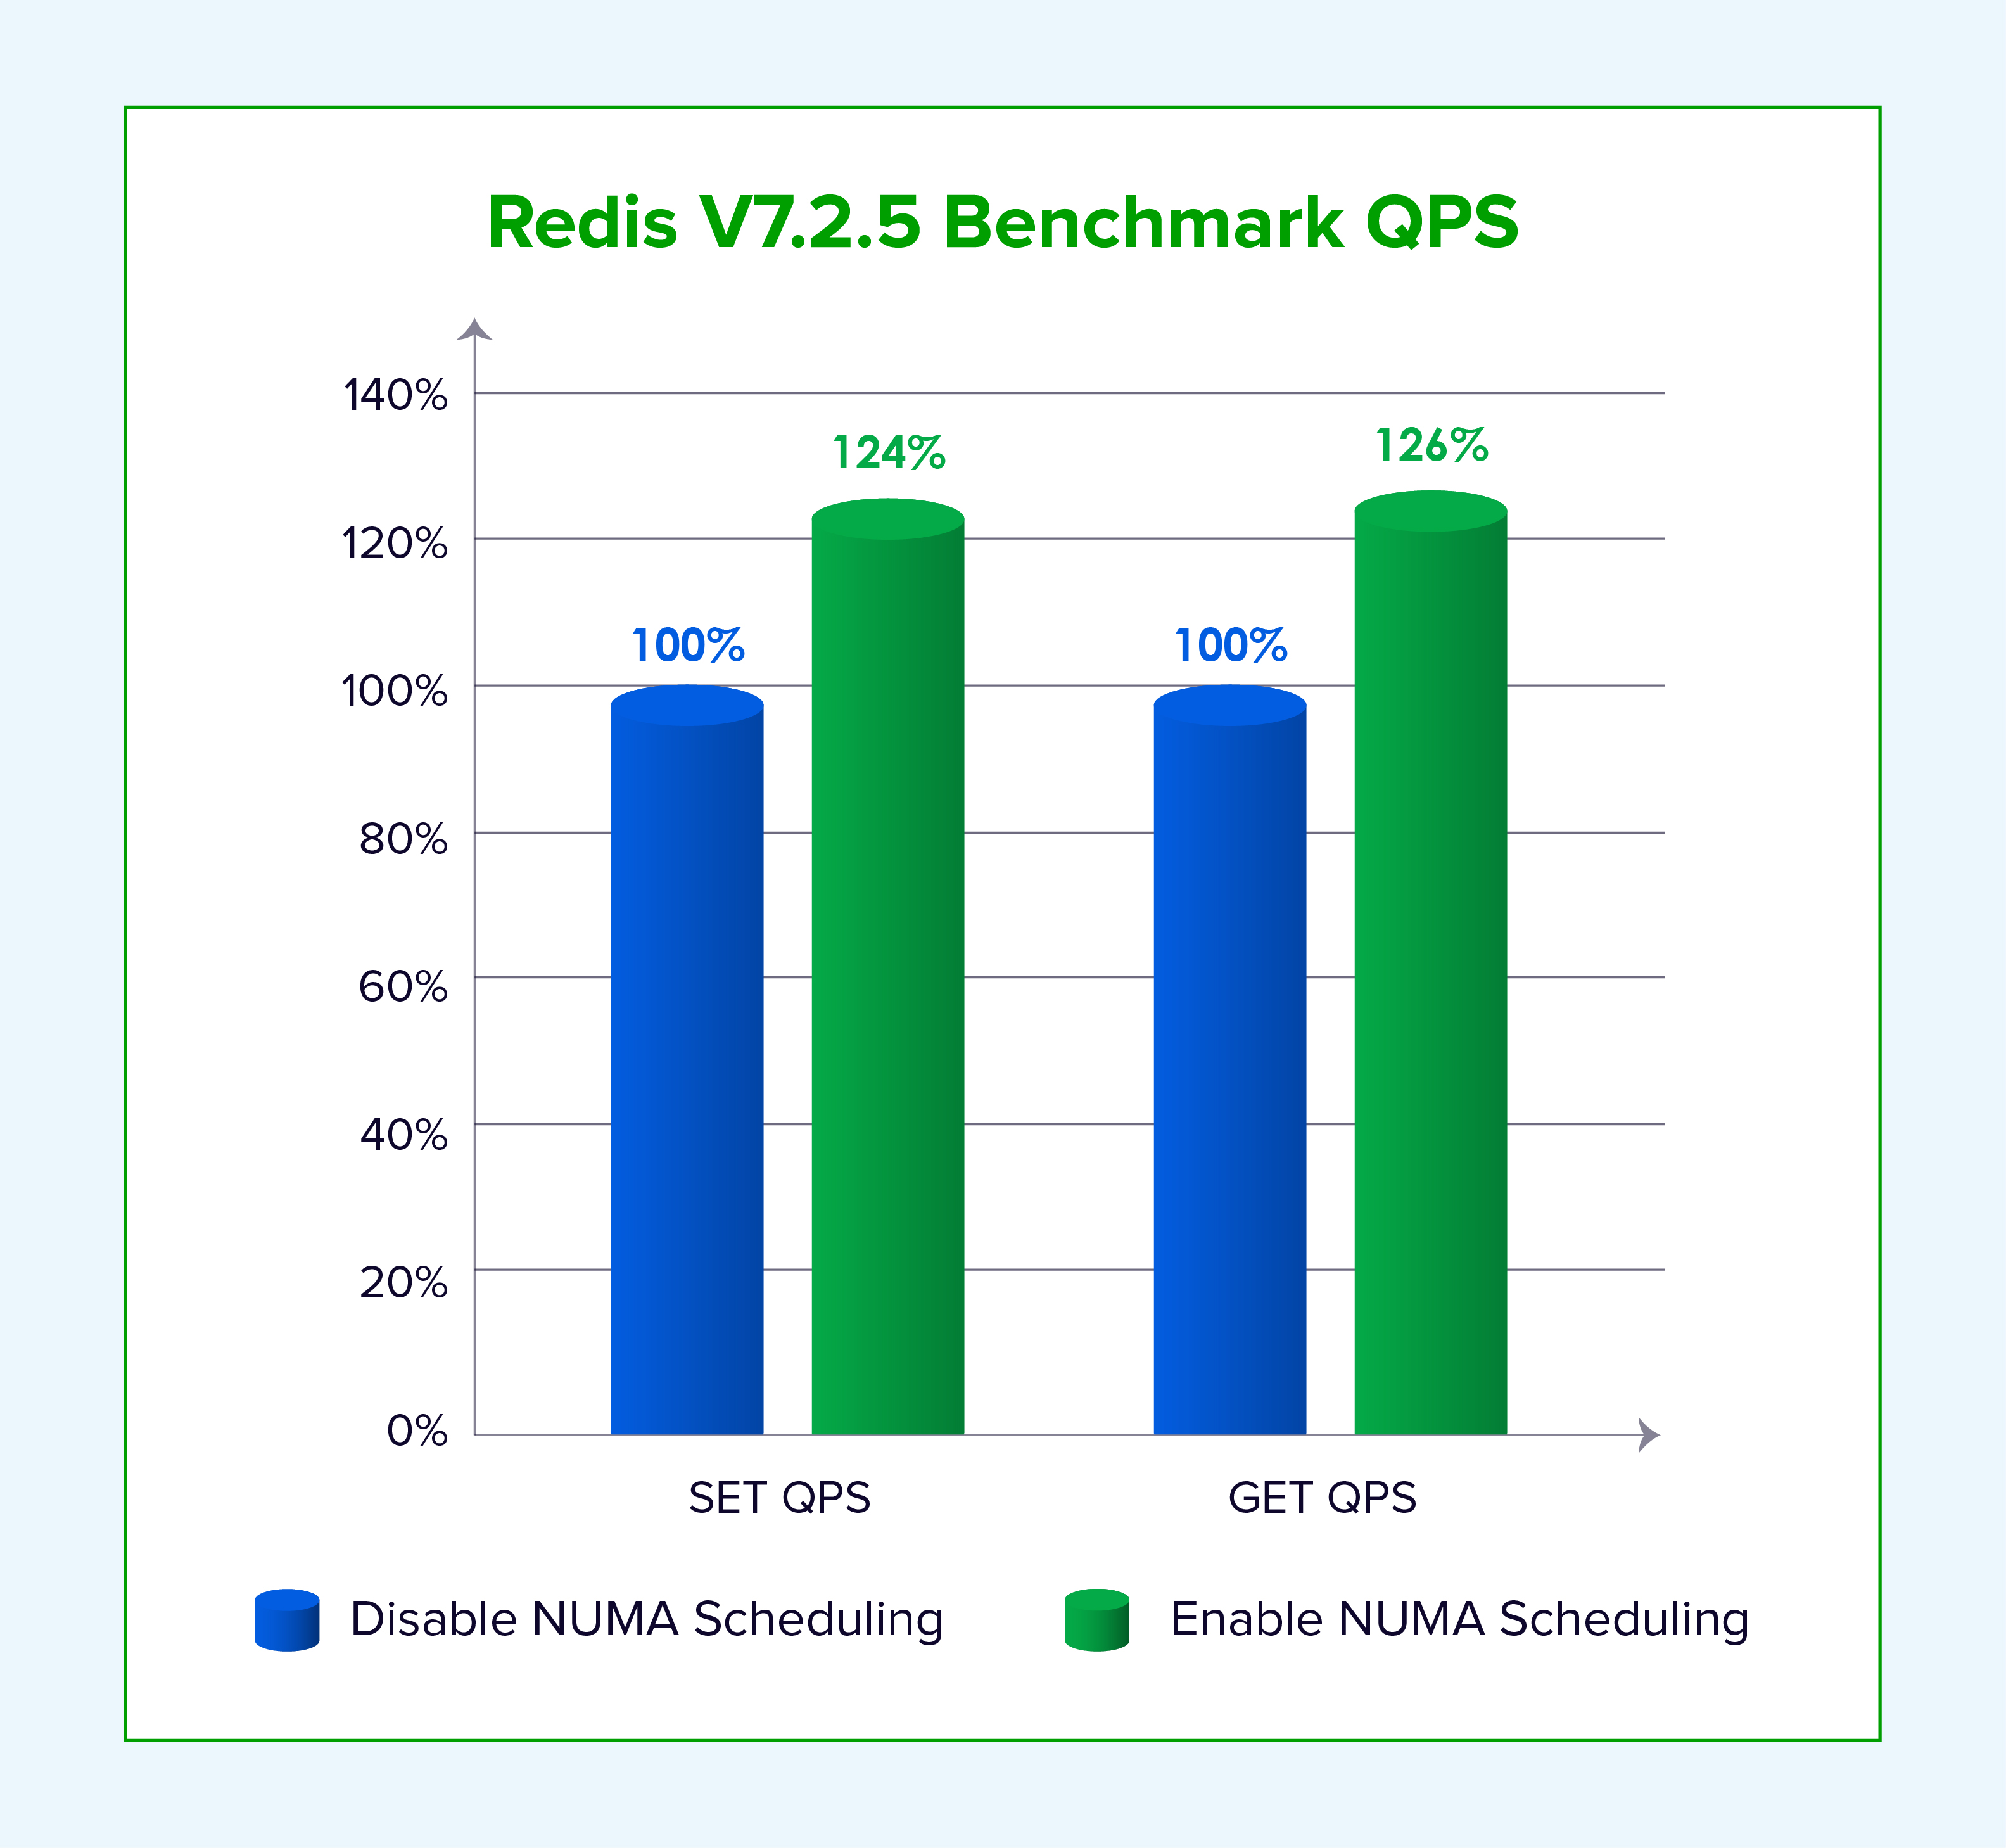
Figura 5. Incremento relativo delle prestazioni Redis (QPS in lettura e scrittura) con scheduling NUMA abilitato.
Caching key-value: Memcached 6.27
memaslap è uno strumento di benchmark incluso in Memcached. Sangfor lo ha utilizzato per misurare il TPS su valori da 1 KB con lo scheduling NUMA disabilitato e abilitato. Il TPS (Transactions Per Second) rappresenta il numero di transazioni elaborate ogni secondo.
memaslap -s 127.0.0.1:11211 -t 300s -T 8
Il grafico seguente mostra le prestazioni relative, assumendo come riferimento pari al 100% il valore di TPS ottenuto con NUMA disabilitato.
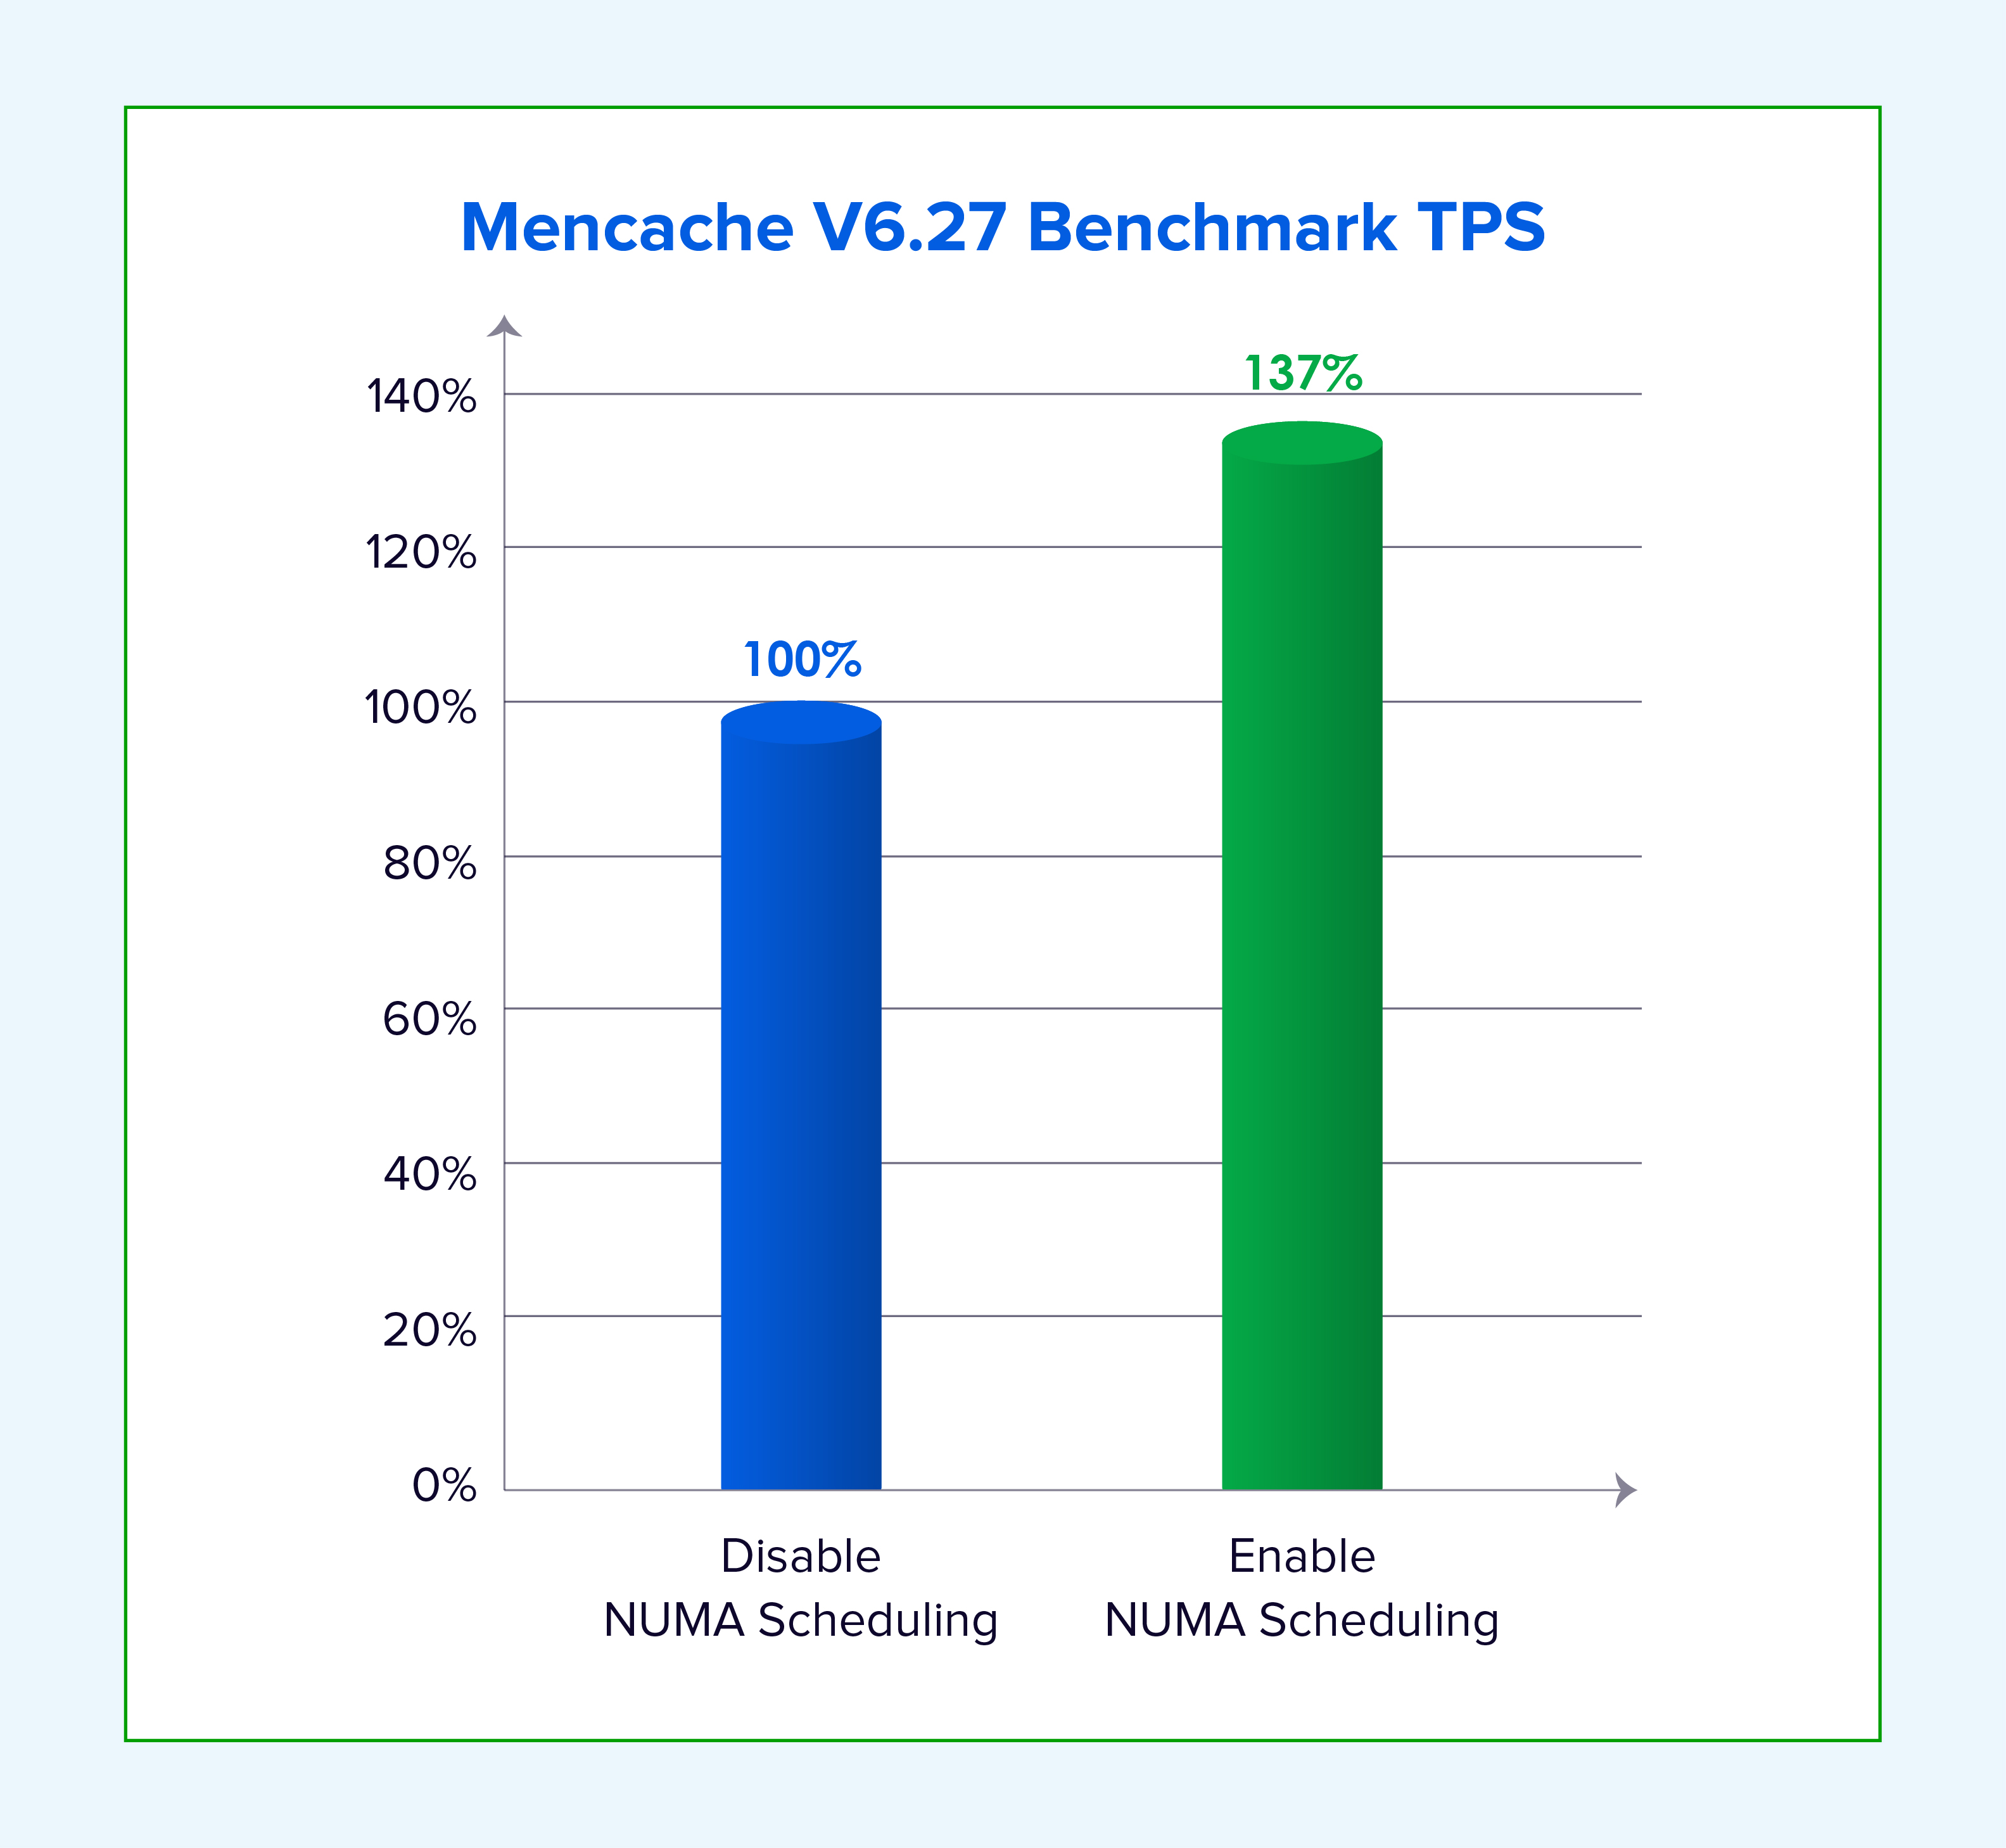
Figura 6. Incremento relativo del throughput transazionale di Memcached con scheduling NUMA abilitato.
I risultati riportati sopra evidenziano chiaramente i vantaggi per le applicazioni ad alta intensità di memoria. Le sezioni seguenti spiegano nel dettaglio il funzionamento delle ottimizzazioni.
1. Allocazione adattiva dei nodi NUMA
Sangfor suddivide in modo adattivo le vCPU delle macchine virtuali e le pianifica sui nodi NUMA più appropriati per ridurre gli accessi alla memoria remota. Se il numero di vCPU di una VM è inferiore al numero di core disponibili in un singolo nodo NUMA, la macchina virtuale viene pianificata su un unico nodo. Se invece la VM richiede un numero di core superiore a quello disponibile in un singolo nodo, viene distribuita su più nodi e la topologia vNUMA viene esposta al sistema operativo guest affinché possa effettuare decisioni consapevoli della topologia.
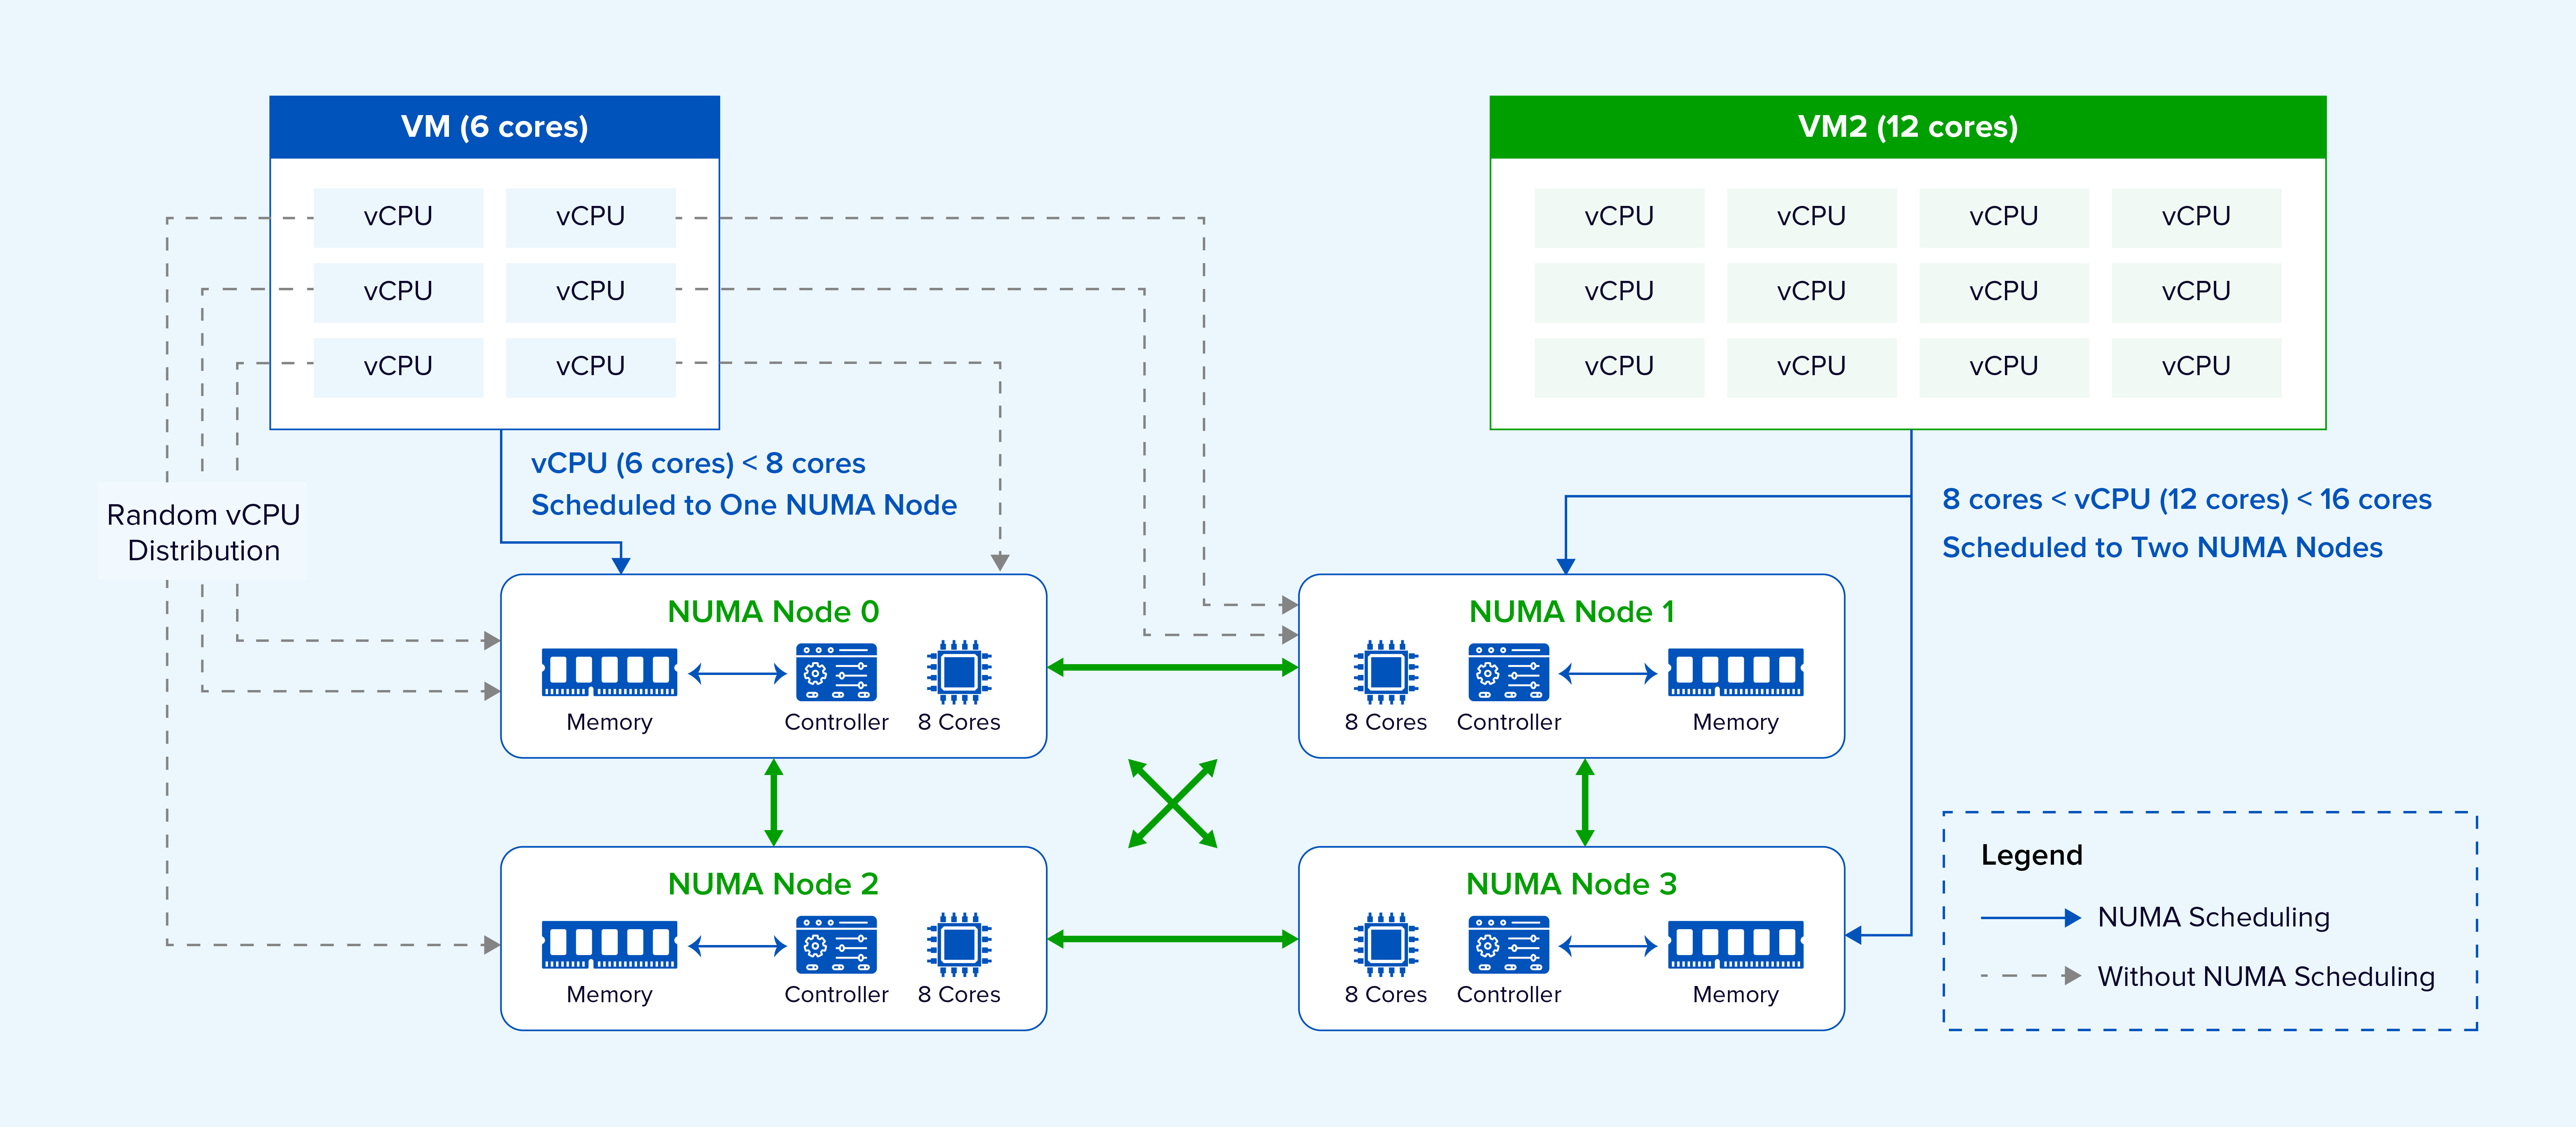
Figura 7. Partizionamento intelligente delle vCPU e mappatura della topologia vNUMA in Sangfor.
Per mantenere un utilizzo bilanciato delle risorse, il posizionamento delle macchine virtuali tiene conto del carico corrente dei diversi nodi NUMA e seleziona preferenzialmente quelli meno occupati. Durante l'esecuzione, le VM possono essere migrate tra nodi NUMA in funzione delle variazioni del carico. Le macchine virtuali prioritarie vengono collocate preferenzialmente sui nodi meno contesi, riducendo la competizione per CPU, larghezza di banda della memoria e risorse della cache.
2. Ottimizzazione per piattaforme server eterogenee
Alcune piattaforme server sono caratterizzate da un numero elevato di nodi NUMA, da distanze differenti tra i nodi e da un numero relativamente ridotto di core per ciascun nodo.
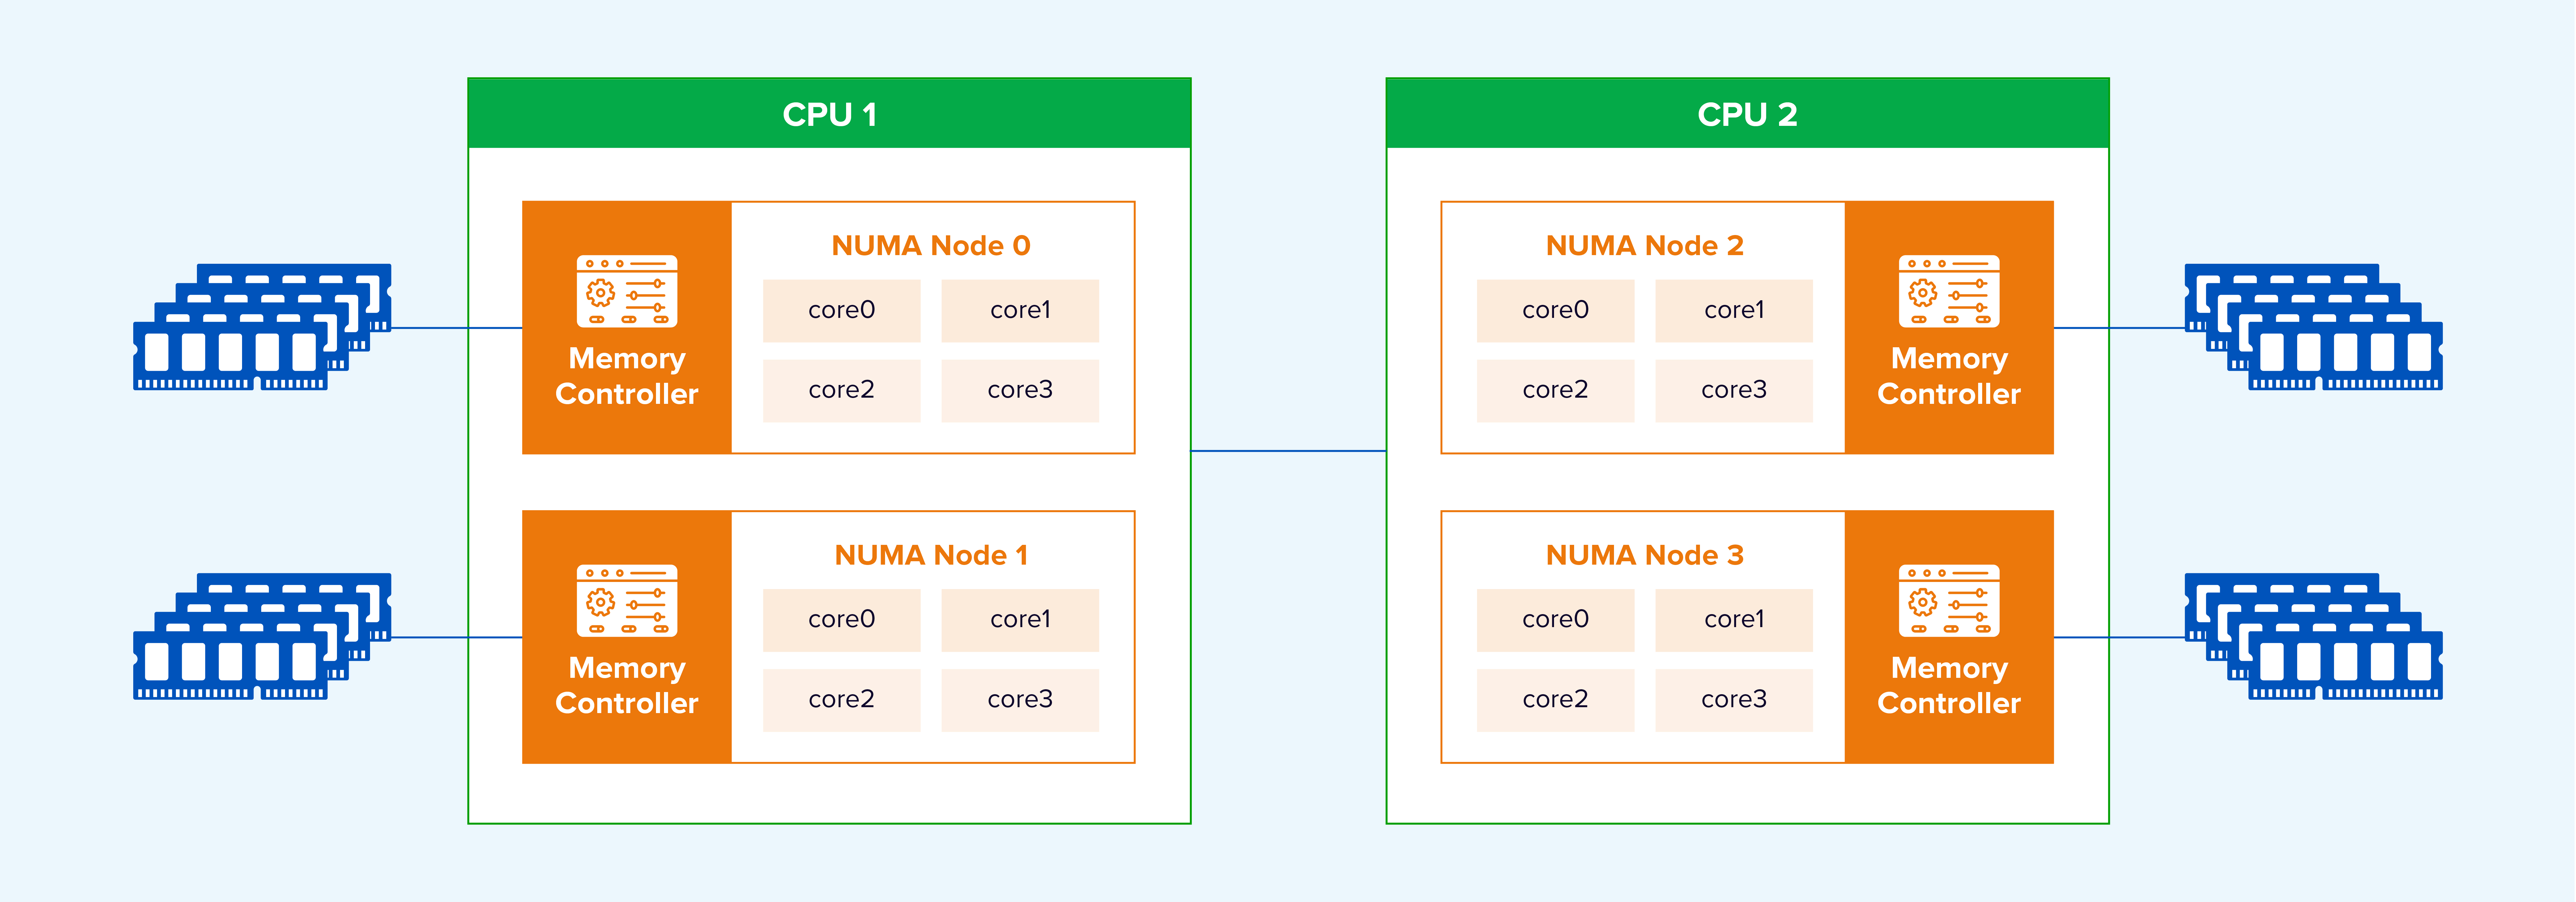
Figura 8. Posizionamento della topologia vNUMA su un server multi-nodo in funzione della topologia fisica.
Sangfor identifica la distanza tra i nodi NUMA e colloca preferenzialmente più nodi vNUMA appartenenti alla stessa macchina virtuale su nodi NUMA fisici tra loro vicini.
Per migliorare ulteriormente le prestazioni nell'instradamento dei dati, Sangfor ha sviluppato un meccanismo di affinità NUMA tra le macchine virtuali e i processi del data plane. La VM e il relativo processo di inoltro dei dati vengono pianificati sullo stesso nodo NUMA, aumentando la percentuale di accessi alla memoria locale. Nella figura seguente, DP indica il processo del data plane.
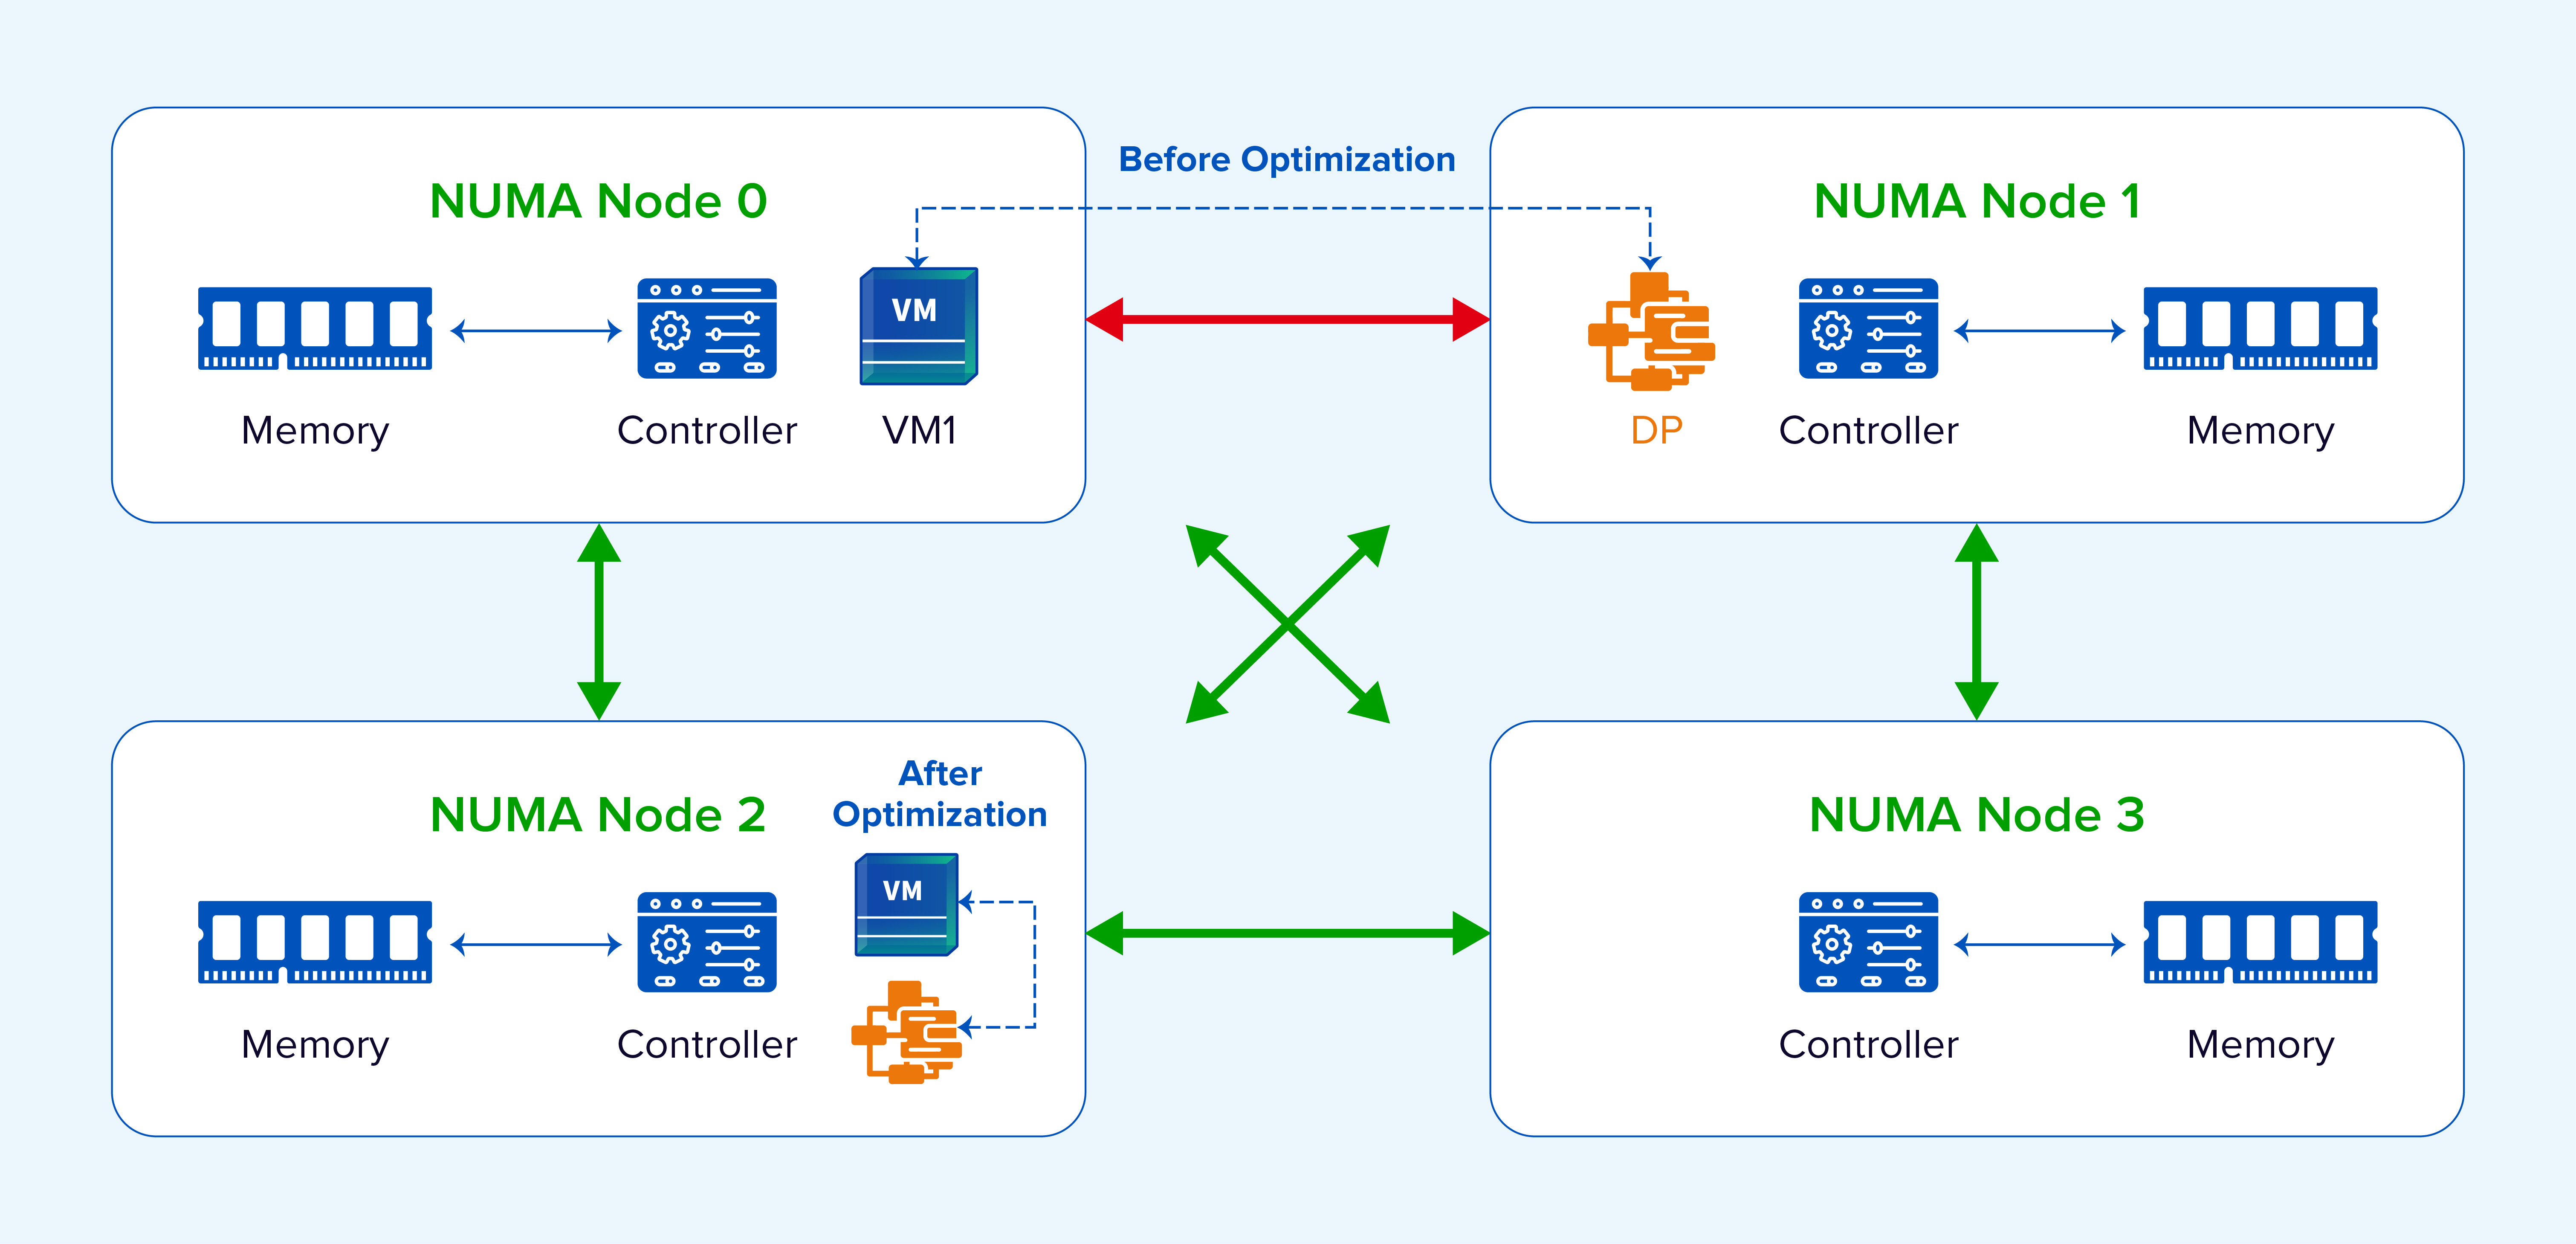
Figura 9. Affinità tra macchina virtuale e data plane per mantenere l'elaborazione in prossimità della memoria locale.
Per sfruttare al massimo i vantaggi dell'architettura NUMA anche nello storage, Sangfor colloca sullo stesso nodo NUMA la vCPU, QEMU, libnfs, aSAN e gli altri processi coinvolti nell'intero percorso di I/O. In questo modo vengono evitati gli accessi alla memoria remota. L'utilizzo di pagine di memoria di grandi dimensioni migliora ulteriormente le prestazioni di accesso alla memoria, riduce l'overhead di elaborazione e aumenta l'efficienza del flusso di I/O.
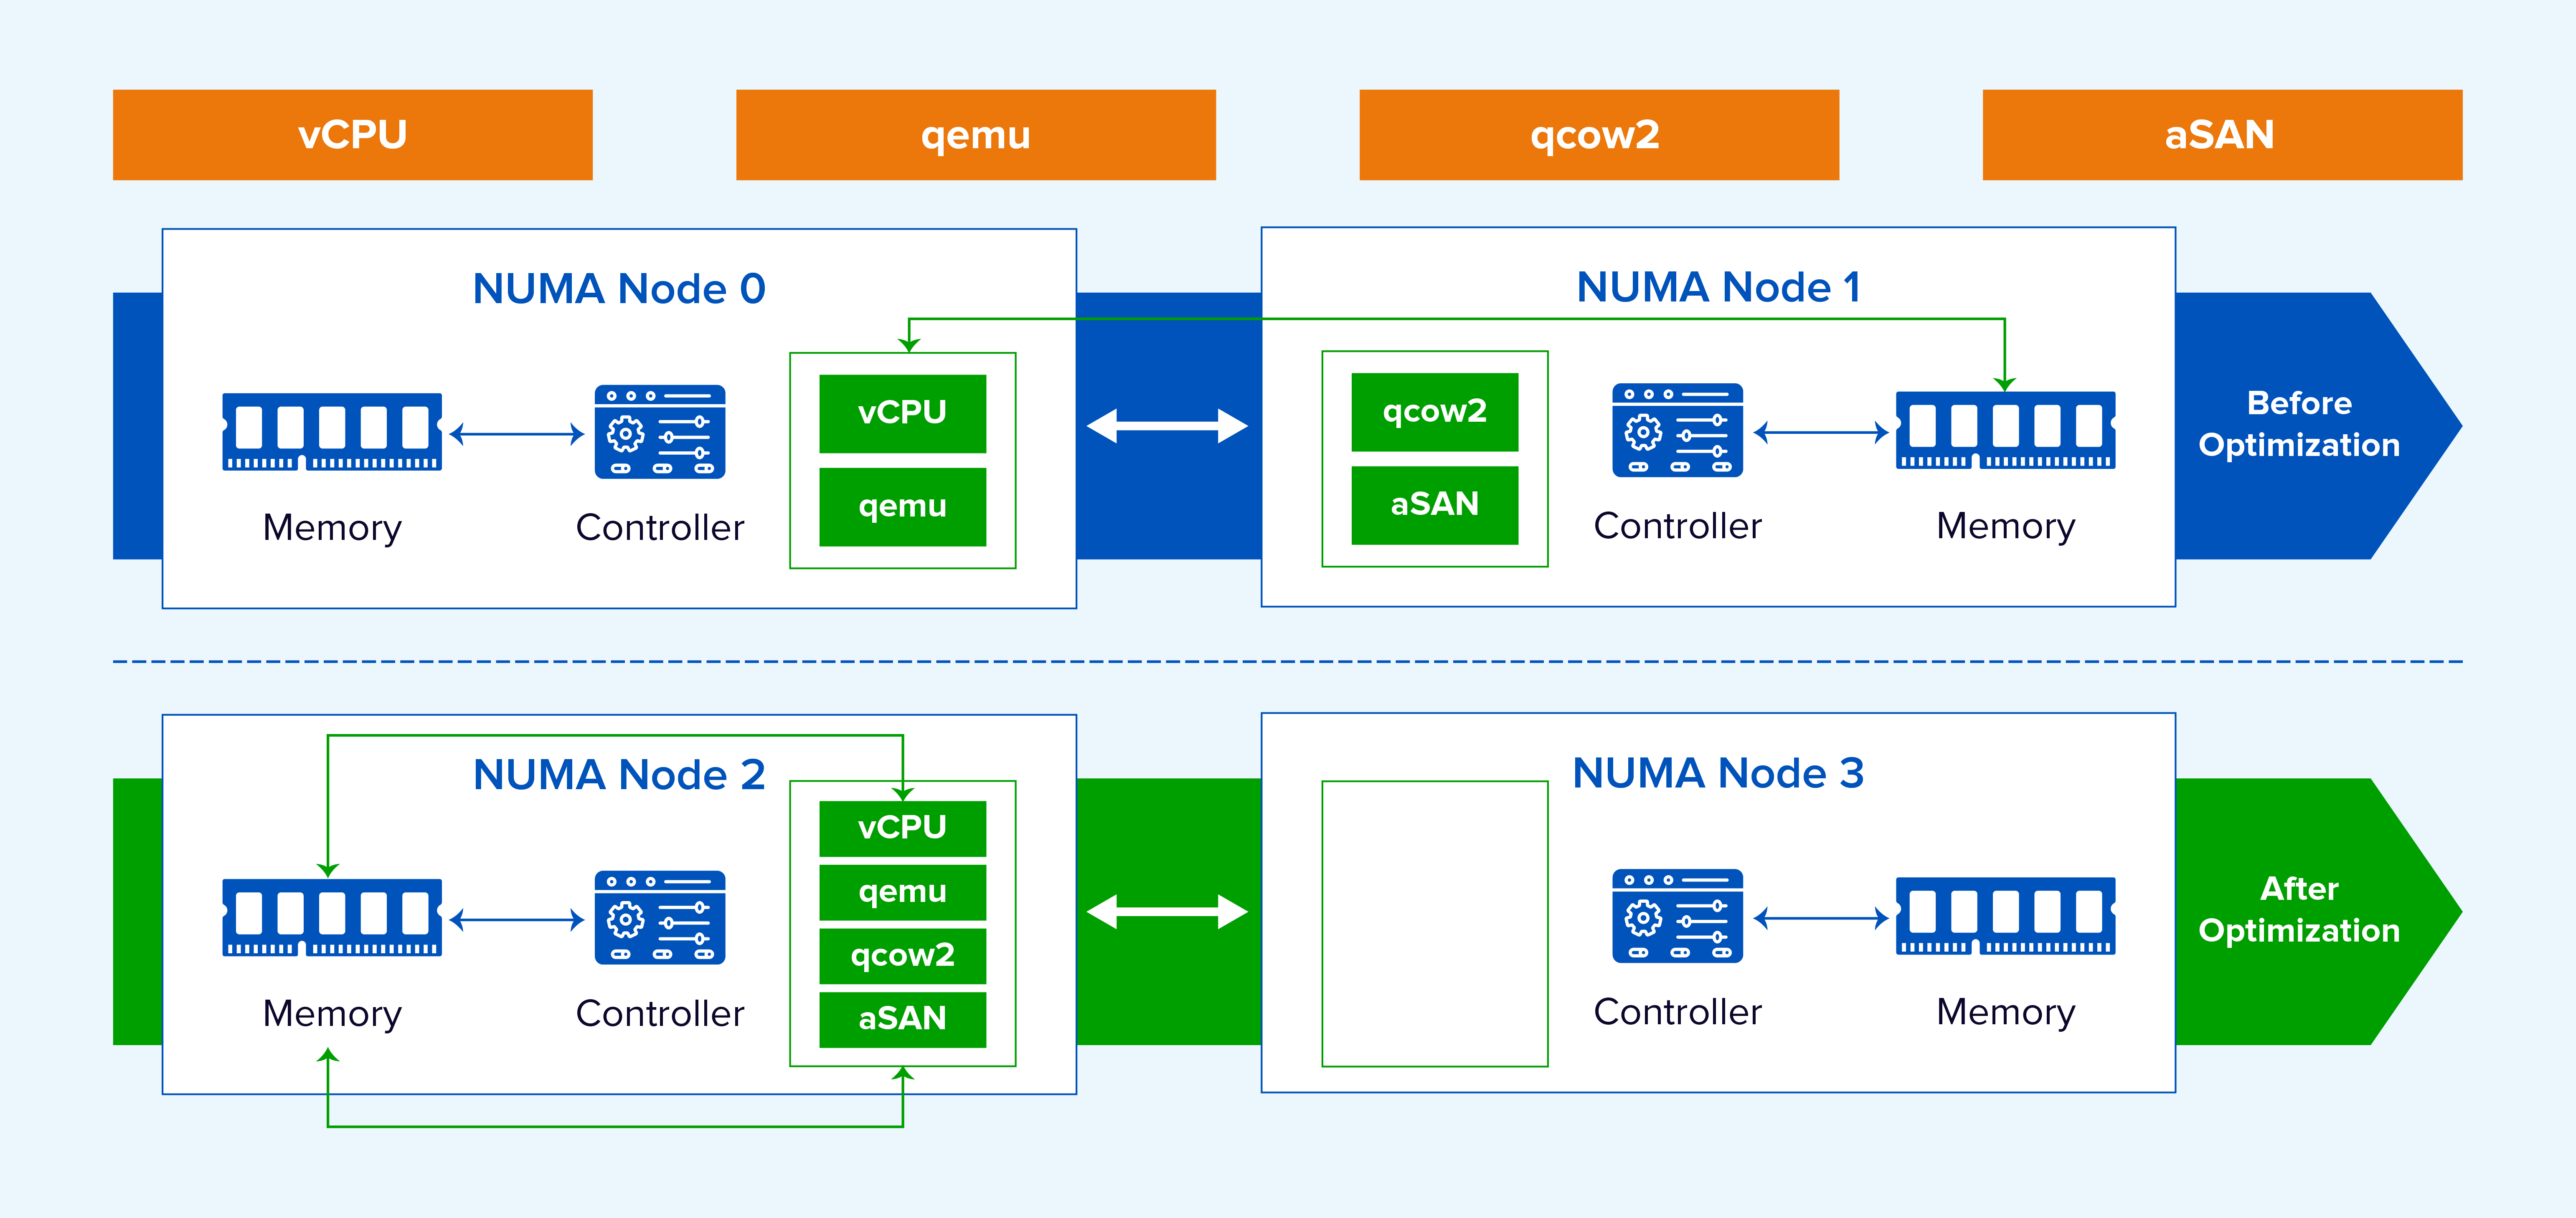
Figura 10. Posizionamento coordinato delle risorse NUMA lungo il percorso di I/O dello storage virtuale.
I dati trasferiti dal buffer della scheda di rete (NIC) allo storage virtuale devono essere elaborati dai thread della CPU. All'aumentare delle prestazioni della rete, l'efficienza della copia dei buffer eseguita da un singolo core può diventare un collo di bottiglia, mentre gli accessi tra nodi NUMA riducono ulteriormente l'efficienza. Sangfor consente a più core della CPU di elaborare contemporaneamente il traffico proveniente dalla NIC e applica l'affinità NUMA. Questo elimina il collo di bottiglia del singolo core, riduce la latenza di trasferimento e migliora la capacità di gestire carichi concorrenti. Nei test interni, le prestazioni di scrittura delle macchine virtuali con elevata profondità di coda (high queue depth) e blocchi di grandi dimensioni sono migliorate di oltre il 20%.
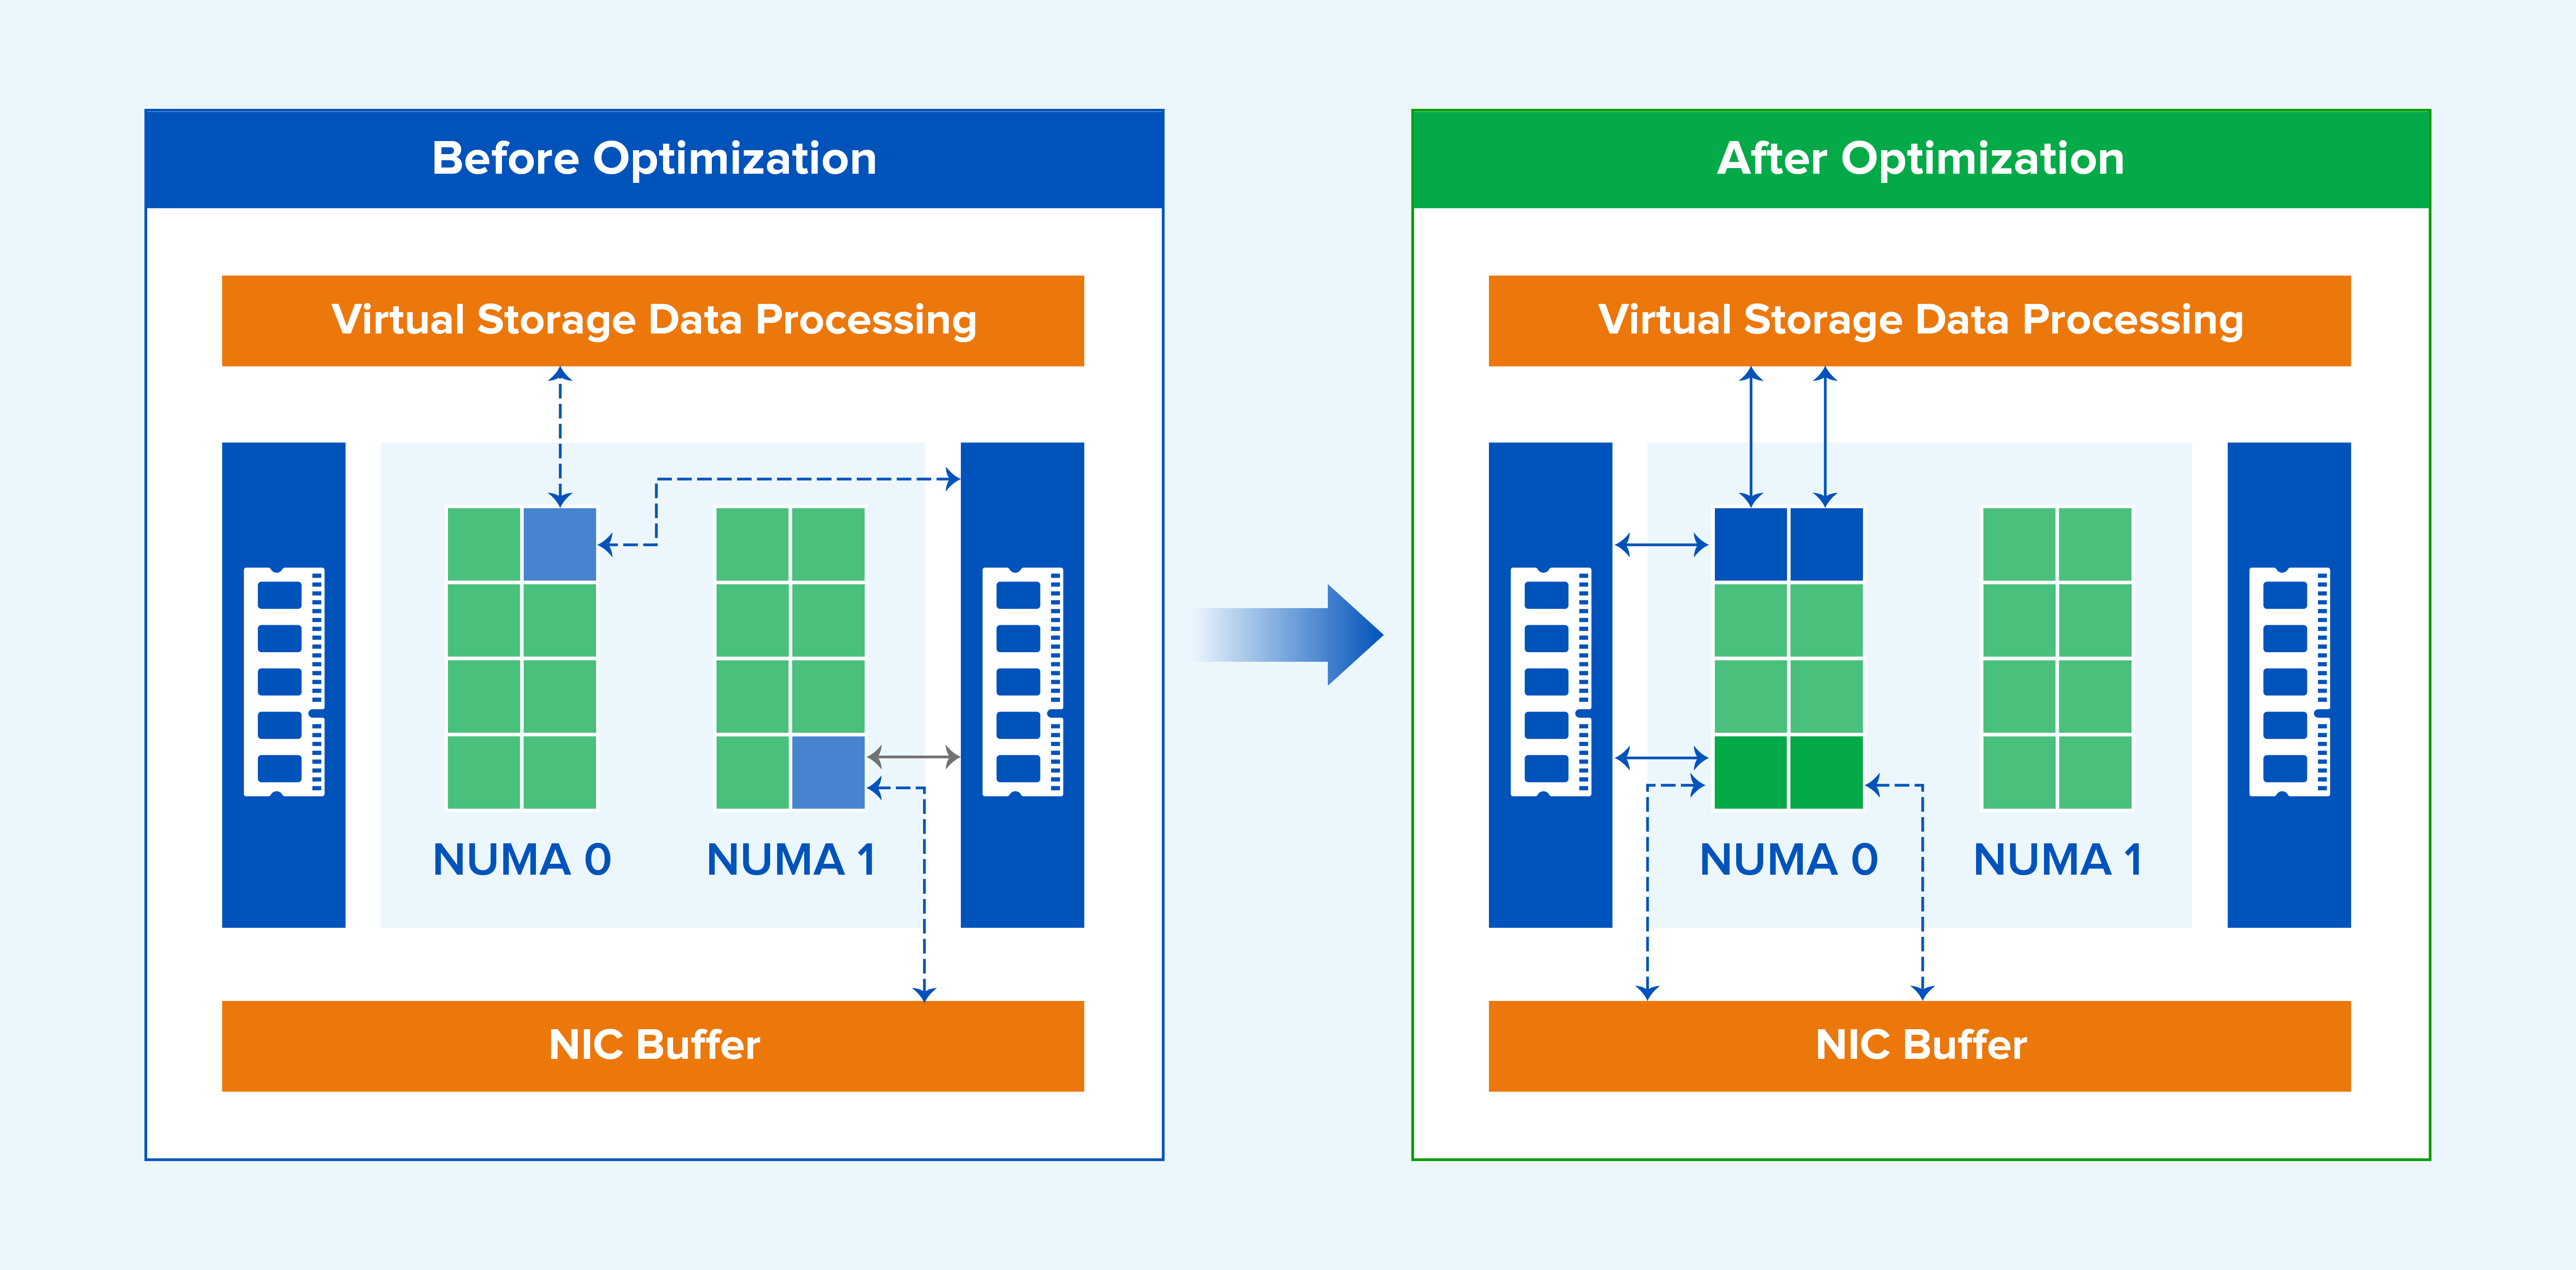
Figura 11. Elaborazione multicore con affinità NUMA tra i buffer della NIC e lo storage virtuale.
3. Confronto con altri approcci del settore
Il supporto NUMA varia tra i diversi fornitori. Un vendor consente agli amministratori di configurare manualmente il nodo NUMA sul quale viene eseguita ciascuna vCPU della macchina virtuale, un altro non supporta questa funzionalità, mentre VMware implementa uno scheduling NUMA adattivo.
Sangfor suddivide automaticamente le vCPU delle macchine virtuali e le assegna ai nodi NUMA in modo da ridurre gli accessi alla memoria remota. Rispetto alla configurazione manuale della posizione di ciascuna vCPU, lo scheduling NUMA adattivo di Sangfor automatizza il partizionamento e il posizionamento delle vCPU, bilancia l'utilizzo tra i nodi e migliora le prestazioni complessive.
Rispetto a un'implementazione di base dello scheduling NUMA adattivo, Sangfor estende inoltre l'ottimizzazione alla pianificazione dei servizi di storage, al riconoscimento delle macchine virtuali prioritarie, al supporto delle piattaforme server eterogenee e all'affinità di rete delle VM. Questi miglioramenti sono il risultato della collaborazione tra il team di ricerca e sviluppo e il team cloud di Sangfor e sono stati progettati sulla base del comportamento reale dei servizi della piattaforma.
PARTE 5. Conclusioni
Lo scheduling NUMA adattivo di Sangfor è stato ottimizzato per diversi scenari infrastrutturali al fine di migliorare l'efficienza dell'accesso alla memoria da parte delle applicazioni.
Le principali ottimizzazioni includono:
- la suddivisione e il posizionamento adattivo delle vCPU delle macchine virtuali sui nodi NUMA, riducendo gli accessi alla memoria remota;
- la migrazione delle macchine virtuali tra i nodi NUMA per mantenere un utilizzo bilanciato delle risorse;
- l'identificazione delle macchine virtuali prioritarie e il loro posizionamento sui nodi meno contesi, riducendo la competizione per CPU, larghezza di banda della memoria e cache;
- l'identificazione della distanza topologica tra i nodi NUMA nei server caratterizzati da numerosi nodi e da differenti distanze di interconnessione, collocando preferenzialmente le risorse vNUMA correlate su nodi NUMA fisici tra loro vicini;
- un'opzione di affinità di rete che consente di collocare una macchina virtuale sullo stesso nodo NUMA del piano dati di rete, migliorando le prestazioni di inoltro del traffico;
- l'applicazione dello scheduling NUMA non solo alle macchine virtuali, ma anche ai servizi di storage.
Esempio di test con UnixBench
UnixBench è un benchmark ampiamente utilizzato per i sistemi operativi di tipo Unix, tra cui UNIX, BSD e Linux. Misura diversi aspetti delle prestazioni del sistema, inclusi CPU, file system, memoria e gestione dei processi.
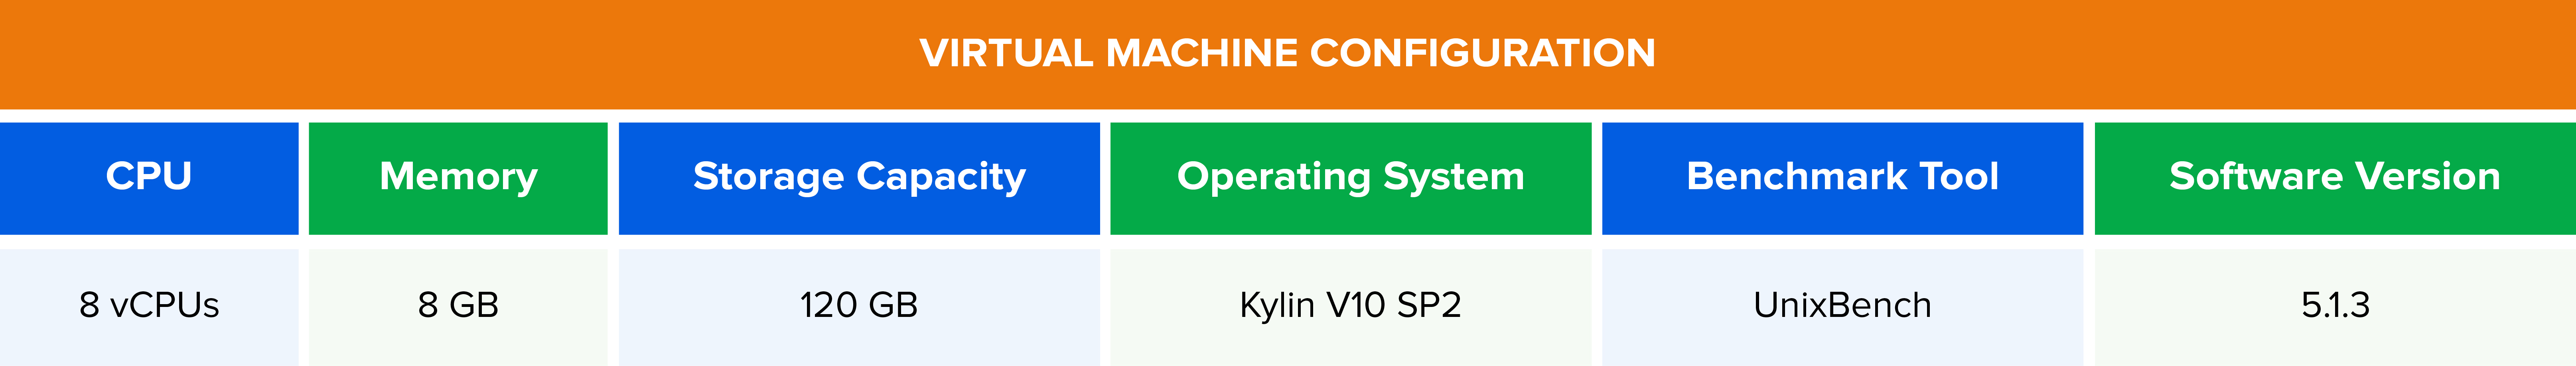
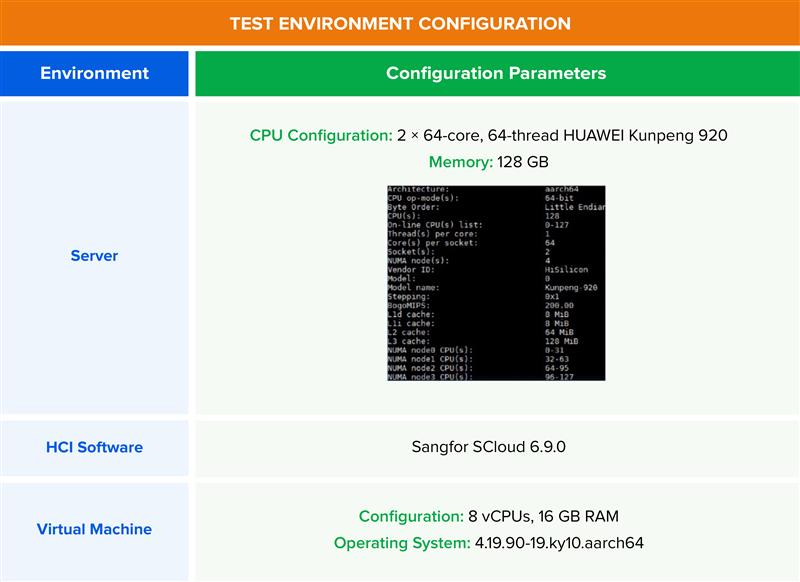
Figura 12. Configurazione della macchina virtuale utilizzata per i test UnixBench.
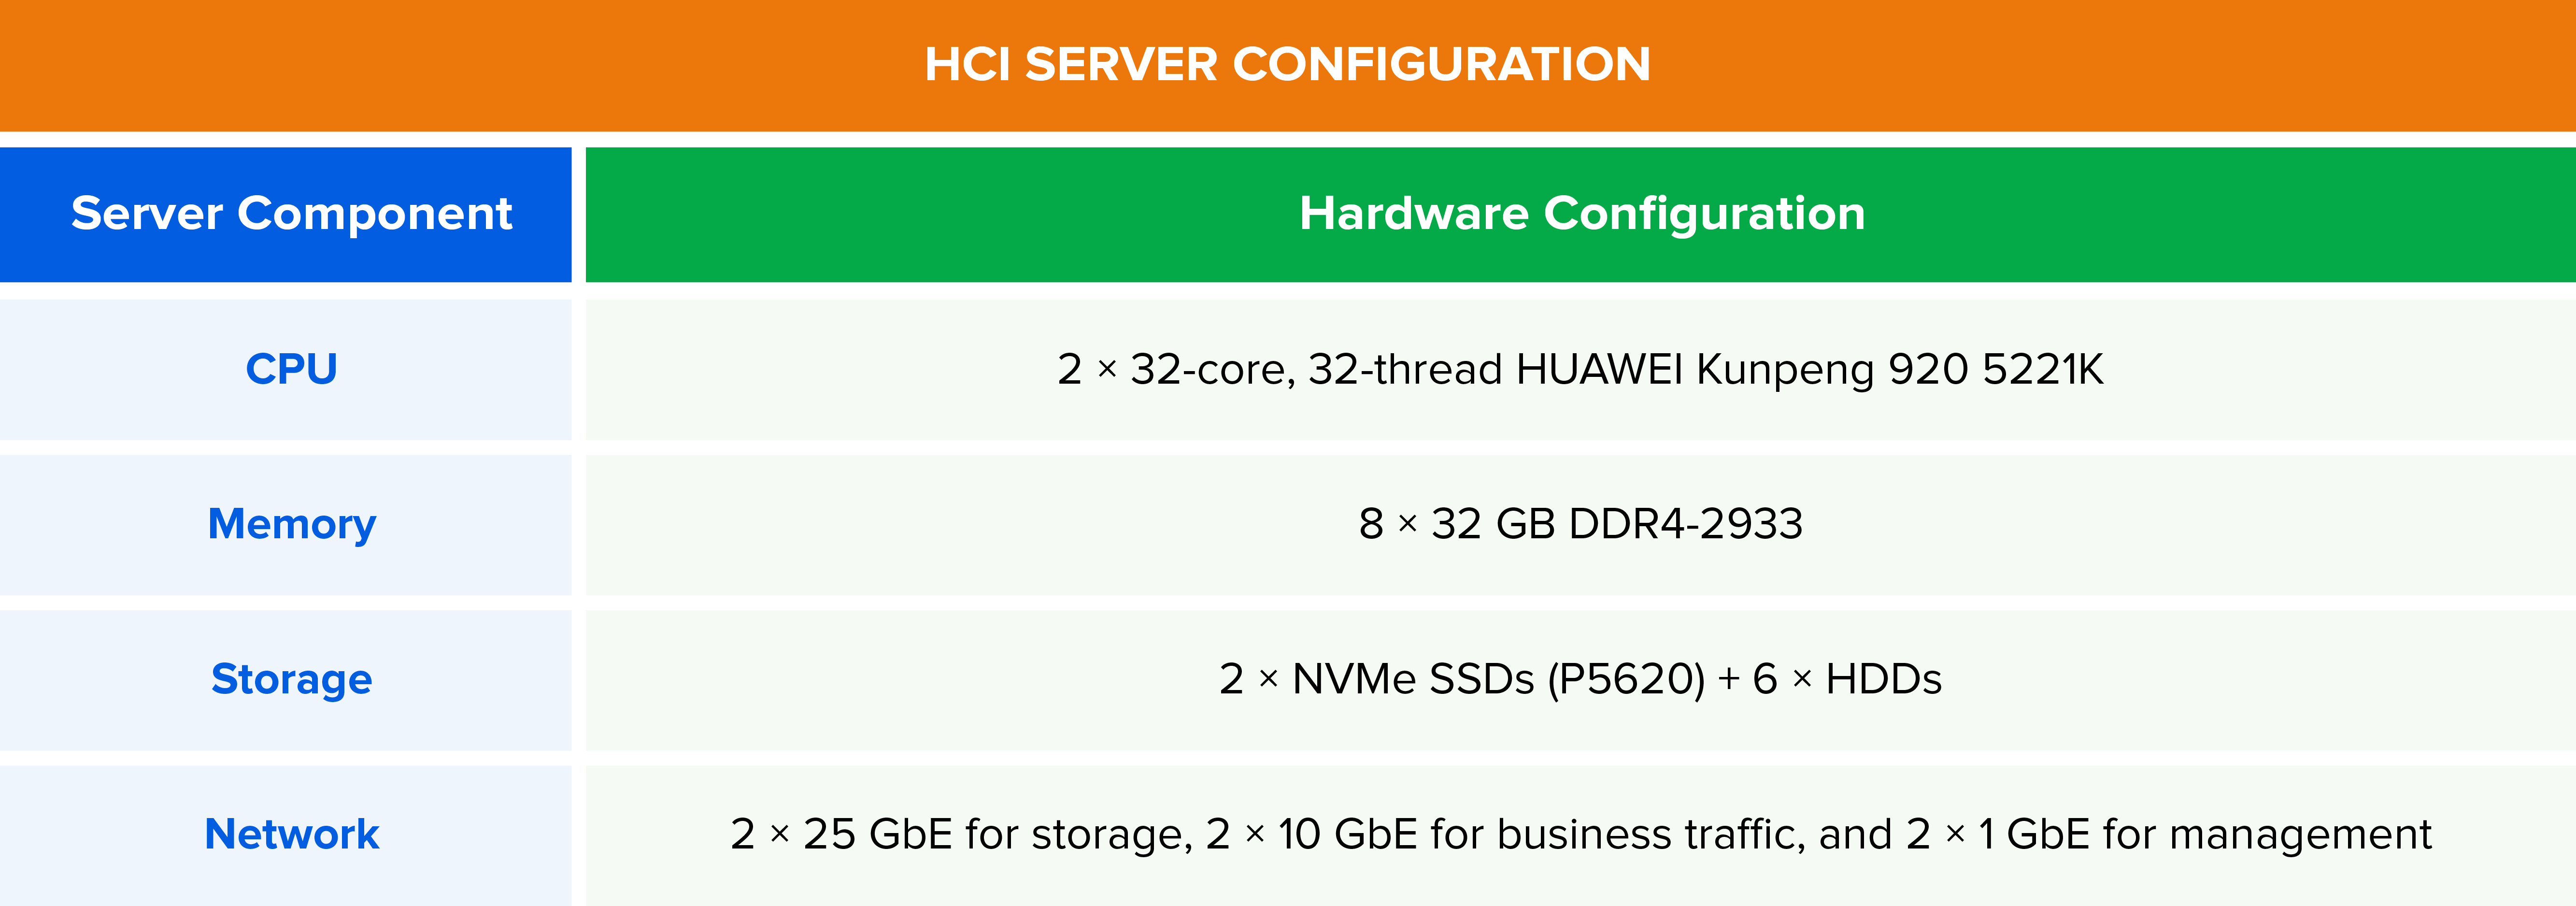
Figura 13. Configurazione hardware del server HCI utilizzato per i test UnixBench.
Risultati dei test: in Sangfor HCI 6.9.0, con NUMA abilitato, il punteggio complessivo ottenuto con 6 macchine virtuali eseguite contemporaneamente sullo stesso host è risultato superiore del 20,2% rispetto alla piattaforma concorrente anonimizzata. Con 8 macchine virtuali eseguite in parallelo, il punteggio complessivo è risultato superiore del 34,17%.
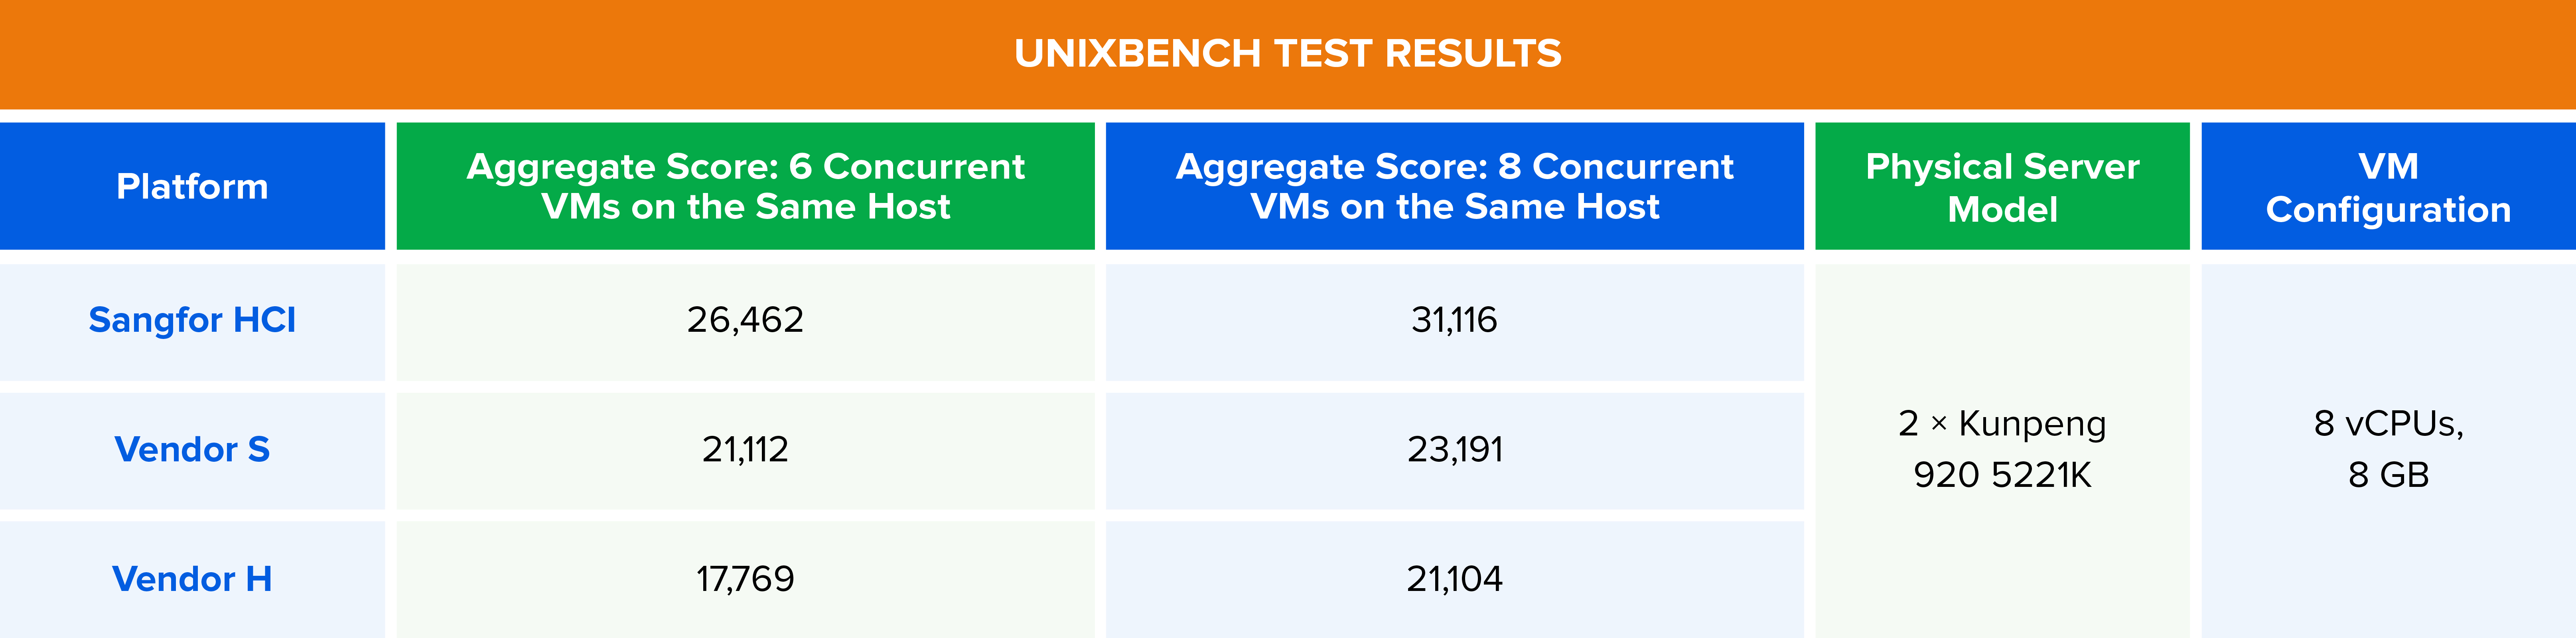
Figura 14. Confronto dei risultati del benchmark UnixBench in presenza di carichi concorrenti di macchine virtuali.
Le osservazioni riportate in questo articolo si basano su benchmark eseguiti da Sangfor in specifici ambienti di test interni e sono fornite esclusivamente a scopo illustrativo dal punto di vista tecnico. I risultati effettivi possono variare in funzione dell'hardware, della versione del software, della configurazione del sistema e del tipo di carico di lavoro. Si raccomanda pertanto ai clienti di validare le applicazioni rappresentative del proprio ambiente rispetto ai propri obiettivi di livello di servizio (Service Level Objectives, SLO).

