
Da immer mehr Unternehmen geschäftskritische Workloads auf virtualisierte, hyperkonvergente und Cloud-Infrastrukturen verlagern, hat die Performance bei hoher Parallelität höchste Priorität. Für Teams, die einen VMware-Ersatz evaluieren, geht es nicht nur darum, ob eine andere Plattform ähnliche Funktionalitäten bietet, sondern auch darum, ob sie die von zentralen Geschäftssystemen geforderte Latenz, den Durchsatz und die Stabilität gewährleisten kann.
Diese Herausforderung zeigt sich besonders deutlich bei speicherintensiven Anwendungen, darunter Hochfrequenzhandel und Risikomanagement im Finanzdienstleistungssektor, elektronische Patientenaktensysteme im Gesundheitswesen und Lagerverwaltungssysteme in der Logistik. Deren steigende Anforderungen an den Speicherzugriff hängen eng mit Backend-Komponenten wie Redis, Apache Spark, SAP HANA und KI-Engines bzw. -Modellen zusammen. Redis beispielsweise ist eine In-Memory-Datenbank, deren Performance direkt von der Speicherzugriffsgeschwindigkeit abhängt.
NUMA ist mittlerweile eine gängige Server-CPU-Architektur. Die Verbesserung der Speicherzugriffseffizienz unter NUMA ist daher ein wichtiger Aspekt der Virtualisierungs-Leistungsoptimierung. Dieser Artikel erläutert die NUMA-Optimierungstechnologien von Sangfor und wie sie Virtualisierungsplattformen dabei unterstützen, hochgradig parallele, geschäftskritische Workloads während des VMware- Ablösungsprozesses zu bewältigen.
TEIL 1. NUMA-Architektur – Hintergrund
Frühe Computersysteme nutzten typischerweise einen einzigen Prozessor für alle Rechenaufgaben. Da die Anwendungen immer komplexer und anspruchsvoller wurden, konnte ein einzelner Prozessor den Anforderungen an Hochleistungsrechnen nicht mehr gerecht werden, und die Systeme entwickelten sich schrittweise hin zu Mehrkernarchitekturen.
Herkömmliche Mehrkernsysteme nutzten üblicherweise symmetrisches Multiprocessing (SMP). Bei SMP haben alle Prozessoren den gleichen Status und die gleichen Zugriffsrechte auf den Speicher. Jeder Thread kann auf jedem Prozessor ausgeführt werden, was eine effektive Lastverteilung ermöglicht und die Gesamtleistung sowie den Durchsatz verbessert. Da jedoch mehrere Kerne denselben Bus für den Speicherzugriff nutzen, kann dieser mit zunehmender Kernanzahl zum Flaschenhals werden und Skalierbarkeit und Leistung einschränken.
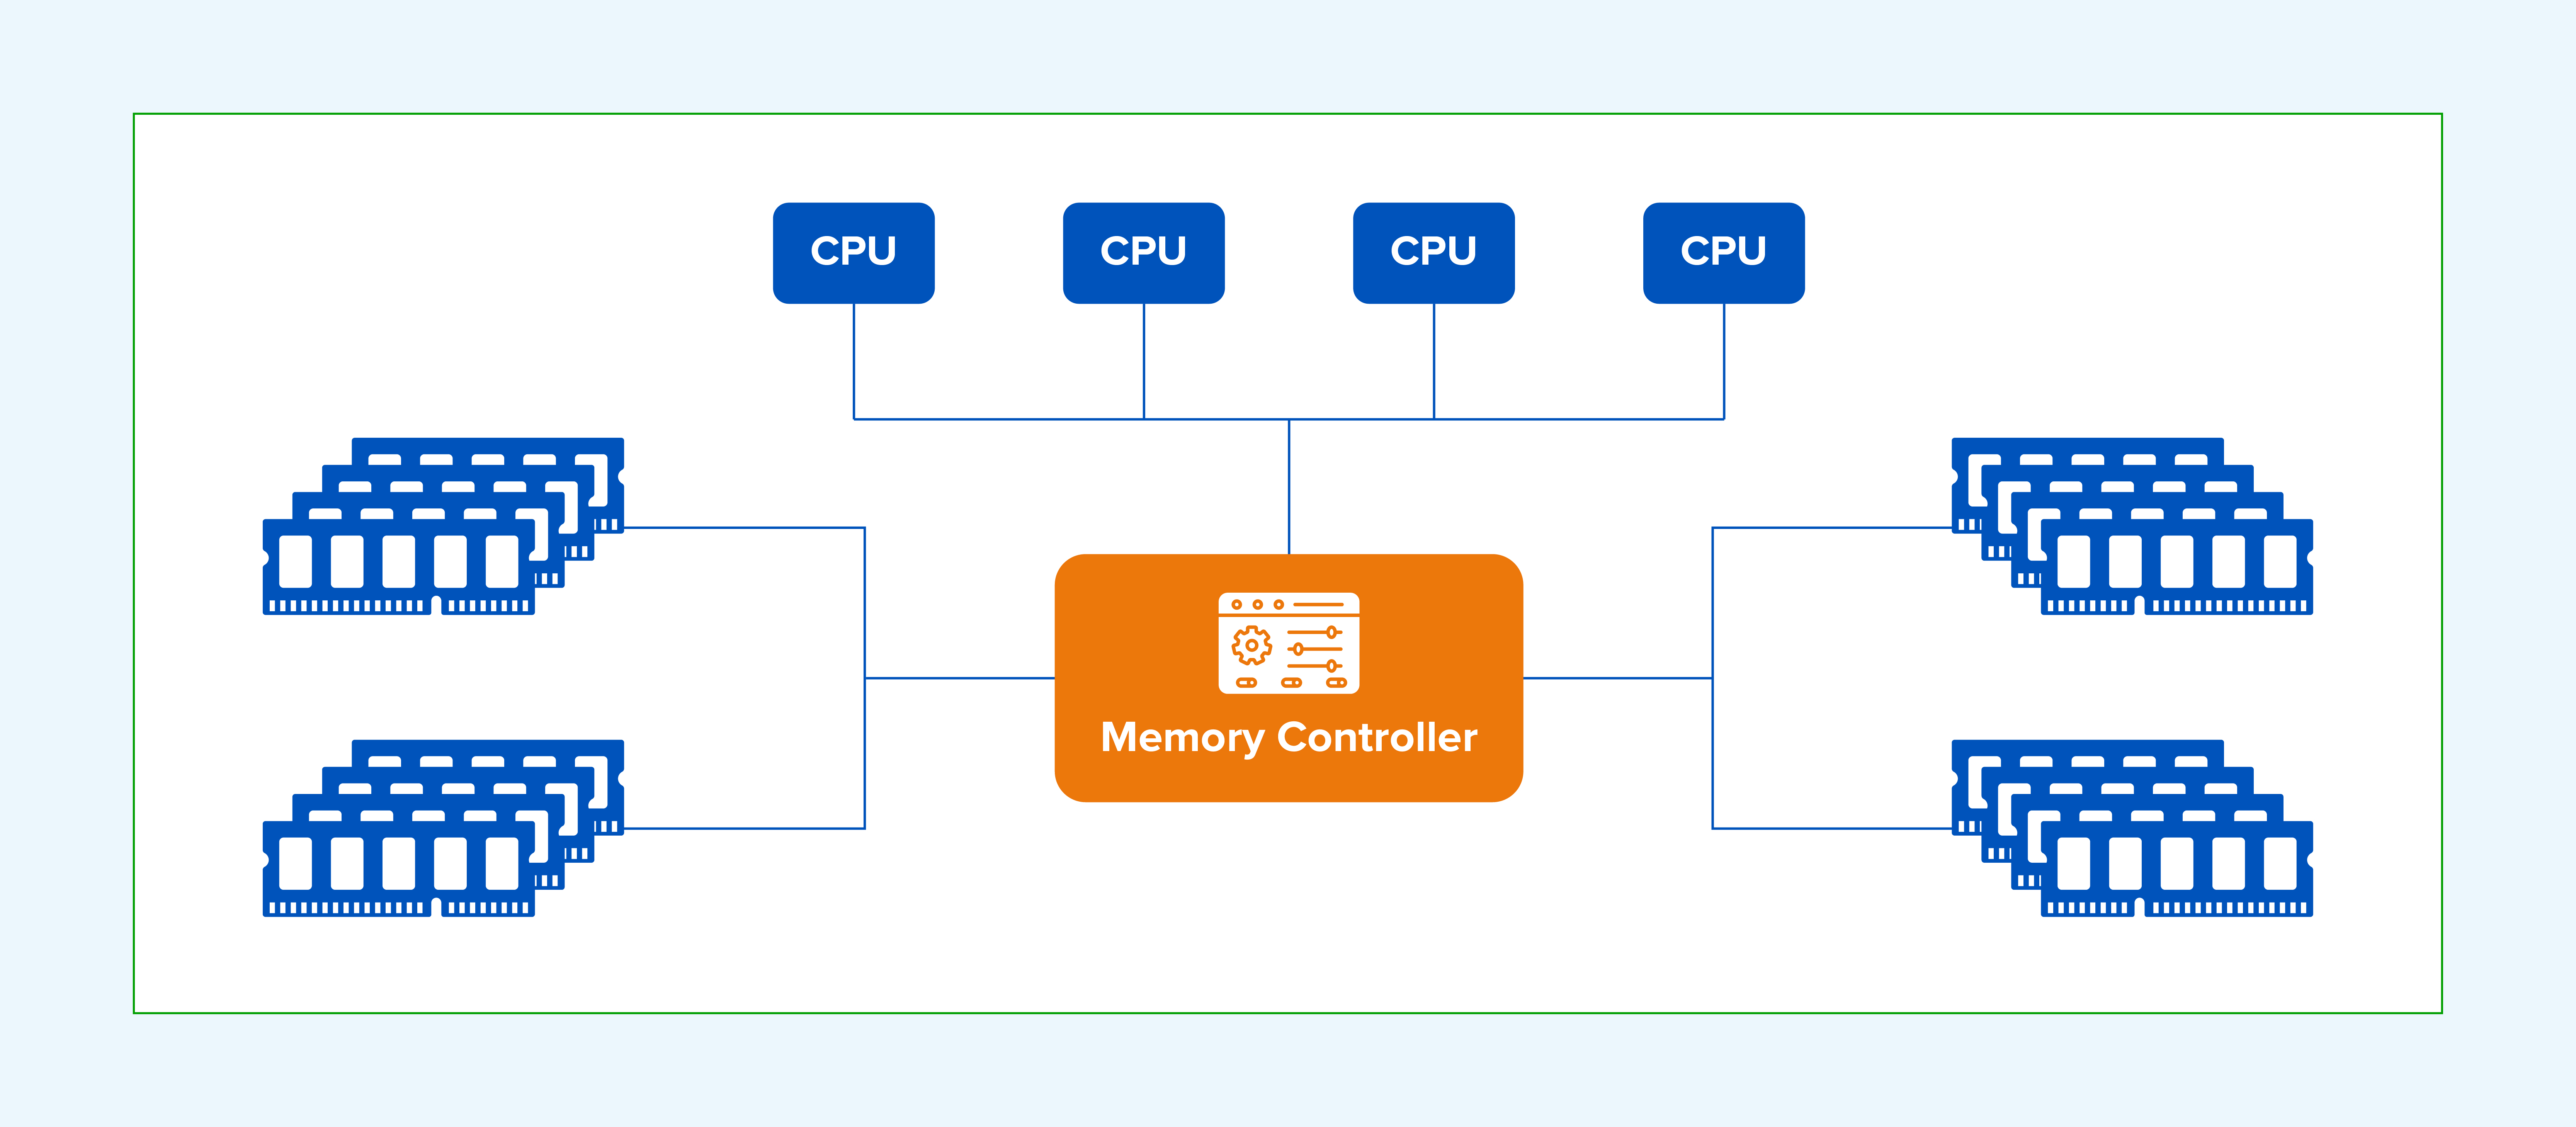
Abbildung 1: Engpass beim Zugriff auf den gemeinsam genutzten Busspeicher in traditionellen SMP-Architekturen.
NUMA behebt den Speicherzugriffsengpass von SMP-Systemen. In einer NUMA-Architektur ist das System in mehrere Knoten unterteilt, von denen jeder einen oder mehrere Prozessoren, lokalen Speicher und E/A-Geräte enthält. Die Knoten kommunizieren über Hochgeschwindigkeitsverbindungen wie AMD HyperTransport oder Intel QuickPath Interconnect (QPI). Dadurch können die Prozessoren zuerst auf den lokalen Speicher zugreifen, was die Speicherzugriffslatenz reduziert und die Leistung des Mehrprozessorsystems verbessert.
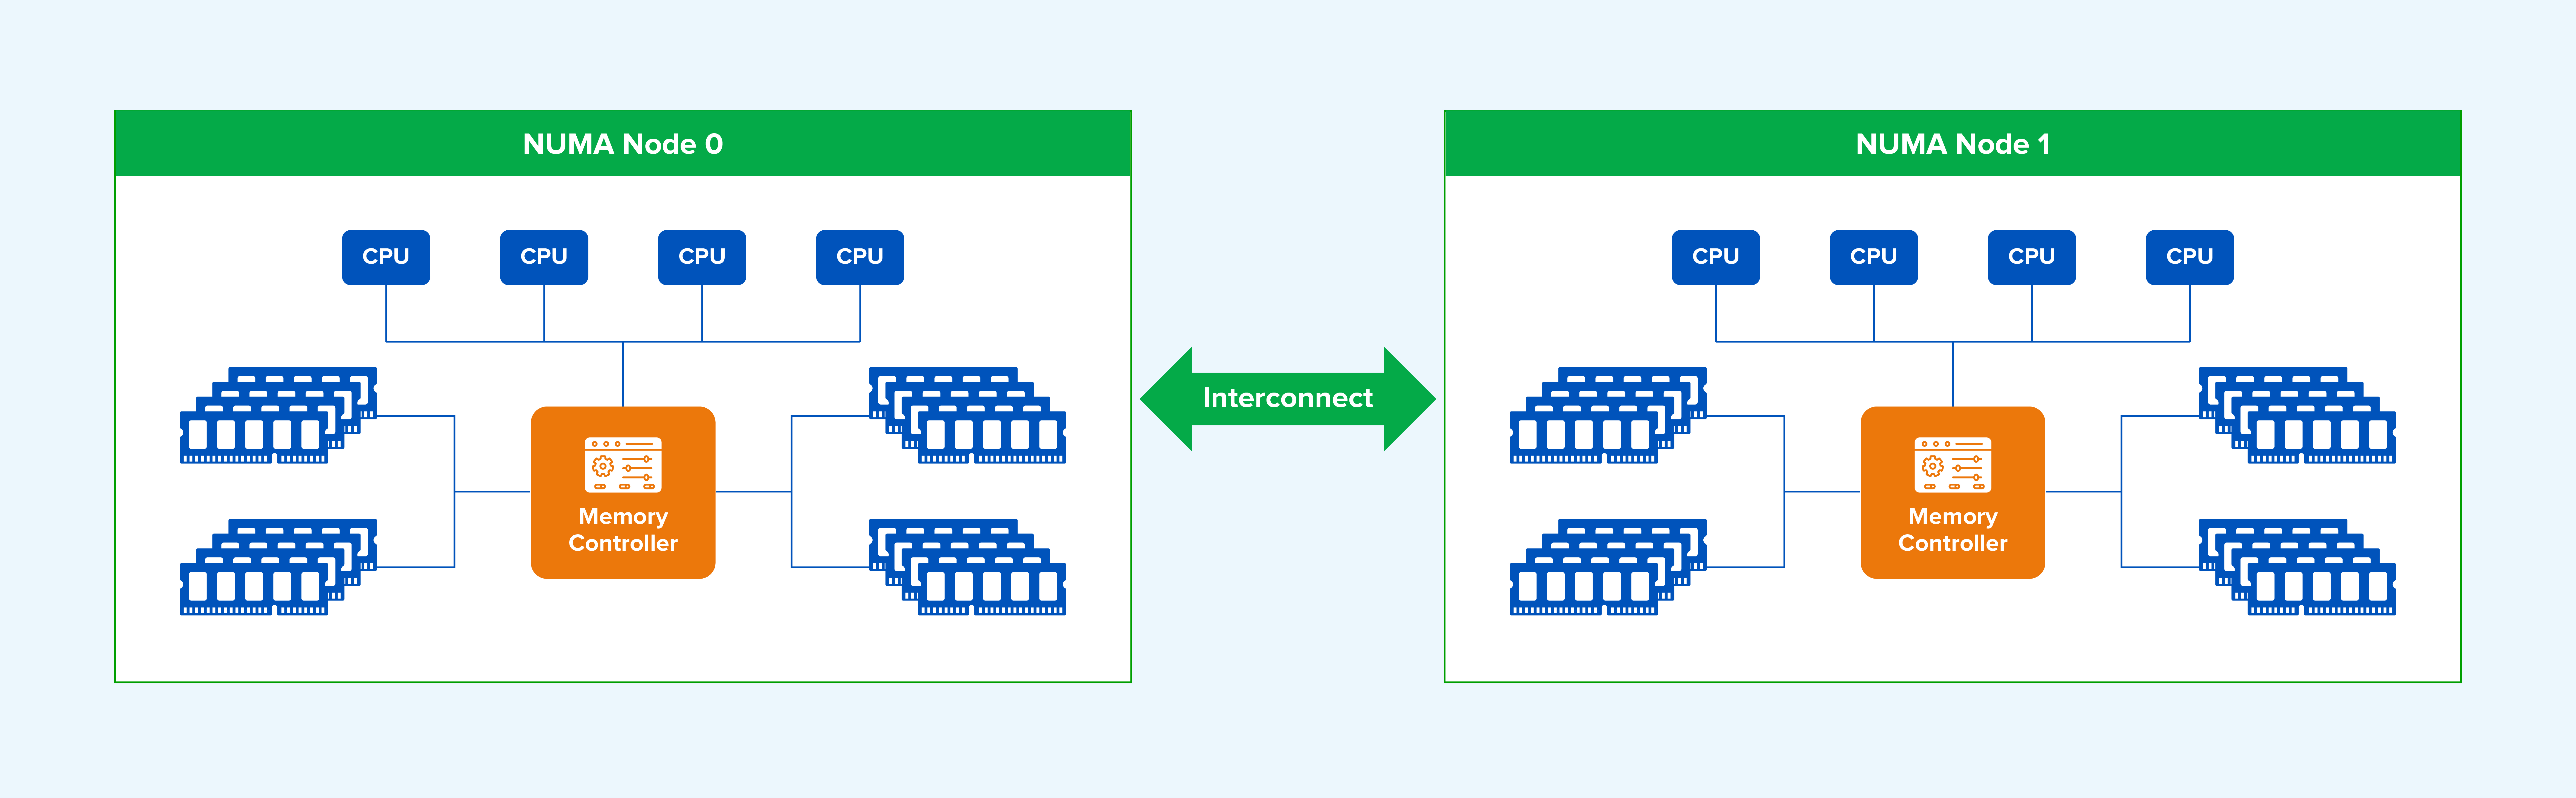
Abbildung 2: Multi-Node-NUMA-Architektur mit knotenlokaler CPU- und Speicherzuweisung.
Ein NUMA-System enthält drei Knotentypen:
- Lokaler Knoten: Für die CPUs innerhalb eines bestimmten Knotens ist dieser Knoten der lokale Knoten.
- Nachbarknoten: Ein Knoten, der an den lokalen Knoten angrenzt.
- Remote-Knoten: Ein Knoten, der weder lokal noch benachbart ist.
Die CPU-Zugriffsgeschwindigkeit variiert je nach Knotentyp. Lokaler Speicher ist am schnellsten zugänglich, entfernter Speicher am langsamsten. Im Allgemeinen verlangsamt sich der Speicherzugriff mit zunehmender topologischer Distanz.
In „NUMA: Ein Überblick“ stellte Dr. Christoph Lameter fest, dass auf einem High-End-Zwei-Knoten-Server im Jahr 2013 die Latenz beim zufälligen Zugriff auf den lokalen Speicher etwa 100 ns betrug, während der Zugriff auf den entfernten Speicher die Latenz um etwa 50 % erhöhte.
TEIL 2. Herausforderungen durch NUMA
In Linux ist ein Thread die Grundeinheit der CPU-Planung und entspricht einem Task in der CPU-Warteschlange. Der Kernel wählt für jeden Task eine relativ freie CPU aus. Da die CPU-Auslastung dynamisch schwankt, nutzt der Kernel Load Balancing, um Tasks auf weniger ausgelastete CPUs zu verteilen. Standardmäßig kann ein Task daher zwischen verschiedenen CPUs wechseln.
Unter NUMA kann ein Prozess von einer CPU auf Knoten 1 zu einer CPU auf Knoten 2 verschoben werden, während er weiterhin auf den auf Knoten 1 zugewiesenen Speicher zugreift, was zu knotenübergreifenden Zugriffen führt. Der Linux-NUMA-Speicherausgleich migriert Prozesse oder Speicherseiten regelmäßig zum lokalen Knoten, kann aber nicht alle Zugriffe auf entfernten Speicher unterbinden.
In einer virtualisierten Umgebung entspricht jede virtuelle CPU (vCPU) eines Threads des Host-Betriebssystems. Wenn mehrere vCPU-Threads auf verschiedenen NUMA-Knoten ausgeführt werden und sich dabei den Speicher teilen oder zwischen Knoten migrieren, kann die VM auf Speicher über NUMA-Knoten hinweg zugreifen und dadurch höhere Latenzzeiten aufweisen.
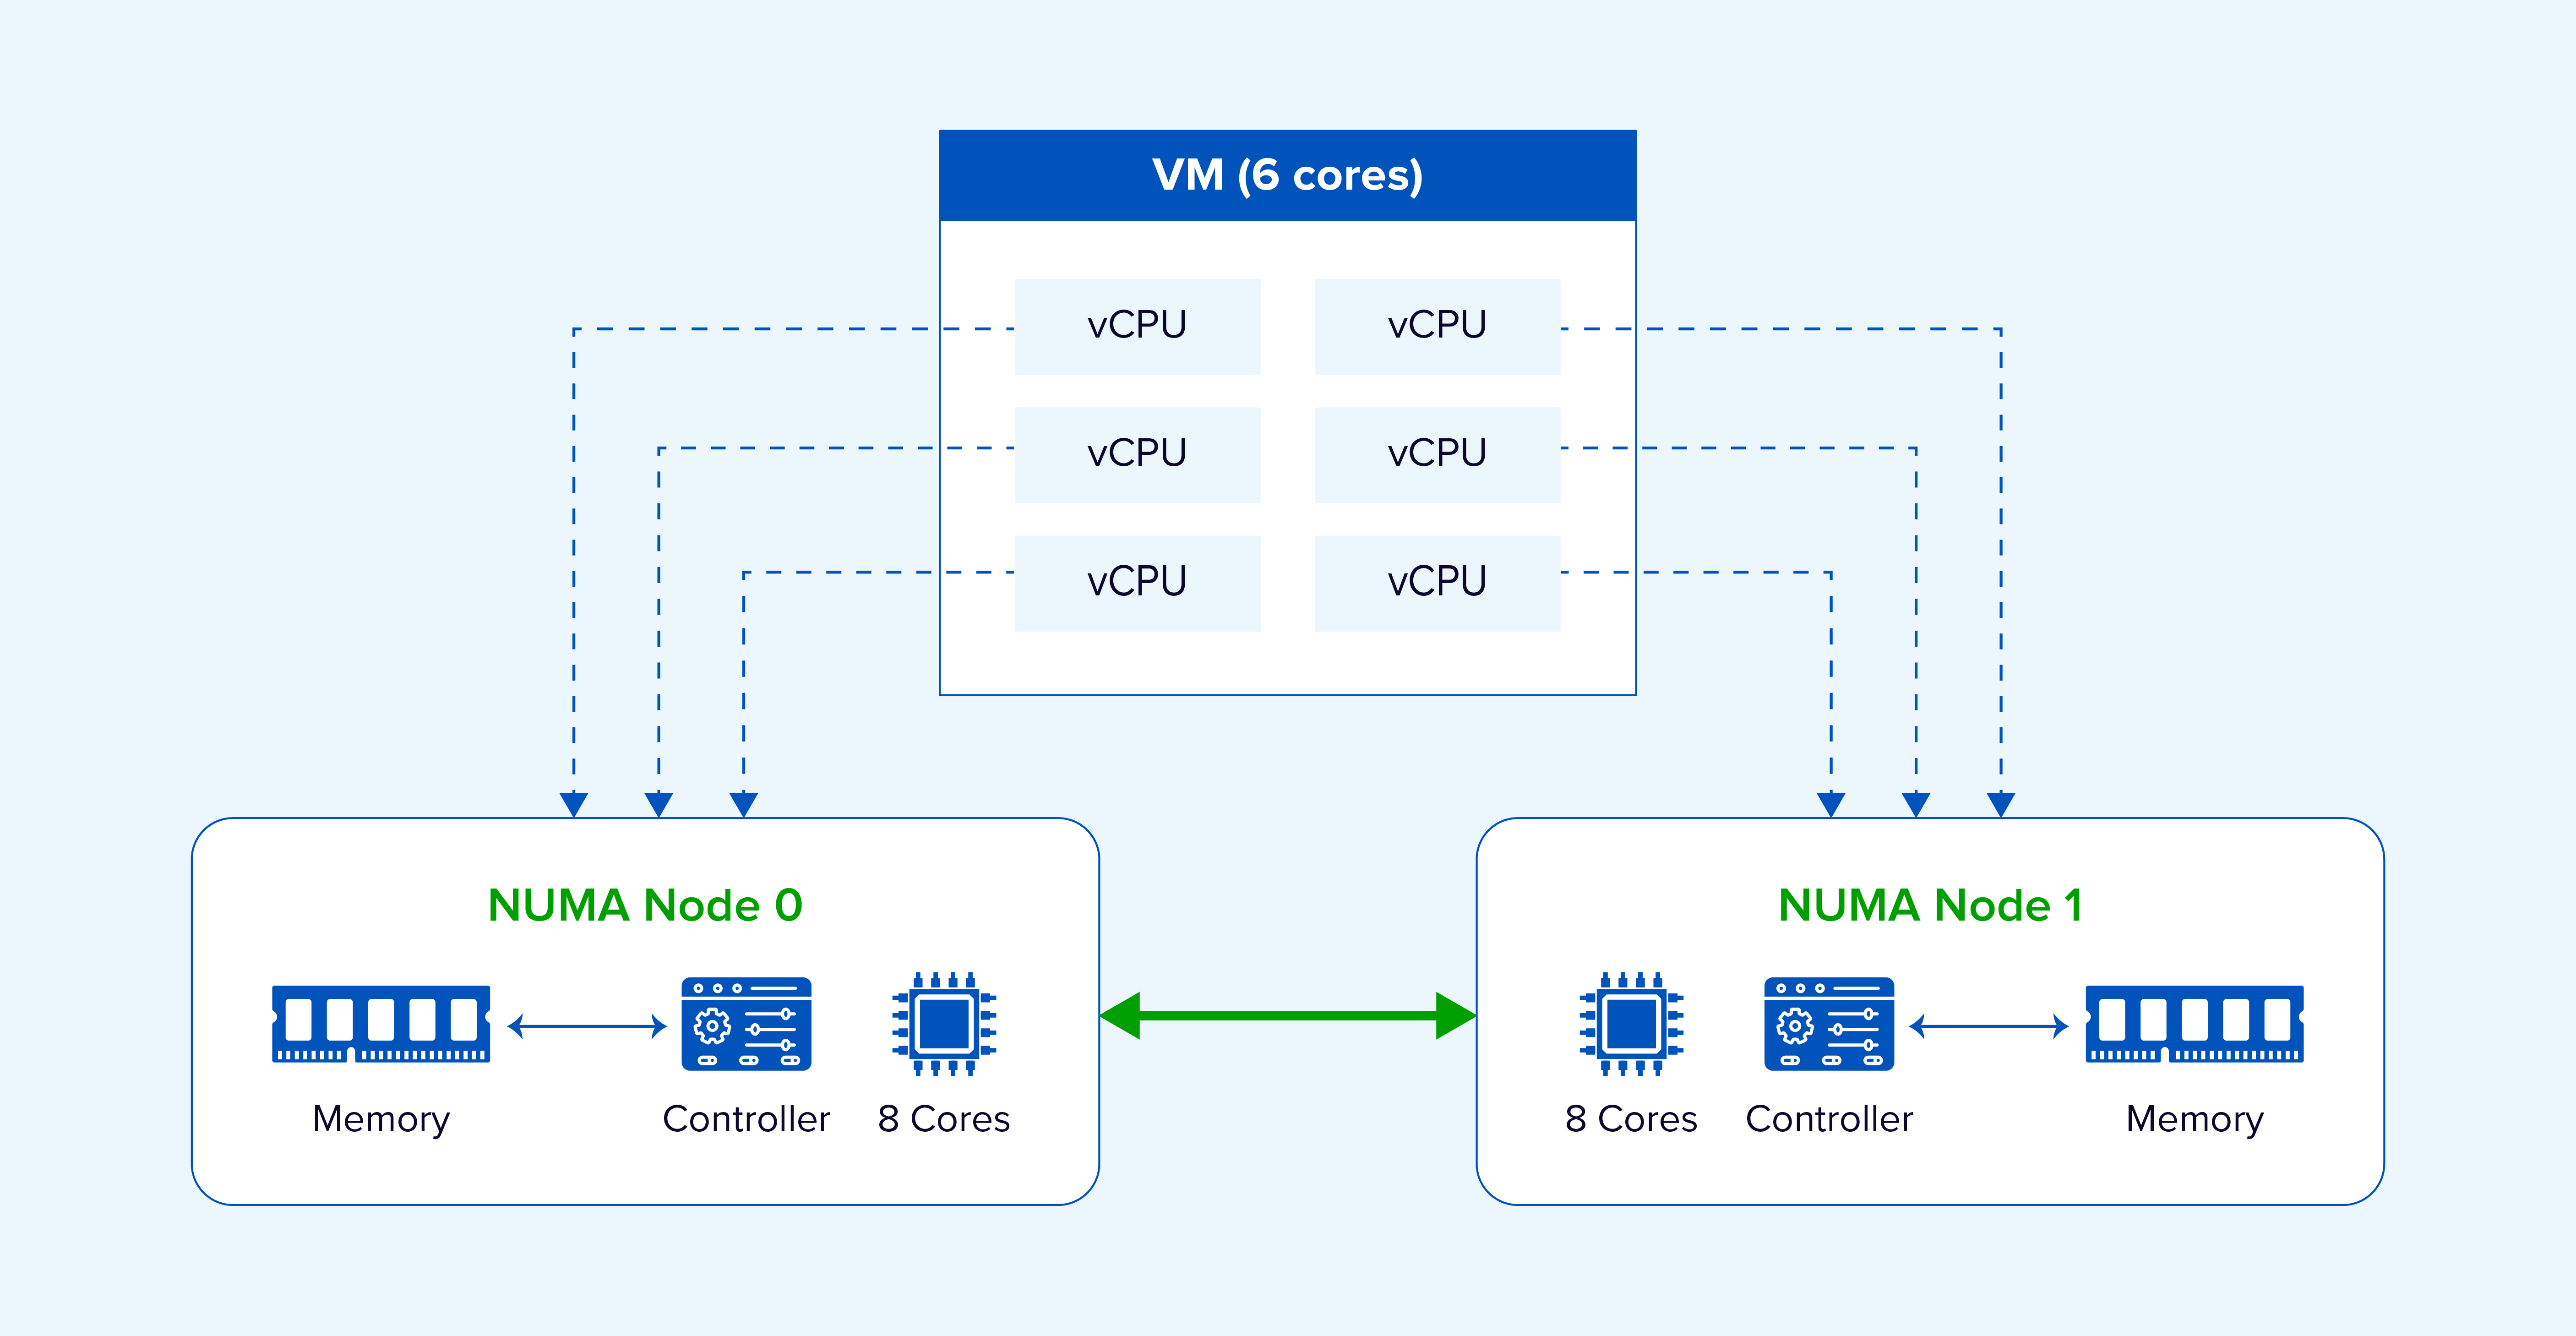
Abbildung 3: Knotenübergreifende Ausführung kann den Remote-Speicherzugriff für eine virtuelle Maschine erhöhen.
TEIL 3. Gängige NUMA-Planungsansätze
In der Branche werden üblicherweise folgende Ansätze verwendet:
Ansatz 1: vCPUs an physische Kerne binden
Administratoren konfigurieren die vCPU-Zuordnung manuell, sodass VM-Ressourcen bevorzugt auf demselben physischen NUMA-Knoten ausgeführt werden.
Ansatz 2: Die Anzahl der einer VM zugewiesenen NUMA-Knoten festlegen
Administratoren konfigurieren die Anzahl der NUMA-Knoten manuell und verteilen die vCPU- und Speicherressourcen gleichmäßig auf diese.
Ansatz 3: Adaptive Zuweisung von NUMA-Knoten
Der Scheduler weist einer VM automatisch geeignete NUMA-Knoten zu. Die VM-CPUs sind auf diese Knoten beschränkt und nutzen bevorzugt lokalen Speicher, um die Datenlokalität zu verbessern. Verfügt die VM über mehr vCPUs, als ein einzelner NUMA-Knoten aufnehmen kann, wird sie auf mehrere Knoten verteilt. Die NUMA-Topologie kann dem Gastbetriebssystem für topologiebasierte Entscheidungen zugänglich gemacht werden, während VMs zwischen Knoten migriert werden können, um die Lastverteilung aufrechtzuerhalten.
Die Ansätze 1 und 2 bringen mehr Einschränkungen mit sich, erfordern eine sorgfältige Dimensionierung der VM-CPUs und können aufgrund statischer Bindung zu einem Ungleichgewicht zwischen den NUMA-Knoten führen. Adaptive Zuweisung ist daher für dynamische Produktionsumgebungen praktikabler.
TEIL 4. Sangfor NUMA-Planung im Detail
Sangfor HCI nutzt primär adaptives NUMA-Scheduling. Es gleicht die Auslastung der NUMA-Knoten aus und reduziert gleichzeitig den Remote-Speicherzugriff durch VM-vCPUs, wodurch die Gesamtleistung verbessert wird.
Adaptives NUMA-Scheduling bietet deutliche Optimierungsvorteile für verschiedene Anwendungstypen, insbesondere für Middleware mit häufigen Speicherzugriffen. Sangfor setzte DM8, Redis und Memcached in virtuellen Maschinen ein und führte Benchmarks mit aktiviertem und deaktiviertem NUMA-Scheduling durch. Die Ergebnisse zeigten deutliche Leistungsverbesserungen der Middleware mit aktiviertem NUMA-Scheduling.
Datenbank-Workloads: Dameng DB (DM8) mit BenchmarkSQL
BenchmarkSQL ist ein Benchmark für relationale Datenbanken, der einen TPC-C-ähnlichen Transaktionsmix ausführt, der Neubestellungen, Zahlungen, Bestellstatusabfragen, Lieferungen und Lagerbestandsabfragen umfasst. Die resultierende Metrik tpmC gibt die Anzahl der pro Minute verarbeiteten Neubestellungstransaktionen an; ein höherer Wert bedeutet eine bessere Performance. BenchmarkSQL 5.0 wurde zum Testen der DM8-Datenbank verwendet. Die folgende Grafik zeigt die relative Performance, wobei das tpmC-Ergebnis ohne NUMA auf 100 % normiert wurde.
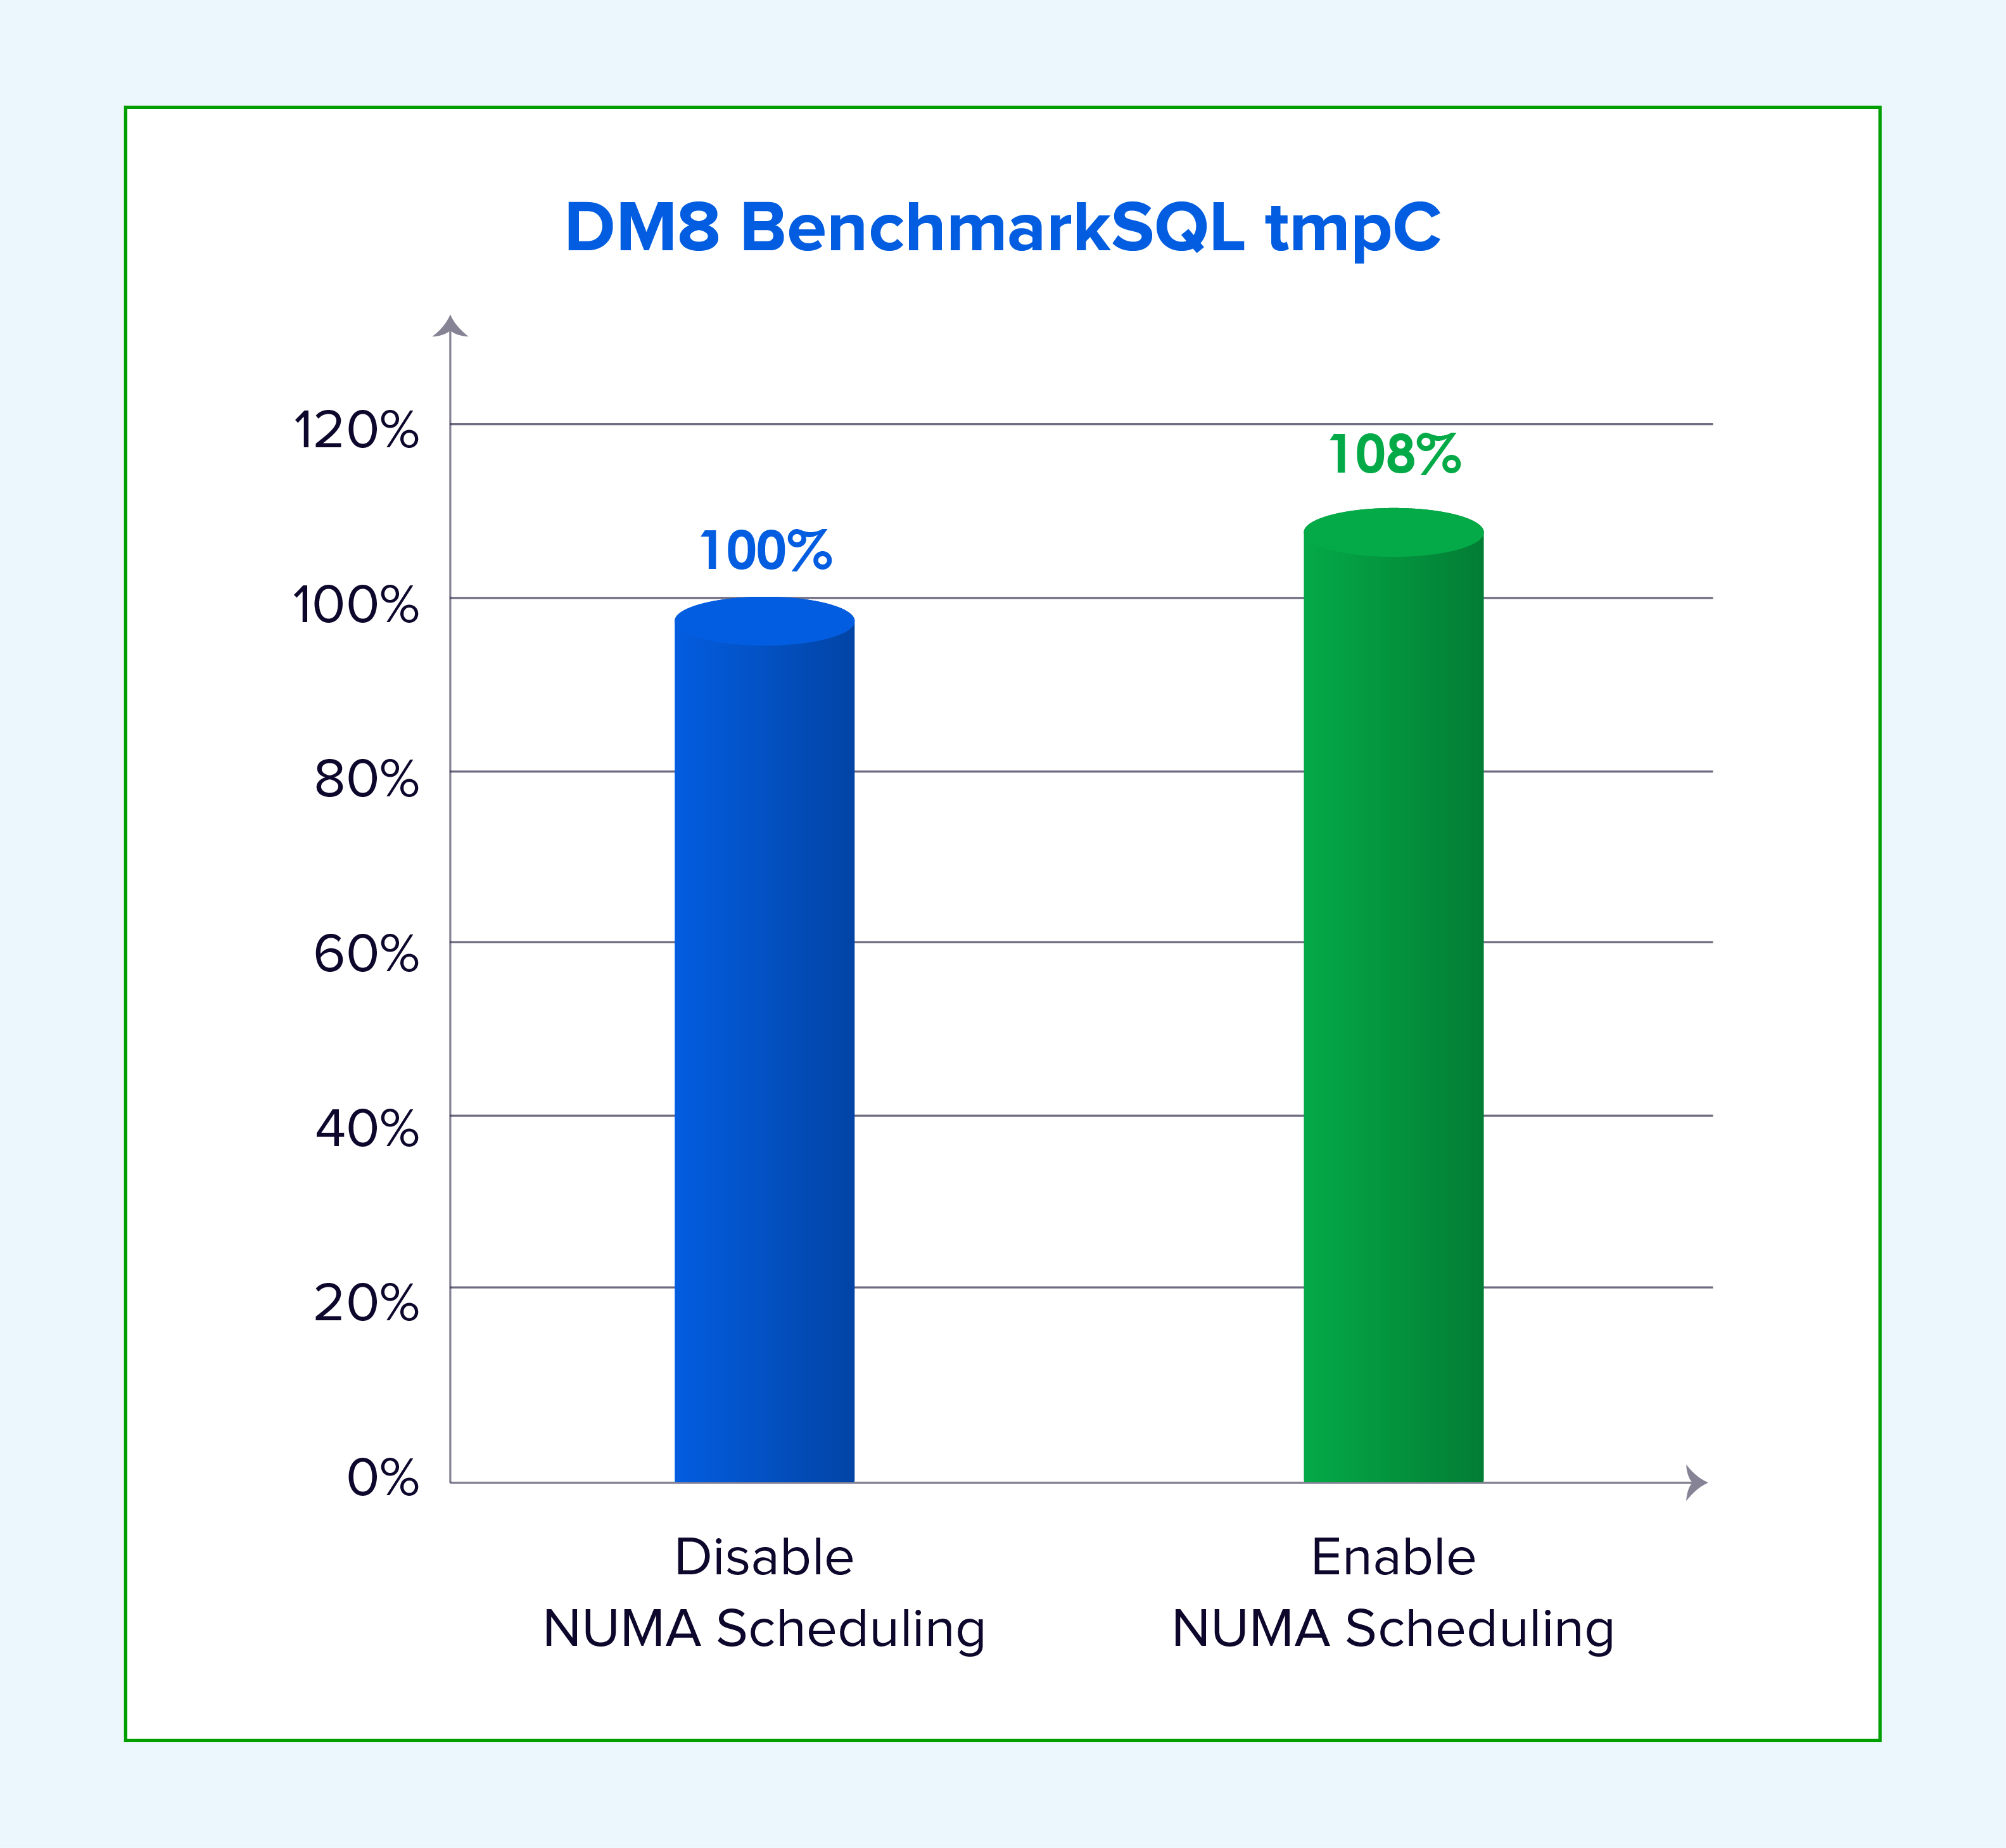
Abbildung 4: Relativer DM8-Transaktionsdurchsatz bei aktiviertem bzw. deaktiviertem NUMA-Scheduling.
In-Memory-Caching: Redis 7.2.5
redis-benchmark ist das offizielle Redis-Performance-Testtool. Sangfor nutzte es, um die GET- und SET-QPS für 1-KB-Werte mit deaktiviertem und aktiviertem NUMA-Scheduling zu testen. QPS steht für die Anzahl der Lese- oder Schreibvorgänge pro Sekunde.
redis-benchmark -t get -d 16 -c 100 -n 6000000 -r 60000000
redis-benchmark -t set -d 16 -c 100 -n 6000000 -r 60000000
Die folgende Grafik zeigt die relative Leistung, wobei das QPS-Ergebnis ohne NUMA auf 100 % normiert wurde.
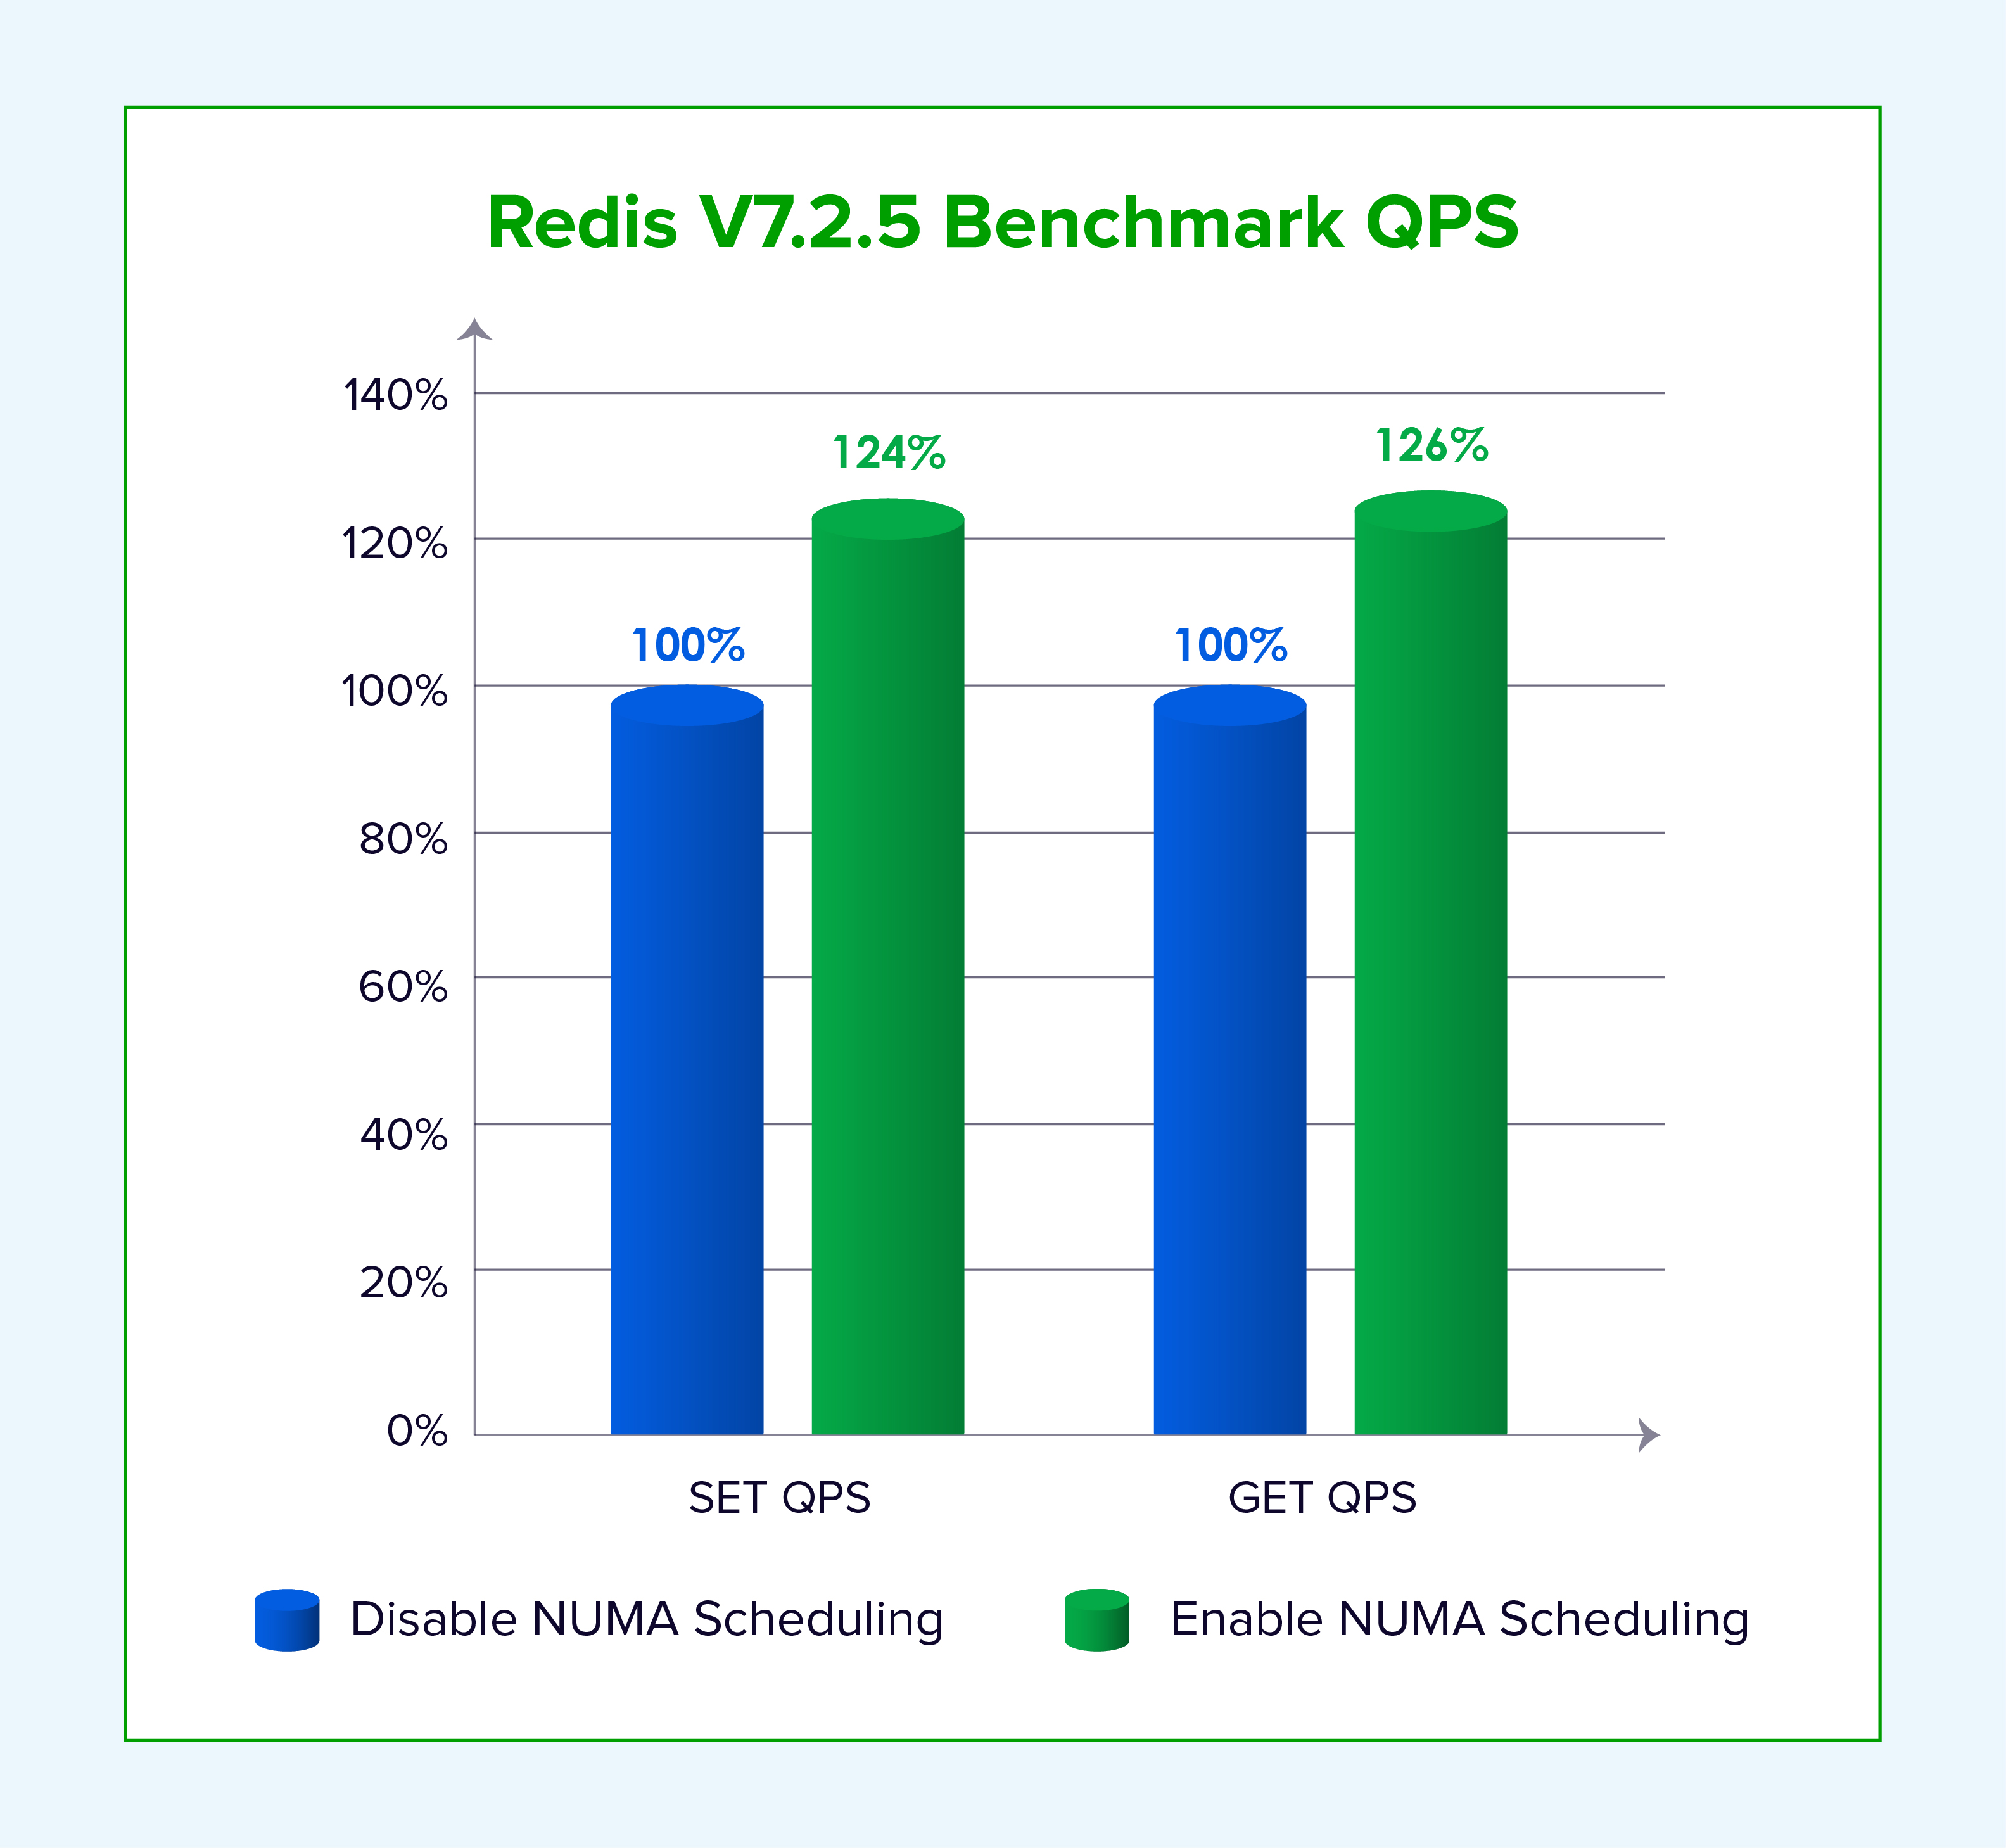
Abbildung 5: Relative Redis-Lese-/Schreib-QPS-Leistungssteigerungen bei aktiviertem NUMA-Scheduling.
Key-Value-Caching: Memcached 6.27
memaslap ist ein in Memcached integriertes Tool für Leistungstests. Sangfor nutzte es, um die Transaktionsrate (TPS) für 1-KB-Werte mit deaktiviertem und aktiviertem NUMA-Scheduling zu testen.
memaslap -s 127.0.0.1:11211 -t 300s -T 8
Die folgende Grafik zeigt die relative Leistung, wobei das TPS-Ergebnis ohne NUMA auf 100 % normiert wurde.
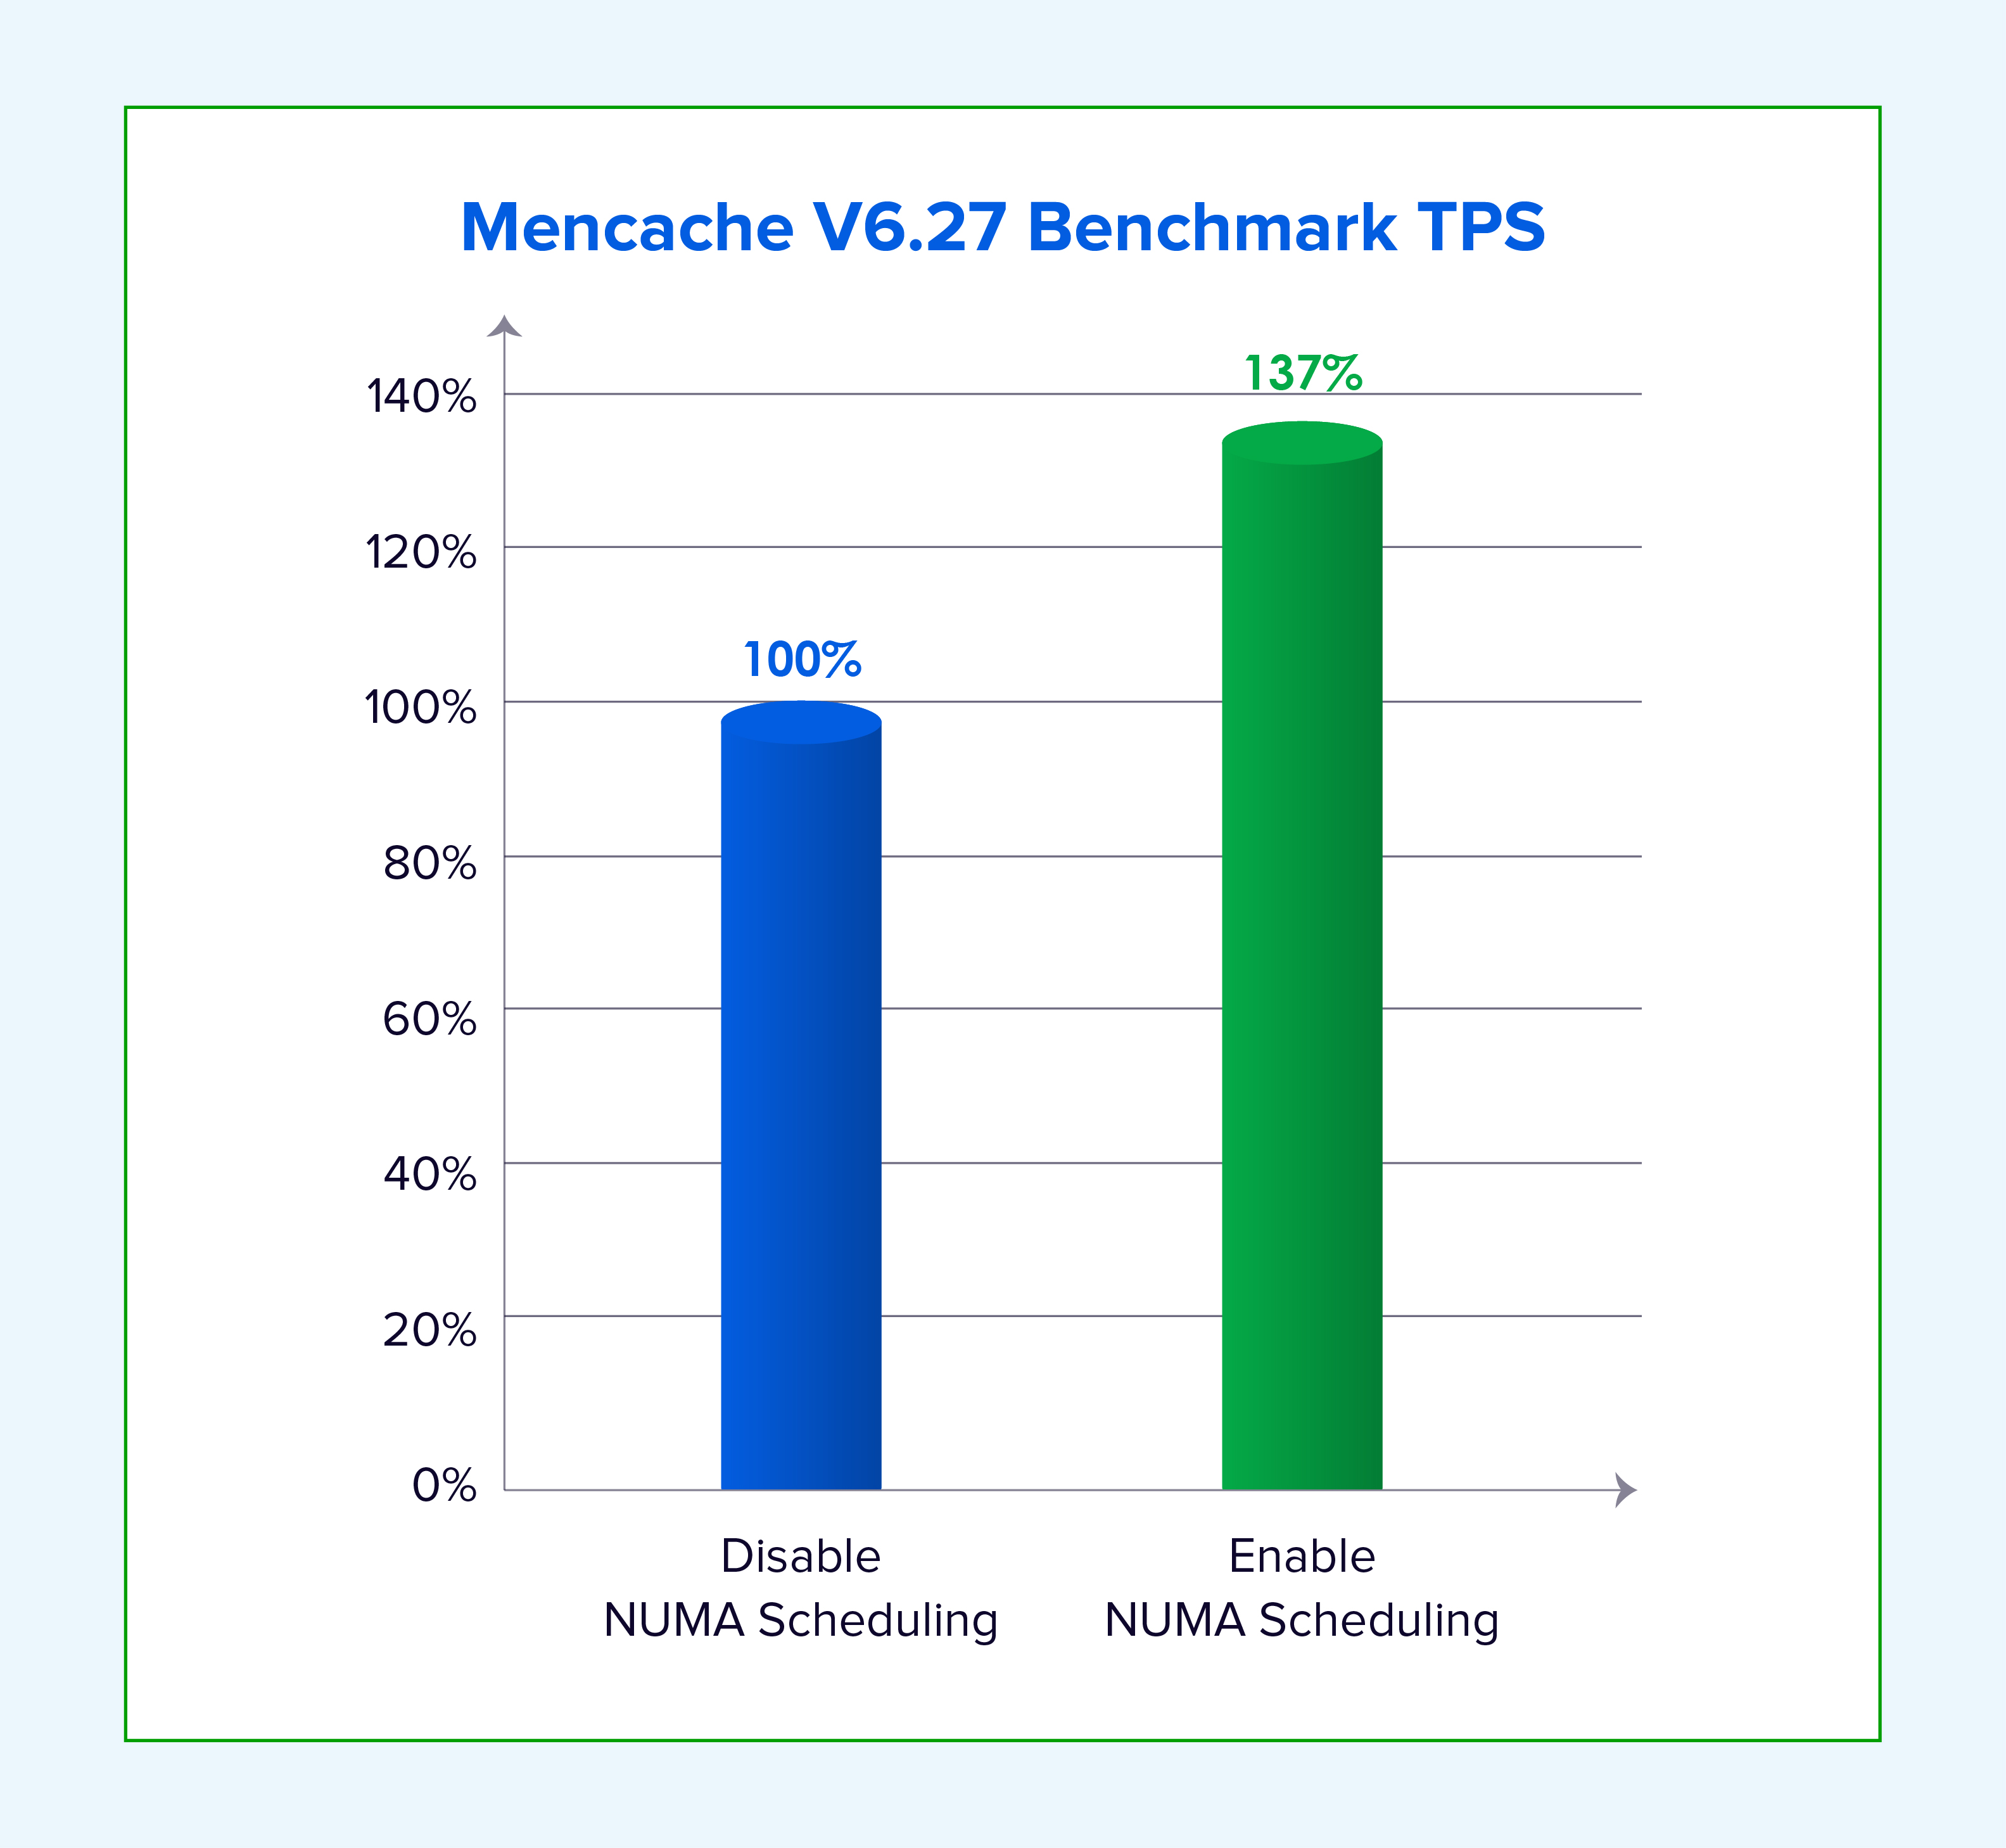
Abbildung 6: Relative Steigerung des Transaktionsdurchsatzes von Memcached bei aktiviertem NUMA-Scheduling.
Die obigen Ergebnisse zeigen deutliche Vorteile für speicherintensive Anwendungen. In den folgenden Abschnitten wird die Funktionsweise der Optimierung erläutert.
1. Adaptive NUMA-Knotenzuweisung
Sangfor partitioniert VM-vCPUs adaptiv und plant sie auf geeigneten NUMA-Knoten ein, um den Zugriff auf den Remote-Speicher zu reduzieren. Ist die Anzahl der VM-vCPUs geringer als die Kernanzahl eines NUMA-Knotens, wird die VM auf einem einzelnen Knoten ausgeführt. Benötigt die VM mehr Kerne, als ein Knoten bereitstellen kann, wird sie auf mehrere Knoten verteilt, und die vNUMA-Topologie wird dem Gastbetriebssystem zur Verfügung gestellt, damit dieses topologiebasierte Entscheidungen treffen kann.
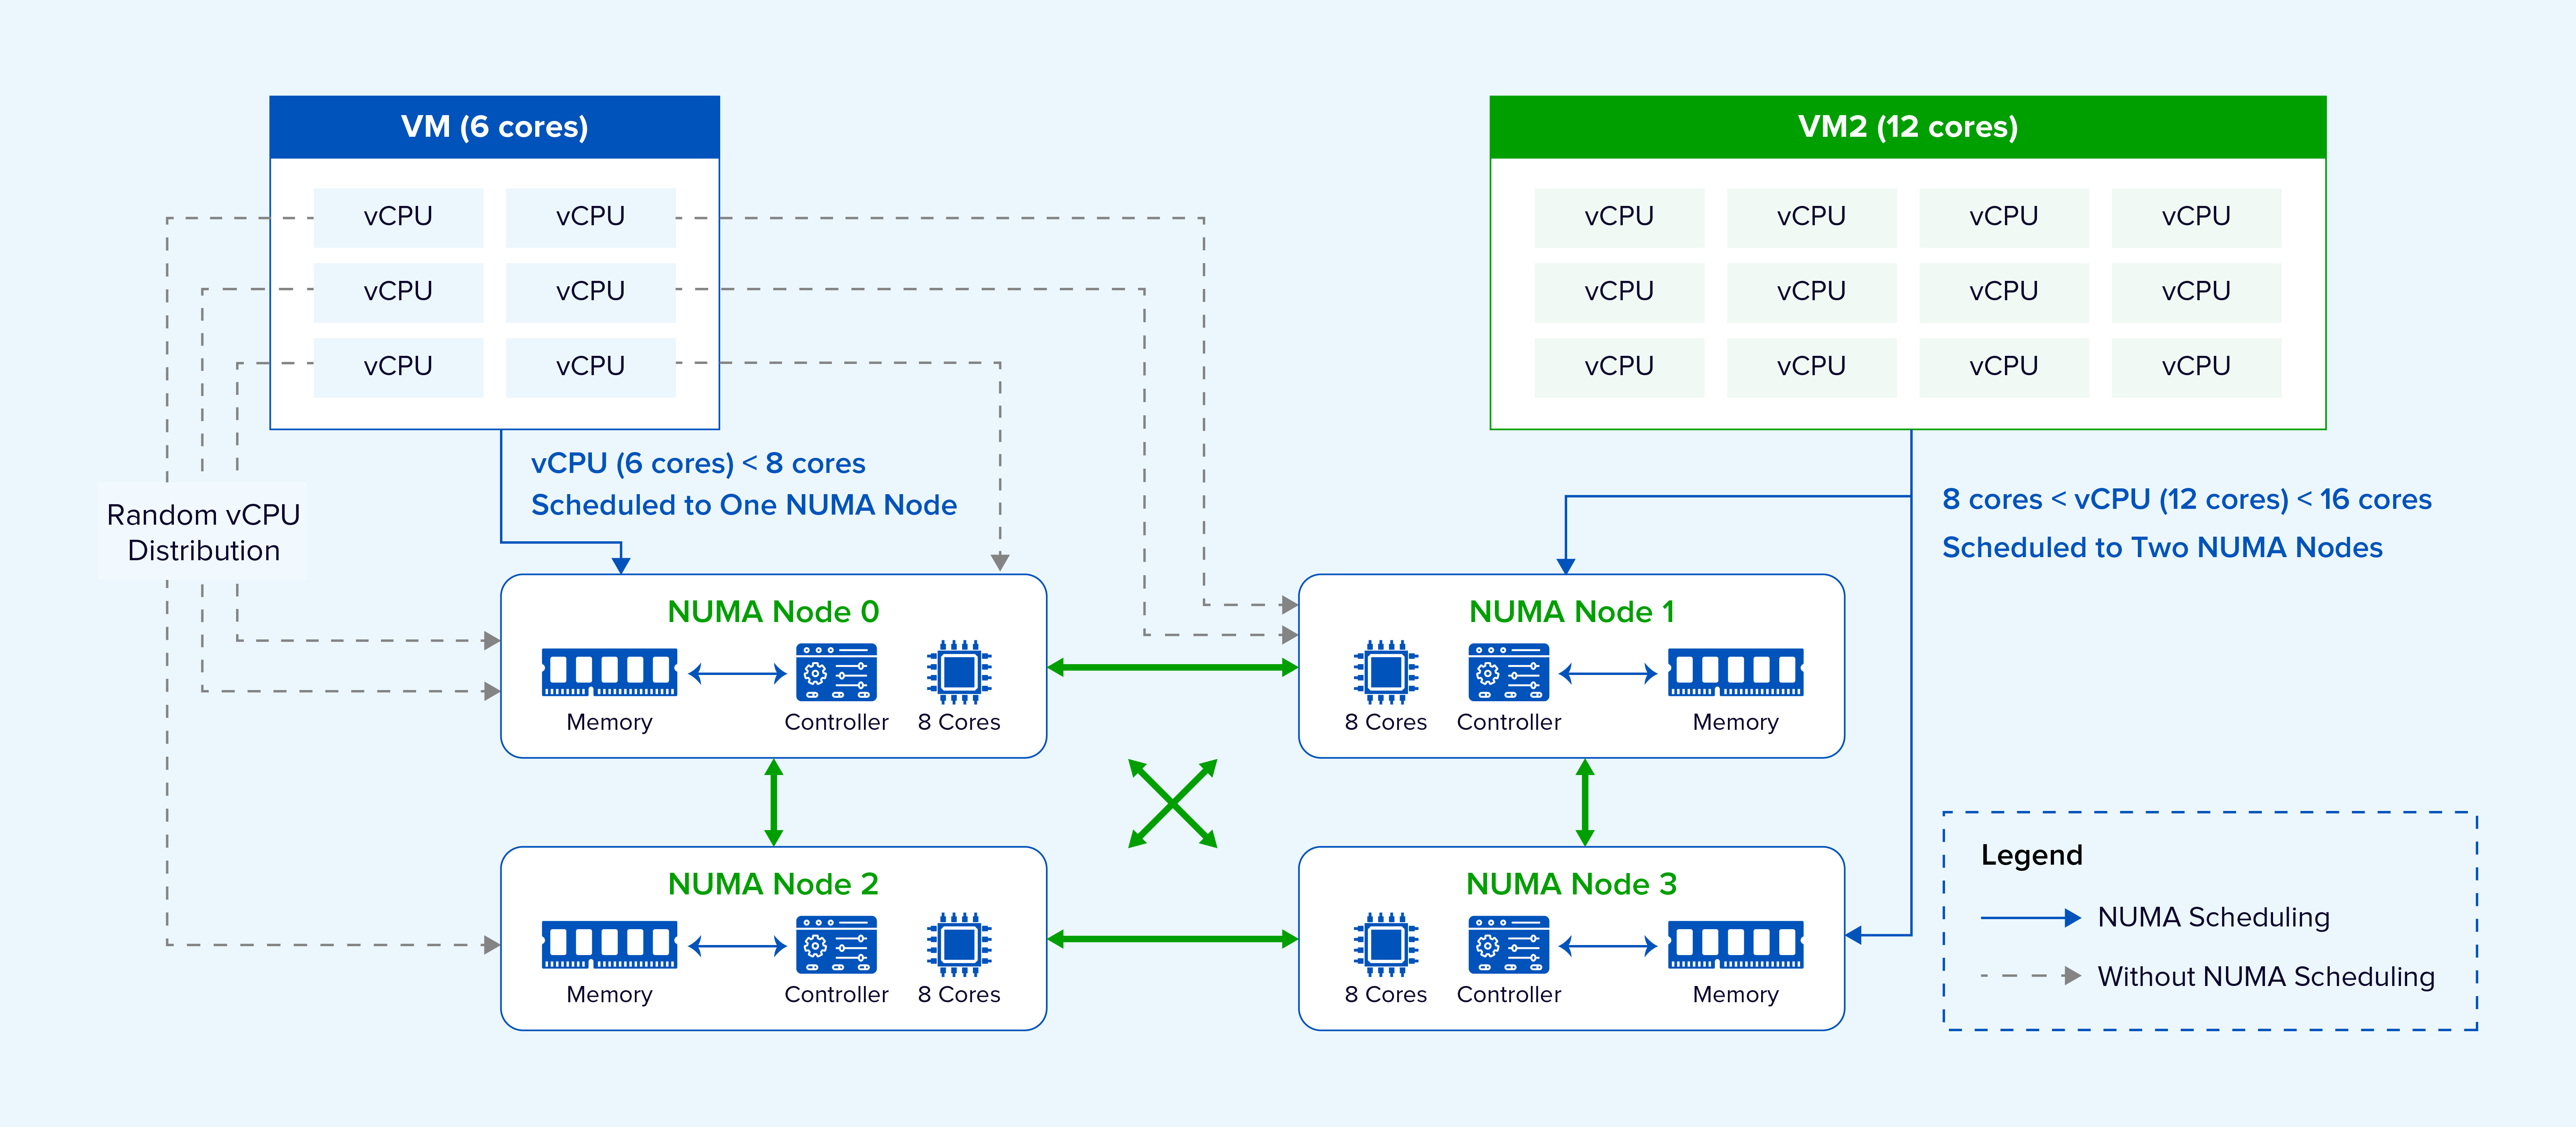
Abbildung 7: Intelligente vCPU-Partitionierung und vNUMA-Topologieabbildung von Sangfor.
Um eine gleichmäßige Auslastung zu gewährleisten, berücksichtigt die VM-Platzierung die aktuelle Last der NUMA-Knoten und wählt einen weniger ausgelasteten Knoten aus. Während der Laufzeit können VMs je nach Auslastung zwischen Knoten migriert werden. Prioritäre VMs werden bevorzugt auf weniger ausgelasteten Knoten platziert, um die Konkurrenz um CPU-, Speicherbandbreite und Cache-Ressourcen zu reduzieren.
2. Optimierung für heterogene Serverplattformen
Manche Serverplattformen enthalten viele NUMA-Knoten, unterschiedliche Abstände zwischen den Knoten und relativ wenige Kerne pro Knoten.
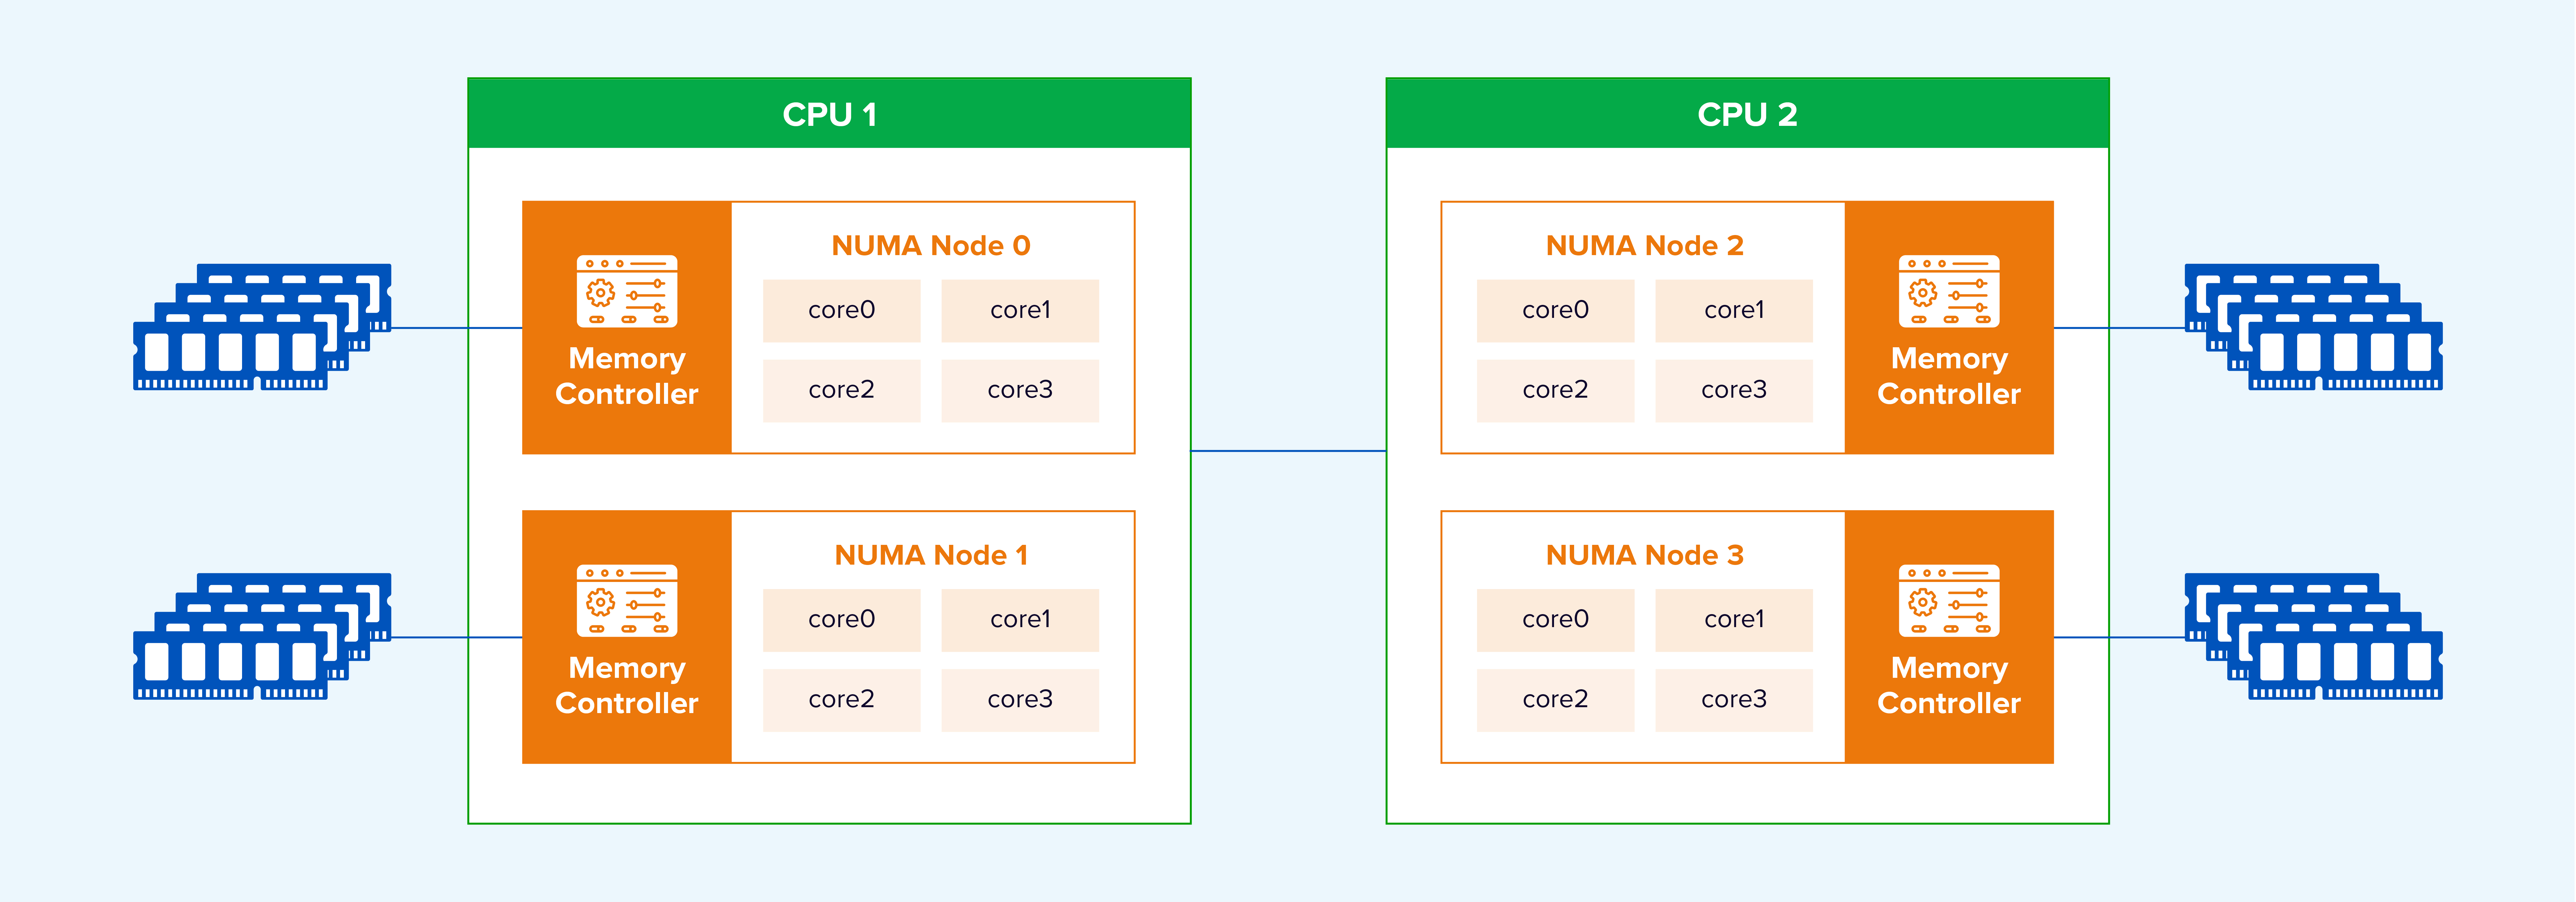
Abbildung 8. Topologiebewusste vNUMA-Platzierung auf einem Multi-Node-Server.
Sangfor ermittelt den Abstand zwischen NUMA-Knoten und platziert bevorzugt mehrere vNUMA-Knoten derselben VM auf nahegelegenen physischen NUMA-Knoten.
Um die Leistung der Datenweiterleitung weiter zu verbessern, entwickelte Sangfor die NUMA-Affinität zwischen virtuellen Maschinen (VMs) und Datenprozessen. Die VM und ihr Datenweiterleitungsprozess werden auf demselben NUMA-Knoten ausgeführt, wodurch der lokale Speicherzugriff erhöht wird. In der folgenden Abbildung bezeichnet DP den Datenprozess.
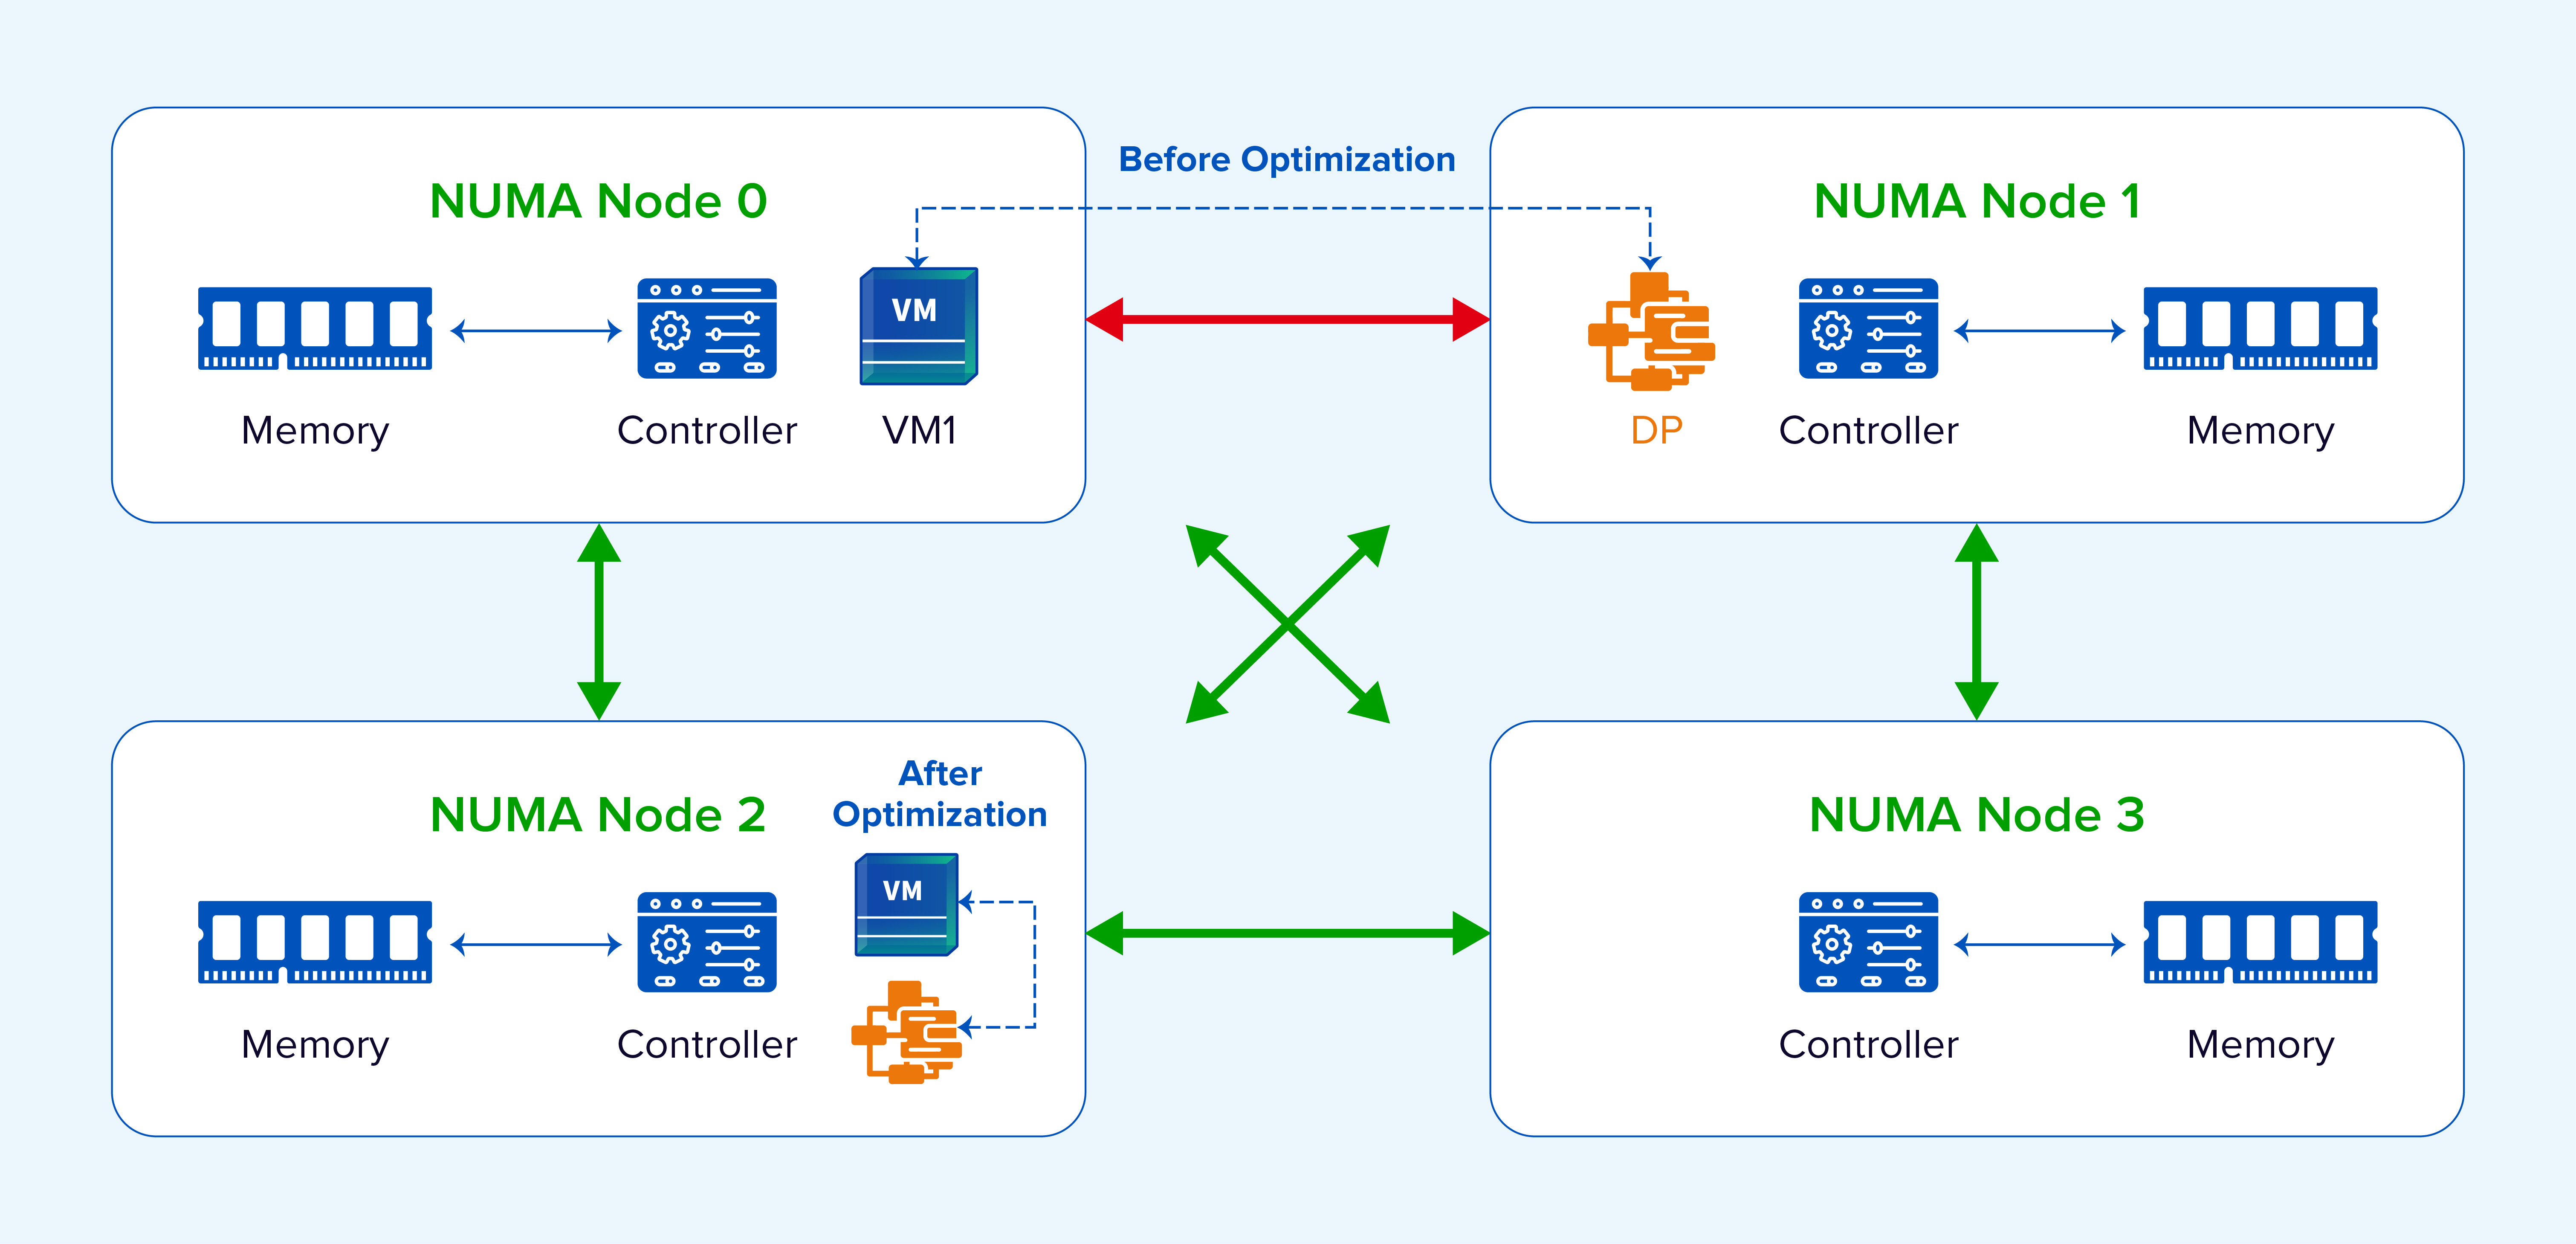
Abbildung 9. Die Affinität zwischen virtueller Maschine und Datenebene sorgt dafür, dass die Verarbeitung nahe am lokalen Speicher stattfindet.
Um die Vorteile von NUMA im gesamten Speicherbereich optimal zu nutzen, platziert Sangfor die vCPU, QEMU, libnfs, aSAN und andere Prozesse, die an einem vollständigen E/A-Pfad beteiligt sind, auf demselben NUMA-Knoten. Dadurch wird der Zugriff auf entfernte Speicher vermieden. Große Speicherseiten verbessern zudem die Speicherzugriffsleistung, reduzieren den Verarbeitungsaufwand und erhöhen die Effizienz des E/A-Flusses.
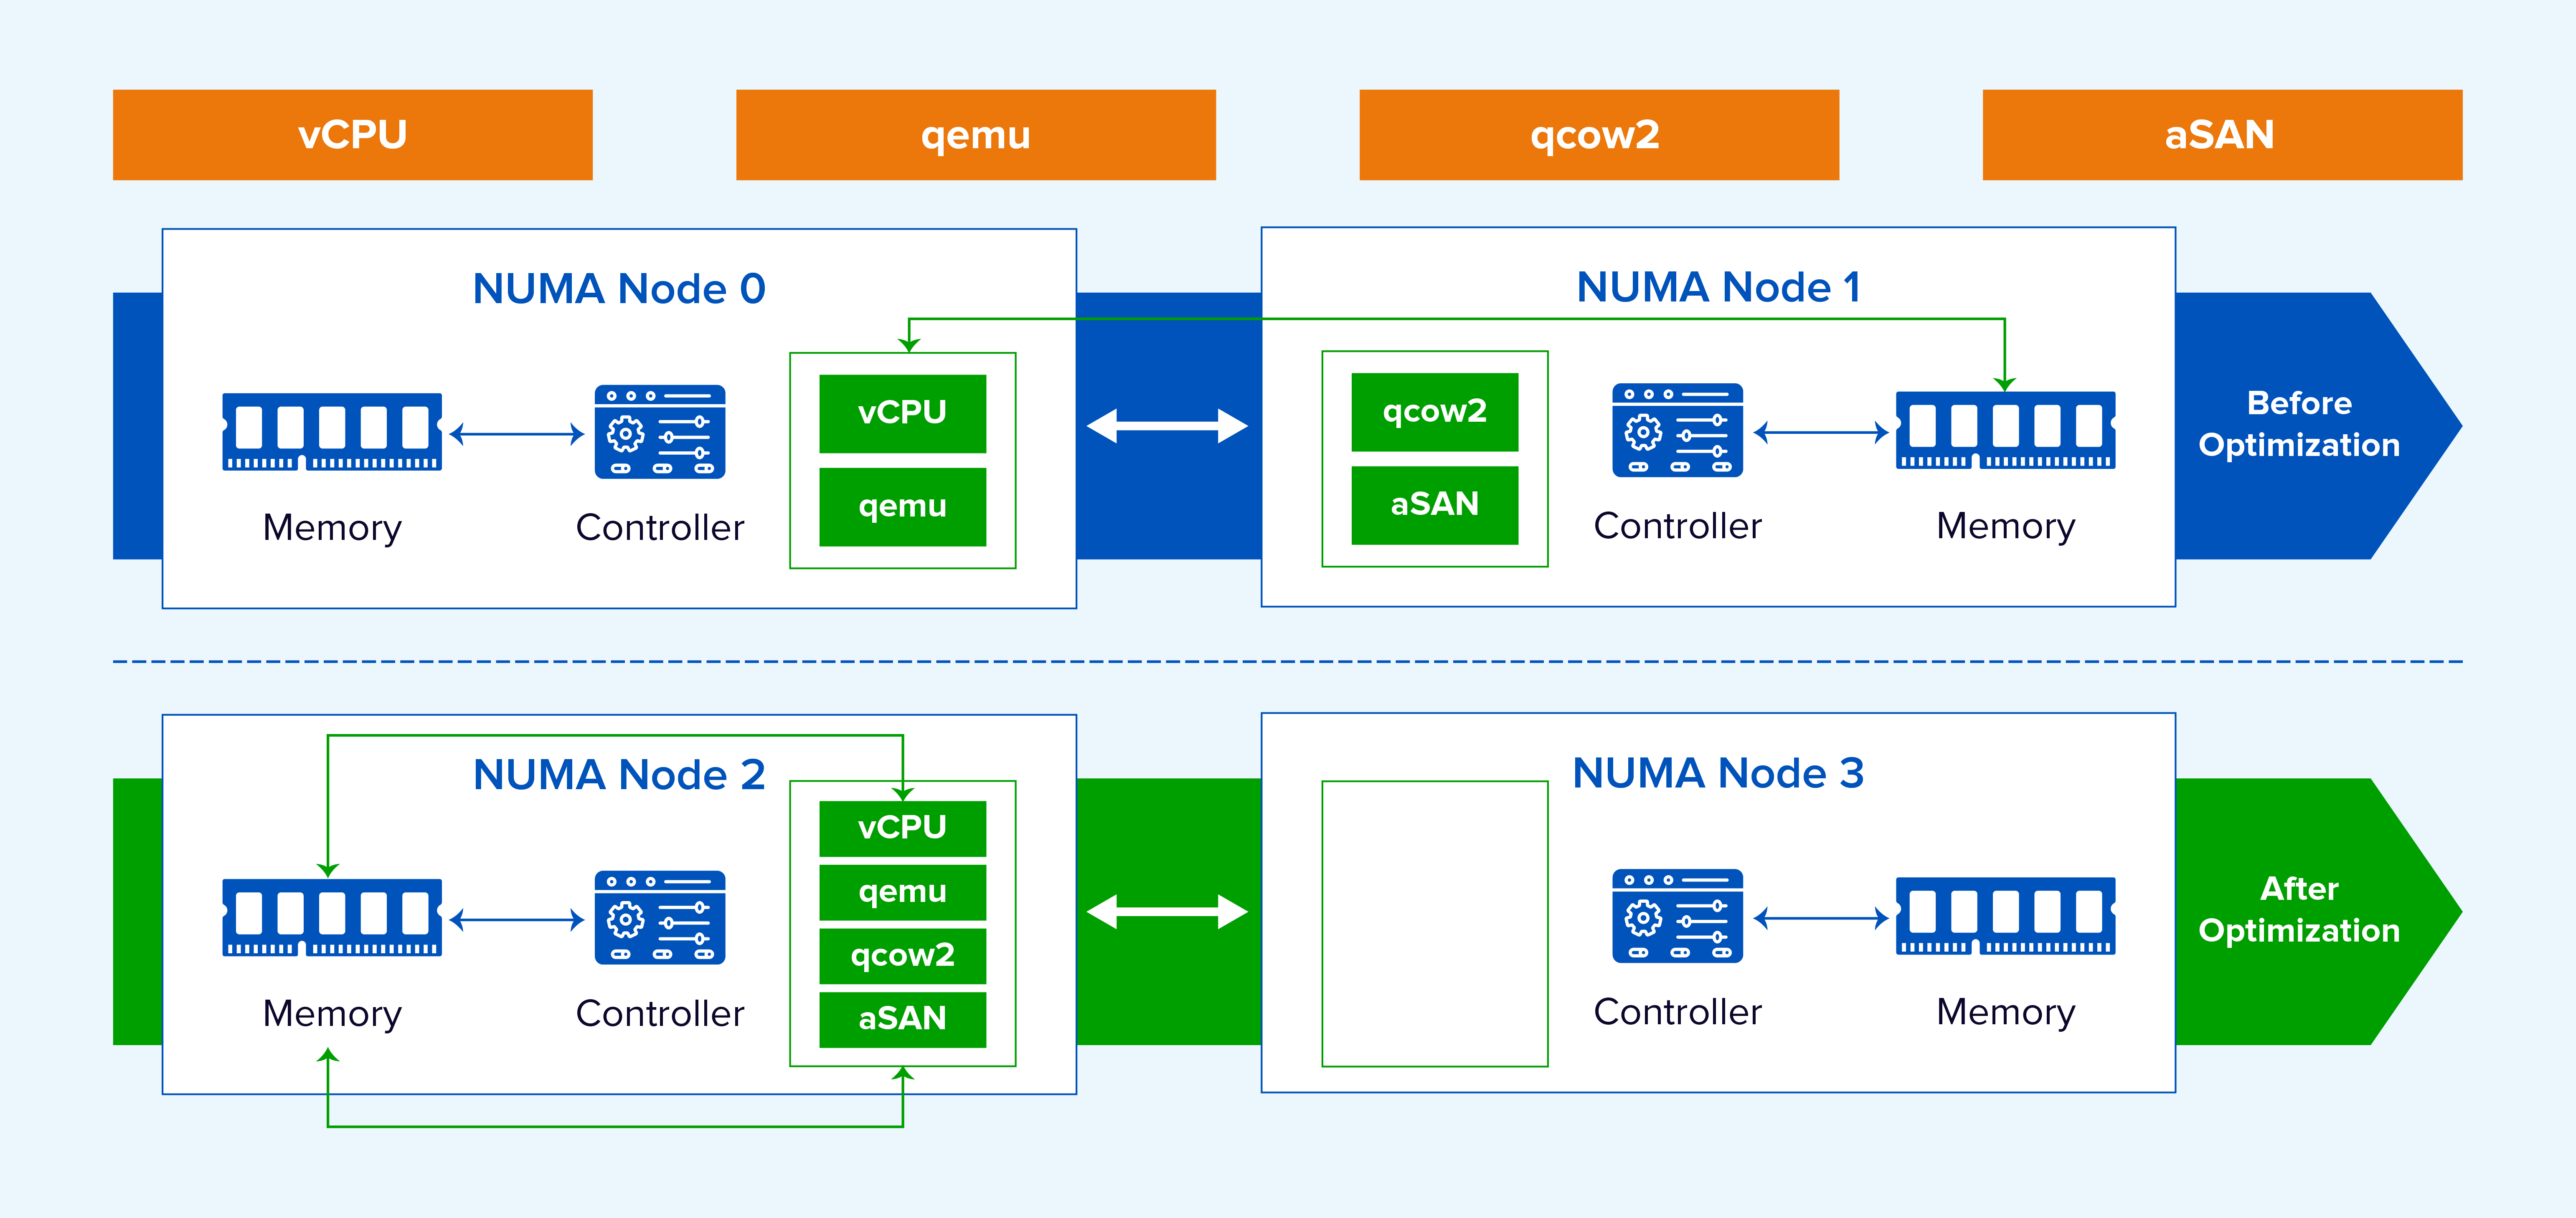
Abbildung 10. Koordinierte NUMA-Platzierung entlang des virtuellen Speicher-E/A-Pfads.
Daten, die von einem NIC-Puffer in den virtuellen Speicher übertragen werden, müssen von CPU-Threads verarbeitet werden. Mit steigender Netzwerkleistung kann die Effizienz des Pufferkopierens auf einem einzelnen Kern zum Flaschenhals werden, während der Zugriff über NUMA-Kerne die Effizienz zusätzlich verringert. Sangfor ermöglicht die Verarbeitung des NIC-Datenverkehrs durch mehrere CPU-Kerne und wendet NUMA-Affinität an. Dadurch wird der Flaschenhals auf einem einzelnen Kern beseitigt, die Übertragungslatenz reduziert und die Parallelverarbeitung verbessert. Interne Tests führten zu einer Verbesserung der Schreibleistung von VMs mit hoher Warteschlangenlänge und großen Blöcken um mehr als 20 %.
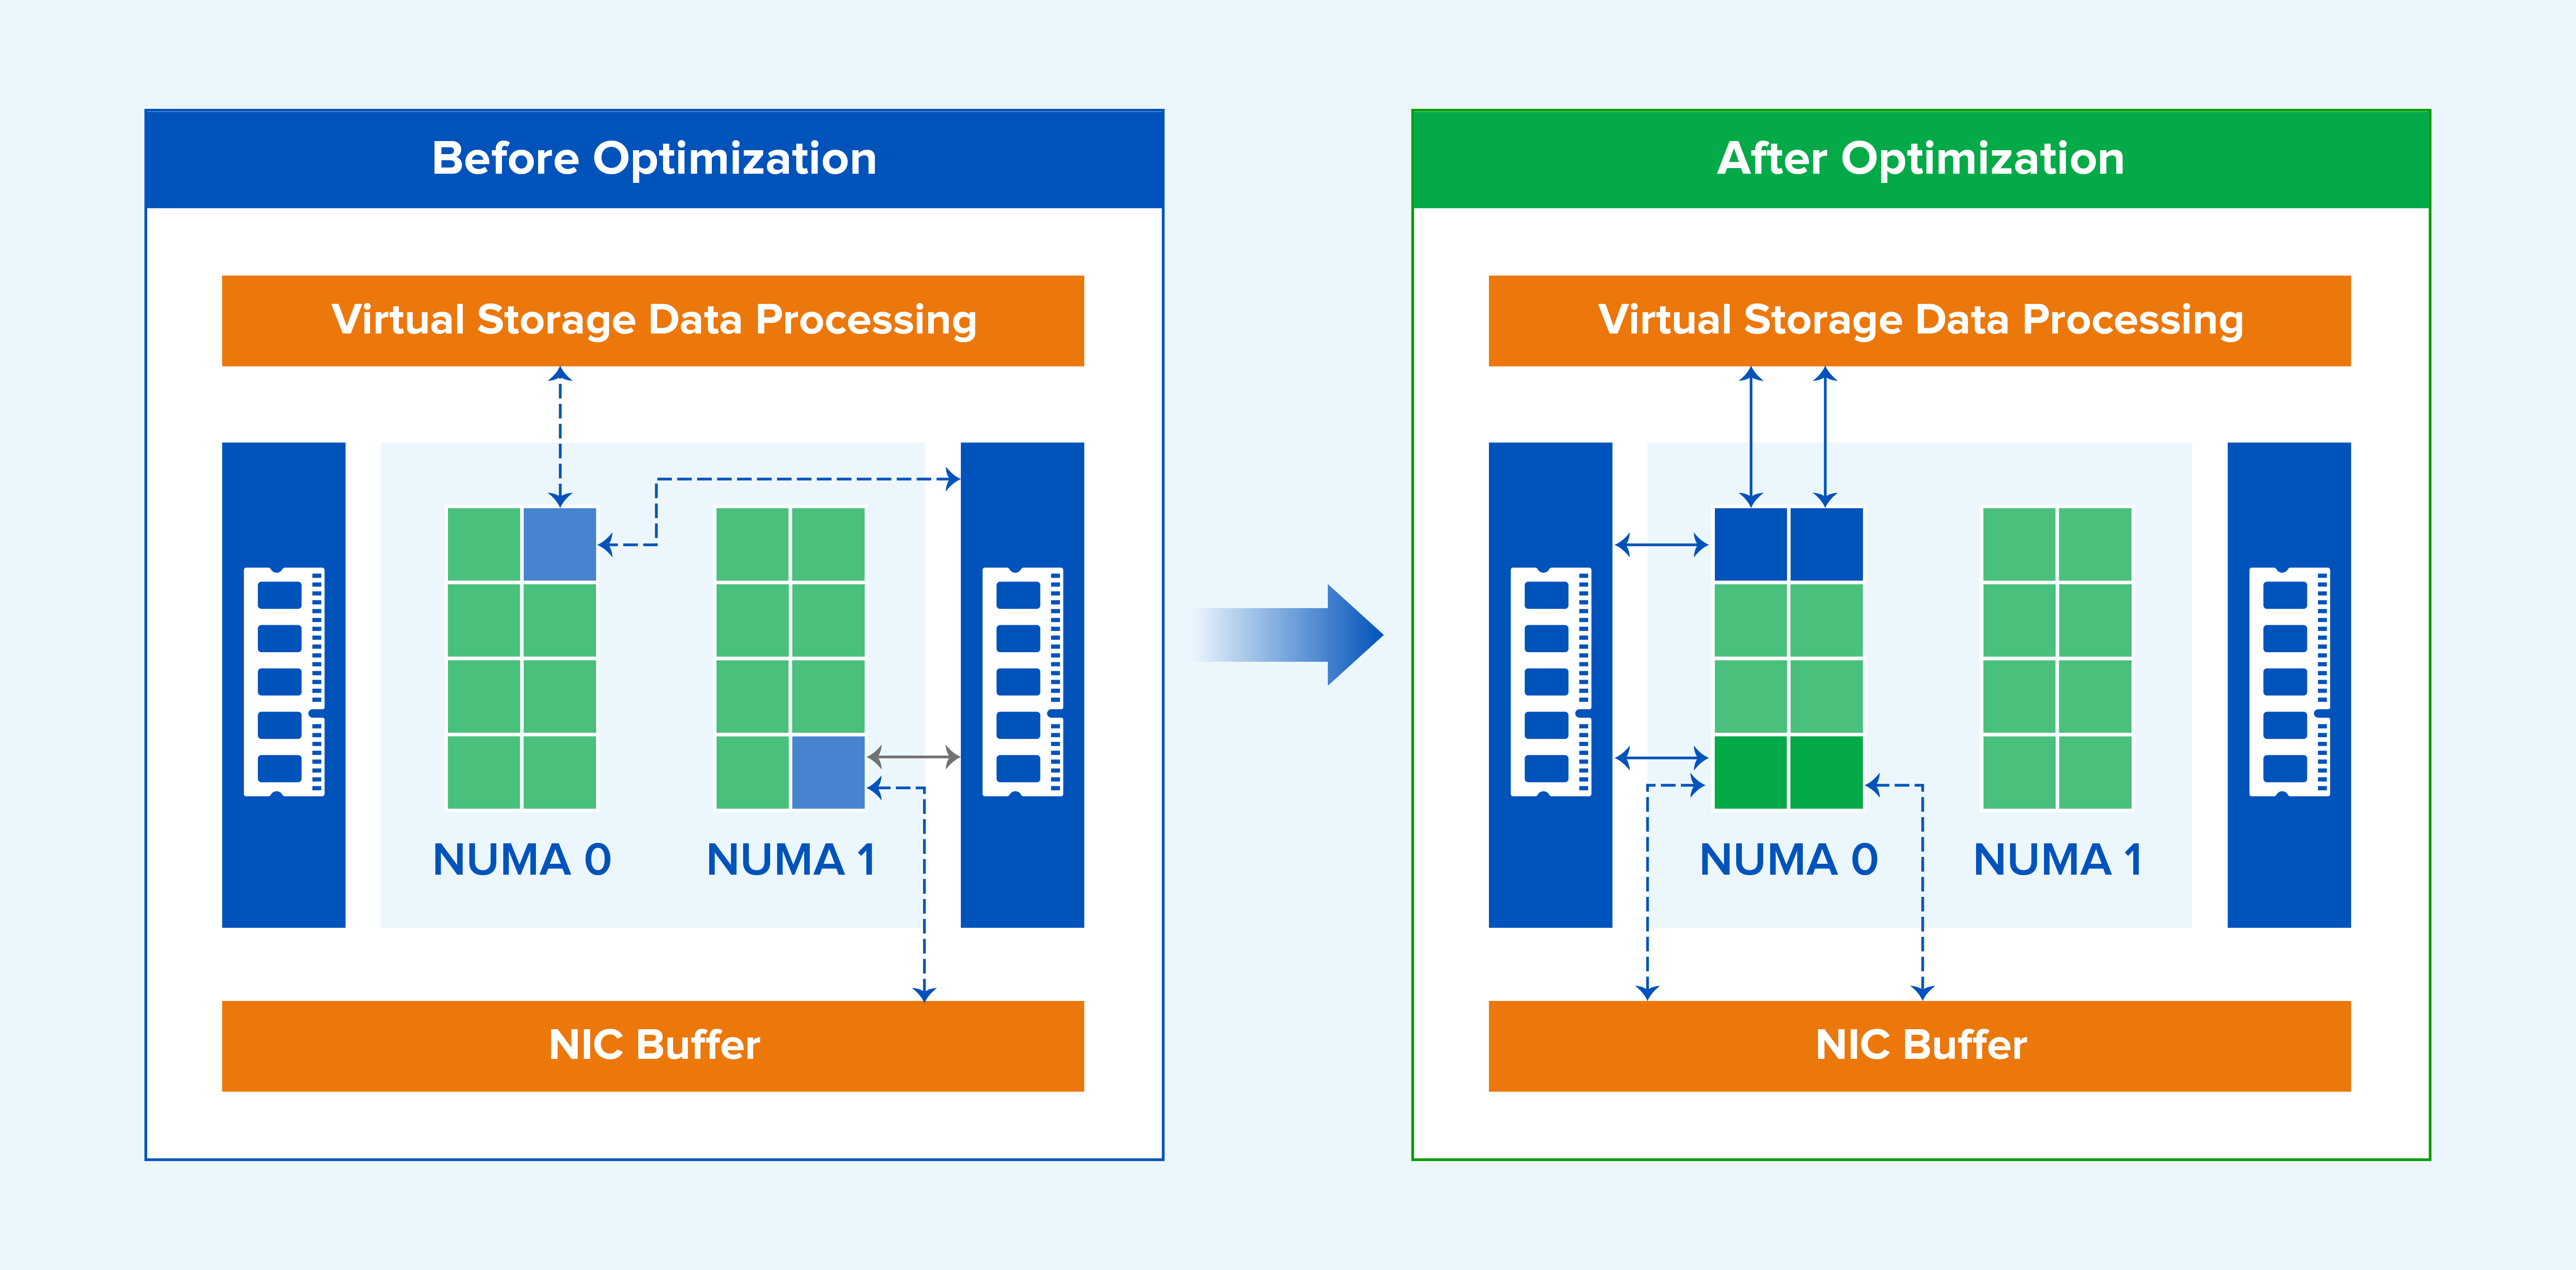
Abbildung 11. Multi-Core, NUMA-affine Verarbeitung zwischen NIC-Puffer und virtuellem Speicher.
3. Vergleich mit anderen Branchenansätzen
Die Unterstützung durch die Branche ist unterschiedlich. Ein Anbieter erlaubt Administratoren die Konfiguration des NUMA-Knotens, auf dem jede VM-vCPU ausgeführt wird, ein anderer unterstützt diese Funktion nicht, und VMware unterstützt adaptives NUMA-Scheduling.
Sangfor partitioniert und platziert VM-vCPUs automatisch auf NUMA-Knoten, um den Zugriff auf den Remote-Speicher zu reduzieren. Im Vergleich zur manuellen Konfiguration des Standorts jeder vCPU automatisiert die adaptive NUMA-Planung von Sangfor die vCPU-Partitionierung und -Platzierung, gleicht die Auslastung der Knoten aus und verbessert die Gesamtleistung.
Im Vergleich zu einer einfachen adaptiven NUMA-Implementierung erweitert Sangfor die Optimierung auf die Speicherdienstplanung, die Priorisierung von VMs, heterogene Serverplattformen und die VM-Netzwerkaffinität. Diese Erweiterungen sind das Ergebnis gemeinsamer Entwicklungsarbeit der Forschungs- und Cloud-Produktteams von Sangfor und basieren auf dem realen Verhalten von Plattform und Dienst.
TEIL 5. Zusammenfassung
Sangfor Adaptive NUMA Scheduling ist für verschiedene Infrastrukturszenarien optimiert, um die Effizienz des Anwendungsspeicherzugriffs zu verbessern:
- Um den Zugriff auf den Remote-Speicher zu reduzieren, werden die VM-vCPUs adaptiv partitioniert und auf NUMA-Knoten platziert.
- Migrieren Sie VMs zwischen NUMA-Knoten, um eine ausgewogene Auslastung zu gewährleisten.
- Prioritäre VMs identifizieren und auf weniger ausgelasteten Knoten platzieren, um die Konkurrenz um CPU, Speicherbandbreite und Cache zu verringern.
- Bei Servern mit vielen NUMA-Knoten und unterschiedlichen Abständen zwischen den Knoten wird der topologische Abstand ermittelt und zugehörige vNUMA-Ressourcen bevorzugt auf nahegelegenen physischen NUMA-Knoten platziert.
- Bieten Sie eine VM-Netzwerkaffinitätsoption an, die eine VM auf demselben NUMA-Knoten wie die Netzwerkdatenebene platziert, um die Weiterleitungsleistung zu verbessern.
- Wenden Sie NUMA-fähiges Scheduling nicht nur auf VMs, sondern auch auf Speicherdienste an.
UnixBench-Testbeispiel
UnixBench ist ein weit verbreiteter Benchmark für Unix-ähnliche Systeme, einschließlich UNIX, BSD und Linux. Er misst verschiedene Systemleistungsdimensionen, darunter CPU-, Dateisystem-, Speicher- und Prozessleistung.
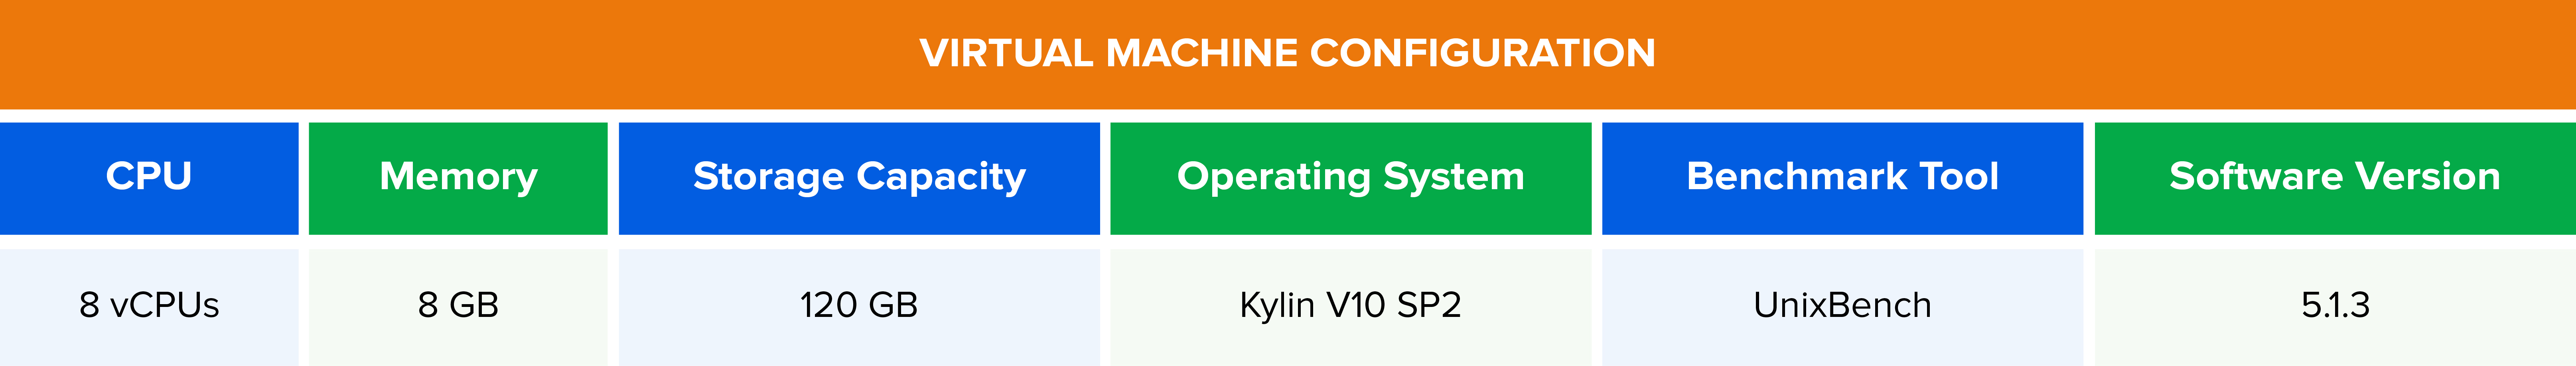
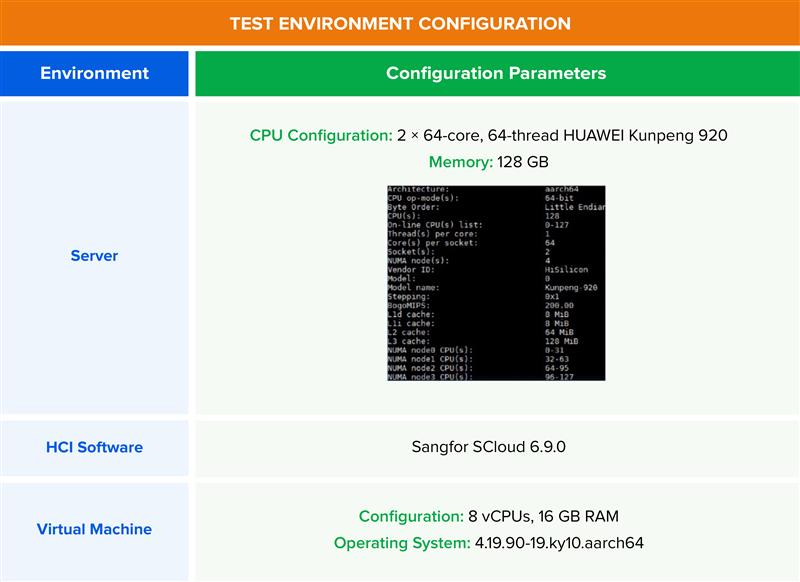
Abbildung 12. Konfiguration der virtuellen Maschine für UnixBench-Tests.
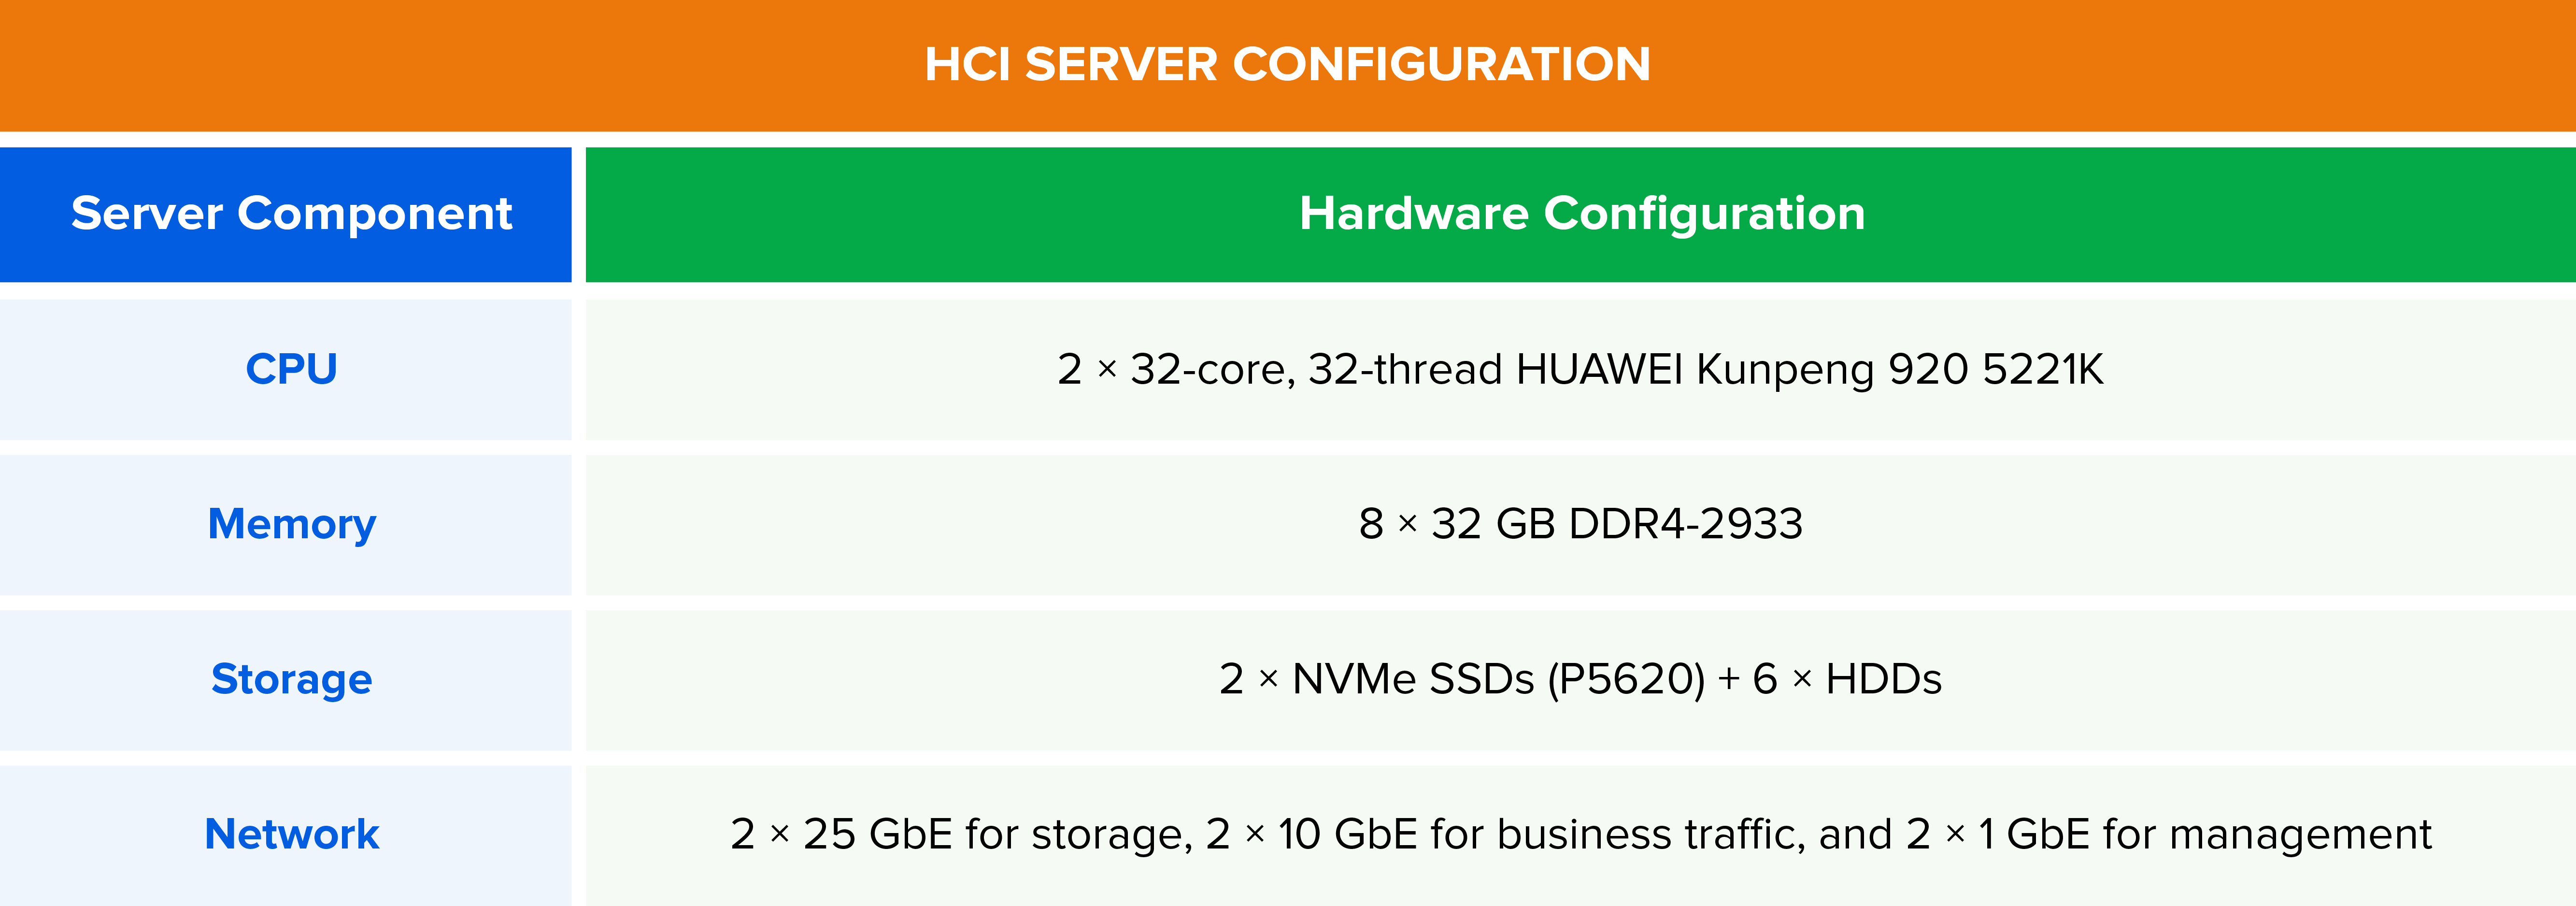
Abbildung 13. Hardwarekonfiguration des HCI-Servers für UnixBench-Tests.
Testergebnisse: In Sangfor HCI 6.9.0 mit aktiviertem NUMA war der aggregierte UnixBench-Score für 6 gleichzeitig auf demselben Host laufende VMs um 20,2 % höher als auf der anonymisierten Vergleichsplattform. Bei 8 gleichzeitig laufenden VMs lag der aggregierte Score um 34,17 % höher.
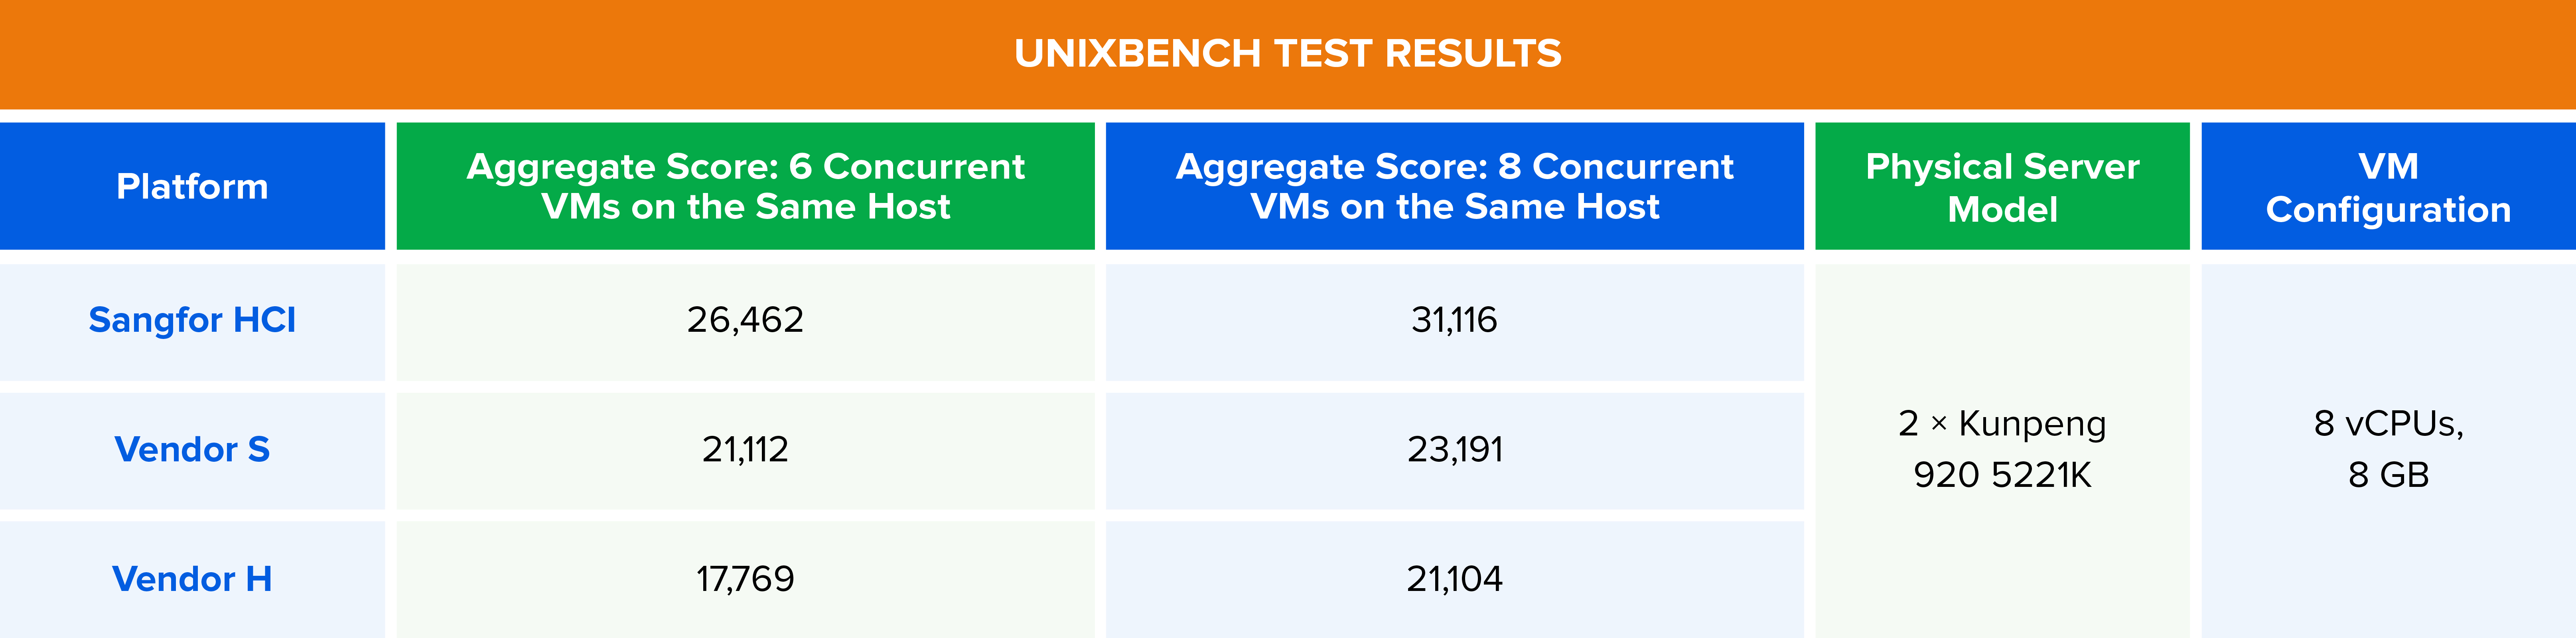
Abbildung 14. Vergleich der UnixBench-Benchmark-Ergebnisse unter gleichzeitiger virtueller Maschinenlast.
Die in diesem Artikel dargestellten Benchmark-Ergebnisse basieren auf spezifischen internen Testumgebungen von Sangfor und dienen der technischen Veranschaulichung. Die tatsächlichen Ergebnisse können je nach Hardware, Softwareversion, Konfiguration und Arbeitslast variieren. Kunden sollten repräsentative Anwendungen anhand ihrer eigenen Service-Level-Ziele validieren.

