
Seiring semakin banyak organisasi memindahkan beban kerja penting bisnis ke infrastruktur virtualisasi, hyperconverged, dan cloud, performa di bawah konkurensi tinggi telah menjadi prioritas utama. Bagi tim yang mengevaluasi pengganti VMware , pertanyaannya bukan hanya apakah platform lain dapat menyediakan fungsionalitas serupa, tetapi apakah platform tersebut dapat mempertahankan latensi, throughput, dan stabilitas yang dibutuhkan oleh sistem bisnis inti.
Tantangan ini terutama terlihat pada aplikasi yang membutuhkan banyak memori, termasuk perdagangan frekuensi tinggi dan manajemen risiko di sektor jasa keuangan, sistem rekam medis elektronik di sektor kesehatan, dan sistem manajemen gudang di sektor logistik. Kebutuhan akses memori yang terus meningkat terkait erat dengan komponen backend seperti Redis, Apache Spark, SAP HANA, dan mesin atau model AI. Redis, misalnya, adalah basis data dalam memori yang kinerjanya secara langsung dipengaruhi oleh kecepatan akses memori.
NUMA kini menjadi arsitektur CPU server utama. Oleh karena itu, peningkatan efisiensi akses memori di bawah NUMA merupakan aspek penting dari optimasi kinerja virtualisasi. Artikel ini menjelaskan teknologi optimasi NUMA Sangfor dan bagaimana teknologi tersebut membantu platform virtualisasi mendukung beban kerja penting bisnis yang sangat konkuren selama penggantian VMware .
BAGIAN 1. Latar Belakang Arsitektur NUMA
Sistem komputer awal biasanya menggunakan satu prosesor untuk semua tugas komputasi. Seiring aplikasi menjadi lebih kompleks dan menuntut, satu prosesor tidak lagi dapat memenuhi persyaratan komputasi berkinerja tinggi, dan sistem secara bertahap berevolusi menuju arsitektur multi-inti.
Sistem multi-core tradisional umumnya menggunakan multiprocessing simetris (SMP). Di bawah SMP, semua prosesor memiliki status yang sama dan hak akses yang sama ke memori. Setiap thread dapat berjalan pada prosesor mana pun, memungkinkan penyeimbangan beban yang efektif dan meningkatkan kinerja serta throughput secara keseluruhan. Namun, karena beberapa core berbagi bus yang sama untuk mengakses memori, bus tersebut dapat menjadi hambatan (bottleneck) seiring bertambahnya jumlah core, sehingga membatasi skalabilitas dan kinerja.
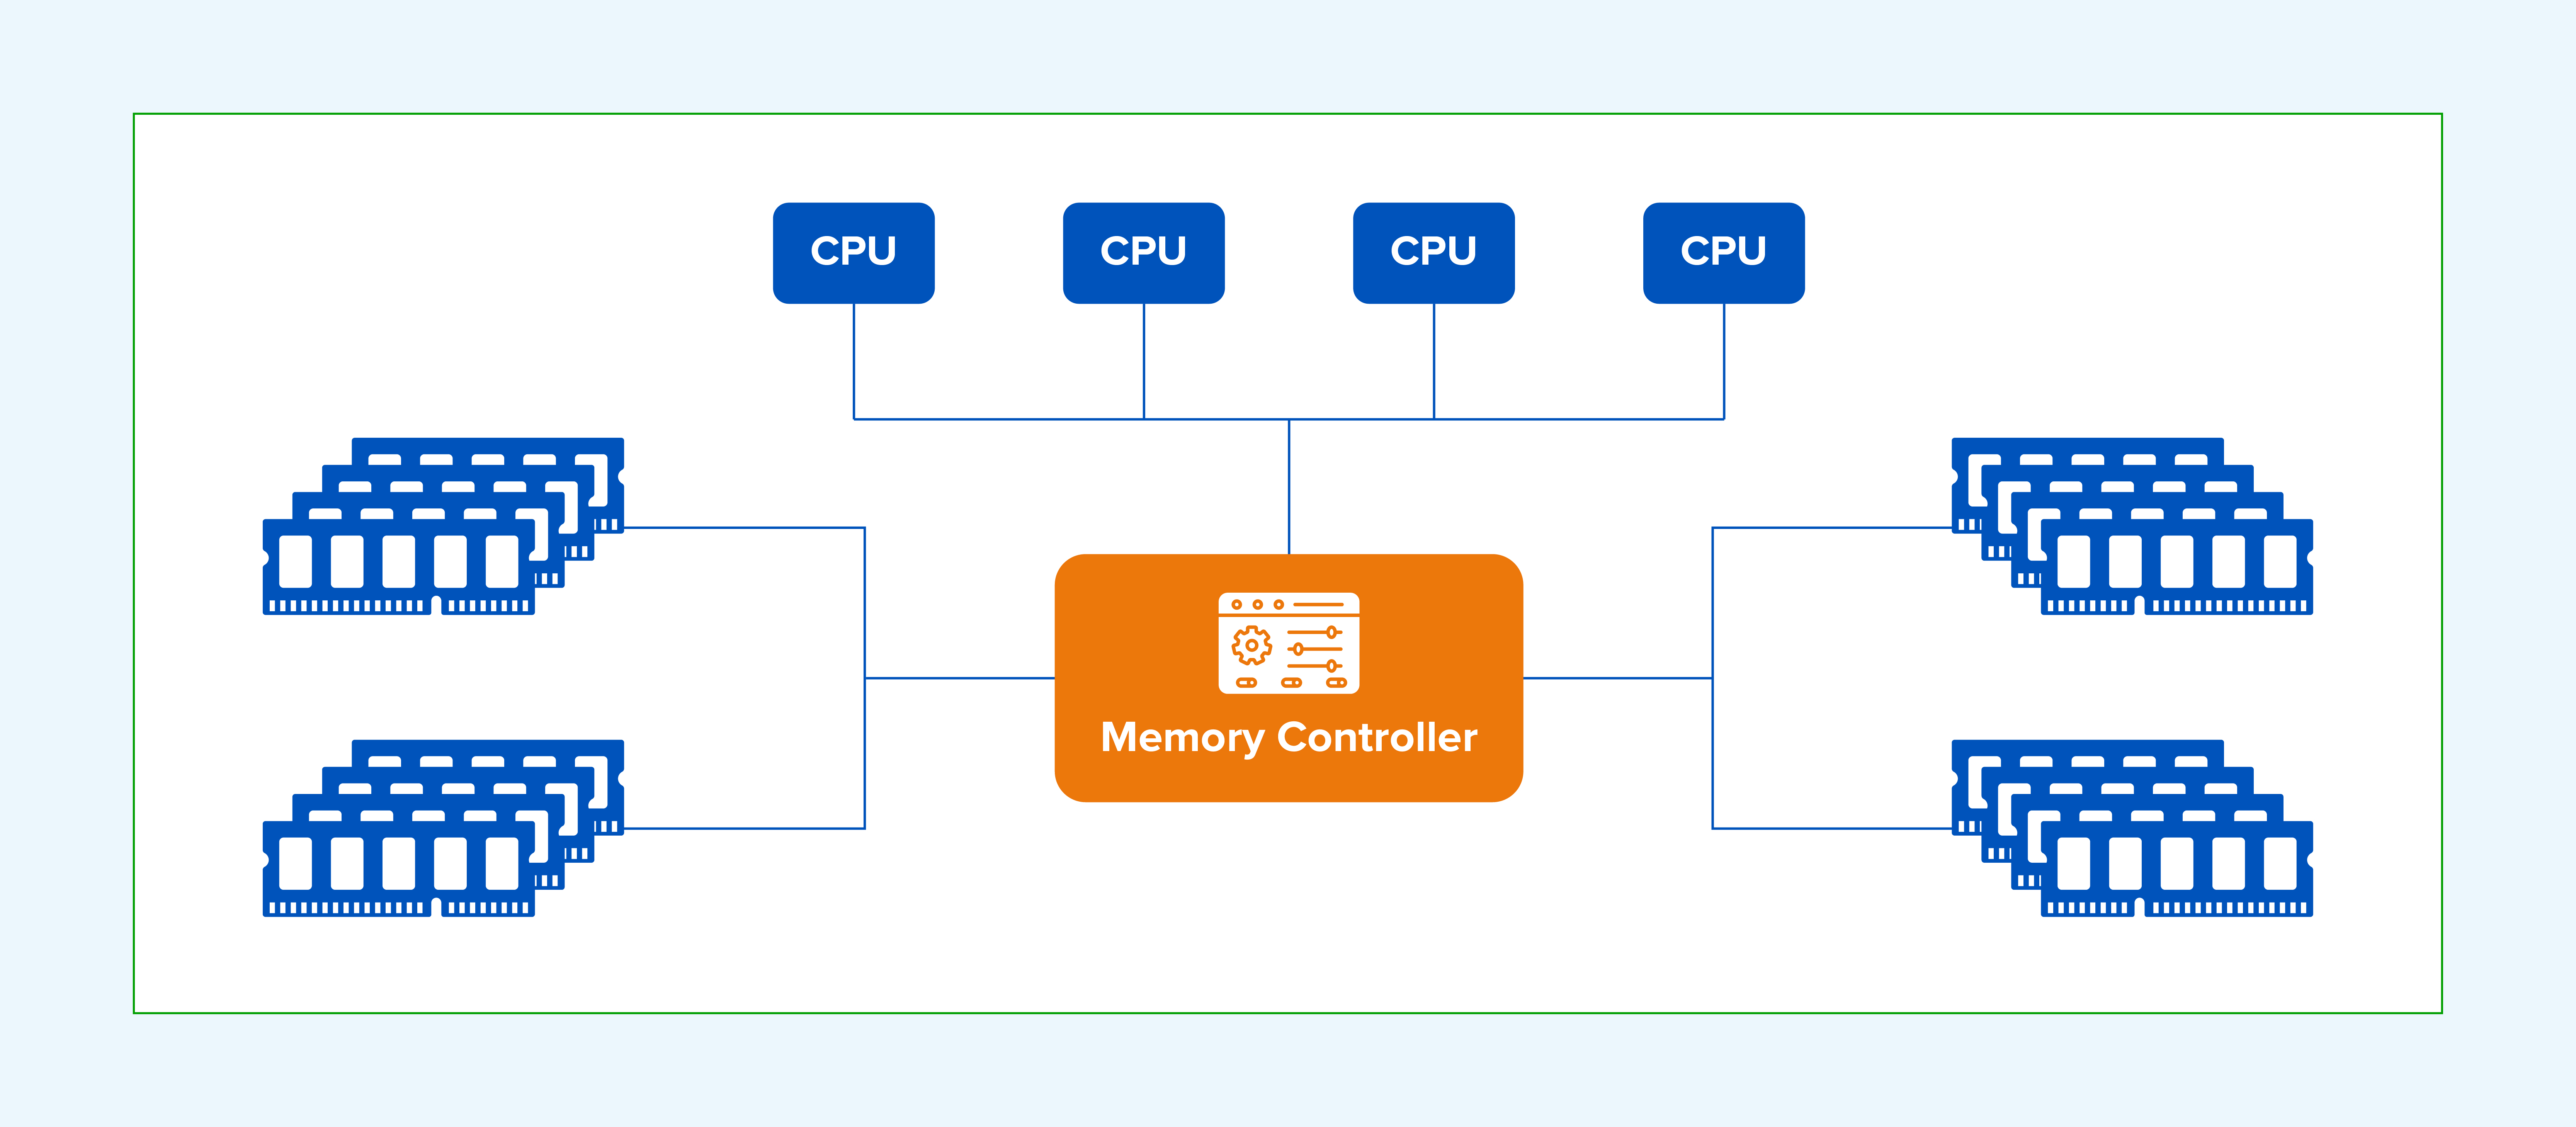
Gambar 1: Hambatan akses memori bus bersama pada arsitektur SMP tradisional.
NUMA mengatasi hambatan akses memori pada SMP. Dalam arsitektur NUMA, sistem dibagi menjadi beberapa node, masing-masing berisi satu atau lebih prosesor, memori lokal, dan perangkat I/O. Node berkomunikasi melalui interkoneksi berkecepatan tinggi—seperti AMD HyperTransport atau Intel QuickPath Interconnect (QPI)—memungkinkan prosesor untuk mengakses memori lokal terlebih dahulu, yang mengurangi latensi akses memori dan meningkatkan kinerja sistem multiprosesor.
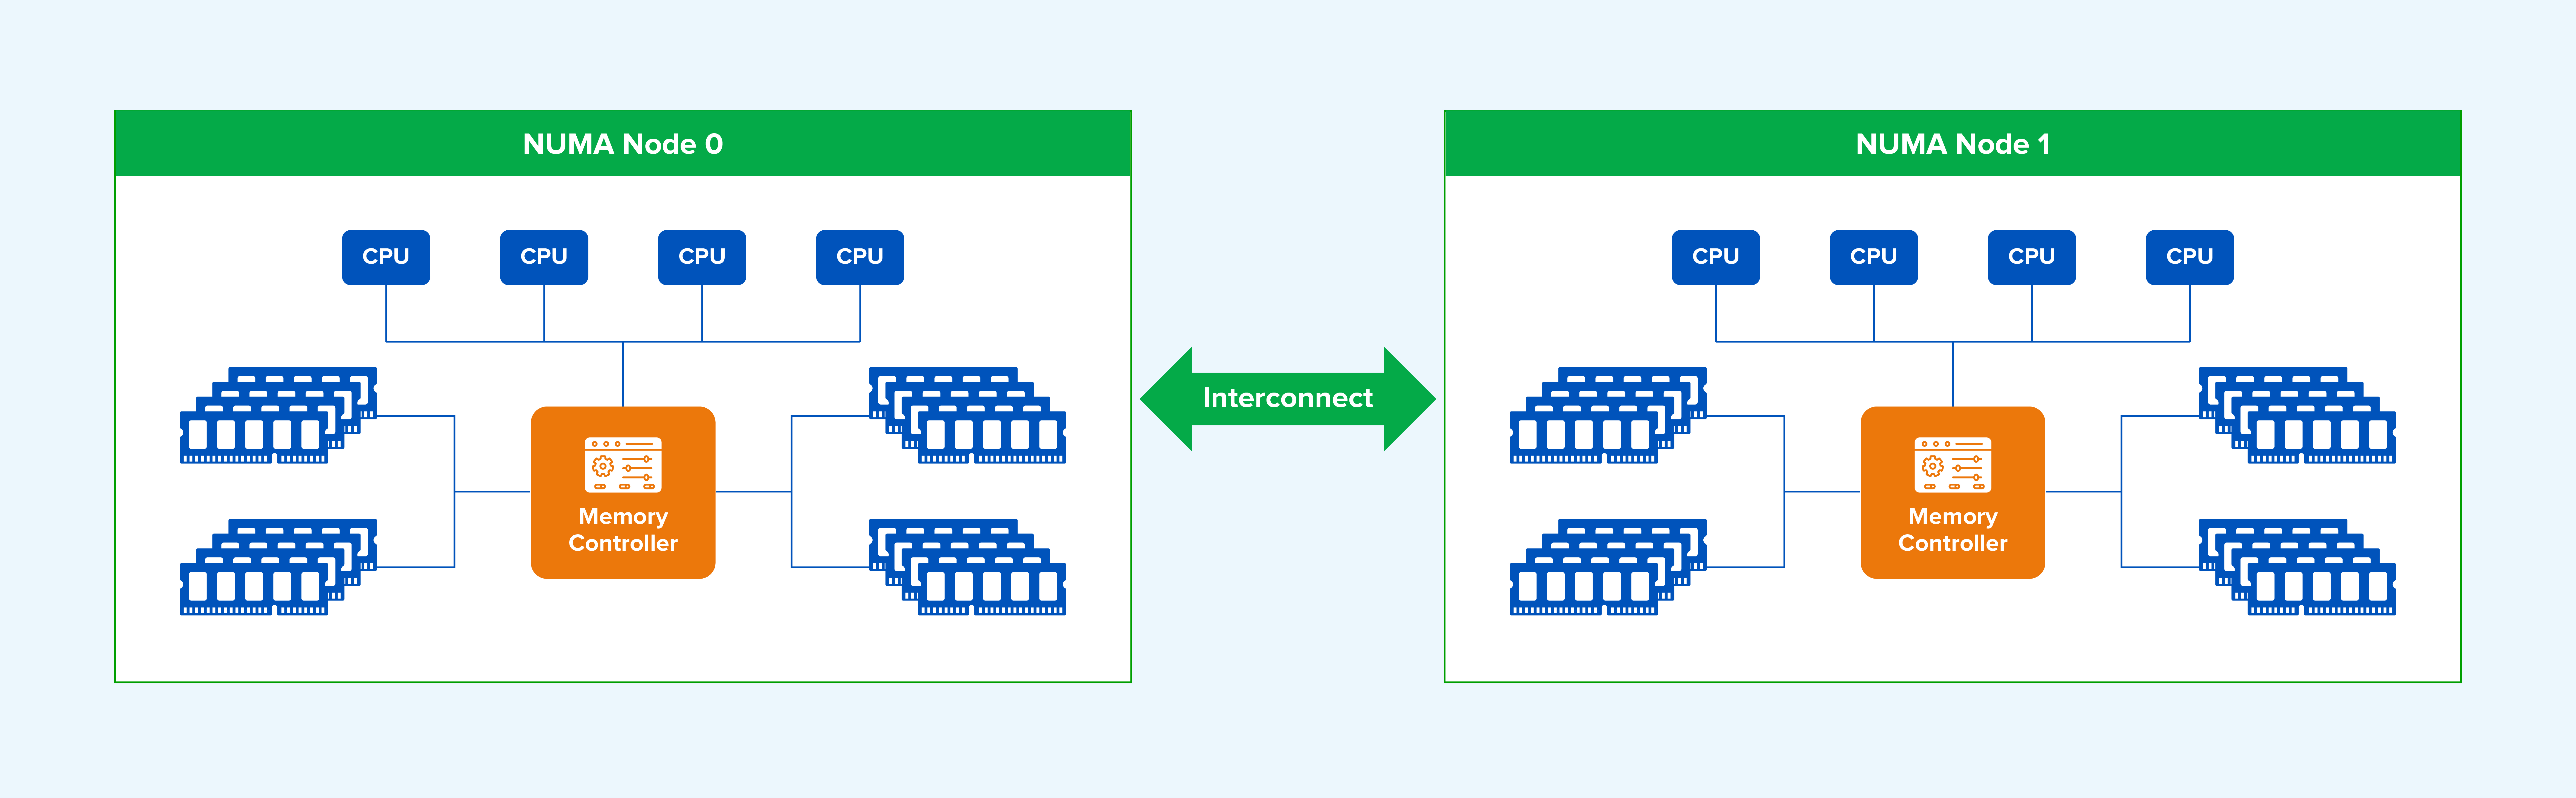
Gambar 2: Arsitektur NUMA multi-node yang menampilkan alokasi CPU dan memori lokal node.
Sistem NUMA berisi tiga jenis node:
- Node lokal: Untuk CPU yang berada dalam node tertentu, node tersebut adalah node lokal.
- Node tetangga: Node yang berdekatan dengan node lokal.
- Node jarak jauh: Sebuah node yang bukan lokal maupun tetangga.
Kecepatan akses CPU berbeda-beda tergantung jenis node. Memori lokal adalah yang tercepat untuk diakses, sedangkan memori jarak jauh adalah yang paling lambat. Secara umum, akses memori menjadi lebih lambat seiring bertambahnya jarak topologi.
Dalam “NUMA: Gambaran Umum,” Dr. Christoph Lameter mencatat bahwa, pada server dua node kelas atas pada tahun 2013, latensi akses memori lokal acak sekitar 100 ns, sedangkan akses memori jarak jauh menambahkan sekitar 50% lebih banyak latensi.
BAGIAN 2. Tantangan yang Dihadirkan oleh NUMA
Di Linux, thread adalah unit dasar penjadwalan CPU dan sesuai dengan tugas pada antrian eksekusi CPU. Kernel memilih CPU yang relatif tidak sibuk untuk setiap tugas. Karena beban CPU berubah secara dinamis, kernel menggunakan penyeimbangan beban untuk memindahkan tugas ke CPU yang kurang sibuk. Secara default, sebuah tugas dapat berpindah antar CPU.
Dalam NUMA, sebuah tugas dapat berpindah dari CPU pada Node 1 ke CPU pada Node 2 sambil tetap mengakses memori yang dialokasikan pada Node 1, sehingga menghasilkan akses lintas node. Penyeimbangan NUMA Linux secara berkala memindahkan tugas atau halaman memori ke arah node lokal, tetapi tidak dapat menghilangkan semua akses memori jarak jauh.
Dalam lingkungan virtualisasi, setiap vCPU VM sesuai dengan thread sistem operasi host. Jika beberapa thread vCPU berjalan pada node NUMA yang berbeda sambil berbagi memori, atau bermigrasi antar node, VM dapat mengakses memori di seluruh node NUMA dan mengalami latensi yang lebih tinggi.
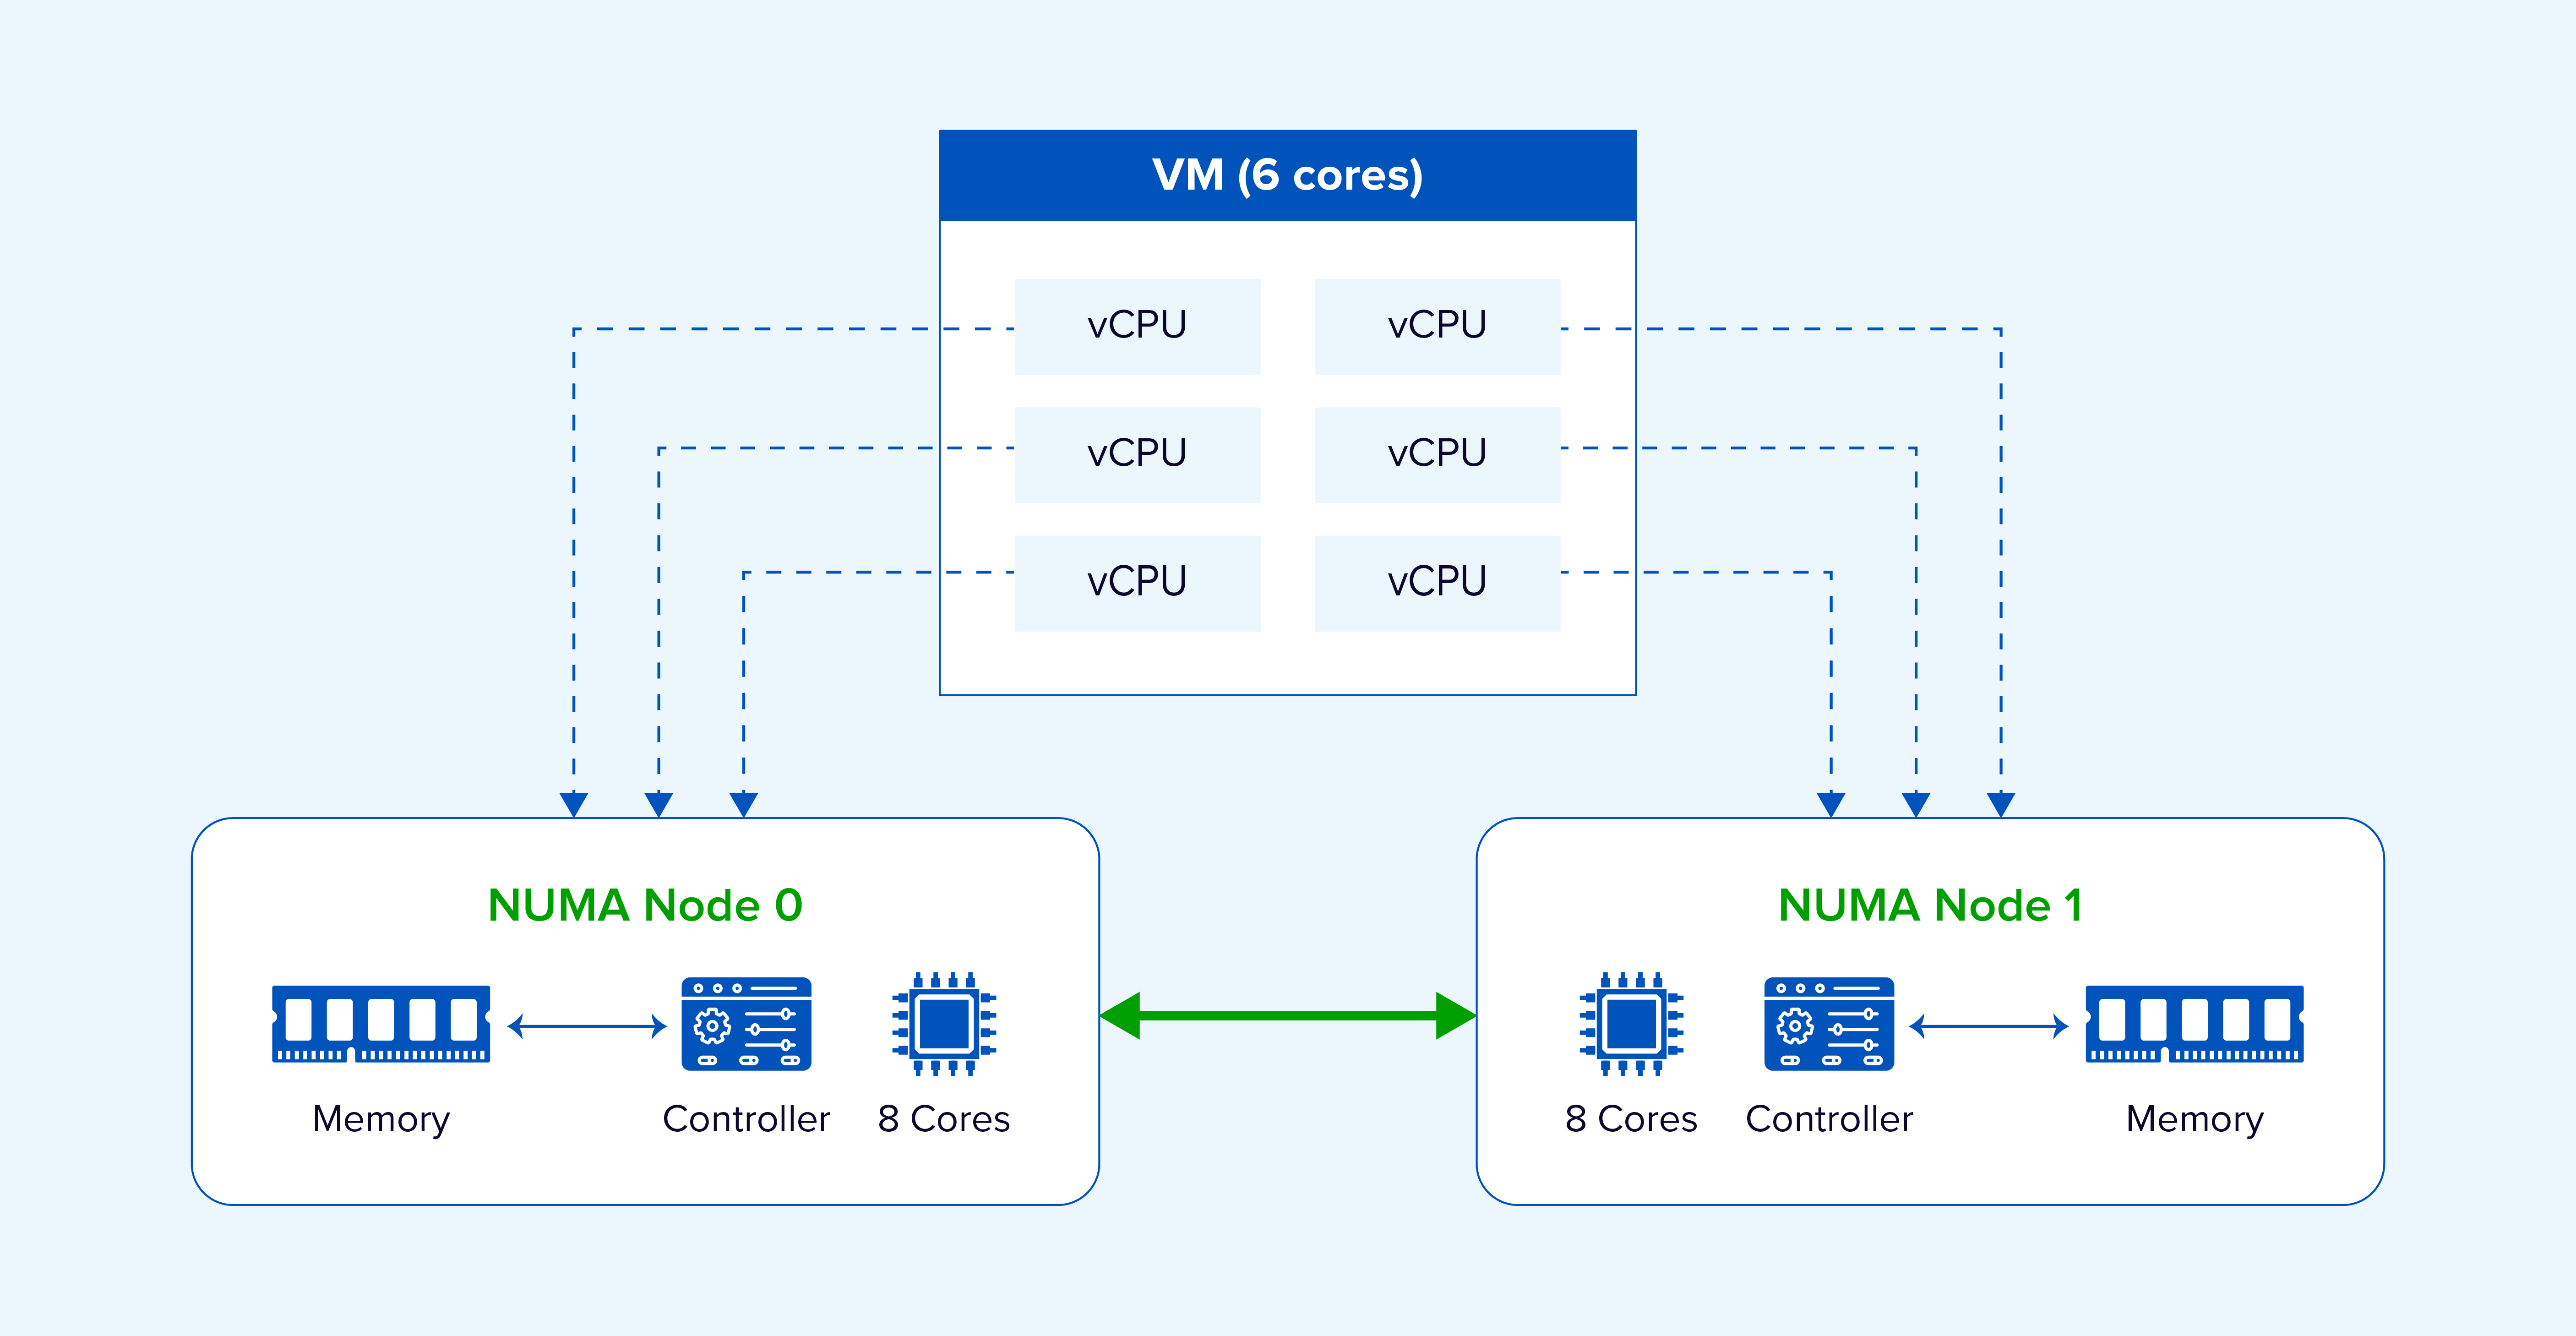
Gambar 3: Eksekusi lintas node dapat meningkatkan akses memori jarak jauh untuk mesin virtual.
BAGIAN 3. Pendekatan Penjadwalan NUMA Umum
Industri ini umumnya menggunakan pendekatan berikut:
Pendekatan 1: Mengaitkan vCPU ke Core Fisik
Administrator mengkonfigurasi secara manual pengikatan vCPU sehingga sumber daya VM diprioritaskan untuk berjalan di dalam node NUMA fisik yang sama.
Pendekatan 2: Menentukan Jumlah Node NUMA yang Ditugaskan ke VM
Administrator mengkonfigurasi jumlah node NUMA secara manual dan mendistribusikan sumber daya vCPU dan memori secara merata di antara node-node tersebut.
Pendekatan 3: Mengalokasikan Node NUMA Secara Adaptif
Penjadwal secara otomatis menetapkan node NUMA yang sesuai ke VM. CPU VM dibatasi pada node tersebut dan lebih memilih menggunakan memori lokal untuk meningkatkan lokalitas. Jika VM memiliki lebih banyak vCPU daripada yang dapat ditampung oleh satu node NUMA, maka VM tersebut didistribusikan ke beberapa node. Topologi NUMA dapat diekspos ke sistem operasi tamu untuk pengambilan keputusan yang peka terhadap topologi, sementara VM dapat dimigrasikan antar node untuk menjaga keseimbangan beban.
Pendekatan 1 dan 2 memberlakukan lebih banyak batasan, memerlukan penentuan ukuran CPU VM yang cermat, dan dapat menciptakan ketidakseimbangan antara node NUMA karena pengikatan statis. Oleh karena itu, alokasi adaptif lebih praktis untuk lingkungan produksi yang dinamis.
BAGIAN 4. Penjadwalan Sangfor NUMA secara Detail
Sangfor HCI terutama menggunakan penjadwalan NUMA adaptif. Sistem ini menyeimbangkan pemanfaatan di seluruh node NUMA sambil mengurangi akses memori jarak jauh oleh vCPU VM, sehingga meningkatkan kinerja secara keseluruhan.
Penjadwalan NUMA adaptif memberikan manfaat optimasi yang jelas di berbagai jenis aplikasi, terutama middleware dengan operasi dalam memori yang sering. Sangfor menerapkan DM8, Redis, dan Memcached di VM dan melakukan benchmark dengan penjadwalan NUMA diaktifkan dan dinonaktifkan. Hasilnya menunjukkan peningkatan kinerja middleware yang jelas dengan penjadwalan NUMA diaktifkan.
Beban Kerja Basis Data: Dameng DB (DM8) dengan BenchmarkSQL
BenchmarkSQL adalah benchmark basis data relasional yang menjalankan campuran transaksi bergaya TPC-C, termasuk pesanan baru, pembayaran, kueri status pesanan, pengiriman, dan kueri tingkat stok. Metrik tpmC yang dihasilkan mewakili jumlah transaksi pesanan baru yang diproses per menit, dengan nilai yang lebih tinggi menunjukkan kinerja yang lebih baik. BenchmarkSQL 5.0 digunakan untuk menguji basis data DM8. Bagan berikut menunjukkan kinerja relatif, dengan hasil tpmC yang dinonaktifkan NUMA dinormalisasi menjadi 100%.
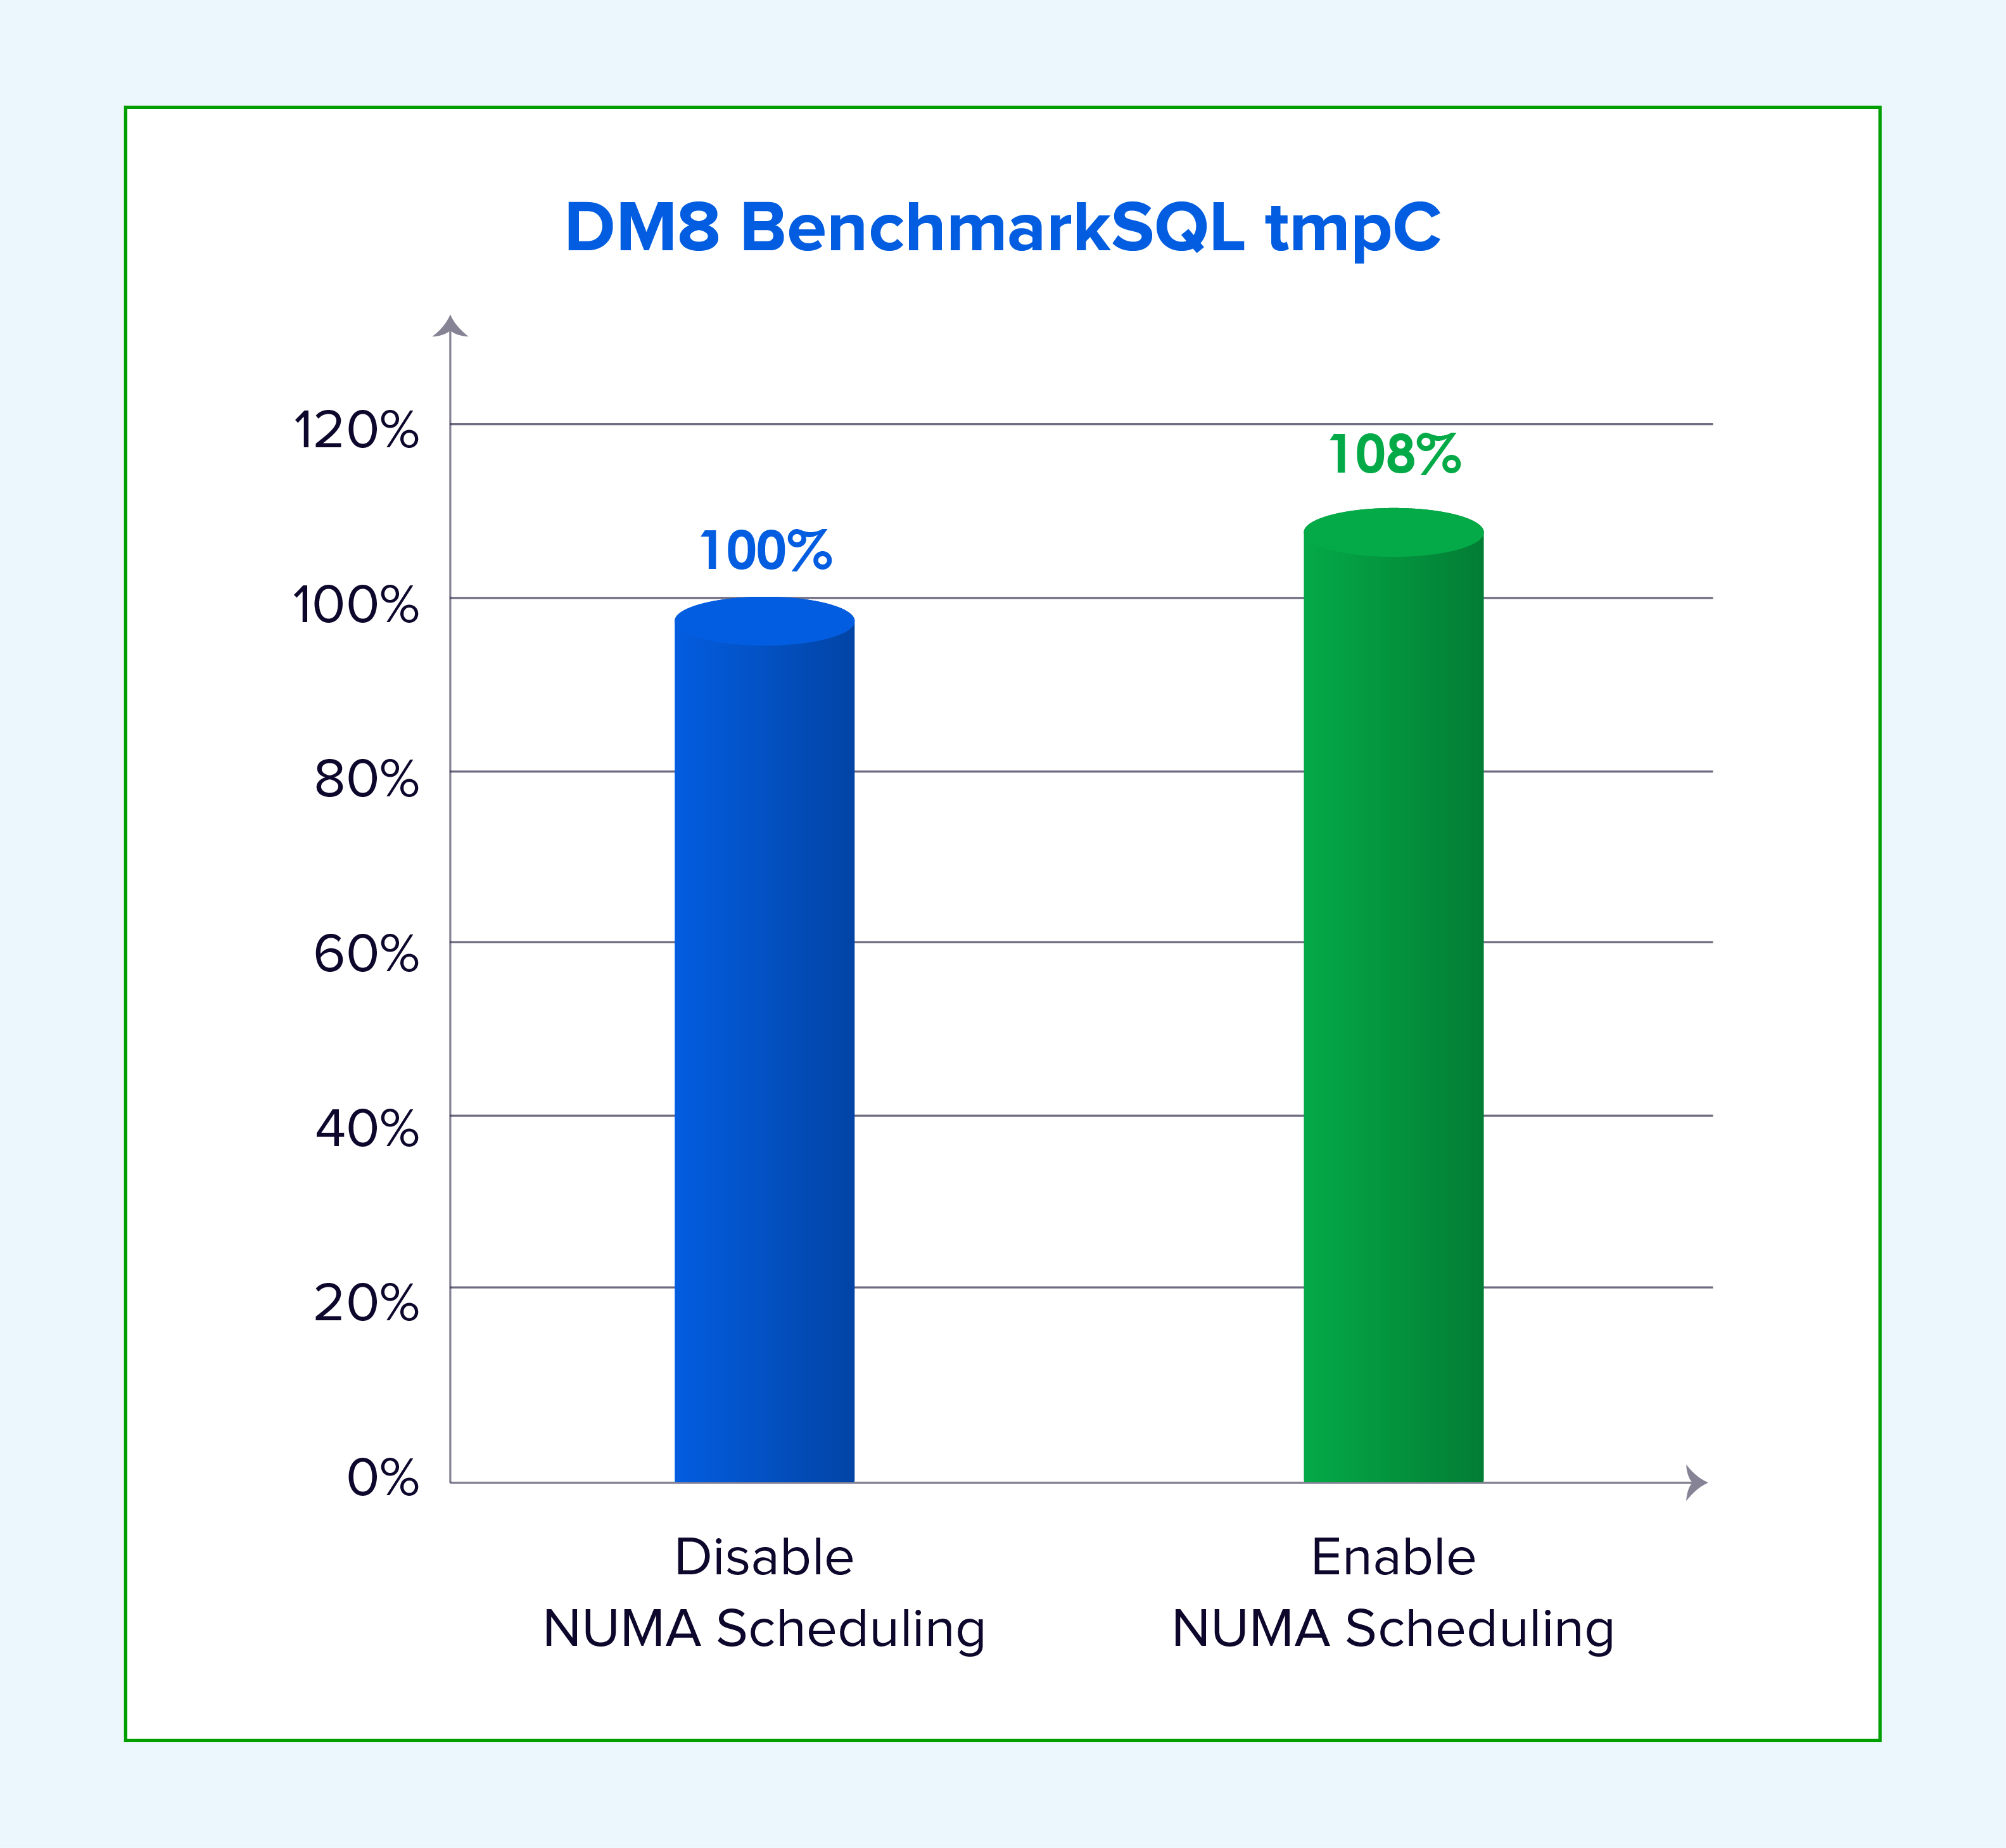
Gambar 4: Throughput transaksi DM8 relatif dengan penjadwalan NUMA diaktifkan vs. dinonaktifkan.
Caching Dalam Memori: Redis 7.2.5
redis-benchmark adalah alat pengujian kinerja Redis resmi. Sangfor menggunakannya untuk menguji QPS (Quality Per Second) untuk operasi GET dan SET untuk nilai 1 KB dengan penjadwalan NUMA dinonaktifkan dan diaktifkan. QPS mewakili jumlah operasi baca atau tulis per detik.
redis-benchmark -t get -d 16 -c 100 -n 6000000 -r 60000000
redis-benchmark -t set -d 16 -c 100 -n 6000000 -r 60000000
Grafik berikut menunjukkan kinerja relatif, dengan hasil QPS yang dinonaktifkan NUMA dinormalisasi menjadi 100%.
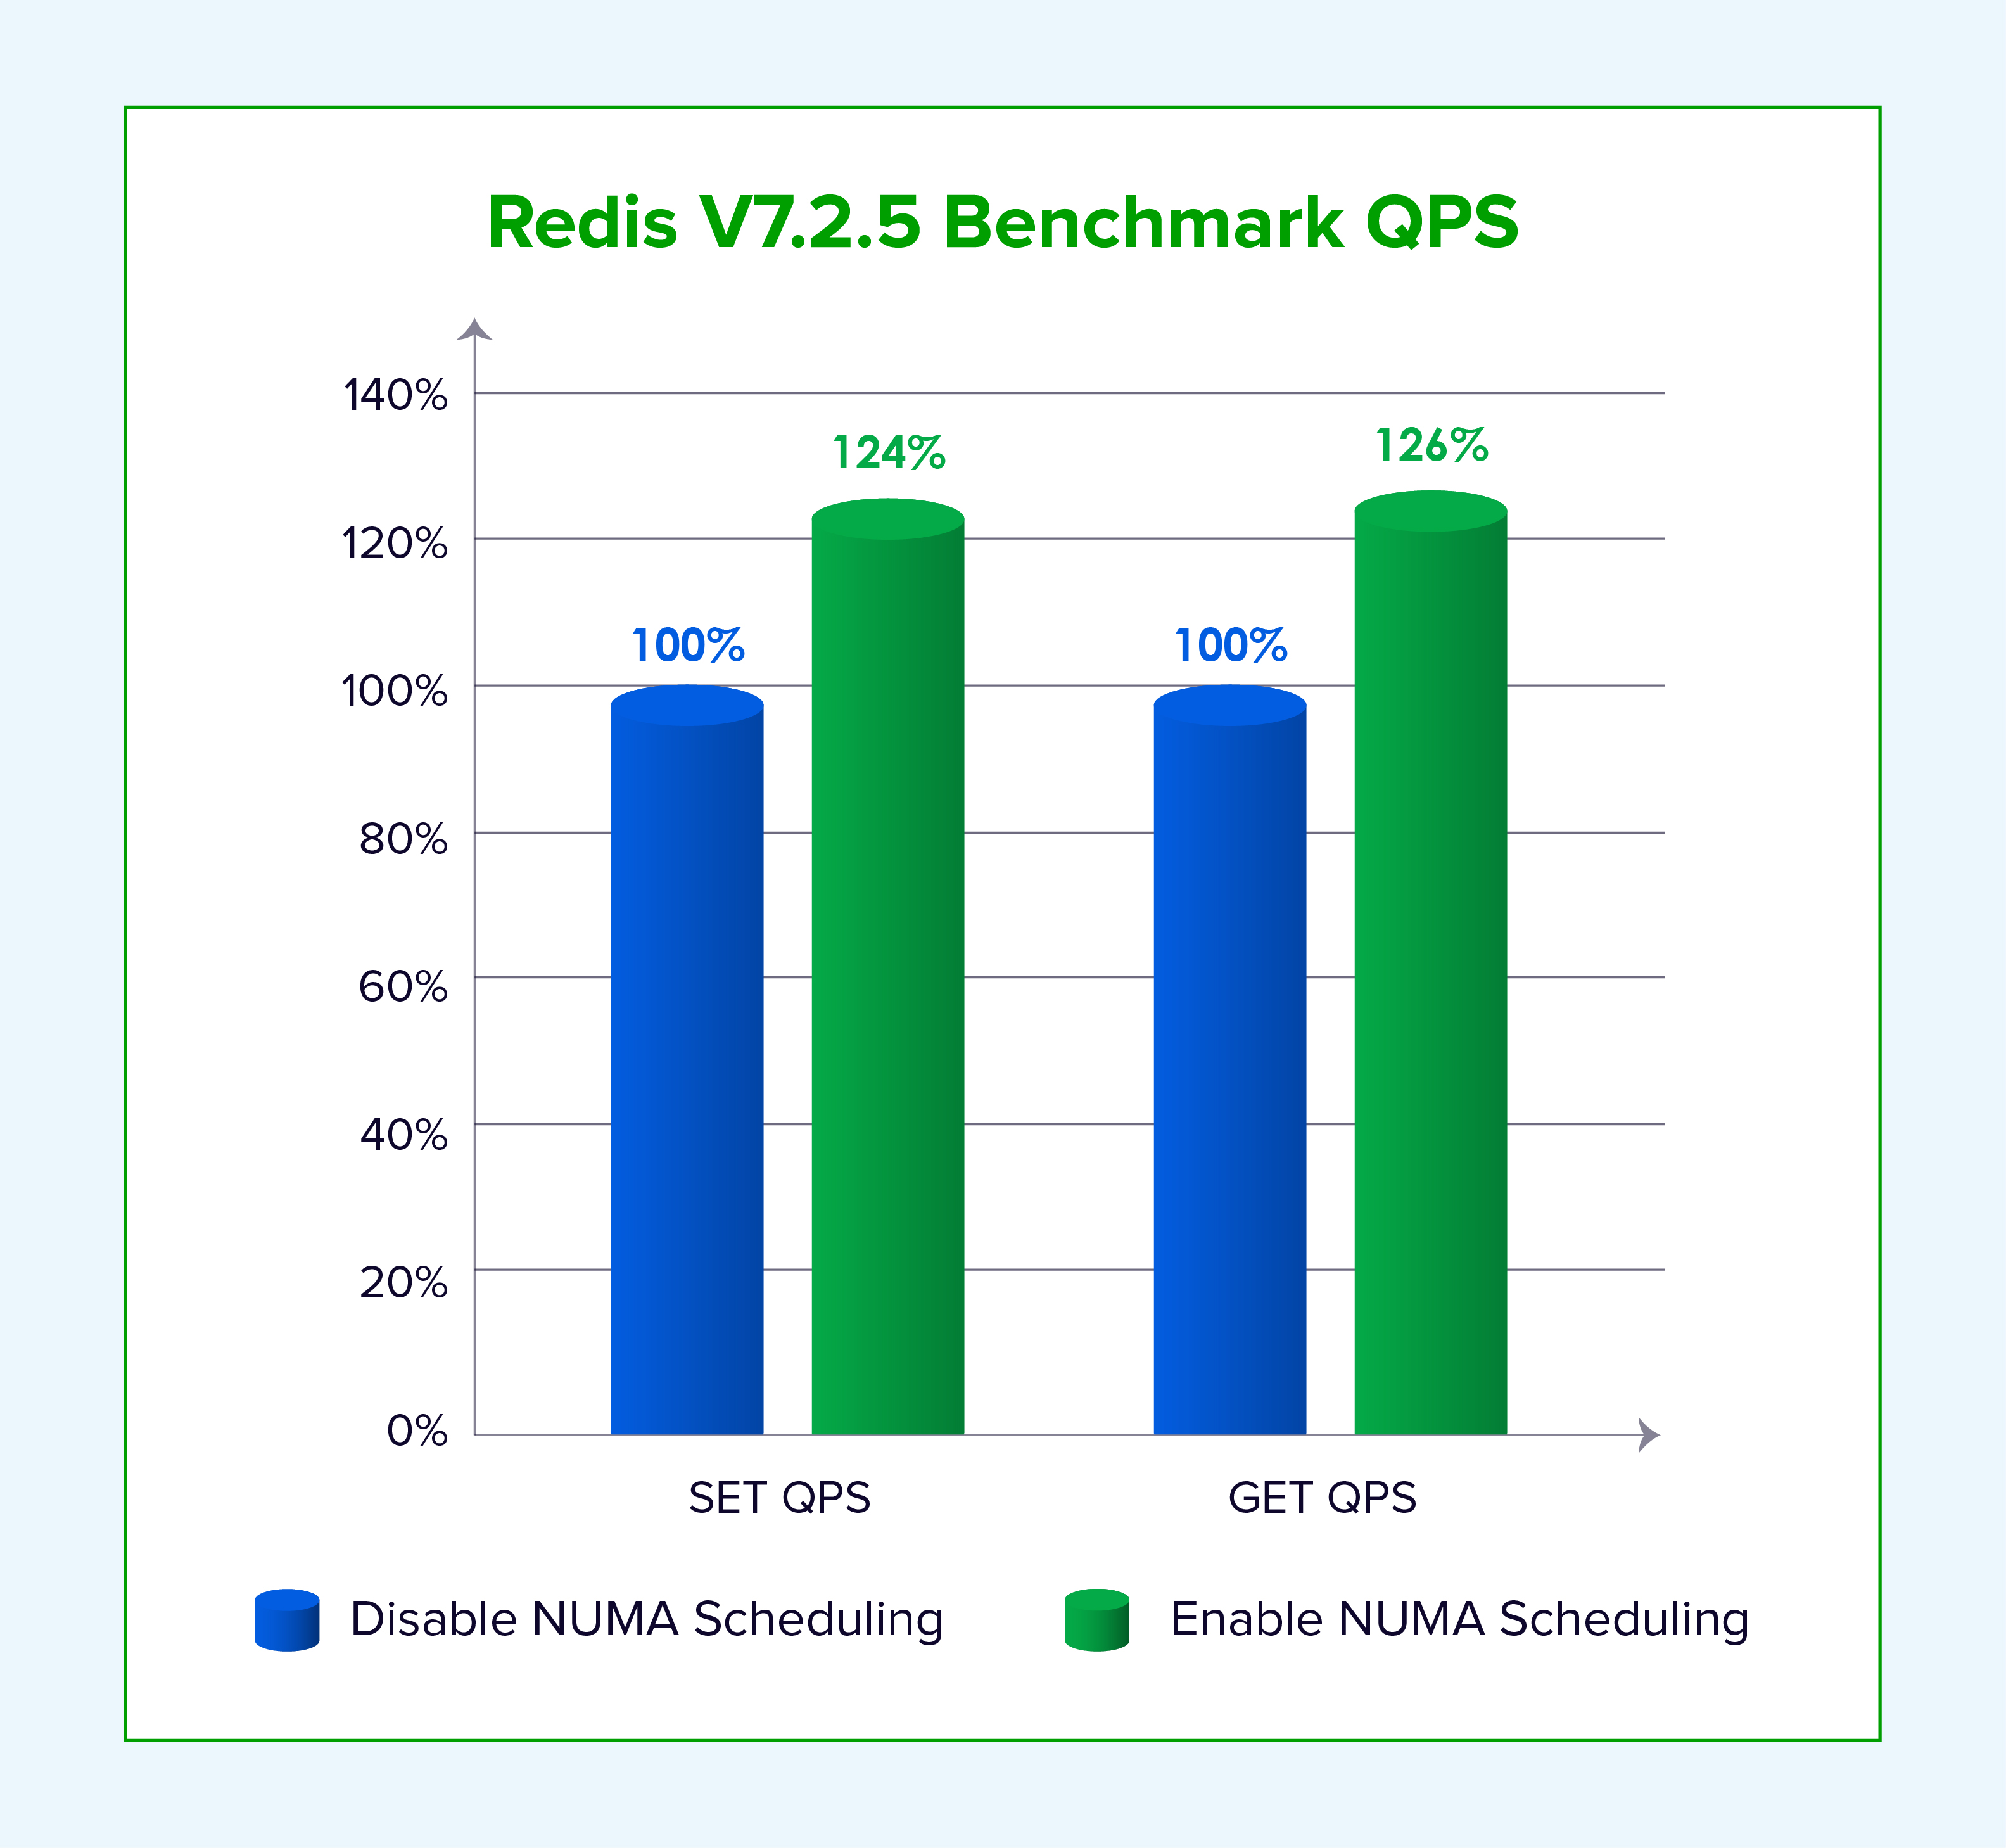
Gambar 5: Peningkatan kinerja QPS baca/tulis Redis relatif dengan penjadwalan NUMA diaktifkan.
Caching Key-Value: Memcached 6.27
memaslap adalah alat pengujian kinerja yang disertakan dengan Memcached. Sangfor menggunakannya untuk menguji TPS untuk nilai 1 KB dengan penjadwalan NUMA dinonaktifkan dan diaktifkan. TPS merupakan singkatan dari transaksi per detik.
memaslap -s 127.0.0.1:11211 -t 300s -T 8
Grafik berikut menunjukkan kinerja relatif, dengan hasil TPS yang dinonaktifkan NUMA dinormalisasi menjadi 100%.
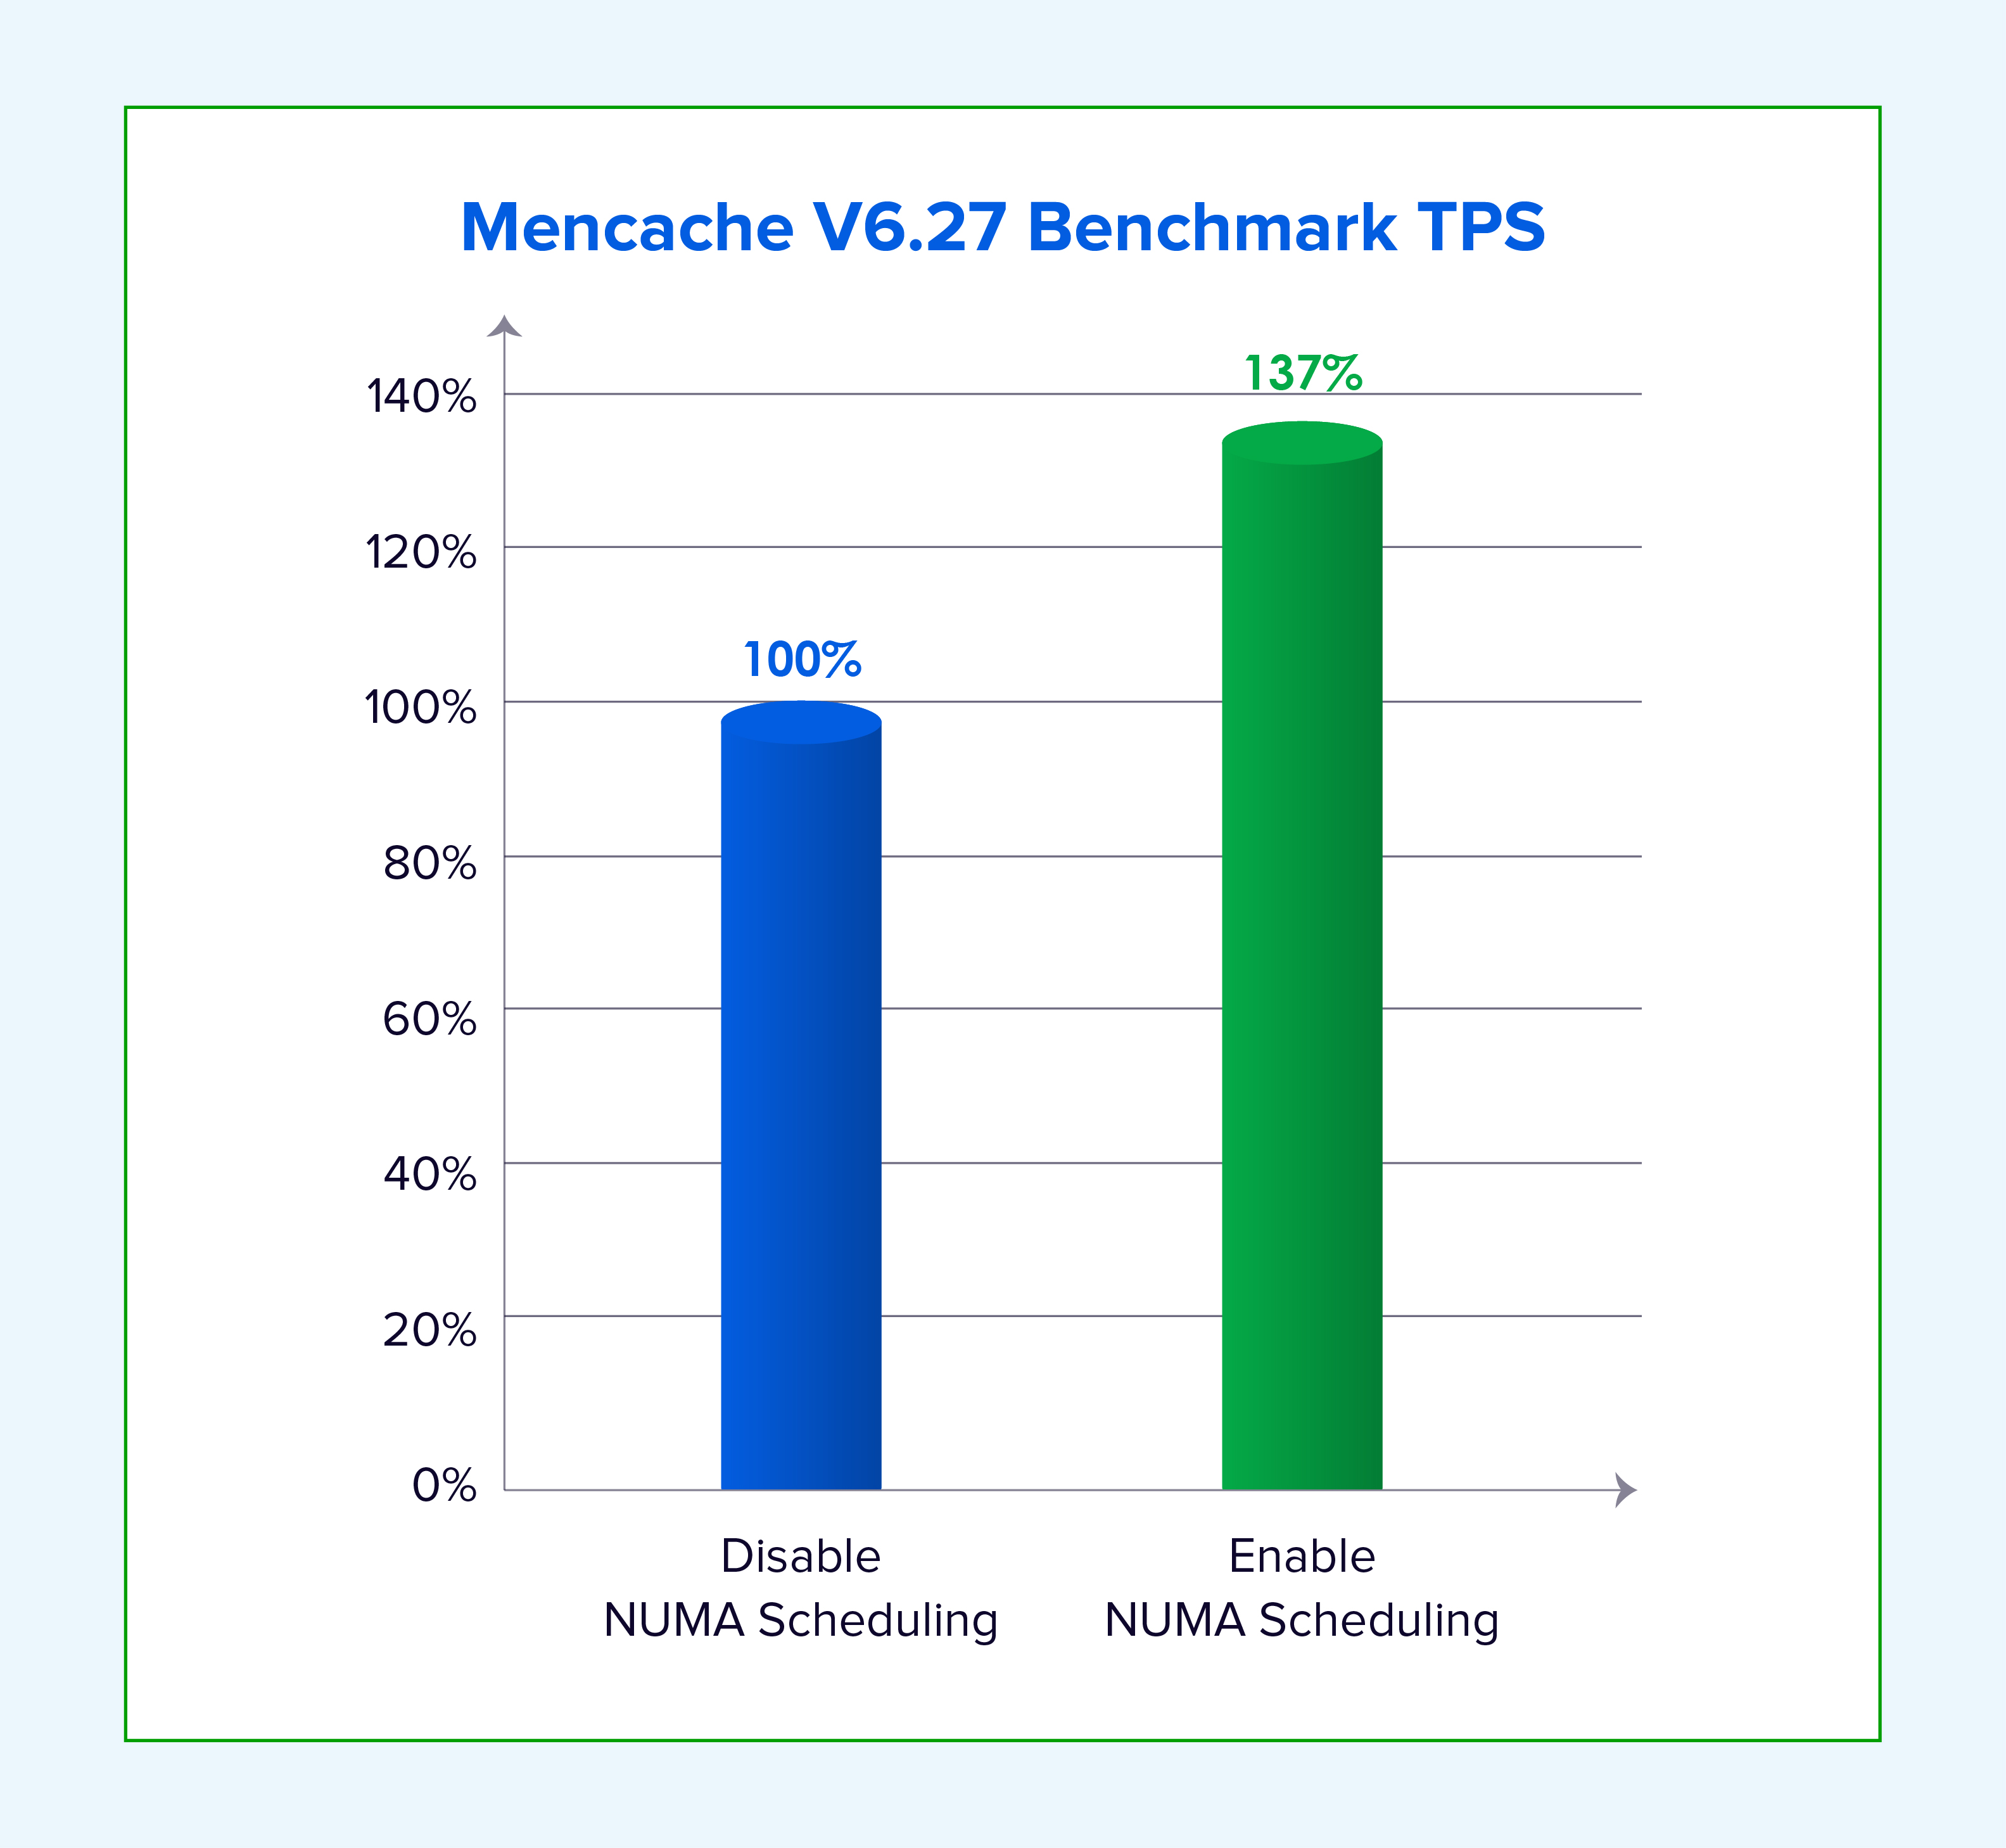
Gambar 6: Peningkatan throughput transaksional Memcached relatif dengan penjadwalan NUMA diaktifkan.
Hasil di atas menunjukkan manfaat yang jelas untuk aplikasi yang membutuhkan banyak memori. Bagian berikut menjelaskan cara kerja optimasi tersebut.
1. Alokasi Node NUMA Adaptif
Sangfor secara adaptif mempartisi vCPU VM dan menjadwalkannya ke node NUMA yang sesuai untuk mengurangi akses memori jarak jauh. Jika jumlah vCPU VM lebih rendah daripada jumlah core dari satu node NUMA, VM dijadwalkan pada satu node. Jika VM membutuhkan lebih banyak core daripada yang dapat disediakan oleh satu node, VM tersebut didistribusikan ke beberapa node, dan topologi vNUMA diekspos ke sistem operasi tamu untuk pengambilan keputusan yang mempertimbangkan topologi.
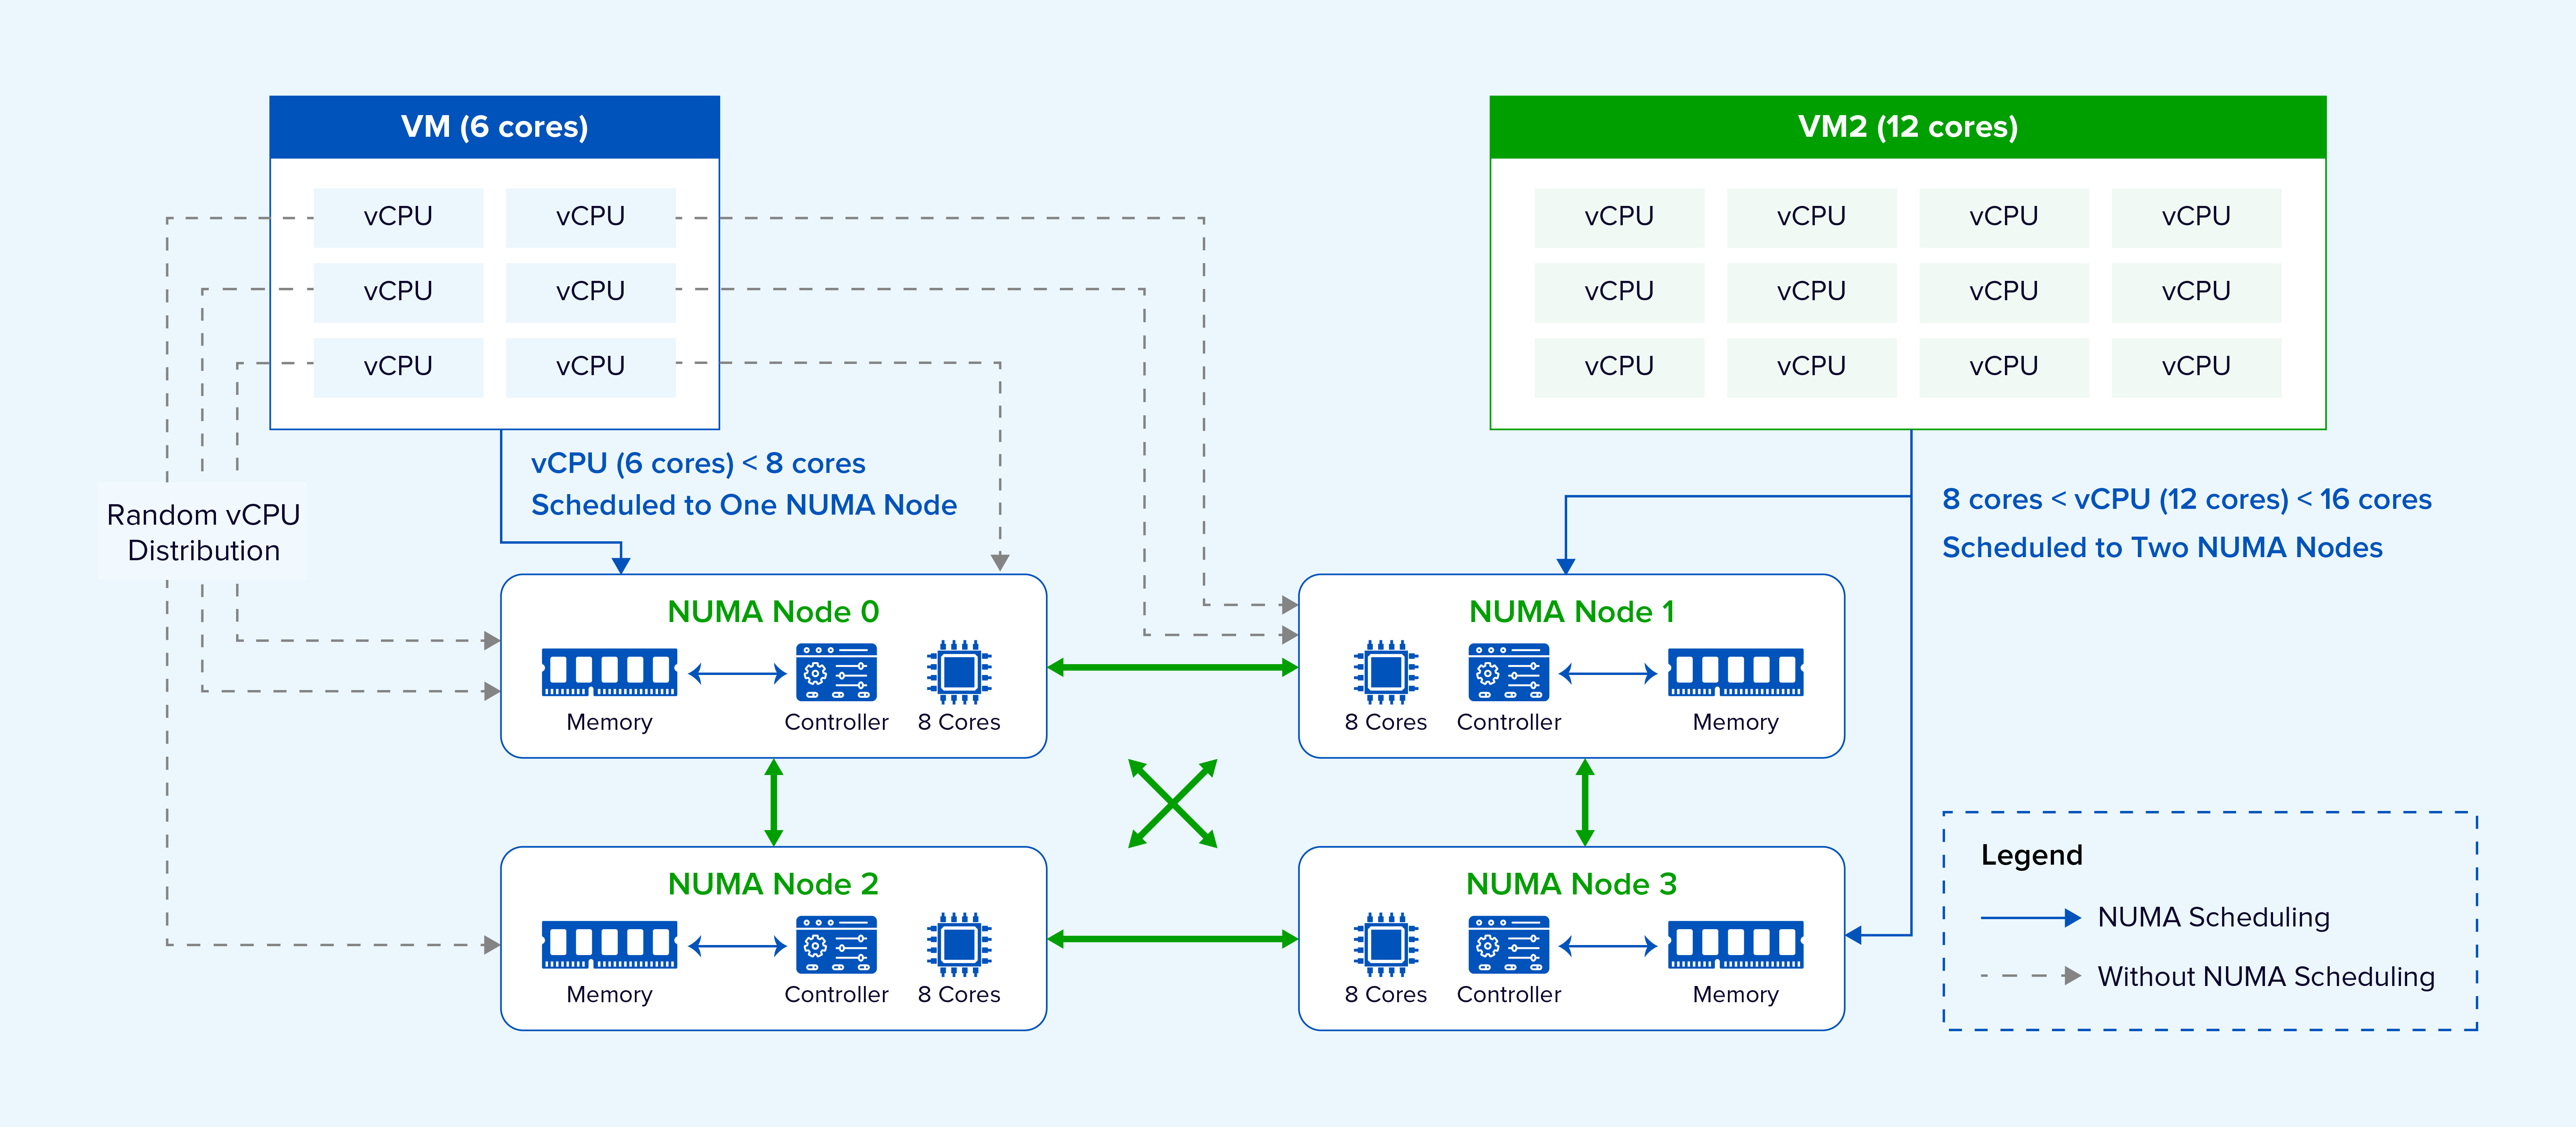
Gambar 7: Partisi vCPU cerdas Sangfor dan pemetaan topologi vNUMA.
Untuk menjaga keseimbangan pemanfaatan, penempatan VM mempertimbangkan beban saat ini di seluruh node NUMA dan memilih node yang kurang sibuk. Selama runtime, VM dapat dimigrasikan antar node seiring perubahan pemanfaatan. VM prioritas ditempatkan secara preferensial pada node yang kurang padat untuk mengurangi persaingan memperebutkan CPU, bandwidth memori, dan sumber daya cache.
2. Optimasi untuk Platform Server Heterogen
Beberapa platform server berisi banyak node NUMA, jarak antar node yang berbeda, dan jumlah core yang relatif sedikit per node.
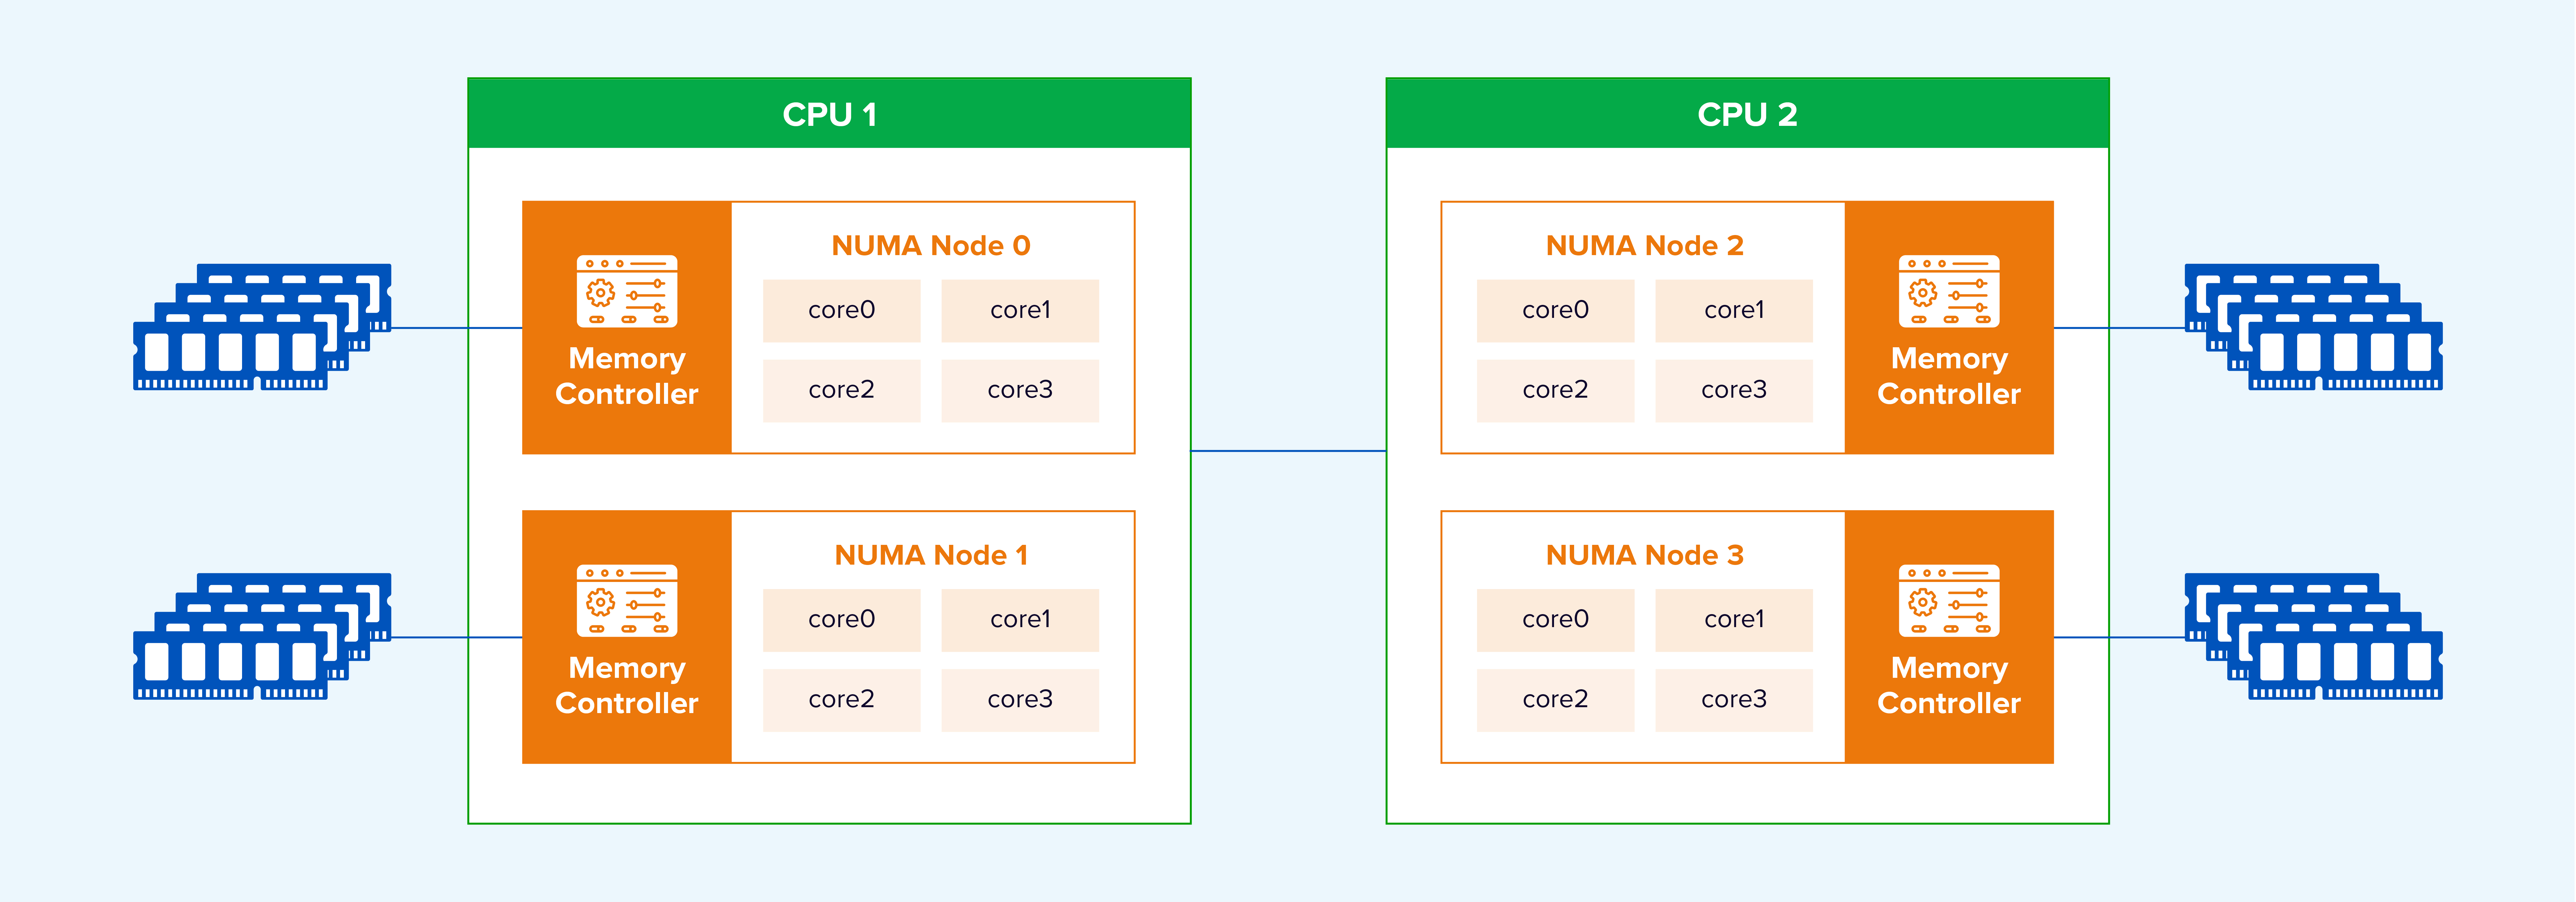
Gambar 8. Penempatan vNUMA yang mempertimbangkan topologi pada server multi-node.
Sangfor mengidentifikasi jarak antara node NUMA dan secara prioritas menempatkan beberapa node vNUMA dari VM yang sama pada node NUMA fisik terdekat.
Untuk lebih meningkatkan kinerja penerusan data, Sangfor mengembangkan afinitas NUMA antara VM dan proses bidang data. VM dan proses penerusan datanya dijadwalkan pada node NUMA yang sama, sehingga meningkatkan akses memori lokal. Pada gambar berikut, DP mengacu pada proses bidang data.
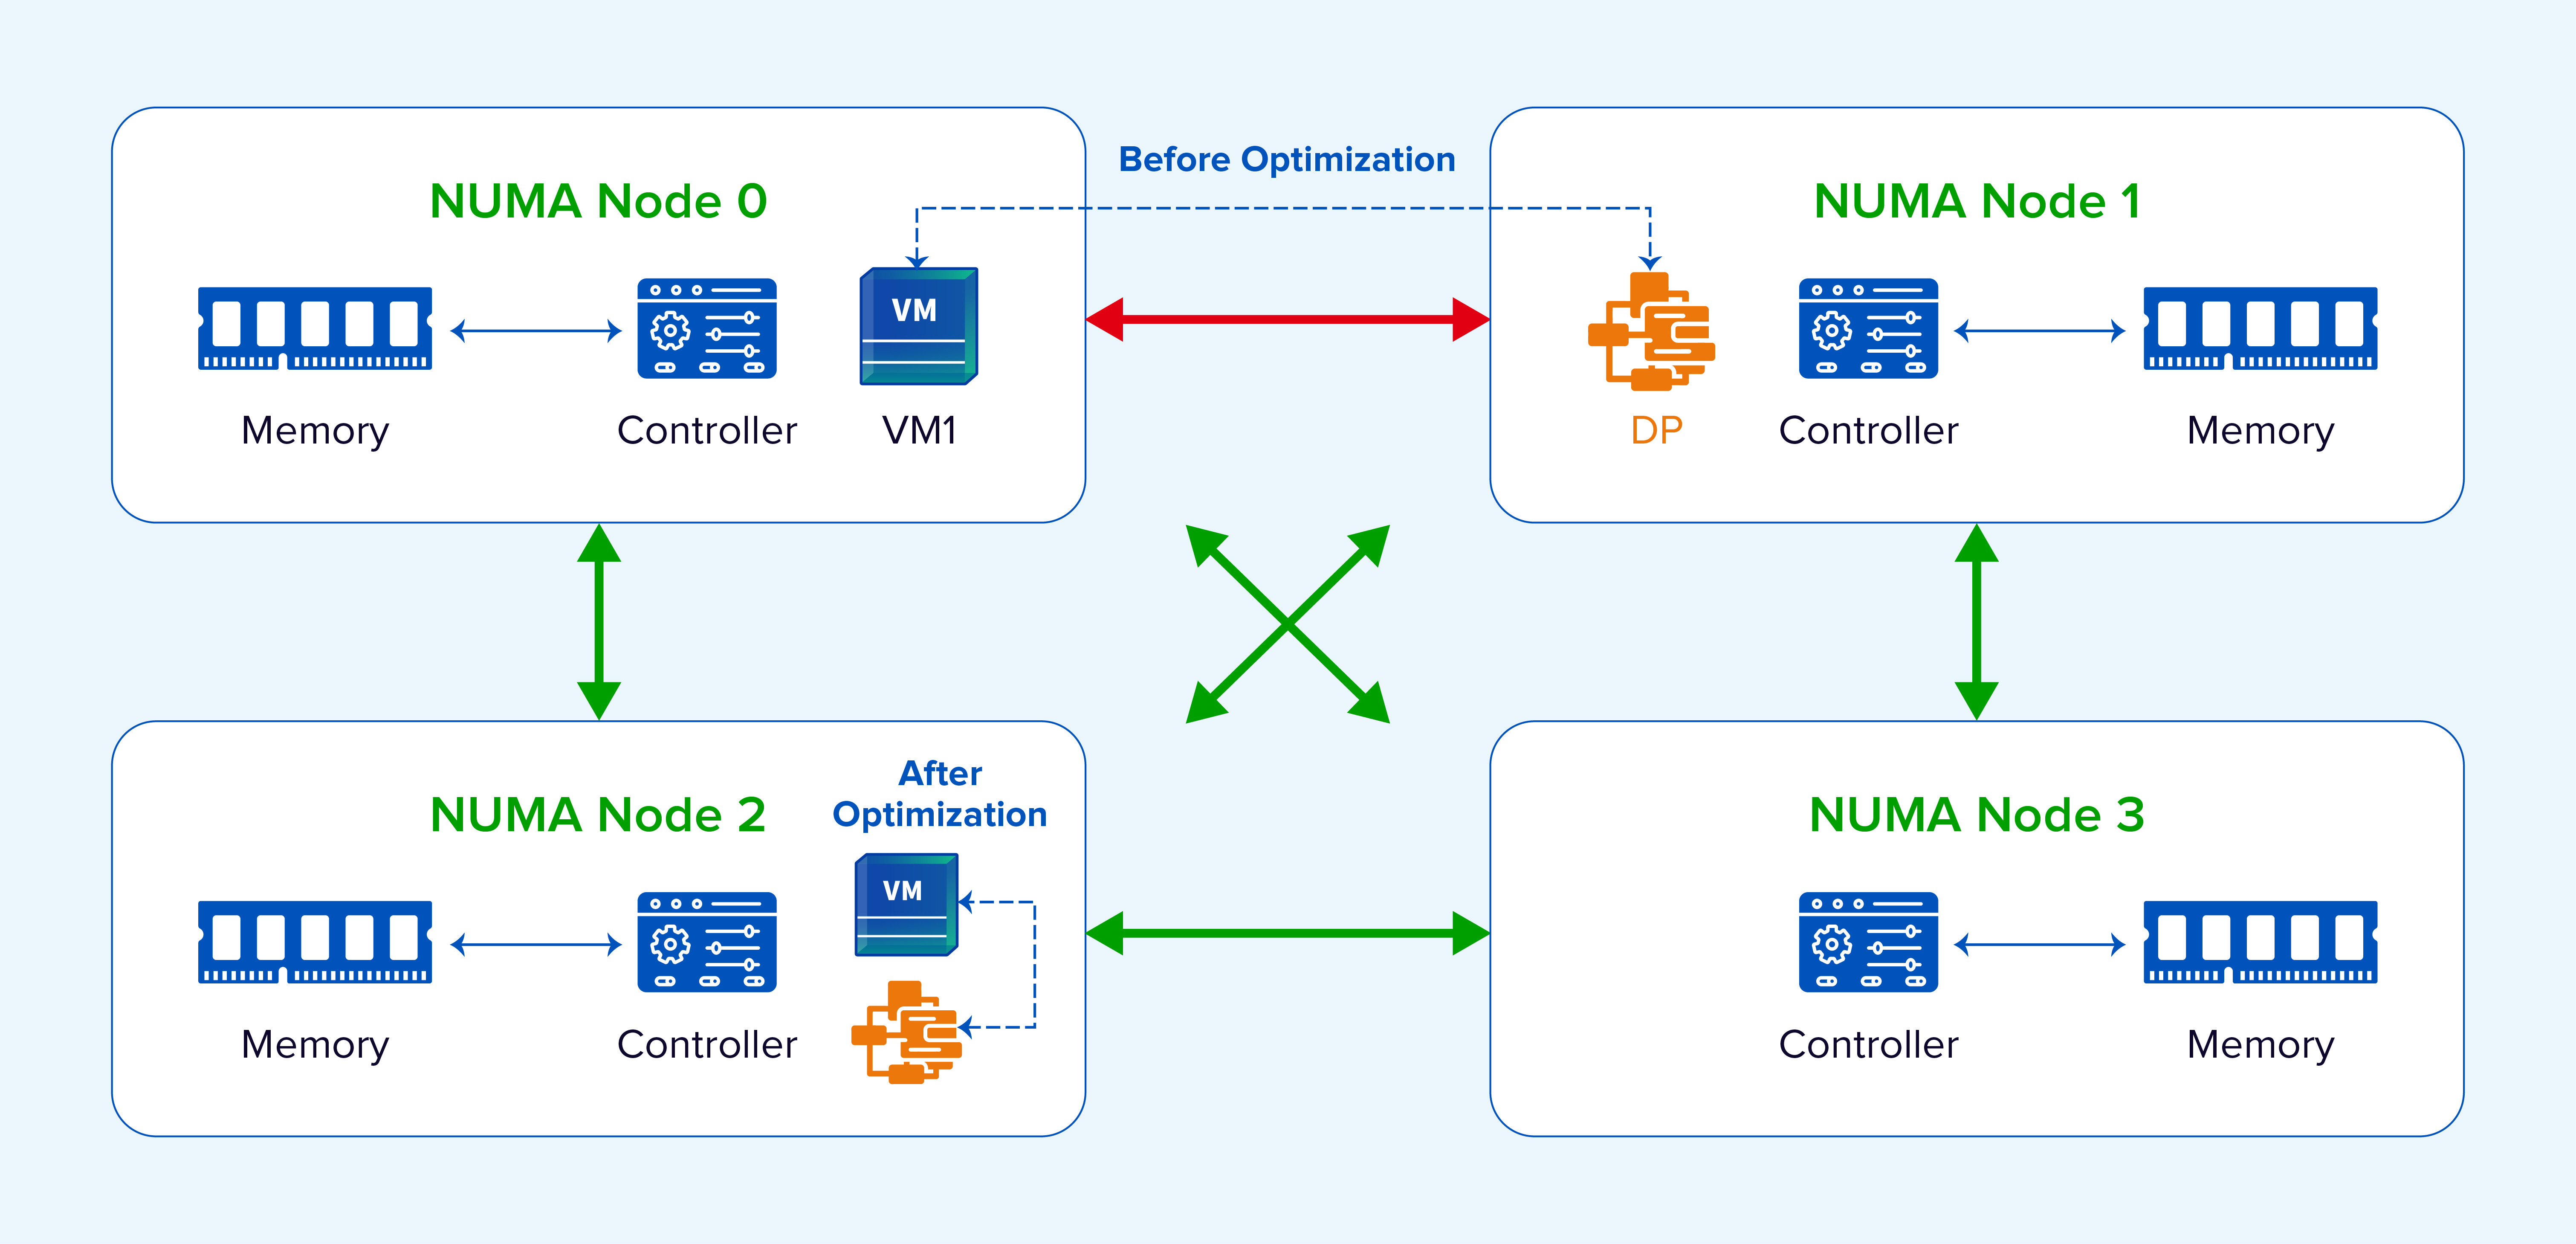
Gambar 9. Afinitas VM dan bidang data menjaga pemrosesan tetap dekat dengan memori lokal.
Untuk memaksimalkan manfaat NUMA di seluruh penyimpanan, Sangfor menempatkan vCPU, QEMU, libnfs, aSAN, dan proses lain yang terlibat dalam jalur I/O lengkap pada node NUMA yang sama. Hal ini menghindari akses memori jarak jauh. Halaman memori yang besar semakin meningkatkan kinerja akses memori, mengurangi overhead pemrosesan, dan meningkatkan efisiensi aliran I/O.
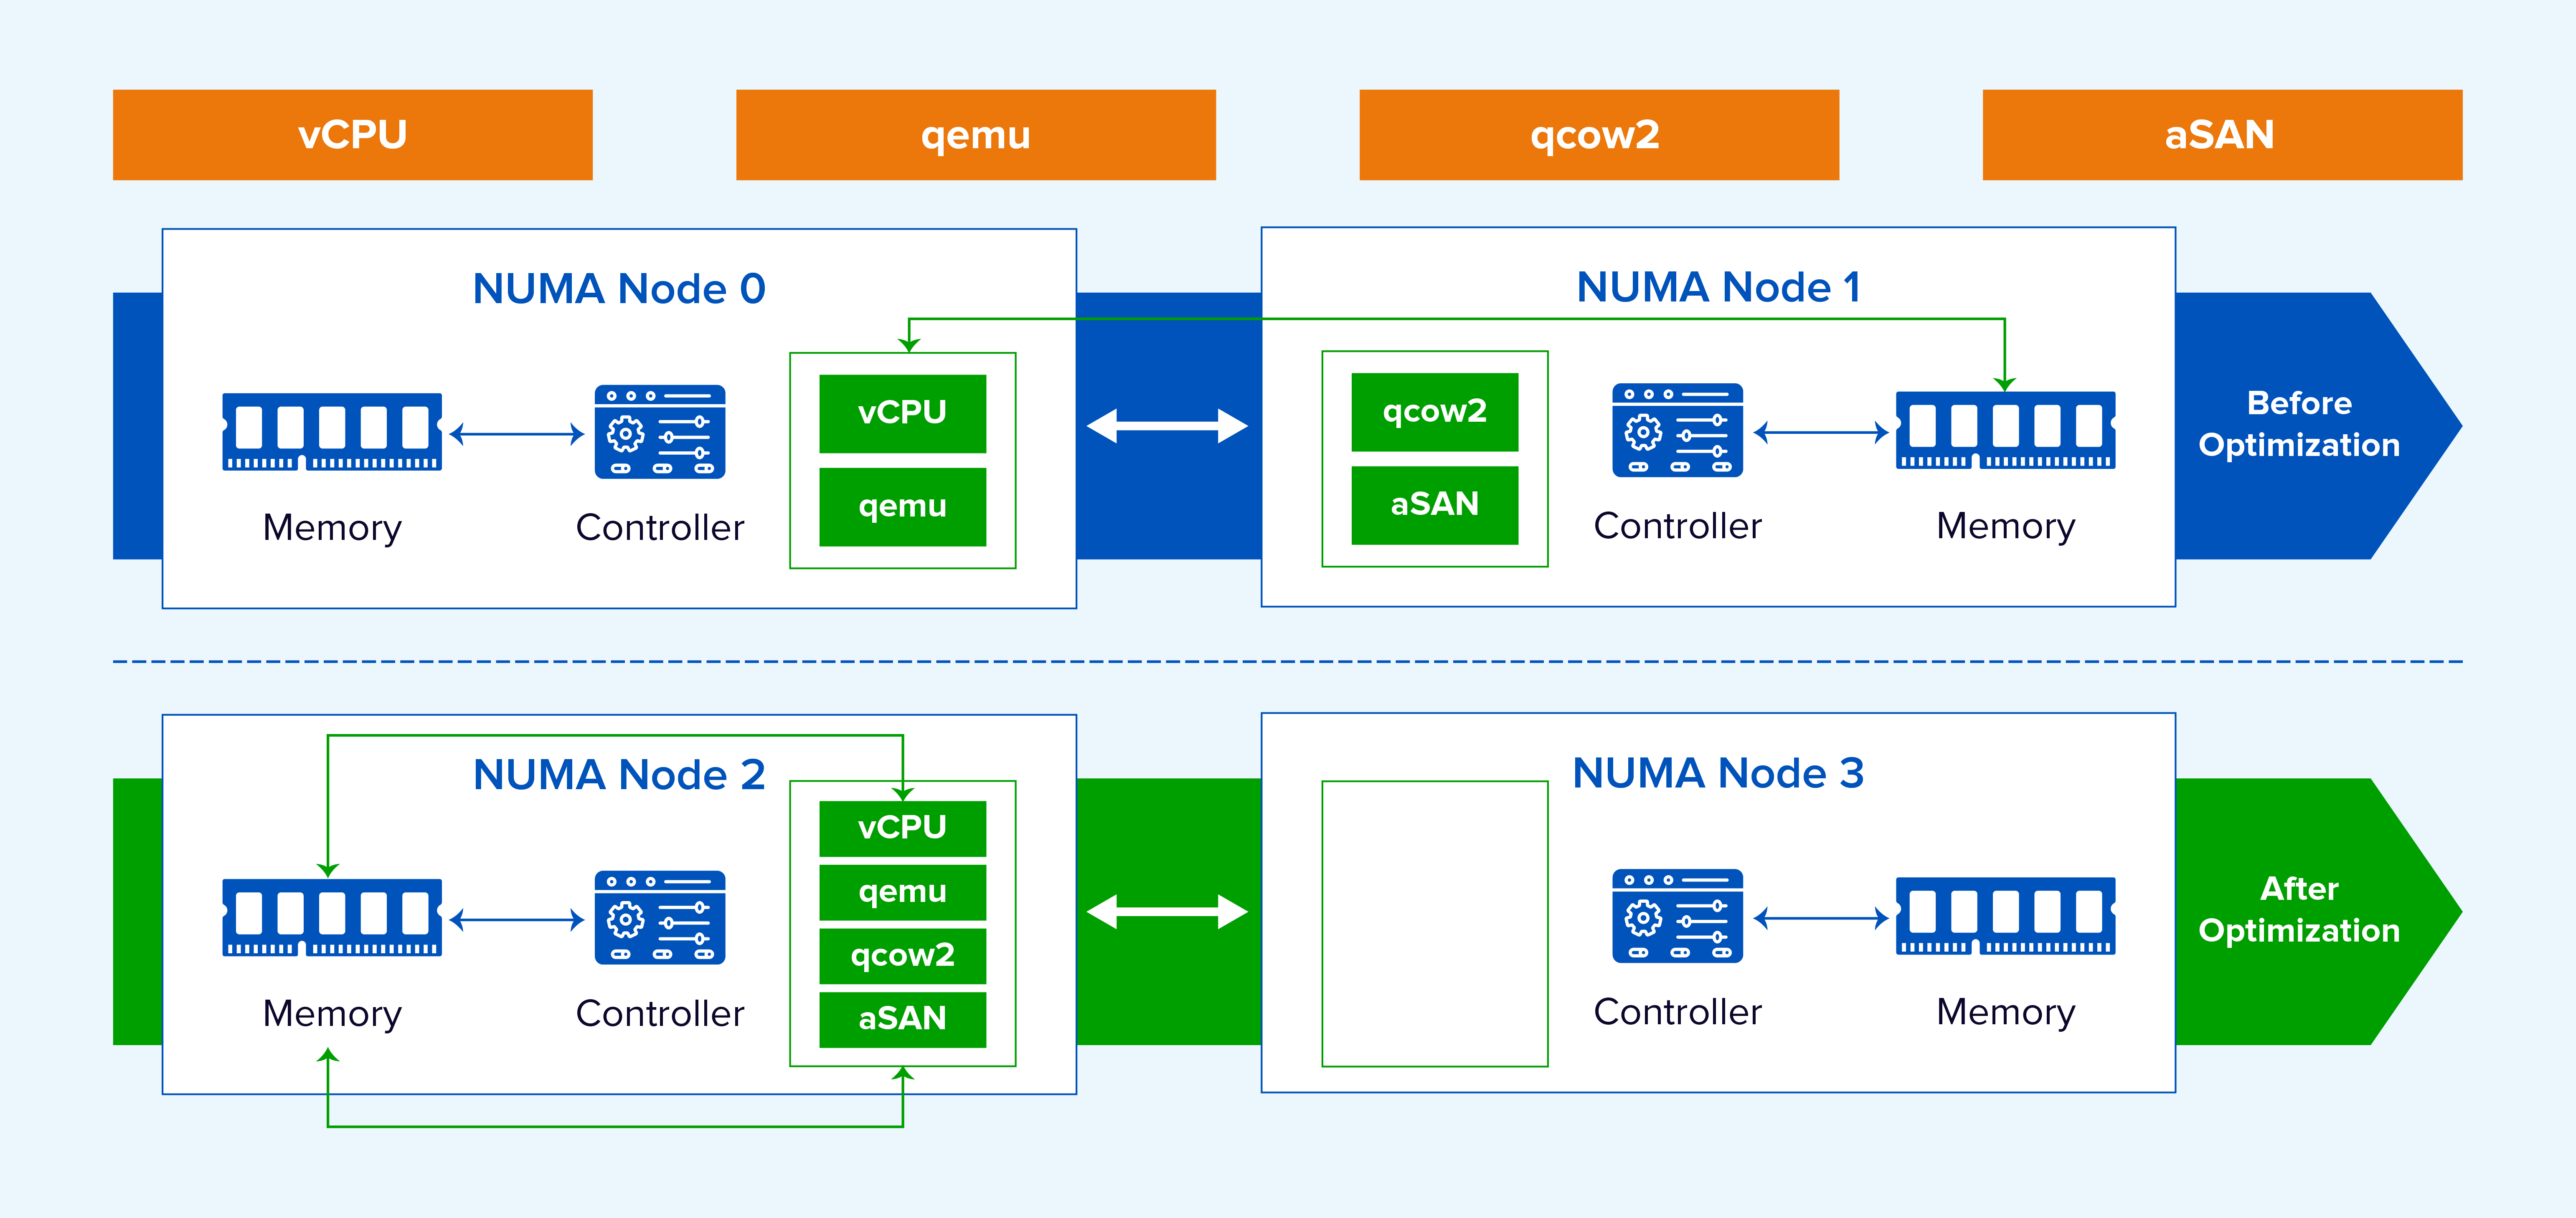
Gambar 10. Penempatan NUMA terkoordinasi di sepanjang jalur I/O penyimpanan virtual.
Data yang berpindah dari buffer NIC ke penyimpanan virtual harus diproses oleh thread CPU. Seiring meningkatnya kinerja jaringan, efisiensi penyalinan buffer inti tunggal dapat menjadi hambatan, sementara akses lintas-NUMA semakin mengurangi efisiensi. Sangfor memungkinkan beberapa inti CPU untuk memproses lalu lintas NIC dan menerapkan afinitas NUMA. Ini menghilangkan hambatan inti tunggal, mengurangi latensi transfer, dan meningkatkan konkurensi. Dalam pengujian internal, kinerja penulisan VM dengan kedalaman antrian tinggi dan blok besar meningkat lebih dari 20%.
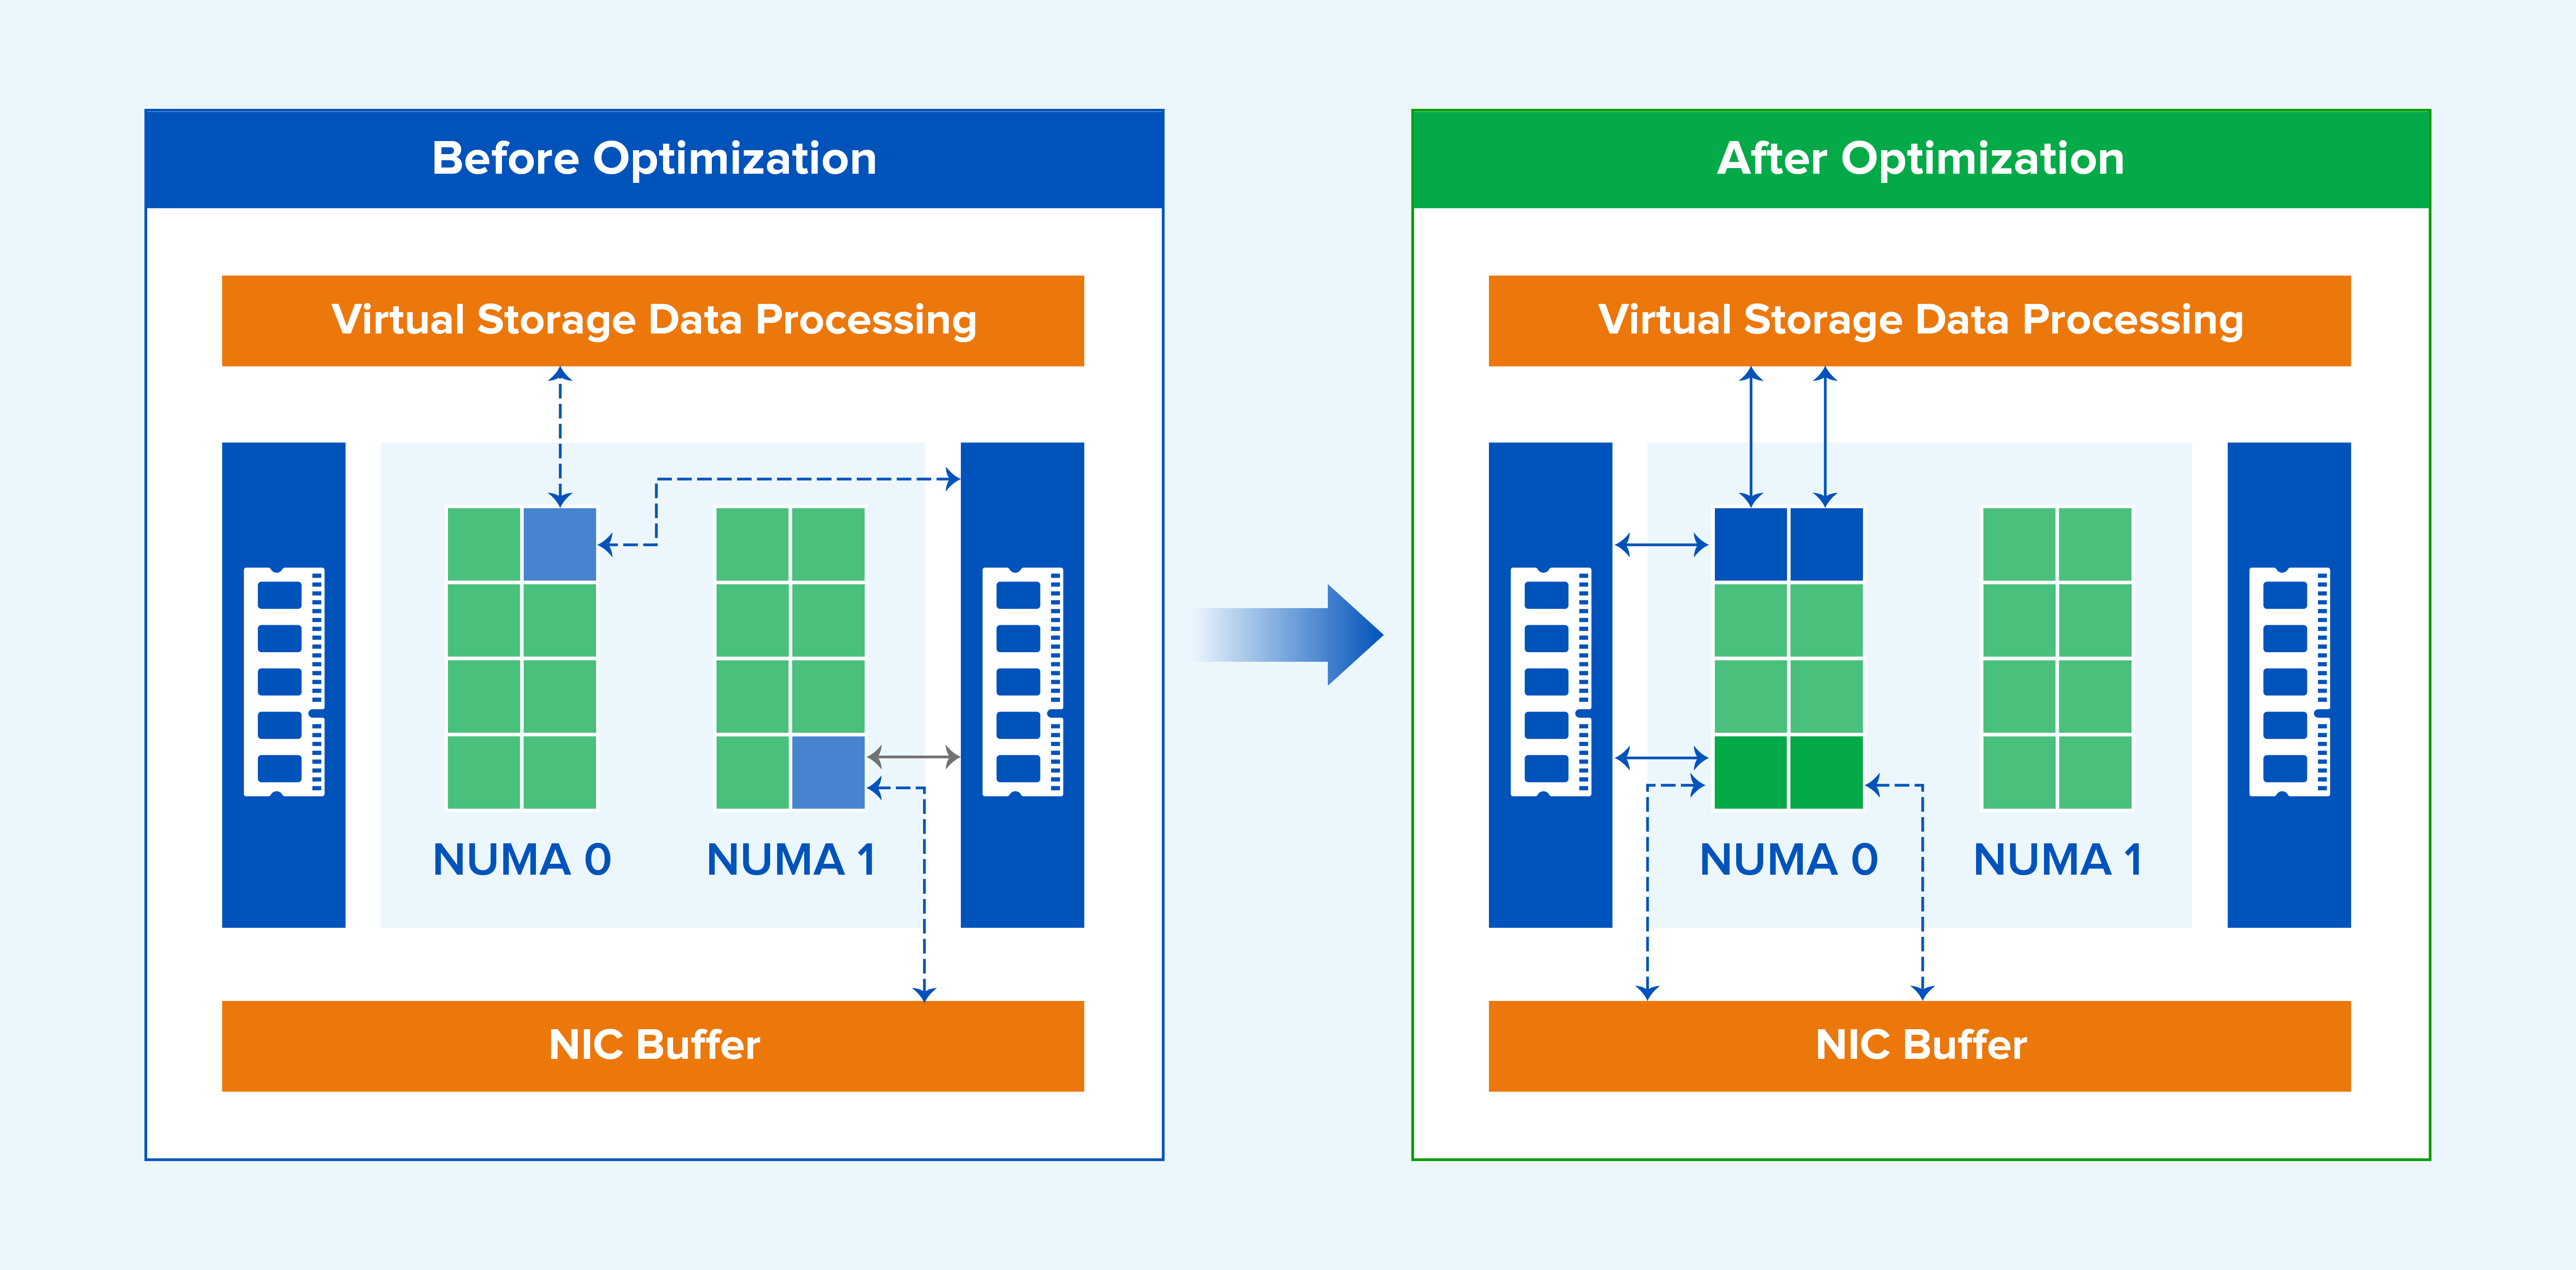
Gambar 11. Pemrosesan multi-inti, NUMA-affine antara buffer NIC dan penyimpanan virtual.
3. Perbandingan dengan Pendekatan Industri Lainnya
Dukungan industri bervariasi. Satu vendor memungkinkan administrator untuk mengkonfigurasi node NUMA tempat setiap vCPU VM berjalan, vendor lain tidak mendukung kemampuan ini, dan VMware mendukung penjadwalan NUMA adaptif.
Sangfor secara otomatis mempartisi dan menempatkan vCPU VM pada node NUMA untuk mengurangi akses memori jarak jauh. Dibandingkan dengan konfigurasi manual lokasi setiap vCPU, penjadwalan NUMA adaptif Sangfor mengotomatiskan partisi dan penempatan vCPU, menyeimbangkan pemanfaatan di seluruh node, dan meningkatkan kinerja secara keseluruhan.
Dibandingkan dengan implementasi NUMA adaptif dasar, Sangfor memperluas optimasi ke penjadwalan layanan penyimpanan, pengenalan VM prioritas, platform server heterogen, dan afinitas jaringan VM. Peningkatan ini mencerminkan rekayasa bersama antara tim riset dan produk cloud Sangfor dan dirancang berdasarkan perilaku layanan platform nyata.
BAGIAN 5. Ringkasan
Penjadwalan NUMA adaptif Sangfor dioptimalkan untuk berbagai skenario infrastruktur guna meningkatkan efisiensi akses memori aplikasi:
- Mempartisi dan menempatkan vCPU VM secara adaptif pada node NUMA untuk mengurangi akses memori jarak jauh.
- Migrasikan VM antar node NUMA untuk menjaga keseimbangan pemanfaatan sumber daya.
- Identifikasi VM prioritas dan tempatkan VM tersebut pada node dengan persaingan lebih rendah, sehingga mengurangi persaingan untuk CPU, bandwidth memori, dan cache.
- Untuk server dengan banyak node NUMA dan jarak antar-node yang berbeda, identifikasi jarak topologi dan prioritaskan penempatan sumber daya vNUMA terkait pada node NUMA fisik terdekat.
- Sediakan opsi afinitas jaringan VM yang menempatkan VM pada node NUMA yang sama dengan bidang data jaringan untuk meningkatkan kinerja penerusan.
- Terapkan penjadwalan yang mendukung NUMA tidak hanya pada VM, tetapi juga pada layanan penyimpanan.
Contoh Pengujian UnixBench
UnixBench adalah benchmark yang banyak digunakan untuk sistem mirip Unix, termasuk UNIX, BSD, dan Linux. Benchmark ini mengukur berbagai dimensi kinerja sistem, termasuk kinerja CPU, sistem file, memori, dan proses.
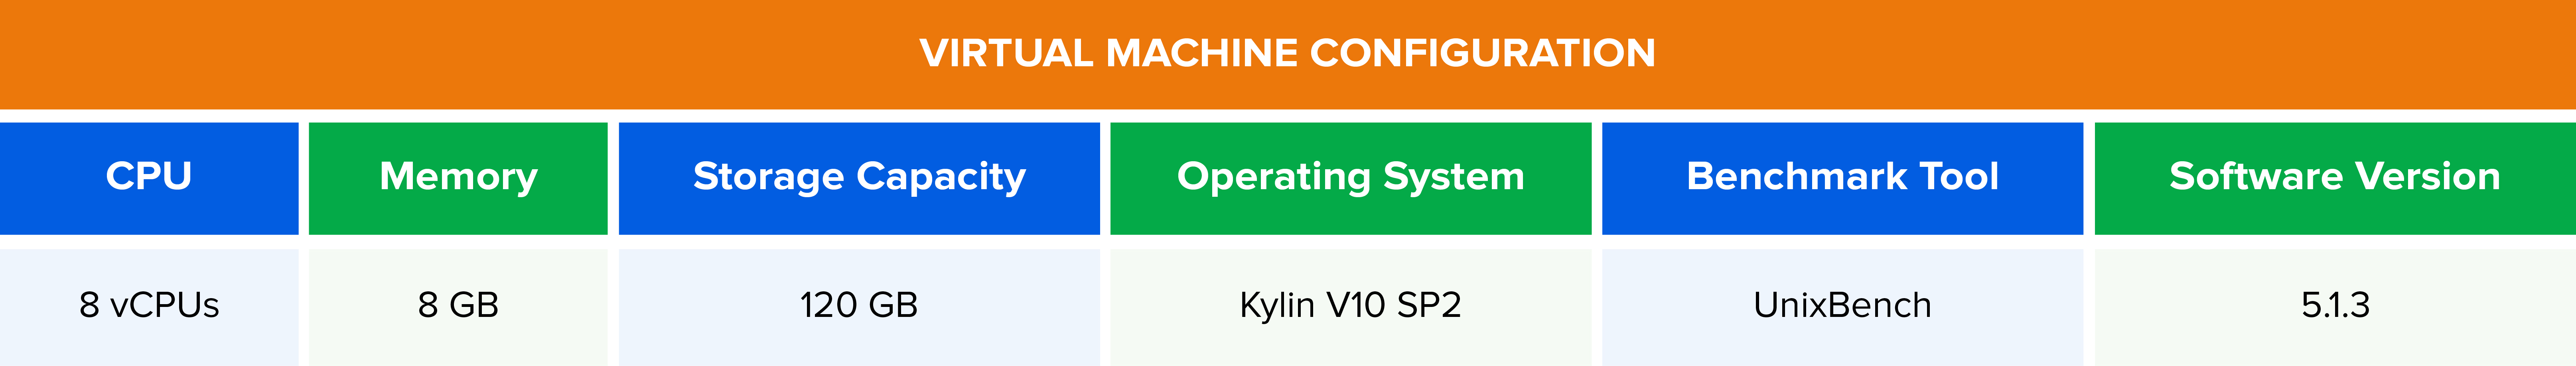
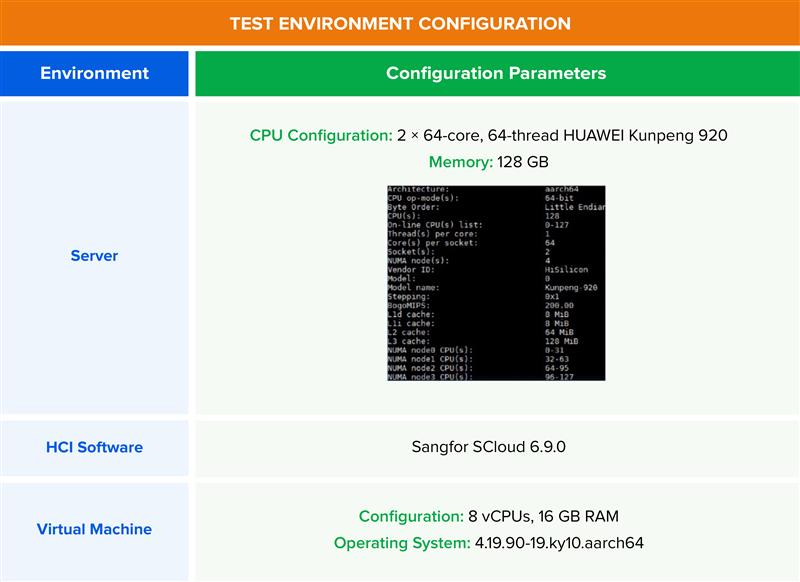
Gambar 12. Konfigurasi mesin virtual untuk pengujian UnixBench.
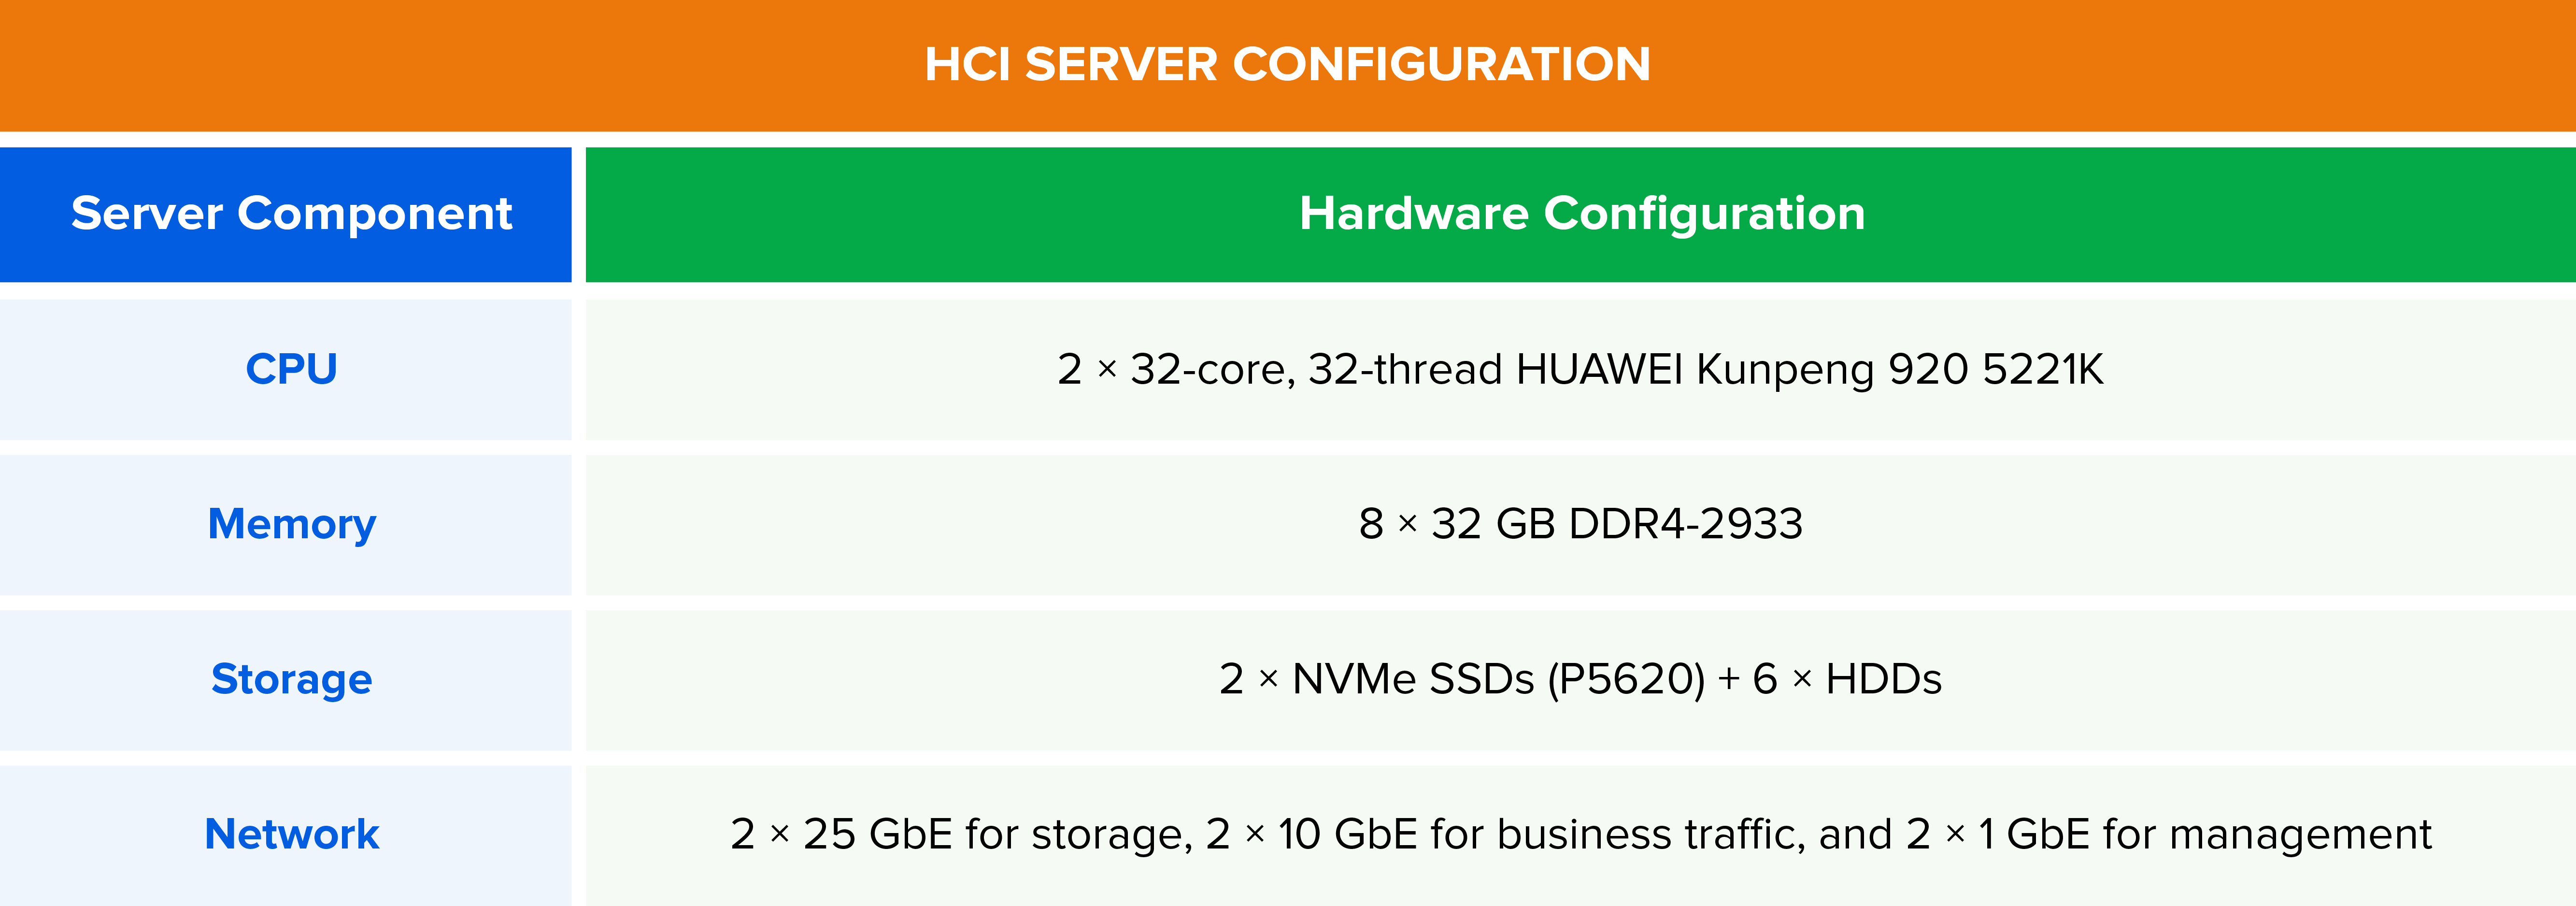
Gambar 13. Konfigurasi perangkat keras server HCI untuk pengujian UnixBench.
Hasil Pengujian: Pada Sangfor HCI 6.9.0, dengan NUMA diaktifkan, skor UnixBench agregat untuk 6 VM yang berjalan secara bersamaan pada host yang sama adalah 20,2% lebih tinggi daripada platform perbandingan anonim. Untuk 8 VM yang berjalan bersamaan, skor agregatnya adalah 34,17% lebih tinggi.
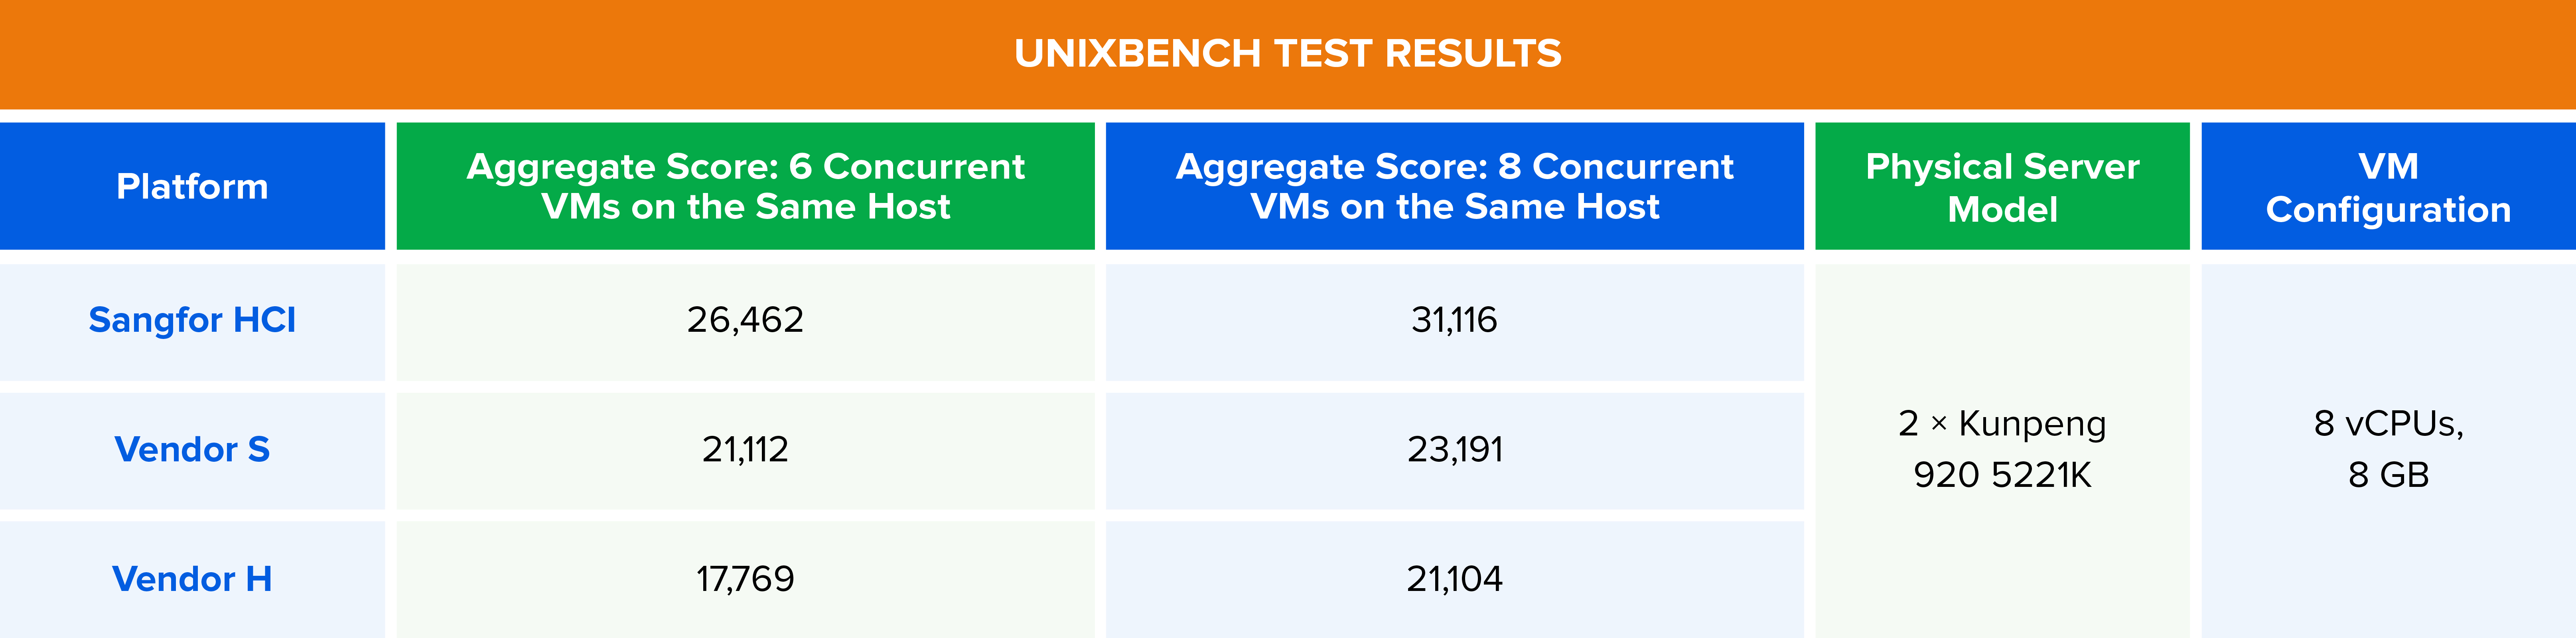
Gambar 14. Hasil benchmark UnixBench komparatif di bawah beban kerja mesin virtual konkuren.
Pengamatan tolok ukur dalam artikel ini mencerminkan lingkungan pengujian internal Sangfor tertentu dan disediakan untuk ilustrasi teknis. Hasil aktual bervariasi tergantung pada perangkat keras, versi perangkat lunak, konfigurasi, dan beban kerja. Pelanggan harus memvalidasi aplikasi representatif terhadap tujuan tingkat layanan mereka sendiri.

