
A medida que más organizaciones trasladan cargas de trabajo críticas para el negocio a infraestructuras virtualizadas, hiperconvergentes y en la nube, el rendimiento bajo alta concurrencia se ha convertido en una prioridad absoluta. Para los equipos que evalúan una alternativa a VMware , la cuestión no es simplemente si otra plataforma puede ofrecer una funcionalidad similar, sino si puede mantener la latencia, el rendimiento y la estabilidad que requieren los sistemas empresariales centrales.
Este desafío se hace especialmente evidente en aplicaciones que requieren un uso intensivo de memoria, como el trading de alta frecuencia y la gestión de riesgos en el sector financiero, los sistemas de historiales clínicos electrónicos en el sector sanitario y los sistemas de gestión de almacenes en logística. Sus crecientes necesidades de acceso a la memoria están estrechamente relacionadas con componentes de backend como Redis, Apache Spark, SAP HANA y motores o modelos de IA. Redis, por ejemplo, es una base de datos en memoria cuyo rendimiento se ve directamente afectado por la velocidad de acceso a la memoria.
NUMA es ahora una arquitectura de CPU de servidor de uso generalizado. Por lo tanto, mejorar la eficiencia del acceso a la memoria en NUMA es un aspecto importante de la optimización del rendimiento de la virtualización. Este artículo explica las tecnologías de optimización NUMA de Sangfor y cómo ayudan a las plataformas de virtualización a soportar cargas de trabajo críticas y altamente concurrentes durante la sustitución de VMware .
PARTE 1. Antecedentes de la arquitectura NUMA
Los primeros sistemas informáticos solían utilizar un único procesador para todas las tareas de computación. A medida que las aplicaciones se volvieron más complejas y exigentes, un solo procesador ya no podía satisfacer los requisitos de computación de alto rendimiento, y los sistemas evolucionaron gradualmente hacia arquitecturas multinúcleo.
Los sistemas multinúcleo tradicionales suelen utilizar el procesamiento simétrico multiprocesador (SMP). En SMP, todos los procesadores tienen el mismo estatus y los mismos derechos de acceso a la memoria. Cualquier hilo puede ejecutarse en cualquier procesador, lo que permite un equilibrio de carga eficaz y mejora el rendimiento y la velocidad de procesamiento generales. Sin embargo, dado que varios núcleos comparten el mismo bus para acceder a la memoria, este puede convertirse en un cuello de botella a medida que aumenta el número de núcleos, lo que limita la escalabilidad y el rendimiento.
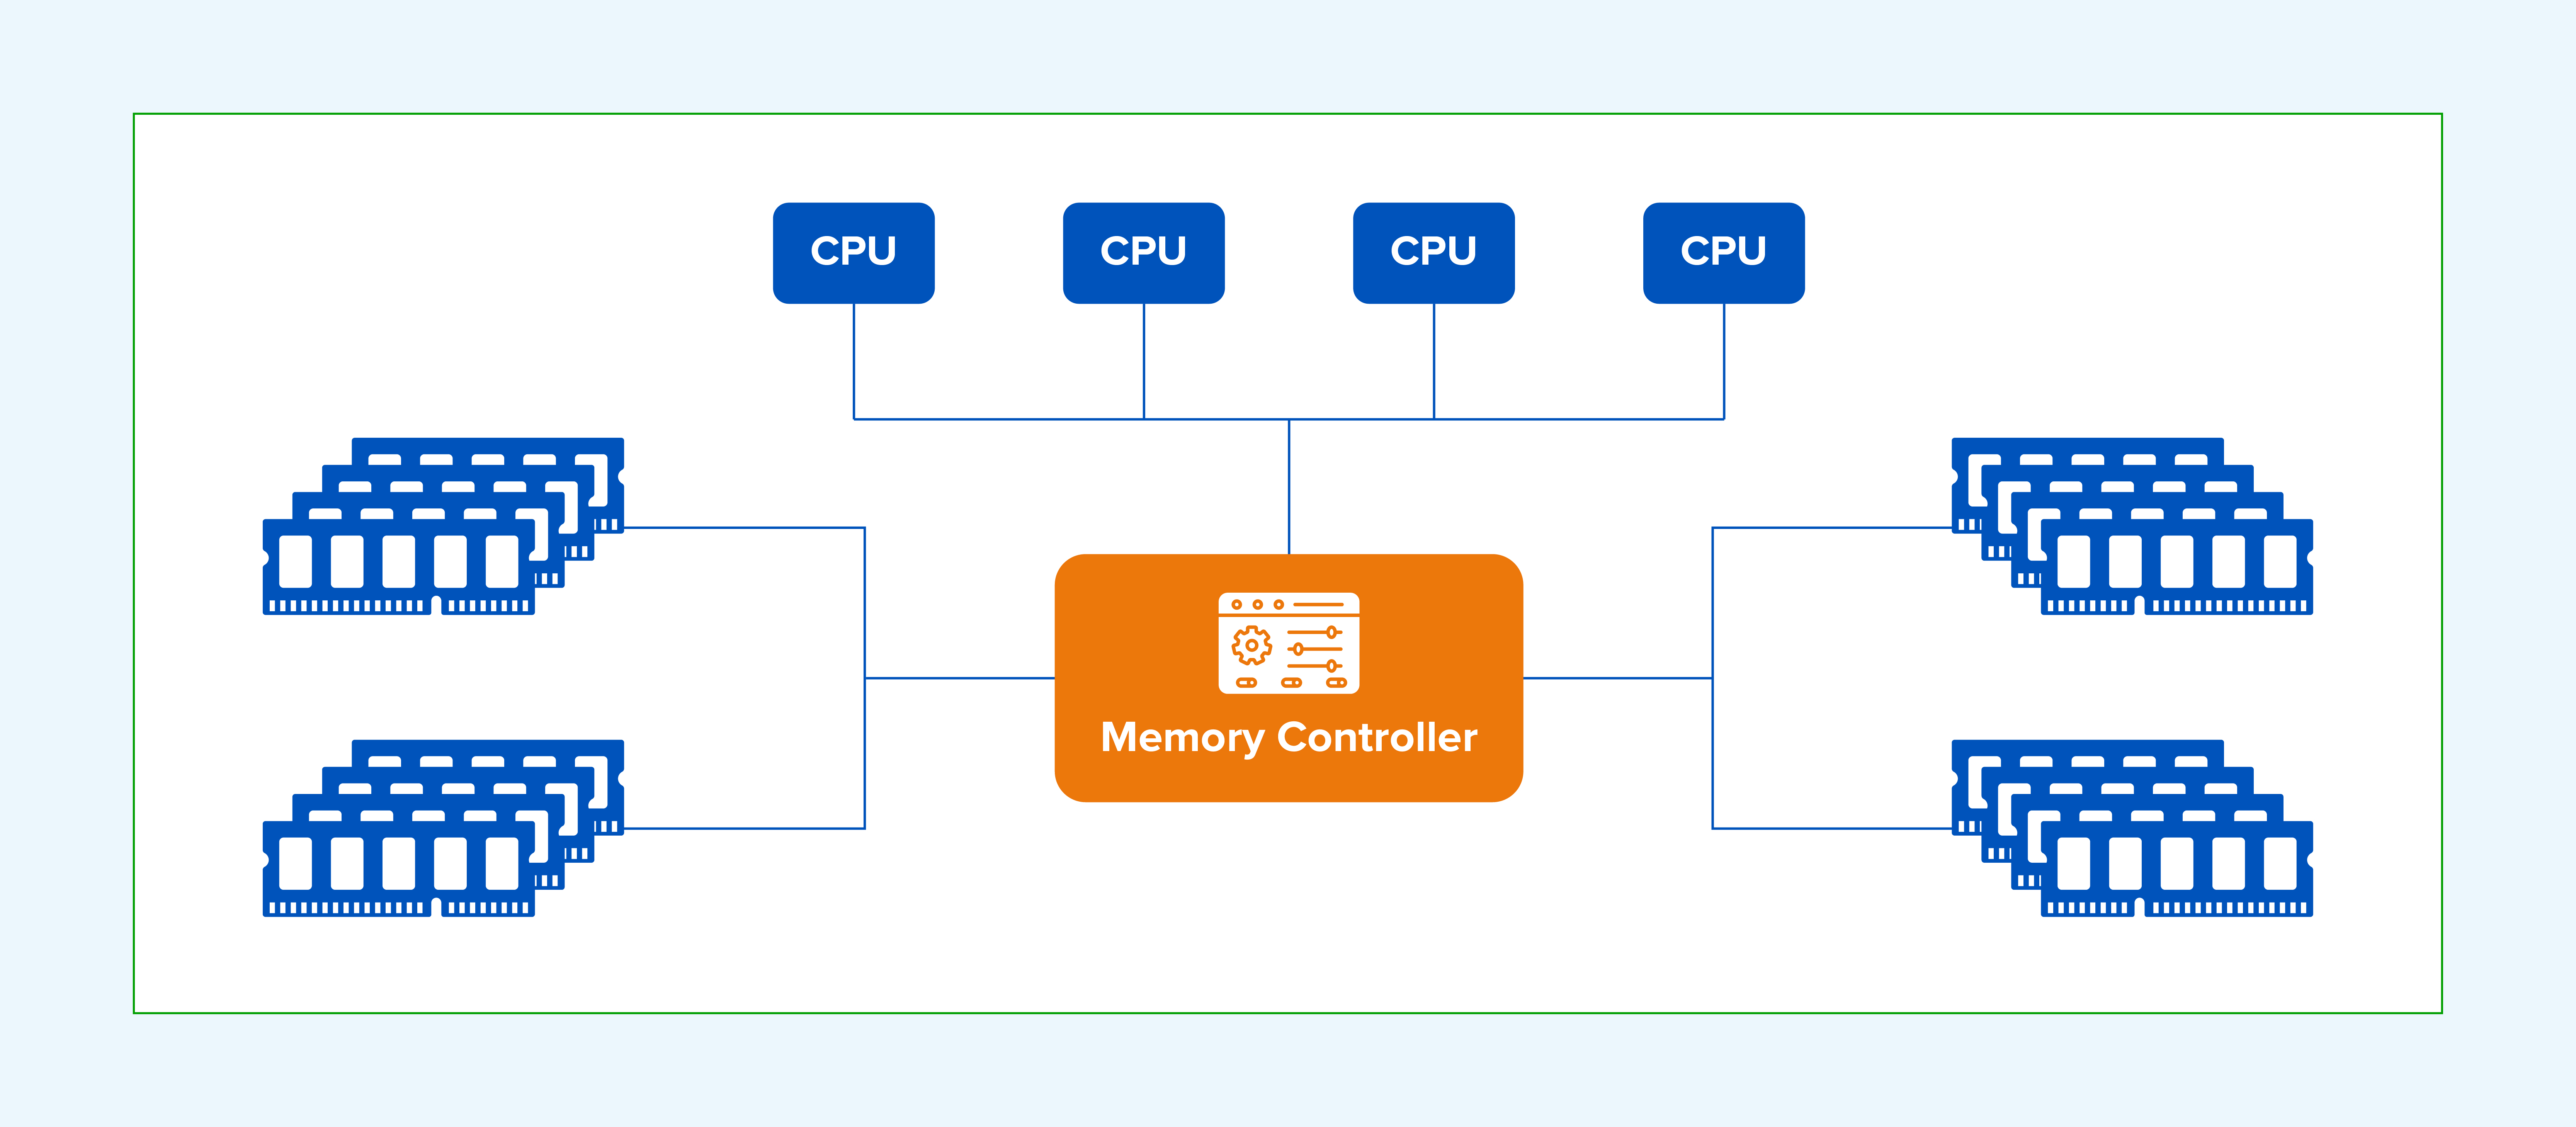
Figura 1: Cuello de botella en el acceso a la memoria del bus compartido en las arquitecturas SMP tradicionales.
NUMA soluciona el cuello de botella de acceso a memoria de SMP. En una arquitectura NUMA, el sistema se divide en varios nodos, cada uno con uno o más procesadores, memoria local y dispositivos de E/S. Los nodos se comunican mediante interconexiones de alta velocidad, como AMD HyperTransport o Intel QuickPath Interconnect (QPI), lo que permite que los procesadores accedan primero a la memoria local, reduciendo así la latencia de acceso a memoria y mejorando el rendimiento del sistema multiprocesador.
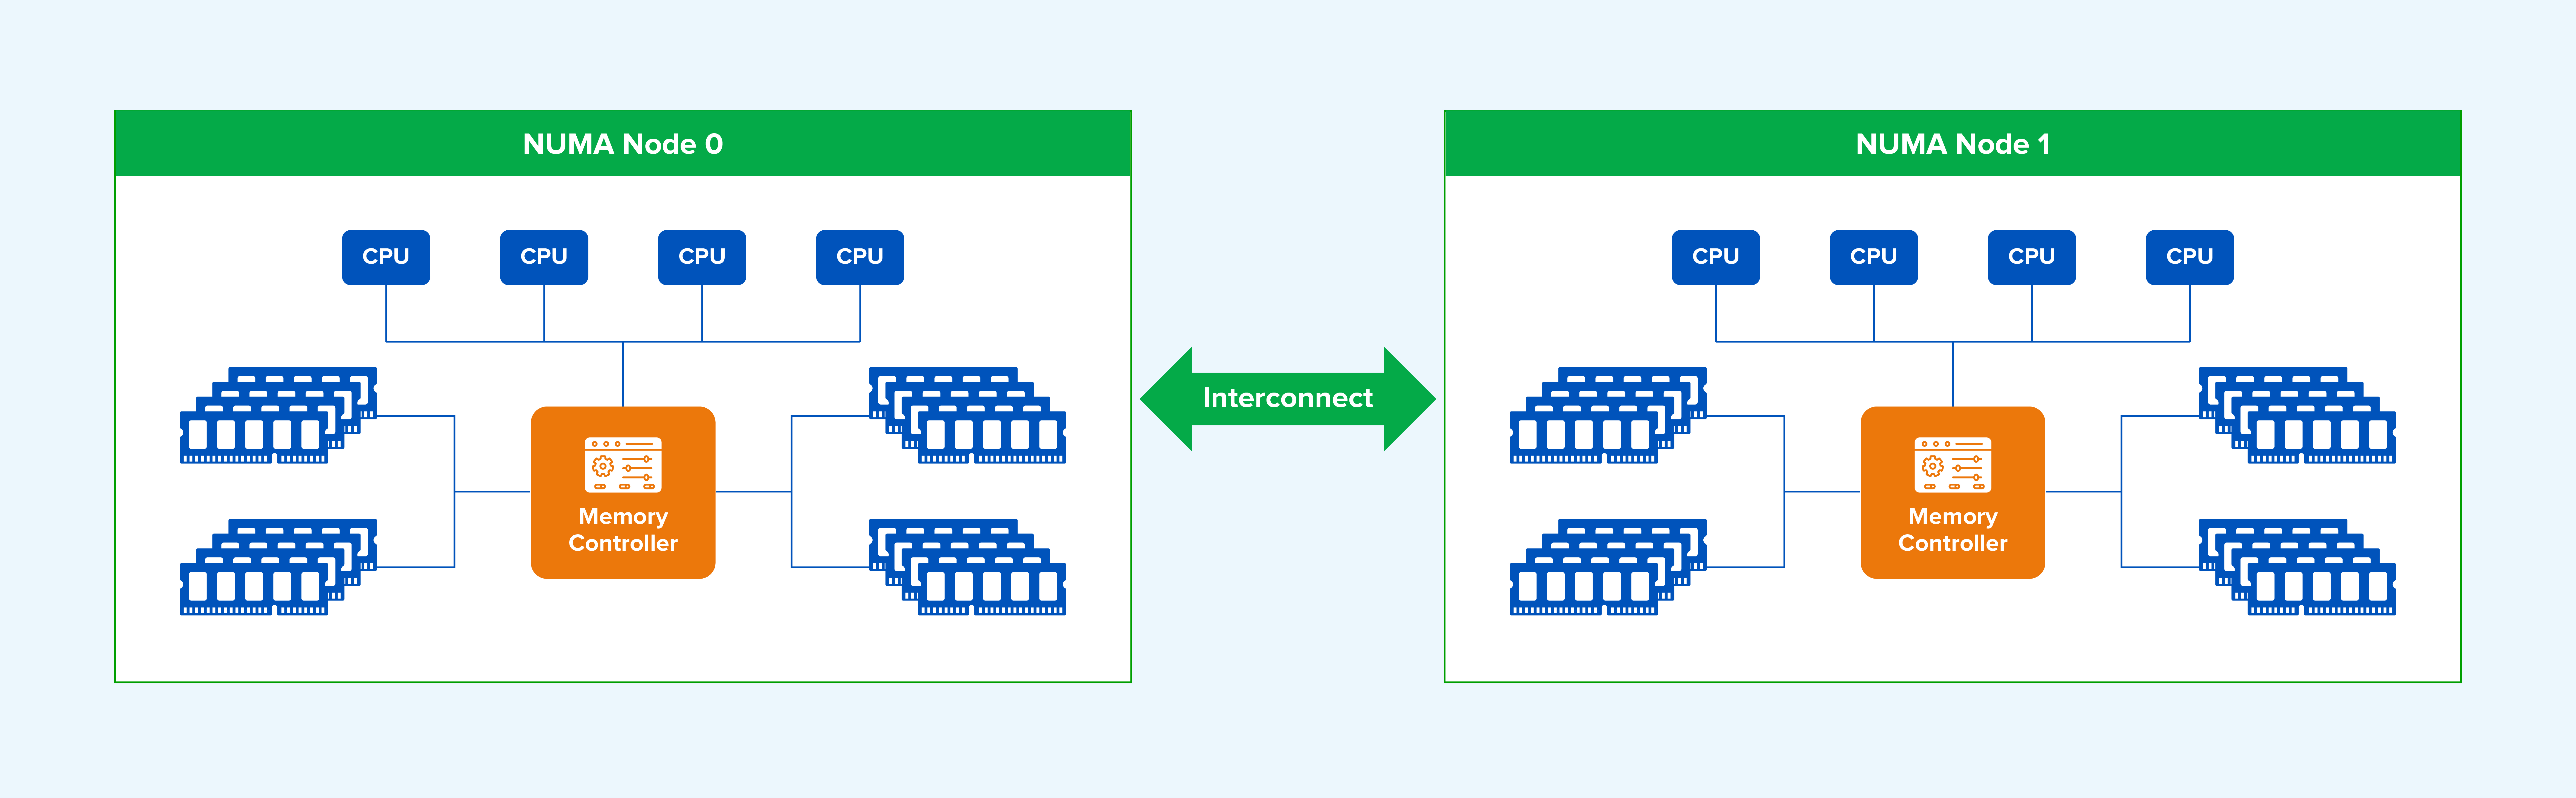
Figura 2: Arquitectura NUMA multinodo con asignación de CPU y memoria local en cada nodo.
Un sistema NUMA contiene tres tipos de nodos:
- Nodo local: Para las CPU dentro de un nodo determinado, ese nodo es el nodo local.
- Nodo vecino: Un nodo adyacente al nodo local.
- Nodo remoto: Un nodo que no es ni local ni vecino.
La velocidad de acceso a la CPU varía según el tipo de nodo. La memoria local es la más rápida de acceder, mientras que la memoria remota es la más lenta. En general, el acceso a la memoria se ralentiza a medida que aumenta la distancia topológica.
En “NUMA: Una visión general”, el Dr. Christoph Lameter señaló que, en un servidor de dos nodos de gama alta en 2013, la latencia de acceso aleatorio a la memoria local era de aproximadamente 100 ns, mientras que el acceso a la memoria remota añadía alrededor de un 50 % más de latencia.
PARTE 2. Desafíos introducidos por NUMA
En Linux, un hilo es la unidad básica de planificación de la CPU y corresponde a una tarea en la cola de ejecución de la CPU. El núcleo selecciona una CPU relativamente inactiva para cada tarea. Dado que la carga de la CPU cambia dinámicamente, el núcleo utiliza el balanceo de carga para migrar las tareas a las CPU menos ocupadas. Por defecto, una tarea puede, por lo tanto, moverse entre diferentes CPU.
En NUMA, una tarea puede pasar de una CPU en el Nodo 1 a una CPU en el Nodo 2 mientras continúa accediendo a la memoria asignada en el Nodo 1, lo que resulta en acceso entre nodos. El balanceo de NUMA de Linux migra periódicamente tareas o páginas de memoria hacia el nodo local, pero no puede eliminar por completo el acceso a memoria remota.
En un entorno virtualizado, cada vCPU de la máquina virtual corresponde a un hilo del sistema operativo del host. Si varios hilos de vCPU se ejecutan en diferentes nodos NUMA compartiendo memoria o migran entre nodos, la máquina virtual puede acceder a la memoria en varios nodos NUMA y experimentar una mayor latencia.
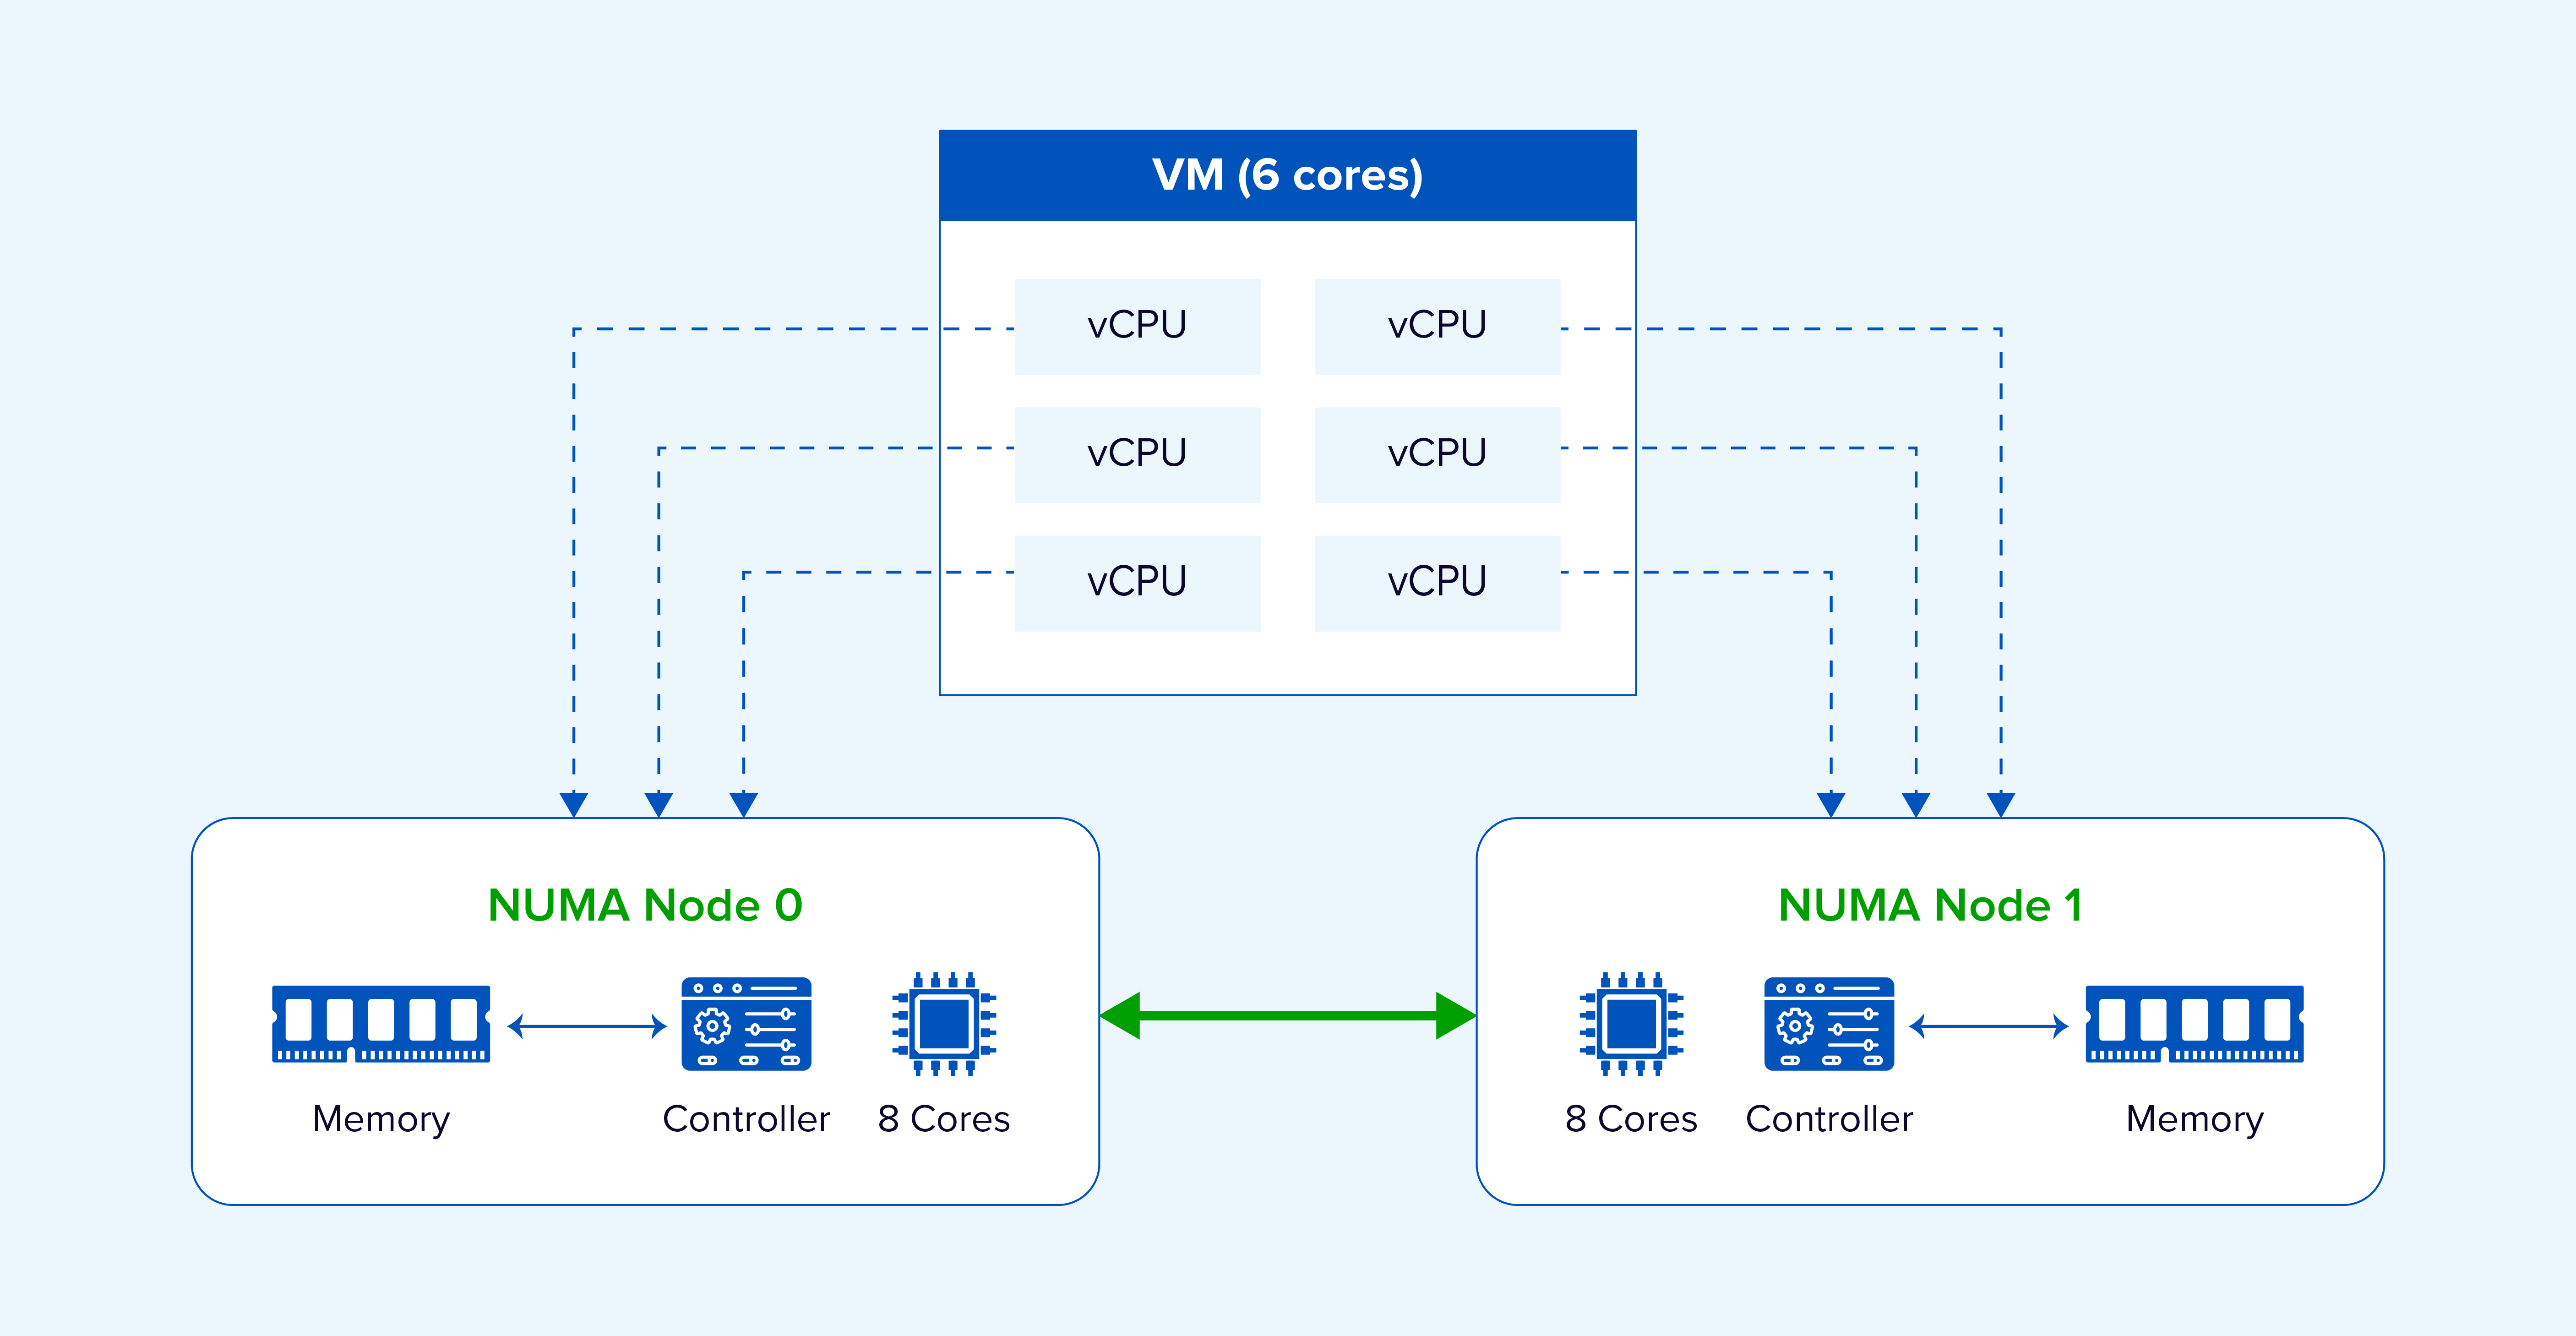
Figura 3: La ejecución entre nodos puede aumentar el acceso a la memoria remota para una máquina virtual.
PARTE 3. Enfoques comunes de planificación NUMA
La industria suele utilizar los siguientes enfoques:
Enfoque 1: Asignar las vCPU a los núcleos físicos
Los administradores configuran manualmente la asignación de vCPU para que los recursos de las máquinas virtuales se ejecuten preferentemente dentro del mismo nodo NUMA físico.
Enfoque 2: Especificar el número de nodos NUMA asignados a una máquina virtual.
Los administradores configuran manualmente el número de nodos NUMA y distribuyen los recursos de vCPU y memoria de manera uniforme entre ellos.
Enfoque 3: Asignación adaptativa de nodos NUMA
El planificador asigna automáticamente nodos NUMA adecuados a una máquina virtual. Las CPU de la máquina virtual se limitan a esos nodos y utilizan preferentemente la memoria local para mejorar la localidad. Si la máquina virtual tiene más vCPU de las que puede alojar un solo nodo NUMA, se distribuye entre varios nodos. La topología NUMA puede exponerse al sistema operativo invitado para que este tome decisiones basadas en la topología, mientras que las máquinas virtuales pueden migrarse entre nodos para mantener el equilibrio de carga.
Los enfoques 1 y 2 imponen más restricciones, requieren un dimensionamiento preciso de la CPU de la máquina virtual y pueden generar desequilibrios entre los nodos NUMA debido a la vinculación estática. Por lo tanto, la asignación adaptativa resulta más práctica para entornos de producción dinámicos.
PARTE 4. Programación de Sangfor NUMA en detalle
Sangfor HCI utiliza principalmente la programación NUMA adaptativa. Equilibra la utilización entre los nodos NUMA al tiempo que reduce el acceso a la memoria remota por parte de las vCPU de las máquinas virtuales, mejorando así el rendimiento general.
La planificación NUMA adaptativa ofrece claras ventajas de optimización en distintos tipos de aplicaciones, especialmente en middleware con operaciones frecuentes en memoria. Sangfor implementó DM8, Redis y Memcached en máquinas virtuales y realizó pruebas de rendimiento con la planificación NUMA habilitada y deshabilitada. Los resultados mostraron mejoras significativas en el rendimiento del middleware con la planificación NUMA habilitada.
Cargas de trabajo de bases de datos: Dameng DB (DM8) con BenchmarkSQL
BenchmarkSQL es una herramienta de evaluación comparativa de bases de datos relacionales que ejecuta una combinación de transacciones al estilo TPC-C, incluyendo nuevos pedidos, pagos, consultas de estado de pedidos, entregas y consultas de nivel de inventario. La métrica tpmC resultante representa el número de transacciones de nuevos pedidos procesadas por minuto, donde un valor más alto indica un mejor rendimiento. Se utilizó BenchmarkSQL 5.0 para probar la base de datos DM8. El siguiente gráfico muestra el rendimiento relativo, con el resultado de tpmC con NUMA deshabilitado normalizado al 100 %.
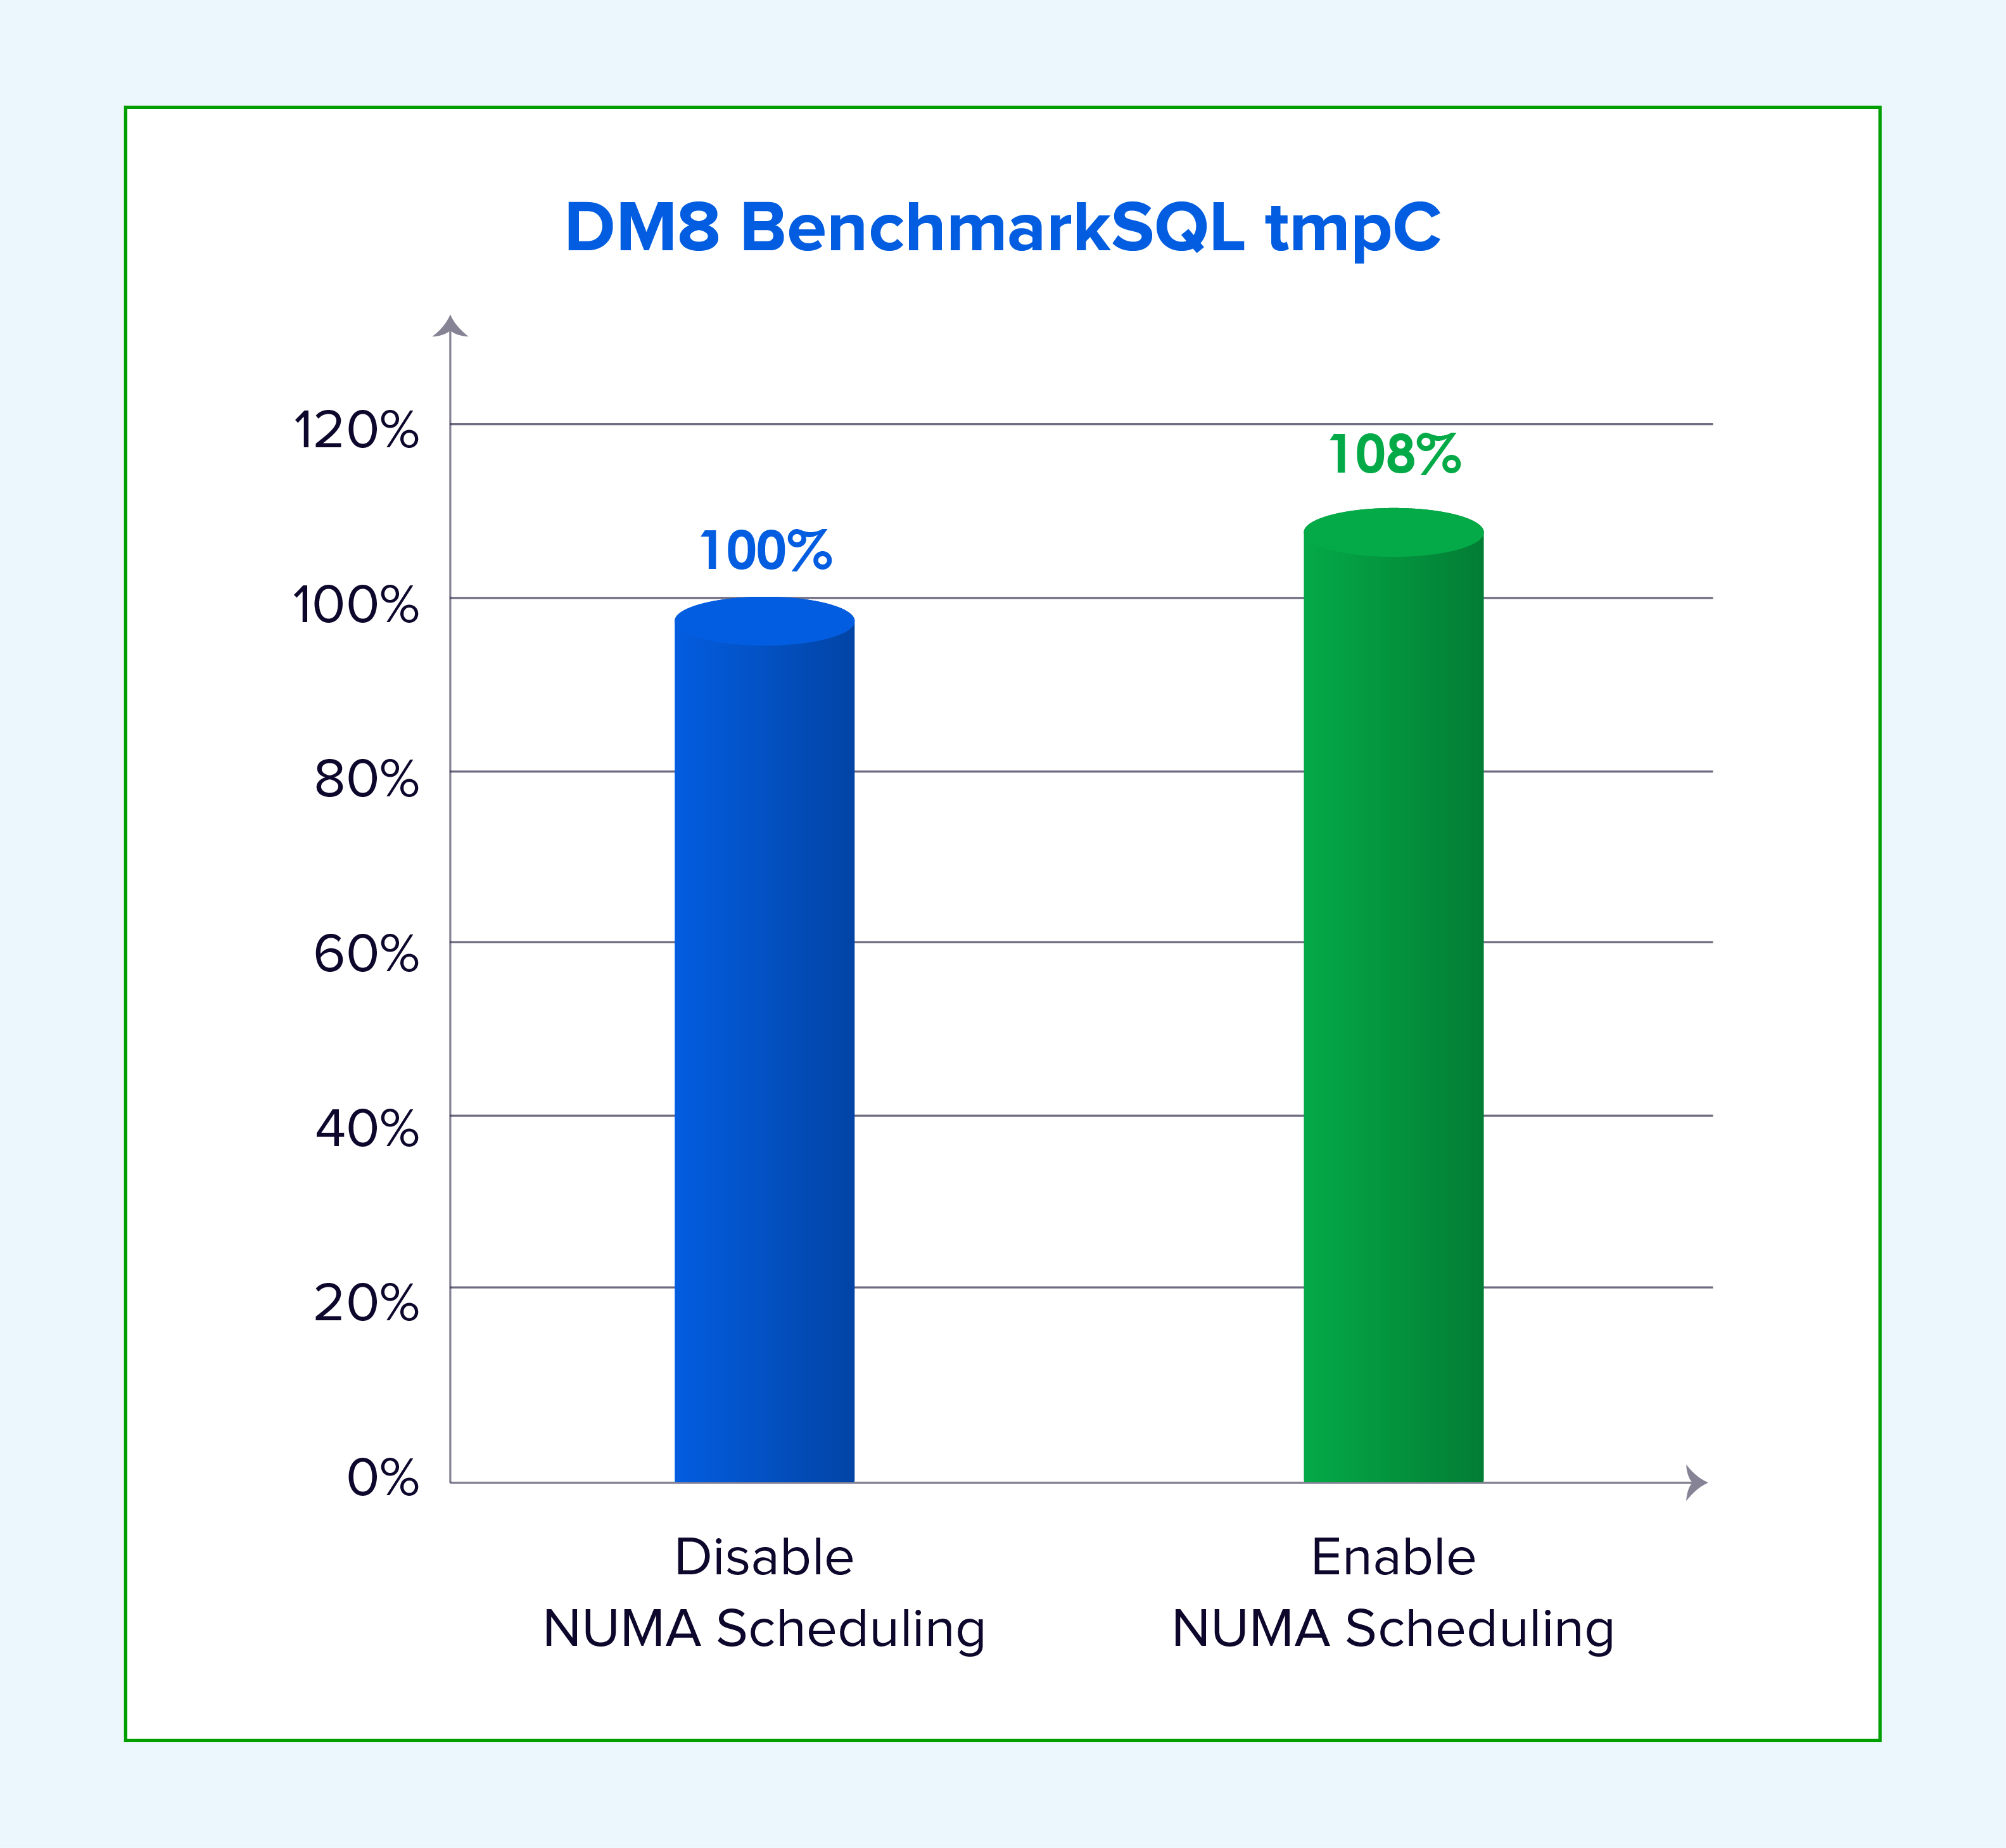
Figura 4: Rendimiento relativo de transacciones DM8 con la planificación NUMA habilitada frente a la deshabilitada.
Almacenamiento en caché en memoria: Redis 7.2.5
redis-benchmark es la herramienta oficial de prueba de rendimiento de Redis. Sangfor la utilizó para probar las consultas QPS de GET y SET para valores de 1 KB con la planificación NUMA deshabilitada y habilitada. QPS representa el número de operaciones de lectura o escritura por segundo.
redis-benchmark -t get -d 16 -c 100 -n 6000000 -r 60000000
redis-benchmark -t set -d 16 -c 100 -n 6000000 -r 60000000
El siguiente gráfico muestra el rendimiento relativo, con el resultado de QPS con NUMA deshabilitado normalizado al 100 %.
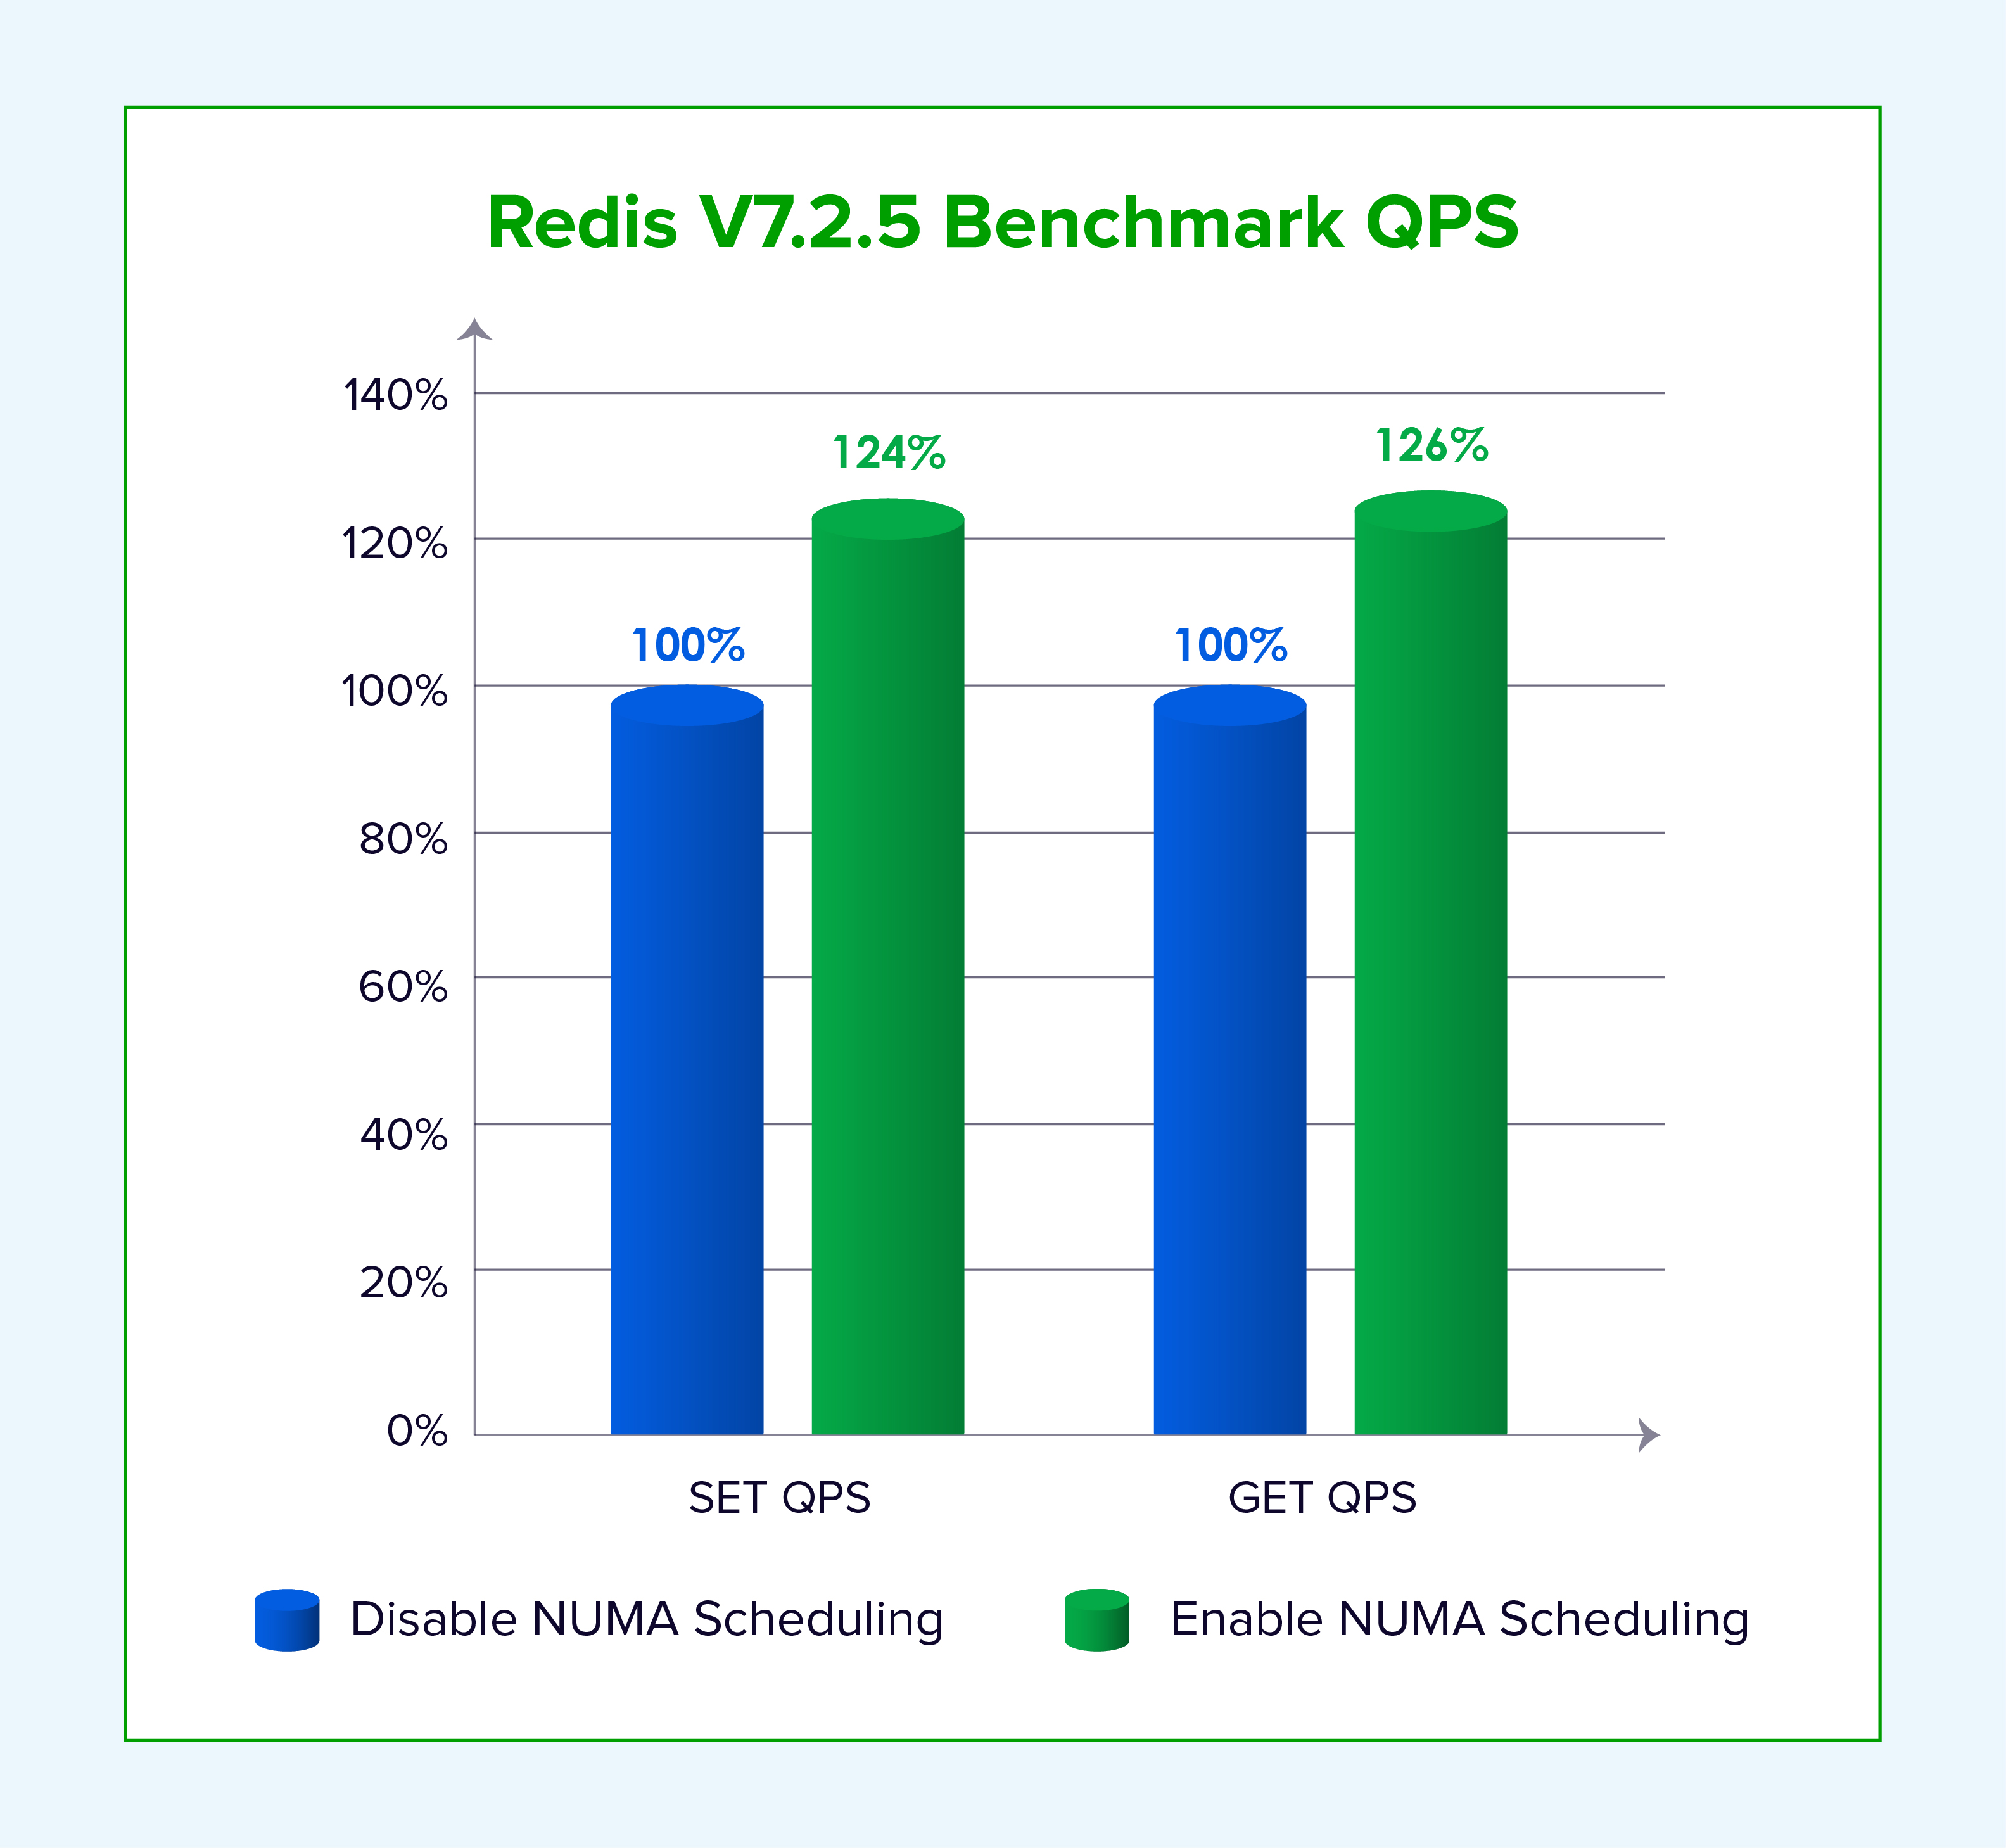
Figura 5: Mejoras relativas en el rendimiento de lectura/escritura de Redis (QPS) con la programación NUMA habilitada.
Almacenamiento en caché de clave-valor: Memcached 6.27
memaslap es una herramienta de prueba de rendimiento incluida con Memcached. Sangfor la utilizó para probar las TPS (transacciones por segundo) para valores de 1 KB con la programación NUMA deshabilitada y habilitada. TPS representa transacciones por segundo.
memaslap -s 127.0.0.1:11211 -t 300s -T 8
El siguiente gráfico muestra el rendimiento relativo, con el resultado de TPS con NUMA deshabilitado normalizado al 100 %.
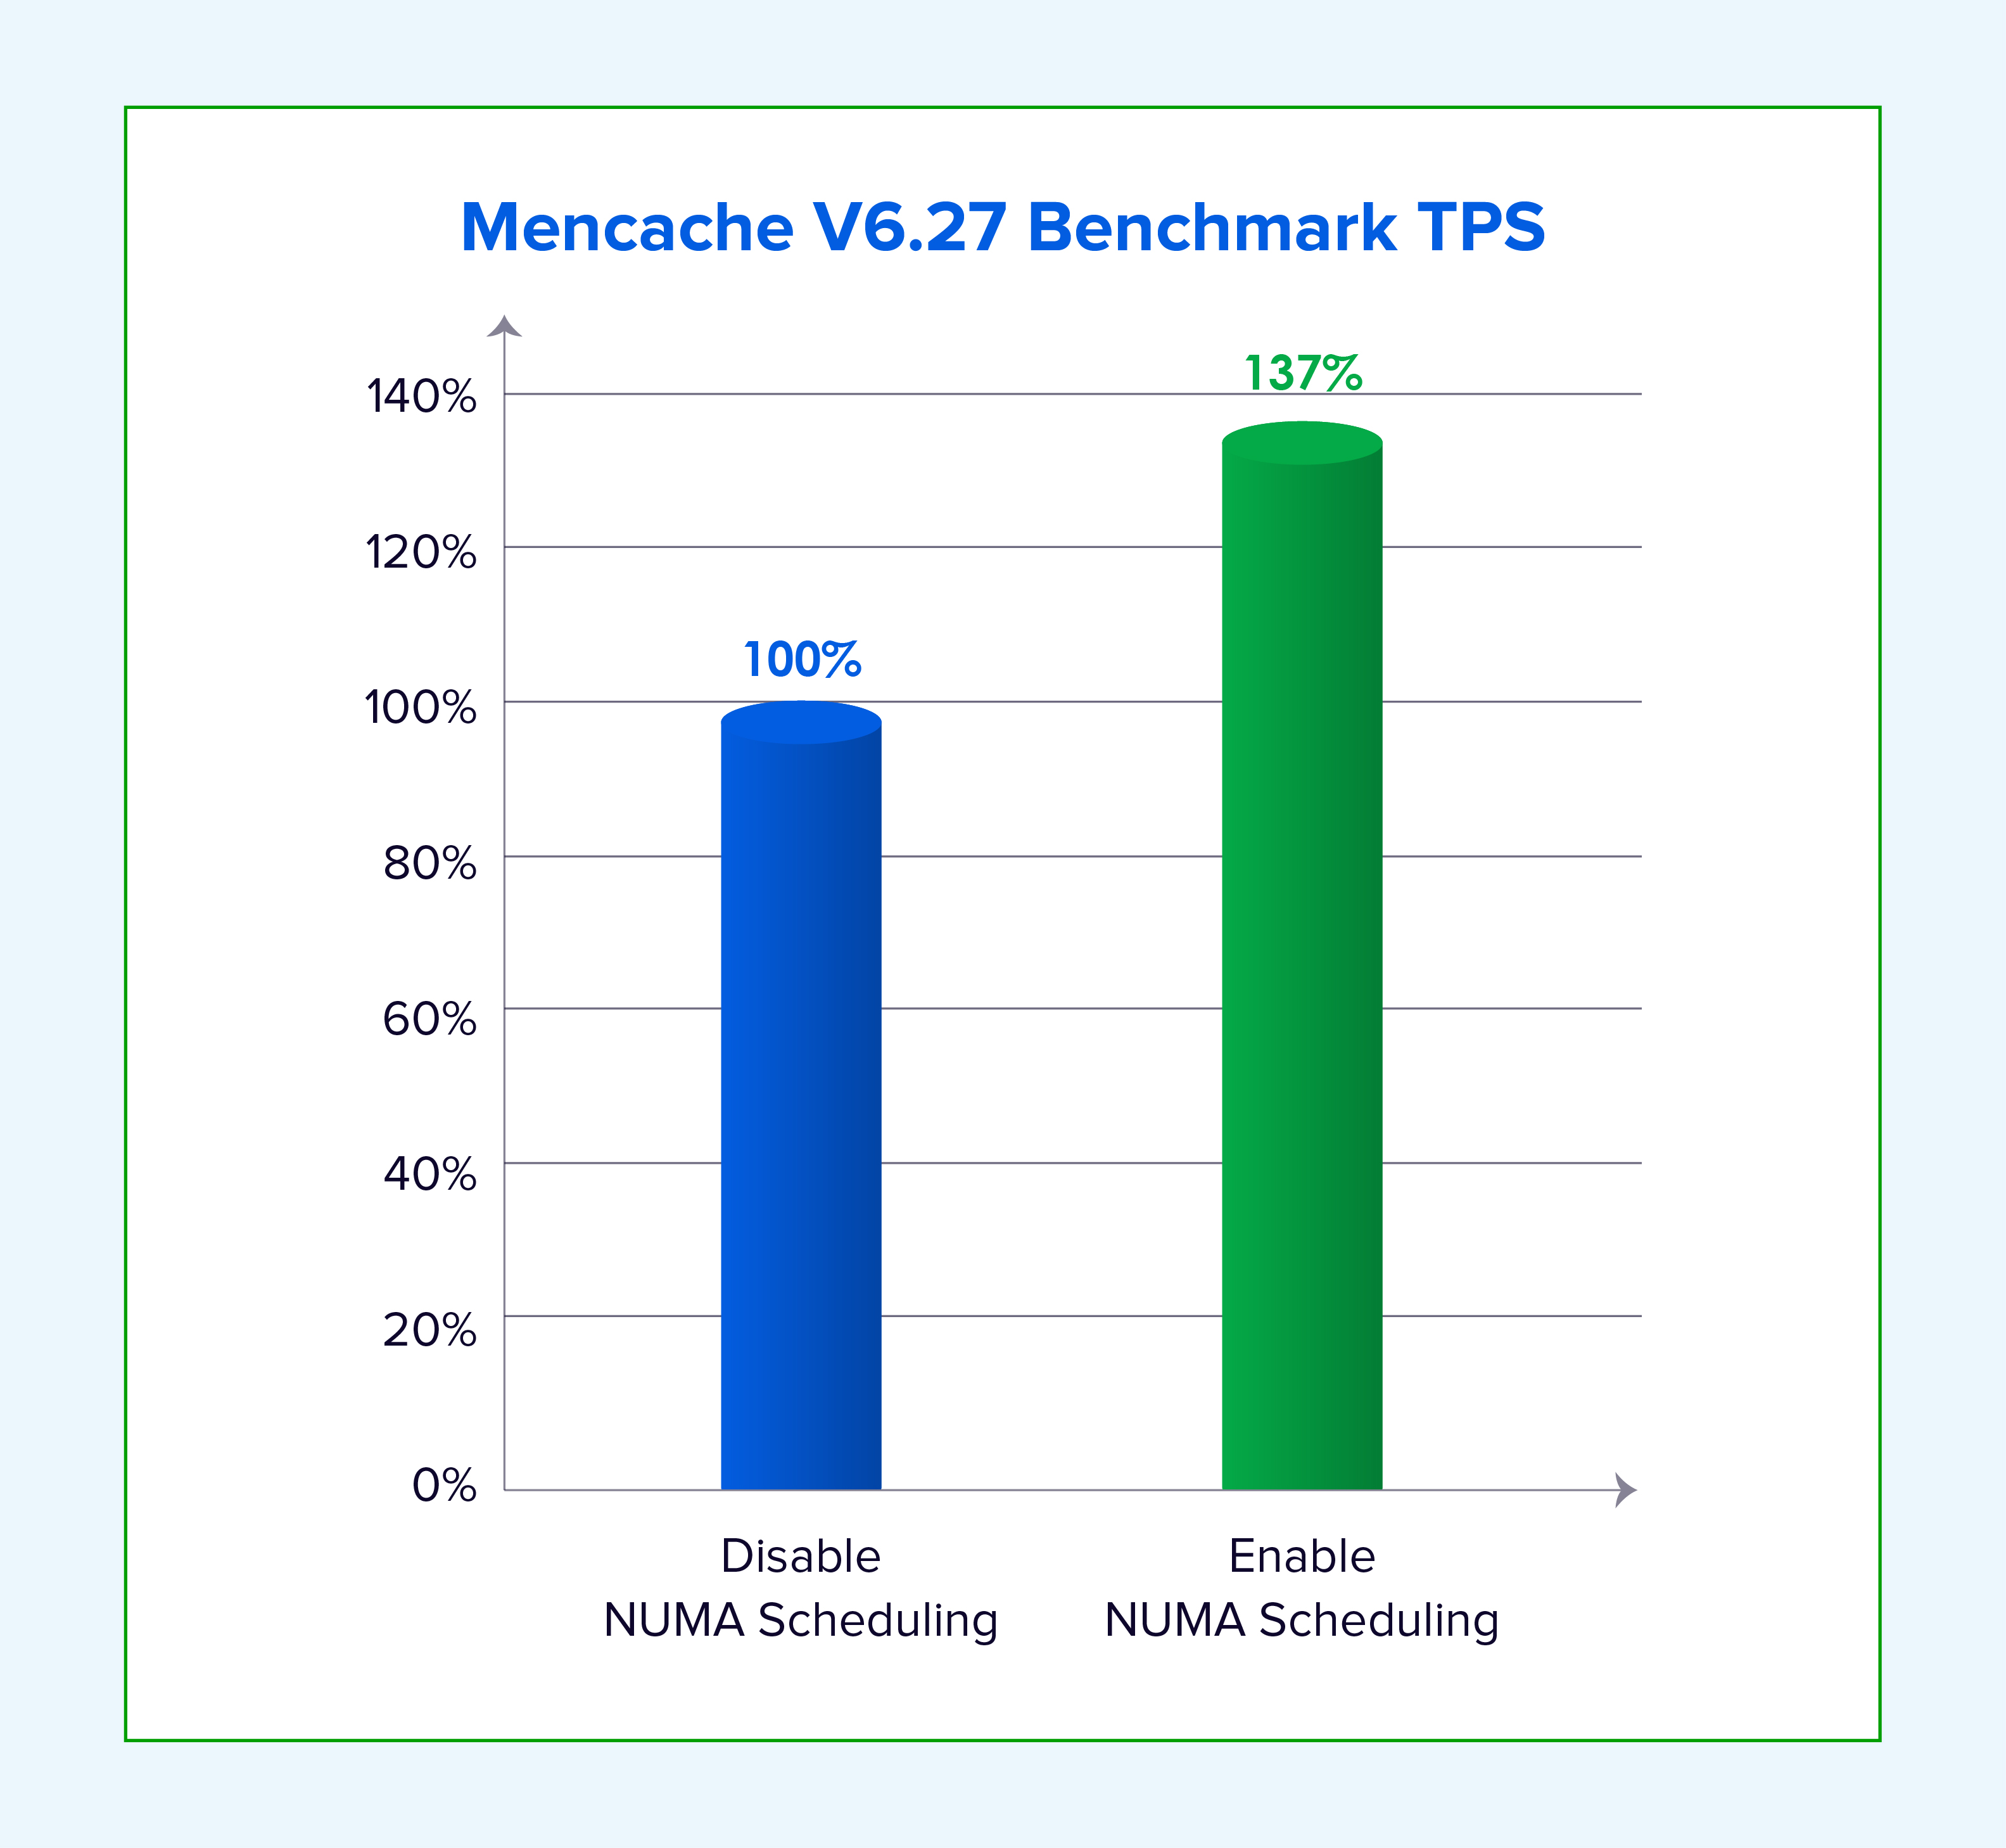
Figura 6: Mejoras relativas en el rendimiento transaccional de Memcached con la planificación NUMA habilitada.
Los resultados anteriores muestran claras ventajas para las aplicaciones que consumen mucha memoria. Las siguientes secciones explican cómo funciona la optimización.
1. Asignación adaptativa de nodos NUMA
Sangfor particiona de forma adaptativa las vCPU de las máquinas virtuales y las asigna a nodos NUMA adecuados para reducir el acceso a la memoria remota. Si el número de vCPU de la máquina virtual es inferior al número de núcleos de un nodo NUMA, la máquina virtual se asigna a un único nodo. Si la máquina virtual requiere más núcleos de los que un nodo puede proporcionar, se distribuye entre varios nodos y la topología vNUMA se expone al sistema operativo invitado para que este tome decisiones basadas en la topología.
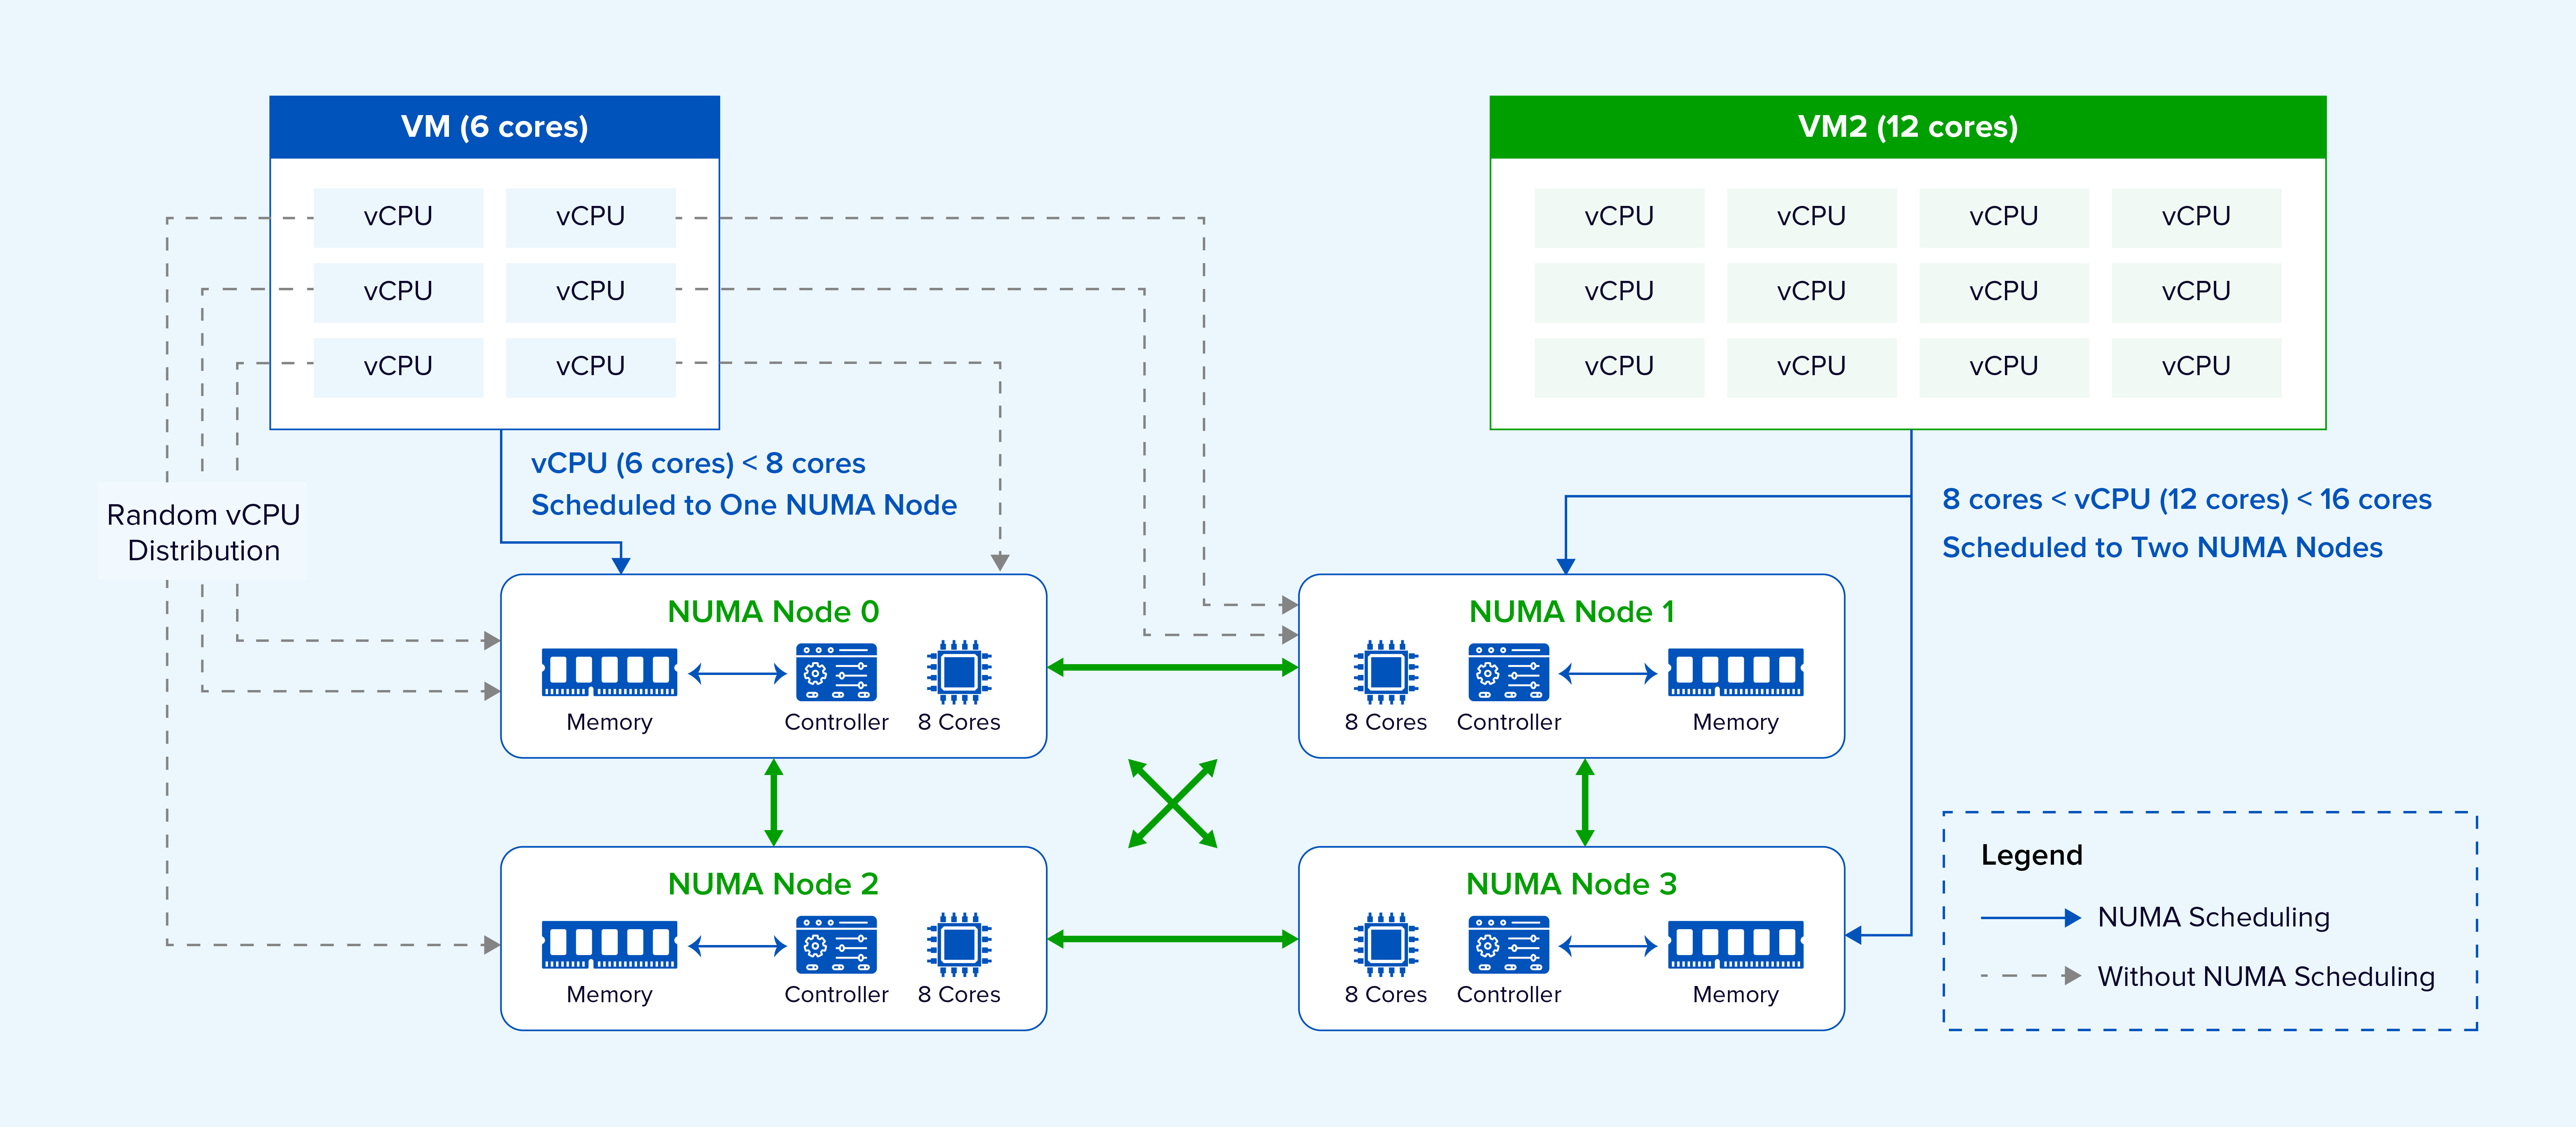
Figura 7: Particionamiento inteligente de vCPU y mapeo de topología vNUMA de Sangfor.
Para mantener una utilización equilibrada, la ubicación de las máquinas virtuales considera la carga actual en los nodos NUMA y selecciona el nodo con menor carga. Durante la ejecución, las máquinas virtuales pueden migrarse entre nodos según varíe su utilización. Las máquinas virtuales prioritarias se ubican preferentemente en los nodos con menor congestión para reducir la competencia por los recursos de CPU, ancho de banda de memoria y caché.
2. Optimización para plataformas de servidores heterogéneas
Algunas plataformas de servidores contienen muchos nodos NUMA, diferentes distancias entre nodos y relativamente pocos núcleos por nodo.
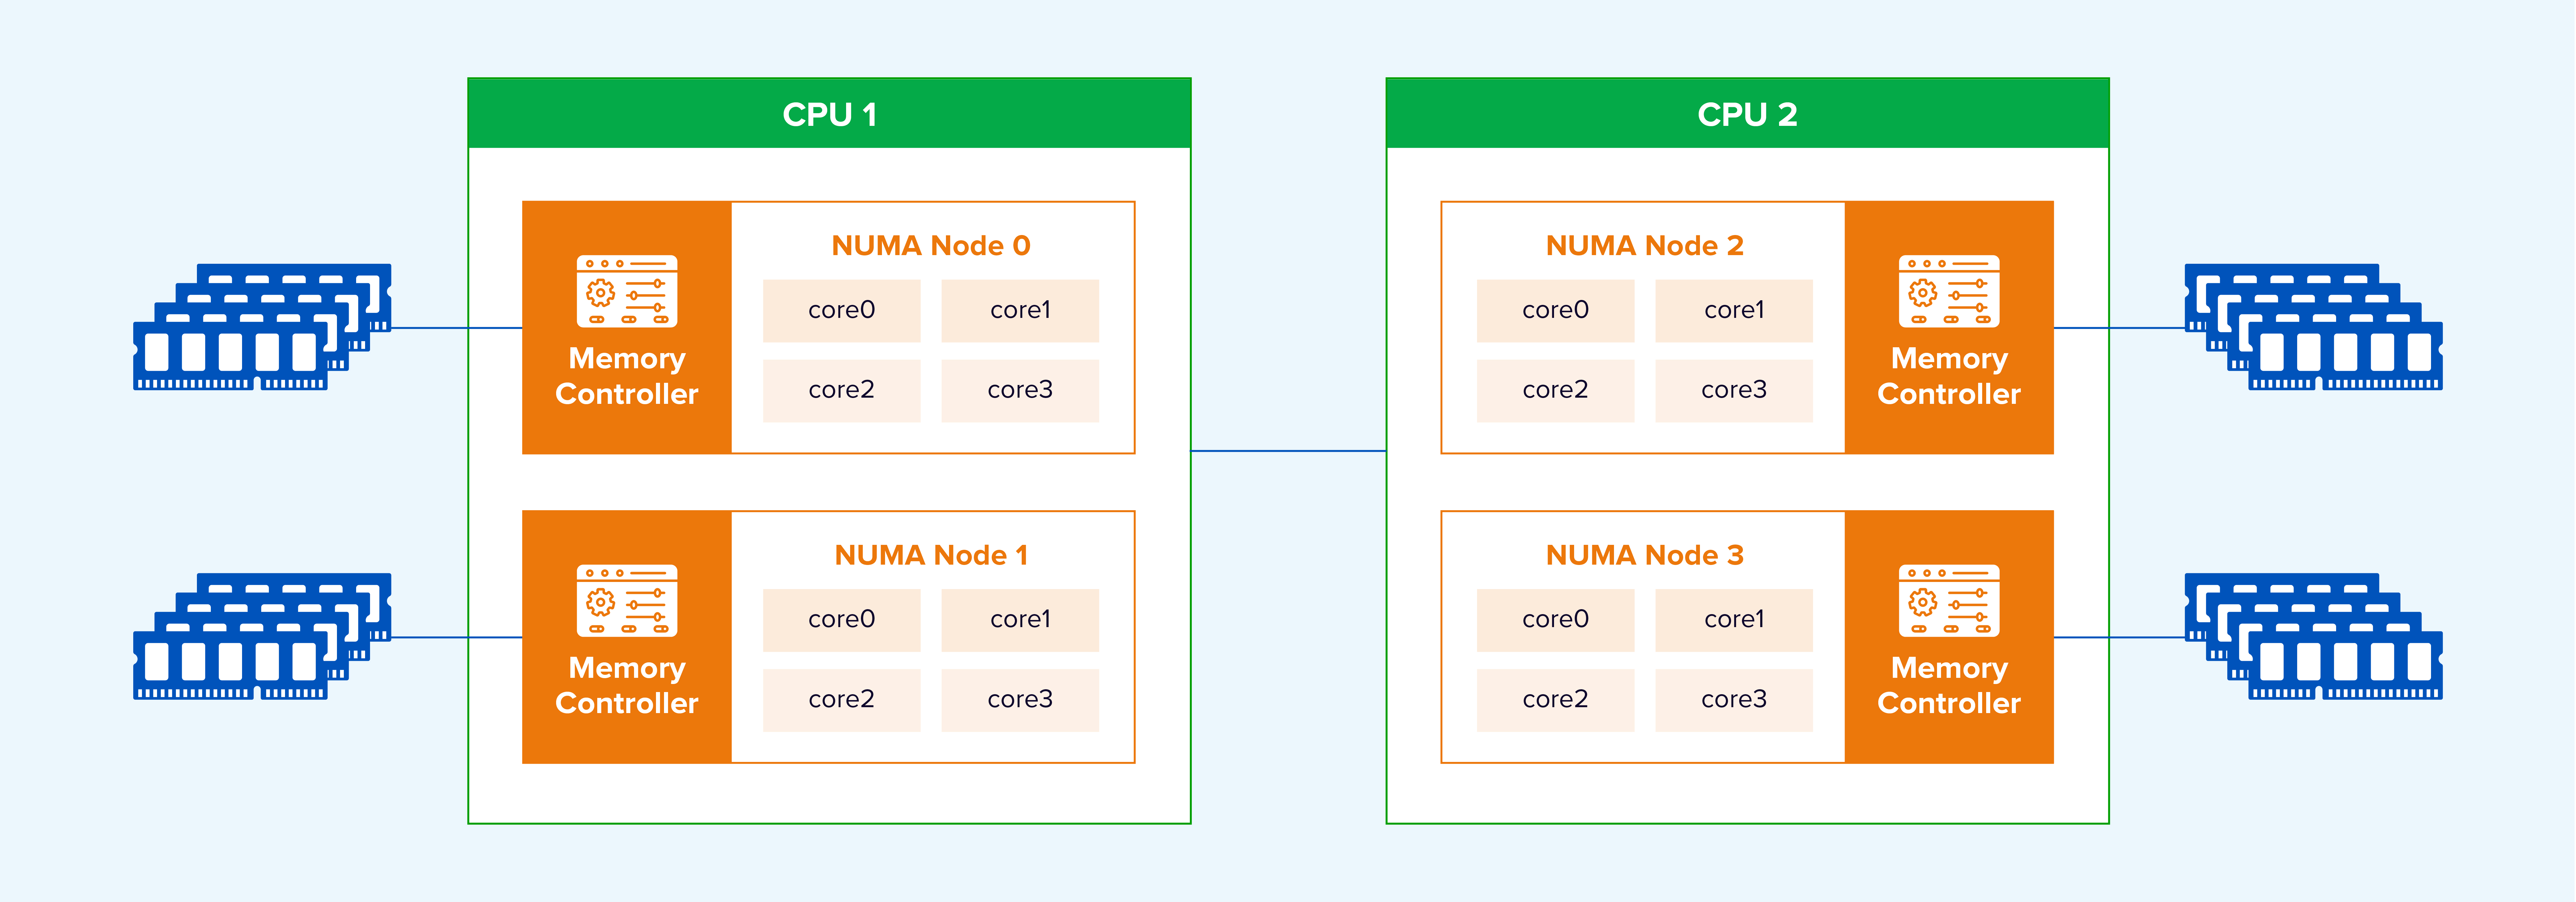
Figura 8. Ubicación de vNUMA con reconocimiento de topología en un servidor multinodo.
Sangfor identifica la distancia entre los nodos NUMA y coloca preferentemente varios nodos vNUMA de la misma máquina virtual en nodos NUMA físicos cercanos.
Para optimizar aún más el rendimiento del reenvío de datos, Sangfor desarrolló la afinidad NUMA entre las máquinas virtuales y los procesos del plano de datos. La máquina virtual y su proceso de reenvío de datos se programan en el mismo nodo NUMA, lo que aumenta el acceso a la memoria local. En la siguiente figura, DP se refiere al proceso del plano de datos.
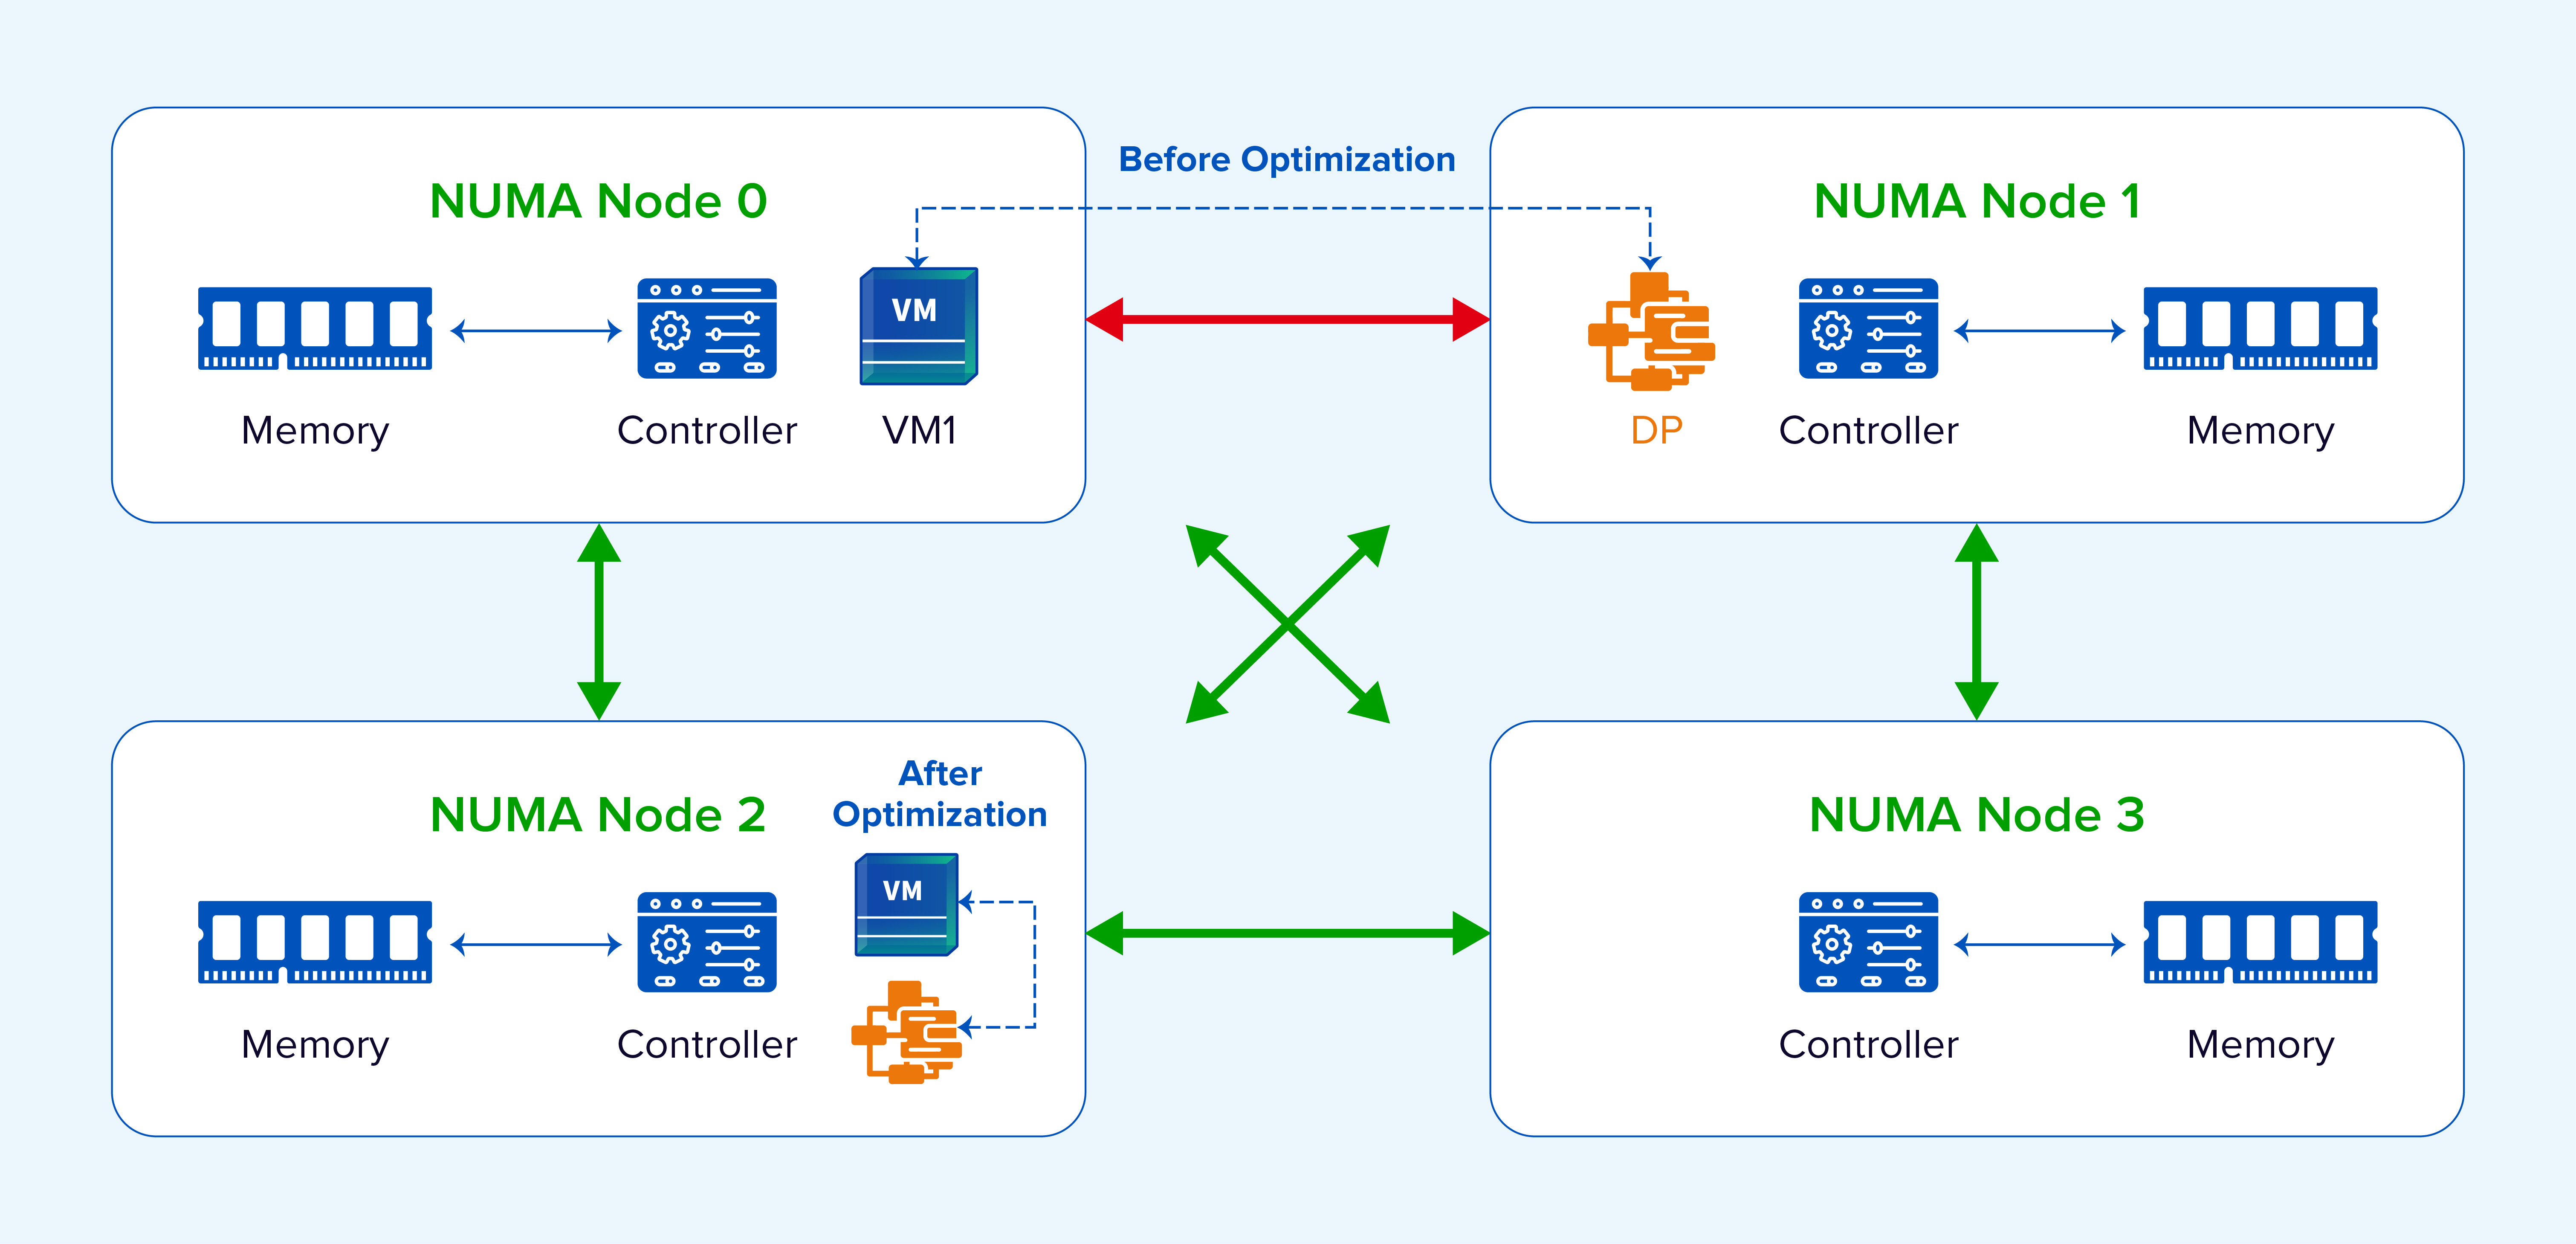
Figura 9. La afinidad entre la máquina virtual y el plano de datos mantiene el procesamiento cerca de la memoria local.
Para maximizar las ventajas de NUMA en el almacenamiento, Sangfor ubica la vCPU, QEMU, libnfs, aSAN y otros procesos involucrados en una ruta de E/S completa en el mismo nodo NUMA. Esto evita el acceso remoto a la memoria. Las páginas de memoria grandes mejoran aún más el rendimiento del acceso a la memoria, reducen la sobrecarga de procesamiento y aumentan la eficiencia del flujo de E/S.
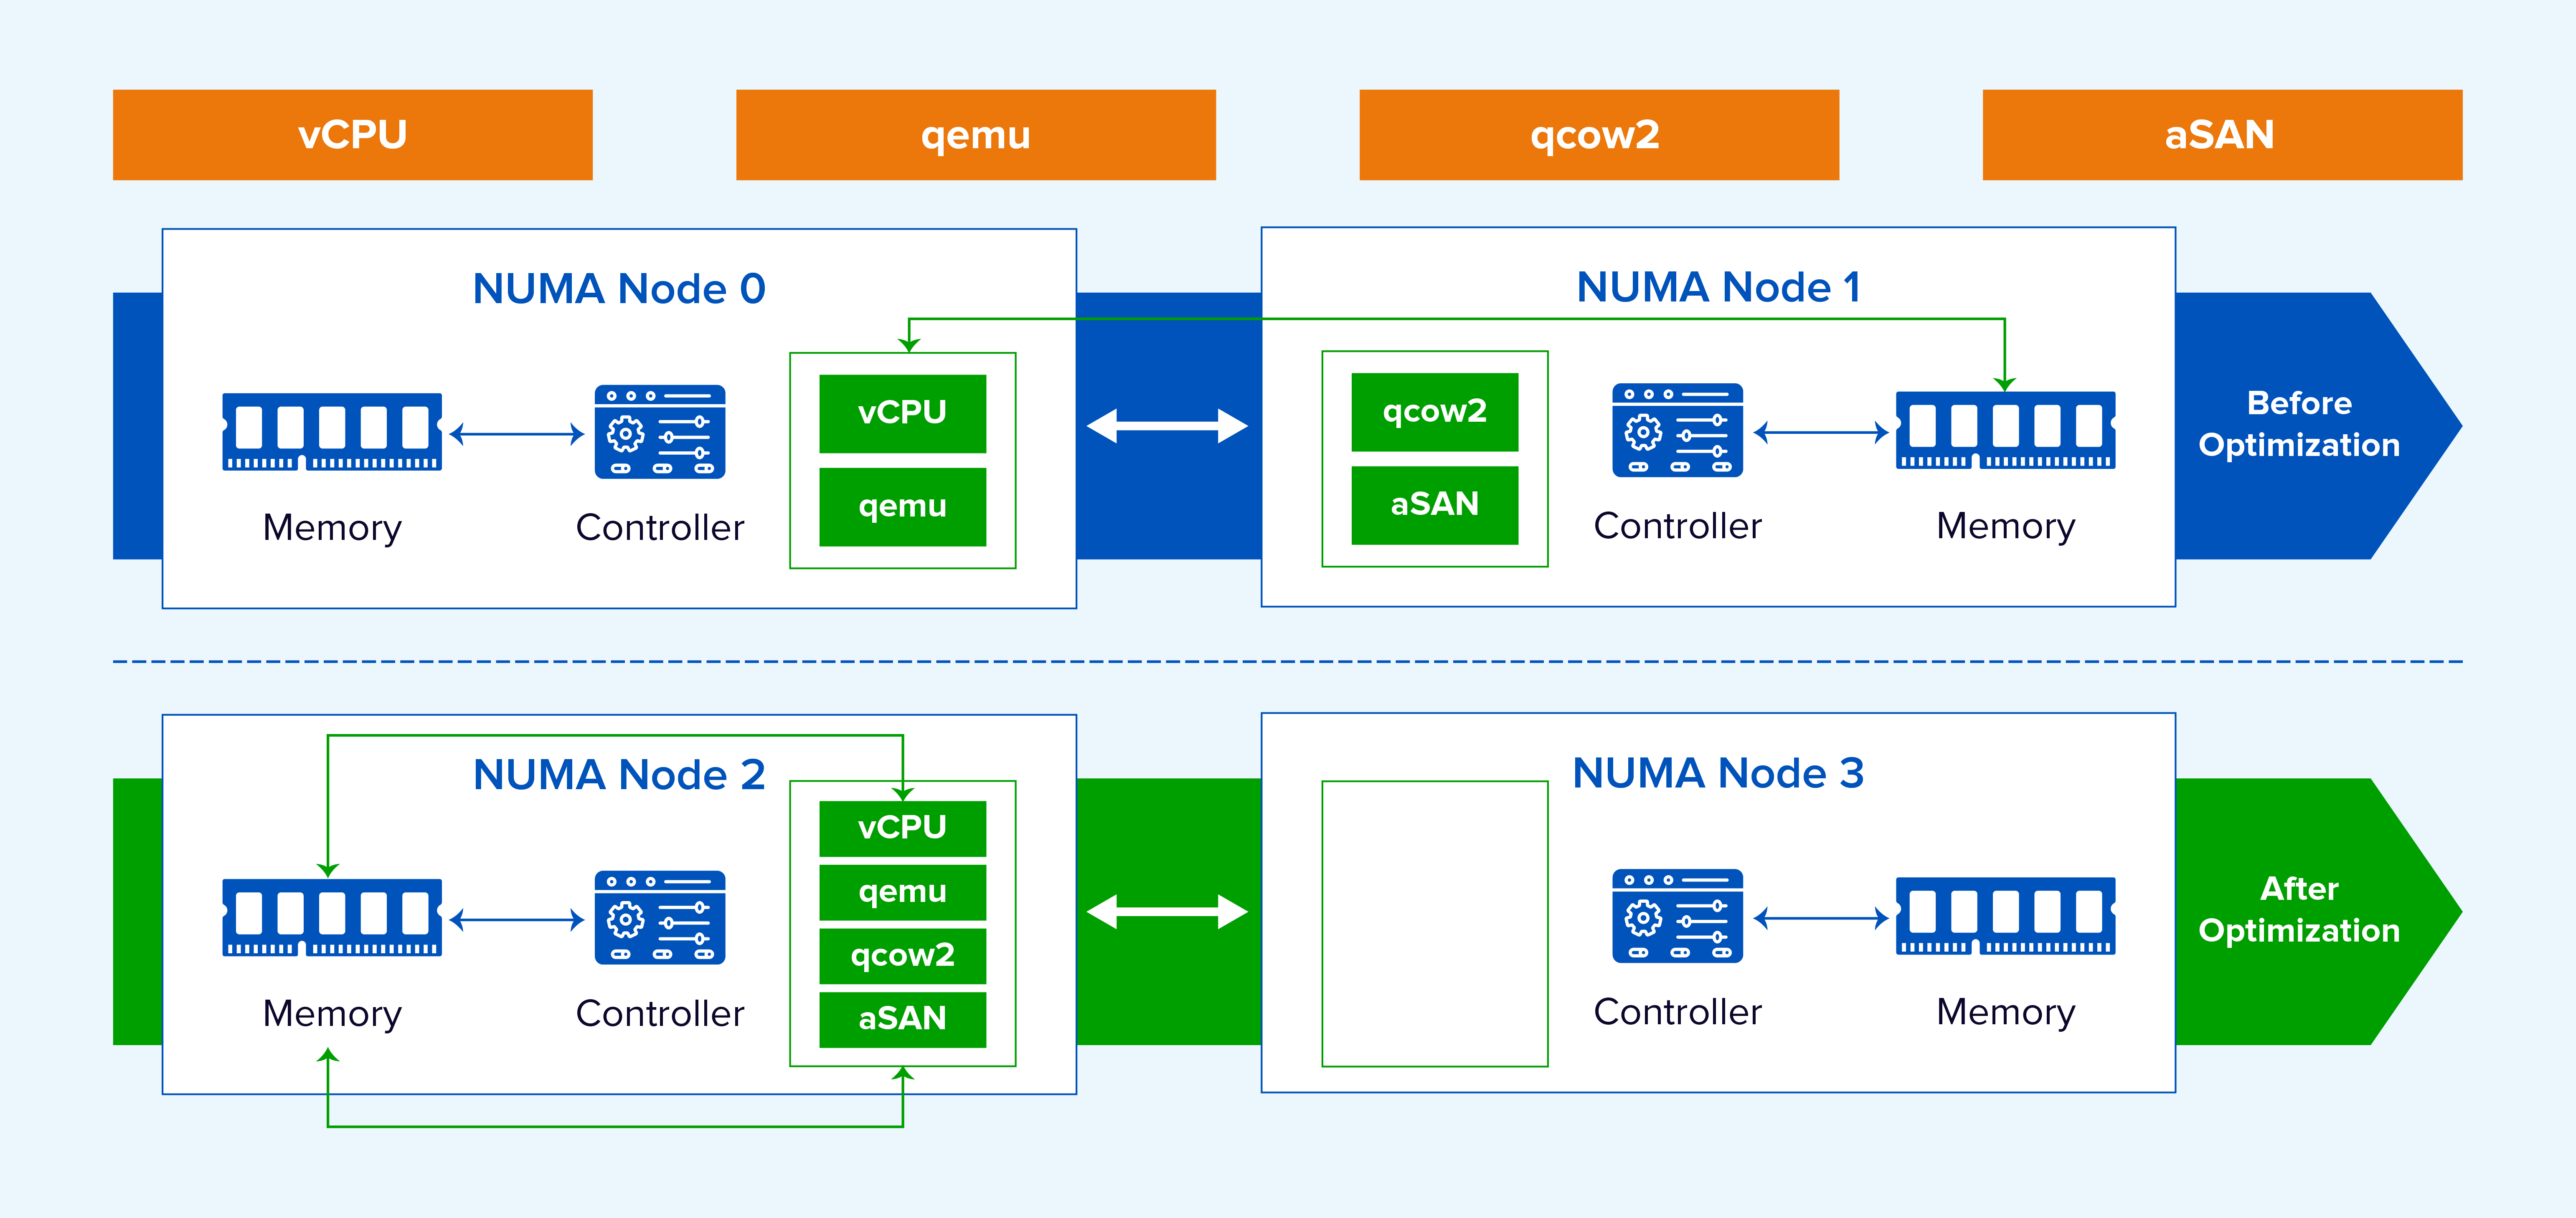
Figura 10. Ubicación NUMA coordinada a lo largo de la ruta de E/S del almacenamiento virtual.
Los datos que se transfieren desde un búfer de NIC al almacenamiento virtual deben ser procesados por subprocesos de la CPU. A medida que aumenta el rendimiento de la red, la eficiencia de la copia de búfer en un solo núcleo puede convertirse en un cuello de botella, mientras que el acceso entre NUMA reduce aún más la eficiencia. Sangfor permite que varios núcleos de la CPU procesen el tráfico de NIC y aplica afinidad NUMA. Esto elimina el cuello de botella de un solo núcleo, reduce la latencia de transferencia y mejora la concurrencia. En pruebas internas, el rendimiento de escritura de máquinas virtuales con gran profundidad de cola y bloques grandes mejoró en más del 20 %.
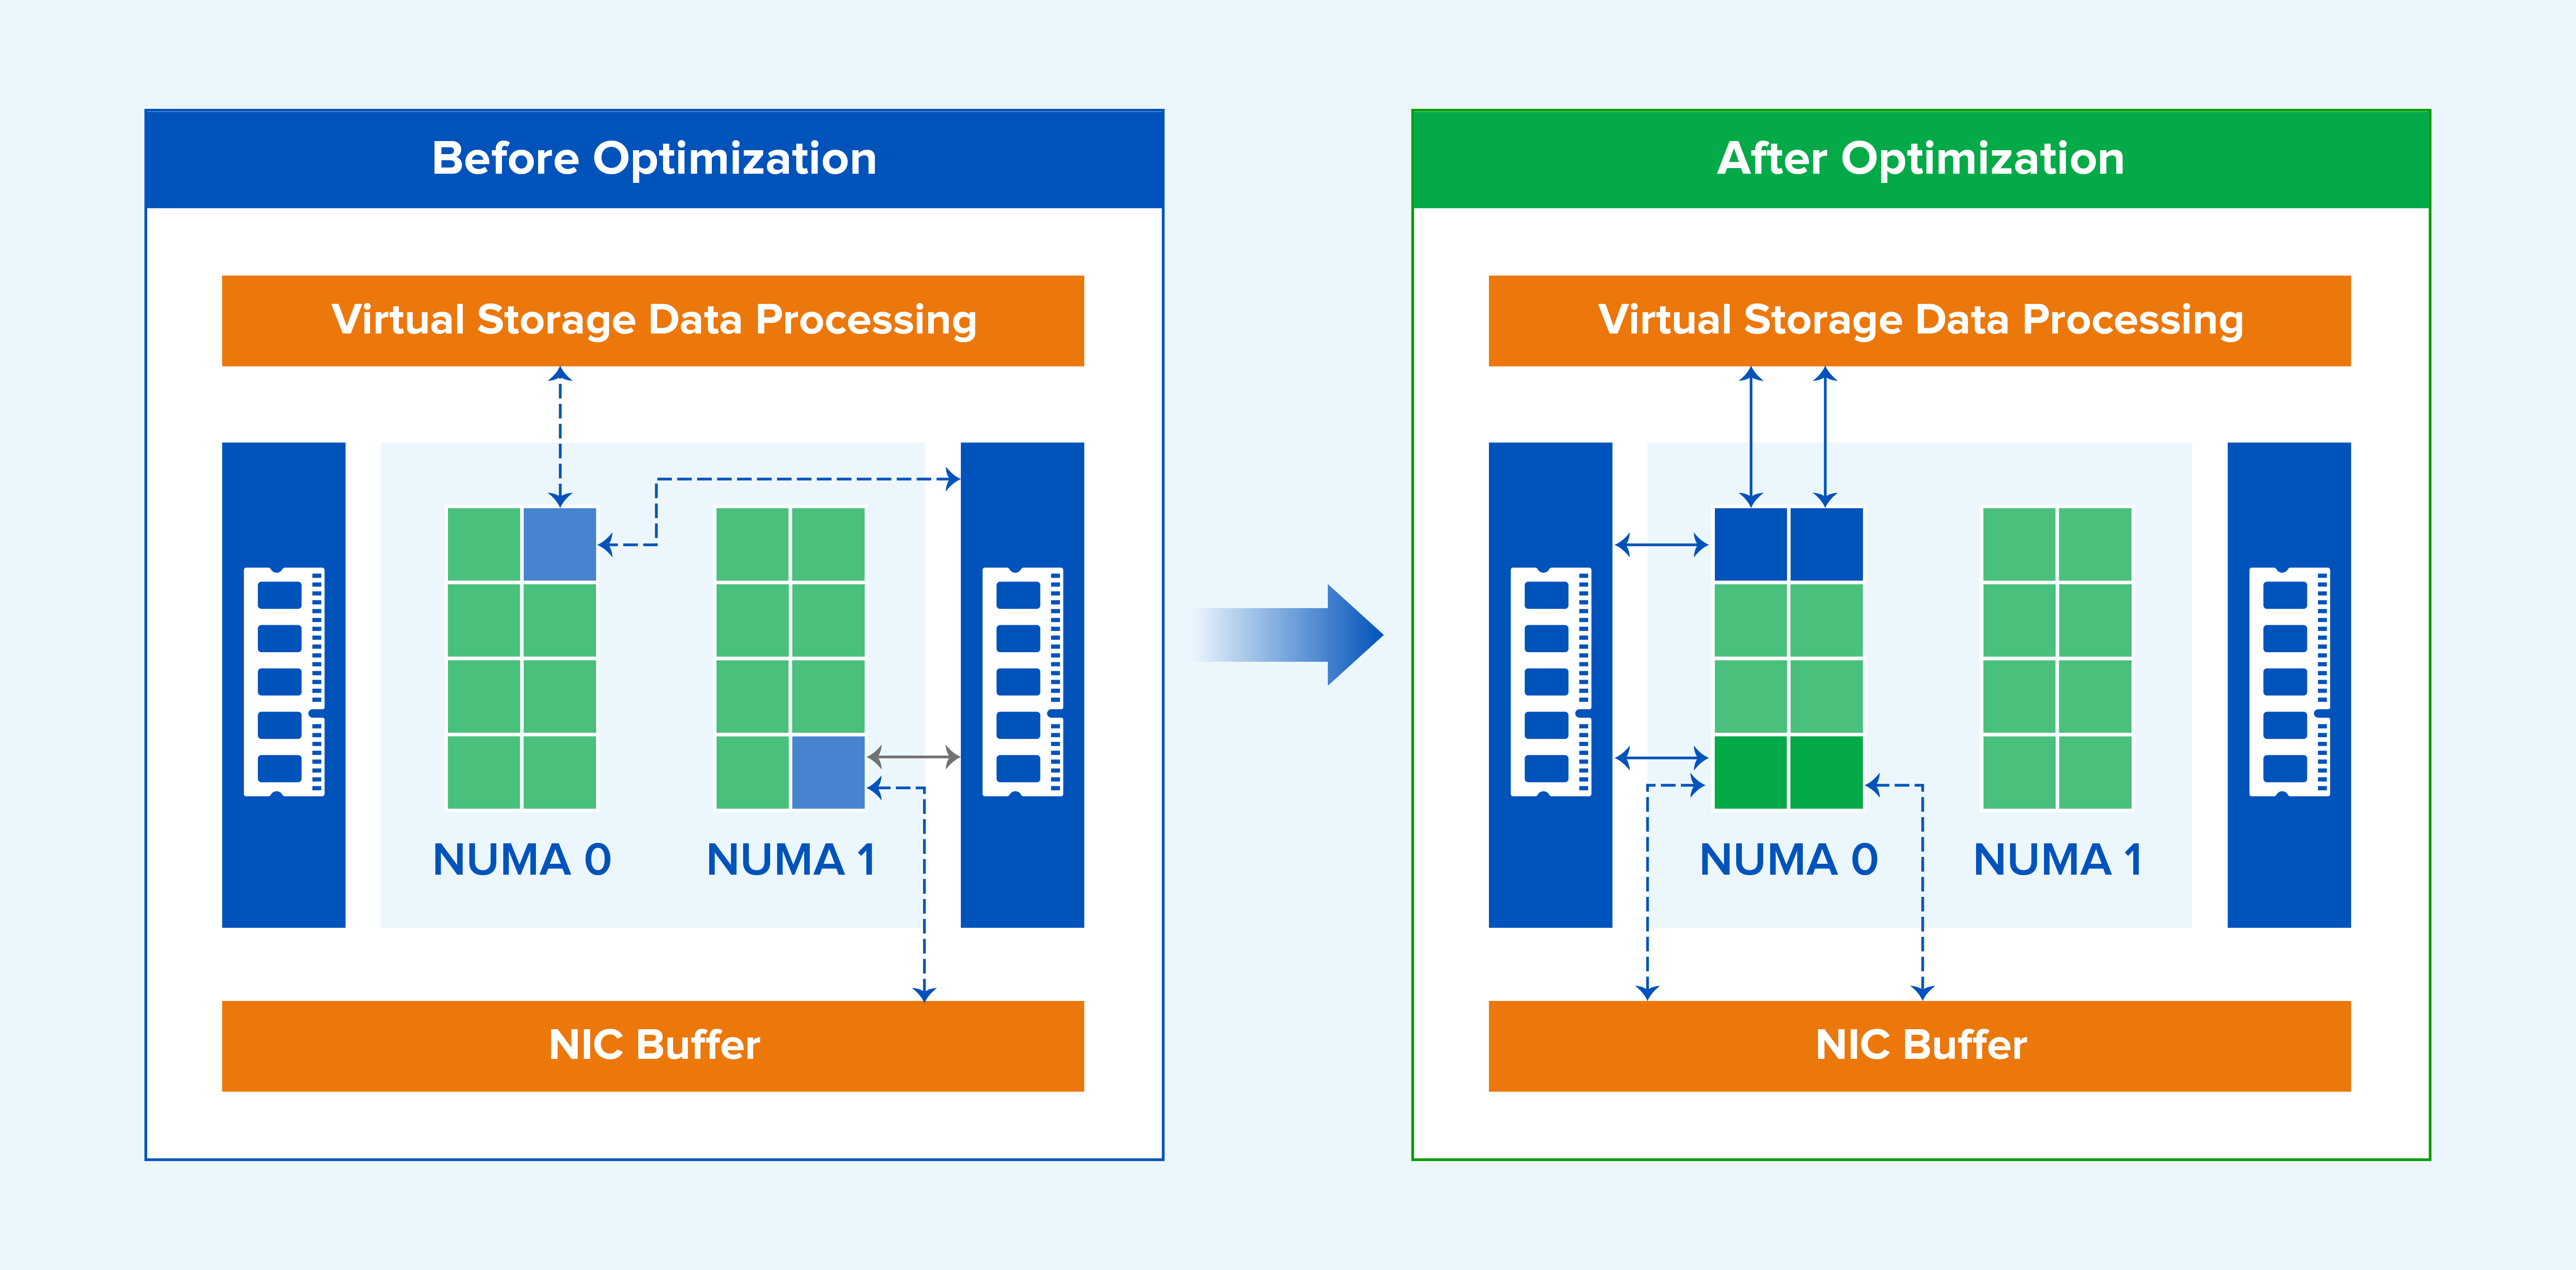
Figura 11. Procesamiento multinúcleo con afinidad NUMA entre búferes de NIC y almacenamiento virtual.
3. Comparación con otros enfoques de la industria
El soporte de la industria varía. Un proveedor permite a los administradores configurar el nodo NUMA en el que se ejecuta cada vCPU de máquina virtual, otro no admite esta capacidad y VMware admite la programación NUMA adaptativa.
Sangfor particiona y ubica automáticamente las vCPU de las máquinas virtuales en nodos NUMA para reducir el acceso a la memoria remota. En comparación con la configuración manual de la ubicación de cada vCPU, la programación NUMA adaptativa de Sangfor automatiza la partición y la ubicación de las vCPU, equilibra la utilización entre los nodos y mejora el rendimiento general.
En comparación con una implementación NUMA adaptativa básica, Sangfor extiende la optimización a la programación de servicios de almacenamiento, el reconocimiento de máquinas virtuales prioritarias, las plataformas de servidores heterogéneas y la afinidad de red de las máquinas virtuales. Estas mejoras reflejan la ingeniería conjunta entre los equipos de investigación y de productos en la nube de Sangfor y están diseñadas en función del comportamiento real de los servicios de plataforma.
PARTE 5. Resumen
La planificación NUMA adaptativa de Sangfor está optimizada para múltiples escenarios de infraestructura con el fin de mejorar la eficiencia del acceso a la memoria de las aplicaciones:
- Particione y ubique de forma adaptativa las vCPU de las máquinas virtuales en nodos NUMA para reducir el acceso a la memoria remota.
- Migre las máquinas virtuales entre nodos NUMA para mantener una utilización equilibrada.
- Identifique las máquinas virtuales prioritarias y manténgalas en nodos con menor carga, reduciendo así la competencia por la CPU, el ancho de banda de la memoria y la caché.
- Para servidores con muchos nodos NUMA y diferentes distancias entre nodos, identifique la distancia topológica y coloque preferentemente los recursos vNUMA relacionados en nodos NUMA físicos cercanos.
- Proporcionar una opción de afinidad de red para máquinas virtuales que coloque una máquina virtual en el mismo nodo NUMA que el plano de datos de la red para mejorar el rendimiento del reenvío.
- Aplique la planificación compatible con NUMA no solo a las máquinas virtuales, sino también a los servicios de almacenamiento.
Ejemplo de prueba de UnixBench
UnixBench es una herramienta de evaluación comparativa ampliamente utilizada para sistemas tipo Unix, incluyendo UNIX, BSD y Linux. Mide múltiples dimensiones del rendimiento del sistema, como el rendimiento de la CPU, el sistema de archivos, la memoria y los procesos.
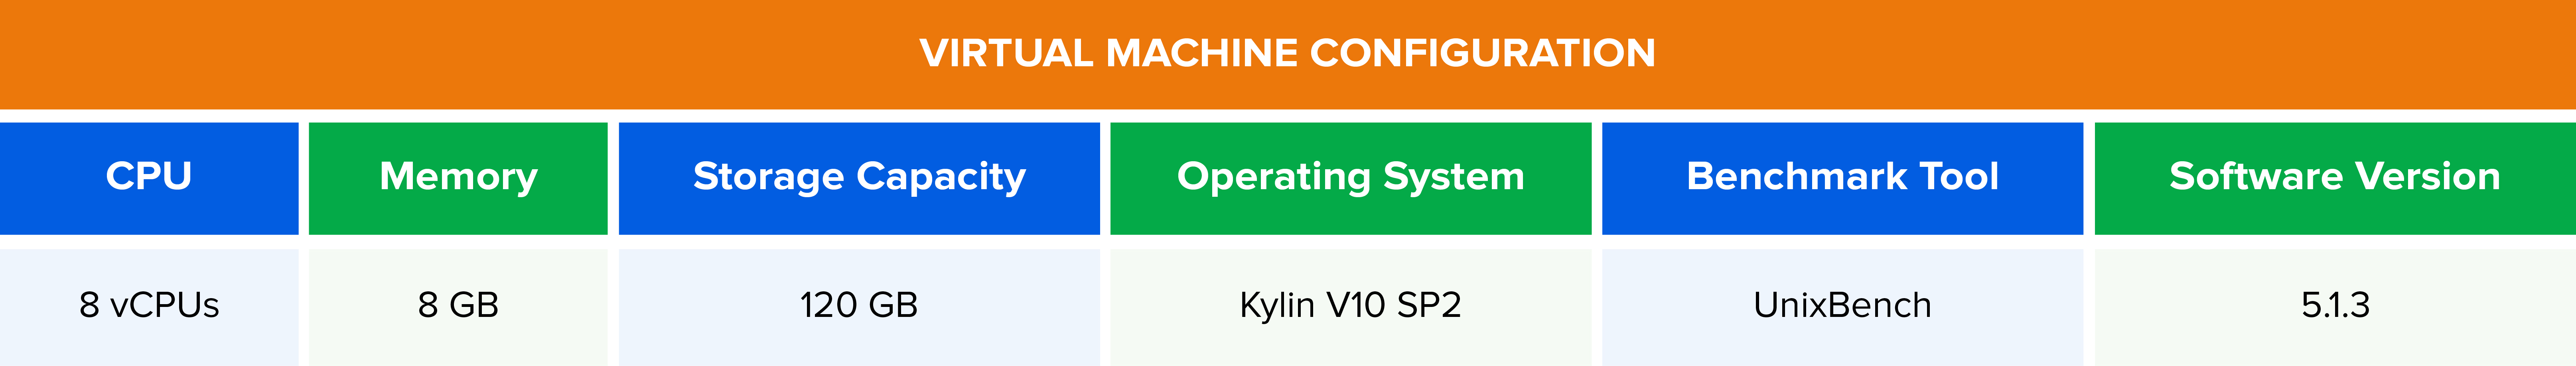
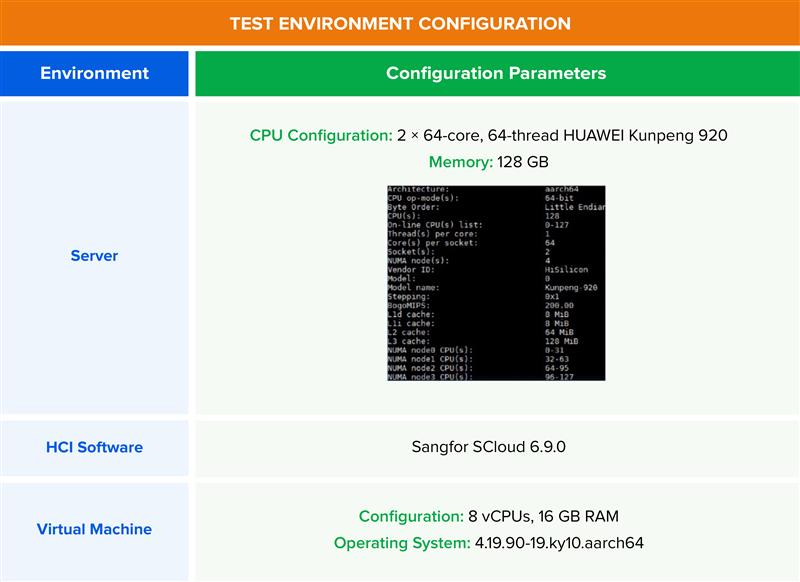
Figura 12. Configuración de la máquina virtual para las pruebas de UnixBench.
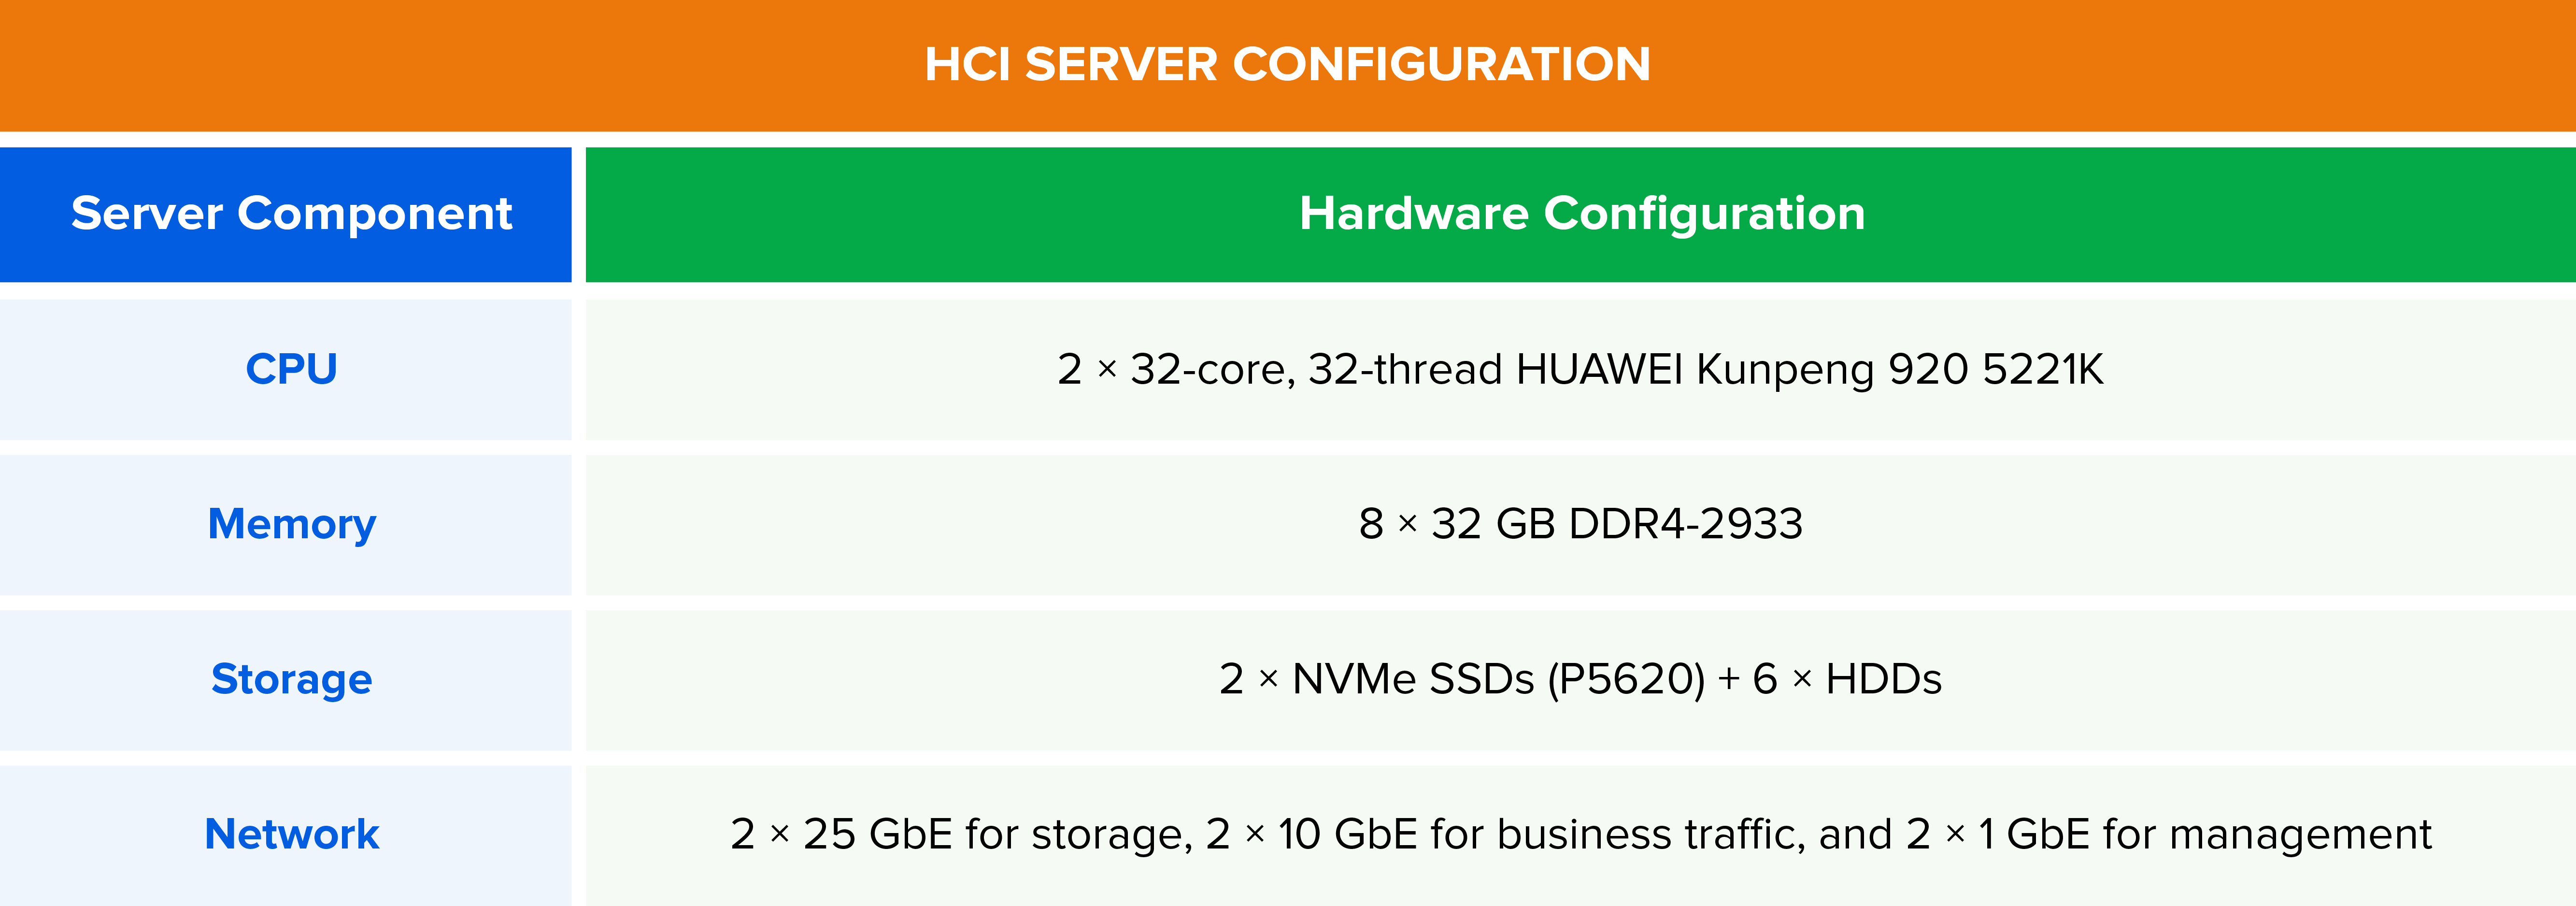
Figura 13. Configuración de hardware del servidor HCI para pruebas UnixBench.
Resultados de las pruebas: En Sangfor HCI 6.9.0, con NUMA habilitado, la puntuación agregada de UnixBench para 6 máquinas virtuales ejecutándose simultáneamente en el mismo host fue un 20,2 % superior a la de la plataforma de comparación anonimizada. Para 8 máquinas virtuales simultáneas, la puntuación agregada fue un 34,17 % superior.
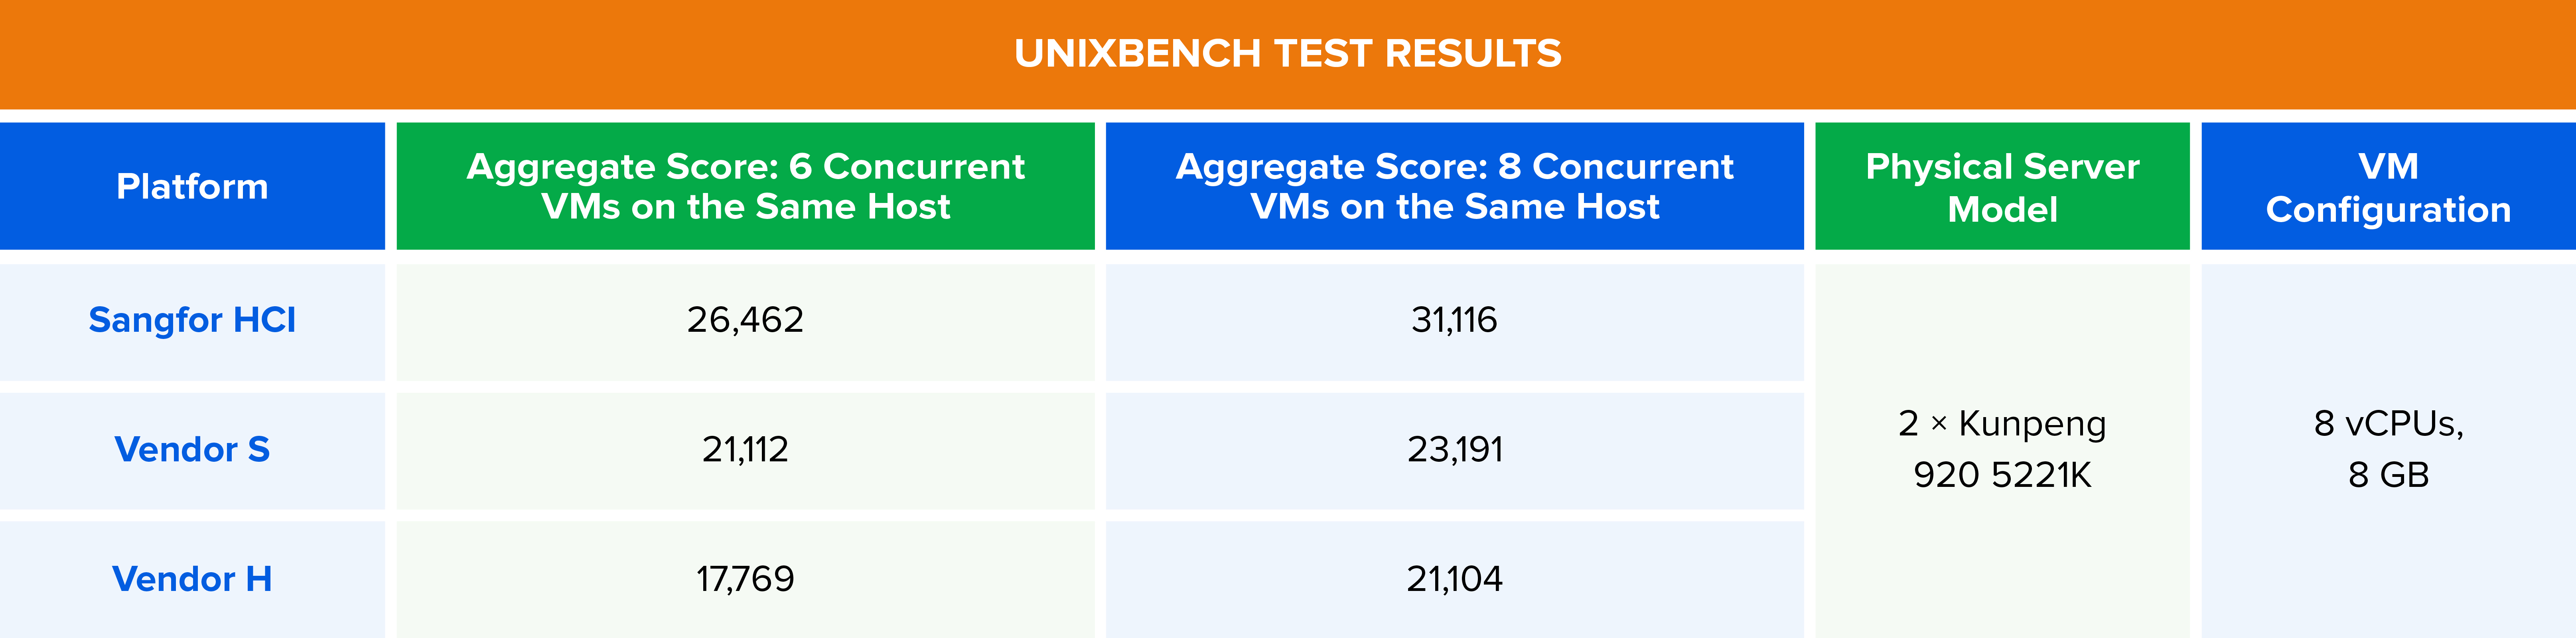
Figura 14. Resultados comparativos de la prueba de rendimiento UnixBench bajo cargas de trabajo concurrentes en máquinas virtuales.
Las observaciones de referencia presentadas en este artículo reflejan entornos de prueba internos específicos de Sangfor y se proporcionan con fines ilustrativos. Los resultados reales varían según el hardware, la versión del software, la configuración y la carga de trabajo. Los clientes deben validar las aplicaciones representativas en función de sus propios objetivos de nivel de servicio.

