このブログ記事をAIで要約してください。
 ChatGPTに質問する
 グロックに質問する
 困惑を尋ねる
 クロードに聞いてみよう
 Google AIに質問する
長年にわたり、仮想マシンの移行は、ほとんどの企業ITチームが基盤となるインフラストラクチャ戦略を変更することなく実行できる運用上のタスクでした。メンテナンスのためにワークロードをホスト間で移動したり、ストレージを新しいデータストアに移動したり、アプリケーションを別のデータセンターに移行したりといった作業です。その目的は単純明快で、基盤となるインフラストラクチャが変更されても、アプリケーションを稼働させ続けることでした。
2026年になると、これまで馴染み深かったこのプロセスは、戦略的な意思決定へと変化します。企業はVMwareのライセンスとインフラストラクチャのコストを見直し、データセンターの近代化、パブリッククラウドから特定のワークロードを移行、そして新たなAIやデータ集約型アプリケーションに対応するためのプラットフォームの準備を進めています。もはや問題は単にVMを移行する方法ではなく、その移行が今後5年間のインフラストラクチャ運用を支えることができるかどうかです。
現在、VMwareはインフラストラクチャ変革の重要な触媒となっています。2023年のブロードコムによるVMware買収後、ライセンス、製品パッケージ、パートナーエコシステムの変更により、企業は新たな仮想化プラットフォームを模索するようになりました。ある独立系調査会社は最近、 企業の48%が2028年までにVMwareから撤退する意向であることを明らかにしました。しかし、同調査報告書は、意向は実行とはイコールではないと指摘しています。これらの企業の4分の1は、VMwareと完全に同等の代替ソリューションをまだ見つけておらず、VMware環境を再構築するには、さまざまなプロバイダーのソリューションを寄せ集める必要があるからです。
最終的に、計画性のないVM移行は、長期的にはより大きな損害を引き起こす可能性があり、アプリケーションのダウンタイム、データの破損やアクセス不能、パフォーマンスの低下、バックアップ保護の不備などにつながります。綿密に計画された移行を行うことで、企業はより管理しやすく持続可能なインフラストラクチャ基盤を構築できます。
このガイドでは、VM移行のさまざまなタイプについて説明し、実践的な5段階の計画フレームワークを提示するとともに、VMwareワークロード移行における特有の課題と失敗要因を検証します。また、企業がVMwareからの移行を検討する際に具体的に考慮すべき点についても解説します。
VM移行とは何か、また、どのような種類があるのか?
VM移行とは、仮想マシン(仮想ディスク、コンピューティング構成、オペレーティングシステム、および関連データを含む)を、あるホスト、ストレージシステム、または仮想化プラットフォームから別のホスト、ストレージシステム、または仮想化プラットフォームへ移動するプロセスです。移行方法によっては、VMは移行中も稼働し続ける場合もあれば、一時的に停止される場合もあります。移行の種類によって、必要なツール、ダウンタイム、および互換性チェックが決まります。以下の分類は、インフラストラクチャチームが利便性ではなくビジネス要件に基づいてアプローチを選択するのに役立ちます。
- ライブマイグレーション(ホットマイグレーション):実行中の仮想マシンが互換性のあるホスト間を移動する際に、メモリの状態が段階的にコピーされます。最終的な切り替えは短時間で完了するため、アプリケーションは引き続き利用可能です。VMware vMotionやSangfor aSVのライブマイグレーションは、この方式の例です。
- コールドマイグレーション(オフラインマイグレーション):この場合、ディスクと構成を移動する前に仮想マシンをシャットダウンします。これはライブメモリを転送するよりも簡単で、重要度の低いシステムや、計画的なメンテナンス期間のあるワークロードに適しています。唯一の欠点は、アプリケーションのダウンタイムが発生することです。
- ストレージ移行:この方法では、仮想マシンが稼働を継続している間に、VMディスクファイルがデータストアまたはストレージシステム間を移動します。これは、ストレージのリフレッシュ、データセンターの統合、ストレージの階層化の際によく使用され、コンピューティングホストを変更せずに済みます。
- クロスプラットフォーム移行:ここでは、ワークロードが物理環境から仮想環境(P2V)、仮想環境から仮想環境(V2V)、仮想環境からクラウド環境(V2C)など、根本的に異なる環境間で移行されます。移行には、ディスクフォーマットの変換、ゲストOSドライバの変更、ネットワークの再構成、および広範な検証が必要になる場合があります。
- ハイパーバイザー間移行:これは、VMをあるハイパーバイザーから別のハイパーバイザー(VMware ESXiからSangfor aSV、KVM、Hyper-Vなど)へ移行する、特殊なV2V移行です。互換性のある変換ユーティリティまたは構造化された移行プラットフォームが必要です。
重要な違いは、ライブマイグレーションとコールドマイグレーションはワークロードの移動方法を説明するのに対し、クロスハイパーバイザーマイグレーションはワークロードの移動先を説明する点です。VMwareワークロードは、別のハイパーバイザーへのコールドマイグレーション、または互換性のある移行先環境内でのライブマイグレーションを実行する可能性があります。では、この情報をどのように実用的な移行計画に反映させればよいのでしょうか?
VM移行の計画:5段階のフレームワーク
エンタープライズVMの移行は、単発的な作業の集合ではなく、反復可能なプロセスとして管理されるべきです。以下の5つのフェーズは、運用リスクを軽減するための実践的なフレームワークを提供します。
フェーズ1:在庫と依存関係のマッピング
仮想マシンを1台移行する前に、既存のシステムと、その仮想マシンに依存しているシステムを把握してください。データベースサーバーは複数のアプリケーションサーバーをサポートしている場合があり、それらのアプリケーションはDNS、認証、ファイル共有、または外部APIに依存している可能性があります。仮想マシンレベルの移行が成功しても、ビジネスアプリケーションレベルでは失敗する可能性があることを覚えておいてください。
インベントリには、CPUとメモリの割り当て、ストレージ容量、オペレーティングシステム、IPアドレス、VLAN、仮想スイッチ、アプリケーション所有者、バックアップスケジュール、および復旧目標を含める必要があります。依存関係のマッピングは、文書化されていない接続が予期せぬ障害を引き起こす可能性がある大規模なシステム環境において特に重要です。
フェーズ2:互換性評価
ハイパーバイザー間の移行では、移行先のシステムに十分なCPUとメモリがあるかどうかを確認するだけでは不十分です。チームは、ディスクフォーマット、仮想ハードウェアのバージョン、ゲストOS、ブート構成、ネットワークアダプタ、ストレージコントローラなどを評価する必要があります。さらに、ドライバの更新、OSのアップグレード、またはアプリケーション固有の修復が必要なワークロードを特定する必要があります。
VMwareへの移行の場合、この評価ではVMware Tools、スナップショット、バックアップ統合、vSwitchおよび分散スイッチ構成、そしてNSXの依存関係も対象とする必要があります。変換が容易なワークロードであっても、移行後に相当な構成作業が必要になる場合があります。
フェーズ3:移住波の計画
VM環境全体を単一の移行イベントとして扱わないでください。アプリケーションの依存関係、ビジネス上の重要度、保守要件、および技術的な類似性に基づいて、ワークロードを段階的にグループ化してください。最初の段階には、独立した開発サーバーや影響の少ない社内アプリケーションが含まれるのが妥当ですが、後の段階では、密接に接続されたデータベース、認証サービス、および顧客向けアプリケーションを含む本番システムを含めることができます。
各ウェーブには、担当者、承認済みのメンテナンス期間、検証チェックリスト、および文書化されたロールバック手順が必要であることを忘れないでください。
フェーズ4:検証を伴う実行
移行は必ず管理されたグループで実行してください。移行を開始する前に、ソース構成を記録し、最新のバックアップを確認し、期待されるパフォーマンスの基準値を確立してください。移行中は、移行プロセス、ソースおよび移行先のリソース使用率、アプリケーションの可用性を監視してください。
シフト終了後、VMが正常に起動しているか、アプリケーションが依存関係にアクセスできるか、ユーザーが認証できるか、スケジュールされたジョブが正しく実行されるか、バックアップポリシーが有効になっているかを確認する必要があります。これらの確認が完了してから、次のウェーブに進んでください。
フェーズ5:廃止措置と浄化
最終段階は、移行されたワークロードが一定期間安定して稼働するまで、元の環境を利用可能な状態に維持することです。重要なシステムの場合、2~4週間が適切な開始期間となる可能性がありますが、期間はアプリケーションのサイクル、復旧要件、およびビジネスリスクによって決定する必要があります。
廃止作業には、不要になったスナップショット、未使用のストレージ、古いネットワーク構成、監視オブジェクト、およびソースバックアップジョブの削除が含まれます。監査、トラブルシューティング、および将来のプラットフォーム変更に備えて、移行記録は常に安全に保管してください。
これらは、VMwareへの移行を漏れなく成功させるために実行できる具体的な手順です。ただし、それでもいくつかの障害が生じる可能性があります。
VMware移行:ハイパーバイザー間VM移行における特有の課題
VMwareワークロードを別のプラットフォームに移行することは、ESXiホスト間で仮想マシンを移行することとは大きく異なります。移行先では、仮想ハードウェアの公開方法、使用するディスクフォーマット、ネットワークおよびゲスト統合メカニズムが異なる場合があります。これらは、移行作業において注意すべき課題の一部です。
VMware VMは単なるディスクファイルではない
VMware仮想マシンは、一般的にVMDK仮想ディスクファイル、VMware仮想ハードウェア抽象化、およびゲストOSとの統合のためのVMware Toolsを使用します。VMDKを新しいハイパーバイザーにコピーしても、完全に互換性のある仮想マシンが自動的に再作成されるわけではありません。コピー先のハイパーバイザーは、ゲストOSを起動し、仮想デバイスを認識し、適切なドライバを提供できる必要があります。
VMware ToolsとゲストOSの統合
VMware Tools は、VMware 環境内でのゲスト OS の統合、最適化されたデバイス ドライバ、および運用機能をサポートします。別のハイパーバイザに移行する場合、移行元のツールは移行先の仮想ハードウェアに適さなくなる可能性があります。選択した移行計画では、VMware Tools を削除し、移行先のプラットフォームのゲスト エージェントまたはドライバをインストールする適切なタイミングを特定する必要があります。これには、メンテナンス ウィンドウと制御された再起動が必要になる場合があります。この手順を省略すると、パフォーマンスの低下、ドライバの競合、またはゲスト OS の予期しない動作が発生する可能性があります。
スナップショットとバックアップの互換性
VMware固有のバックアップ統合も重要な検討事項です。VMware vSphere API for Data Protection(VADP)に依存するバックアッププラットフォームは、別のハイパーバイザー上で稼働する仮想マシンに対しても同様の保護を提供するとは限りません。ソースを廃止する前に、移行されたすべての仮想マシンがサポートされているバックアップワークフローによって保護されていることを確認してください。最初のバックアップが正常に完了したことを確認し、代表的なワークロードに対して復旧手順をテストする必要があります。
ここで、SangforはVeeamおよびCohesityとのエコシステム統合により、Sangfor aSVのバックアップとリカバリをサポートします。Veeamはバックアップ、リカバリ、および災害復旧のオーケストレーションをカバーし、Cohesity(Veritasとの合併後)は移行環境全体にわたってデータの回復力、管理、およびセキュリティを拡張します。これらのパートナーシップにより、企業は移行計画の一環として、ターゲットプラットフォームの保護を確立することができ、後続プロジェクトとして行う必要がなくなります。
ネットワーク構成を再構築する必要があります
仮想スイッチ、ポートグループ、分散スイッチポリシー、およびNSXネットワークは、別のハイパーバイザーに自動的に移行されません。移行先の環境には、独自のネットワークモデルに従って構成された、同等の接続性とセキュリティポリシーが必要です。VMwareから別の環境への移行の場合、ネットワーク検証には、ゲートウェイ接続、DNS、アプリケーションとデータベース間の通信、ファイアウォールルール、およびロードバランサーやIDサービスへの依存関係を含める必要があります。
VMwareから代替プラットフォームへのVM移行ツール
企業は一般的に、移行ツールに関して3つのアプローチを採用しています。
1. ネイティブ変換ユーティリティ:これらは、移行先のハイパーバイザーベンダーが提供するツールで、ディスク変換、ゲストOSの準備、移行ワークフローを自動化できます。大規模なシステム群を単一のターゲットプラットフォームに移行する場合に、これらのツールが推奨されることがよくあります。
2. サードパーティ製V2V移行プラットフォーム:独立したツールは、複数のハイパーバイザーをサポートし、変換、オーケストレーション、検証機能を提供する場合があります。ゲストOSのバージョン、ディスクの種類、およびエンタープライズ規模の移行要件に対するサポート状況を評価してください。
3. 手動変換ツール: qemu-img のようなユーティリティはディスク形式を変換できます。これは小規模な環境や特殊なワークロードには有効ですが、ゲスト構成、ドライバ、ネットワーク、検証に関して移行チームの責任が増える可能性もあります。
適切なツールの選択は、仮想マシンの数、ワークロードの多様性、必要なダウンタイム、そして組織がサポートできる自動化のレベルによって異なります。では、スムーズな移行をどのように実現すればよいのでしょうか?
VM移行のベストプラクティス:スムーズな移行と失敗を分けるもの
VM移行計画を成功させるには、正確性、安全性、信頼性が不可欠です。ここでは、よりスムーズで実りある移行を実現するために、貴社が実践できるベストプラクティスをいくつかご紹介します。
依存関係マッピングを必須事項にする
最も深刻な移行失敗は、多くの場合、仮想マシン自体の外部で発生します。ネットワーク経路、ファイアウォールポリシー、またはサービス依存関係が見落とされたために、移行されたアプリケーションがデータベース、IDプロバイダー、ファイル共有、またはAPIへのアクセスを失う可能性があります。そのため、重要な依存関係をマッピングし、アプリケーション所有者を検証プロセスに参加させることが重要です。アプリケーションの準備が整っていても、インフラストラクチャが準備できていない可能性があるからです。
必要になる前にロールバックをテストしてください
各移行ウェーブには、明確なロールバック手順が必要です。これにより、ロールバックをトリガーする条件を定義し、ソースVMとデータ復旧ポイントを特定し、決定を承認できる人物を確認できます。文書にのみ存在するロールバック計画では不十分です。本番環境への移行ウェーブの前に、代表的なワークロードでテストする必要があります。これは、ハイパーバイザー間で移行する場合に特に重要です。ハイパーバイザー間では、変換の失敗により、ライブ移行を単に元に戻すのではなく、元のVMを復元する必要が生じる可能性があるためです。
廃止前にバックアップカバレッジを検証する
バックアップ保護はワークロードに合わせて行う必要があります。常に、バックアップ先のプラットフォームがサポートされていること、VMが適切なバックアップポリシーに含まれていること、そしてバックアップが正常に完了したことを確認してください。より要求の厳しい環境では、復元テストを通じてリカバリ時間とリカバリポイントの目標値も検証する必要があります。バックアップジョブが成功したという報告は有用な証拠となりますが、リカバリ検証に代わるものではありません。
トラフィックが少ない時間帯に移行する
ライブマイグレーションはダウンタイムを削減しますが、リソースの競合を完全に解消するわけではありません。VMメモリのコピーやストレージの同期は、特にメモリ変更頻度の高い負荷の高いワークロードの場合、ネットワーク帯域幅とCPUリソースを消費する可能性があります。可能な限りトラフィックの少ない時間帯に移行を計画し、リソース使用状況を監視し、インフラストラクチャがその負荷に対してテストされていない限り、多数の頻繁なVMを同時に移動することは避けてください。
遺産とその結果を記録する
必ず、元の仮想マシン構成、移行ツールとそのバージョン、ゲストOSへの変更点、ネットワーク割り当て、検証結果、および発生した問題点を記録してください。一貫したドキュメント作成により、後続の移行作業では以前のミスを繰り返すことなく改善を図ることができます。移行手順書は、最初の移行作業に参加しなかった人にとっても役立ちます。これは、人員の入れ替わり、慌ただしいメンテナンス、不完全な引き継ぎを防ぐための実用的な対策となります。
さて、このフレームワークを大規模に実行するとなると、ほとんどの社内チームは追加のサポートを必要とします。特に、大規模な仮想マシン環境全体における互換性評価、ウェーブシーケンス、ロールバックテストなどにおいて、その必要性が高まります。Sangforの移行ツールとプロフェッショナルサービスは、まさにこうしたニーズに応えるために設計されています。
Sangfor がエンタープライズ VM の移行をどのようにサポートするか
Sangforは、大企業向けに仮想化およびインフラストラクチャ製品を提供するグローバルな多国籍企業であり、企業データセンターの近代化を目的とした製品ポートフォリオを展開しています。同社のaSVハイパーバイザーおよびHCIプラットフォームは、より広範なインフラストラクチャ戦略の一環としてVMwareの代替ソリューションを検討している組織にとって最適な選択肢となります。
Sangfor aSVは、スタンドアロンのコンピューティングプラットフォームとして、またはSangfor HCIのコンピューティングコンポーネントとして利用可能なタイプ1ハイパーバイザーです。エンタープライズ仮想化ワークロードをサポートし、VMware ESXiから別のハイパーバイザーへの移行パスを提供するように設計されています。
VMwareの代替を検討している企業にとって重要なのは、移行先で既存のVMが実行できるかどうかだけでなく、移行プロセスを標準化、テスト、そして本番環境のワークロード全体で再現できるかどうかです。Sangforは、VMware ESXiからaSVへのワークロード移行のための移行ユーティリティも提供しており、ワークロードをターゲット環境に移行するために必要な変換および準備手順をサポートします。サポートされるゲストOSのバージョン、ソース構成、および自動化機能については、技術評価の際に必ず確認してください。
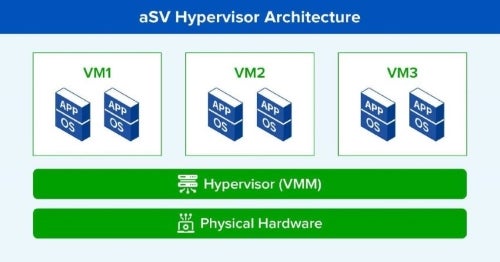
ここで、構造化された移行ワークフローが重要になります。ディスク変換をプロジェクト全体として扱うのではなく、企業はツールがVMの検出、ゲストの準備、ネットワーク構成、検証、ロールバック計画をどのようにサポートするかを評価する必要があります。Sangfor aSVは、互換性のあるホスト間でのライブ移行もサポートしており、aSV上でワークロードが確立された後でも、メンテナンス、負荷分散、ハードウェア更新のための使い慣れた運用機能を提供します。ライブ移行はハイパーバイザー間の変換の代替にはなりませんが、VMがaSV上で実行された後、移行先環境内でVMを移動する際に役立ちます。
SangforのHCIは、コンピューティング、ストレージ、ネットワーク、管理機能を統合したインフラストラクチャプラットフォームです。より広範なデータセンター近代化プロジェクトに取り組む組織にとって、HCIはハイパーバイザー移行と並行して一貫した運用モデルを提供できます。Sangfor Cloudプラットフォームは、仮想化インフラストラクチャ全体にわたる集中管理と可視性も提供します。移行プログラム中、集中管理レイヤーは、VMの配置、リソース使用率、移行状況、移行後の健全性を追跡するのに役立ち、環境が1つのプラットフォームから別のプラットフォームに移行する際の運用上の断片化を軽減します。
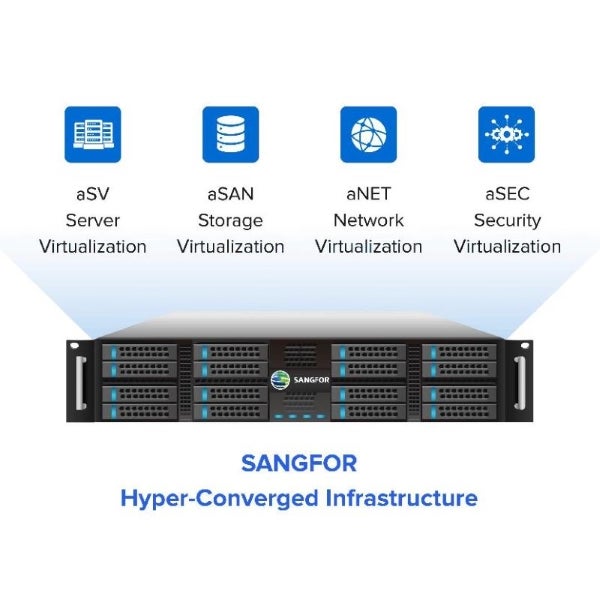
Sangforの幅広いインフラストラクチャポートフォリオも、ストレージ、ネットワーク、セキュリティに同様の統合アプローチを採用しています。VMwareの顧客はvSANを別途ライセンスが必要なストレージレイヤーとして追加することが多いのに対し、aSANはHCIスタックに完全統合された分散型ソフトウェア定義ストレージとして組み込まれています。NSXはネットワーク仮想化を高度な別途ライセンスが必要な、高度なスキルを要するレイヤーとして追加するのに対し、aNETは同じプラットフォームの一部として組み込み型の視覚化されたネットワーク仮想化を提供し、aSECがマイクロセグメンテーションとセキュリティを処理します。これらのコンポーネントは、VMwareへの移行がより大規模なインフラストラクチャ変革の一部となる場合に、aSVと併せて評価することができます。
移行チームは、それぞれの環境におけるサポートされている統合、構成要件、および復旧ワークフローを確認する必要があります。バックアップ体制は最終的にはプロジェクトの成果物であり、移行後の後付け事項ではありません。
多くの場合、大規模なVMwareリプレースプログラムには、複数のデータセンター、多様なゲストOS、複雑なアプリケーション依存関係、そして厳格な変更管理要件が伴います。Sangforのグローバルプロフェッショナルサービス組織は、こうしたプログラムを管理する企業に対し、移行計画、実行、および移行後の検証をサポートします。VMwareの代替ソリューションを探している組織は、プラットフォームの機能と、必要な規模での移行を実際に実行できる能力の両方を考慮して決定を下すべきです。
VM移行を、管理されたビジネス変革へと導きましょう。
2026年におけるVM移行は、もはや単なる技術的な手順ではありません。インフラストラクチャの経済性を向上させ、運用を簡素化し、変化するビジネス要件をサポートするプラットフォームを構築する機会となります。最も安全なアプローチは、規律に基づいたものです。つまり、環境のインベントリを作成し、依存関係をマッピングし、互換性を検証し、段階的に移行し、ロールバックをテストし、ソースを廃止する前にバックアップ保護を確認することです。これらの手順は、移行先が別のVMwareクラスタ、クラウドプラットフォーム、またはSangfor aSVやHCIのようなエンタープライズグレードの代替ソリューションのいずれであっても適用されます。
VMwareへの移行を検討している組織にとって、意思決定はワークロード要件、運用リスク、総所有コスト、そして移行期間全体を通して信頼性の高いアプリケーションおよびデータ保護を維持できる能力に基づいて行うべきです。最終的には、適切なフレームワークとツールを用いることで、複雑な移行を、管理された再現可能なインフラストラクチャ変革へと変えることができるのです。
よくある質問
仮想マシンとその関連データ、構成、およびオペレーティングシステムを、あるホスト、ストレージシステム、または仮想化プラットフォームから別のホスト、ストレージシステム、または仮想化プラットフォームに移行するプロセス。これは、仮想マシンが実行中(ライブマイグレーション)またはシャットダウン後(コールドマイグレーション)に実行できます。
ライブマイグレーションは、稼働中の仮想マシンを最小限の中断で移動させるのに対し、コールドマイグレーションでは、移動前に仮想マシンの電源をオフにする必要があります。ライブマイグレーションはメンテナンスや負荷分散に役立ちますが、コールドマイグレーションはオフラインのワークロードやハイパーバイザー間の変換にはより簡便な場合が多いです。
まず、仮想マシンとその依存関係を一覧化し、次にディスクフォーマット、ゲストOSの互換性、ドライバ、ネットワーク構成、およびバックアップ要件を評価します。サポートされている変換ユーティリティまたは移行プラットフォームを使用し、移行先のワークロードを検証し、ロールバックとリカバリの要件が満たされるまでソースを保持します。
アプリケーションのダウンタイム、依存関係の破損、ゲストドライバの互換性の問題、ネットワーク接続障害、データ整合性の問題、バックアップのカバー範囲の不足などが発生する可能性があります。ハイパーバイザ間の移行では、ディスクフォーマットや仮想ハードウェアの互換性の問題が発生するリスクも加わるため、テストとロールバック計画が特に重要になります。
変換先ハイパーバイザーベンダーが提供するネイティブ変換ユーティリティ、サードパーティ製のV2V移行プラットフォーム、およびqemu-imgなどの手動ディスク変換ユーティリティなどがあります。最適な選択肢は、ソースおよびターゲットハイパーバイザー、ワークロードの多様性、規模、ダウンタイム要件、および必要な自動化レベルによって異なります。



